{count, plural, one {लर्निंग पाथ} other {लर्निंग पाथ}}
एआई एजेंट मूलभूत बातें
{hours} घंटा
GLM 5.1 आज चलाए जा सकने वाले सबसे मजबूत ओपन मॉडलों में से एक है, और Artificial Analysis फिलहाल इसे अपनी Intelligence Index पर लीडिंग ओपन-वेट्स मॉडल के रूप में बताता है। Z.ai भी इसे कोडिंग, रीजनिंग और एजेंटिक वर्कफ़्लो के लिए एक फ्लैगशिप रिलीज़ के रूप में प्रस्तुत करता है।
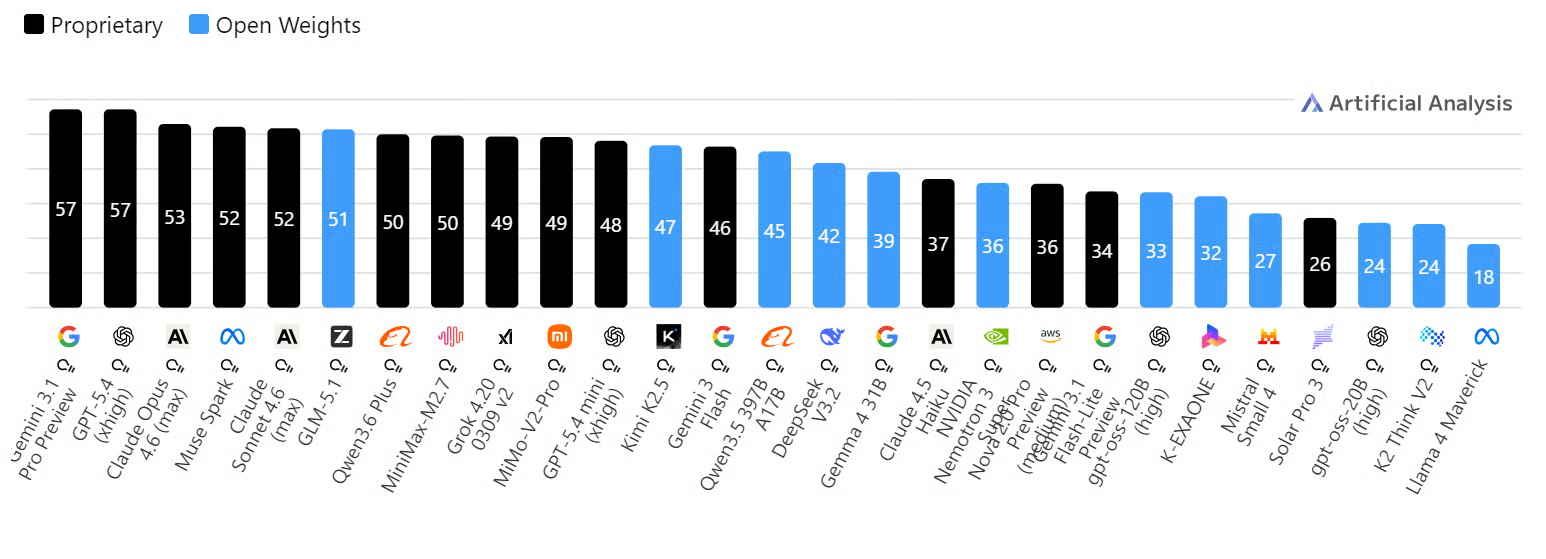
स्रोत: AI Model & API Providers Analysis | Artificial Analysis
इसे लोकली चलाने से आपको पूरे वर्कफ़्लो पर अधिक नियंत्रण मिलता है। आपका डेटा आपके अपने वातावरण में रहता है, और आप प्रॉम्प्ट्स का परीक्षण कर सकते हैं, इंटीग्रेशन बना सकते हैं, और अधिक गोपनीयता के साथ तथा बाहरी डेटा एक्सपोज़र की कम चिंता के साथ इसे कोडिंग प्रोजेक्ट्स में इस्तेमाल कर सकते हैं।
इस ट्यूटोरियल में, आप एक H100 RunPod वातावरण सेटअप करेंगे, GLM 5.1 को लोकली चलाएँगे, API कॉल्स से इसे टेस्ट करेंगे, OpenAI Python SDK से जोड़ेंगे, WebUI के ज़रिए एक्सेस करेंगे, और Claude Code के साथ इंटीग्रेट करेंगे।
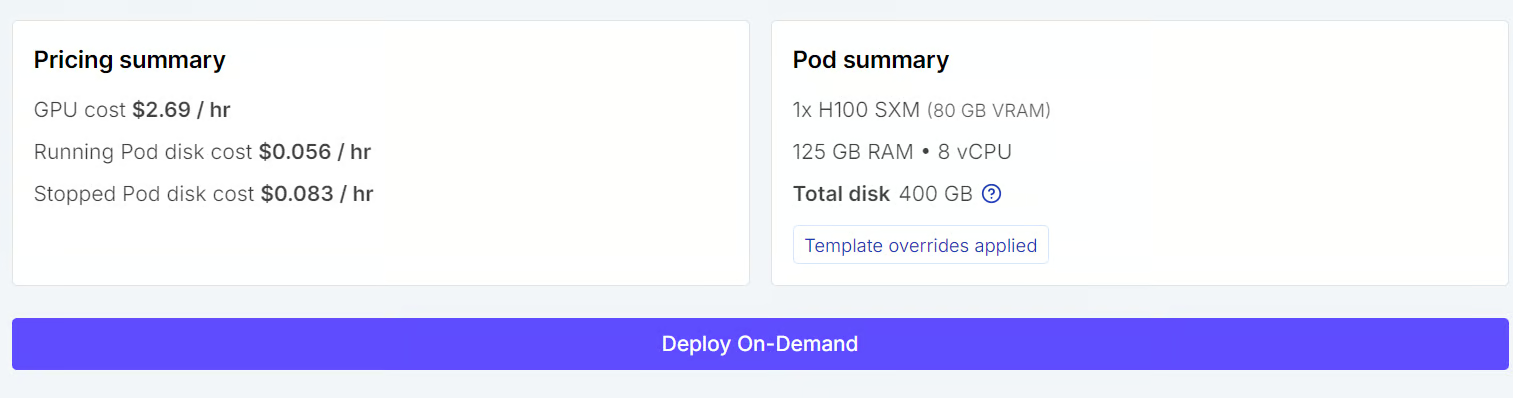
RunPod में Pods टैब पर जाएँ और एक H100 SXM मशीन चुनें। टेम्पलेट के लिए नवीनतम PyTorch विकल्प चुनें, ताकि आपके पास मॉडल वर्कलोड चलाने के लिए रेडी-टू-यूज़ वातावरण हो।
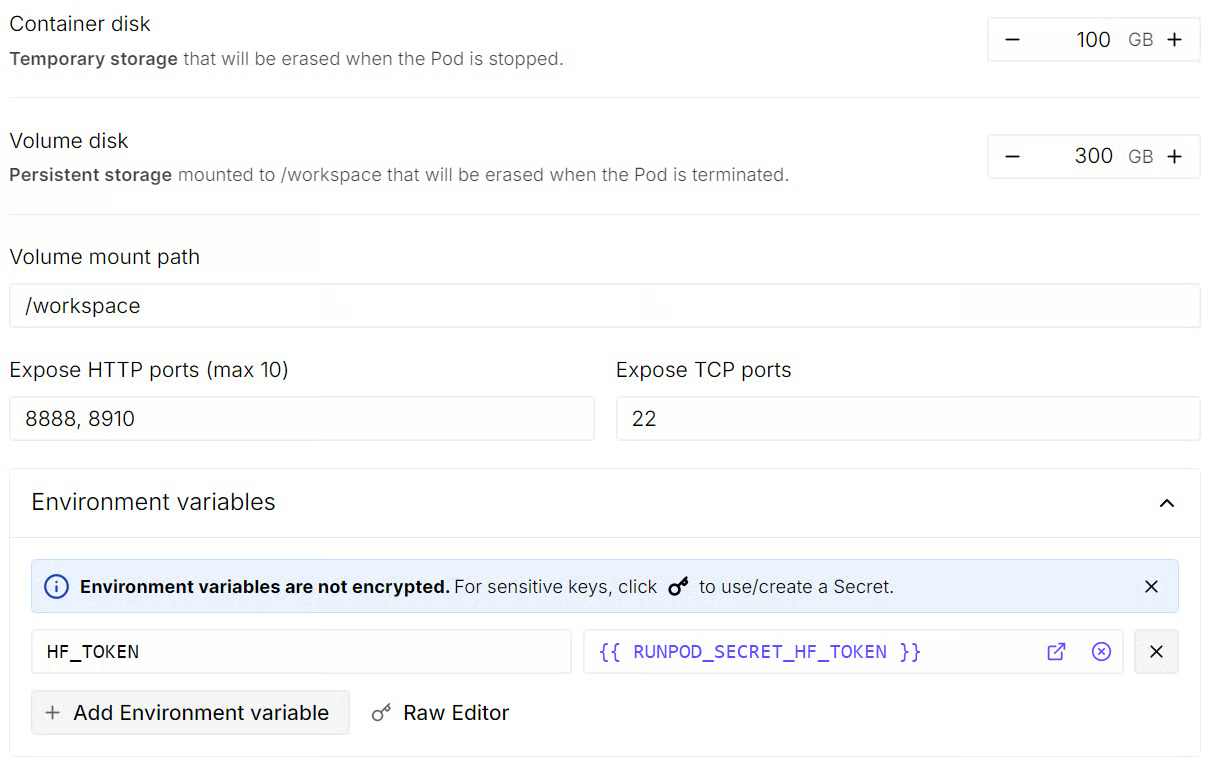
डिप्लॉय करने से पहले, pod स्टोरेज सेटिंग्स अपडेट करें। container disk को 100GB और volume disk को 300GB पर सेट करें, ताकि मॉडल फ़ाइलों, डिपेंडेंसीज़ और cached डाउनलोड्स के लिए पर्याप्त जगह हो।
हम सारा काम माउंटेड /workspace डायरेक्टरी के अंदर करेंगे ताकि सब कुछ एक ही जगह रहे। आपको port 8910 भी एक्सपोज़ करना चाहिए, जिसे हम लोकल मॉडल सर्वर और llama.cpp के WebUI के लिए उपयोग करेंगे।
अब, अपने Hugging Face टोकन को HF_TOKEN नाम के environment variable के रूप में जोड़ें।
यह सेट हो जाने पर, pod summary की समीक्षा करें और Deploy On-Demand पर क्लिक करें। Pod शुरू होने के बाद, उससे जुड़ी JupyterLab इंस्टेंस खोलें।
JupyterLab के भीतर, नया टर्मिनल लॉन्च करें और आवश्यक सिस्टम पैकेज इंस्टॉल करने के लिए निम्नलिखित कमांड चलाएँ:
apt-get update
apt-get install -y pciutils build-essential cmake curl git tmux libcurl4-openssl-dev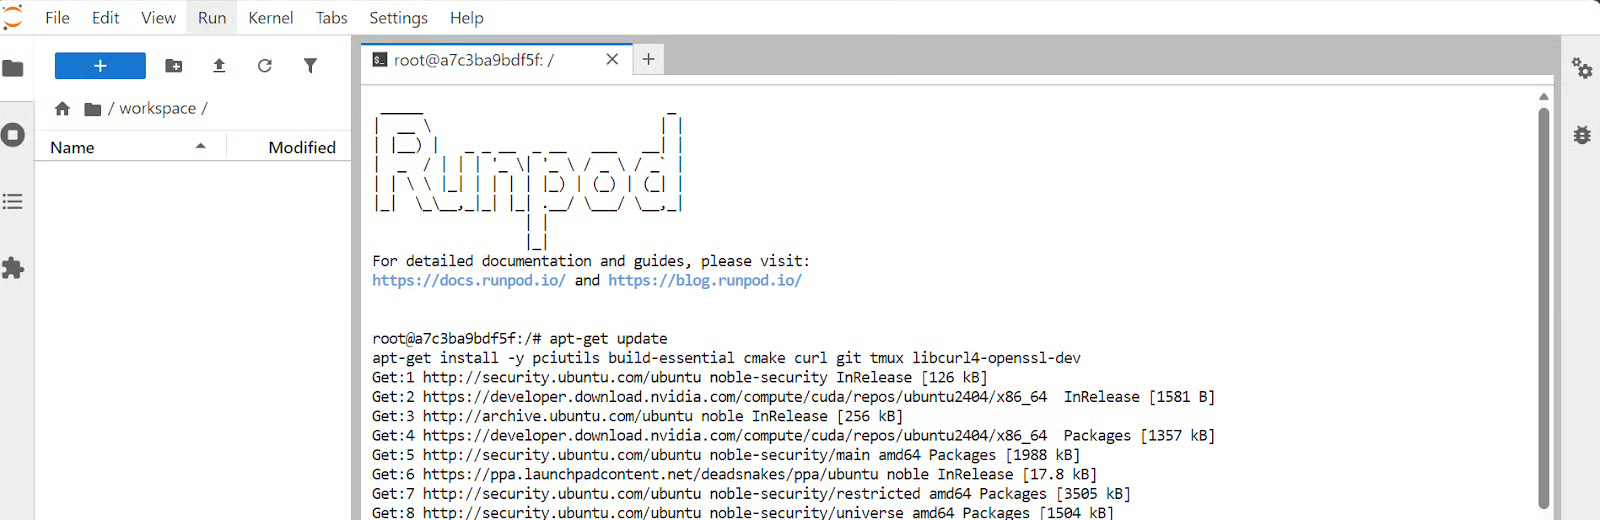
अब जब pod तैयार है, अगला कदम llama.cpp को CUDA सपोर्ट के साथ बनाना है ताकि यह लोकल इन्फ़ेरेंस के लिए H100 GPU का उपयोग कर सके।
पहले, GitHub से llama.cpp रेपो क्लोन करें:
git clone https://github.com/ggml-org/llama.cppइसके बाद, बिल्ड कॉन्फ़िगर करें और जनरेट हुई बिल्ड फ़ाइलों को अलग build फ़ोल्डर में रखें:
cmake llama.cpp -B llama.cpp/build \
-DBUILD_SHARED_LIBS=OFF \
-DGGML_CUDA=ON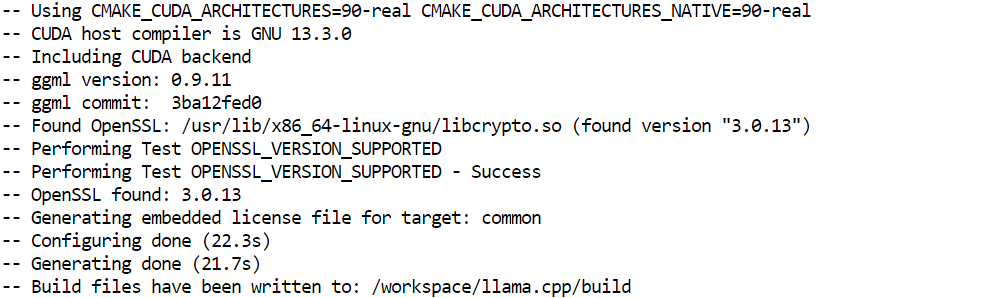
इसके बाद, आवश्यक मुख्य बाइनरीज़ को ऑप्टिमाइज़्ड Release मोड में कंपाइल करें:
cmake --build llama.cpp/build --config Release -j --clean-first \
--target llama-cli llama-mtmd-cli llama-server llama-gguf-split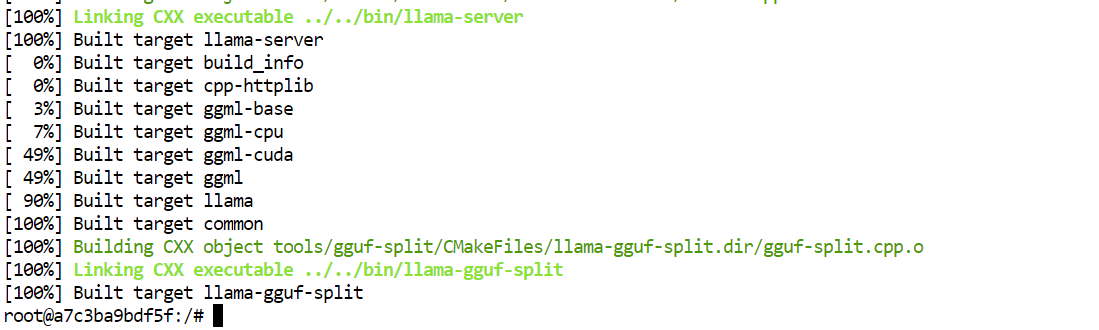
अंत में, कंपाइल की गई बाइनरीज़ को मुख्य llama.cpp फ़ोल्डर में कॉपी करें ताकि बाद में इन्हें चलाना आसान रहे:
cp llama.cpp/build/bin/llama-* llama.cppइस चरण के अंत तक, आपके पास मुख्य llama.cpp टूल्स तैयार होंगे, जिनमें llama-server भी शामिल है, जिसका उपयोग हम आगे GLM 5.1 को लोकली चलाने के लिए करेंगे।
मॉडल डाउनलोड करने से पहले, यह समझना उपयोगी है कि हम इस सेटअप के लिए 2-बिट संस्करण का उपयोग क्यों कर रहे हैं।
पूरा GLM 5.1 मॉडल में 744B पैरामीटर्स हैं, जिनमें से 40B सक्रिय पैरामीटर्स हैं, 200K कॉन्टेक्स्ट विंडो है, और लगभग 1.65TB डिस्क स्पेस की आवश्यकता होती है। यह एक व्यावहारिक लोकल सेटअप के लिए बहुत बड़ा है।
Unsloth Dynamic 2-bit GGUF संस्करण आकार को लगभग 220–236GB तक कम कर देता है, जिससे स्टोरेज आवश्यकता लगभग 80% तक घट जाती है, जबकि बेहतर प्रदर्शन के लिए महत्वपूर्ण लेयर्स उच्च प्रिसिशन में बनी रहती हैं।
यही कारण है कि हमारे हार्डवेयर के लिए 2-बिट मॉडल सही विकल्प है। 80GB VRAM और 125GB RAM के साथ, यह क्वांटाइज़्ड संस्करण अभी भी संसाधन-सघन है, लेकिन लोकली चलाने के लिए कहीं अधिक व्यावहारिक है और कोडिंग व एजेंटिक वर्कफ़्लो के लिए मजबूत प्रदर्शन देता है।
अब, आइए मॉडल फ़ाइलें कुशलता से डाउनलोड करने के लिए आवश्यक टूल्स इंस्टॉल करें।
पहले, hf_xet सपोर्ट के साथ Hugging Face Hub पैकेज तथा hf-xet हेल्पर इंस्टॉल करें:
pip -q install -U "huggingface_hub[hf_xet]" hf-xetइसके बाद, बड़े मॉडल डाउनलोड तेज़ करने के लिए hf_transfer इंस्टॉल करें:
pip -q install -U hf_transferफिर, तेज़ डाउनलोड के लिए हाई-परफ़ॉर्मेंस ट्रांसफ़र सक्षम करें:
export HF_XET_HIGH_PERFORMANCE=1अंत में, GLM 5.1 मॉडल फ़ाइलें एक लोकल फ़ोल्डर में डाउनलोड करें:
hf download unsloth/GLM-5.1-GGUF \
--local-dir models/GLM-5.1-GGUF \
--include "*UD-IQ2_M*"
यह छोटा संस्करण भी अभी काफी बड़ा डाउनलोड है। मेरे सेटअप में, 2-बिट मॉडल को लगभग 17 मिनट लगे, इसलिए थोड़ी देर लगे तो चिंतित न हों।

अब लोकल सर्वर लॉन्च करने और मॉडल को मेमोरी में लोड करने का समय है।
निम्नलिखित कमांड चलाएँ:
./llama.cpp/llama-server \
  --model ./models/GLM-5.1-GGUF/UD-IQ2_M/GLM-5.1-UD-IQ2_M-00001-of-00006.gguf \
  --alias "GLM-5.1" \
  --host 0.0.0.0 \
  --port 8910 \
  --jinja \
  --fit on \
  --threads 16 \
  --threads-batch 16 \
  --ctx-size 32768 \
  --batch-size 2048 \
  --ubatch-size 512 \
  --flash-attn on \
  --temp 0.7 \
  --top-p 0.95 \
  --cont-batching \
  --metrics \
  --perf
यहाँ ध्यान देने वाला मुख्य आर्ग्युमेंट --fit on है। यह सर्वर को बताता है कि मॉडल का अधिकतम भाग स्वतः GPU पर रखा जाए और शेष को सिस्टम RAM में ऑफ़लोड किया जाए। हमारे सेटअप में यह विशेष रूप से उपयोगी है, क्योंकि यह हमें उपलब्ध 80GB VRAM और 125GB RAM में बहुत बड़े मॉडल को लेयर्स की मैन्युअल प्लेसमेंट किए बिना चलाने में मदद करता है।
अन्य आर्ग्युमेंट्स मुख्यतः सर्वर का नाम, पोर्ट, परफ़ॉर्मेंस सेटिंग्स, बैचिंग और इन्फ़ेरेंस के लिए कॉन्टेक्स्ट लंबाई संभालते हैं।
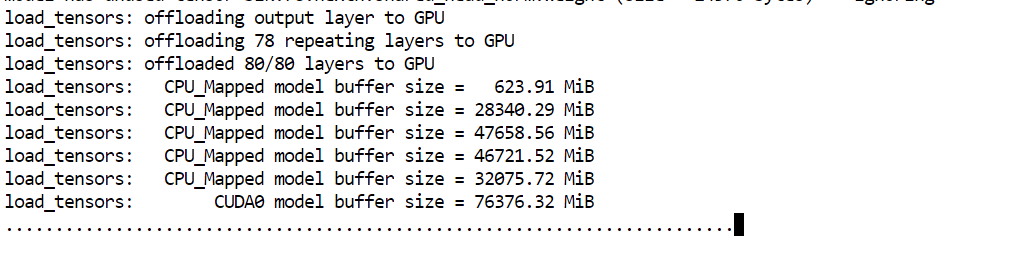
मॉडल के लोड होने के बाद, आपको एक संदेश दिखेगा कि सर्वर यहाँ सुन रहा है: http://0.0.0.0:8910।
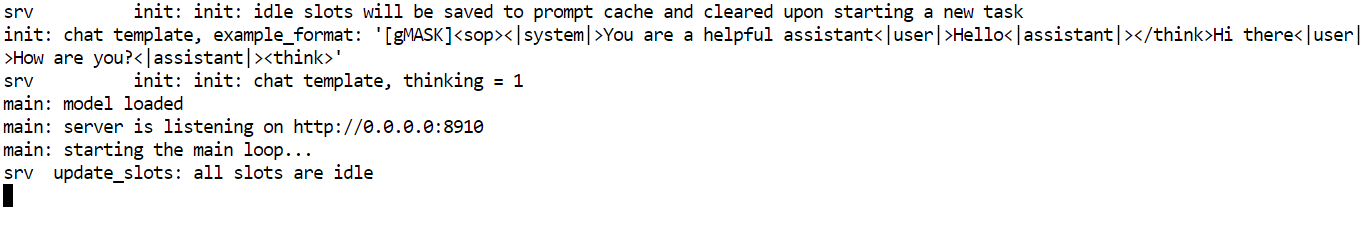
इस बिंदु पर, GLM 5.1 लोकली चल रहा है और अगले चरण में परीक्षण के लिए तैयार है।
सर्वर चल रहा है, तो अगला कदम यह सुनिश्चित करना है कि मॉडल अपने लोकल API के माध्यम से सही ढंग से रिस्पॉन्ड कर रहा है।
JupyterLab के अंदर एक नया टर्मिनल खोलें ताकि सर्वर मूल टर्मिनल में चलता रहे। फिर curl से एक साधारण टेस्ट अनुरोध भेजें:
curl http://127.0.0.1:8910/v1/messages \
-H "Content-Type: application/json" \
-H "x-api-key: local-test" \
-d '{
"model": "GLM-5.1",
"max_tokens": 300,
"messages": [
{"role": "user", "content": "Write a Python hello world function."}
]
}'
यह अनुरोध आपके लोकली चल रहे GLM 5.1 सर्वर को एक प्रॉम्प्ट भेजता है और एक छोटा रिस्पॉन्स जनरेट करने के लिए कहता है। यहाँ ध्यान देने वाली मुख्य बातें हैं लोकल सर्वर URL, मॉडल का नाम, और रिक्वेस्ट बॉडी में उपयोग किया गया messages फ़ॉर्मेट।
यदि सब कुछ सही काम कर रहा है, तो टर्मिनल मॉडल के आउटपुट वाला JSON रिस्पॉन्स लौटाएगा।
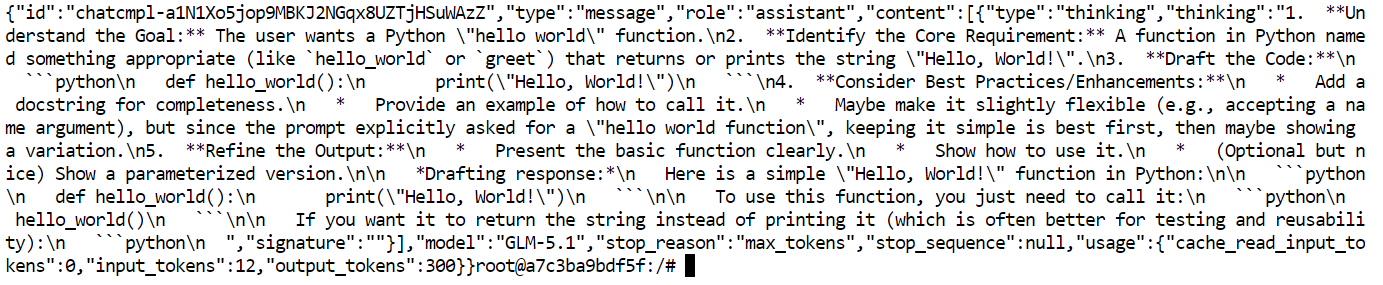
अब जब लोकल API काम कर रहा है, अगला कदम इसे OpenAI Python SDK से जोड़ना है। यह उपयोगी है क्योंकि कई मौजूदा ऐप्स और स्क्रिप्ट्स पहले से ही OpenAI क्लाइंट का उपयोग करते हैं, इसलिए उसे आपके लोकल GLM 5.1 सर्वर की ओर इंगित करना इंटीग्रेशन को बहुत आसान बना देता है।
पहले, pip अपग्रेड करें और OpenAI पैकेज इंस्टॉल करें:
python -m pip install --upgrade pip
pip install openai
इसके बाद, एक छोटा Python स्क्रिप्ट चलाएँ जो SDK को आपके लोकल सर्वर से जोड़ता है:
python - <<'PY'
from openai import OpenAI

client = OpenAI(
    api_key="local-key",
    base_url="http://127.0.0.1:8910/v1",
)

resp = client.completions.create(
    model="GLM-5.1",
    prompt="Answer briefly and in plain text only.\n\nQuestion: What is the capital city of Australia?\nAnswer:",
    temperature=0.2,
    max_tokens=12,
)

print(resp.choices[0].text.strip())
PY
यहाँ मुख्य बात यह है कि हम OpenAI क्लाउड API को कॉल नहीं कर रहे हैं। इसके बजाय, हम वही SDK उपयोग कर रहे हैं लेकिन base_url बदल रहे हैं ताकि यह लोकल GLM 5.1 सर्वर की ओर इशारा करे, जो पोर्ट 8910 पर चल रहा है।
यदि सब कुछ सही से सेट है, तो आउटपुट यह होना चाहिए:
Canberraनवीनतम llama.cpp सर्वर में बिल्ट-इन WebUI भी शामिल है, जिसका मतलब है कि आप केवल टर्मिनल या API कॉल्स की बजाय एक सरल चैट इंटरफ़ेस के माध्यम से अपने लोकल GLM 5.1 मॉडल के साथ इंटरैक्ट कर सकते हैं।
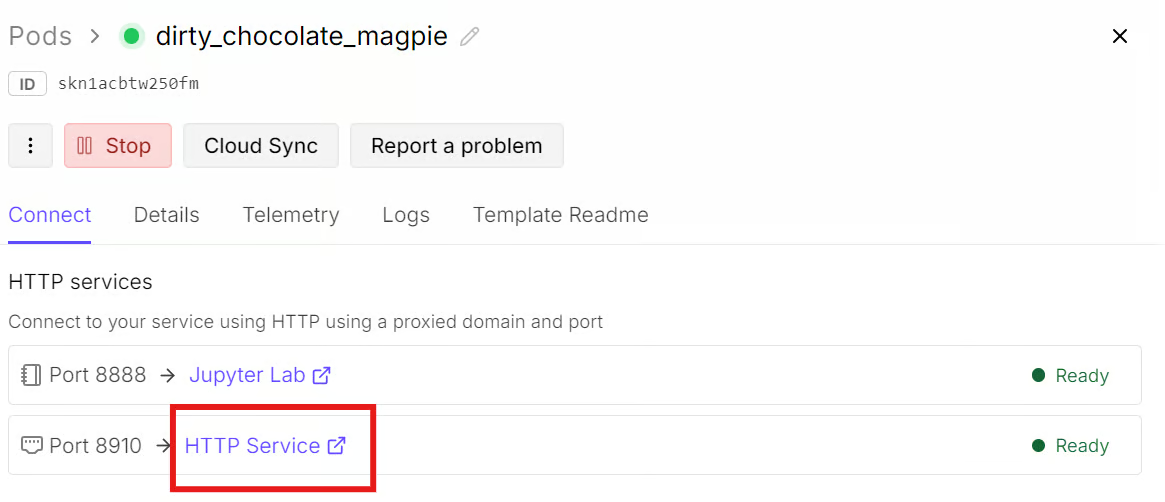
इसे खोलने के लिए, अपने RunPod डैशबोर्ड पर जाएँ और अपने pod के लिए Connect टैब खोलें। चूँकि पोर्ट 8910 पहले से एक्सपोज़ है, उस पोर्ट के लिए HTTP Service लिंक पर क्लिक करें। यह llama.cpp WebUI को नए ब्राउज़र टैब में खोलेगा।
पेज लोड होते ही, आप सीधे मॉडल से चैट करना शुरू कर सकते हैं। अपना पहला प्रॉम्प्ट टाइप करें, और कुछ सेकंड में रिस्पॉन्स दिखना चाहिए। मेरे सेटअप में, मॉडल लगभग 8 टोकन प्रति सेकंड की दर से जनरेट कर रहा था, जो इस आकार के मॉडल के लिए अच्छा स्पीड है।
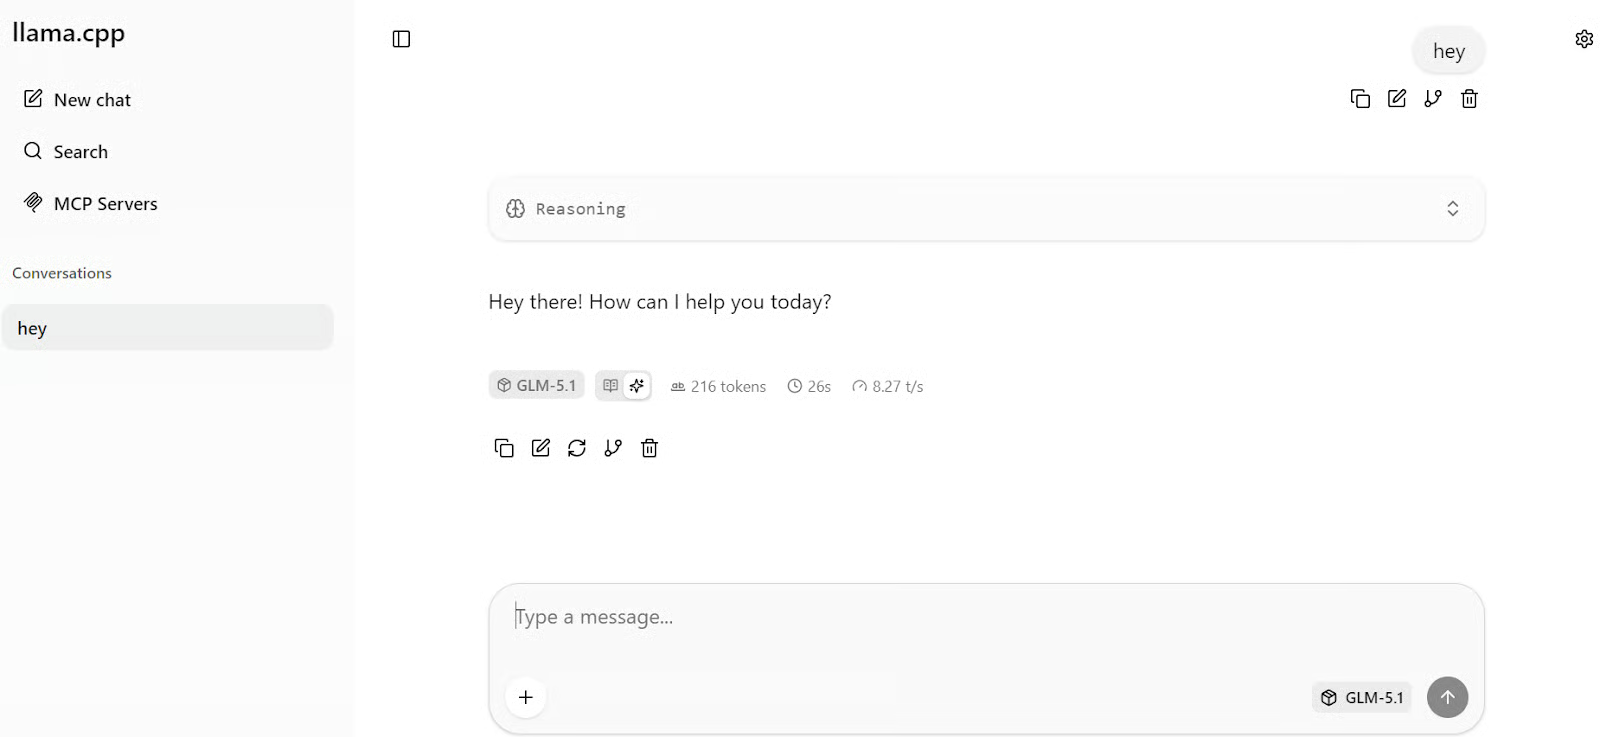
एक त्वरित परीक्षण के लिए, इसे एक सरल Hello World ऐप बनाने के लिए कहें। इसने कई लोकप्रिय प्रोग्रामिंग भाषाओं में काम करने वाले उदाहरण जनरेट किए।
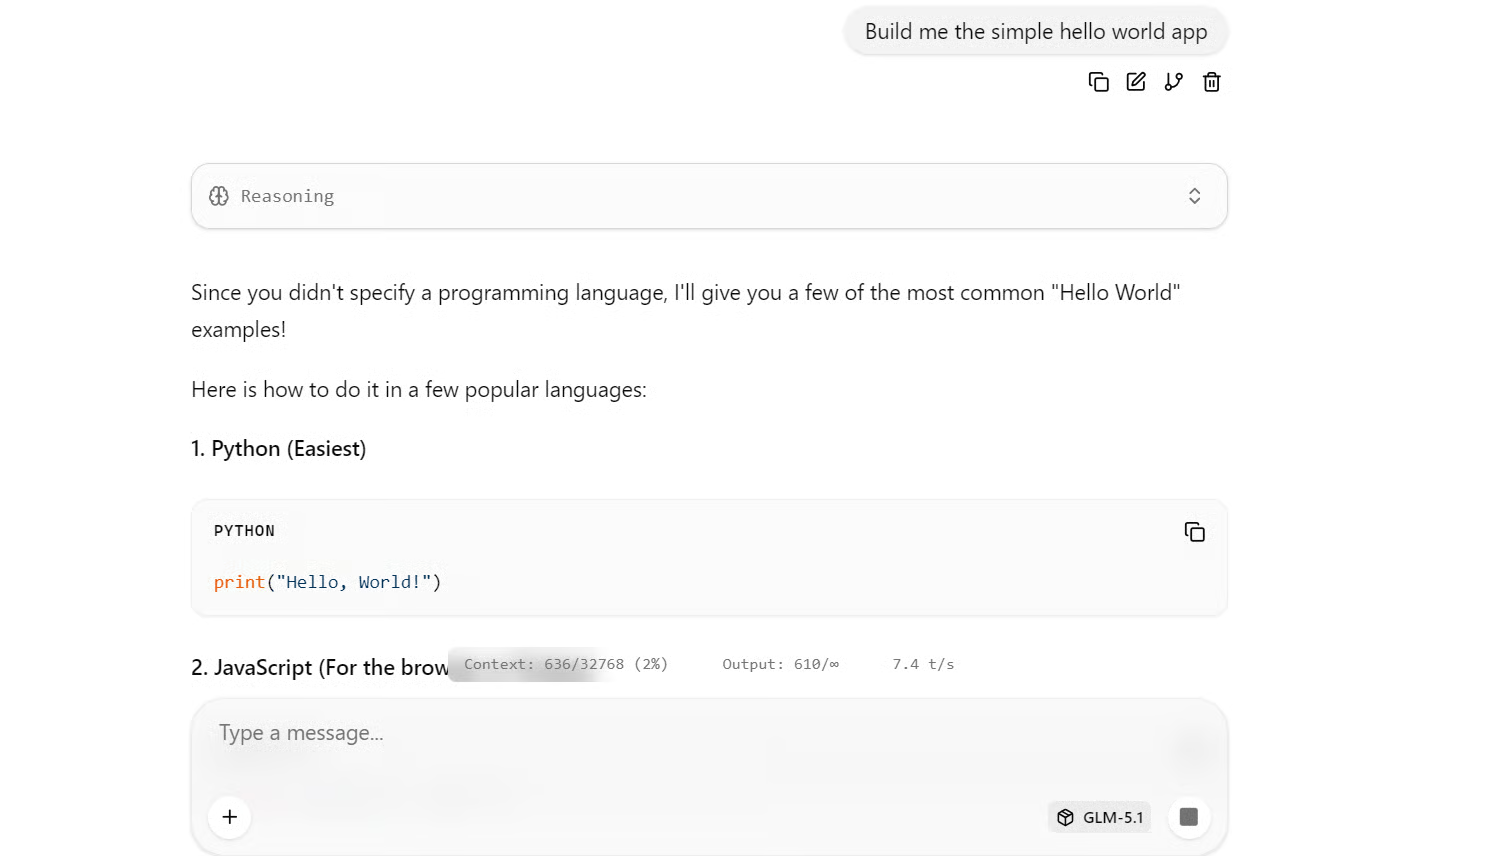
अब जब GLM 5.1 लोकली चल रहा है, अगला कदम इसे Claude Code से जोड़ना है। यह उपयोगी परीक्षण है क्योंकि GLM 5.1 को एक मजबूत कोडिंग मॉडल के रूप में पेश किया जाता है, इसलिए इसे कोडिंग एजेंट वर्कफ़्लो में इस्तेमाल करने से असल डेवलपमेंट टास्क्स पर इसका प्रदर्शन बेहतर समझ में आता है।
शुरू करें Claude Code इंस्टॉल करके:
curl -fsSL https://claude.ai/install.sh | bash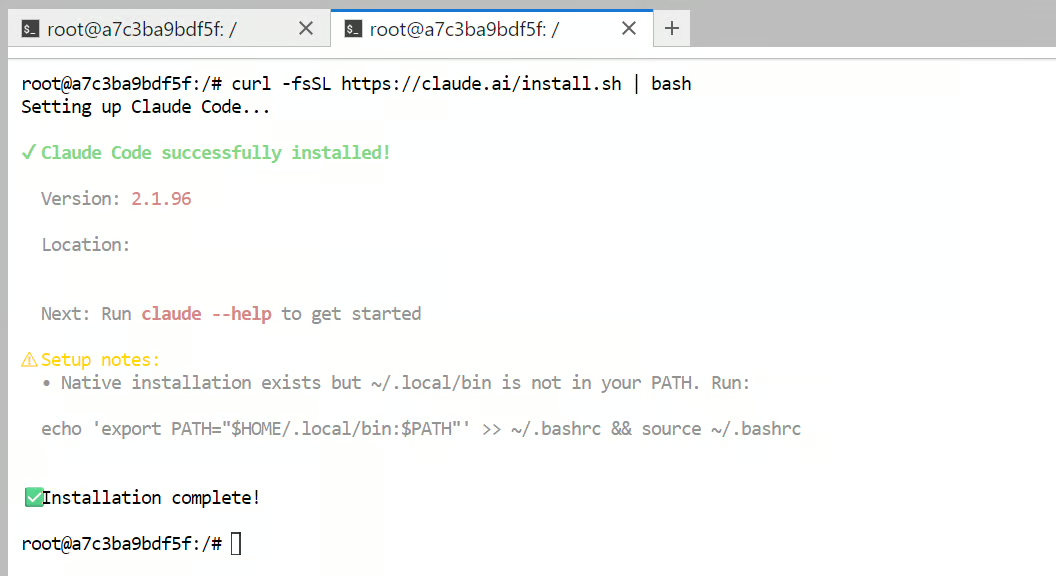
इसके बाद, Claude Code को अपने शेल PATH में जोड़ें ताकि claude कमांड टर्मिनल से काम करे:
echo 'export PATH="$HOME/.local/bin:$PATH"' >> ~/.bashrc && source ~/.bashrcफिर, Claude Code को कॉन्फ़िगर करें ताकि यह होस्टेड Anthropic API की बजाय आपके लोकल GLM 5.1 सर्वर की ओर पॉइंट करे:
cat >> ~/.bashrc <<'EOF'
export ANTHROPIC_BASE_URL="http://127.0.0.1:8910"
export ANTHROPIC_AUTH_TOKEN="local-dev-token"
export ANTHROPIC_MODEL="GLM-5.1"
export ANTHROPIC_DEFAULT_SONNET_MODEL="GLM-5.1"
export API_TIMEOUT_MS=1200000
EOF
इसके बाद, अपनी शेल कॉन्फ़िगरेशन को रीलोड करें ताकि वे environment variables प्रभाव में आ जाएँ:
source ~/.bashrcअब, एक टेस्ट फ़ोल्डर बनाएं और उसके अंदर Claude Code लॉन्च करें:
mkdir -p test-claude-local
cd test-claude-local
claude
Claude Code पहली बार शुरू होने पर, आपसे कुछ सेटअप चरण पूरे करने को कह सकता है, जैसे थीम चुनना या वर्किंग डायरेक्टरी पर भरोसा करना। यह हो जाने पर, आप इसे टास्क देने शुरू कर सकते हैं।
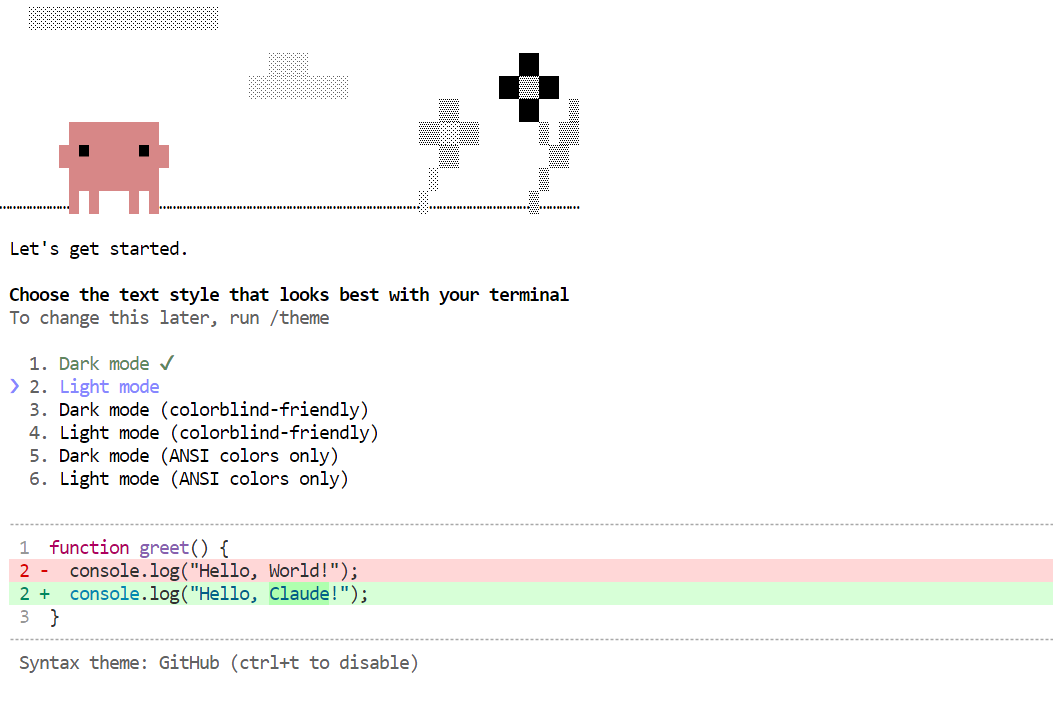
एक साधारण प्रथम परीक्षण के लिए, यह प्रॉम्प्ट आज़माएँ:
Build the simple Hello World app in Python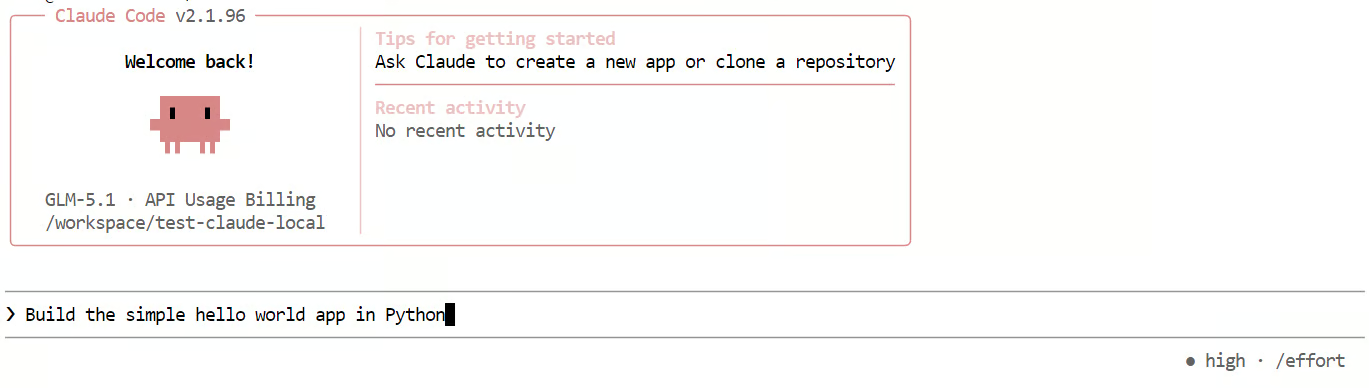
इससे आप जाँच सकते हैं कि Claude Code सफलतापूर्वक आपके लोकल GLM 5.1 सर्वर को अनुरोध भेज रहा है और कोड जनरेशन के लिए उसका उपयोग कर रहा है।
मेरे अनुभव में, यह सेटअप काम करता है, लेकिन यह पहले के परीक्षणों की तुलना में स्पष्ट रूप से धीमा था।
लंबे कॉन्टेक्स्ट और कोडिंग-शैली के प्रॉम्प्ट्स के साथ, जनरेशन स्पीड लगभग 2 टोकन प्रति सेकंड तक गिर गई, और मॉडल अक्सर सरल उत्तर देने से पहले अधिक समय तक रीजनिंग में लगा रहता था।
यह GLM 5.1 के साथ इस वर्कफ़्लो में देखे गए मुख्य समझौते में से एक है: यह सक्षम है, लेकिन हल्के-फुल्के कोडिंग टास्क्स के लिए आपकी अपेक्षा से धीमा और अधिक verbose हो सकता है।
यह अनुभाग कुछ आम समस्याओं और उनके त्वरित समाधानों को कवर करता है जिनका सामना आप GLM 5.1 को लोकली चलाते समय कर सकते हैं।
आमतौर पर इसका मतलब है कि मॉडल उपलब्ध GPU और सिस्टम मेमोरी के लिए बहुत बड़ा है, इसलिए छोटा क्वांट आज़माएँ या कॉन्टेक्स्ट साइज कम करें। llama.cpp --fit on भी सपोर्ट करता है, जो उपलब्ध मेमोरी में मॉडल को स्वतः फिट करने में मदद करता है।
सुनिश्चित करें कि आप RunPod से सही एक्सपोज़्ड पोर्ट खोल रहे हैं, न कि JupyterLab URL। llama.cpp सर्वर में अपना बिल्ट-इन WebUI होता है, इसलिए सर्वर पोर्ट मायने रखता है, और URL को एक्सपोज़्ड HTTP सर्विस पर 0.0.0.0:8910 की ओर इशारा करना चाहिए।
यह आम तौर पर base URL या endpoint मिसमैच होता है। llama.cpp OpenAI-कम्पैटिबल रूट्स और Anthropic Messages-कम्पैटिबल रूट्स सपोर्ट करता है, इसलिए जाँचें कि आपका टूल सही पाथ, जैसे /v1 या /v1/messages, की ओर पॉइंट कर रहा है।
ऐसा इसलिए हो सकता है क्योंकि परफ़ॉर्मेंस क्लाइंट और बैकएंड मॉडल व्यवहार दोनों पर निर्भर करता है। Claude Code सेटिंग्स और environment variables के माध्यम से कॉन्फ़िगरेशन सपोर्ट करता है, लेकिन धीमे रिस्पॉन्स अक्सर मॉडल के अधिक समय तक रीजनिंग या जनरेशन करने के कारण होते हैं।
लंबी कॉन्टेक्स्ट विंडो और बड़े जनरेशन मेमोरी प्रेशर और रिस्पॉन्स टाइम बढ़ाते हैं। कॉन्टेक्स्ट साइज, प्रॉम्प्ट लंबाई, या जनरेशन सेटिंग्स कम करने से लोकल सेटअप में स्पीड बेहतर हो सकती है।
कुल मिलाकर, GLM 5.1 को लोकली सेटअप करना काफ़ी सीधा था। मॉडल डाउनलोड करना, सर्वर चलाना और बेसिक उपयोग के लिए इसका परीक्षण करना ज्यादा मेहनत वाला नहीं लगा। सरल लोकल प्रयोगों के लिए प्रक्रिया काफ़ी संभालने योग्य लगती है।
मुख्य चुनौती तब शुरू होती है जब आप इसे एजेंटिक कोडिंग वर्कफ़्लो के लिए उपयोग करना चाहते हैं। इसके लिए अधिक RAM और VRAM की ज़रूरत होती है, और जैसे-जैसे कॉन्टेक्स्ट विंडो भरती है, टोकन जनरेशन स्पष्ट रूप से धीमा हो सकता है। हालाँकि मॉडल शुरुआत में तेज़ लग सकता है, थिंकिंग मोड बहुत देर जोड़ देता है, इसलिए लोकल उपयोग के लिए, यदि स्पीड महत्वपूर्ण है, तो थिंकिंग मोड को बंद रखना अक्सर समझदारी है।
परफ़ॉर्मेंस से आगे, व्यावहारिक पक्ष भी है। लोकल मॉडल चलाने का मतलब है कि आपको मॉडल सर्वर मैनेज करना, GPU सेटअप संभालना, और इन्फ्रास्ट्रक्चर समस्याओं से स्वयं निपटना होगा। जब RunPod या Vast.ai जैसे GPU रेंटल प्लेटफ़ॉर्म पर उपलब्धता सीमित हो जाती है—जो बढ़ती मांग के कारण अधिक सामान्य हो गया है—तो यह और कठिन हो जाता है।
इसीलिए, कई मामलों में, एक मैनेज्ड API विकल्प बेहतर साबित हो सकता है। आप कुछ प्राइवेसी और नियंत्रण छोड़ सकते हैं, लेकिन आपको बेहतर स्पीड, कम मेंटेनेंस और बड़े या अधिक जटिल कोडिंग टास्क्स के लिए कहीं अधिक स्मूद अनुभव मिलता है। यदि लागत केवल प्रति माह कुछ डॉलर है, तो सब कुछ स्वयं मैनेज करने की तुलना में यह सार्थक सौदा हो सकता है।
तो, यदि आपका लक्ष्य प्रयोग करना, सीखना, या हल्के लोकल टास्क्स के लिए GLM 5.1 चलाना है, तो इसे लोकली चलाना अच्छा विकल्प है। लेकिन यदि आपका लक्ष्य बड़े पैमाने पर भरोसेमंद एजेंटिक कोडिंग है, तो मैनेज्ड सर्विस अक्सर अधिक व्यावहारिक राह होती है। विस्तृत तुलना के लिए, हमारा GLM-5 बनाम GPT-5.3-Codex गाइड देखें।
एजेंटिक AI कोर्स
{count, plural, one {लर्निंग पाथ} other {लर्निंग पाथ}}
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}