
कोर्स
Python में Time Series Analysis
4 घंटा
70.9K
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखें4 जनवरी के Facebook Live कोड-अलॉन्ग सत्र में, हमने 'diet', 'gym' और 'finance' कीवर्ड्स के Google Trends डेटा को देखा कि समय के साथ ये कैसे बदलते हैं। हमने अपने आप से पूछा कि क्या जनवरी में, जब हम सब नई शुरुआत करने की सोचते हैं, इन शब्दों की खोजें ज्यादा हो सकती हैं?
इस ट्यूटोरियल में, आप सत्र के दौरान तैयार किए गए कोड को कदम-दर-कदम देखेंगे। आपको ज्यादा गणित नहीं करना होगा। इस ट्यूटोरियल का फोकस पूरी तरह से संबंधित डेटासेट की दृश्यात्मक खोज पर होगा।
pandas पर और जानने के लिए, DataCamp का Data Manipulation with Python ट्रैक देखें। pandas के साथ टाइम सीरीज़ पर और जानने के लिए, Manipulating Time Series Data in Python कोर्स देखें।
तो सवाल वही है: क्या जनवरी में, जब हम सब नई शुरुआत करना चाहते हैं, इन शब्दों की खोजें ज्यादा हो सकती हैं?
आइए यहाँ जाकर डेटा देखते हैं। नोट करें कि यह ट्यूटोरियल FiveThirtyEight के इस लेख से प्रेरित है।
आप डेटा .csv के रूप में डाउनलोड भी कर सकते हैं, फ़ाइल में सेव करें और अपनी Python एनवायरनमेंट में इंपोर्ट करके खुद विश्लेषण करें। आप अभी यही करेंगे। चलिए शुरू करते हैं!
शुरू करने के लिए, आप कुछ पैकेज इंपोर्ट करेंगे: इस मामले में, आप numpy, pandas, matplotlib और seaborn का उपयोग करेंगे।
इसके अलावा, अगर आप इमेजेज़ को Jupyter Notebook में प्लॉट करना चाहते हैं, तो आप IPython मैजिक %matplotlib inline जोड़ सकते हैं। वैकल्पिक रूप से, आप sns.set() के साथ Seaborn के डिफ़ॉल्ट्स भी सेट कर सकते हैं:
# Import packages
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
%matplotlib inline
sns.set()
.read_csv() से डाउनलोड किया गया डेटा इंपोर्ट करें और .head() के साथ शुरुआती कुछ पंक्तियाँ देखें।
नोट करें कि आप फ़ाइल की शुरुआत में पहली पंक्ति को स्किप करने के लिए skiprows आर्गुमेंट जोड़ते हैं।
 df = pd.read_csv('data/multiTimeline.csv', skiprows=1)
df.head()| Month | diet: (Worldwide) | gym: (Worldwide) | finance: (Worldwide) | |
|---|---|---|---|---|
| 0 | 2004-01 | 100 | 31 | 48 |
| 1 | 2004-02 | 75 | 26 | 49 |
| 2 | 2004-03 | 67 | 24 | 47 |
| 3 | 2004-04 | 70 | 22 | 48 |
| 4 | 2004-05 | 72 | 22 | 43 |
आप .info() मेथड का उपयोग करके अपने डेटा टाइप्स, पंक्तियों की संख्या और अधिक भी देख सकते हैं:
df.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 168 entries, 0 to 167
Data columns (total 4 columns):
Month                   168 non-null object
diet: (Worldwide)       168 non-null int64
gym: (Worldwide)        168 non-null int64
finance: (Worldwide)    168 non-null int64
dtypes: int64(3), object(1)
memory usage: 5.3+ KB
अब जब आपने Google Trends से डेटा इंपोर्ट कर लिया है और उस पर एक नज़र डाल ली है, तो डेटा को विश्लेषण के लिए तैयार करने के लिए उसे मनचाहे स्वरूप में ढालने का समय है।
सबसे पहले, आप अपने DataFrame df के कॉलम्स के नाम बदलना चाहेंगे ताकि उनमें स्पेसेज़ न हों। इसे करने के कई तरीके हैं, लेकिन अभी के लिए, आप df.columns को कॉलम्स के मनचाहे नामों की सूची असाइन करेंगे।
df.head() कॉल करके अपने रीअसाइनमेंट के परिणाम को दोबारा जांचें:
df.columns = ['month', 'diet', 'gym', 'finance']
df.head()
| month | diet | gym | finance | |
|---|---|---|---|---|
| 0 | 2004-01 | 100 | 31 | 48 |
| 1 | 2004-02 | 75 | 26 | 49 |
| 2 | 2004-03 | 67 | 24 | 47 |
| 3 | 2004-04 | 70 | 22 | 48 |
| 4 | 2004-05 | 72 | 22 | 43 |
अगला कदम, आप 'month' कॉलम को DateTime डेटा टाइप में बदलेंगे और उसे DataFrame का इंडेक्स बना देंगे।
नोट करें कि आप ऐसा इसलिए करते हैं क्योंकि आपने .info() मेथड के परिणाम में देखा कि 'Month' कॉलम का डेटा टाइप object था। यह जनरल डेटा टाइप स्ट्रिंग्स से लेकर इंटीजर्स तक सबको समेटता है। टाइम सीरीज़ डेटा देखते समय यह वांछित नहीं है। यही कारण है कि आप .to_datetime() का उपयोग करके अपने DataFrame के 'month' कॉलम को DateTime में कन्वर्ट करेंगे।
सावधानी रखें! जब आप DataFrame df का इंडेक्स सेट कर रहे हों, तो inplace आर्गुमेंट ज़रूर शामिल करें ताकि वास्तव में मूल इंडेक्स बदल जाए और 'month' कॉलम पर सेट हो जाए।
df.month = pd.to_datetime(df.month)
df.set_index('month', inplace=True)
df.head()
| diet | gym | finance | |
|---|---|---|---|
| month | |||
| 2004-01-01 | 100 | 31 | 48 |
| 2004-02-01 | 75 | 26 | 49 |
| 2004-03-01 | 67 | 24 | 47 |
| 2004-04-01 | 70 | 22 | 48 |
| 2004-05-01 | 72 | 22 | 43 |
अब अपने DataFrame की दृश्यात्मक खोज करने का समय है।
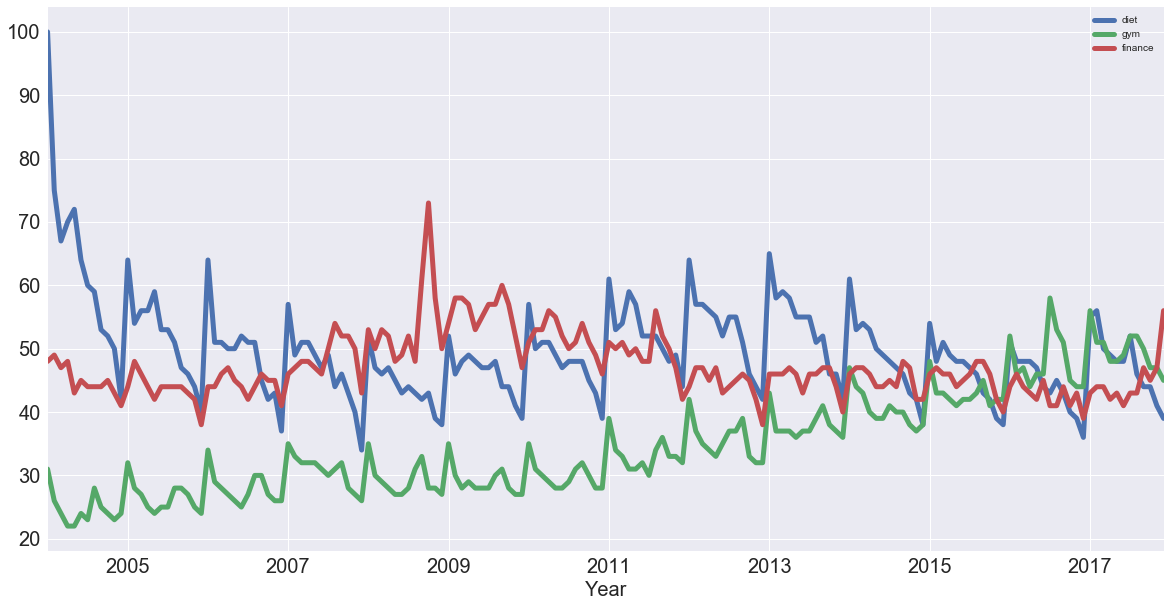
आप बिल्ट-इन pandas विज़ुअलाइज़ेशन मेथड .plot() का उपयोग करके अपने डेटा को एक ही फ़िगर पर 3 लाइन प्लॉट्स के रूप में प्लॉट कर सकते हैं (प्रत्येक कॉलम के लिए एक, यानी 'diet', 'gym', और 'finance')।
नोट करें कि आप इस मेथड को कुछ आर्गुमेंट्स भी दे सकते हैं, जैसे figsize, linewidth और fontsize ताकि क्रमशः फ़िगर का आकार, लाइन की चौड़ाई और प्लॉट का फ़ॉन्ट आकार सेट हो सके।
साथ ही, आप देखेंगे कि x-अक्ष पर डिफ़ॉल्ट लेबल के अनुसार महीने नहीं, बल्कि साल दिख रहे हैं। अपने प्लॉट को थोड़ा सटीक बनाने के लिए, आप x-अक्ष का लेबल 'Year' सेट करेंगे और फ़ॉन्ट साइज 20 रखेंगे।
टिप: अगर आप Matplotlib आउटपुट दबाना चाहते हैं, तो अपनी आखिरी कोड लाइन के अंत में सेमीकोलन ; जोड़ दें!
df.plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
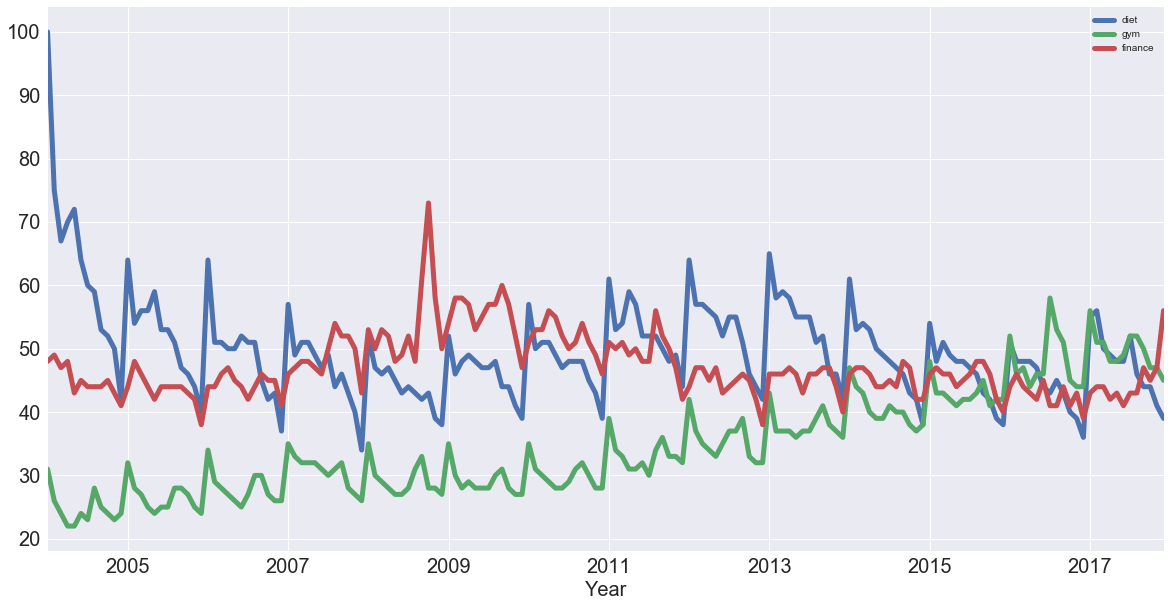
नोट करें कि यह डेटा सापेक्ष (relative) है। जैसा कि Google Trends पर लिखा है:
संख्याएँ दिए गए क्षेत्र और समय के लिए चार्ट पर सबसे ऊँचे बिंदु के सापेक्ष सर्च इंटरेस्ट को दर्शाती हैं। 100 का मान उस शब्द की चरम लोकप्रियता है। 50 का मतलब है कि शब्द आधा लोकप्रिय है। इसी तरह 0 का स्कोर दर्शाता है कि वह शब्द चरम के 1% से भी कम लोकप्रिय था।
यदि आप चाहें, तो आप 'diet' कॉलम को अकेले एक टाइम सीरीज़ के रूप में भी प्लॉट कर सकते हैं:
df[['diet']].plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
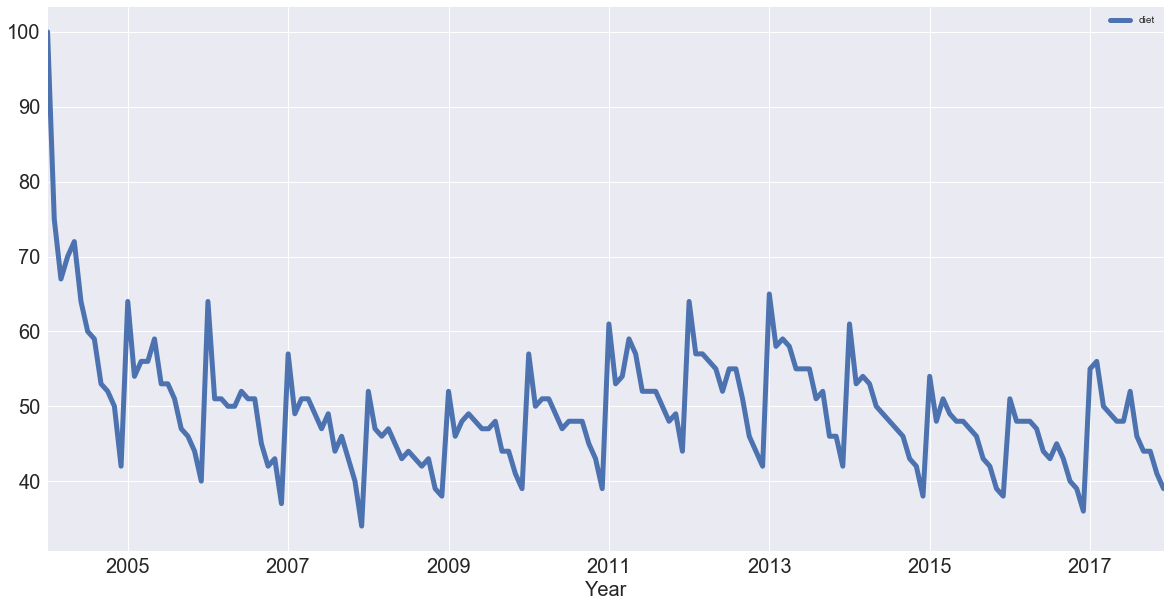
नोट: सबसे पहले ध्यान देने वाली बात यह है कि इसमें मौसमीपन (seasonality) है: हर जनवरी एक बड़ा उछाल आता है। साथ ही, एक ट्रेंड भी दिखता है: यह थोड़ा ऊपर जाता है, फिर नीचे, फिर ऊपर और फिर नीचे। यानी, इन टाइम सीरीज़ में ट्रेंड और मौसमी दोनों घटक दिखते हैं।
इसे ध्यान में रखते हुए, आप सीखेंगे कि अपनी टाइम सीरीज़ में ट्रेंड्स की पहचान कैसे करें!
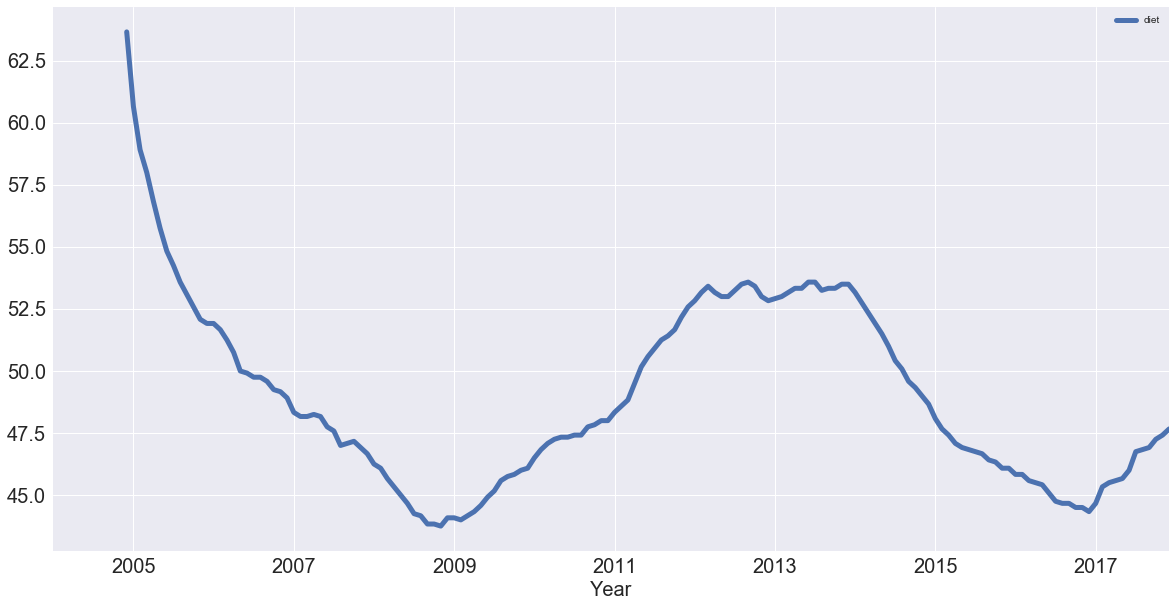
टाइम सीरीज़ में ट्रेंड्स की पहचान के कई तरीके हैं। एक लोकप्रिय तरीका है रोलिंग एवरेज लेना, जिसका मतलब है कि हर समय बिंदु के लिए आप उसके दोनों ओर के बिंदुओं का औसत लेते हैं। ध्यान दें कि बिंदुओं की संख्या विंडो साइज द्वारा तय होती है, जिसे आपको चुनना होता है।
औसत लेने से शोर और मौसमीपन स्मूद हो जाते हैं। आप अभी इसका एक उदाहरण देखेंगे। 'diet' की इस रोलिंग एवरेज को बिल्ट-इन pandas मेथड्स से देखें।
विंडो साइज तय करने की बात आए तो यहाँ, चूँकि आप वार्षिक मौसमीपन की बात कर रहे हैं, तो पहले बारह महीनों की विंडो साइज आज़माना समझदारी है।
diet = df[['diet']]
diet.rolling(12).mean().plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
नोट करें कि ऊपर दिए कोड खंड में आपने 'diet' कॉलम को DataFrame के रूप में निकालने के लिए दो सेट स्क्वेयर ब्रैकेट्स का उपयोग किया; अगर आप एक सेट, जैसे df['diet'], का उपयोग करते, तो एक pandas Series बनती।
उपरोक्त कोड खंड में, आपने मेथड चेनिंग भी की: आपने किसी ऑब्जेक्ट पर एक के बाद एक मेथड्स कॉल किए। मेथड चेनिंग काफ़ी लोकप्रिय है और pandas ऐसा पैकेज है जो इस शैली का भरपूर उपयोग करने देता है!
अब आपके पास वह ट्रेंड है जिसकी आपको तलाश थी! आपने पिछले प्लॉट की तुलना में ज्यादातर मौसमीपन हटा दिया है।
आप 'gym' की रोलिंग एवरेज को भी उसी विंडो साइज के साथ बिल्ट-इन pandas मेथड्स से प्लॉट कर सकते हैं जैसा आपने 'diet' डेटा के लिए लिया था:
gym = df[['gym']]
gym.rolling(12).mean().plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
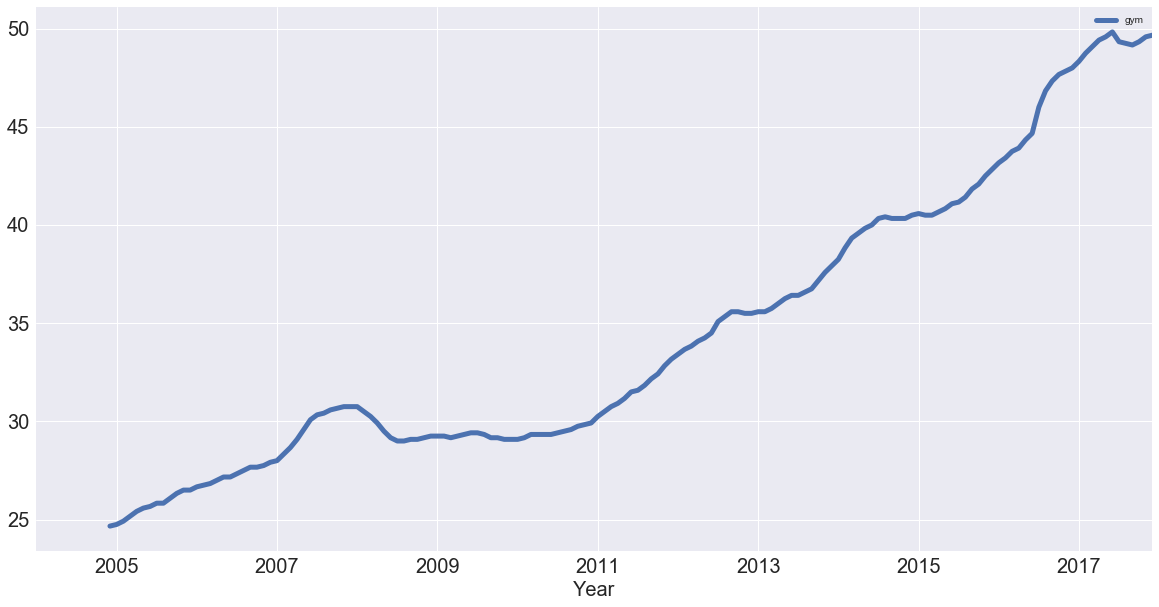
आपने सफलतापूर्वक मौसमीपन हटा दिया है और आप "gym" के लिए एक ऊपर जाता हुआ ट्रेंड देखते हैं! लेकिन ये दो सर्च टर्म्स आपस में कैसे तुलना करते हैं?
आप इसे 'gym' और 'diet' के ट्रेंड्स को एक ही फ़िगर पर प्लॉट करके समझ सकते हैं:
df_rm = pd.concat([diet.rolling(12).mean(), gym.rolling(12).mean()], axis=1)
df_rm.plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
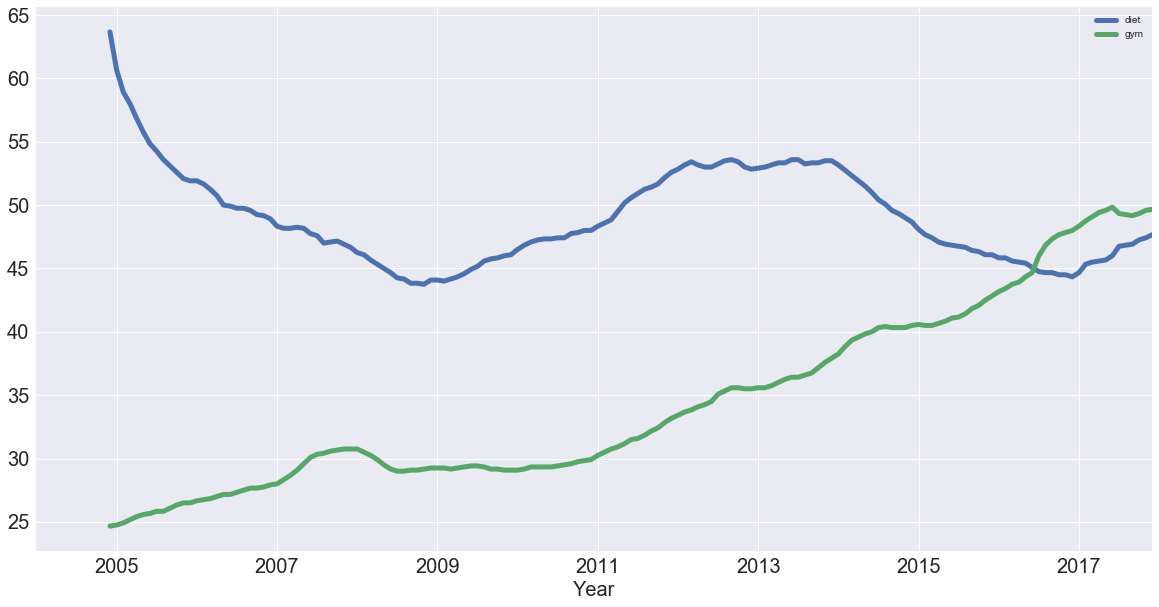
आपने एक नया DataFrame df_rm बनाया जिसमें 'diet' और 'gym' की रोलिंग एवरेज वाली दो कॉलम्स हैं। आपने pd.concat() फंक्शन का उपयोग किया, जो पहली आर्गुमेंट के रूप में कॉलम्स की सूची लेता है और, चूँकि आपको इन्हें कॉलम्स के रूप में जोड़ना था, आपने axis आर्गुमेंट को 1 सेट किया।
इसके बाद, आपने पहले की तरह ही plot() मेथड से इस DataFrame को प्लॉट किया! तो अब, मौसमीपन हटाने पर, आप देखते हैं कि diet में संभवतः कुछ मौसमीपन है, जबकि gym वास्तव में बढ़ रहा है!
डेटा में ट्रेंड्स की पहचान करने के बाद, अब मौसमीपन के बारे में सोचने का समय है, जो आपकी टाइम सीरीज़ की आवृत्तिमय प्रकृति है। जैसा कि आपने ट्यूटोरियल की शुरुआत में देखा, डेटा की टाइम सीरीज़ में ट्रेंड और मौसमी दोनों घटक दिख रहे थे।
मौसमी घटकों के बारे में सोचने का एक तरीका यह है कि टाइम सीरीज़ से ट्रेंड हटा दें, ताकि आप मौसमीपन की आसानी से जाँच कर सकें। ट्रेंड हटाने के लिए, आप ऊपर गणना किए गए ट्रेंड (रोलिंग मीन) को मूल सिग्नल से घटा सकते हैं। हालाँकि, यह इस पर निर्भर करेगा कि आपने कितने डेटा पॉइंट्स का औसत लिया।
ट्रेंड हटाने का एक और तरीका "डिफरेंसिंग" कहलाता है, जिसमें आप लगातार डेटा पॉइंट्स के बीच के अंतर को देखते हैं (इसे "फर्स्ट-ऑर्डर डिफरेंसिंग" कहते हैं, क्योंकि आप केवल एक डेटा पॉइंट और उससे पहले वाले के बीच का अंतर देखते हैं)।
आप pandas और diff() व plot() मेथड्स का उपयोग करके 'diet' Series का फर्स्ट ऑर्डर डिफरेंस निकाल और प्लॉट कर सकते हैं:
diet.diff().plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
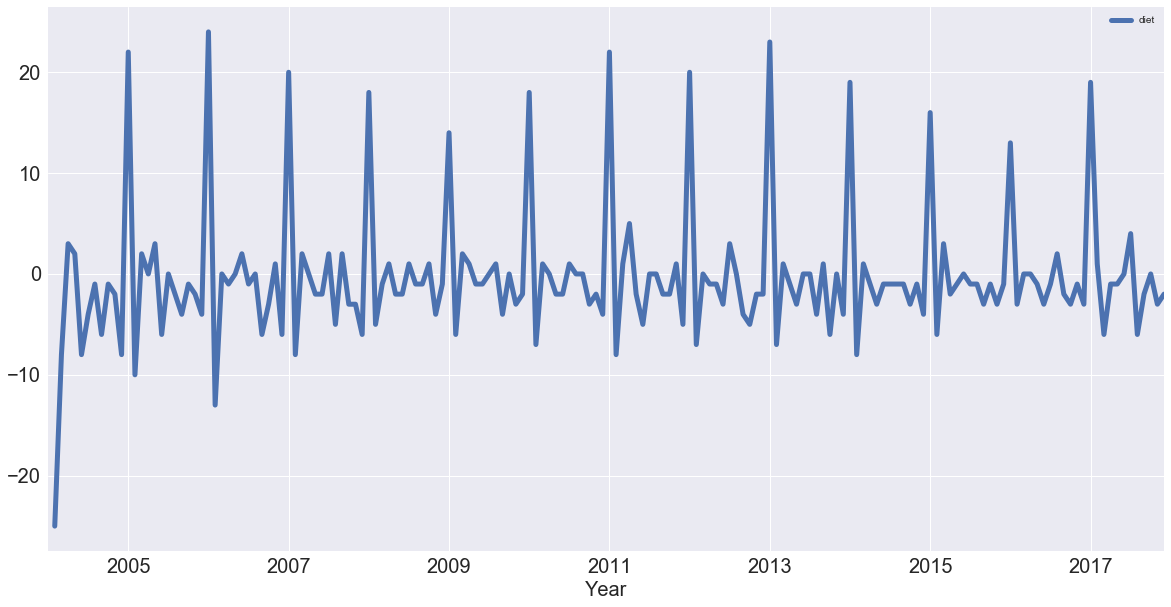
देखें कि आपने ट्रेंड का अधिकांश हिस्सा हटा दिया है और अब आप हर साल जनवरी के पीक स्पष्ट रूप से देख सकते हैं। हर जनवरी, आपने देखे गए सबसे ऊँचे सर्च आइटम पर 20 या उससे अधिक प्रतिशत का बड़ा स्पाइक आता है!
नोट: आप 2nd ऑर्डर डिफरेंसिंग भी कर सकते हैं, यानी अगर ट्रेंड अभी पूरी तरह नहीं हटा है तो आप एक डेटा पॉइंट और उससे पहले के दो पॉइंट्स के बीच के अंतर को देखते हैं। डिफरेंसिंग पर और जानने के लिए यहाँ देखें।
डिफरेंसिंग आपकी टाइम सीरीज़ को स्टेशनरी टाइम सीरीज़ में बदलने में बहुत मददगार है। आप यहाँ इस पर गहराई में नहीं जाएंगे, लेकिन स्टेशनरी टाइम सीरीज़ वह होती है जिसकी सांख्यिकीय विशेषताएँ (जैसे औसत और वैरिएंस) समय के साथ नहीं बदलतीं। ये टाइम सीरीज़ उपयोगी हैं क्योंकि कई टाइम सीरीज़ पूर्वानुमान विधियाँ इस धारणा पर आधारित हैं कि टाइम सीरीज़ लगभग स्टेशनरी है।
इन सब के साथ, अब आप अपनी टाइम सीरीज़ की आवृत्ति (periodicity) का विश्लेषण उसके ऑटोकोरिलेशन फ़ंक्शन को देखकर करेंगे। लेकिन उससे पहले, आप सहसंबंध (correlation) पर एक छोटा सा मोड़ लेंगे।
कोई टाइम सीरीज़ आवृत्तिमय (periodic) है यदि वह बराबर अंतराल पर खुद को दोहराती है, जैसे हर 12 महीने।
इसे ऐसे भी सोचा जा सकता है कि अगर टाइम सीरीज़ में कहीं पीक है, तो 12 महीने बाद भी पीक होगा और अगर कहीं ट्रफ है, तो 12 महीने बाद फिर ट्रफ होगा।
इसे एक और तरीके से भी सोच सकते हैं कि टाइम सीरीज़ अपने आप से, 12 महीने शिफ्ट की गई वर्ज़न के साथ, सहसंबद्ध है। यानी अगर आप टाइम सीरीज़ को 12 महीने आगे या पीछे खिसकाएँ, तो वह किसी हद तक खुद पर मैप हो जाएगी।
किसी टाइम सीरीज़ का अपने ही शिफ्ट किए गए वर्ज़न के साथ सहसंबंध देखना ऑटोकोरिलेशन की अवधारणा से पकड़ा जाता है।
आप अभी इस पर पहुँचेंगे।
पहले, सहसंबंध के बारे में खुद को याद दिलाएँ और इस अवधारणा को सहज रूप से समझें!
दो वेरिएबल्स का कॉरिलेशन कोएफिशिएंट इस बात को पकड़ता है कि वे कितने रैखिक रूप से संबंधित हैं। इसे समझने के लिए, आप iris डेटा सेट की मदद से एक व्यावहारिक उदाहरण देखेंगे, जिसमें फूलों के माप हैं।
इसे और विस्तार से देखने के लिए, आप scikit-learn से iris डेटासेट इंपोर्ट करेंगे, उसे DataFrame में बदलेंगे और .head() की मदद से शुरुआती पंक्तियाँ देखेंगे:
from sklearn import datasets
iris = datasets.load_iris()
df_iris = pd.DataFrame(data= np.c_[iris['data'], iris['target']],
                     columns= iris['feature_names'] + ['target'])
df_iris.head()
| sepal length (cm) | sepal width (cm) | petal length (cm) | petal width (cm) | target | |
|---|---|---|---|---|---|
| 0 | 5.1 | 3.5 | 1.4 | 0.2 | 0.0 |
| 1 | 4.9 | 3.0 | 1.4 | 0.2 | 0.0 |
| 2 | 4.7 | 3.2 | 1.3 | 0.2 | 0.0 |
| 3 | 4.6 | 3.1 | 1.5 | 0.2 | 0.0 |
| 4 | 5.0 | 3.6 | 1.4 | 0.2 | 0.0 |
इस डेटासेट को समझने के लिए याद रखें कि सभी फूलों में सेपल और पंखुड़ी (petal) होती हैं। सेपल पंखुड़ियों को ढँकता है और आमतौर पर हरा और पत्ते जैसा होता है, जबकि पंखुड़ियाँ आमतौर पर रंगीन होती हैं। 'target' कॉलम, जो लक्ष्य वेरिएबल है, आईरिस फूलों की प्रजाति है, जो Versicolor, Virginica या Setosa हो सकती है। ऊपर की तालिका में इन्हें 0, 1, और 2 के रूप में एन्कोड किया गया है।
अब, सहसंबंध के बारे में सोचने के लिए, आप देखेंगे कि आईरिस फूलों की सेपल लंबाई का सेपल चौड़ाई से क्या संबंध है। ऐसा करने के लिए, आप pandas या seaborn का उपयोग करके 'sepal length' बनाम 'sepal width' का स्कैटर प्लॉट बनाएँगे:
sns.lmplot(x='sepal length (cm)', y='sepal width (cm)', fit_reg=False, data=df_iris);
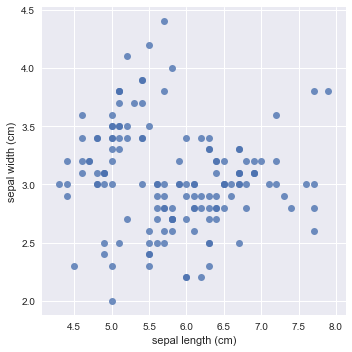
नोट करें कि आपने fit_reg आर्गुमेंट को False सेट करके लीनियर रीग्रेशन को बंद कर दिया है।
क्या सभी फूलों में सेपल लंबाई और चौड़ाई सकारात्मक रूप से सहसंबद्ध हैं या नकारात्मक रूप से? क्या वे प्रत्येक प्रजाति के भीतर सकारात्मक या नकारात्मक रूप से सहसंबद्ध हैं? यह एक आवश्यक भेद है।
पहली नज़र में, ऊपर के प्लॉट में नकारात्मक सहसंबंध लगता है: जैसे-जैसे सेपल लंबाई बढ़ती है, सेपल चौड़ाई थोड़ा कम होती दिखती है।
अब 'sepal length' बनाम 'sepal width' का स्कैटर प्लॉट बनाते हैं, जिसे लक्ष्य (species) के अनुसार रंग दिया गया है:
sns.lmplot(x='sepal length (cm)', y='sepal width (cm)', fit_reg=False, data=df_iris, hue='target');
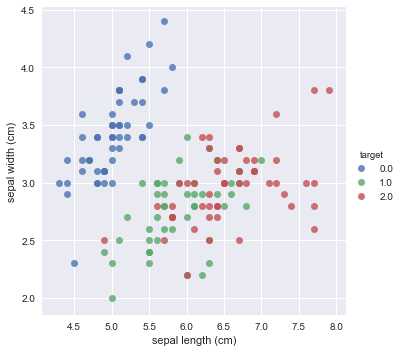
पहली नज़र में, ऊपर का प्लॉट सकारात्मक सहसंबंध दिखाता है: आईरिस फूल की प्रत्येक प्रजाति के लिए, जब सेपल लंबाई बढ़ती है, तो सेपल चौड़ाई भी बढ़ती दिखती है।
विज़ुअलाइज़ेशन सहसंबंध की सहज समझ के लिए बेहतरीन हैं, लेकिन इसे और विस्तार से समझने का एक तरीका यह है कि वास्तव में कॉरिलेशन कोएफिशिएंट की गणना की जाए।
आप .corr() मेथड की मदद से प्रत्येक जोड़ी के माप का कॉरिलेशन कोएफिशिएंट निकाल सकते हैं:
df_iris.corr()
| sepal length (cm) | sepal width (cm) | petal length (cm) | petal width (cm) | target | |
|---|---|---|---|---|---|
| sepal length (cm) | 1.000000 | -0.109369 | 0.871754 | 0.817954 | 0.782561 |
| sepal width (cm) | -0.109369 | 1.000000 | -0.420516 | -0.356544 | -0.419446 |
| petal length (cm) | 0.871754 | -0.420516 | 1.000000 | 0.962757 | 0.949043 |
| petal width (cm) | 0.817954 | -0.356544 | 0.962757 | 1.000000 | 0.956464 |
| target | 0.782561 | -0.419446 | 0.949043 | 0.956464 | 1.000000 |
नोट करें कि 'sepal length (cm)' और 'sepal width (cm)' नकारात्मक रूप से सहसंबद्ध लगते हैं! और वे हैं भी, मापे गए सभी फूलों की आबादी पर। आप देखते हैं कि कॉरिलेशन कोएफिशिएंट -0.1 है। हालाँकि, वे प्रत्येक प्रजाति के भीतर नकारात्मक रूप से सहसंबद्ध नहीं हैं, क्योंकि कोएफिशिएंट 0.78 है।
दिलचस्पी रखने वालों के लिए, इसे Simpson's paradox कहा जाता है और कारणात्मक निष्कर्ष (causal inference) के बारे में सोचते समय यह महत्वपूर्ण है। और पढ़ें यहाँ।
इसे और आगे बढ़ाते हैं। प्रत्येक प्रजाति के भीतर मापों की जोड़ी के कॉरिलेशन कोएफिशिएंट्स निकालते हैं। तरीका है .groupby() और .corr() मेथड्स को चेन करना, लक्ष्य के आधार पर ग्रुप करना और कॉरिलेशन कोएफिशिएंट प्रिंट करना:
df_iris.groupby(['target']).corr()
| petal length (cm) | petal width (cm) | sepal length (cm) | sepal width (cm) | ||
|---|---|---|---|---|---|
| target | |||||
| 0.0 | petal length (cm) | 1.000000 | 0.306308 | 0.263874 | 0.176695 |
| petal width (cm) | 0.306308 | 1.000000 | 0.279092 | 0.279973 | |
| sepal length (cm) | 0.263874 | 0.279092 | 1.000000 | 0.746780 | |
| sepal width (cm) | 0.176695 | 0.279973 | 0.746780 | 1.000000 | |
| 1.0 | petal length (cm) | 1.000000 | 0.786668 | 0.754049 | 0.560522 |
| petal width (cm) | 0.786668 | 1.000000 | 0.546461 | 0.663999 | |
| sepal length (cm) | 0.754049 | 0.546461 | 1.000000 | 0.525911 | |
| sepal width (cm) | 0.560522 | 0.663999 | 0.525911 | 1.000000 | |
| 2.0 | petal length (cm) | 1.000000 | 0.322108 | 0.864225 | 0.401045 |
| petal width (cm) | 0.322108 | 1.000000 | 0.281108 | 0.537728 | |
| sepal length (cm) | 0.864225 | 0.281108 | 1.000000 | 0.457228 | |
| sepal width (cm) | 0.401045 | 0.537728 | 0.457228 | 1.000000 |
इस कॉरिलेशन मैट्रिक्स में, आप देख सकते हैं कि:
ये सभी सकारात्मक सहसंबंध के घटते हुए मान हैं, लेकिन ये सभी आपके मूल नकारात्मक सहसंबंध की तुलना में बहुत अधिक सकारात्मक हैं।
यह बेहद महत्वपूर्ण संकेत है और आपके डेटा के गहन विश्लेषण की अहमियत का स्पष्ट स्मरण कराता है।
अब जब आपने सहसंबंध पर नज़दीकी नज़र डाल ली है, तो आप अपनी टाइम सीरीज़ की आवृत्ति का विश्लेषण उसकी ऑटोकोरिलेशन फ़ंक्शन को देखकर करने के लिए तैयार हैं!
शुरू करने के लिए, अपनी सभी टाइम सीरीज़ दोबारा प्लॉट करें ताकि आपको याद रहे कि वे कैसी दिखती हैं:
df.plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
फिर, .corr() की मदद से इन सभी टाइम सीरीज़ के कॉरिलेशन कोएफिशिएंट्स की गणना करें:
df.corr()
| diet | gym | finance | |
|---|---|---|---|
| diet | 1.000000 | -0.100764 | -0.034639 |
| gym | -0.100764 | 1.000000 | -0.284279 |
| finance | -0.034639 | -0.284279 | 1.000000 |
ऊपर का परिणाम आपको क्या बताता है?
आइए 'diet' और 'gym' पर ध्यान दें; ये नकारात्मक रूप से सहसंबद्ध हैं। यह दिलचस्प है! याद रखें कि आपके पास मौसमी और ट्रेंड घटक हैं। कॉरिलेशन कोएफिशिएंट से 'diet' और 'gym' नकारात्मक रूप से सहसंबद्ध हैं। हालाँकि, टाइम सीरीज़ को देखकर लगता है कि इनके मौसमी घटक सकारात्मक रूप से सहसंबद्ध होंगे और इनके ट्रेंड नकारात्मक रूप से।
वास्तविक कॉरिलेशन कोएफिशिएंट दरअसल दोनों को ही पकड़ रहा है।
अब आप जो करना चाहते हैं, वह है इन टाइम सीरीज़ की फर्स्ट-ऑर्डर डिफरेंस को प्लॉट करना और फिर उनका कॉरिलेशन निकालना, क्योंकि वह लगभग मौसमी घटकों का कॉरिलेशन होगा। याद रखें कि ट्रेंड हटाने से मौसमीपन में सहसंबंध सामने आ सकता है।
.diff() और .plot() की मदद से फर्स्ट-ऑर्डर डिफरेंसेज़ प्लॉट करके शुरुआत करें:
df.diff().plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
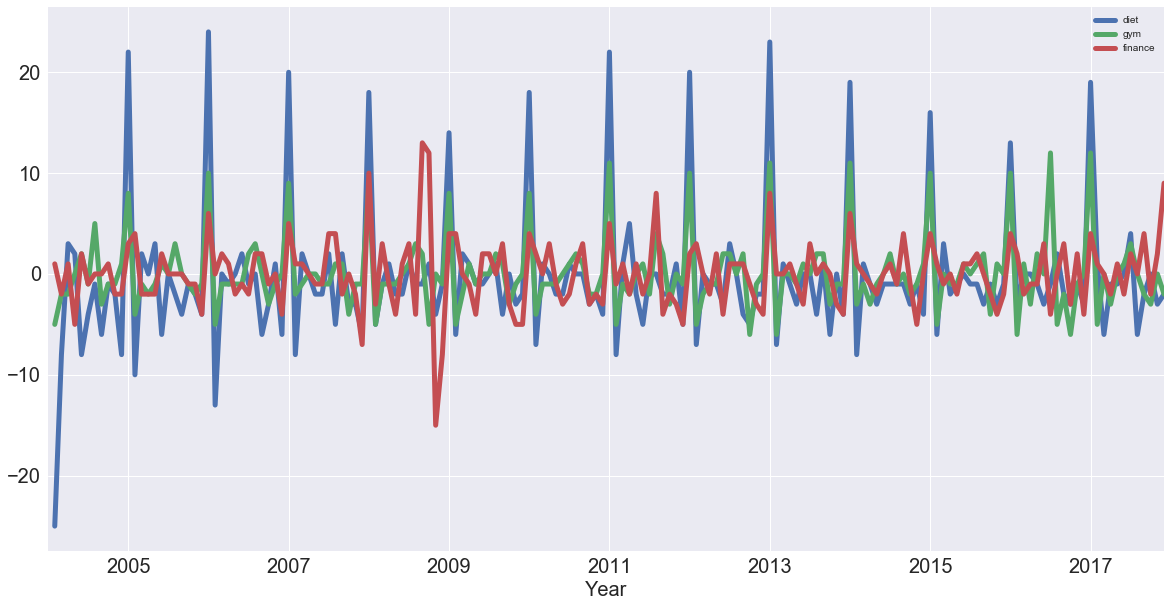
आप देखते हैं कि 'diet' और 'gym' ट्रेंड हटाने के बाद बेहद सहसंबद्ध हैं। अब, आप इन टाइम सीरीज़ की फर्स्ट-ऑर्डर डिफरेंस के कॉरिलेशन कोएफिशिएंट्स निकालेंगे:
df.diff().corr()
| diet | gym | finance | |
|---|---|---|---|
| diet | 1.000000 | 0.758707 | 0.373828 |
| gym | 0.758707 | 1.000000 | 0.301111 |
| finance | 0.373828 | 0.301111 | 1.000000 |
नोट करें कि फिर से, जब आप ट्रेंड और मौसमी घटक दोनों को साथ सोच रहे थे तो हल्का नकारात्मक सहसंबंध था। अब, आप देखते हैं कि मौसमी घटक के साथ, 'diet' और 'gym' अत्यधिक सहसंबद्ध हैं, 0.76 के कोएफिशिएंट के साथ।
अब जब आपने वेरिएबल्स और टाइम सीरीज़ के सहसंबंध में झाँक लिया है, तो 'diet' सीरीज़ का ऑटोकोरिलेशन प्लॉट करने का समय है: x-अक्ष पर लैग होगा और y-अक्ष पर यह कि दिए गए लैग पर टाइम सीरीज़ अपने आप से कितनी सहसंबद्ध है।
तो, इसका मतलब यह है कि अगर मूल टाइम सीरीज़ हर दो दिनों में खुद को दोहराती है, तो आप ऑटोकोरिलेशन फ़ंक्शन में 2 दिनों पर स्पाइक देखने की उम्मीद करेंगे।
यहाँ, आप प्लॉट देखेंगे और आपको 12 महीनों पर ऑटोकोरिलेशन फ़ंक्शन में स्पाइक की उम्मीद करनी चाहिए: टाइम सीरीज़ अपने आप से बारह महीने शिफ्ट की गई वर्ज़न के साथ सहसंबद्ध है।
pandas के plotting इंटरफ़ेस का उपयोग करें, जिसमें autocorrelation_plot() फंक्शन है। आप इस फंक्शन का उपयोग करके 'diet' टाइम सीरीज़ को प्लॉट कर सकते हैं:
pd.plotting.autocorrelation_plot(diet);
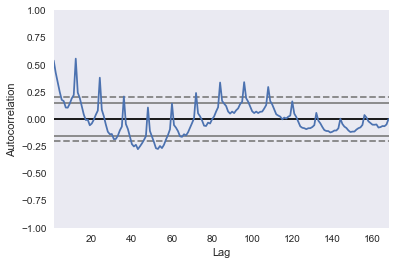
यदि आप अपनी धुरी (axes) में और लैग्स शामिल करें, तो आप देखेंगे कि 12 महीनों पर कॉरिलेशन में बड़ा पीक आता है। 24 महीनों पर एक और पीक आता है, जहाँ यह अपने आप से सहसंबद्ध है। 36 पर एक और पीक है, लेकिन जैसे-जैसे आप और दूर जाते हैं, सहसंबंध कम होता जाता है।
बेशक, लैग 0 पर अपने आप के साथ सहसंबंध 1 होता है।
ऊपर दिए प्लॉट की डॉटेड लाइनें वास्तव में सहसंबंध की सांख्यिकीय महत्वपूर्णता (statistical significance) के बारे में बताती हैं। इस मामले में, आप कह सकते हैं कि 'diet' सीरीज़ बारह महीनों के लैग के साथ सचमुच ऑटोकोरिलेटेड है।
आपने इस 12 महीने के दोहराव की मौसमीपन की पहचान कर ली है!
इस ट्यूटोरियल में आपने काफी कुछ कवर किया! आपने 'diet', 'gym' के कीवर्ड्स के Google Trends डेटा को देखा और 'finance' पर भी सरसरी नज़र डाली कि समय के साथ ये कैसे बदलते हैं। आपने seasonality, trends, correlation, autocorrelation जैसे कॉन्सेप्ट्स कवर किए...
जिन डेटा वैज्ञानिकों में उत्साह है, उनके लिए दो चीज़ें हैं जो आप तुरंत कर सकते हैं:
Python के बारे में और जानें
कोर्स
कोर्स
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखें