
कोर्स
Llama 3 के साथ काम करना
2 घंटा
15.7K
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखेंMeta ने अभी-अभी Llama 4 मॉडल सूट की घोषणा की है, जिसमें दो जारी मॉडल शामिल हैं—Llama 4 Scout और Llama 4 Maverick—और तीसरा मॉडल अभी प्रशिक्षण में है: Llama 4 Behemoth.
Scout और Maverick वेरिएंट अभी उपलब्ध हैं, Meta के सामान्य ओपन-वेट लाइसेंस के तहत खुले तौर पर जारी किए गए हैं—एक उल्लेखनीय शर्त के साथ: अगर आपकी सेवाओं के 700 मिलियन से अधिक मासिक सक्रिय उपयोगकर्ता हैं, तो आपको Meta से अलग लाइसेंस प्राप्त करना होगा, जिसे वह अपने विवेक से दे भी सकता है या नहीं भी।
Llama Scout 1 करोड़ (10 मिलियन) टोकन का कॉन्टेक्स्ट विंडो सपोर्ट करता है, जो किसी भी सार्वजनिक रूप से जारी मॉडल में सबसे बड़ा है। Llama Maverick एक जनरलिस्ट मॉडल है और GPT-4o, Gemini 2.0 Flash, और DeepSeek-V3 को टक्कर देता है। Llama Behemoth, जो अभी प्रशिक्षण में है, एक उच्च-क्षमता वाले टीचर मॉडल के रूप में काम करता है।
इस परिचयात्मक ब्लॉग में, मैं आपको Llama 4 सूट का अवलोकन दूंगा। हमारी टीम पहले ही मॉडल का परीक्षण कर चुकी है, और यदि आप अपनी सीख को आगे बढ़ाना चाहते हैं तो मैं इन ट्यूटोरियल्स की सिफारिश करता हूँ:
अपडेट: लगभग एक साल की शांति के बाद, Meta ने अपना नवीनतम LLM जारी किया है। एक ओवरव्यू पाने के लिए हमारा Muse Spark गाइड देखें।
हम अपने पाठकों को AI की ताज़ा खबरों से अपडेट रखते हैं The Median भेजकर, हमारा मुफ़्त शुक्रवार न्यूज़लेटर जो हफ्ते की प्रमुख कहानियों को सरलता से समझाता है। सब्सक्राइब करें और हर हफ्ते कुछ ही मिनटों में अपडेटेड रहें:
Llama 4 Meta का नया बड़े भाषा मॉडलों का परिवार है। रिलीज़ में दो मॉडल शामिल हैं जो पहले से उपलब्ध हैं—Llama 4 Scout और Llama 4 Maverick—और तीसरा, Llama 4 Behemoth, जो अभी प्रशिक्षण में है।
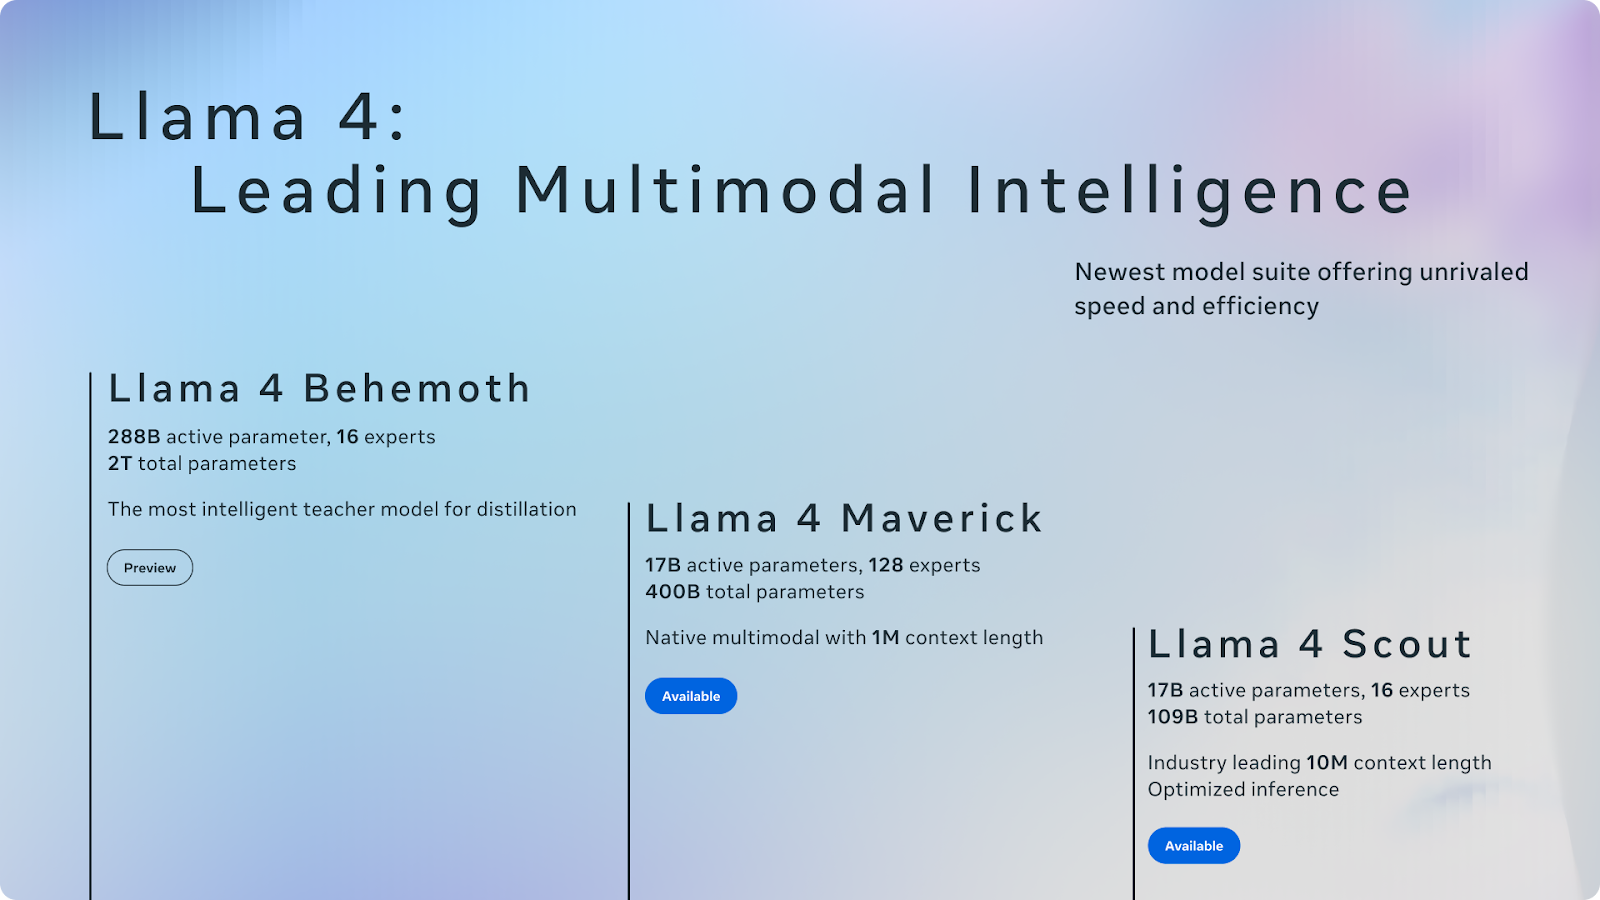
स्रोत: Meta AI
Llama 4 उल्लेखनीय सुधार लाता है। खास तौर पर, यह mixture-of-experts (MoE) आर्किटेक्चर शामिल करता है, जिसका उद्देश्य विशिष्ट कार्यों के लिए केवल आवश्यक घटकों को सक्रिय करके दक्षता और प्रदर्शन में सुधार करना है (इस पर आगे बात होगी)। यह डिज़ाइन अधिक स्केलेबल और विशेषज्ञता-आधारित AI मॉडलों की ओर बदलाव का संकेत देता है।
Llama 4 Meta की ओपन-वेट मॉडल जारी करने की रणनीति को जारी रखता है—पर एक शर्त के साथ। यदि आपकी कंपनी ऐसे सेवाएँ चलाती है जिनके 700 मिलियन से अधिक मासिक सक्रिय उपयोगकर्ता हैं, तो आपको Meta से अलग लाइसेंस की आवश्यकता होगी, जो दिया भी जा सकता है या नहीं भी। उस सीमा को अलग रखें, तो यह रिलीज़ अभी भी ओपन-वेट परिदृश्य में एक बड़ा इवेंट लगता है, भले ही हाल के महीनों में परिदृश्य तेज़ी से बदल गया है।
यदि Llama 2 और 3 ने कभी इस श्रेणी को परिभाषित किया था, तो अब Llama 4 एक कहीं अधिक प्रतिस्पर्धी मैदान में उतरा है। DeepSeek मज़बूत रीज़निंग क्षमताओं के साथ आया है। अलीबाबा की Qwen सीरीज़ ने बहुभाषी और कोडिंग बेंचमार्क्स में अच्छा प्रदर्शन किया है। Google के Gemma मॉडल छोटे, कुशल आर्किटेक्चर के साथ इसी क्षेत्र में आगे बढ़ रहे हैं। और कुछ दिन पहले ही, OpenAI ने ओपन-वेट मॉडल जारी करने की योजना की घोषणा की, जो एक साल पहले असंभावित लगता।
आइए प्रत्येक मॉडल के बारे में और विवरण जानें।
Llama 4 Scout इस नए सूट का हल्का-फुल्का मॉडल है, लेकिन संभवतः सबसे दिलचस्प भी। यह एकल H100 GPU पर चलता है और 1 करोड़ टोकन का कॉन्टेक्स्ट विंडो सपोर्ट करता है। इससे Scout अब तक जारी किसी भी ओपन-वेट मॉडल में सबसे अधिक कॉन्टेक्स्ट संभालने वाला बन जाता है और बहु-दस्तावेज़ सार-संक्षेप, लंबी-रूप कोड रीज़निंग और एक्टिविटी पार्सिंग जैसे कार्यों के लिए बेहद उपयोगी हो सकता है।
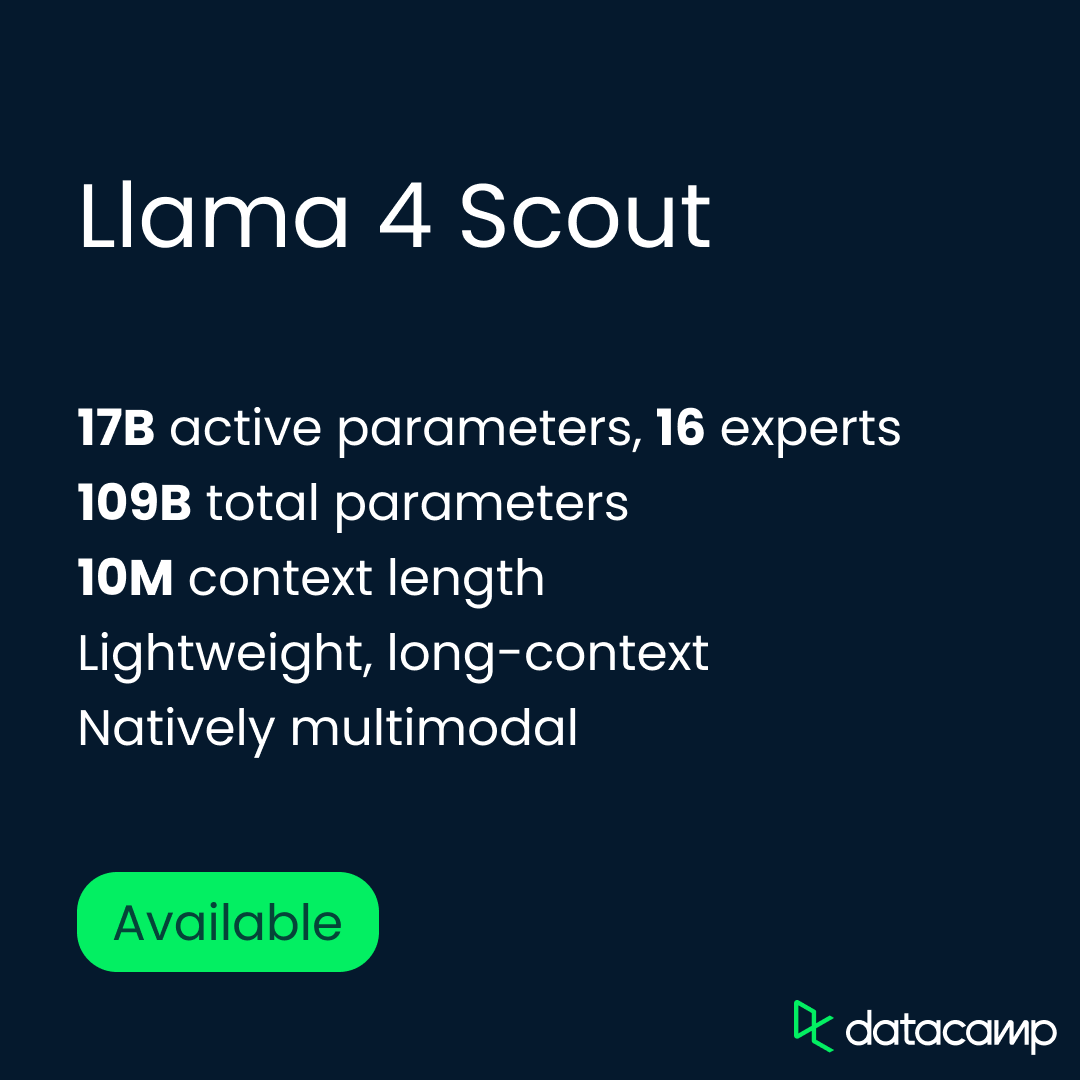
Scout में 17 बिलियन सक्रिय पैरामीटर्स हैं, जो 16 एक्सपर्ट्स के जरिए संगठित हैं, और कुल पैरामीटर्स 109 बिलियन हैं। इसे 256K कॉन्टेक्स्ट विंडो के साथ प्री-ट्रेंड और पोस्ट-ट्रेंड किया गया था, लेकिन Meta का कहना है कि यह उससे कहीं आगे भी अच्छी तरह सामान्यीकृत करता है (इस दावे का अभी परीक्षण होना बाकी है)। व्यवहार में, यह पूरे कोडबेस, सेशन हिस्ट्रीज़ या विधिक दस्तावेज़ों जैसी वर्कफ़्लोज़ के लिए रास्ता खोलता है—सब कुछ एक ही फॉरवर्ड पास में प्रोसेस होता है।
आर्किटेक्चर की दृष्टि से, Scout Meta के mixture-of-experts (MoE) फ्रेमवर्क पर बना है, जहाँ प्रति टोकन केवल कुछ पैरामीटर्स सक्रिय होते हैं—इसके विपरीत घने मॉडलों जैसे GPT-4o में सभी पैरामीटर्स सक्रिय होते हैं। इसका मतलब है कि यह कंप्यूट-कुशल और अत्यधिक स्केलेबल है।
मूल आर्किटेक्चर से आगे, Meta ने Scout की मल्टीमॉडल क्षमताओं पर ज़ोर दिया है। इसे टेक्स्ट, इमेज और वीडियो डेटा पर अर्ली फ्यूज़न के साथ प्री-ट्रेन किया गया, जिससे यह स्वाभाविक रूप से टेक्स्ट और विज़ुअल प्रॉम्प्ट्स के संयोजन को संभाल सकता है। विज़ुअल ग्राउंडिंग और VQA (विज़ुअल क्वेश्चन आंसरिंग) जैसे इमेज-हेवी कार्यों में, Scout किसी भी पिछले Llama मॉडल से बेहतर प्रदर्शन करता है—और कहीं बड़े सिस्टम्स के मुकाबले भी टिकता है।
संक्षेप में, Scout व्यापकता और स्केल के लिए बना है। यह कुशलता से चलने, किसी भी पिछले ओपन मॉडल से अधिक इनपुट संभालने, और टेक्स्ट व इमेज दोनों कार्यों में अच्छी तरह काम करने के लिए डिज़ाइन किया गया है। हम जल्द ही उस 10M कॉन्टेक्स्ट लिमिट का परीक्षण करेंगे—और वापस रिपोर्ट करेंगे।
Llama 4 Maverick इस लाइनअप का जनरलिस्ट है—एक पूर्ण-स्केल, मल्टीमॉडल मॉडल जो चैट, रीज़निंग, इमेज अंडरस्टैंडिंग और कोड में प्रदर्शन के लिए बना है। जहाँ Scout कॉन्टेक्स्ट लंबाई की हदें आगे बढ़ाता है, वहीं Maverick कार्यों में संतुलित, उच्च-गुणवत्ता वाला आउटपुट देने पर केंद्रित है। यह Meta का GPT-4o, DeepSeek-V3, और Gemini 2.0 Flash का जवाब है।
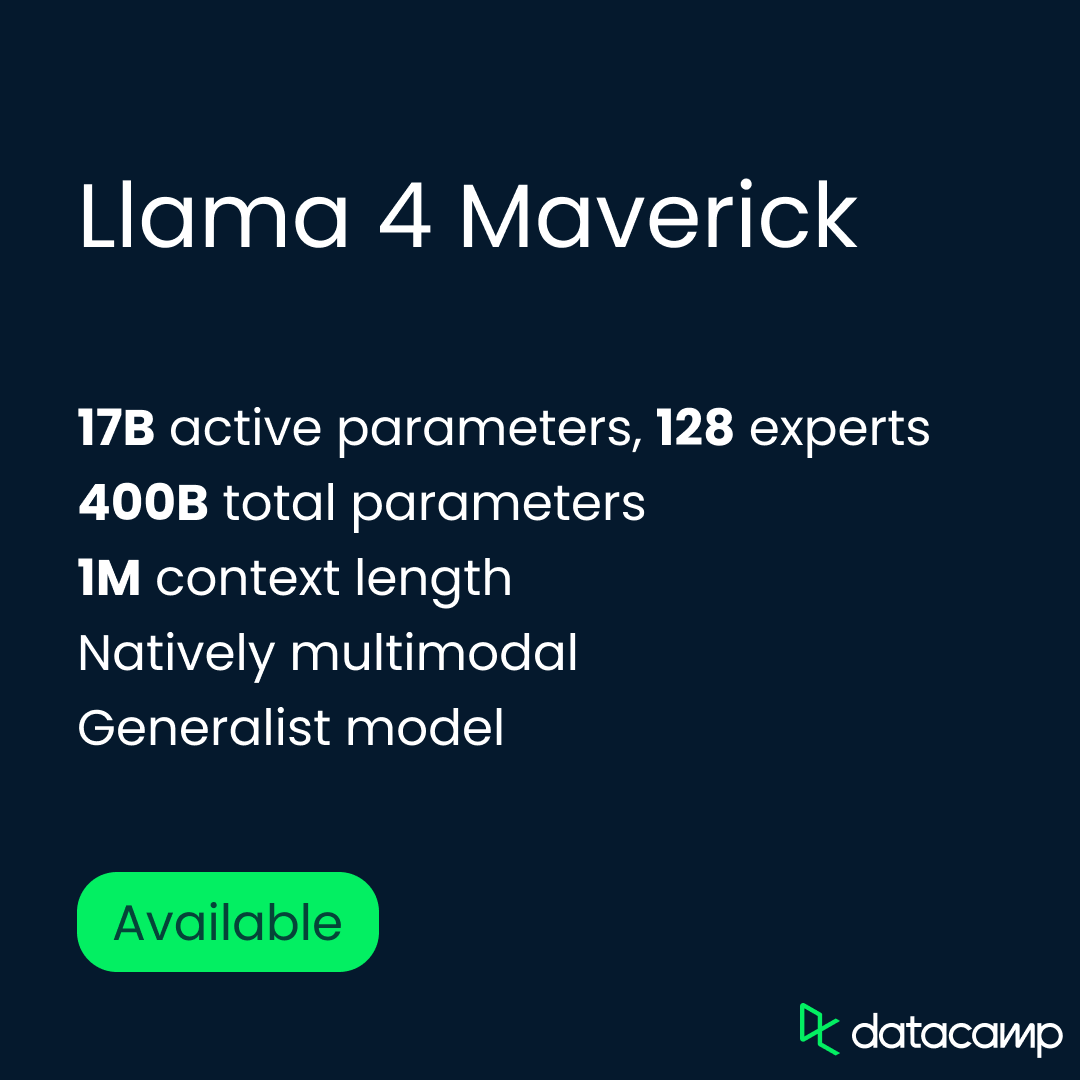
Maverick में भी Scout जितने ही 17 बिलियन सक्रिय पैरामीटर्स हैं, लेकिन बड़ा MoE कॉन्फ़िगरेशन है: 128 एक्सपर्ट्स और कुल 400 बिलियन पैरामीटर्स। Scout की तरह, यह mixture-of-experts आर्किटेक्चर का उपयोग करता है, जो प्रति टोकन केवल मॉडल के हिस्से को सक्रिय करता है—इन्फ़रेंस लागत घटाते हुए क्षमता को स्केल करता है। मॉडल एकल H100 DGX होस्ट पर चलता है, लेकिन बड़े पैमाने के अनुप्रयोगों के लिए डिस्ट्रीब्यूटेड इन्फ़रेंस के साथ भी डिप्लॉय किया जा सकता है।
यहाँ Meta ने पोस्ट-ट्रेनिंग के लिए अलग तरीका अपनाया, जिसमें हल्के सुपरवाइज़्ड फाइन-ट्यूनिंग, ऑनलाइन रीइन्फोर्समेंट लर्निंग, और डायरेक्ट प्रेफ़रेन्स ऑप्टिमाइज़ेशन का मिश्रण शामिल था। लक्ष्य था कठिन प्रॉम्प्ट्स पर प्रदर्शन को तेज़ करना, बिना मॉडल को अधिक सीमित किए। इसी उद्देश्य से, Meta ने पहले के Llama मॉडलों द्वारा "आसान" चिह्नित 50% से अधिक प्रशिक्षण उदाहरणों को फ़िल्टर कर दिया और एक ऐसा करिकुलम बनाया जो कठिन रीज़निंग, कोडिंग और मल्टीमॉडल कार्यों पर ज़ोर देता है।
Maverick को Llama 4 Behemoth, Meta के कहीं बड़े आंतरिक मॉडल, से सह-डिस्टिल भी किया गया, जिससे प्रशिक्षण लागत बढ़ाए बिना प्रदर्शन में बढ़त मिली। Meta के अनुसार, इस डिस्टिलेशन पाइपलाइन ने रीज़निंग और चैट क्वालिटी में उल्लेखनीय छलांग दी।
Llama 4 Behemoth अब तक का Meta का सबसे शक्तिशाली और सबसे बड़ा मॉडल है—लेकिन यह अभी उपलब्ध नहीं है। यह अब भी प्रशिक्षण में है और DeepSeek-R1 या OpenAI के o3 की तरह वैसा रीज़निंग मॉडल नहीं है, जो मल्टी-स्टेप चेन-ऑफ-थॉट कार्यों के लिए बनाए और ऑप्टिमाइज़ किए गए हैं।
अब तक जो पता है, उसके आधार पर यह सीधे उपयोग हेतु एक उत्पाद के रूप में भी डिज़ाइन नहीं लगता। इसके बजाय, यह एक टीचर मॉडल के रूप में काम करता है, जिसका उपयोग डिस्टिल करने और Scout तथा Maverick दोनों को आकार देने के लिए किया गया। एक बार जारी होने पर, यह दूसरों को भी अपने मॉडल डिस्टिल करने की अनुमति दे सकता है।
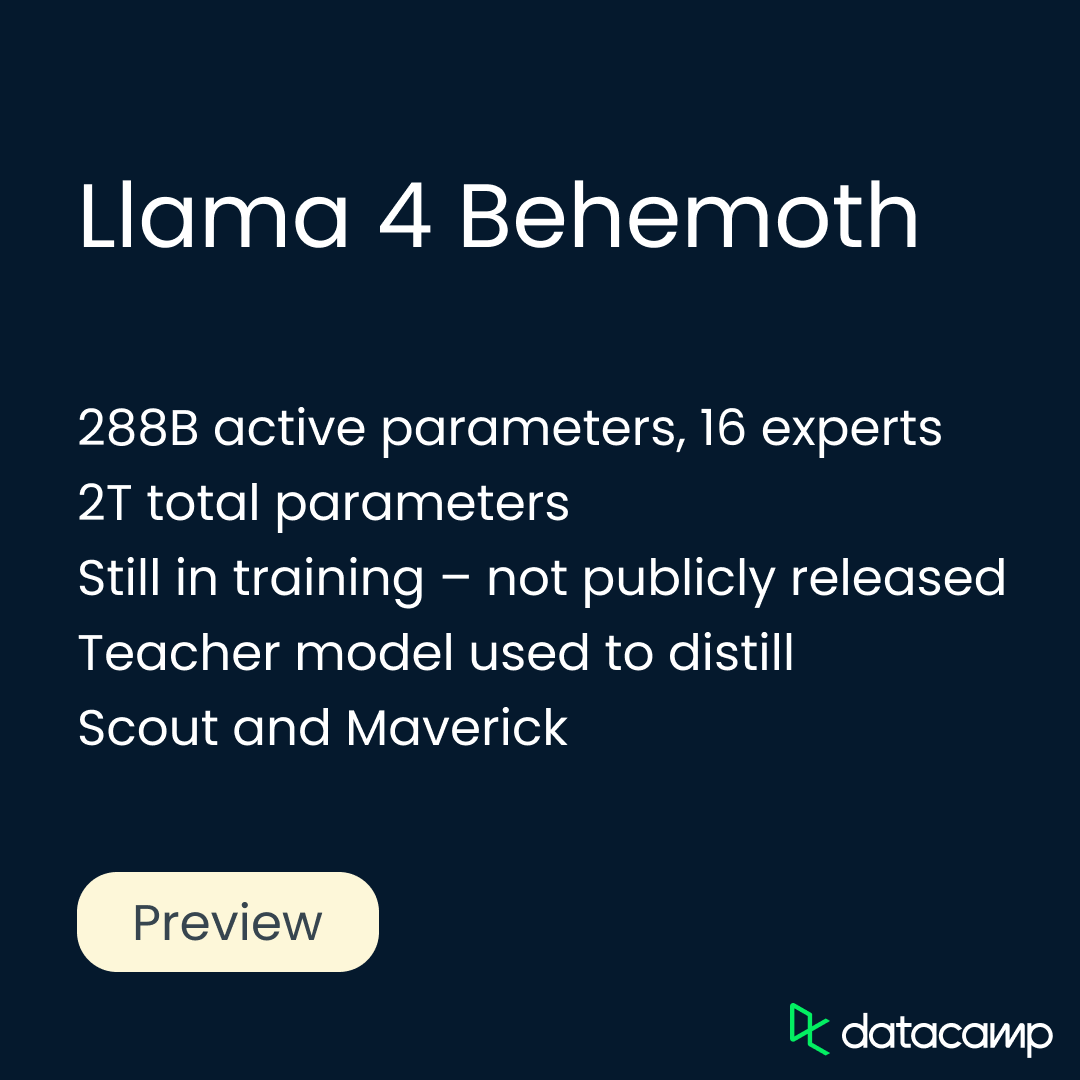
Behemoth में 288 बिलियन सक्रिय पैरामीटर्स हैं, जो 16 एक्सपर्ट्स के जरिए संगठित हैं, और कुल पैरामीटर्स लगभग 2 ट्रिलियन के क़रीब हैं। Meta ने इस पैमाने पर Behemoth को सपोर्ट करने के लिए पूरी तरह नया ट्रेनिंग इन्फ्रास्ट्रक्चर बनाया। इसमें असिंक्रोनस रीइन्फोर्समेंट लर्निंग, प्रॉम्प्ट कठिनाई के आधार पर करिकुलम सैंपलिंग, और नया डिस्टिलेशन लॉस फ़ंक्शन शामिल है जो सॉफ्ट और हार्ड टार्गेट्स के बीच डायनामिक रूप से संतुलन बनाता है।
पोस्ट-ट्रेनिंग के लिए Behemoth को अलग नुस्ख़े की ज़रूरत पड़ी। Meta ने कठिन प्रॉम्प्ट्स पर केंद्रित होने के लिए SFT उदाहरणों में से 95% से अधिक को हटा दिया और जटिल रीज़निंग, कोडिंग और बहुभाषी परिदृश्यों पर रीइन्फोर्समेंट लर्निंग केंद्रित की। विविध सिस्टम इंस्ट्रक्शनों से सैंपलिंग ने मॉडल को सामान्यीकृत करने में मदद की, जबकि डायनामिक फ़िल्टरिंग ने RL प्रशिक्षण के दौरान लो-वैल्यू प्रॉम्प्ट्स को हटा दिया।
Meta ने प्रत्येक Llama 4 मॉडल के लिए आंतरिक बेंचमार्क परिणाम जारी किए, उनकी तुलना अपने पिछले Llama वेरिएंट्स और कई प्रतिस्पर्धी ओपन-वेट तथा फ्रंटियर मॉडलों से की।
इस खंड में, मैं Meta के ही आँकड़ों का उपयोग करते हुए Scout, Maverick और Behemoth के बेंचमार्क हाइलाइट्स से आपको परिचित कराऊंगा। हमेशा की तरह, स्व-रिपोर्टेड बेंचमार्क्स को सावधानी से देखें—लेकिन ये स्कोर यह पहला उपयोगी संकेत देते हैं कि हर मॉडल अलग-अलग कार्यों में कैसा प्रदर्शन करता है और मौजूदा परिदृश्य में कहाँ खड़ा है। Scout से शुरू करते हैं।
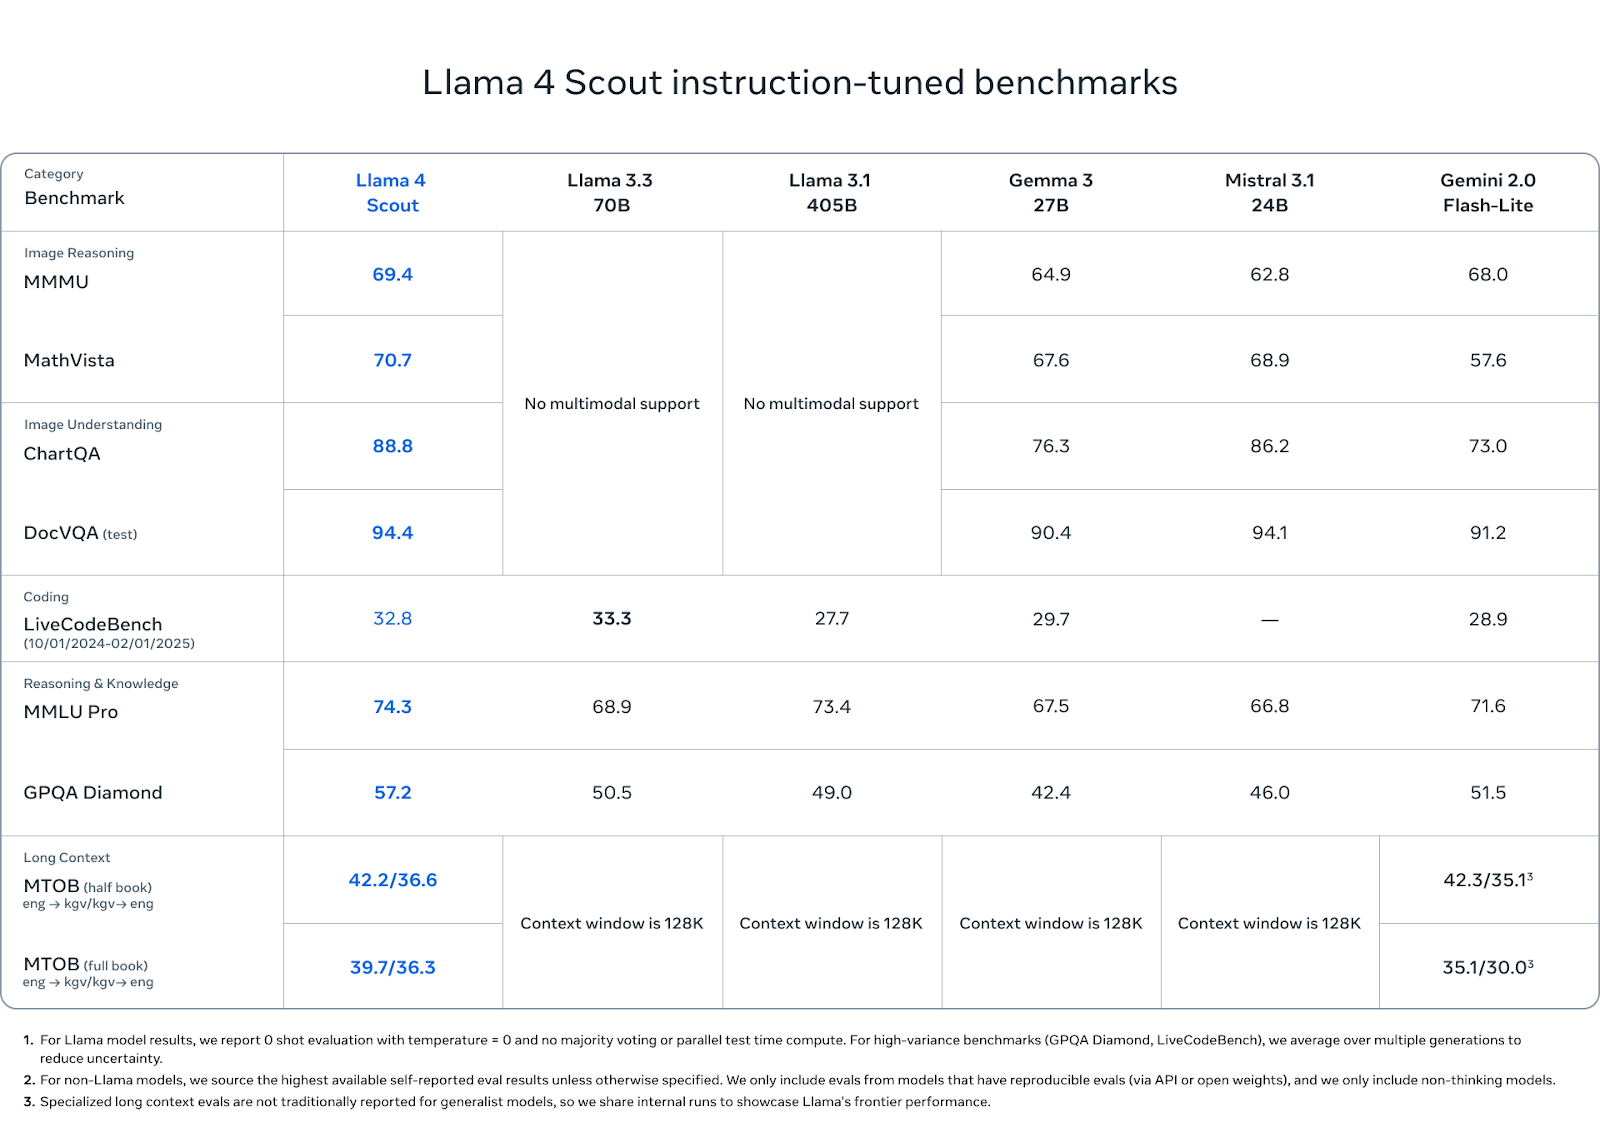
Llama 4 Scout रीज़निंग, कोडिंग और मल्टीमॉडल बेंचमार्क्स के मिश्रण में अच्छा प्रदर्शन करता है—खासतौर पर इसके छोटे सक्रिय पैरामीटर काउंट और सिंगल-GPU फ़ुटप्रिंट को देखते हुए।
स्रोत: MetaAI
इमेज अंडरस्टैंडिंग पर, Scout प्रतिस्पर्धियों से आगे निकलता है: यह ChartQA पर 88.8 और DocVQA (टेस्ट) पर 94.4 स्कोर करता है, Gemini 2.0 Flash-Lite (क्रमशः 73.0 और 91.2) से बेहतर और Mistral 3.1 तथा Gemma 3 27B के बराबर या थोड़ा आगे।
MMMU (69.4) और MathVista (70.7) जैसे इमेज रीज़निंग बेंचमार्क्स में भी यह ओपन-वेट समूह में अग्रणी है, Gemma 3 (64.9, 67.6), Mistral 3.1 (62.8, 68.9), और Gemini Flash-Lite (68.0, 57.6) से बेहतर।
कोडिंग में, Scout LiveCodeBench पर 32.8 स्कोर करता है, जो Gemini Flash-Lite (28.9) और Gemma 3 27B (29.7) से आगे है, हालांकि Llama 3.3 के 33.3 से थोड़ा पीछे। यह कोडिंग-फर्स्ट मॉडल नहीं है, पर अपना स्थान बनाए रखता है।
ज्ञान और रीज़निंग पर, Scout MMLU Pro पर 74.3 और GPQA Diamond पर 57.2 स्कोर करता है, दोनों पर हर अन्य ओपन-वेट मॉडल से आगे। ये बेंचमार्क्स लंबी-रूप, मल्टी-स्टेप रीज़निंग को प्राथमिकता देते हैं, इसलिए इस पैमाने पर Scout का मज़बूत प्रदर्शन उल्लेखनीय है।
अंत में, Scout की लंबी-कॉन्टेक्स्ट क्षमताएँ वास्तविक दुनिया की संभावनाएँ दिखाती हैं। MTOB (Massive Textual Overlap Benchmark) पर, जो मॉडल की अंग्रेज़ी और KGV, एक लो-रिसोर्स भाषा, के बीच अनुवाद क्षमता जाँचता है, यह हाफ-बुक टेस्ट पर 42.2/36.6 और फुल-बुक टेस्ट पर 39.7/36.3 स्कोर करता है। हाफ-बुक टेस्ट पर, Gemini 2.0 Flash-Lite 42.3 के साथ थोड़ा आगे है, लेकिन फुल-बुक पर Scout अंतर घटाता है और Gemini के 35.1/30.0 को पीछे छोड़ता है।
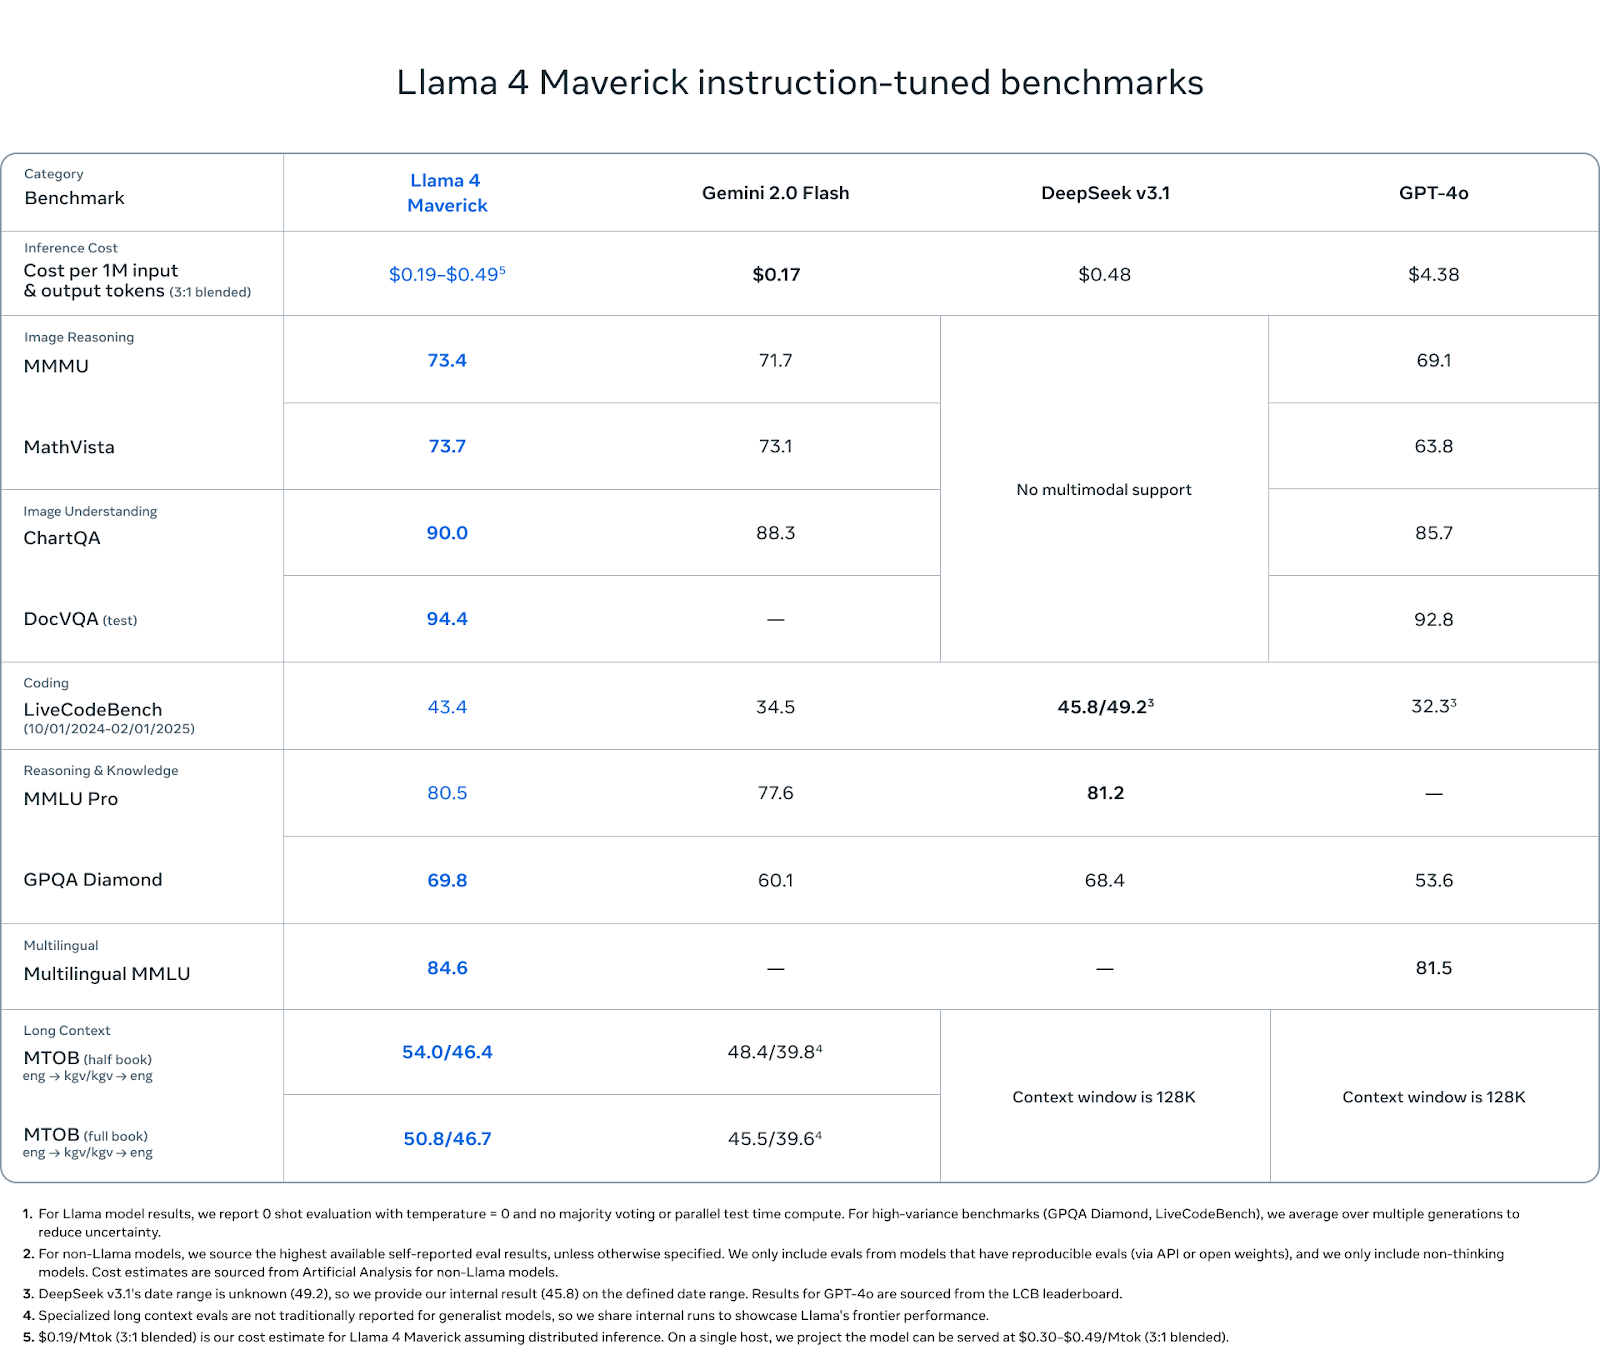
Maverick Llama 4 लाइनअप का सबसे संतुलित मॉडल है—और बेंचमार्क परिणाम इसे दर्शाते हैं। यह Scout की तरह कॉन्टेक्स्ट लंबाई की हदों या Behemoth के कच्चे पैमाने को नहीं साधता, पर मल्टीमॉडल रीज़निंग, कोडिंग, भाषा समझ और लंबी-कॉन्टेक्स्ट रिटेंशन जैसे हर अहम श्रेणी में निरंतर प्रदर्शन करता है।
स्रोत: MetaAI
इमेज रीज़निंग में, Maverick MMMU पर 73.4 और MathVista पर 73.7 स्कोर करता है, Gemini 2.0 Flash (71.7 और 73.1) और GPT-4o (69.1 और 63.8) से बेहतर। ChartQA (इमेज अंडरस्टैंडिंग) पर यह 90.0 स्कोर करता है, जो Gemini के 88.3 से थोड़ा ऊपर और GPT-4o के 85.7 से काफी ऊपर है। DocVQA में, Maverick 94.4 तक पहुँचता है, जो Scout के बराबर और GPT-4o के 92.8 से बेहतर है।
कोडिंग में, Maverick LiveCodeBench पर 43.4 स्कोर करता है, GPT-4o (32.3), Gemini Flash (34.5) से ऊपर और DeepSeek v3.1 के 45.8 के क़रीब।
रीज़निंग और ज्ञान पर, Maverick MMLU Pro पर 80.5 और GPQA Diamond पर 69.8 स्कोर करता है, फिर से Gemini Flash (77.6 और 60.1) और GPT-4o (कोई रिपोर्टेड MMLU Pro नहीं, GPQA पर 53.6) से बेहतर। MMLU Pro में DeepSeek v3.1 0.7 के मामूली अंतर से आगे है।
बहुभाषी समझ में भी Maverick अच्छा प्रदर्शन करता है, Multilingual MMLU पर 84.6 स्कोर करते हुए, जो Gemini के 81.5 से थोड़ा ऊपर है। इससे यह उन डेवलपर्स के लिए बढ़त देता है जो कई भाषाओं या भौगोलिक क्षेत्रों में काम करते हैं।
लंबी-कॉन्टेक्स्ट आकलनों (MTOB) में, Maverick हाफ-बुक टेस्ट पर 54.0/46.4 और फुल-बुक पर 50.8/46.7 स्कोर करता है—जो क्रमशः Gemini के 48.4/39.8 और 45.5/39.6 से काफी आगे है। ये स्कोर सुझाते हैं कि भले ही Maverick अपना कॉन्टेक्स्ट विंडो Scout जितनी जोर से न बताता हो, फिर भी उसे अपने विस्तारित विंडो से अर्थपूर्ण लाभ मिलता है।
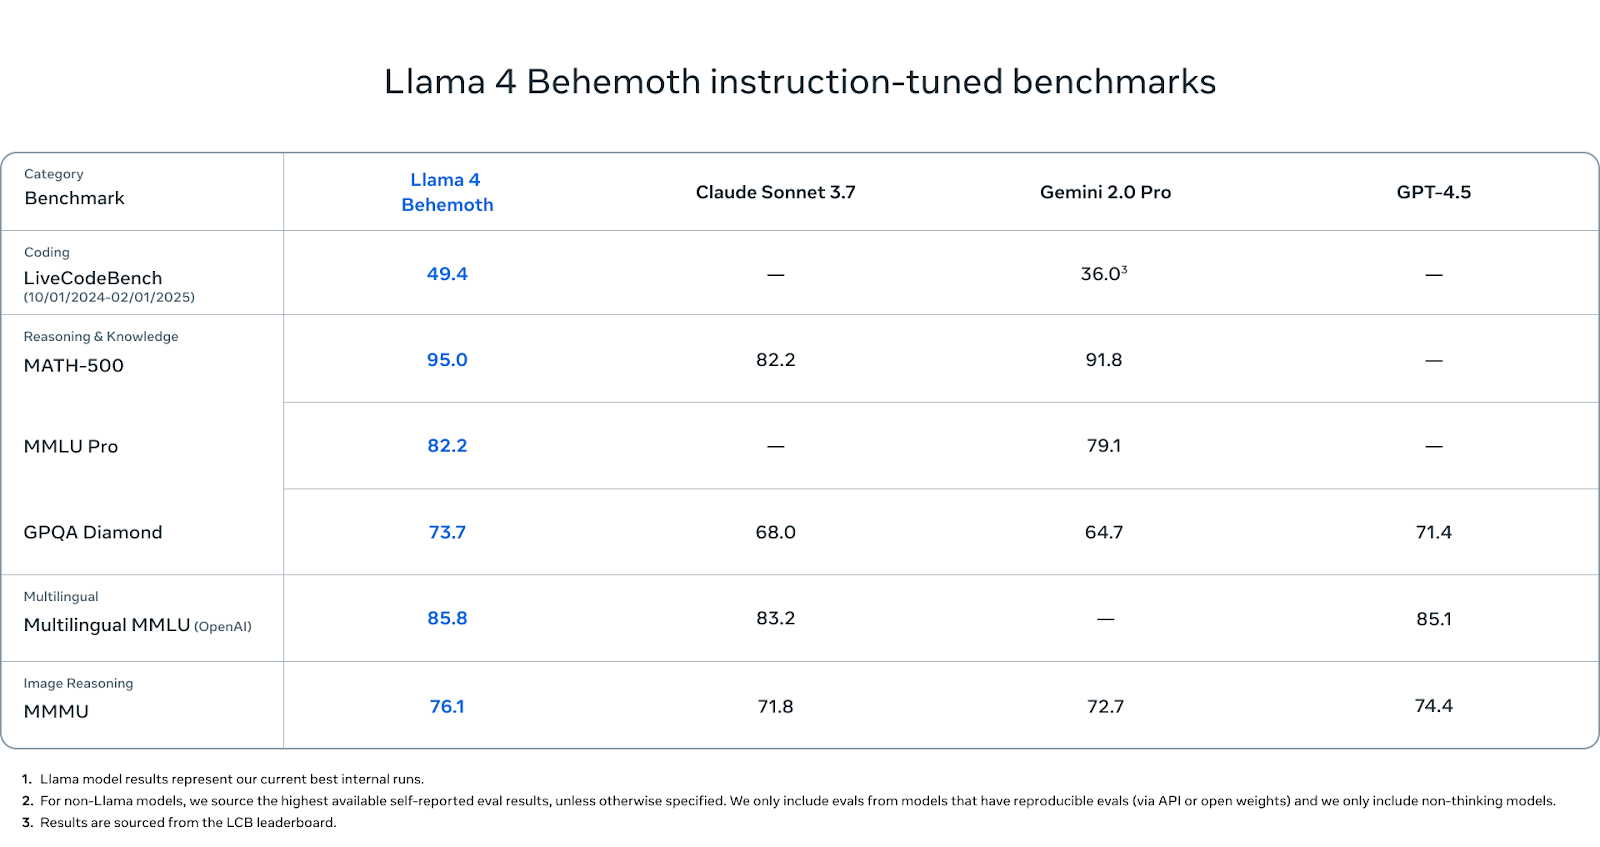
Behemoth अभी जारी नहीं हुआ है, लेकिन इसके बेंचमार्क आँकड़ों पर ध्यान देना चाहिए।
स्रोत: MetaAI
STEM-प्रधान बेंचमार्क्स पर, Behemoth असाधारण प्रदर्शन करता है। यह MATH-500 पर 95.0 स्कोर करता है—जो Gemini 2.0 Pro (91.8) से अधिक है और Claude Sonnet 3.7 (82.2) से काफ़ी ऊपर है। MMLU Pro पर Behemoth 82.2 स्कोर करता है, जबकि Gemini Pro 79.1 पर आता है (Claude का कोई रिपोर्टेड स्कोर नहीं)। और GPQA Diamond पर, जो तथ्यात्मक गहराई और सटीकता को पहचानता है, Behemoth 73.7 तक पहुँचता है, जो Claude (68.0), Gemini (64.7), और GPT-4.5 (71.4) से आगे है।
बहुभाषी समझ में, Behemoth Multilingual MMLU पर 85.8 स्कोर करता है, जो Claude Sonnet (83.2) और GPT-4.5 (85.1) से थोड़ा आगे है। ये स्कोर उन वैश्विक डेवलपर्स के लिए मायने रखते हैं जो अंग्रेज़ी के बाहर काम करते हैं, और Behemoth वर्तमान में इस श्रेणी में अग्रणी है।
इमेज रीज़निंग में, Behemoth MMMU पर 76.1 तक पहुँचता है, Gemini (71.8), Claude (72.7), और GPT-4.5 (74.4) को पीछे छोड़ते हुए। जबकि यह इसका मुख्य फोकस नहीं है, फिर भी यह अग्रणी मल्टीमॉडल मॉडलों के मुकाबले प्रतिस्पर्धी प्रदर्शन करता है।
कोड जनरेशन में, Behemoth LiveCodeBench पर 49.4 स्कोर करता है। यह Gemini 2.0 Pro (36.0) से काफ़ी ऊपर है।
Llama 4 Scout और Llama 4 Maverick दोनों अभी Meta के ओपन-वेट लाइसेंस के तहत उपलब्ध हैं। आप इन्हें आधिकारिक Llama वेबसाइट से सीधे डाउनलोड कर सकते हैं या Hugging Face के माध्यम से।
Meta की अपनी सेवाओं के माध्यम से मॉडलों तक पहुँचने के लिए, आप WhatsApp, Messenger, Instagram और Facebook पर Meta AI के साथ इंटरैक्ट कर सकते हैं। वर्तमान में एक्सेस के लिए Meta अकाउंट से लॉगिन आवश्यक है, और Meta AI के लिए कोई स्टैंडअलोन API एंडपॉइंट नहीं है—कम से कम अभी तक।
यदि आप मॉडलों को अपनी एप्लिकेशन्स या इन्फ्रास्ट्रक्चर में इंटीग्रेट करने की योजना बना रहे हैं, तो लाइसेंसिंग क्लॉज़ ध्यान में रखें: यदि आपके उत्पाद या सेवा के 700 मिलियन से अधिक मासिक सक्रिय उपयोगकर्ता हैं, तो आपको Meta से अलग अनुमति लेनी होगी। अन्यथा, ये मॉडल शोध, प्रयोग और अधिकांश व्यावसायिक उपयोग मामलों के लिए उपयोगी हैं।
Scout एकल GPU पर अभूतपूर्व कॉन्टेक्स्ट लंबाई लाता है। Maverick रीज़निंग, कोड और मल्टीमॉडल कार्यों में बड़े मॉडलों के सामने टिकता है। और Behemoth, जो अभी प्रशिक्षण में है, यह झलक देता है कि टीचर मॉडल कैसे अधिक कुशल और डिप्लॉयबल वेरिएंट्स को आकार दे सकते हैं।
ओपन-वेट स्पेस पहले से अधिक प्रतिस्पर्धी है। DeepSeek, Qwen, Gemma और जल्द ही OpenAI भी मज़बूत रिलीज़ के साथ आगे बढ़ रहे हैं। Llama 4 Meta के सतत प्रयास का विस्तार है, जो विविध उपयोग मामलों के लिए स्केलेबल, खुले तौर पर उपलब्ध मॉडल प्रदान करता है।
इन कोर्सों के साथ AI सीखें!
कोर्स
कोर्स
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखें