Cours
Travailler avec Llama 3
2 h
15.4K
Meta vient d’annoncer la suite de modèles Llama 4, qui comprend deux modèles déjà disponibles — Llama 4 Scout et Llama 4 Maverick — et un troisième encore en entraînement : Llama 4 Behemoth.
Les variantes Scout et Maverick sont disponibles dès maintenant, publiées ouvertement sous la licence open-weight habituelle de Meta — avec une réserve notable : si vos services dépassent 700 millions d’utilisateurs actifs mensuels, vous devez obtenir une licence distincte auprès de Meta, qui peut ou non vous être accordée à sa discrétion.
Llama Scout prend en charge une fenêtre de contexte de 10 millions de tokens, la plus grande de tous les modèles publiés publiquement. Llama Maverick est un modèle généraliste qui vise GPT-4o, Gemini 2.0 Flash et DeepSeek-V3. Llama Behemoth, encore en entraînement, sert de modèle enseignant à haute capacité.
Dans cet article d’introduction, je vous propose un tour d’horizon de la suite Llama 4. Notre équipe a déjà testé le modèle, et je vous recommande ces tutoriels si vous souhaitez aller plus loin :
Mise à jour : après environ un an de silence, Meta a publié son tout dernier LLM. Pour une vue d’ensemble, consultez notre guide sur Muse Spark.
Nous tenons nos lecteurs informés des dernières avancées en IA via The Median, notre newsletter gratuite du vendredi qui décode les actus clés de la semaine. Abonnez-vous et restez au fait en quelques minutes par semaine :
Llama 4 est la nouvelle famille de grands modèles de langage de Meta. La publication inclut deux modèles déjà disponibles : Llama 4 Scout et Llama 4 Maverick ; et un troisième, Llama 4 Behemoth, encore en entraînement.
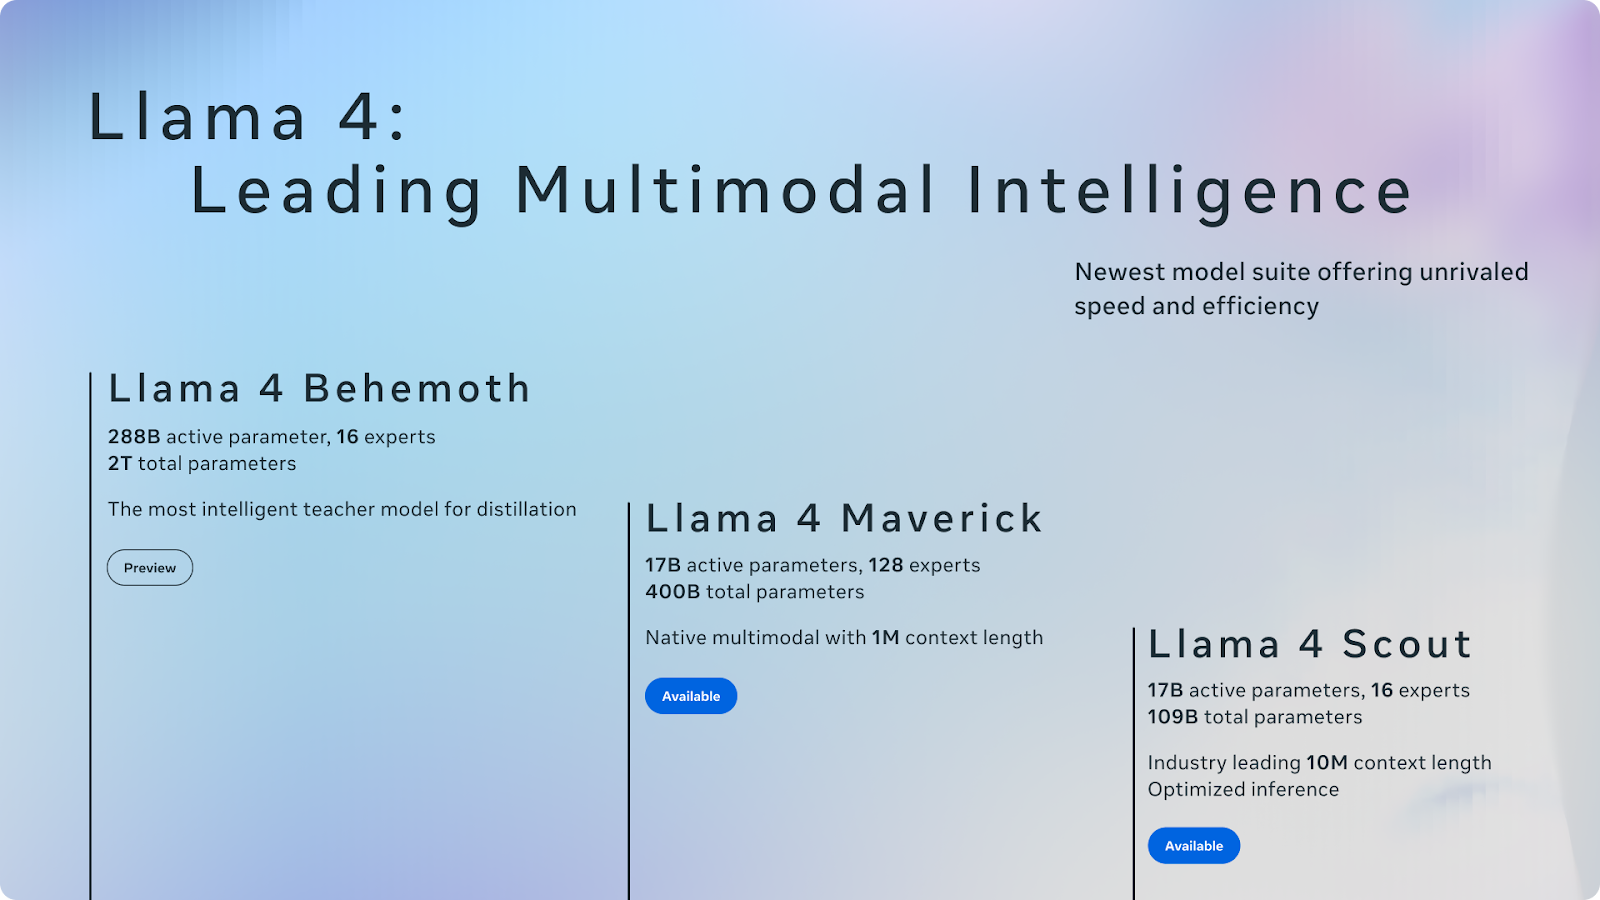
Source : Meta AI
Llama 4 introduit des améliorations substantielles. En particulier, il intègre une architecture mixture-of-experts (MoE), qui vise à améliorer l’efficacité et les performances en activant uniquement les composantes nécessaires pour une tâche donnée (nous y revenons juste après). Ce design marque une évolution vers des modèles d’IA plus extensibles et spécialisés.
Llama 4 prolonge la stratégie de Meta consistant à publier des modèles open-weight — mais avec une réserve. Si votre entreprise exploite des services totalisant plus de 700 millions d’utilisateurs actifs mensuels, vous devrez obtenir une licence distincte de Meta, qui peut ne pas être accordée. Malgré cette contrainte, la sortie reste un événement majeur dans l’écosystème open-weight, même si celui-ci a évolué très rapidement ces derniers mois.
Si Llama 2 et 3 ont un temps défini la catégorie, Llama 4 arrive désormais dans un champ bien plus concurrentiel. DeepSeek s’est imposé avec de fortes capacités de raisonnement. La série Qwen d’Alibaba s’illustre sur des benchmarks multilingues et de code. Les modèles Gemma de Google avancent sur le même terrain avec des architectures plus petites et efficaces. Et tout récemment, OpenAI a annoncé son intention de publier un modèle open-weight, une inflexion impensable il y a un an.
Voyons maintenant les détails de chaque modèle.
Llama 4 Scout est le modèle le plus léger de la nouvelle suite, mais c’est sans doute le plus intrigant. Il fonctionne sur un seul GPU H100 et prend en charge une fenêtre de contexte de 10 millions de tokens. Cela en fait le modèle open-weight le plus gourmand en contexte à ce jour et potentiellement le plus utile pour des tâches comme la synthèse multi-documents, le raisonnement sur de longs codes et l’analyse d’activité.
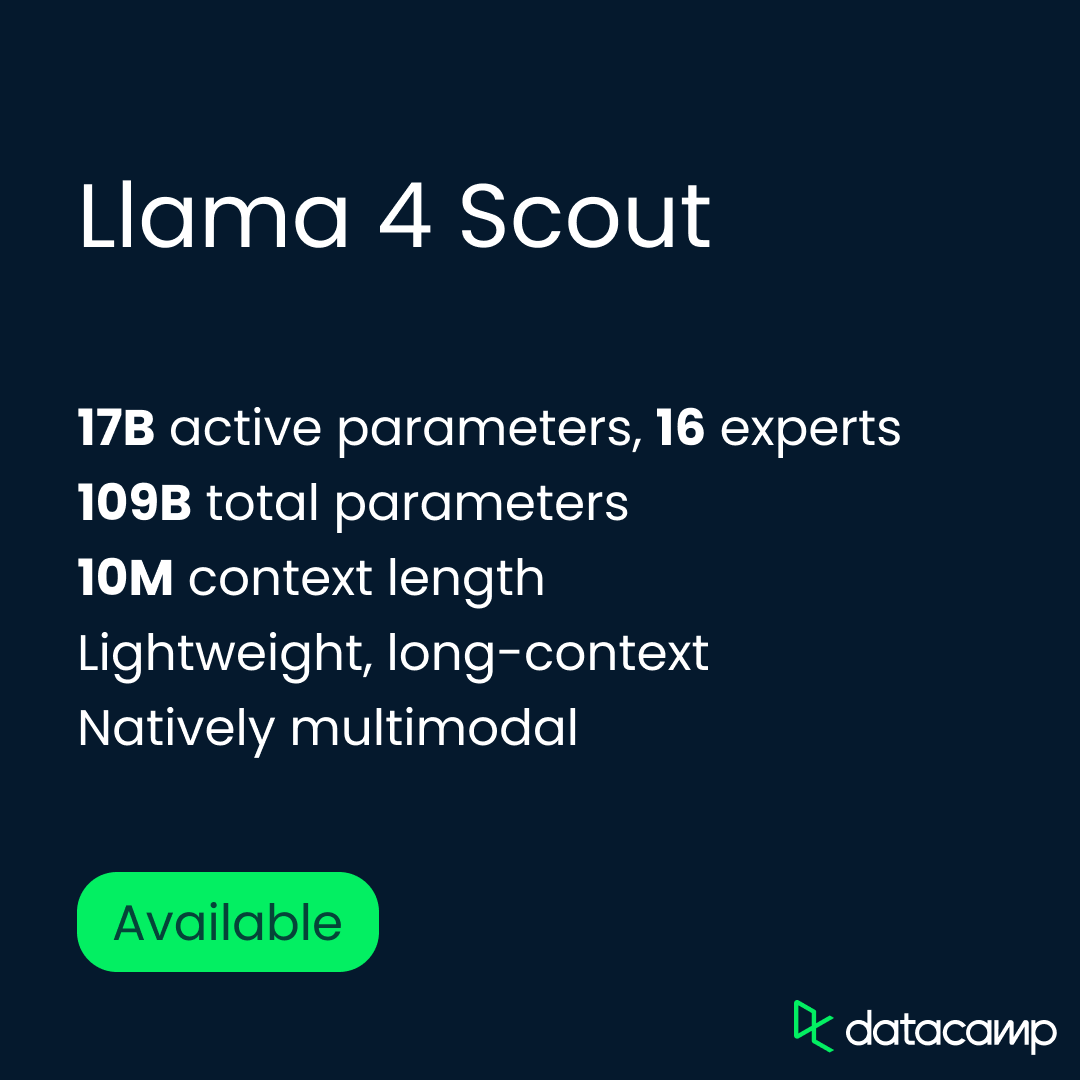
Scout compte 17 milliards de paramètres actifs, organisés via 16 experts, pour un total d’environ 109 milliards de paramètres. Il a été pré-entraîné et post-entraîné avec une fenêtre de contexte de 256 K, mais Meta affirme qu’il généralise bien au-delà (à vérifier). En pratique, cela ouvre la voie à des workflows englobant des bases de code entières, des historiques de session ou des documents juridiques — le tout traité en un seul passage avant.
Sur le plan architectural, Scout s’appuie sur le cadre MoE de Meta, où seul un sous-ensemble de paramètres s’active par token — contrairement aux modèles denses comme GPT-4o, où tous les paramètres sont activés. Résultat : efficacité de calcul et grande scalabilité.
Au-delà de l’architecture, Meta met en avant les capacités multimodales de Scout. Il a été pré-entraîné sur des données texte, image et vidéo avec une fusion précoce, ce qui lui permet de gérer nativement des combinaisons d’invites textuelles et visuelles. Sur des tâches riches en images comme l’ancrage visuel et la VQA (visual question answering), Scout surpasse tous les précédents modèles Llama — et tient tête à des systèmes bien plus grands.
En bref, Scout est conçu pour la polyvalence et l’échelle. Il fonctionne efficacement, accepte plus d’entrée que tout autre modèle open-source publié auparavant et se montre performant sur les tâches texte et image. Nous testerons bientôt cette limite de contexte à 10 M — et nous vous ferons un retour.
Llama 4 Maverick est le généraliste de la gamme : un modèle multimodal de grande ampleur, conçu pour la performance en conversation, raisonnement, compréhension d’images et code. Tandis que Scout repousse les limites de longueur de contexte, Maverick privilégie une qualité d’output équilibrée et élevée sur l’ensemble des tâches. C’est la réponse de Meta à GPT-4o, DeepSeek-V3 et Gemini 2.0 Flash.
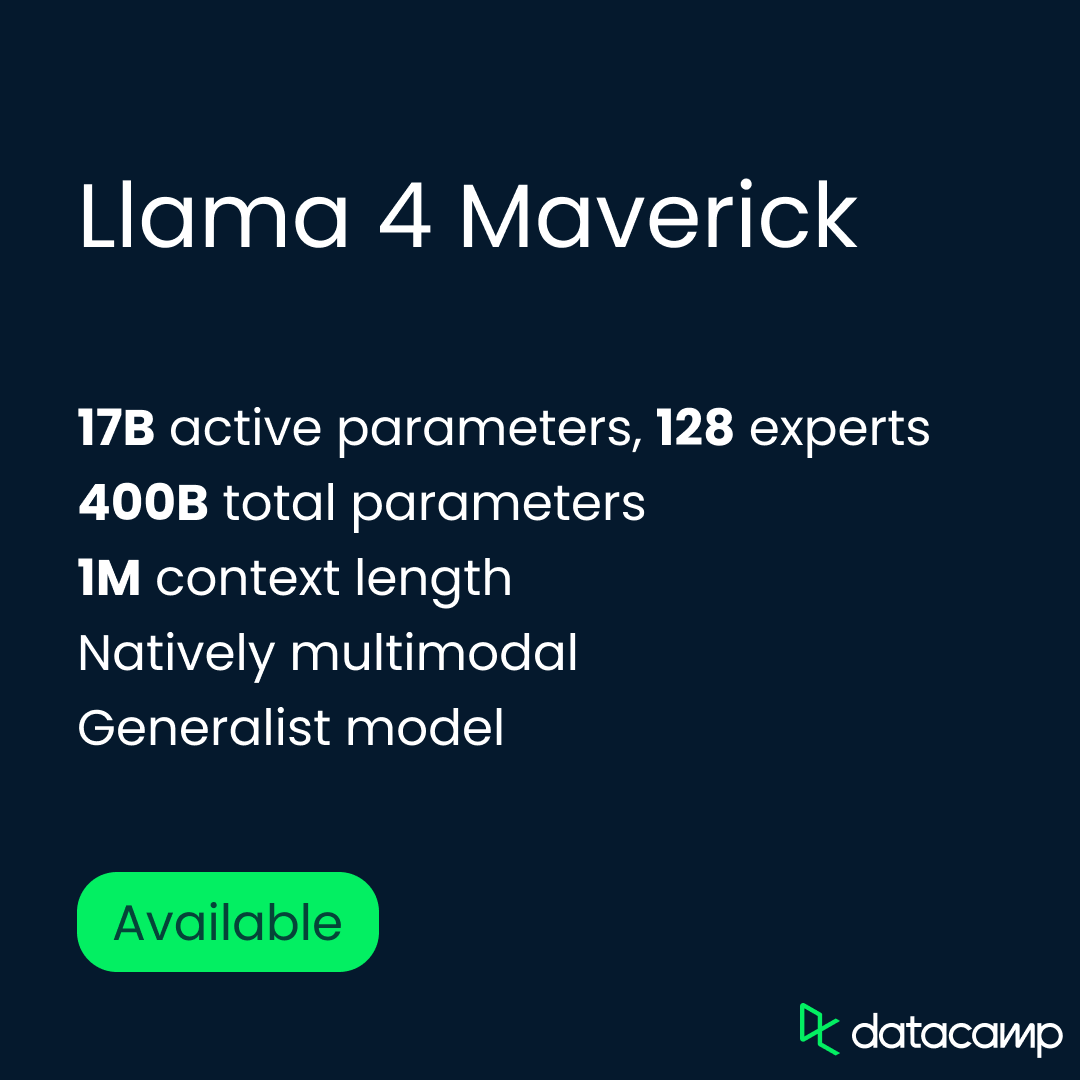
Maverick dispose du même nombre de 17 milliards de paramètres actifs que Scout, mais avec une configuration MoE plus vaste : 128 experts et un total d’environ 400 milliards de paramètres. Comme Scout, il utilise une architecture MoE qui n’active qu’une partie du modèle par token — réduisant les coûts d’inférence tout en augmentant la capacité. Le modèle tourne sur un hôte H100 DGX unique, mais peut aussi être déployé en inférence distribuée pour des applications à grande échelle.
Meta a adopté une approche différente pour le post-entraînement, mêlant fine-tuning supervisé léger, apprentissage par renforcement en ligne et optimisation directe des préférences. L’objectif : affûter les performances sur des prompts difficiles sans surcontraindre le modèle. Pour ce faire, Meta a écarté plus de 50 % des exemples d’entraînement jugés « faciles » par d’anciennes versions de Llama et a bâti un programme de formation axé sur des tâches plus ardues de raisonnement, de codage et multimodales.
Maverick a également été co-distillé depuis Llama 4 Behemoth, le modèle interne bien plus grand de Meta, ce qui a permis d’améliorer les performances sans coûts d’entraînement additionnels. D’après Meta, cette chaîne de distillation a entraîné une nette progression du raisonnement et de la qualité en conversation.
Llama 4 Behemoth est à ce jour le modèle le plus puissant et le plus volumineux de Meta — mais il n’est pas encore disponible. Toujours en entraînement, Behemoth n’est pas un modèle de raisonnement au même sens que DeepSeek-R1 ou o3 d’OpenAI, qui sont conçus et optimisés pour des raisonnements multi-étapes de type chain-of-thought.
D’après les informations disponibles, il ne semble pas non plus conçu comme un produit d’usage direct. Il agit plutôt comme un modèle enseignant, utilisé pour distiller et façonner Scout et Maverick. Une fois publié, il pourrait aussi permettre à d’autres de distiller leurs propres modèles.
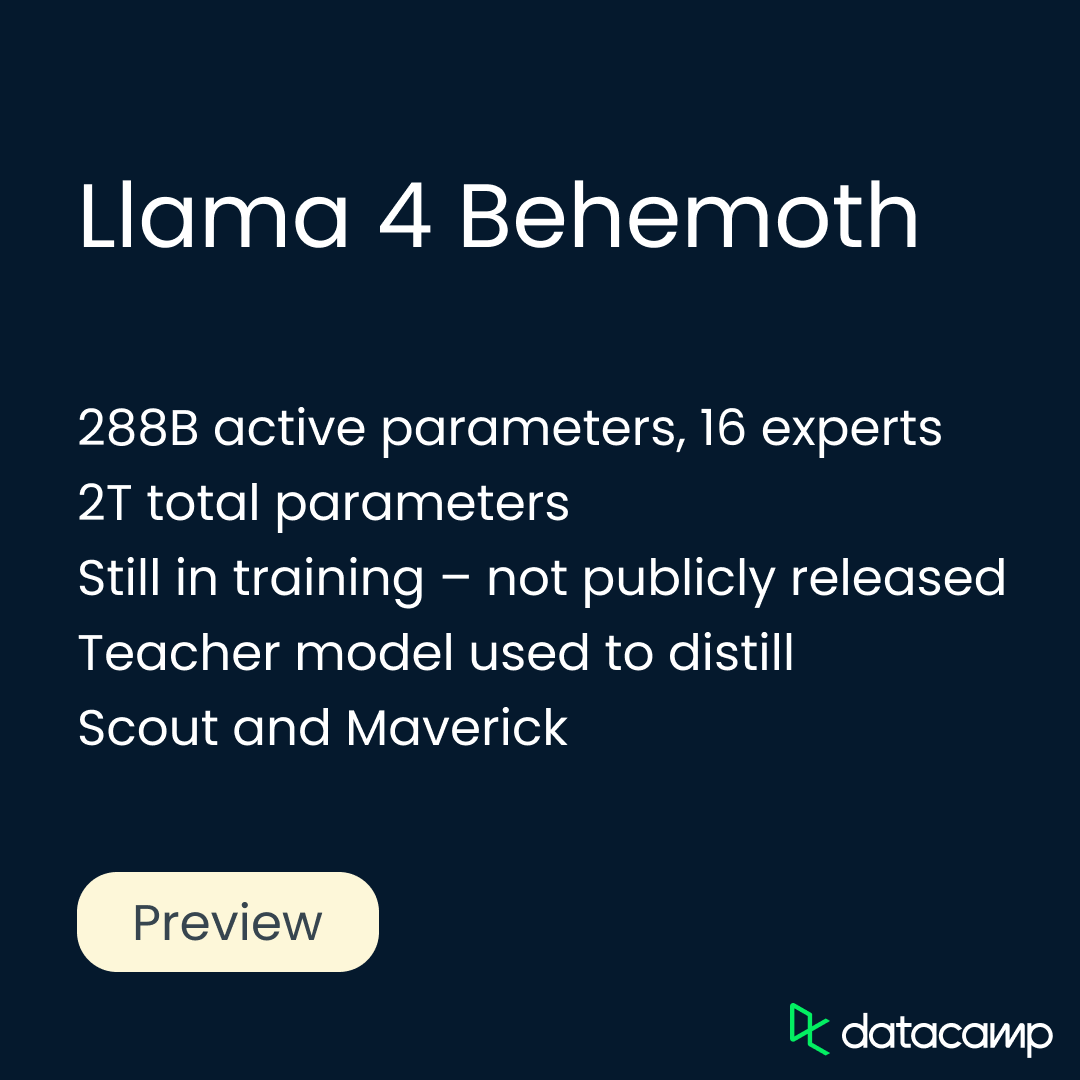
Behemoth compte 288 milliards de paramètres actifs, organisés via 16 experts, pour un total avoisinant les 2 billions de paramètres. Meta a conçu une infrastructure d’entraînement entièrement nouvelle pour supporter Behemoth à cette échelle. Elle introduit de l’apprentissage par renforcement asynchrone, un échantillonnage du programme basé sur la difficulté des prompts, et une nouvelle fonction de perte de distillation qui équilibre dynamiquement cibles « molles » et « dures ».
Le post-entraînement de Behemoth a également nécessité une recette différente. Meta a écarté plus de 95 % des exemples SFT pour se concentrer sur des prompts difficiles et a orienté l’apprentissage par renforcement vers des scénarios complexes de raisonnement, de codage et multilingues. L’échantillonnage à partir d’instructions système variées a aidé le modèle à généraliser, tandis qu’un filtrage dynamique éliminait les prompts à faible valeur durant l’entraînement RL.
Meta a publié des résultats de benchmarks internes pour chacun des modèles Llama 4, les comparant aux précédentes variantes Llama ainsi qu’à plusieurs modèles open-weight concurrents et modèles de pointe.
Dans cette section, je vous présente les points saillants des benchmarks pour Scout, Maverick et Behemoth, selon les chiffres de Meta. Comme toujours, prudence avec les benchmarks auto-reportés ; ils offrent néanmoins un premier aperçu utile des performances de chaque modèle selon les tâches et de leur position dans le paysage actuel. Commençons par Scout.
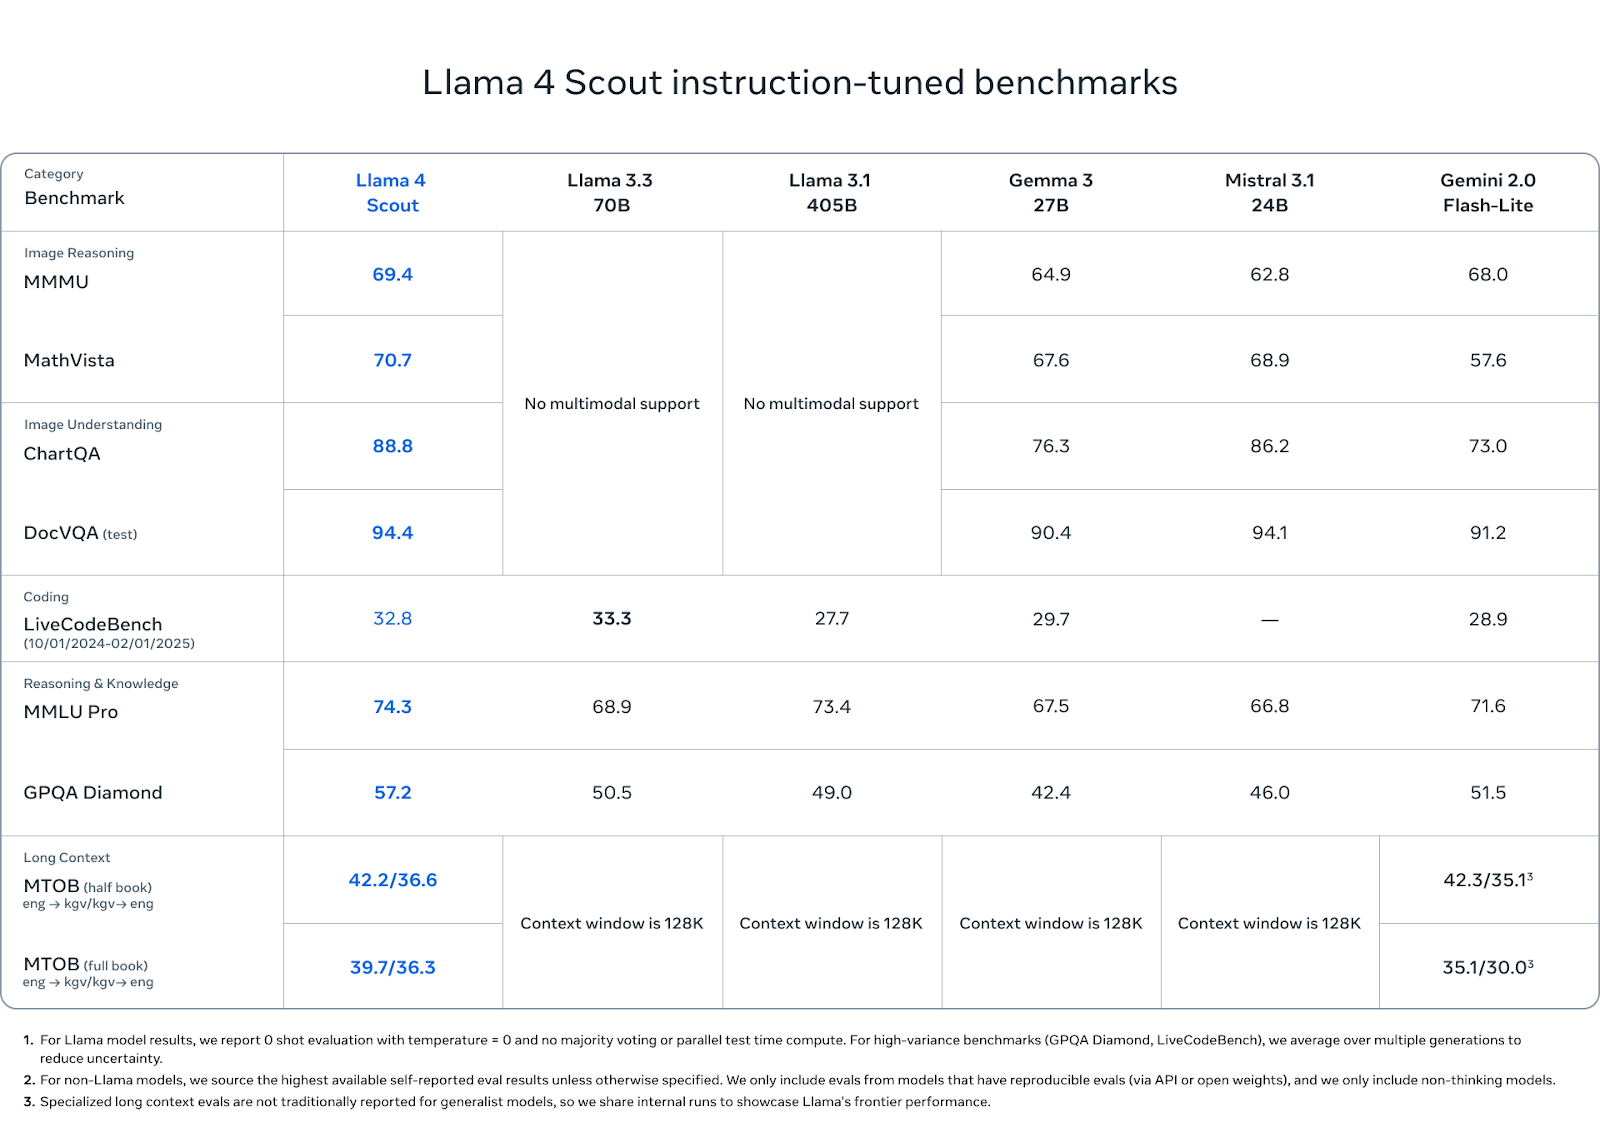
Llama 4 Scout s’en sort très bien sur un mélange de benchmarks de raisonnement, de code et multimodaux — d’autant plus au vu de son nombre de paramètres actifs réduit et de son empreinte sur un seul GPU.
Source : MetaAI
Sur la compréhension d’images, Scout devance ses concurrents : 88,8 sur ChartQA et 94,4 sur DocVQA (test), mieux que Gemini 2.0 Flash-Lite (73,0 et 91,2) et au niveau ou légèrement au-dessus de Mistral 3.1 et Gemma 3 27B.
Sur les benchmarks de raisonnement visuel comme MMMU (69,4) et MathVista (70,7), il mène aussi la danse côté open-weight, devant Gemma 3 (64,9 ; 67,6), Mistral 3.1 (62,8 ; 68,9) et Gemini Flash-Lite (68,0 ; 57,6).
En code, Scout obtient 32,8 sur LiveCodeBench, devant Gemini Flash-Lite (28,9) et Gemma 3 27B (29,7), mais légèrement derrière Llama 3.3 (33,3). Ce n’est pas un modèle prioritairement axé code, mais il tient son rang.
Sur la connaissance et le raisonnement, Scout atteint 74,3 sur MMLU Pro et 57,2 sur GPQA Diamond, surpassant tous les autres modèles open-weight sur les deux. Ces benchmarks favorisent le raisonnement long et multi-étapes, la performance de Scout est donc notable, surtout à cette échelle.
Enfin, ses capacités long-contexte montrent un vrai potentiel. Sur MTOB (Massive Textual Overlap Benchmark), qui évalue la capacité à traduire entre l’anglais et le KGV, une langue à faibles ressources, il obtient 42,2/36,6 sur le test demi-livre et 39,7/36,3 sur le test livre entier. Sur le demi-livre, Gemini 2.0 Flash-Lite garde un léger avantage avec 42,3, mais Scout comble l’écart sur le livre entier, dépassant les 35,1/30,0 de Gemini.
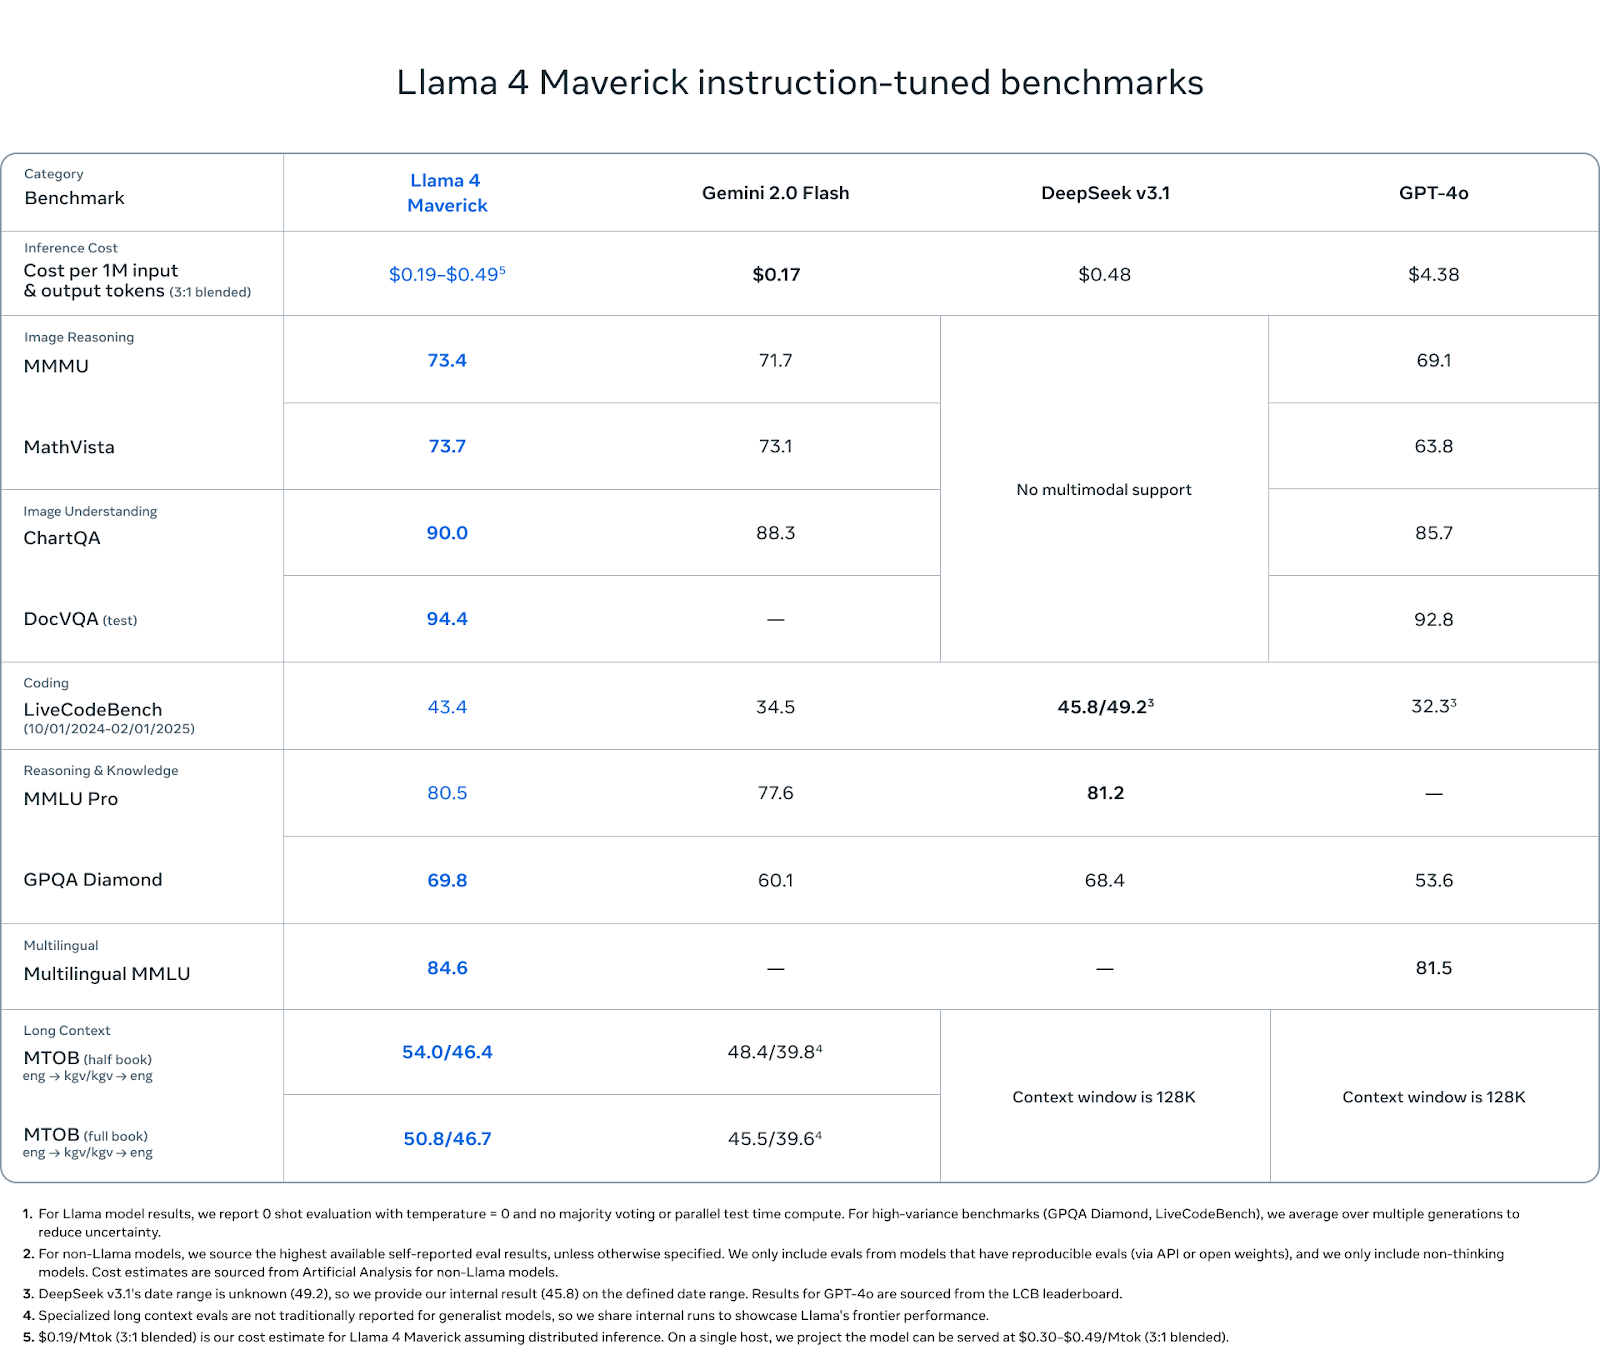
Maverick est le modèle le plus équilibré de la gamme Llama 4 — et les benchmarks le confirment. Sans viser les extrêmes de contexte de Scout ni l’échelle brute de Behemoth, il reste constant dans toutes les catégories clés : raisonnement multimodal, codage, compréhension linguistique et rétention long-contexte.
Source : MetaAI
En raisonnement visuel, Maverick obtient 73,4 sur MMMU et 73,7 sur MathVista, devant Gemini 2.0 Flash (71,7 et 73,1) et GPT-4o (69,1 et 63,8). Sur ChartQA (compréhension d’images), il atteint 90,0, légèrement au-dessus des 88,3 de Gemini et nettement au-dessus des 85,7 de GPT-4o. Sur DocVQA, Maverick atteint 94,4, à l’égal de Scout et devant les 92,8 de GPT-4o.
En codage, Maverick obtient 43,4 sur LiveCodeBench, au-dessus de GPT-4o (32,3), de Gemini Flash (34,5) et proche des 45,8 de DeepSeek v3.1.
Sur le raisonnement et la connaissance, Maverick atteint 80,5 sur MMLU Pro et 69,8 sur GPQA Diamond, là encore devant Gemini Flash (77,6 et 60,1) et GPT-4o (pas de score MMLU Pro, 53,6 sur GPQA). DeepSeek v3.1 garde 0,7 point d’avance sur MMLU Pro.
Maverick se montre également performant en compréhension multilingue, avec 84,6 sur Multilingual MMLU, légèrement au-dessus des 81,5 de Gemini. Un atout pour les développeurs qui travaillent sur plusieurs langues ou zones géographiques.
Sur les évaluations long-contexte (MTOB), Maverick obtient 54,0/46,4 sur le demi-livre et 50,8/46,7 sur le livre entier — nettement devant les 48,4/39,8 et 45,5/39,6 de Gemini. Ces scores suggèrent que, même s’il ne met pas autant en avant sa longueur de contexte que Scout, il profite bel et bien de sa fenêtre étendue.
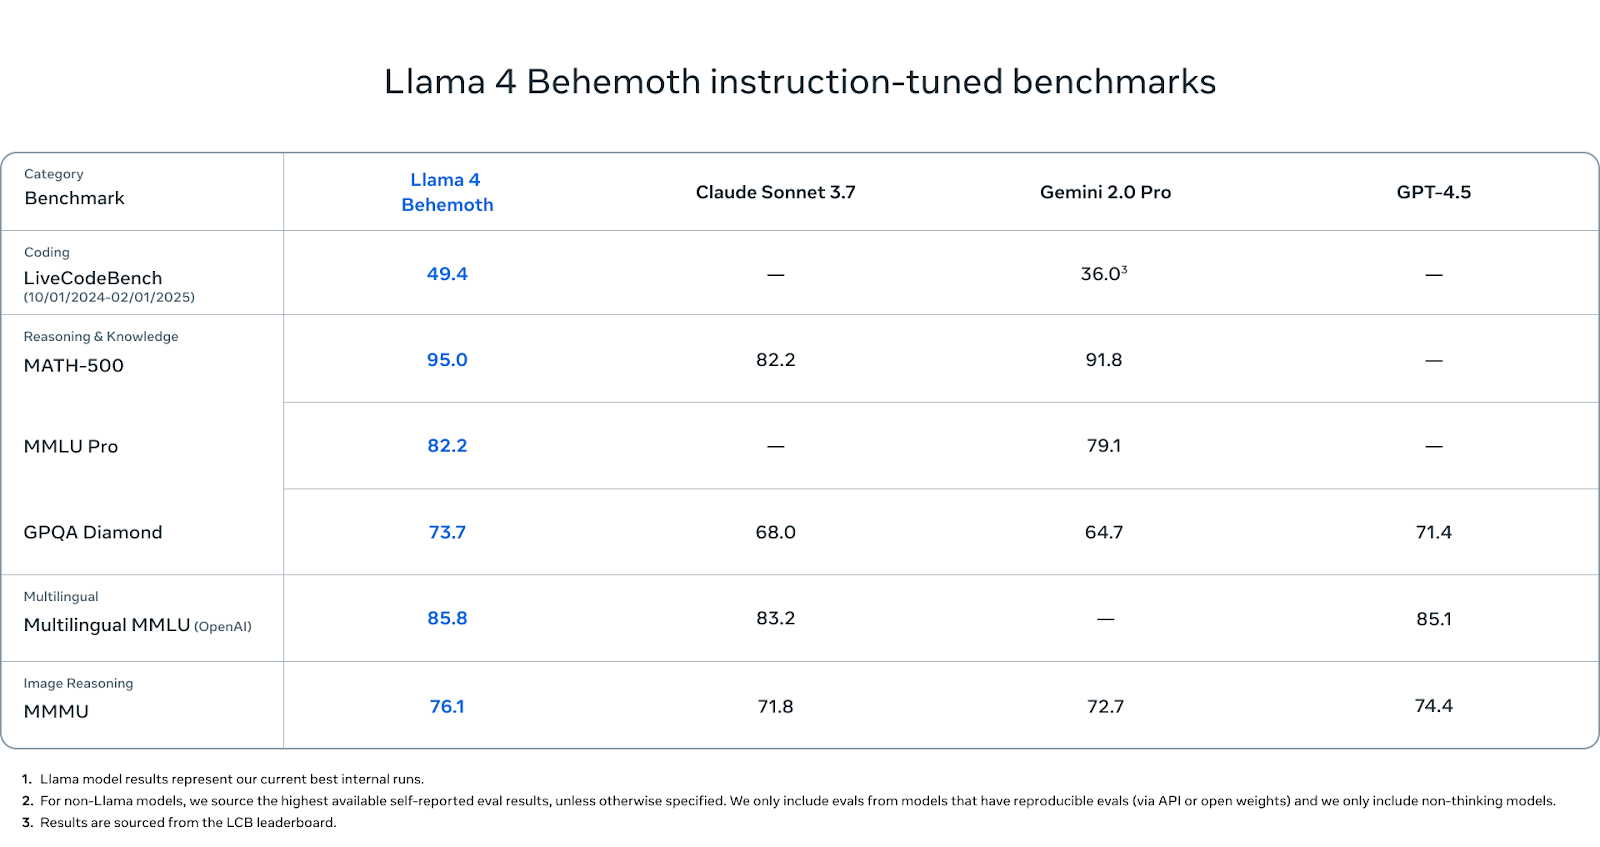
Behemoth n’est pas encore publié, mais ses chiffres de benchmark valent le détour.
Source : MetaAI
Sur les benchmarks à forte composante STEM, Behemoth excelle. Il atteint 95,0 sur MATH-500 — au-dessus de Gemini 2.0 Pro (91,8) et nettement devant Claude Sonnet 3.7 (82,2). Sur MMLU Pro, Behemoth marque 82,2, quand Gemini Pro obtient 79,1 (pas de score rapporté pour Claude). Et sur GPQA Diamond, un autre benchmark qui valorise la profondeur factuelle et la précision, Behemoth atteint 73,7, devant Claude (68,0), Gemini (64,7) et GPT-4.5 (71,4).
En compréhension multilingue, Behemoth obtient 85,8 sur Multilingual MMLU, légèrement devant Claude Sonnet (83,2) et GPT-4.5 (85,1). Des scores importants pour les développeurs à l’échelle mondiale, et Behemoth mène actuellement cette catégorie.
En raisonnement visuel, Behemoth atteint 76,1 sur MMMU, devant Gemini (71,8), Claude (72,7) et GPT-4.5 (74,4). Même si ce n’est pas son axe principal, il reste compétitif face aux modèles multimodaux leaders.
En génération de code, Behemoth obtient 49,4 sur LiveCodeBench. Un score nettement supérieur à Gemini 2.0 Pro (36,0).
Llama 4 Scout et Llama 4 Maverick sont tous deux disponibles dès maintenant sous la licence open-weight de Meta. Vous pouvez les télécharger directement depuis le site Llama officiel ou via Hugging Face.
Pour accéder aux modèles via les services de Meta, vous pouvez interagir avec Meta AI sur plusieurs plateformes : WhatsApp, Messenger, Instagram et Facebook. L’accès nécessite actuellement une connexion avec un compte Meta, et il n’existe pas d’endpoint API autonome pour Meta AI — du moins pas encore.
Si vous envisagez d’intégrer les modèles à vos propres applications ou à votre infrastructure, gardez en tête la clause de licence : si votre produit ou service dépasse les 700 millions d’utilisateurs actifs mensuels, vous devrez obtenir une autorisation distincte de Meta. Les modèles restent par ailleurs utilisables pour la recherche, l’expérimentation et la plupart des usages commerciaux.
Scout introduit une longueur de contexte inédite sur un seul GPU. Maverick rivalise avec des modèles plus grands sur les tâches de raisonnement, de code et multimodales. Et Behemoth, encore en entraînement, montre comment des modèles enseignants peuvent façonner des variantes plus efficaces et déployables.
L’espace open-weight n’a jamais été aussi concurrentiel. DeepSeek, Qwen, Gemma, et bientôt OpenAI, avancent tous avec des sorties solides. Llama 4 s’inscrit dans la continuité de l’effort de Meta pour proposer des modèles extensibles et ouverts pour une large gamme d’usages.
Formez-vous à l’IA avec ces cours !
Cours
Cours
Cursus