
Kursus
Pengantar Penulisan Fungsi di R
4 jam
53.9K
Fungsi biaya berperan sebagai "pencatat skor" dari keputusan. Fungsi ini mengukur seberapa jauh prediksi menyimpang dari nilai aktual suatu dataset dibandingkan dengan nilai prediksi. Dalam machine learning, fungsi ini membimbing algoritma optimisasi untuk meminimalkan galat dan meningkatkan akurasi model.
Pada artikel ini, kita membangun intuisi selangkah demi selangkah. Kita mulai dari aplikasi ekonomi, di mana fungsi biaya menggambarkan trade-off antara produksi dan efisiensi. Lalu kita beralih ke machine learning, di mana fungsi ini mendorong proses pelatihan model. Selanjutnya, kita meninjau optimisasi sebagai jembatan di antara keduanya. Terakhir, kita mengeksplorasi contoh dunia nyata.
Fungsi biaya fundamental bagi optimisasi dan evaluasi. Mari kita definisikan fungsi biaya secara matematis dan meninjau sifat-sifat kuncinya.
Sebuah fungsi biaya (juga disebut "fungsi galat") memetakan satu atau lebih variabel input menjadi satu nilai numerik yang merepresentasikan "biaya" dari sebuah keputusan atau prediksi. Dalam machine learning, ini biasanya didefinisikan sebagai rata-rata dari fungsi loss pada seluruh sampel dalam dataset.
Fungsi biaya memainkan dua peran: berfungsi sebagai objektif yang diminimalkan oleh algoritma optimisasi, dan sebagai metrik evaluasi untuk mengukur performa model.
Mari melihat fungsi biaya sebagai objektif. Untuk setiap rumah, fungsi loss menghukum selisih antara harga jual aktual dan harga yang diprediksi. Fungsi biaya mengagregasikan penalti ini di seluruh rumah:
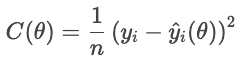
Biaya yang lebih kecil menunjukkan kesesuaian keseluruhan yang lebih baik, sedangkan biaya yang lebih besar menunjukkan galat rata-rata yang lebih tinggi. Optimizer menyesuaikan parameter untuk meminimalkan biaya ini.
Sebagai metrik evaluasi, fungsi biaya mengukur kinerja. Misalnya, sebuah pengklasifikasi dapat dievaluasi dengan akurasi, atau recall, atau metrik mana pun yang sesuai untuk aplikasinya. Dengan demikian, fungsi biaya menyediakan cara untuk menilai keberhasilan.
Tiga sifat matematis berikut sangat relevan.
Bersama-sama, sifat-sifat ini menentukan seberapa mudah suatu fungsi biaya dioptimalkan. Ketika salah satu sifat ini tidak terpenuhi, teknik khusus mungkin diperlukan untuk mengompensasi.
Fungsi biaya menggambarkan hubungan antara kuantitas output dan total biaya produk. Ini adalah alat penting untuk memahami perilaku perusahaan, strategi penetapan harga, dan analisis laba.
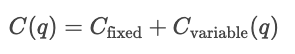
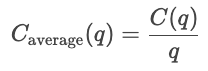
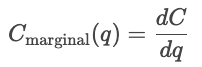
Kurva biaya menunjukkan bagaimana biaya bervariasi sebagai fungsi dari total kuantitas yang diproduksi. Biaya tetap konstan, sehingga ditampilkan sebagai garis horizontal, sementara biaya variabel meningkat sebagai fungsi jumlah unit yang diproduksi.
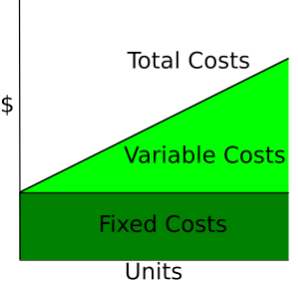
Wikipedia: Cost Curve
Dalam jangka pendek, setidaknya satu input, seperti modal atau ukuran pabrik, ditahan konstan, dan input lainnya bervariasi. Biaya jangka pendek mengukur seberapa efisien suatu perusahaan beroperasi dengan pengaturan saat ini. Jadi, untuk kuantitas q tertentu, biaya dalam jangka pendek adalah jumlah dari biaya tetap dan biaya variabel yang bergantung pada kuantitas.
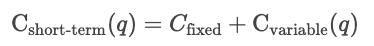
Dalam jangka pendek, optimalkan dalam kapasitas saat ini.
Dalam jangka panjang, semua input bersifat variabel. Perusahaan mungkin menskalakan proses produksinya. Biaya jangka panjang mengukur efisiensi ketika kapasitas itu sendiri dapat berubah, menunjukkan biaya minimum yang dapat dicapai untuk setiap tingkat output
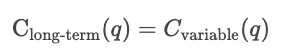
Dalam jangka panjang, optimalkan dengan memilih kapasitas optimal itu sendiri.
Fungsi biaya digunakan untuk menganalisis perilaku penetapan harga. Perusahaan membandingkan kurva biaya dengan harga pasar untuk membantu memutuskan apakah perlu memperluas atau mengurangi produksi. Jika biaya marjinal berada di bawah harga pasar, memproduksi lebih banyak meningkatkan laba; jika biaya marjinal kurang dari harga pasar, memproduksi lebih banyak unit justru menambah biaya.
Fungsi biaya juga digunakan dalam strategi penetapan harga. Fungsi ini menentukan harga minimum yang layak untuk dibebankan perusahaan. Perusahaan mungkin mengenakan harga di atas biaya marjinal untuk memaksimalkan laba, atau lebih dekat ke MC di industri yang sangat kompetitif. Dengan demikian, analisis biaya menginformasikan penetapan harga impas, penetapan harga biaya-plus, dan strategi penetapan harga dinamis.
Titik impas terjadi ketika total pendapatan sama dengan total biaya.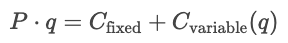
Pada titik ini, perusahaan menutup semua biaya tetapi tidak memperoleh laba. Memproduksi lebih sedikit menghasilkan kerugian, sedangkan memproduksi lebih banyak menghasilkan laba.
Laba adalah selisih antara total pendapatan dan total biaya.
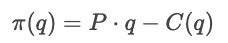
Jika pendapatan marjinal melebihi biaya marjinal (MR > MC), perusahaan akan meningkatkan output untuk menghasilkan lebih banyak laba. Jika pendapatan marjinal kurang dari biaya marjinal (MR < MC), perusahaan akan menurunkan output untuk memperoleh tambahan laba. Perusahaan memaksimalkan laba dengan memproduksi pada kuantitas di mana MR = MC.
Untuk informasi lebih lanjut tentang keuangan, saya sarankan melihat sumber daya DataCamp berikut.
Dalam aplikasi ML, fungsi biaya mengkuantifikasi residual (selisih antara nilai prediksi dan nilai aktual) di seluruh dataset. Bagian ini membahas keluarga utama fungsi biaya dan bagaimana fungsi tersebut membentuk perilaku model.
Dalam konteks machine learning, tujuan regresi (tidak harus regresi linear) adalah memprediksi nilai kontinu. Fungsi loss regresi mengukur galat antara nilai aktual dan prediksi untuk sampel tertentu; fungsi biaya mengagregasikan fungsi loss menjadi suatu kuantitas keseluruhan. Proses optimisasi menggunakan fungsi biaya untuk meminimalkan galat keseluruhan.
Kita berfokus pada empat keluarga utama fungsi biaya: mean absolute error (MAE), mean squared error (MSE), root mean square error (RMSE), dan Huber loss.
Fungsi biaya yang berbeda menangani galat secara berbeda. Secara efektif, fungsi ini mendefinisikan seberapa keras menghukum deviasi antara nilai prediksi dan aktual. MAE menerapkan penalti seragam, mewakili perilaku median dan ketangguhan terhadap outlier. MSE menguadratkan setiap residual, membuat galat besar mendominasi dan dihukum lebih berat. Huber loss memadukan keduanya, menggunakan penalti kuadratik untuk galat kecil dan linear untuk galat besar (melampaui ambang δ).
Mean absolute error didefinisikan sebagai rata-rata dari nilai absolut residual.
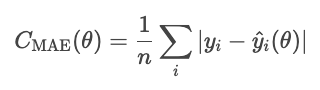
MAE memperlakukan semua deviasi secara setara, sehingga tidak terlalu dipengaruhi oleh outlier dibandingkan metode lain yang akan kita lihat, seperti MSE. Namun, galat absolut kurang nyaman secara matematis dan membuat optimisasi berbasis gradien lebih sulit.
Catatan tentang parameter fungsi. θ merepresentasikan parameter model. Optimizer mengendalikan biaya berdasarkan parameter ini, bukan langsung pada nilai prediksi yang timbul darinya. Karena itu, kita menulis biaya sebagai fungsi dari θ, bukan Ŷi.
Mean squared error (MSE) diberikan oleh rumus berikut.
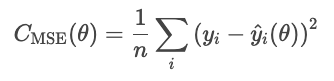
Mengkuadratkan residual membesar-besarkan galat besar, yang membuat MSE sensitif terhadap outlier. Namun, bentuk galat ini terdiferensial dan konveks, sehingga ramah untuk optimisasi.
Kelemahan MSE adalah satuannya dikudratkan. Misalnya, dalam model regresi harga rumah, loss dinyatakan dalam dolar kuadrat, yang kurang intuitif. RMSE mengoreksi masalah ini dengan mengambil akar kuadrat dari MSE.
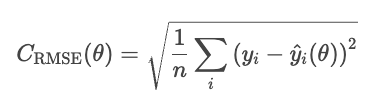
RMSE berperilaku mirip dengan MSE namun dengan satuan yang sama dengan permasalahan (dolar, bukan dolar kuadrat).
Huber loss kurang sensitif terhadap outlier dalam data dibandingkan MSE (atau RMSE). Ia menggabungkan MAE dan MSE, dan mengendalikan transisi dengan parameter δ.
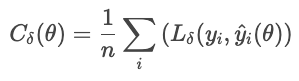
dengan
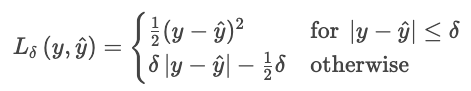
Rumus ini mencegah beberapa residual besar mendominasi loss. Huber loss adalah pilihan baik untuk data dunia nyata yang bising, di mana Anda mengharapkan observasi ekstrem sesekali.
Klasifikasi memprediksi kategori diskret. Fungsi biaya ini membandingkan distribusi probabilitas dengan label sebenarnya, menghukum prediksi yang salah atau terlalu percaya diri.
Cross-entropy loss (log loss) memberi penghargaan ketika model yakin dan benar, serta menghukum ketika model yakin namun salah.
Untuk pengklasifikasi yang menghasilkan probabilitas murni Ŷ, kemungkinan label yang teramati Y adalah
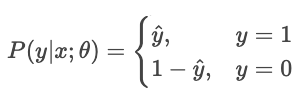
Maximum-likelihood estimation (MLE) memaksimalkan likelihood ini di seluruh sampel.
Mari ubah gagasan ini menjadi meminimalkan biaya. Meminimalkan sama dengan memaksimalkan nilai negatifnya, jadi mari kita balik tandanya. Kita juga ambil logaritma.
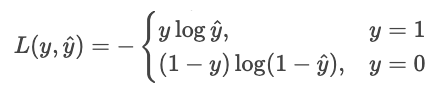
Kita dapat menuliskannya lebih ringkas sebagai sebuah penjumlahan tunggal.
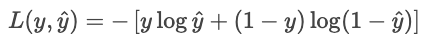
Mengapa log? Log memiliki beberapa keunggulan
Misalkan sebuah model memprediksi probabilitas untuk dua pilihan: "anjing" (pilihan 0) atau "kucing" (pilihan 1). Jika jawaban sebenarnya adalah 1 ("kucing") dan model 90% yakin itu kucing, loss kecil karena model yakin dan benar. Jika model mengatakan 10% yakin itu kucing, loss besar, karena model yakin namun salah.
Ketika ada lebih dari dua kelas ("kucing", "anjing", "burung"), model menghasilkan skor mentah ("logit") untuk tiap kelas, dinotasikan Zi. Logit dapat berupa bilangan real apa pun, sehingga dikonversi menjadi probabilitas yang berjumlah satu melalui fungsi softmax.
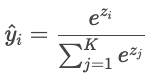
Prediksi model kemudian dibandingkan dengan label aktual menggunakan cross-entropy.
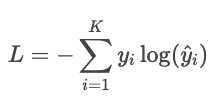
Contoh
Misalkan label sebenarnya adalah "kucing" dan model memprediksi probabilitas: kucing: 80%, anjing: 15%, burung: 5%. Loss-nya adalah
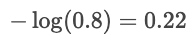
Jika probabilitas prediksi untuk "kucing" hanya 30%, maka loss akan jauh lebih tinggi:
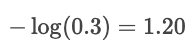
Log menghukum kesalahan yang yakin dan memberi penghargaan pada prediksi dengan kepercayaan tinggi.
Hinge loss terutama digunakan untuk klasifikasi margin-maksimum, seperti pada support vector machines (SVM). Tujuannya adalah mengklasifikasikan dengan yakin dengan menjaga prediksi tetap jauh dari batas keputusan.
Untuk klasifikasi biner, hinge loss diberikan oleh rumus berikut.
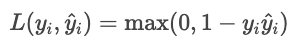
dengan
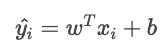
Fungsi biaya total adalah
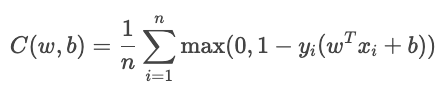
Istilah YiŶi mengukur seberapa baik sampel diklasifikasikan.
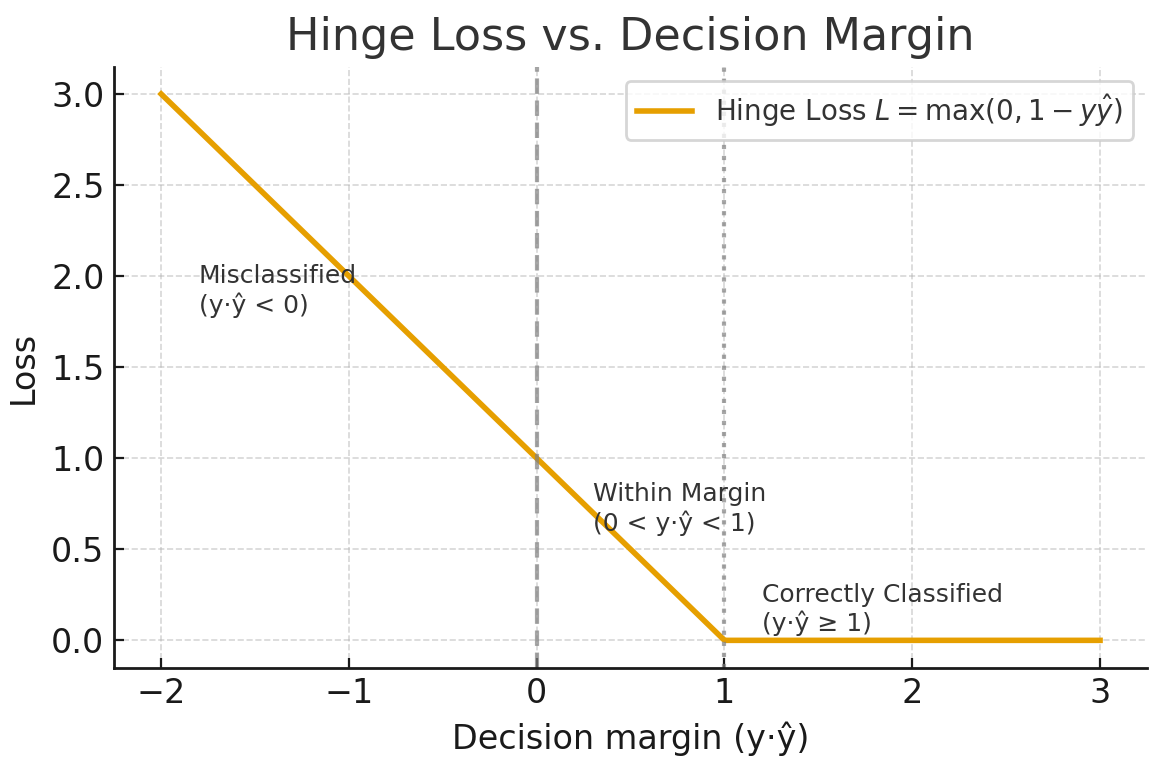
Dihasilkan oleh ChatGPT 5
Divergensi Kullback-Leibler (KL) adalah ukuran seberapa jauh distribusi probabilitas pendekatan Q berbeda dari distribusi probabilitas P yang diberikan. Didefinisikan sebagai
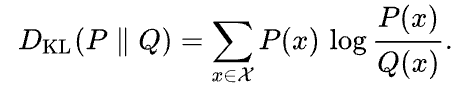
Wikipedia
Divergensi KL dapat ditafsirkan sebagai rata-rata selisih jumlah bit untuk mengodekan sampel P menggunakan kode yang dioptimalkan untuk Q.
Teknik regularisasi mencegah model menyesuaikan noise dalam data pelatihan dengan menambahkan suatu suku ke fungsi biaya yang menghukum solusi yang terlalu kompleks.
Tanpa regularisasi, model meminimalkan loss:
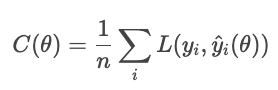
Dengan regularisasi, model menambahkan suku penalti
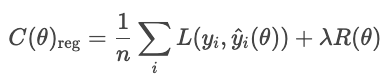
dengan
Jenis regularisasi yang umum adalah L1, L2, dan elastic net.
Regularisasi L1 (alias lasso) menambahkan nilai absolut dari setiap bobot model ke fungsi biaya.
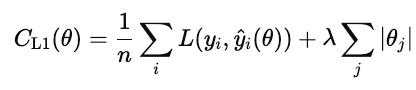
Ketika biaya ini diminimalkan, banyak bobot terdorong menjadi nol. Ini membuat L1 menjadi bentuk seleksi fitur otomatis. Fitur yang tidak berkontribusi didorong ke nol.
Regularisasi L2 (alias ridge regression) menghukum kuadrat dari setiap bobot model.
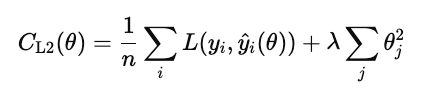
Berbeda dengan L1, ia tidak mengatur bobot persis ke nol, tetapi mengecilkannya secara mulus. Ini mempertahankan semua fitur dalam model namun mengurangi pengaruhnya untuk menstabilkan prediksi.
Elastic net menambahkan L1 dan L2 sekaligus.
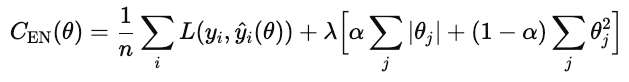
λ mengendalikan seberapa kuat regularisasi keseluruhan. α adalah angka antara 0 dan 1 yang mengendalikan persentase L1 versus L2, di mana 1 adalah L1 murni dan 0 adalah ridge murni.
Strategi loss klasifikasi yang berbeda memiliki trade-off.
Cross-entropy memaksimalkan probabilitas yang benar dengan menghukum jawaban salah yang yakin. Trade-off-nya adalah sensitif terhadap outlier dan data yang salah label. Ini bekerja paling baik saat Anda peduli pada kualitas kepercayaan (mis., model risiko).
Hinge loss menegakkan margin sehingga klasifikasi yang benar bukan sekadar benar, melainkan benar dengan yakin. Ia mengabaikan sampel yang aman berada di luar margin dan memberi penalti linear untuk pelanggaran. Ia kurang sensitif terhadap outlier dibanding cross-entropy, tetapi lebih sulit dioptimalkan secara mulus, karena tidak terdiferensial di titik hinge.
Kullback-Leibler (KL) divergence mencocokkan satu distribusi probabilitas dengan yang lain. Ini ekuivalen dengan cross-entropy dikurangi entropi dari distribusi sebenarnya.
Untuk informasi lebih lanjut, lihat tautan berikut.
Sejauh ini, kita telah membahas fungsi biaya secara teori. Dalam praktik, keberhasilan model ML bergantung pada seberapa efisien fungsi-fungsi tersebut diminimalkan. Pada bagian ini, kita memperkenalkan detail praktis dari algoritma optimisasi inti dan strategi penyetelan.
Optimisasi adalah proses menemukan nilai optimal dari parameter model yang meminimalkan fungsi biaya. Dalam ML, ini berarti menemukan parameter yang membuat prediksi sedekat mungkin dengan nilai aktual.
Gradient descent adalah algoritma standar untuk mengoptimalkan fungsi biaya. Algoritma ini secara iteratif memperbarui parameter model ke arah yang paling mengurangi biaya, yaitu gradien negatif. Secara konseptual, ia mengukur kemiringan multivariabel dari fungsi biaya dan melangkah turun bukit.
Aturan pembaruannya adalah
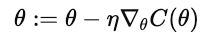
dengan θ adalah parameter model, n adalah laju pembelajaran, dan  adalah gradien fungsi biaya terhadap parameter.
Pilihan laju pembelajaran sangat krusial. Jika terlalu besar, pembaruan melampaui minimum dan berosilasi atau menyimpang. Jika terlalu kecil, konvergensi menjadi lambat dan dapat mandek di minimum lokal.
Variannya yang utama adalah batch, stochastic, dan mini-batch.
Gradient descent standar menerapkan laju pembelajaran tetap untuk semua parameter. Dalam model kompleks, parameter yang berbeda mungkin membutuhkan ukuran langkah berbeda. Optimizer adaptif menyesuaikan laju pembelajaran berdasarkan riwayat besaran gradien.
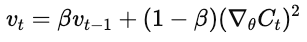
Pembelajaran tiap parameter diskalakan secara terbalik terhadap rata-rata ini. Ini mencegah osilasi dan memungkinkan kemajuan stabil bahkan ketika beberapa parameter memiliki gradien curam. RMSProp banyak digunakan untuk jaringan berulang dan data bising.
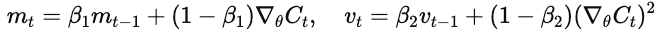
Optimizer ini berkonsvergensi cepat, tangguh terhadap data bising, dan menjadi default pada kerangka kerja jaringan dalam.
Sebelum mengoptimalkan dengan gradient descent, skala fitur agar berada pada rentang yang sebanding. Penskalaan yang tepat meningkatkan stabilitas dan efisiensi optimisasi.
Tanpa penskalaan, fitur dengan rentang numerik besar mendominasi gradien. Gradient descent kemudian bergerak zigzag alih-alih mengambil langkah langsung menuju minimum.
Ada dua pendekatan umum.
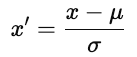
dengan u sebagai mean dan ơ sebagai simpangan baku. Standarisasi mempertahankan struktur data.
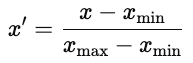
Normalisasi umum digunakan pada neural network, di mana fungsi aktivasi bekerja terbaik dengan input yang dibatasi.
Inisialisasi parameter sangat memengaruhi pelatihan model. Inisialisasi yang buruk dapat menyebabkan konvergensi lambat, gradien meledak atau lenyap, atau model gagal belajar. Inisialisasi yang baik menempatkan parameter pada wilayah permukaan biaya di mana gradien stabil.
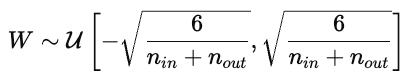
Ini menjaga aktivasi dan gradien kira-kira konstan di seluruh layer.
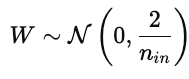
Ini mencegah gradien terlalu cepat lenyap selama backpropagation.
Kurva training loss memplot galat model pada dataset pelatihan dari waktu ke waktu. Kurva ini menunjukkan seberapa baik model memperbarui parameternya untuk meminimalkan galat. Kurva yang terus menurun mengindikasikan model mempelajari pola dari data.
Kurva validation loss menunjukkan kemampuan model untuk menggeneralisasi pada data yang tak terlihat, seperti set hold-out atau validasi. Ini mengindikasikan kemampuan model untuk memprediksi pada data yang belum pernah dilihat sebelumnya.
Idealnya, kedua kurva menurun pada awal lalu mendatar. Ini menunjukkan bahwa model efektif belajar dan efektif menggeneralisasi.
Overfitting terjadi ketika model mempelajari noise seolah-olah sinyal, dan tidak menggeneralisasi dengan baik. Ini tampak pada grafik kurva pelatihan dan validasi ketika training loss menurun tetapi validation loss meningkat. Perbaikannya termasuk menggunakan dataset yang lebih besar, atau menerapkan regularisasi dalam model.
Underfitting terjadi ketika model gagal menangkap pola mendasar dalam data. Kedua kurva pelatihan dan validasi tetap tinggi. Dalam kasus ini, coba lebih banyak data, model yang lebih kompleks, atau kurangi regularisasi.
Konvergensi adalah titik ketika kurva mendatar, dan pelatihan lebih lanjut memberikan sedikit peningkatan. Ini adalah titik manis antara overfitting dan underfitting.
Kita telah melihat bagaimana ekonomi dan machine learning bergantung pada optimisasi untuk membimbing pengambilan keputusan dan pelatihan. Kedua bidang berupaya membuat keputusan terbaik berdasarkan metrik biaya atau loss. Mari mendalami teori optimisasi secara lebih umum.
Sebuah fungsi objektif adalah fungsi matematika yang mendefinisikan apa yang ingin kita minimalkan atau maksimalkan. Dalam kasus yang telah kita lihat sejauh ini, kita meminimalkan biaya atau galat. Untuk ekonomi, kita melihat kurva biaya, dan untuk ML, kita melihat loss regresi (MAE, RMSE, Huber), serta loss klasifikasi (cross-entropy, hinge loss, KL loss). Keduanya adalah contoh mengoptimalkan fungsi objektif.
Sering kali, kita ingin mengoptimalkan beberapa tujuan yang kerap saling bertentangan. Perusahaan mungkin ingin memaksimalkan laba sekaligus meminimalkan risiko. Data scientist mungkin ingin meningkatkan akurasi model tanpa mengorbankan interpretabilitas atau keadilan. Tujuan yang saling bersaing seperti ini mendefinisikan masalah optimisasi multi-objektif di mana memperbaiki satu objektif dapat memperburuk yang lain.
Sebuah solusi dikatakan Pareto optimal jika tidak ada objektif yang dapat diperbaiki tanpa membuat setidaknya satu objektif lain menjadi lebih buruk. Himpunan solusi Pareto-optimal membentuk Frontier Pareto, kurva yang terdiri dari trade-off terbaik yang dapat dicapai. Setiap titik pada kurva ini merepresentasikan keseimbangan prioritas yang berbeda.
Sebagai contoh, meningkatkan kompleksitas model mungkin memperbaiki akurasi namun mengurangi interpretabilitas. Model yang lebih sederhana lebih mudah dijelaskan tetapi dapat berkinerja lebih buruk. Frontier Pareto mencakup "trade-off terbaik" dan mengecualikan solusi yang didominasi oleh variabel lain.
Memilih titik yang tepat bergantung pada konteks dan pertimbangan. Anda dapat memberi bobot pada setiap tujuan atau menggunakan batasan kebijakan.
Ketika hasil tidak pasti, optimisasi meminimalkan loss ekspektasian, yaitu rata-rata loss di semua skenario yang mungkin. Dalam ML, gagasan ini muncul dalam fungsi risiko.
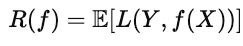
dengan L(Y,f(x)) sebagai loss untuk prediksi tertentu, dan ekspektasi mengambil rata-rata atas distribusi data. Tujuannya adalah menemukan model f yang meminimalkan loss ekspektasian ini. Model ini berkinerja terbaik secara rata-rata, bukan hanya pada sampel individual.
Risiko Bayes adalah batas bawah teoretis dari loss ekspektasian. Secara formal, diberikan oleh rumus berikut.
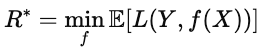
Secara intuitif, ini adalah "skor sempurna", yaitu nilai terkecil yang dapat dicapai dengan informasi sempurna tentang distribusi data. Semakin dekat kinerja model ke risiko Bayes, semakin optimal model tersebut.
Fungsi biaya digunakan di industri mana pun yang membuat keputusan berbasis data. Fungsi ini membantu menyeimbangkan tujuan yang bersaing dan memformalkan arti "lebih baik". Fungsi-fungsi ini menyeimbangkan tujuan yang bersaing dan membimbing optimisasi. Logika yang sama yang digunakan untuk melatih model ML digunakan untuk mengoptimalkan proses dunia nyata.
Dalam manufaktur, misalnya, fungsi biaya mengkuantifikasi kerugian, seperti kerugian persediaan. Fungsi biaya persediaan menyeimbangkan biaya stok berlebih terhadap penalti kekurangan. Kerangka serupa digunakan untuk penjadwalan produksi atau penggunaan energi untuk meminimalkan total biaya ekspektasian dalam ketidakpastian.
Dalam layanan kesehatan, model prediktif menggunakan fungsi biaya untuk menyeimbangkan akurasi dan alokasi sumber daya. Misalnya, model risiko readmisi mengidentifikasi pasien berisiko tinggi sejak dini sehingga klinisi dapat melakukan intervensi dengan panggilan tindak lanjut atau kunjungan rumah. Melewatkan pasien berisiko tinggi lebih mahal daripada menandai pasien berisiko rendah, sehingga fungsi menghukum kesalahan tersebut secara berbeda.
Sektor keuangan juga menggunakan fungsi objektif. Misalnya, model penilaian kredit memprediksi probabilitas peminjam akan gagal bayar dalam periode waktu tertentu, katakanlah dua belas bulan. Menyetujui peminjam berisiko menghasilkan potensi kerugian finansial, sementara menolak peminjam aman berpotensi kehilangan pendapatan. Model meminimalkan biaya ekspektasian.
Di semua domain ini, fungsi biaya menyeimbangkan trade-off menjadi kuantitas terukur yang dapat digunakan dan dipertimbangkan oleh pengambil keputusan.
Fungsi biaya menyediakan metode untuk mengevaluasi keputusan. Dalam ekonomi, fungsi ini memodelkan trade-off antara output dan efisiensi. Dalam machine learning, fungsi ini mengukur kesenjangan antara prediksi dan kebenaran.
Dalam ML, fungsi biaya adalah landasan perancangan model. Pilihan fungsi loss menentukan apa yang dianggap model sebagai "keberhasilan." Mean squared error memberi penghargaan pada akurasi keseluruhan, cross-entropy memberi penghargaan pada probabilitas yang terkalibrasi, dan hinge loss memberi penghargaan pada pemisahan yang yakin.
Di semua domain dan industri, logika dasarnya sama: tetapkan sebuah objektif dan optimalkan itu. Fungsi biaya menerjemahkan tujuan yang samar menjadi angka konkret yang membimbing optimisasi.
Fungsi biaya bermanfaat dalam ekonomi, machine learning, manufaktur, keuangan, layanan kesehatan, dan di mana pun seseorang ingin mengkuantifikasi trade-off.
Untuk informasi lebih lanjut, saya sarankan sumber daya DataCamp berikut.
Kursus Teratas DataCamp
Kursus
Program
Kursus
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt



