

Sai số tuyệt đối trung bình (MAE)
Sai số tuyệt đối trung bình được định nghĩa là trung bình giá trị tuyệt đối của các phần dư.
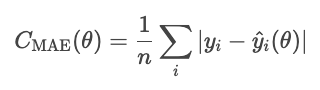
MAE đối xử mọi sai lệch như nhau, nên không bị ảnh hưởng nhiều bởi ngoại lệ như các phương pháp khác mà ta sẽ thấy, chẳng hạn MSE. Tuy nhiên, giá trị tuyệt đối bất tiện về mặt toán học và khiến tối ưu hóa dựa trên gradient khó hơn.
Lưu ý về tham số của hàm. θ đại diện cho các tham số mô hình. Bộ tối ưu điều khiển chi phí dựa trên các tham số này, không trực tiếp dựa trên các giá trị dự đoán phát sinh từ chúng. Do đó, ta viết chi phí như một hàm của θ, không phải Ŷi.
MSE
Sai số bình phương trung bình (MSE) được cho bởi công thức sau.
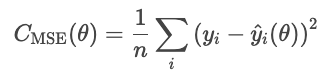
Bình phương phần dư phóng đại các lỗi lớn, khiến MSE nhạy với ngoại lệ. Tuy vậy, dạng lỗi này khả vi và lồi, nên thân thiện cho tối ưu hóa.
RMSE
Một nhược điểm của MSE là đơn vị bị bình phương. Chẳng hạn, trong mô hình hồi quy giá nhà, mất mát tính bằng đô-la bình phương, thiếu ý nghĩa trực quan. RMSE khắc phục bằng cách lấy căn bậc hai của MSE.
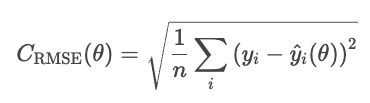
RMSE có hành vi tương tự MSE nhưng đơn vị trùng với đơn vị của bài toán (đô-la, không phải đô-la bình phương).
Huber
Mất mát Huber ít nhạy với ngoại lệ trong dữ liệu hơn MSE (hoặc RMSE). Nó kết hợp MAE và MSE, và điều khiển chuyển tiếp bằng tham số δ.
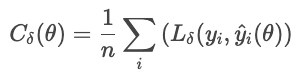
trong đó
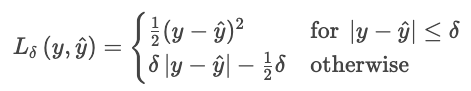
Công thức này ngăn một vài phần dư lớn chi phối mất mát. Mất mát Huber là lựa chọn tốt cho dữ liệu đời thực nhiễu, nơi bạn kỳ vọng đôi khi có quan sát cực trị.
Các mất mát trong phân loại
Phân loại dự đoán các hạng mục rời rạc. Các hàm chi phí này so sánh phân phối xác suất với nhãn thật, phạt các dự đoán sai hoặc quá tự tin.
Mất mát cross-entropy
Cross-entropy (log loss) thưởng cho mô hình khi nó tự tin và đúng, và phạt khi nó tự tin nhưng sai.
Với một bộ phân loại xuất ra các xác suất thuần Ŷ, xác suất xảy ra của nhãn quan sát Y là
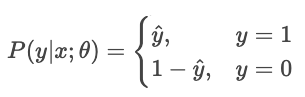
Ước lượng hợp lý cực đại (MLE) tối đa hóa xác suất này trên toàn bộ mẫu.
Hãy chuyển ý tưởng này thành tối thiểu hóa chi phí. Tối thiểu hóa tương đương tối đa hóa giá trị âm của nó, vì vậy hãy đổi dấu. Đồng thời lấy log.
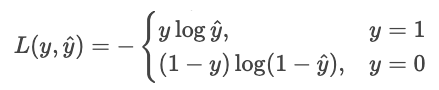
Ta có thể viết gọn hơn dưới dạng một tổng.
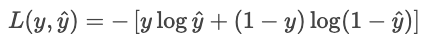
Tại sao lại dùng log? Log có vài ưu điểm
- Biến tích thành tổng. Thay vì nhân các số nhỏ và có nguy cơ tràn số dưới, ta cộng xác suất,
- Khiến hàm trở nên lõm. Log biến khả năng xảy ra thành một hàm lõm với một cực đại toàn cục duy nhất.
- Đem lại đường cong phạt có ý nghĩa.
- p = 1.0 dẫn đến mất mát 0,
- p = 0.9 dẫn đến mất mát 0.1 (nhỏ)
- p = 0.2 dẫn đến mất mát 2.3 (lớn)
- p = 0.01 dẫn đến mất mát 4.6 (rất lớn)
- Tránh lũy thừa lồng nhau. Trong hồi quy logistic và mạng nơ-ron, log "gỡ" các lũy thừa lồng nhau, giúp đạo hàm đơn giản và ổn định.
Giả sử một mô hình dự đoán xác suất cho hai lựa chọn: "chó" (lựa chọn 0) hoặc "mèo" (lựa chọn 1). Nếu đáp án thật là 1 ("mèo") và mô hình chắc chắn 90% là mèo, mất mát nhỏ vì mô hình tự tin và đúng. Nếu mô hình nói chỉ 10% chắc chắn là mèo, mất mát lớn vì mô hình tự tin nhưng sai.
Cross-entropy cho phân loại đa lớp
Khi có nhiều hơn hai lớp ("mèo", "chó", "chim"), mô hình tạo ra điểm số thô ("logit") cho mỗi lớp, ký hiệu Zi. Logit có thể là bất kỳ số thực nào, nên được chuyển thành xác suất tổng bằng một qua hàm softmax.
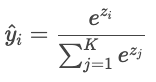
Các dự đoán của mô hình sau đó được so sánh với nhãn thực bằng cross-entropy.
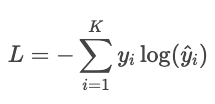
Ví dụ
Giả sử nhãn thực là "mèo" và mô hình dự đoán xác suất: mèo: 80%, chó: 15%, chim: 5%. Mất mát là
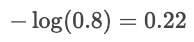
Nếu xác suất dự đoán cho "mèo" chỉ là 30%, thì mất mát sẽ cao hơn nhiều:
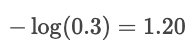
Log phạt các lỗi tự tin và thưởng cho dự đoán có độ tự tin cao.
Hinge Loss
Hinge loss chủ yếu dùng cho phân loại biên tối đa, như trong SVM. Mục tiêu là phân loại với độ tự tin cao bằng cách giữ dự đoán cách xa ranh giới quyết định.
Với phân loại nhị phân, hinge loss được cho bởi công thức sau.
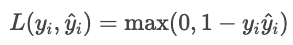
trong đó
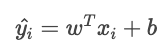
Hàm chi phí tổng là
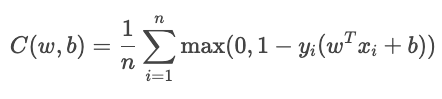
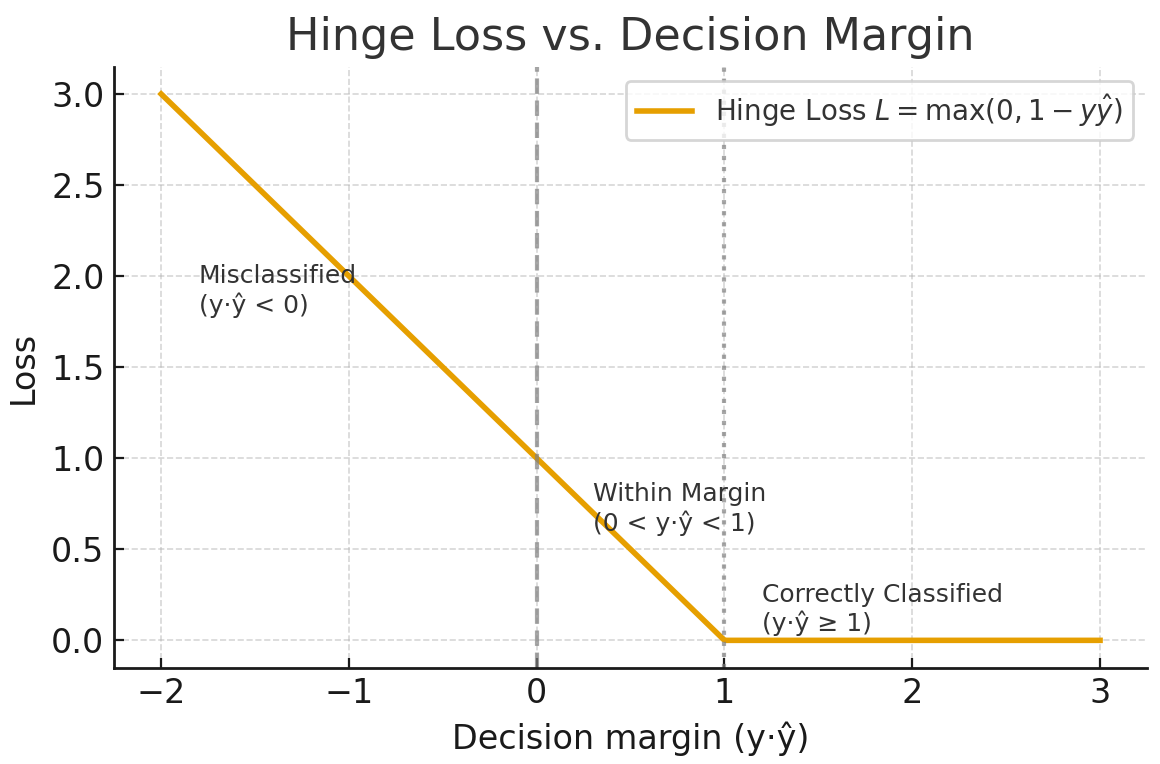
Hạng tử YiŶi đo mức độ phân loại tốt của mẫu.
- Khi lớn hơn 1, mẫu nằm ở phía đúng của ranh giới và không có mất mát.
- Khi nằm giữa 0 và 1, điểm nằm trong biên, nên áp dụng mức phạt nhỏ.
- Khi nhỏ hơn 0, mô hình phân loại sai. Mất mát tăng tuyến tính theo khoảng cách đến ranh giới.
Được tạo bởi ChatGPT 5
Kullback-Leibler (KL)
Độ lệch Kullback-Leibler (KL) đo mức độ khác biệt giữa phân phối xác suất xấp xỉ Q so với phân phối xác suất cho trước P. Nó được định nghĩa là
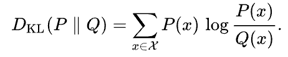
Wikipedia
Độ lệch KL có thể được hiểu là chênh lệch trung bình về số bit để mã hóa các mẫu của P bằng một mã tối ưu cho Q.
Regularization
Các kỹ thuật regularization ngăn mô hình khớp với nhiễu trong dữ liệu huấn luyện bằng cách thêm một hạng tử vào hàm chi phí để phạt các nghiệm quá phức tạp.
Không dùng regularization, mô hình tối thiểu hóa mất mát:
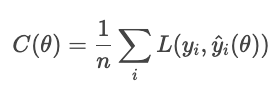
Với regularization, mô hình thêm một hạng phạt
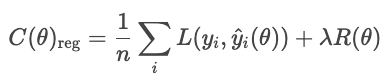
trong đó
- L là mất mát thông thường (ví dụ, RMSE, cross-entropy)
- R(θ) đo độ phức tạp mô hình
- λ điều khiển đánh đổi giữa độ khớp và độ đơn giản
Các loại regularization phổ biến là L1, L2 và elastic net.
Regularization L1 (còn gọi là lasso) cộng giá trị tuyệt đối của từng trọng số mô hình vào hàm chi phí.
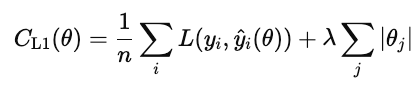
Khi chi phí này được tối thiểu hóa, nhiều trọng số bị đẩy về 0. Điều này khiến L1 trở thành một dạng tự động chọn đặc trưng. Các đặc trưng không đóng góp sẽ bị đẩy về 0.
Regularization L2 (còn gọi là hồi quy ridge) phạt bình phương mỗi trọng số mô hình.
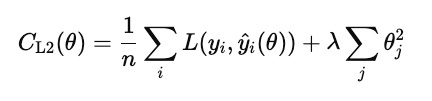
Không giống L1, nó không đặt trọng số về đúng 0, mà thu nhỏ chúng một cách trơn tru. Điều này giữ tất cả đặc trưng trong mô hình nhưng giảm ảnh hưởng của chúng để ổn định dự đoán.
Elastic net kết hợp cả L1 và L2.
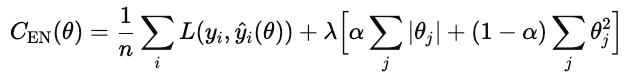
λ điều khiển độ mạnh của regularization tổng thể. α là số nằm giữa 0 và 1 điều khiển tỷ lệ L1 so với L2, với 1 là L1 thuần và 0 là ridge thuần.
Đánh đổi
Các chiến lược mất mát trong phân loại có những đánh đổi.
Cross-entropy tối đa hóa xác suất đúng bằng cách phạt nặng các câu trả lời sai nhưng tự tin. Đánh đổi là nó nhạy với ngoại lệ và dữ liệu gán nhãn sai. Nó hoạt động tốt nhất khi bạn quan tâm tới chất lượng độ tin cậy (ví dụ, mô hình rủi ro).
Hinge loss áp đặt một biên sao cho các phân loại đúng không chỉ đúng mà còn đúng với độ tự tin cao. Nó bỏ qua các mẫu an toàn vượt quá biên và áp dụng mức phạt tuyến tính cho các vi phạm. Nó ít nhạy với ngoại lệ hơn cross-entropy, nhưng khó tối ưu trơn tru hơn vì không khả vi tại điểm gấp khúc.
Độ lệch Kullback-Leibler (KL) ghép một phân phối xác suất với phân phối khác. Nó tương đương cross-entropy trừ đi entropy của phân phối thật.
Để biết thêm thông tin, hãy xem các liên kết sau.
- Hàm mất mát Cross-Entropy trong Học máy: Nâng cao độ chính xác mô hình
- Từ Dữ liệu đến Doanh thu - Dự đoán chi phí bảo hiểm
- Tối ưu hóa dự đoán giá bằng kỹ thuật đặc trưng
- Cheat Sheet về các chiều chất lượng dữ liệu
- Hướng dẫn tương quan trong R
Triển khai và thực hành Hàm chi phí trong Học máy
Cho tới giờ, chúng ta đã bàn về hàm chi phí ở khía cạnh lý thuyết. Trên thực tế, thành công của một mô hình ML phụ thuộc vào mức độ hiệu quả khi nó tối thiểu hóa các hàm đó. Phần này giới thiệu các chi tiết thực tiễn của những thuật toán tối ưu hóa cốt lõi và chiến lược tinh chỉnh.
Thuật toán tối ưu hóa và tinh chỉnh tham số
Tối ưu hóa là quá trình tìm các giá trị tham số mô hình tối ưu để tối thiểu hóa một hàm chi phí. Trong ML, điều này có nghĩa khám phá các tham số khiến dự đoán gần nhất có thể với thực tế.
Gradient descent
Gradient descent là thuật toán tiêu chuẩn để tối ưu hóa hàm chi phí. Nó lặp lại việc cập nhật tham số mô hình theo hướng giảm chi phí nhiều nhất, tức gradient âm. Về mặt trực quan, nó đo "độ dốc" đa biến của hàm chi phí và đi xuống đồi.
Quy tắc cập nhật là
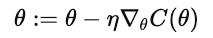
trong đó θ là các tham số mô hình, n là tốc độ học, và  là gradient của hàm chi phí theo các tham số.
Lựa chọn tốc độ học là then chốt. Nếu quá lớn, các cập nhật vượt quá điểm cực tiểu và dao động hoặc phân kỳ. Nếu quá nhỏ, hội tụ chậm và có thể mắc kẹt ở cực tiểu cục bộ.
Ba biến thể chính là batch, stochastic và mini-batch.
- Batch gradient descent. Tính gradient bằng toàn bộ tập huấn luyện. Ổn định nhưng chậm và tốn bộ nhớ với các tập dữ liệu lớn hoặc học trực tuyến.
- Stochastic gradient descent (SGD). Cập nhật tham số sau mỗi ví dụ huấn luyện. Nhanh và tiết kiệm bộ nhớ, nhưng nhiễu theo nghĩa mỗi bước có thể lệch nhẹ khỏi quỹ đạo tối ưu. Tuy nhiên, tính ngẫu nhiên giúp thoát khỏi cực tiểu cục bộ.
- Mini-batch gradient descent. Thỏa hiệp thực tế. Tính gradient trên các lô nhỏ để cân bằng tốc độ và ổn định. Cũng cho phép song song hóa trên GPU.
Bộ tối ưu thích nghi
Gradient descent tiêu chuẩn áp dụng một tốc độ học cố định cho mọi tham số. Trong các mô hình phức tạp, những tham số khác nhau có thể cần bước nhảy khác nhau. Bộ tối ưu thích nghi điều chỉnh tốc độ học dựa trên lịch sử độ lớn gradient.
- RMSProp sử dụng trung bình suy giảm theo hàm mũ của các gradient bình phương gần đây.
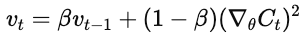
Tốc độ học của mỗi tham số được chia tỷ lệ nghịch với trung bình này. Điều này ngăn dao động và cho phép tiến triển ổn định ngay cả khi một số tham số có gradient dốc. RMSProp được dùng rộng rãi cho mạng hồi quy (RNN) và dữ liệu nhiễu.
- Adaptive Moment Estimation (Adam) theo dõi cả trung bình và phương sai của các gradient quá khứ và điều chỉnh kích thước bước động.
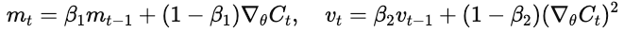
Nó hội tụ nhanh, bền vững với dữ liệu nhiễu, và là bộ tối ưu mặc định cho các khung mạng sâu.
Chuẩn hóa đặc trưng và khởi tạo
Trước khi tối ưu bằng gradient descent, hãy chuẩn hóa đặc trưng để chúng ở các miền giá trị có thể so sánh. Chuẩn hóa đúng giúp tối ưu hóa ổn định và hiệu quả hơn.
Nếu không chuẩn hóa, các đặc trưng có miền số lớn chi phối gradient. Gradient descent khi đó sẽ "zigzag" thay vì bước thẳng tới cực tiểu.
Có hai cách tiếp cận phổ biến.
- Standardization. Đưa mỗi đặc trưng về trung bình 0 và phương sai đơn vị.
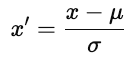
trong đó u là trung bình và ơ là độ lệch chuẩn. Standardization giữ nguyên cấu trúc dữ liệu.
- Normalization. Co dãn mỗi đặc trưng về một khoảng cố định, thường là [0, 1].
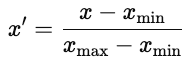
Normalization phổ biến trong mạng nơ-ron, nơi các hàm kích hoạt hoạt động tốt nhất với đầu vào được chặn trên.
Chiến lược khởi tạo tham số
Khởi tạo tham số ảnh hưởng mạnh tới quá trình huấn luyện mô hình. Khởi tạo kém có thể khiến hội tụ chậm, gradient bùng nổ hay biến mất, hoặc mô hình không học được. Khởi tạo tốt đặt tham số vào vùng của bề mặt chi phí nơi gradient ổn định.
- Khởi tạo ngẫu nhiên. Gán các giá trị ngẫu nhiên nhỏ, thường rút từ phân phối đều hoặc chuẩn. Ngẫu nhiên hóa phá vỡ tính đối xứng để tham số học các đặc trưng khác biệt. Tuy nhiên, nếu phương sai quá cao hoặc thấp, gradient có thể bùng nổ hoặc biến mất.
- Khởi tạo Xavier (Glorot). Thiết kế cho các hàm kích hoạt phi tuyến như tanh hoặc sigmoid, Xavier chia tỷ lệ phương sai của trọng số theo số kết nối vào và ra.
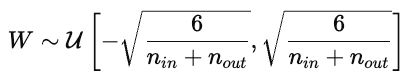
Điều này giúp các kích hoạt và gradient xấp xỉ hằng định qua các lớp.
- Khởi tạo He. Điều chỉnh phương sai cho các kích hoạt ReLU, vốn triệt tiêu các giá trị âm. Trọng số được rút từ phân phối chuẩn với phương sai chỉ định:
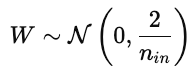
Điều này ngăn gradient biến mất quá nhanh trong lan truyền ngược.
Giám sát, chẩn đoán và trực quan hóa
Một đường cong mất mát huấn luyện vẽ lỗi của mô hình trên tập huấn luyện theo thời gian. Nó cho thấy mức độ mô hình cập nhật tham số để giảm lỗi. Đường cong giảm đều cho thấy mô hình đang học các mẫu từ dữ liệu.
Đường cong mất mát trên tập thẩm định cho thấy khả năng khái quát hóa trên dữ liệu chưa thấy, như tập giữ lại hoặc tập thẩm định. Nó phản ánh khả năng mô hình dự đoán trên dữ liệu chưa từng thấy.
Lý tưởng nhất, cả hai đường đều giảm ở đầu, rồi phẳng dần. Điều này chứng tỏ mô hình vừa học hiệu quả vừa khái quát hóa tốt.
Overfitting xảy ra khi mô hình học nhiễu như thể đó là tín hiệu và không khái quát hóa tốt. Điều này xuất hiện trên đồ thị khi đường mất mát huấn luyện giảm nhưng mất mát thẩm định tăng. Cách khắc phục gồm dùng tập dữ liệu lớn hơn, hoặc áp dụng regularization trong mô hình.
Underfitting xảy ra khi mô hình không nắm bắt được các mẫu tiềm ẩn trong dữ liệu. Cả hai đường cong huấn luyện và thẩm định đều cao. Trong trường hợp này, hãy thử thêm dữ liệu, mô hình phức tạp hơn, hoặc giảm regularization.
Hội tụ là điểm đường cong phẳng ra, và huấn luyện thêm mang lại ít cải thiện. Đây là điểm ngọt giữa overfitting và underfitting.
Tối ưu hóa Hàm chi phí và Lý thuyết Quyết định
Chúng ta đã thấy kinh tế học và học máy đều dựa vào tối ưu hóa để dẫn dắt ra quyết định và huấn luyện. Cả hai lĩnh vực đều nỗ lực đưa ra quyết định tốt nhất dựa trên một thước đo chi phí hoặc mất mát. Hãy đi sâu hơn vào lý thuyết tối ưu hóa nói chung.
Hàm mục tiêu
Một hàm mục tiêu là một hàm toán học xác định điều ta muốn tối thiểu hóa hoặc tối đa hóa. Trong các ví dụ đã thấy, ta đã tối thiểu hóa chi phí hoặc lỗi. Với kinh tế, ta xem các đường chi phí, còn với ML, ta xem các mất mát hồi quy (MAE, RMSE, Huber) và mất mát phân loại (cross-entropy, hinge loss, KL). Đây đều là các ví dụ tối ưu hóa hàm mục tiêu.
Tối ưu hóa đa mục tiêu
Thường thì, ta muốn tối ưu nhiều mục tiêu, thường là xung đột nhau. Một công ty có thể muốn tối đa hóa lợi nhuận đồng thời tối thiểu hóa rủi ro. Một nhà khoa học dữ liệu có thể muốn cải thiện độ chính xác mô hình mà không hy sinh khả năng diễn giải hoặc tính công bằng. Những mục tiêu cạnh tranh như vậy xác định một bài toán tối ưu hóa đa mục tiêu trong đó cải thiện một mục tiêu có thể làm xấu đi mục tiêu khác.
Biên Pareto
Một nghiệm là tối ưu Pareto nếu không thể cải thiện mục tiêu nào mà không làm ít nhất một mục tiêu khác tệ đi. Tập hợp các nghiệm tối ưu Pareto tạo thành biên Pareto, một đường cong gồm các đánh đổi tốt nhất có thể đạt được. Mỗi điểm trên đường cong này đại diện cho một sự cân bằng ưu tiên khác nhau.
Ví dụ, tăng độ phức tạp của mô hình có thể cải thiện độ chính xác nhưng giảm khả năng diễn giải. Mô hình đơn giản hơn dễ giải thích hơn nhưng có thể hoạt động kém hơn. Biên Pareto bao gồm các "đánh đổi tốt nhất" và loại trừ các nghiệm bị chi phối bởi biến khác.
Chọn điểm phù hợp phụ thuộc vào bối cảnh và phán đoán. Bạn có thể gán trọng số cho từng mục tiêu hoặc dùng các ràng buộc chính sách.
Tổn thất kỳ vọng
Khi kết quả bất định, tối ưu hóa sẽ tối thiểu hóa tổn thất kỳ vọng, tức mất mát trung bình trên mọi kịch bản có thể. Trong ML, ý tưởng này xuất hiện trong hàm rủi ro.
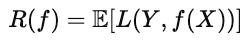
trong đó L(Y,f(x)) là mất mát cho một dự đoán nhất định, và toán tử kỳ vọng lấy trung bình trên phân phối dữ liệu. Mục tiêu là tìm mô hình f tối thiểu hóa tổn thất kỳ vọng này. Mô hình này đạt hiệu năng tốt nhất trung bình, không chỉ trên từng mẫu riêng lẻ.
Rủi ro Bayes
Rủi ro Bayes là cận dưới lý thuyết của tổn thất kỳ vọng. Về hình thức, nó được cho bởi công thức sau.
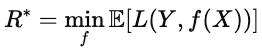
Trực giác, đó là "điểm số hoàn hảo", tức giá trị nhỏ nhất có thể đạt được nếu biết hoàn hảo về phân phối dữ liệu. Mức hiệu năng của mô hình càng gần rủi ro Bayes, mô hình càng tối ưu.
Ứng dụng liên ngành
Hàm chi phí được dùng trong mọi ngành đưa ra quyết định dựa trên dữ liệu. Chúng giúp cân bằng các mục tiêu cạnh tranh và cụ thể hóa "tốt hơn" có nghĩa là gì. Những hàm này cân bằng các mục tiêu đối nghịch và dẫn dắt tối ưu hóa. Cùng một logic dùng để huấn luyện mô hình ML cũng được dùng để tối ưu hóa quy trình thực tế.
Ứng dụng ngành và trường hợp theo miền
Trong sản xuất, chẳng hạn, hàm chi phí định lượng các mất mát như mất mát tồn kho. Một hàm chi phí tồn kho cân bằng chi phí dự trữ dư thừa so với chi phí phạt vì thiếu hàng. Khung tương tự được dùng cho lập lịch sản xuất hoặc sử dụng năng lượng để tối thiểu hóa tổng chi phí kỳ vọng trong điều kiện bất định.
Trong chăm sóc sức khỏe, các mô hình dự đoán dùng hàm chi phí để cân bằng độ chính xác và phân bổ nguồn lực. Ví dụ, mô hình nguy cơ tái nhập viện xác định sớm bệnh nhân rủi ro cao để lâm sàng can thiệp bằng cuộc gọi theo dõi hoặc thăm nhà. Bỏ sót một bệnh nhân rủi ro cao tốn kém hơn gắn cờ nhầm một bệnh nhân rủi ro thấp, nên hàm phạt các lỗi đó khác nhau.
Tài chính cũng dùng các hàm mục tiêu. Ví dụ, mô hình chấm điểm tín dụng dự đoán xác suất người vay sẽ vỡ nợ trong một khoảng thời gian nhất định, chẳng hạn mười hai tháng. Phê duyệt một người vay rủi ro dẫn đến tổn thất tài chính tiềm ẩn, trong khi từ chối một người vay an toàn có thể mất doanh thu. Mô hình tối thiểu hóa chi phí kỳ vọng.
Trên mọi miền, hàm chi phí chuyển các đánh đổi thành đại lượng đo lường được để nhà ra quyết định sử dụng và suy luận.
Kết luận
Hàm chi phí cung cấp một phương pháp để đánh giá quyết định. Trong kinh tế học, chúng mô hình hóa đánh đổi giữa đầu ra và hiệu quả. Trong học máy, chúng đo khoảng cách giữa dự đoán và sự thật.
Trong ML, hàm chi phí là nền tảng của thiết kế mô hình. Việc lựa chọn hàm mất mát quyết định điều mô hình xem là "thành công." MSE thưởng cho độ chính xác tổng thể, cross-entropy thưởng cho xác suất được hiệu chỉnh, và hinge loss thưởng cho sự tách biệt tự tin.
Trên mọi lĩnh vực và ngành, logic cơ bản giống nhau: xác định mục tiêu và tối ưu hóa nó. Hàm chi phí chuyển các mục tiêu mơ hồ thành con số cụ thể để dẫn dắt tối ưu hóa.
Hàm chi phí hữu ích trong kinh tế, học máy, sản xuất, tài chính, chăm sóc sức khỏe và mọi nơi khác nơi người ta muốn định lượng các đánh đổi.
Để biết thêm thông tin, tôi khuyến nghị các tài nguyên DataCamp sau.
Câu hỏi thường gặp về Hàm chi phí
Hàm chi phí là gì?
Hàm chi phí xác định mức độ phù hợp giữa dự đoán của mô hình với dữ liệu. Nó tổng hợp lỗi thành một giá trị duy nhất. Các thuật toán tối ưu hóa sau đó tối thiểu hóa giá trị này để cải thiện hiệu năng.
Hàm chi phí khác nhau thế nào giữa nhiệm vụ hồi quy và phân loại?
Mô hình hồi quy dự đoán các giá trị liên tục, nên mất mát của chúng (ví dụ MSE, MAE) đo khoảng cách số học tới mục tiêu.
Mô hình phân loại dự đoán xác suất lớp; các mất mát như cross-entropy so sánh phân phối xác suất dự đoán với lớp thật và phạt nặng các dự đoán sai nhưng tự tin.
Một số ứng dụng thực tế của hàm chi phí trong kinh doanh là gì?
Hàm chi phí hữu ích trong bất kỳ quy trình kinh doanh nào có đánh đổi hoặc tối ưu hóa. Ví dụ gồm tối ưu hóa giá và doanh thu, quản lý tồn kho, mô hình tín dụng và rủi ro, giữ chân khách hàng hoặc logistics.
Hàm mất mát Huber xử lý ngoại lệ trong dữ liệu như thế nào?
Hàm mất mát Huber xử lý lỗi nhỏ như MSE và lỗi lớn như MAE, nhờ đó ít nhạy với ngoại lệ hơn.
Mối quan hệ giữa chi phí cận biên và chi phí bình quân là gì?
Chi phí cận biên (MC) đo chi phí sản xuất thêm một đơn vị. Chi phí bình quân (AC) là tổng chi phí chia cho số đơn vị. Khi MC < AC, sản xuất thêm làm giảm chi phí bình quân; khi MC > AC, sản xuất thêm làm tăng chi phí bình quân; và khi MC = AC, chi phí bình quân đạt mức tối thiểu.

Mark Pedigo, PhD, là một nhà khoa học dữ liệu xuất sắc với chuyên môn về khoa học dữ liệu trong y tế, lập trình và giáo dục. Với bằng Tiến sĩ Toán học, Cử nhân Khoa học Máy tính và Chứng chỉ Chuyên nghiệp về AI, Mark kết hợp hiểu biết kỹ thuật với khả năng giải quyết vấn đề thực tiễn. Sự nghiệp của anh bao gồm các vai trò trong phát hiện gian lận, dự đoán tử vong ở trẻ sơ sinh và dự báo tài chính, cùng với những đóng góp cho phần mềm ước tính chi phí của NASA. Là một nhà giáo dục, anh đã giảng dạy tại DataCamp và Đại học Washington ở St. Louis, đồng thời cố vấn cho các lập trình viên trẻ. Trong thời gian rảnh, Mark thích hoạt động ngoài trời ở Minnesota cùng vợ là Mandy và chú chó Harley, và chơi piano jazz.


Hàm chi phí đóng vai trò là "trọng tài" cho các quyết định. Chúng đo lường mức độ sai lệch giữa dự đoán so với giá trị thực tế của một tập dữ liệu so với giá trị dự đoán. Trong học máy, chúng dẫn dắt các thuật toán tối ưu hóa nhằm giảm lỗi và cải thiện độ chính xác của mô hình.
Trong bài viết này, chúng ta xây dựng trực giác từng bước. Bắt đầu từ các ứng dụng kinh tế, nơi hàm chi phí mô tả đánh đổi giữa sản lượng và hiệu quả. Tiếp theo, chuyển sang học máy, nơi chúng thúc đẩy quá trình huấn luyện mô hình. Kế đến, chúng ta xem xét tối ưu hóa như chiếc cầu nối giữa hai lĩnh vực. Cuối cùng, chúng ta khám phá các ví dụ trong đời thực.
Hàm chi phí là gì?
Hàm chi phí là nền tảng của tối ưu hóa và đánh giá. Hãy định nghĩa hàm chi phí một cách toán học và xem xét các thuộc tính chính của chúng.
Một hàm chi phí (còn gọi là "hàm lỗi") ánh xạ một hoặc nhiều biến đầu vào thành một giá trị số duy nhất đại diện cho "chi phí" của một quyết định hoặc dự đoán. Trong học máy, nó thường được định nghĩa là trung bình của hàm mất mát trên toàn bộ mẫu trong tập dữ liệu.
Hàm chi phí có hai vai trò: vừa là mục tiêu để thuật toán tối ưu hóa tối thiểu hóa, vừa là thước đo đánh giá mức độ hoạt động của mô hình.
Hãy xem hàm chi phí như một mục tiêu. Với mỗi căn nhà, hàm mất mát phạt chênh lệch giữa giá bán thực tế và giá dự đoán. Hàm chi phí tổng hợp các khoản phạt này trên tất cả các căn:
Chi phí nhỏ hơn cho thấy mức độ khớp tổng thể tốt hơn, trong khi chi phí lớn hơn cho thấy lỗi trung bình lớn hơn. Bộ tối ưu điều chỉnh các tham số để tối thiểu hóa chi phí này.
Với vai trò là thước đo đánh giá, hàm chi phí đo lường hiệu năng. Chẳng hạn, một bộ phân loại có thể được đánh giá bằng độ chính xác, hoặc recall, hoặc bất kỳ chỉ số nào phù hợp với ứng dụng. Theo cách này, hàm chi phí cung cấp cách để đánh giá mức độ thành công.
Thuộc tính của hàm chi phí
Ba thuộc tính toán học đặc biệt liên quan.
Kết hợp lại, các thuộc tính này quyết định mức độ dễ tối ưu của một hàm chi phí. Khi thiếu một trong các thuộc tính, có thể cần những kỹ thuật đặc biệt để bù đắp.
Ứng dụng Kinh tế và Kinh doanh của Hàm chi phí
Hàm chi phí mô tả mối quan hệ giữa lượng đầu ra và tổng chi phí sản phẩm. Chúng là công cụ thiết yếu để hiểu hành vi doanh nghiệp, chiến lược định giá và phân tích lợi nhuận.
Các loại chi phí kinh tế
Đường chi phí
Đường chi phí cho thấy chi phí biến thiên theo hàm của tổng lượng sản xuất. Chi phí cố định là hằng số nên hiển thị dưới dạng đường ngang, trong khi chi phí biến đổi tăng theo số đơn vị sản xuất.
Wikipedia: Đường chi phí
Chi phí ngắn hạn so với dài hạn
Trong ngắn hạn, ít nhất một đầu vào như vốn hoặc quy mô nhà máy được giữ cố định, còn các đầu vào khác thay đổi. Chi phí ngắn hạn đo lường mức độ hiệu quả mà doanh nghiệp vận hành với cấu hình hiện tại. Vì vậy, với một lượng q cho trước, chi phí ngắn hạn là tổng của chi phí cố định và chi phí biến đổi phụ thuộc vào lượng.
Trong ngắn hạn, tối ưu hóa trong phạm vi công suất hiện có.
Trong dài hạn, mọi đầu vào đều biến đổi. Doanh nghiệp có thể mở rộng quy trình sản xuất. Chi phí dài hạn đo lường hiệu quả khi chính năng lực có thể thay đổi, thể hiện chi phí tối thiểu đạt được cho bất kỳ mức đầu ra nào
Trong dài hạn, tối ưu hóa bằng cách chọn chính mức công suất tối ưu.
Phân tích sản xuất và lợi nhuận
Hàm chi phí được dùng để phân tích hành vi định giá. Doanh nghiệp so sánh các đường chi phí với giá thị trường để quyết định có nên mở rộng hay thu hẹp sản xuất. Nếu chi phí cận biên thấp hơn giá thị trường, sản xuất thêm làm tăng lợi nhuận; nếu chi phí cận biên lớn hơn giá thị trường, sản xuất thêm sẽ tốn tiền.
Hàm chi phí cũng được dùng trong chiến lược định giá. Chúng xác định mức giá tối thiểu khả thi mà doanh nghiệp có thể tính. Doanh nghiệp có thể đặt giá cao hơn chi phí cận biên để tối đa hóa lợi nhuận, hoặc gần với MC trong các ngành cạnh tranh cao. Nhờ đó, phân tích chi phí hỗ trợ định giá hòa vốn, định giá cộng chi phí và định giá động.
Điểm hòa vốn xảy ra khi tổng doanh thu bằng tổng chi phí.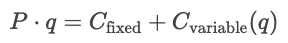
Tại điểm này, công ty bù đắp toàn bộ chi phí nhưng không có lợi nhuận. Sản xuất ít hơn dẫn đến thua lỗ, trong khi sản xuất nhiều hơn tạo ra lợi nhuận.
Lợi nhuận là chênh lệch giữa tổng doanh thu và tổng chi phí.
Nếu doanh thu cận biên vượt quá chi phí cận biên (MR > MC), doanh nghiệp sẽ tăng sản lượng để tạo thêm lợi nhuận. Nếu doanh thu cận biên nhỏ hơn chi phí cận biên (MR < MC), doanh nghiệp sẽ giảm sản lượng để tăng lợi nhuận. Doanh nghiệp tối đa hóa lợi nhuận bằng cách sản xuất tại mức mà MR = MC.
Để biết thêm về tài chính, tôi khuyến nghị tham khảo các tài nguyên DataCamp sau.
Hàm chi phí trong Học máy
Trong các ứng dụng ML, hàm chi phí định lượng phần dư (chênh lệch giữa giá trị dự đoán và giá trị thực) trên toàn bộ tập dữ liệu. Phần này khám phá các họ hàm chi phí chính và cách chúng định hình hành vi mô hình.
Các mất mát trong hồi quy
Trong bối cảnh học máy, mục tiêu của hồi quy (không nhất thiết là hồi quy tuyến tính ) là dự đoán một giá trị liên tục. Hàm mất mát hồi quy định lượng lỗi giữa giá trị thực và giá trị dự đoán cho một mẫu cụ thể; hàm chi phí tổng hợp các hàm mất mát thành một đại lượng tổng thể. Quá trình tối ưu hóa sử dụng hàm chi phí để tối thiểu hóa lỗi tổng thể.
Chúng ta tập trung vào bốn họ hàm chi phí chính: sai số tuyệt đối trung bình (MAE), sai số bình phương trung bình (MSE), căn sai số bình phương trung bình (RMSE) và mất mát Huber.
Các hàm chi phí khác nhau xử lý lỗi theo những cách khác nhau. Về thực chất, chúng định nghĩa mức độ phạt sai lệch giữa giá trị dự đoán và giá trị thực. MAE áp dụng mức phạt đồng đều, đại diện cho hành vi trung vị và tính bền vững với ngoại lệ. MSE bình phương từng phần dư, khiến lỗi lớn chi phối và bị phạt nặng hơn. Mất mát Huber pha trộn hai cách này, dùng mức phạt bậc hai cho lỗi nhỏ và tuyến tính cho lỗi lớn (vượt ngưỡng δ).