
Corso
Introduzione alla scrittura di funzioni in R
4 ore
53.9K
Le funzioni di costo agiscono come l'"arbitro del punteggio" delle decisioni. Misurano quanto le previsioni si discostano dai valori reali di un dataset rispetto ai valori previsti. Nel machine learning, guidano gli algoritmi di ottimizzazione per minimizzare l'errore e migliorare l'accuratezza del modello.
In questo articolo costruiamo l'intuizione passo dopo passo. Partiamo dalle applicazioni economiche, dove le funzioni di costo descrivono il trade-off tra produzione ed efficienza. Poi passiamo al machine learning, dove guidano l'addestramento dei modelli. Successivamente, esaminiamo l'ottimizzazione come ponte tra i due ambiti. Infine, esploriamo esempi reali.
Le funzioni di costo sono fondamentali per l'ottimizzazione e la valutazione. Definiamo matematicamente le funzioni di costo ed esaminiamone le proprietà chiave.
Una funzione di costo (chiamata anche "funzione di errore") mappa una o più variabili in ingresso in un singolo valore numerico che rappresenta il "costo" di una decisione o previsione. Nel machine learning, di solito è definita come la media della funzione di loss su tutti i campioni del dataset.
La funzione di costo svolge due ruoli: serve come obiettivo che un algoritmo di ottimizzazione minimizza e come metrica di valutazione per misurare quanto bene si comporta un modello.
Vediamo una funzione di costo come obiettivo. Per ogni casa, la funzione di loss penalizza la differenza tra il prezzo di vendita reale e quello previsto. La funzione di costo aggrega queste penalità su tutte le case:
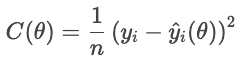
Un costo più basso indica un adattamento complessivo migliore, mentre un costo più alto indica un errore medio maggiore. L'ottimizzatore regola i parametri per minimizzare questo costo.
Come metrica di valutazione, le funzioni di costo misurano le prestazioni. Per esempio, un classificatore può essere valutato con accuracy o recall, o con qualsiasi metrica adatta all'applicazione. In questo modo, le funzioni di costo forniscono un modo per giudicare il successo.
Tre proprietà matematiche sono particolarmente rilevanti.
Insieme, queste proprietà determinano quanto una funzione di costo sia trattabile per l'ottimizzazione. Quando una di queste proprietà manca, possono essere necessarie tecniche speciali per compensare.
Le funzioni di costo descrivono la relazione tra la quantità di output e il costo totale dei prodotti. Sono uno strumento essenziale per comprendere il comportamento delle imprese, le strategie di pricing e l'analisi dei profitti.
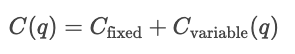
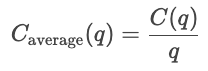
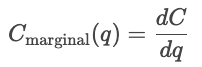
Le curve di costo mostrano come i costi variano in funzione della quantità totale prodotta. I costi fissi sono costanti, quindi sono rappresentati come una linea orizzontale, mentre i costi variabili aumentano in funzione delle unità prodotte.
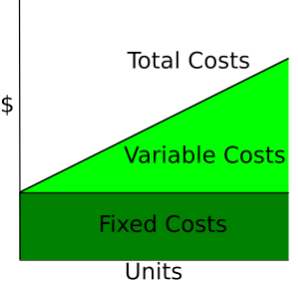
Wikipedia: Cost Curve
Nel breve periodo, almeno un input, come il capitale o la dimensione dell'impianto, è mantenuto costante, mentre altri input variano. I costi di breve periodo misurano quanto efficientemente un'impresa opera con la configurazione attuale. Quindi, per una quantità q data, il costo nel breve termine è la somma dei costi fissi e dei costi variabili dipendenti dalla quantità.
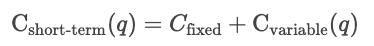
Nel breve periodo, ottimizza entro la capacità attuale.
Nel lungo periodo, tutti gli input sono variabili. L'impresa potrebbe scalare i processi produttivi. I costi di lungo periodo misurano l'efficienza quando può cambiare la capacità stessa, mostrando il costo minimo ottenibile per qualsiasi livello di output
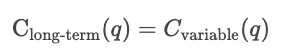
Nel lungo periodo, ottimizza scegliendo la capacità ottimale stessa.
Le funzioni di costo sono usate per analizzare il comportamento dei prezzi. Le imprese confrontano le curve di costo con i prezzi di mercato per decidere se espandere o ridurre la produzione. Se il costo marginale è inferiore al prezzo di mercato, produrre di più aumenta il profitto; se il costo marginale è inferiore al prezzo di mercato, produrre più unità costa denaro.
Le funzioni di costo sono utilizzate anche nelle strategie di pricing. Determinano il prezzo minimo praticabile che un'azienda può applicare. Le imprese possono fissare prezzi al di sopra del costo marginale per massimizzare il profitto, o più vicini all'MC in settori altamente competitivi. Così, l'analisi dei costi informa il pricing di pareggio, il cost-plus pricing e le strategie di pricing dinamico.
Il punto di pareggio si verifica quando il ricavo totale è uguale al costo totale.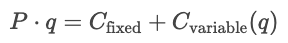
In questo punto, l'azienda copre tutti i costi ma non realizza profitto. Produrre meno comporta una perdita, mentre produrre di più genera profitto.
Il profitto è la differenza tra ricavo totale e costo totale.
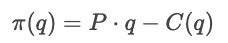
Se il ricavo marginale supera il costo marginale (MR > MC), l'impresa aumenterà l'output per generare più profitto. Se il ricavo marginale è inferiore al costo marginale (MR < MC), l'impresa ridurrà l'output per ottenere profitto aggiuntivo. L'impresa massimizza il profitto producendo la quantità per cui MR = MC.
Per ulteriori informazioni sulla finanza, ti consiglio di consultare queste risorse DataCamp.
Nelle applicazioni di ML, le funzioni di costo quantificano i residui (la differenza tra valori previsti e valori reali) su tutto il dataset. In questa sezione esploriamo le principali famiglie di funzioni di costo e come influenzano il comportamento del modello.
Nel contesto del machine learning, l'obiettivo della regressione (non necessariamente lineare regression) è prevedere un valore continuo. Una funzione di loss per regressione quantifica l'errore tra valori reali e previsti per un determinato campione; le funzioni di costo aggregano le funzioni di loss in una quantità complessiva. I processi di ottimizzazione usano le funzioni di costo per minimizzare l'errore complessivo.
Ci concentriamo sulle quattro principali famiglie di funzioni di costo: mean absolute error (MAE), mean squared error (MSE), root mean square error (RMSE) e Huber loss.
Funzioni di costo diverse gestiscono gli errori in modo diverso. In pratica, definiscono quanto severamente punire gli scostamenti tra valori previsti e reali. La MAE applica una penalità uniforme, rappresentando un comportamento mediano e robusto agli outlier. La MSE eleva al quadrato ogni residuo, facendo sì che gli errori grandi dominino e siano puniti più severamente. La Huber loss fonde le due, usando una penalità quadratica per errori piccoli e lineare per quelli grandi (oltre una soglia δ).
La mean absolute error è definita come la media del valore assoluto dei residui.
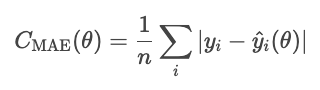
La MAE tratta tutti gli scostamenti allo stesso modo, quindi è meno influenzata dagli outlier rispetto ad altri metodi che vedremo, come la MSE. Tuttavia, l'errore assoluto è scomodo matematicamente e rende più difficile l'ottimizzazione basata sul gradiente.
Una nota sul parametro della funzione. θ rappresenta i parametri del modello. L'ottimizzatore controlla il costo in base a questi parametri, non direttamente sui valori previsti che ne derivano. Pertanto, scriviamo il costo come funzione di θ, non di Ŷi.
La mean squared error (MSE) è data dalla seguente formula.
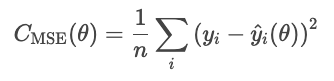
Elevare al quadrato i residui enfatizza gli errori grandi, il che rende la MSE sensibile agli outlier. Tuttavia, questa forma di errore è derivabile e convessa, quindi adatta all'ottimizzazione.
Uno svantaggio della MSE è che le sue unità sono al quadrato. Per esempio, in un modello di regressione dei prezzi delle case, la loss è in dollari al quadrato, che è poco intuitivo. La RMSE corregge questo problema prendendo la radice quadrata della MSE.
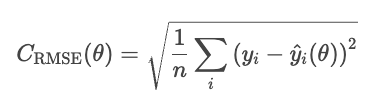
La RMSE si comporta in modo simile alla MSE ma le unità sono nelle stesse unità del problema (dollari, non dollari al quadrato).
La Huber loss è meno sensibile agli outlier nei dati rispetto alla MSE (o alla RMSE). Combina MAE e MSE e controlla la transizione con un parametro δ.
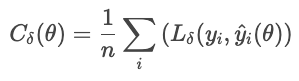
dove
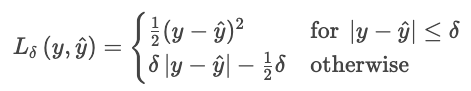
Questa formula impedisce a pochi grandi residui di dominare la loss. La Huber loss è una buona scelta per dati reali rumorosi in cui ti aspetti osservazioni occasionalmente estreme.
La classificazione prevede categorie discrete. Queste funzioni di costo confrontano distribuzioni di probabilità con le etichette vere, penalizzando previsioni errate o troppo sicure.
La cross-entropy loss (log loss) premia un modello quando è correttamente sicuro e lo punisce quando è sicuro ma sbaglia.
Per un classificatore che produce probabilità pure Ŷ, la verosimiglianza dell'etichetta osservata Y è
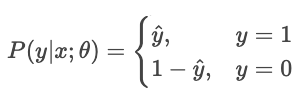
La stima di massima verosimiglianza (MLE) massimizza questa verosimiglianza su tutti i campioni.
Trasformiamo questa idea nel minimizzare il costo. Minimizzare equivale a massimizzare il negativo, quindi invertiamo il segno. Prendiamo anche i logaritmi.
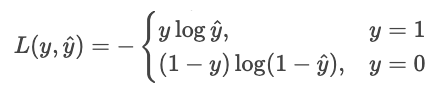
Possiamo scriverlo più sinteticamente come una singola somma.
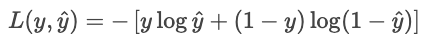
Perché il logaritmo? Il log ha diversi vantaggi
Supponiamo che un modello predica probabilità per due scelte: "dog" (scelta 0) o "cat" (scelta 1). Se la risposta reale è 1 ("cat") e il modello è sicuro al 90% che sia un gatto, la loss è piccola perché il modello era sicuro e corretto. Se il modello dice di essere sicuro al 10% che sia un gatto, la loss è grande, perché il modello era sicuro ma sbagliava.
Quando ci sono più di due classi ("cat", "dog", "bird"), il modello produce un punteggio grezzo ("logit") per ciascuna classe, indicato con Zi. I logit possono essere qualsiasi numero reale, quindi sono convertiti in probabilità che sommano a uno tramite la funzione softmax.
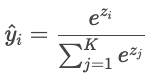
Le previsioni del modello sono quindi confrontate con le etichette reali usando la cross-entropy.
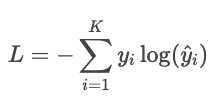
Esempio
Supponiamo che l'etichetta vera sia "cat" e che il modello preveda probabilità: cat: 80%, dog: 15%, bird: 5%. La loss è
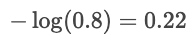
Se la probabilità prevista per "cat" fosse solo del 30%, allora la loss sarebbe molto più alta:
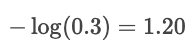
Il log punisce gli errori sicuri e premia le previsioni ad alta confidenza.
La hinge loss è usata principalmente per la classificazione a margine massimo, come nelle support vector machines (SVM). L'obiettivo è classificare con sicurezza mantenendo le previsioni lontane dalla frontiera decisionale.
Per la classificazione binaria, la hinge loss è data dalla seguente formula.
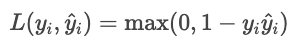
dove
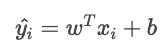
La funzione di costo totale è
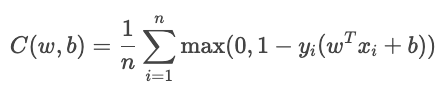
Il termine YiŶi misura quanto bene è classificato il campione.
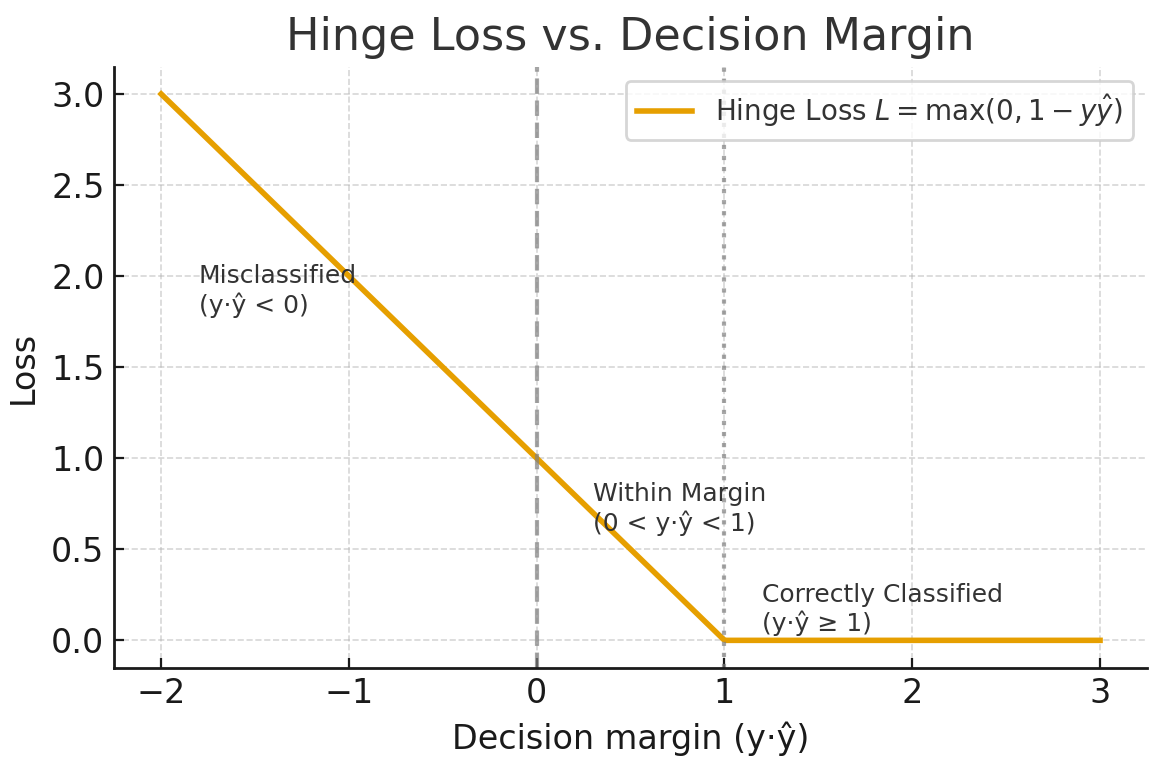
Generato da ChatGPT 5
La divergenza di Kullback-Leibler (KL) è una misura di quanto una distribuzione di probabilità approssimante Q differisca da una data distribuzione di probabilità P. È definita come
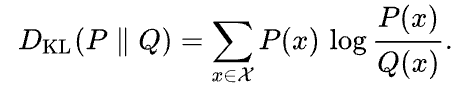
Wikipedia
La divergenza KL può essere interpretata come la differenza media nel numero di bit per codificare campioni di P usando un codice ottimizzato per Q.
Le tecniche di regolarizzazione impediscono ai modelli di adattarsi al rumore nei dati di training aggiungendo alla funzione di costo un termine che penalizza soluzioni eccessivamente complesse.
Senza regolarizzazione, il modello minimizza la loss:
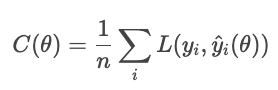
Con la regolarizzazione, il modello aggiunge un termine di penalità
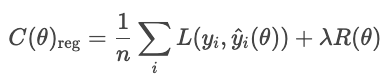
dove
Tipi comuni di regolarizzazione sono L1, L2 ed elastic net.
La regolarizzazione L1 (nota anche come lasso) aggiunge alla funzione di costo il valore assoluto di ciascun peso del modello.
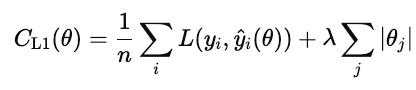
Quando questo costo viene minimizzato, molti pesi vengono spinti a zero. Questo rende la L1 una forma di selezione automatica delle feature. Le feature che non contribuiscono vengono spinte a zero.
La regolarizzazione L2 (nota anche come ridge regression) penalizza il quadrato di ciascun peso del modello.
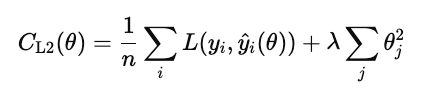
A differenza della L1 non porta i pesi esattamente a zero, ma li riduce in modo graduale. Questo mantiene tutte le feature nel modello ma ne riduce l'influenza per stabilizzare le previsioni.
Elastic net aggiunge sia L1 che L2.
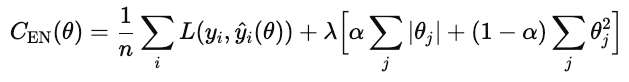
λ controlla l'intensità complessiva della regolarizzazione. α è un numero tra 0 e 1 che controlla le percentuali di L1 rispetto a L2, dove 1 è L1 pura e 0 è ridge pura.
Le diverse strategie di loss per classificazione presentano dei trade-off.
La cross-entropy massimizza la probabilità corretta penalizzando le risposte errate e sicure. I trade-off sono che è sensibile agli outlier e ai dati etichettati male. Funziona meglio quando ti interessa la qualità della confidenza (ad es., modelli di rischio).
La hinge loss impone un margine affinché le classificazioni corrette non siano solo corrette, ma anche sicure. Ignora i campioni sufficientemente oltre il margine e dà una penalità lineare per le violazioni. È meno sensibile agli outlier rispetto alla cross-entropy, ma più difficile da ottimizzare in modo fluido, poiché non è derivabile nel punto di cerniera.
La divergenza di Kullback-Leibler (KL) fa corrispondere una distribuzione di probabilità a un'altra. È equivalente alla cross-entropy meno l'entropia della distribuzione vera.
Per ulteriori informazioni, consulta questi link.
Finora abbiamo discusso le funzioni di costo in teoria. In pratica, il successo di un modello di ML dipende da quanto efficientemente le minimizza. In questa sezione introduciamo dettagli pratici dei principali algoritmi di ottimizzazione e delle strategie di tuning.
L'ottimizzazione è il processo di trovare i valori ottimali dei parametri del modello che minimizzano una funzione di costo. In ML, significa scoprire i parametri che rendono le previsioni il più possibile vicine ai valori reali.
La discesa del gradiente è l'algoritmo standard per ottimizzare le funzioni di costo. Aggiorna iterativamente i parametri del modello nella direzione che riduce maggiormente il costo, cioè il gradiente negativo. Concettualmente, misura la pendenza multivariata della funzione di costo e scende lungo il pendio.
La regola di aggiornamento è
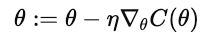
dove θ sono i parametri del modello, n è il learning rate, e  è il gradiente della funzione di costo rispetto ai parametri.
La scelta del learning rate è critica. Se è troppo grande, gli aggiornamenti oltrepassano il minimo e oscillano o divergono. Se è troppo piccolo, la convergenza diventa lenta e può bloccarsi in minimi locali.
Le principali varianti sono batch, stocastica e mini-batch.
La discesa del gradiente standard applica un learning rate fisso a tutti i parametri. Nei modelli complessi, parametri diversi possono richiedere passi di dimensione diversa. Gli ottimizzatori adattivi regolano i learning rate in base alla storia delle ampiezze dei gradienti.
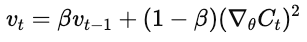
L'apprendimento di ciascun parametro è scalato inversamente a questa media. Ciò previene l'oscillazione e consente progressi stabili anche quando alcuni parametri hanno gradienti ripidi. RMSProp è ampiamente usato per reti ricorrenti e dati rumorosi.
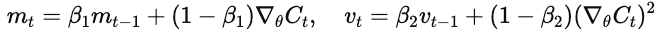
Converge velocemente, è robusto ai dati rumorosi ed è l'ottimizzatore predefinito per i framework di reti profonde.
Prima di ottimizzare con la discesa del gradiente, scala le feature in modo che operino su intervalli comparabili. Uno scaling corretto migliora la stabilità e l'efficienza dell'ottimizzazione.
Senza scaling, le feature con intervalli numerici ampi dominano il gradiente. La discesa del gradiente allora zigzaga invece di compiere passi diretti verso il minimo.
Ci sono due approcci comuni.
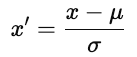
dove u è la media e ơ è la deviazione standard. La standardizzazione preserva la struttura dei dati.
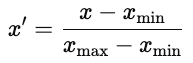
La normalizzazione è comune nelle reti neurali, dove le funzioni di attivazione rendono meglio con input limitati.
L'inizializzazione dei parametri influenza fortemente l'addestramento del modello. Una cattiva inizializzazione può causare convergenza lenta, gradienti esplosivi o vanescenti, o modelli che non imparano. Una buona inizializzazione colloca i parametri in una regione della superficie di costo in cui i gradienti sono stabili.
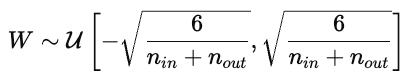
Questo mantiene attivazioni e gradienti approssimativamente costanti tra i layer.
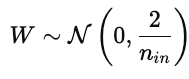
Questo evita che i gradienti svaniscano troppo velocemente durante il backpropagation.
Una curva di training loss traccia l'errore del modello sul dataset di training nel tempo. Mostra quanto bene il modello aggiorna i parametri per minimizzare l'errore. Una curva che diminuisce costantemente indica che il modello sta imparando i pattern dai dati.
La curva di validation loss mostra la capacità del modello di generalizzare su dati non visti, come un set di hold-out o di validazione. Indica la capacità del modello di prevedere su dati mai visti prima.
Idealmente, entrambe le curve diminuiscono all'inizio e poi si appiattiscono. Questo dimostra che il modello sta sia imparando in modo efficace sia generalizzando efficacemente.
Overfitting si verifica quando il modello apprende il rumore come se fosse segnale e non generalizza bene. Questo appare in un grafico con curve di training e validation quando la training loss diminuisce ma la validation loss aumenta. Le soluzioni includono usare un dataset più grande o applicare regolarizzazione nel modello.
Underfitting si verifica quando il modello non riesce a catturare i pattern sottostanti nei dati. Sia le curve di training che di validation restano alte. In questo caso, prova con più dati, un modello più complesso o riduci la regolarizzazione.
Convergenza è il punto in cui la curva si appiattisce e ulteriore training offre pochi miglioramenti. Questo è il punto di equilibrio tra overfitting e underfitting.
Abbiamo visto come economia e machine learning si affidino all'ottimizzazione per guidare il processo decisionale e l'addestramento. Entrambi i campi mirano a prendere le decisioni migliori in base a una metrica di costo o loss. Approfondiamo più in generale la teoria dell'ottimizzazione.
Una funzione obiettivo è una funzione matematica che definisce ciò che vogliamo minimizzare o massimizzare. Nei casi visti finora, abbiamo minimizzato costo o errore. In economia abbiamo considerato le curve di costo, e in ML abbiamo visto le loss di regressione (MAE, RMSE, Huber) e le loss di classificazione (cross-entropy, hinge loss, KL loss). Sono entrambi esempi di ottimizzazione di una funzione obiettivo.
Spesso vogliamo ottimizzare obiettivi multipli, spesso in conflitto tra loro. Un'azienda potrebbe voler massimizzare il profitto minimizzando al contempo il rischio. Un data scientist potrebbe voler migliorare l'accuratezza del modello senza sacrificare interpretabilità o equità. Questi obiettivi in competizione definiscono un problema di ottimizzazione multi-obiettivo in cui migliorare un obiettivo può peggiorarne un altro.
Una soluzione è ottimale in senso paretiano se nessun obiettivo può essere migliorato senza peggiorarne almeno un altro. L'insieme delle soluzioni pareto-ottimali forma la frontiera di Pareto, una curva che consiste nei migliori trade-off ottenibili. Ogni punto su questa curva rappresenta un diverso equilibrio di priorità.
Per esempio, aumentare la complessità di un modello può migliorare l'accuratezza ma ridurre l'interpretabilità. I modelli più semplici sono più facili da spiegare ma possono performare peggio. La frontiera di Pareto include i "migliori trade-off" ed esclude soluzioni dominate da altre variabili.
La scelta del punto giusto dipende dal contesto e dal giudizio. Puoi assegnare pesi a ciascun obiettivo o usare vincoli di policy.
Quando gli esiti sono incerti, l'ottimizzazione minimizza la loss attesa, la perdita media su tutti gli scenari possibili. In ML, questa idea compare nella funzione di rischio.
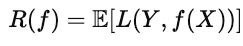
dove L(Y,f(x)) è la loss per una data previsione, e l'aspettazione fa la media sulla distribuzione dei dati. L'obiettivo è trovare il modello f che minimizza questa loss attesa. Questo modello performa meglio in media, non solo sui singoli campioni.
Il rischio di Bayes è il limite inferiore teorico della loss attesa. Formalmente, è dato dalla seguente formula.
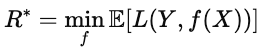
Intuitivamente, è il "punteggio perfetto", cioè il valore più piccolo ottenibile con informazioni perfette sulla distribuzione dei dati. Quanto più le prestazioni di un modello si avvicinano al rischio di Bayes, tanto più è ottimale.
Le funzioni di costo sono utilizzate in qualsiasi settore che prenda decisioni basate sui dati. Aiutano a bilanciare obiettivi in competizione e a formalizzare cosa significa "meglio". Queste funzioni bilanciano obiettivi in competizione e guidano l'ottimizzazione. La stessa logica usata per addestrare i modelli di ML è usata per ottimizzare i processi reali.
Nella manifattura, per esempio, le funzioni di costo quantificano le perdite, come la perdita di inventario. Una funzione di costo dell'inventario bilancia la spesa di scorte in eccesso contro le penalità per le carenze. Quadri simili sono usati per la schedulazione della produzione o l'uso di energia per minimizzare il costo totale atteso sotto incertezza.
In sanità, i modelli predittivi usano funzioni di costo per bilanciare accuratezza e allocazione delle risorse. Per esempio, un modello di rischio di riammissione identifica precocemente i pazienti ad alto rischio così che i clinici possano intervenire con chiamate di follow-up o visite domiciliari. Perdere un paziente ad alto rischio è più costoso che segnalarne uno a basso rischio, quindi la funzione penalizza diversamente questi errori.
La finanza usa anch'essa funzioni obiettivo. Per esempio, i modelli di credit scoring prevedono la probabilità che un mutuatario vada in default entro un periodo stabilito, diciamo dodici mesi. Approvare un mutuatario rischioso comporta una potenziale perdita finanziaria, mentre rifiutare un mutuatario sicuro comporta una potenziale perdita di ricavi. Il modello minimizza il costo atteso.
In tutti questi domini, le funzioni di costo bilanciano i trade-off in quantità misurabili che i decisori possono usare e con cui possono ragionare.
Le funzioni di costo forniscono un metodo per valutare le decisioni. In economia, modellano il trade-off tra output ed efficienza. Nel machine learning, misurano il divario tra previsioni e verità.
In ML, le funzioni di costo sono le fondamenta della progettazione dei modelli. La scelta delle funzioni di loss determina cosa il modello considera "successo". La mean squared error premia l'accuratezza complessiva, la cross-entropy premia probabilità calibrate e la hinge loss premia la separazione sicura.
In tutti i domini e i settori, la logica di base è la stessa: definire un obiettivo e ottimizzarlo. Le funzioni di costo traducono obiettivi vaghi in numeri concreti che guidano l'ottimizzazione.
Le funzioni di costo sono utili in economia, machine learning, manifattura, finanza, sanità e ovunque si voglia quantificare i trade-off.
Per ulteriori informazioni, ti consiglio queste risorse DataCamp.
I migliori corsi DataCamp
Corso
Programma
Corso
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min



