

Ortalama Mutlak Hata (MAE)
Ortalama mutlak hata, artıkların mutlak değerlerinin ortalaması olarak tanımlanır.
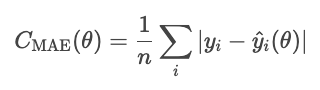
MAE tüm sapmaları eşit şekilde ele alır; bu nedenle MSE gibi göreceğimiz diğer yöntemler kadar aykırı değerlerden etkilenmez. Ancak, mutlak hata matematiksel olarak sakıncalıdır ve gradyan tabanlı optimizasyonu zorlaştırır.
Fonksiyon parametresi hakkında bir not. θ model parametrelerini temsil eder. En iyileyici maliyeti, doğrudan onlardan türeyen tahmin değerlerine değil, bu parametrelere dayanarak kontrol eder. Bu nedenle maliyeti, θ'nın, Ŷi'nın değil bir fonksiyonu olarak yazarız.
MSE
Ortalama kare hata (MSE) aşağıdaki formülle verilir.
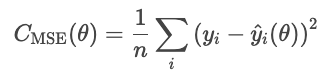
Artıkların karesini almak, büyük hataları abartır; bu da MSE'yi aykırı değerlere duyarlı yapar. Ancak bu hata biçimi türevlenebilir ve konvekstir; bu da optimizasyon dostu olmasını sağlar.
RMSE
MSE'nin bir dezavantajı, biriminin kareli olmasıdır. Örneğin, konut fiyatları regresyon modelinde, kayıp dolar kare cinsindendir; bu ise sezgisel anlamdan yoksundur. RMSE bu sorunu MSE'nin karekökünü alarak düzeltir.
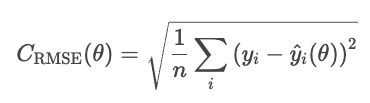
RMSE, MSE'ye benzer davranır ancak birimi, problemin birimleriyle aynıdır (dolar, dolar kare değil).
Huber
Huber kaybı, MSE'ye (veya RMSE'ye) kıyasla verideki aykırı değerlere daha az duyarlıdır. MAE ve MSE'yi birleştirir ve geçişi bir δ parametresiyle kontrol eder.
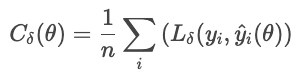
burada
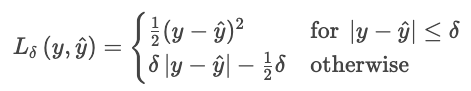
Bu formül, birkaç büyük artığın kayba hükmetmesini engeller. Huber kaybı, ara sıra aşırı gözlemler beklediğiniz gürültülü gerçek dünya verileri için iyi bir seçimdir.
Sınıflandırma kayıpları
Sınıflandırma, ayrık kategorileri tahmin eder. Bu maliyet fonksiyonları, yanlış ya da aşırı kendinden emin tahminleri cezalandırarak olasılık dağılımlarını gerçek etiketlerle karşılaştırır.
Çapraz entropi kaybı
Çapraz entropi kaybı (log kaybı), model doğruya kendinden emin olduğunda ödüllendirir, kendinden emin bir şekilde yanıldığında cezalandırır.
Saf olasılıklar üreten bir sınıflandırıcı için Ŷ, gözlenen etiket Y'nin olabilirliği şöyledir:
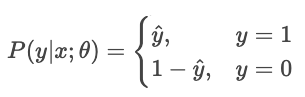
En çok olabilirlik kestirimi (MLE) bu olabilirliği tüm örnekler üzerinde maksimize eder.
Bu fikri maliyeti en aza indirmeye dönüştürelim. En azlamak, negatifi maksimize etmekle aynıdır; bu yüzden işareti çevirelim. Bir de log alalım.
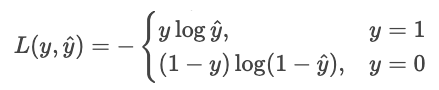
Bunu tek bir toplam olarak daha özlü yazabiliriz.
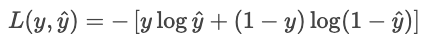
Neden log? Logun birkaç avantajı vardır
- Çarpımı toplama çevirir. Küçük sayıları çarpıp taşma (underflow) riski almak yerine olasılıkları toplarız,
- Fonksiyonu konkav yapar. Log, olabilirliği tek bir küresel maksimuma sahip konkav bir fonksiyona dönüştürür.
- Anlamlı bir ceza eğrisi verir.
- p = 1.0, 0 kayıp ile sonuçlanır,
- p = 0.9, 0.1 (küçük) kayıpla sonuçlanır
- p = 0.2, 2.3 (büyük) kayıpla sonuçlanır
- p = 0.01, 4.6 (çok büyük) kayıpla sonuçlanır
- İçiçe üstel ifadelerden kaçınır. Lojistik regresyon ve sinir ağlarında, log, iç içe üstel ifadeleri "açar"; türevleri basit ve kararlı kılar.
Bir modelin iki seçenek için olasılık tahmin ettiğini varsayalım: "köpek" (seçenek 0) veya "kedi" (seçenek 1). Gerçek yanıt 1 ("kedi") ise ve model kediden %90 emin ise, model hem emin hem de doğru olduğundan kayıp küçüktür. Model kediden yalnızca %10 emin olduğunu söylerse, model emin ama yanlış olduğundan kayıp büyüktür.
Çok sınıflı sınıflandırma için çapraz entropi
İki sınıftan fazlası olduğunda ("kedi", "köpek", "kuş"), model her sınıf için bir ham skor ("logit") üretir; Zi ile gösterilir. Logitler herhangi bir reel sayı olabilir; bu nedenle softmax fonksiyonu ile toplamı bire eşit olasılıklara dönüştürülürler.
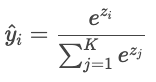
Ardından modelin tahminleri, gerçek etiketlerle çapraz entropi kullanılarak karşılaştırılır.
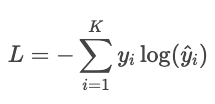
Örnek
Gerçek etiketin "kedi" olduğunu ve modelin şu olasılıkları tahmin ettiğini varsayalım: kedi: %80, köpek: %15, kuş: %5. Kayıp şöyledir:
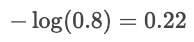
"Kedi" için tahmin edilen olasılık yalnızca %30 olsaydı, kayıp çok daha yüksek olurdu:
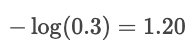
Log, kendinden emin hataları cezalandırır ve yüksek güvenli tahminleri ödüllendirir.
Hinge Loss
Hinge kaybı çoğunlukla destek vektör makinelerinde (SVM) olduğu gibi maksimum marjlı sınıflandırma için kullanılır. Amaç, tahminleri karar sınırından uzak tutarak güvenle sınıflandırmaktır.
İkili sınıflandırma için hinge kaybı aşağıdaki formülle verilir.
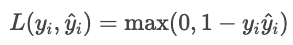
burada
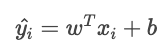
Toplam maliyet fonksiyonu şöyledir:
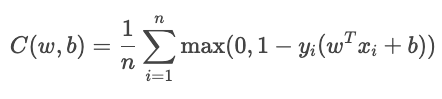
YiŶi terimi, örneğin ne kadar iyi sınıflandığını ölçer.
- 1'den büyük olduğunda, örnek sınırın doğru tarafındadır ve kayıp yoktur.
- 0 ile 1 arasındayken, nokta marj içinde yer alır; bu nedenle küçük bir ceza uygulanır.
- 0'dan küçük olduğunda, model yanlış sınıflandırmıştır. Kayıp, sınırdan olan mesafe ile doğrusal olarak artar.
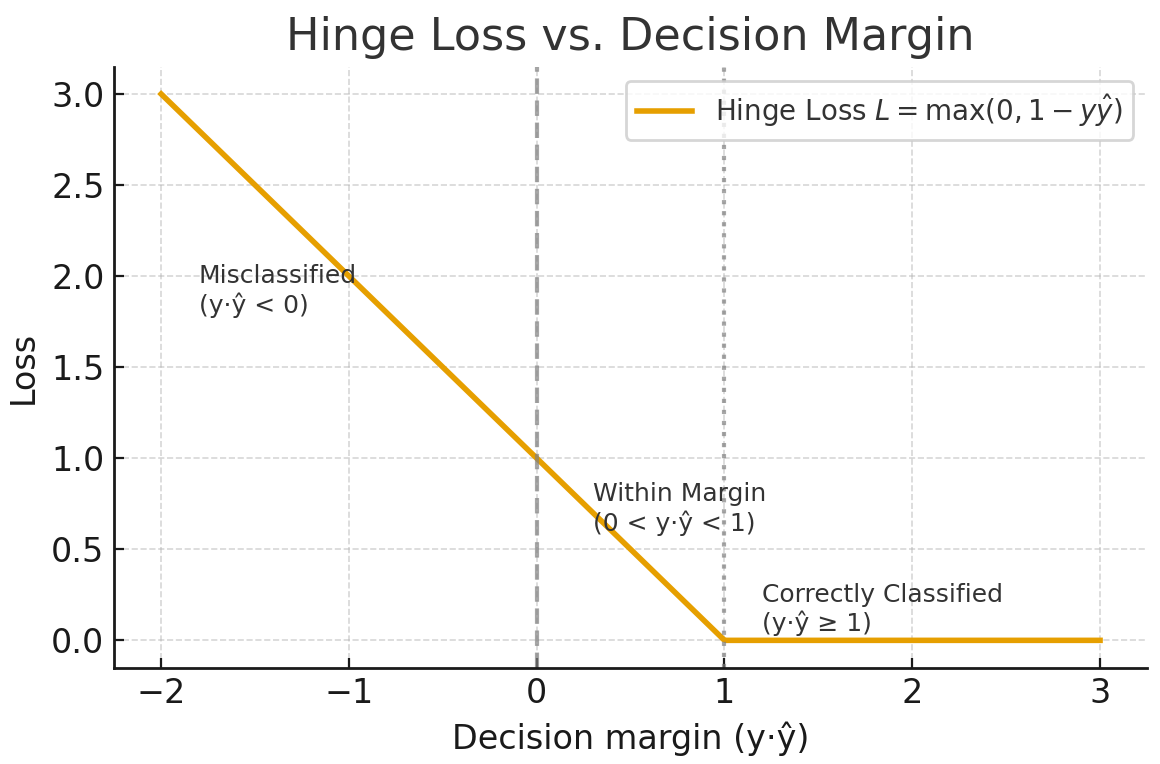
ChatGPT 5 tarafından oluşturuldu
Kullback-Leibler (KL)
Kullback-Leibler (KL) sapması, yaklaşıklanan olasılık dağılımı Q'nun, verilen bir olasılık dağılımı P'den ne kadar saptığını ölçer. Şöyle tanımlanır:
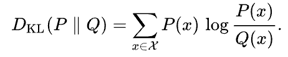
Vikipedi
KL sapması, P örneklerini, Q için optimize edilmiş bir kodla kodlamak için gereken ortalama bit farkı olarak da yorumlanabilir.
Düzenlileştirme
Düzenlileştirme teknikleri, eğitim verilerindeki gürültünün modele uydurulmasını, maliyet fonksiyonuna aşırı karmaşık çözümleri cezalandıran bir terim ekleyerek engeller.
Düzenlileştirme olmadan, model kaybı en aza indirir:
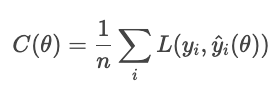
Düzenlileştirme ile model bir ceza terimi ekler
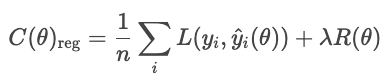
burada
- L olağan kayıptır (ör. RMSE, çapraz entropi)
- R(θ) model karmaşıklığını ölçer
- λ uyum ile sadelik arasındaki ödünleşimi kontrol eder
Yaygın düzenlileştirme türleri L1, L2 ve elastic net'tir.
L1 düzenlileştirme (lasso olarak da bilinir), her model ağırlığının mutlak değerini maliyet fonksiyonuna ekler.
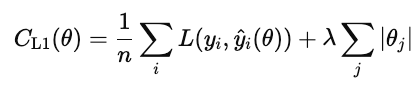
Bu maliyet en aza indirildiğinde birçok ağırlık sıfıra itilmiş olur. Bu, L1'i otomatik özellik seçiminin bir biçimi yapar. Katkı sunmayan özellikler sıfıra itilir.
L2 düzenlileştirme (ridge regresyon olarak da bilinir), her model ağırlığının karesini cezalandırır.
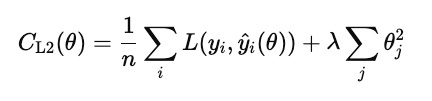
L1'in aksine ağırlıkları tam olarak sıfıra indirmez, onları düzgün şekilde küçültür. Bu, tüm özellikleri modelde tutar ancak etkilerini azaltarak tahminleri dengeler.
Elastic net hem L1'i hem L2'yi ekler.
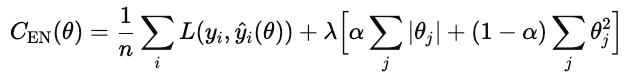
λ genel düzenlileştirmenin ne kadar güçlü olduğunu kontrol eder. α, L1'e karşı L2'nin yüzdelerini kontrol eden 0 ile 1 arasında bir sayıdır; 1 saf L1, 0 saf ridge'dir.
Ödünleşimler
Farklı sınıflandırma kayıp stratejilerinin ödünleşimleri vardır.
Çapraz entropi, yanlış yanıtlarda kendinden emin olmayı cezalandırarak doğru olasılığı maksimize eder. Ödünleşimler; aykırı değerlere ve yanlış etiketlenmiş verilere duyarlı olmasıdır. Güven kalitesiyle ilgilendiğinizde (ör. risk modelleri) en iyi şekilde çalışır.
Hinge kaybı bir marj uygular; böylece doğru sınıflamalar sadece doğru olmakla kalmaz, aynı zamanda güvenle doğrudur. Marjın güvenli biçimde ötesindeki örnekleri görmezden gelir ve ihlaller için doğrusal bir ceza verir. Çapraz entropiye göre aykırı değerlere daha az duyarlıdır, ancak menteşe noktasında türevlenebilir olmadığı için düzgün şekilde optimize etmek daha zordur.
Kullback-Leibler (KL) sapması, bir olasılık dağılımını diğerine uydurur. Çapraz entropinin, gerçek dağılımın entropisi çıkarılmış haline denktir.
Daha fazla bilgi için bu bağlantılara göz atın.
- Makine Öğreniminde Çapraz Entropi Kayıp Fonksiyonu: Model Doğruluğunu Artırma
- Veriden Paraya - Sigorta Ücretlerini Tahmin Etme
- Özellik Mühendisliği ile Fiyat Tahminlerini Optimize Edin
- Veri Kalitesi Boyutları Cheat Sheet
- R Korelasyon Eğitimi
Makine Öğreniminde Maliyet Fonksiyonu Uygulaması ve Pratiği
Şimdiye kadar maliyet fonksiyonlarını teoride tartıştık. Pratikte bir ML modelinin başarısı, bu fonksiyonları ne kadar verimli en aza indirdiğine bağlıdır. Bu bölümde, temel optimizasyon algoritmalarının ve ayarlama stratejilerinin pratik ayrıntılarını tanıtıyoruz.
Optimizasyon algoritmaları ve parametre ayarlama
Optimizasyon, bir maliyet fonksiyonunu en aza indiren model parametrelerinin en uygun değerlerini bulma sürecidir. ML'de bu, tahminleri gerçeğe olabildiğince yaklaştıran parametreleri keşfetmek anlamına gelir.
Gradyan inişi
Gradyan inişi, maliyet fonksiyonlarını optimize etmek için standart algoritmadır. Model parametrelerini maliyeti en çok azaltan yönde, yani negatif gradyan yönünde yinelemeli olarak günceller. Kavramsal olarak, maliyet fonksiyonunun çok değişkenli eğimini ölçer ve yokuş aşağı adımlar atar.
Güncelleme kuralı şöyledir
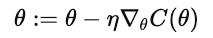
burada θ model parametreleri, n öğrenme oranı, ve  parametrelere göre maliyet fonksiyonunun gradyanıdır.
Öğrenme oranının seçimi kritiktir. Çok büyükse, güncellemeler en düşük noktayı aşar ve salınım yapar veya ıraksar. Çok küçükse, yakınsama yavaşlar ve yerel minimumlarda takılabilir.
Başlıca varyantlar toplu, stokastik ve mini-topludur.
- Toplu (batch) gradyan inişi. Gradyanı tüm eğitim setini kullanarak hesaplar. Büyüktür ama büyük veri kümeleri veya çevrimiçi öğrenme için yavaş ve bellek yoğundur.
- Stokastik gradyan inişi (SGD). Her eğitim örneğinden sonra parametreleri günceller. Hızlı ve bellek açısından verimlidir; ancak her adım, en iyi yoldan biraz sapabilecek derecede gürültülüdür. Yine de rastgelelik yerel minimumlardan kaçmaya yardımcı olabilir.
- Mini-toplu (mini-batch) gradyan inişi. Pratik bir uzlaşma. Hızı ve kararlılığı dengelemek için küçük partiler üzerinde gradyanları hesaplar. Ayrıca GPU paralelleştirmesine imkân tanır.
Uyarlamalı en iyileyiciler
Standart gradyan inişi, tüm parametrelere sabit bir öğrenme oranı uygular. Karmaşık modellerde farklı parametrelerin farklı adım boyutlarına ihtiyacı olabilir. Uyarlamalı en iyileyiciler, gradyan büyüklüklerinin geçmişine dayanarak öğrenme oranlarını ayarlar.
- RMSProp, yakın geçmişteki kare gradyanların üssel azalan ortalamasını kullanır.
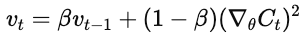
Her parametrenin öğrenmesi bu ortalamanın tersiyle ölçeklenir. Bu, salınımı önler ve bazı parametrelerin dik gradyanlara sahip olduğu durumlarda bile istikrarlı ilerleme sağlar. RMSProp, yinelemeli ağlar ve gürültülü veriler için yaygın olarak kullanılır.
- Uyarlamalı Moment Kestirimi (Adam), geçmiş gradyanların hem ortalamasını hem de varyansını izler ve adım boyutlarını dinamik olarak uyarlar.
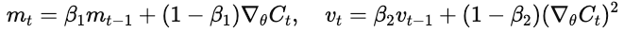
Hızlı yakınsar, gürültülü verilere karşı dayanıklıdır ve derin ağ çerçeveleri için varsayılan en iyileyicidir.
Özellik ölçekleme ve başlatma
Gradyan inişi ile optimize etmeden önce, özellikleri karşılaştırılabilir aralıklarda çalışacak şekilde ölçekleyin. Uygun ölçekleme, optimizasyonun kararlılığını ve verimliliğini artırır.
Ölçekleme olmadan, sayısal aralığı büyük olan özellikler gradyana egemen olur. Gradyan inişi o zaman, en aza doğru doğrudan adımlar atmak yerine zikzak yapar.
İki yaygın yaklaşım vardır.
- Standardizasyon. Her özelliği sıfıra ortalar ve birim varyansa yeniden ölçekler.
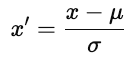
burada u ortalama, ơ standart sapmadır. Standardizasyon, verinin yapısını korur.
- Normalizasyon. Her özelliği tipik olarak [0, 1] sabit aralığına yeniden ölçekleyin.
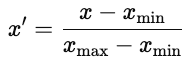
Normalizasyon, aktivasyon fonksiyonlarının sınırlı girdilerle en iyi performansı gösterdiği sinir ağlarında yaygındır.
Parametre başlatma stratejileri
Parametre başlatma, model eğitimini güçlü şekilde etkiler. Kötü başlatma, yavaş yakınsamaya, patlayan veya sönümlenen gradyanlara ya da öğrenemeyen modellere neden olabilir. İyi başlatma, parametreleri gradyanların kararlı olduğu maliyet yüzeyinin bir bölgesine yerleştirir.
- Rastgele başlatma. Tipik olarak uniform ya da normal dağılımdan çekilen küçük rastgele değerler atar. Rastgelelik simetriyi bozar; böylece parametreler farklı özellikler öğrenir. Ancak varyans çok yüksek ya da çok düşükse, gradyanlar patlayabilir veya sönümlenebilir.
- Xavier (Glorot) başlatma. Tanh veya sigmoid gibi doğrusal olmayan aktivasyonlar için tasarlanmıştır; Xavier, ağırlıkların varyansını giriş ve çıkış bağlantılarının sayısına göre ölçekler.
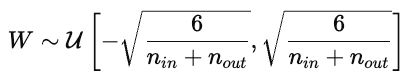
Bu, katmanlar boyunca aktivasyonları ve gradyanları yaklaşık olarak sabit tutar.
- He başlatma. Negatif değerleri sıfırlayan ReLU aktivasyonları için varyansı ayarlar. Ağırlıklar aşağıdaki varyansla normal dağılımdan çekilir:
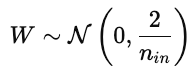
Bu, geri yayılım sırasında gradyanların çok hızlı sönümlenmesini engeller.
İzleme, tanılama ve görselleştirme
Bir eğitim kaybı eğrisi, modelin zaman içindeki eğitim veri kümesi üzerindeki hatasını çizer. Modelin hatayı en aza indirmek için parametrelerini ne kadar iyi güncellediğini gösterir. Sürekli azalan bir eğri, modelin veriden kalıpları öğrendiğini gösterir.
Doğrulama kaybı eğrisi, bir ayırma ya da doğrulama seti gibi görülmemiş veriler üzerinde modelin genelleme yeteneğini gösterir. Modelin daha önce görmediği verileri tahmin etme yeteneğini gösterir.
İdeal olarak, her iki eğri de başlangıçta azalır, sonra yataylaşır. Bu, modelin hem etkili şekilde öğrendiğini hem de etkili şekilde genelleme yaptığını gösterir.
Aşırı uyum, model gürültüyü sanki sinyalmiş gibi öğrendiğinde ve iyi genelleme yapamadığında ortaya çıkar. Eğitim kaybı azalırken doğrulama kaybı artıyorsa bu durum, eğitim ve doğrulama eğrilerini gösteren bir grafikte belirir. Çözümler arasında daha büyük bir veri kümesi kullanmak ya da modelde düzenlileştirme uygulamak bulunur.
Yetersiz uyum, model verideki temel kalıpları yakalayamadığında ortaya çıkar. Hem eğitim hem doğrulama eğrileri yüksek kalır. Bu durumda daha fazla veri, daha karmaşık bir model deneyin veya düzenlileştirmeyi azaltın.
Yakınsama, eğrinin yataylaştığı ve daha fazla eğitimin çok az iyileştirme sağladığı noktadır. Bu, aşırı uyum ile yetersiz uyum arasındaki tatlı noktadır.
Maliyet Fonksiyonu Optimizasyonu ve Karar Teorisi
Ekonomi ve makine öğreniminin, karar alma ve eğitimi yönlendirmek için optimizasyona nasıl güvendiğini gördük. Her iki alan da bir maliyet ya da kayıp metriğine dayanarak en iyi kararları vermeye çalışır. Gelin, optimizasyon teorisini daha genel olarak inceleyelim.
Amaç fonksiyonları
Bir amaç fonksiyonu, neyi en aza indirmek veya maksimize etmek istediğimizi tanımlayan matematiksel bir fonksiyondur. Şimdiye kadar gördüğümüz örneklerde maliyeti veya hatayı en aza indirdik. Ekonomide maliyet eğrilerine, ML'de ise regresyon kayıplarına (MAE, RMSE, Huber) ve sınıflandırma kayıplarına (çapraz entropi, hinge kaybı, KL kaybı) baktık. Bunların her ikisi de bir amaç fonksiyonunu optimize etmeye örnektir.
Çok amaçlı optimizasyon
Çoğu zaman birden çok ve çoğu kez birbiriyle çelişen hedefleri optimize etmek isteriz. Bir şirket kârı maksimize ederken riski en aza indirmek isteyebilir. Bir veri bilimci, yorumlanabilirlik veya adaletten ödün vermeden model doğruluğunu artırmak isteyebilir. Bu tür yarışan hedefler, birini iyileştirmenin diğerini kötüleştirebileceği çok amaçlı bir optimizasyon problemi tanımlar.
Pareto sınırı
Bir çözüm, Pareto optimal ise, hiçbir amaç en az bir diğerini kötüleştirmeden iyileştirilemiyorsa öyledir. Pareto-optimal çözümler kümesi, en iyi elde edilebilir ödünleşimlerden oluşan Pareto sınırını oluşturur; bu eğri, en iyi elde edilebilir ödünleşimlerden oluşur. Bu eğri üzerindeki her nokta, önceliklerin farklı bir dengesini temsil eder.
Örneğin, bir modelin karmaşıklığını artırmak doğruluğu iyileştirebilir ama yorumlanabilirliği azaltabilir. Daha basit modeller açıklaması daha kolaydır ama daha kötü performans gösterebilir. Pareto sınırı, "en iyi ödünleşimleri" içerir ve diğer değişkenler tarafından baskılanan (domine edilen) çözümleri dışlar.
Doğru noktayı seçmek bağlama ve muhakemeye bağlıdır. Her hedefe ağırlıklar atayabilir veya politika kısıtları kullanabilirsiniz.
Beklenen kayıp
Sonuçların belirsiz olduğu durumlarda, optimizasyon beklenen kaybı, tüm olası senaryolar üzerindeki ortalama kaybı en aza indirir. ML'de bu fikir, risk fonksiyonunda karşımıza çıkar.
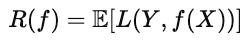
burada L(Y,f(x)) belirli bir tahmin için kayıptır ve beklenti, veri dağılımı üzerinde ortalama alır. Amaç, bu beklenen kaybı en aza indiren f modelini bulmaktır. Bu model, yalnızca bireysel örneklerde değil, ortalamada en iyi performansı gösterir.
Bayes riski
Bayes riski, beklenen kaybın kuramsal alt sınırıdır. Biçimsel olarak aşağıdaki formülle verilir.
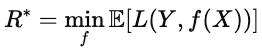
Sezgisel olarak, "mükemmel skor"dur; yani veri dağılımı hakkında mükemmel bilgi altında elde edilebilecek en küçük değerdir. Bir modelin performansı Bayes riskine ne kadar yakınsa, o kadar optimâldir.
Disiplinlerarası Uygulamalar
Maliyet fonksiyonları, veri odaklı kararlar alan her sektörde kullanılır. Rekabet eden hedefleri dengelemeye ve "daha iyi"nin ne anlama geldiğini resmîleştirmeye yardımcı olurlar. Bu fonksiyonlar, rekabet eden hedefleri dengeler ve optimizasyona rehberlik eder. ML modellerini eğitmek için kullanılan aynı mantık, gerçek dünya süreçlerini optimize etmek için kullanılır.
Sektörel uygulamalar ve alan kullanım senaryoları
Örneğin imalatta, maliyet fonksiyonları envanter kaybı gibi kayıpları niceler. Bir envanter maliyet fonksiyonu, fazla stok maliyeti ile stok yetersizliği cezalarını dengeler. Benzer çerçeveler, belirsizlik altında beklenen toplam maliyeti en aza indirmek için üretim çizelgeleme veya enerji kullanımında kullanılır.
Sağlıkta, kestirimci modeller doğruluk ile kaynak tahsisini dengelemek için maliyet fonksiyonlarını kullanır. Örneğin, yeniden yatış riski modeli, klinisyenlerin takip aramaları veya ev ziyaretleriyle müdahale edebilmesi için yüksek riskli hastaları erken belirler. Yüksek riskli bir hastayı kaçırmanın maliyeti, düşük riskli birini işaretlemekten daha yüksektir; bu nedenle fonksiyon bu hataları farklı şekilde cezalandırır.
Finansta da amaç fonksiyonları kullanılır. Örneğin, kredi skorlama modelleri, bir borçlunun belirli bir süre içinde, diyelim on iki ayda, temerrüde düşme olasılığını tahmin eder. Riskli bir borçluyu onaylamak olası finansal kayba yol açarken, güvenli bir borçluyu reddetmek potansiyel geliri kaybettirir. Model beklenen maliyeti en aza indirir.
Tüm bu alanlarda, maliyet fonksiyonları ödünleşimleri, karar vericilerin kullanıp üzerine düşünebileceği ölçülebilir niceliklere dönüştürür.
Sonuç
Maliyet fonksiyonları, kararları değerlendirmek için bir yöntem sunar. Ekonomide, çıktı ile verimlilik arasındaki ödünleşimi modellemek için kullanılır. Makine öğreniminde, tahminlerle gerçeğin farkını ölçerler.
ML'de, maliyet fonksiyonları model tasarımının temelidir. Kayıp fonksiyonlarının seçimi, modelin "başarı" olarak kabul ettiğini belirler. Ortalama kare hata genel doğruluğu, çapraz entropi kalibre edilmiş olasılıkları, hinge kaybı ise güvenli ayrımı ödüllendirir.
Tüm alanlar ve sektörlerde temel mantık aynıdır: bir amaç tanımlayın ve onu optimize edin. Maliyet fonksiyonları, belirsiz hedefleri optimizasyona rehberlik eden somut sayılara çevirir.
Maliyet fonksiyonları; ekonomi, makine öğrenimi, imalat, finans, sağlık ve ödünleşimleri nicelleştirmek isteyen her yerde faydalıdır.
Daha fazla bilgi için şu DataCamp kaynaklarını öneririm.
Maliyet Fonksiyonları SSS
Maliyet fonksiyonu nedir?
Bir maliyet fonksiyonu, bir modelin tahminlerinin verilerle ne kadar uyuştuğunu belirler. Hataları tek bir değerde toplar. Ardından optimizasyon algoritmaları bu değeri en aza indirerek performansı iyileştirir.
Maliyet fonksiyonları regresyon ve sınıflandırma görevlerinde nasıl farklılık gösterir?
Regresyon modelleri sürekli değerler tahmin eder; dolayısıyla kayıpları (ör. MSE, MAE) hedeften sayısal uzaklığı ölçer.
Sınıflandırma modelleri sınıf olasılıklarını tahmin eder; çapraz entropi gibi kayıplar, tahmin edilen olasılık dağılımını gerçek sınıfla karşılaştırır ve kendinden emin hataları güçlü şekilde cezalandırır.
Maliyet fonksiyonlarının iş dünyasındaki gerçek uygulamalarına bazı örnekler nelerdir?
Maliyet fonksiyonları, ödünleşim veya optimizasyon içeren herhangi bir iş sürecinde faydalıdır. Örnekler arasında fiyatlandırma ve gelir optimizasyonu, envanter yönetimi, kredi ve risk modelleme, müşteri elde tutma veya lojistik yer alır.
Huber kayıp fonksiyonu verideki aykırı değerleri nasıl ele alır?
Huber kayıp fonksiyonu, küçük hataları MSE gibi, büyük hataları ise MAE gibi ele alır; bu da onu aykırı değerlere karşı daha az duyarlı kılar.
Marjinal maliyet ile ortalama maliyet arasındaki ilişki nedir?
Marjinal maliyet (MC), bir ek birim üretmenin maliyetini ölçer. Ortalama maliyet (AC), toplam maliyetin birim sayısına bölünmesidir. MC < AC iken, daha fazla üretmek ortalama maliyeti düşürür; MC > AC iken, daha fazla üretmek ortalama maliyeti yükseltir; MC = AC iken, ortalama maliyet minimumdadır.

Mark Pedigo, PhD, sağlık verisi bilimi, programlama ve eğitim alanlarında uzmanlığa sahip seçkin bir veri bilimcisidir. Matematikte doktora, Bilgisayar Biliminde lisans ve Yapay Zekâ alanında Profesyonel Sertifika sahibi olan Mark, teknik bilgisini pratik problem çözme becerileriyle birleştirir. Kariyeri, dolandırıcılık tespiti, bebek ölümü tahmini ve finansal öngörü gibi rollerin yanı sıra NASA’nın maliyet tahmin yazılımına katkıları içerir. Bir eğitimci olarak DataCamp ve St. Louis’teki Washington University’de ders vermiş ve kıdemsiz programcılara mentorluk yapmıştır. Boş zamanlarında Mark, eşi Mandy ve köpeği Harley ile Minnesota’nın doğasında vakit geçirmeyi ve caz piyano çalmayı sever.




Maliyet fonksiyonları, kararların "skorbordu" gibi davranır. Tahminlerin, bir veri kümesindeki gerçek değerlerden ne kadar saptığını ölçer. Makine öğreniminde, hatayı en aza indirmek ve model doğruluğunu artırmak için optimizasyon algoritmalarına yol gösterirler.
Bu yazıda, sezgiyi adım adım inşa ediyoruz. Üretim ve verimlilik arasındaki ödünleşimi tanımlayan maliyet fonksiyonlarının kullanıldığı ekonomik uygulamalarla başlıyoruz. Ardından, model eğitimini yönlendirdikleri makine öğrenimine dönüyoruz. Sonra, ikisi arasındaki köprü olarak optimizasyonu inceliyoruz. Son olarak, gerçek dünya örneklerini keşfediyoruz.
Maliyet Fonksiyonu Nedir?
Maliyet fonksiyonları, optimizasyon ve değerlendirme için temeldir. Maliyet fonksiyonlarını matematiksel olarak tanımlayalım ve temel özelliklerini inceleyelim.
Bir maliyet fonksiyonu ("hata fonksiyonu" olarak da adlandırılır) bir veya daha fazla girdi değişkenini, bir kararın ya da tahminin "maliyetini" temsil eden tek bir sayısal değere eşler. Makine öğreniminde genellikle, veri kümesindeki tüm örnekler boyunca kayıp fonksiyonunun ortalaması olarak tanımlanır.
Maliyet fonksiyonu iki rol oynar: Bir optimizasyon algoritmasının en aza indirdiği bir amaç (objective) olarak hizmet eder ve bir modelin ne kadar iyi performans gösterdiğini ölçmek için bir değerlendirme metriği olarak kullanılır.
Bir amacı olarak maliyet fonksiyonuna bakalım. Her ev için, kayıp fonksiyonu, gerçek satış fiyatı ile tahmin edilen fiyat arasındaki farkı cezalandırır. Maliyet fonksiyonu bu cezaları tüm evler boyunca toplar:
Daha küçük maliyet daha iyi bir genel uyuma, daha büyük maliyet ise daha büyük ortalama hataya işaret eder. En iyileyici (optimizer) bu maliyeti en aza indirmek için parametreleri ayarlar.
Bir değerlendirme metriği olarak maliyet fonksiyonları performansı ölçer. Örneğin, bir sınıflandırıcı doğruluk ya da duyarlılık gibi uygulamaya uygun bir metrikle değerlendirilebilir. Bu şekilde, maliyet fonksiyonları başarıyı yargılamanın bir yolunu sunar.
Maliyet fonksiyonlarının özellikleri
Üç matematiksel özellik özellikle önemlidir.
Birlikte, bu özellikler bir maliyet fonksiyonunun optimizasyon için ne kadar elverişli olduğunu belirler. Bu özelliklerden biri eksik olduğunda, telafi etmek için özel teknikler gerekebilir.
Ekonomi ve İş Dünyasında Maliyet Fonksiyonlarının Uygulamaları
Maliyet fonksiyonları, çıktı miktarı ile ürünlerin toplam maliyeti arasındaki ilişkiyi tanımlar. Firma davranışını, fiyatlandırma stratejilerini ve kâr analizini anlamak için vazgeçilmez bir araçtır.
Ekonomik maliyet türleri
Maliyet eğrileri
Maliyet eğrileri, maliyetlerin üretilen toplam miktarın bir fonksiyonu olarak nasıl değiştiğini gösterir. Sabit maliyetler sabittir, bu nedenle yatay bir çizgi olarak gösterilir; değişken maliyetler ise üretilen birimlerin bir fonksiyonu olarak artar.
Vikipedi: Maliyet Eğrisi
Kısa dönem ve uzun dönem maliyetler
Kısa dönemde, sermaye veya tesis büyüklüğü gibi en az bir girdi sabit tutulur, diğer girdiler değişir. Kısa dönem maliyetleri, bir firmanın mevcut kurulumu ile ne kadar verimli çalıştığını ölçer. Dolayısıyla, verilen bir q miktarı için, kısa dönemde maliyet sabit maliyetler ile miktara bağlı değişken maliyetlerin toplamıdır.
Kısa dönemde, mevcut kapasite içinde optimize edin.
Uzun dönemde tüm girdiler değişkendir. Firma üretim süreçlerini ölçeklendirebilir. Uzun dönem maliyetleri, kapasitenin bizzat değişebildiği durumda verimliliği ölçer ve herhangi bir çıktı düzeyi için elde edilebilecek en düşük maliyeti gösterir
Uzun dönemde, bizzat en uygun kapasiteyi seçerek optimize edin.
Üretim ve kâr analizi
Maliyet fonksiyonları, fiyatlandırma davranışını analiz etmek için kullanılır. Firmalar, üretimi genişletip genişletmemeye karar vermek için maliyet eğrilerini piyasa fiyatlarıyla karşılaştırır. Marjinal maliyet piyasa fiyatının altındaysa, daha fazla üretmek kârı artırır; marjinal maliyet piyasa fiyatından düşükse, daha fazla birim üretmek para kaybettirir.
Maliyet fonksiyonları fiyatlandırma stratejilerinde de kullanılır. Bir firmanın uygulayabileceği asgari uygulanabilir fiyatı belirlerler. Firmalar kârı maksimize etmek için marjinal maliyetin üzerinde fiyatlayabilir ya da yoğun rekabetin olduğu sektörlerde MC'ye daha yakın fiyatlayabilir. Böylece, maliyet analizi başa baş fiyatlama, maliyet artı fiyatlama ve dinamik fiyatlama stratejilerini bilgilendirir.
Başa baş noktası, toplam gelirin toplam maliyete eşit olduğu yerdir.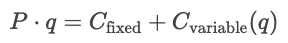
Bu noktada, şirket tüm maliyetlerini karşılar ancak kâr etmez. Daha az üretmek zararla sonuçlanırken, daha fazla üretmek kâr yaratır.
Kâr, toplam gelir ile toplam maliyet arasındaki farktır.
Eğer marjinal gelir marjinal maliyeti aşıyorsa (MR > MC), firma daha fazla kâr elde etmek için çıktıyı artıracaktır. Marjinal gelir marjinal maliyetten düşükse (MR < MC), firma ek kâr elde etmek için çıktıyı azaltacaktır. Firma, MR = MC olduğu miktarda üreterek kârı maksimize eder.
Finans hakkında daha fazla bilgi için şu DataCamp kaynaklarına göz atmanızı öneririm.
Makine Öğreniminde Maliyet Fonksiyonları
ML uygulamalarında, maliyet fonksiyonları artıklar—tahmin edilen değerlerle gerçek değerler arasındaki farklar—ı tüm veri kümesi boyunca niceler. Bu bölüm, başlıca maliyet fonksiyonu ailelerini ve model davranışını nasıl şekillendirdiklerini inceler.
Regresyon kayıpları
Makine öğrenimi bağlamında, regresyonun amacı (mutlaka doğrusal regresyon olmak zorunda değildir) sürekli bir değeri tahmin etmektir. Bir regresyon kayıp fonksiyonu, belirli bir örnek için gerçek ve tahmin edilen değerler arasındaki hatayı niceler; maliyet fonksiyonları kayıp fonksiyonlarını tek bir toplam niceliğe dönüştürür. Optimizasyon süreçleri, toplam hatayı en aza indirmek için maliyet fonksiyonlarını kullanır.
Dört ana maliyet fonksiyonu ailesine odaklanıyoruz: ortalama mutlak hata (MAE), ortalama kare hata (MSE), karekök ortalama kare hata (RMSE) ve Huber kaybı.
Farklı maliyet fonksiyonları hataları farklı şekilde ele alır. Etkide, tahmin edilen ve gerçek değerler arasındaki sapmaların ne kadar şiddetle cezalandırılacağını tanımlarlar. MAE, medyan davranışı ve aykırı değerlere karşı sağlamlığı temsil ederek tekdüze bir ceza uygular. MSE, her artık değeri karesini alır; böylece büyük hatalar baskın hale gelir ve daha ağır cezalandırılır. Huber kaybı bunları harmanlar; küçük hatalar için karesel, büyük hatalar (bir eşik δ sonrasında) için doğrusal bir ceza uygular.