

Mean Absolute Error (MAE)
De mean absolute error wordt gedefinieerd als het gemiddelde van de absolute waarde van de residuen.
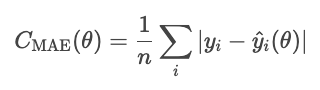
De MAE behandelt alle afwijkingen gelijk, waardoor ze minder beïnvloed wordt door uitschieters dan andere methoden die we zullen zien, zoals de MSE. De absolute fout is echter wiskundig onhandig en maakt gradiënt-gebaseerde optimalisatie lastiger.
Een opmerking over de functieparameter. θ stelt de modelparameters voor. De optimizer stuurt de kosten op basis van deze parameters, niet direct op de voorspelde waarden die eruit voortkomen. Daarom schrijven we de kosten als een functie van θ, niet van Ŷi.
MSE
De mean squared error (MSE) wordt gegeven door de volgende formule.
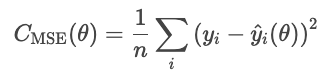
Het kwadrateren van residuen vergroot grote fouten, waardoor MSE gevoelig is voor uitschieters. Deze vorm van fout is echter differentieerbaar en convex, wat haar vriendelijk maakt voor optimalisatie.
RMSE
Een nadeel van de MSE is dat de eenheden gekwadrateerd zijn. In een regressiemodel voor huizenprijzen is het verlies bijvoorbeeld in dollar kwadraat, wat weinig intuïtieve betekenis heeft. De RMSE verhelpt dit door de vierkantswortel van de MSE te nemen.
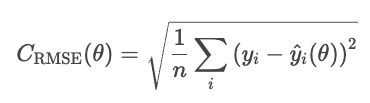
RMSE gedraagt zich vergelijkbaar met MSE maar de eenheden zijn dezelfde als die van het probleem (dollars, niet dollars in het kwadraat).
Huber
Het Huber-verlies is minder gevoelig voor uitschieters in de data dan de MSE (of RMSE). Het combineert MAE en MSE, en stuurt de overgang met een parameter δ.
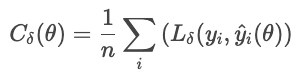
waar
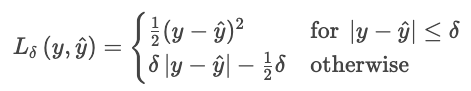
Deze formule voorkomt dat een paar grote residuen het verlies domineren. Het Huber-verlies is een goede keuze voor rumoerige, realistische data waar je af en toe extreme observaties verwacht.
Classificatieverliezen
Classificatie voorspelt discrete categorieën. Deze kostenfuncties vergelijken kansverdelingen met echte labels, en bestraffen onjuiste of overzekere voorspellingen.
Cross-entropy loss
Cross-entropy-verlies (log loss) beloont een model als het met vertrouwen correct is, en bestraft het als het met vertrouwen fout zit.
Voor een classifier die zuivere waarschijnlijkheden Ŷ uitstoot, is de waarschijnlijkheid van het geobserveerde label Y
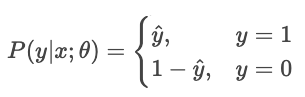
Maximum-likelihoodschatting (MLE) maximaliseert deze waarschijnlijkheid over alle samples.
Laten we dit idee omzetten naar het minimaliseren van kosten. Minimaliseren is hetzelfde als het maximaliseren van het negatieve, dus laten we het teken omdraaien. Laten we ook logaritmes nemen.
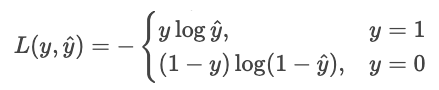
We kunnen dit beknopter schrijven als één som.
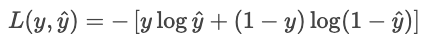
Waarom de log? De log heeft verschillende voordelen
- Het maakt van het product een som. In plaats van kleine getallen te vermenigvuldigen en onderloop te riskeren, tellen we waarschijnlijkheden op,
- Het maakt de functie concave. De log transformeert de likelihood in een concave functie met één globaal maximum.
- Het geeft een betekenisvolle strafcurve.
- p = 1,0 resulteert in een verlies van 0,
- p = 0,9 resulteert in een verlies van 0,1 (klein)
- p = 0,2 resulteert in een verlies van 2,3 (groot)
- p = 0,01 resulteert in een verlies van 4,6 (enorm)
- Het voorkomt geneste exponenten. In logistische regressie en neurale netten "wikkelt" de log geneste exponenten af, waardoor afgeleiden eenvoudig en stabiel worden.
Stel dat een model waarschijnlijkheden voorspelt voor twee keuzes: "hond" (keuze 0) of "kat" (keuze 1). Als het echte antwoord 1 ("kat") is en het model is voor 90% zeker dat het een kat is, dan is het verlies klein omdat het model zelfverzekerd en correct was. Als het model zegt dat het voor 10% zeker is dat het een kat is, dan is het verlies groot, omdat het model zelfverzekerd maar fout was.
Cross-entropy voor multi-class classificatie
Wanneer er meer dan twee klassen zijn ("kat", "hond", "vogel"), produceert het model een ruwe score ("logit") voor elke klasse, genoteerd als Zi. Logits kunnen elk reëel getal zijn, dus ze worden omgezet in waarschijnlijkheden die optellen tot één via de softmax-functie.
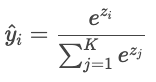
De voorspellingen van het model worden vervolgens vergeleken met de werkelijke labels met behulp van de cross-entropy.
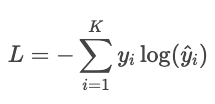
Voorbeeld
Stel dat het ware label "kat" is en het model de volgende waarschijnlijkheden voorspelt: kat: 80%, hond: 15%, vogel: 5%. Het verlies is
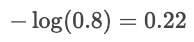
Als de voorspelde waarschijnlijkheid voor "kat" slechts 30% was, dan zou het verlies veel hoger zijn:
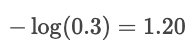
De log bestraft zelfverzekerde fouten en beloont voorspellingen met hoge zekerheid.
Hinge loss
De hinge loss wordt vooral gebruikt voor max-margin classificatie, zoals bij support vector machines (SVM's). Het doel is om met vertrouwen te classificeren door voorspellingen ver van de beslissingsgrens te houden.
Voor binaire classificatie wordt de hinge loss gegeven door de volgende formule.
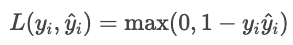
waar
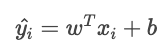
De totale kostenfunctie is
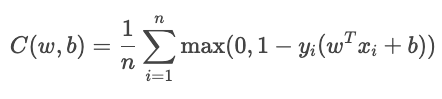
De term YiŶi meet hoe goed de sample is geclassificeerd.
- Als deze groter is dan 1, ligt de sample aan de juiste kant van de grens zonder verlies.
- Ligt deze tussen 0 en 1, dan bevindt het punt zich binnen de marge en wordt een kleine straf toegepast.
- Is deze kleiner dan 0, dan heeft het model verkeerd geclassificeerd. Het verlies groeit lineair met de afstand tot de grens.
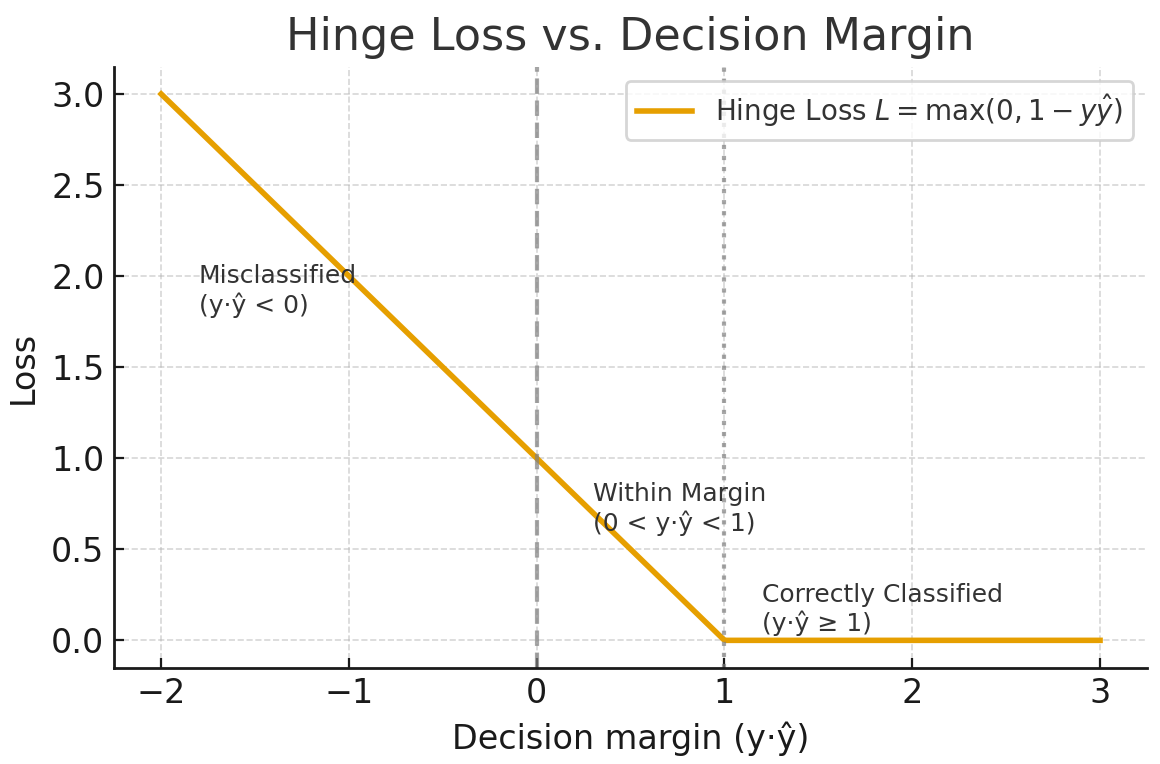
Gegenereerd door ChatGPT 5
Kullback-Leibler (KL)
De Kullback-Leibler (KL) divergentie is een maat voor hoeveel een benaderende kansverdeling Q afwijkt van een gegeven kansverdeling P. Deze is gedefinieerd als
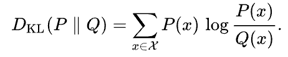
Wikipedia
De KL-divergentie kan worden geïnterpreteerd als het gemiddelde verschil in het aantal bits voor het coderen van samples van P met een code die geoptimaliseerd is voor Q.
Regularisatie
Regularisatietechnieken voorkomen dat modellen ruis in de trainingsdata fitten door een term aan de kostenfunctie toe te voegen die te complexe oplossingen bestraft.
Zonder regularisatie minimaliseert het model het verlies:
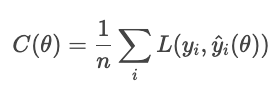
Met regularisatie voegt het model een strafterm toe
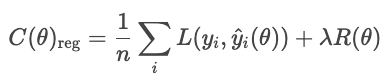
waar
- L het gebruikelijke verlies is (bijv. RMSE, cross-entropy)
- R(θ) de modelcomplexiteit meet
- λ de afweging tussen fit en eenvoud bepaalt
Veelvoorkomende vormen van regularisatie zijn L1, L2 en elastic net.
L1-regularisatie (ook wel lasso) voegt de absolute waarde van elk modelgewicht toe aan de kostenfunctie.
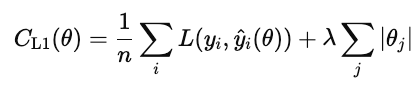
Wanneer deze kosten worden geminimaliseerd, worden veel gewichten naar nul geduwd. Dit maakt L1 een vorm van automatische featureselectie. Features die niet bijdragen, worden naar nul gedrukt.
L2-regularisatie (ook wel ridge-regressie) bestraft het kwadraat van elk modelgewicht.
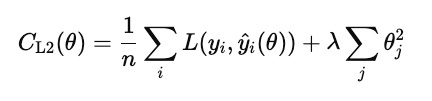
In tegenstelling tot L1 zet het gewichten niet exact op nul, maar krimpt het deze geleidelijk. Dit houdt alle features in het model maar vermindert hun invloed om voorspellingen te stabiliseren.
Elastic net voegt zowel L1 als L2 toe.
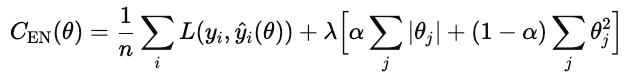
λ bepaalt hoe sterk de totale regularisatie is. α is een getal tussen 0 en 1 dat het aandeel L1 versus L2 bepaalt, waarbij 1 puur L1 is en 0 puur ridge.
Trade-offs
De verschillende strategieën voor classificatieverlies hebben trade-offs.
Cross-entropy maximaliseert de juiste waarschijnlijkheid door zelfverzekerde foute antwoorden te bestraffen. Trade-offs zijn dat het gevoelig is voor uitschieters en verkeerd gelabelde data. Het werkt het best wanneer je geeft om de kwaliteit van zekerheid (bijv. risicomodellen).
Hinge loss handhaaft een marge zodat correcte classificaties niet alleen correct zijn, maar ook met vertrouwen correct. Het negeert samples die veilig buiten de marge liggen en geeft een lineaire straf voor overtredingen. Het is minder gevoelig voor uitschieters dan cross-entropy, maar lastiger om soepel te optimaliseren, omdat het niet differentieerbaar is bij de scharnierpunt.
Kullback-Leibler(KL) divergentie matcht de ene kansverdeling met een andere. Het is gelijk aan cross-entropy minus de entropie van de ware verdeling.
Voor meer informatie, bekijk deze links.
- Cross-Entropy Loss Function in Machine Learning: Enhancing Model Accuracy
- From Data to Dollars - Predicting Insurance Charges
- Optimize Pricing Predictions with Feature Engineering
- Data Quality Dimensions Cheat Sheet
- R Correlation Tutorial
Implementatie van kostenfuncties en praktijk in machine learning
Tot nu toe hebben we kostenfuncties in theorie besproken. In de praktijk hangt het succes van een ML-model af van hoe efficiënt het die functies minimaliseert. In deze sectie introduceren we praktische details van kernoptimalisatie-algoritmen en tuningstrategieën.
Optimalisatie-algoritmen en parameterafstemming
Optimalisatie is het proces van het vinden van de optimale waarden van modelparameters die een kostenfunctie minimaliseren. In ML betekent dit het ontdekken van de parameters die voorspellingen zo dicht mogelijk bij de werkelijkheid brengen.
Gradient descent
Gradient descent is het standaardalgoritme voor het optimaliseren van kostenfuncties. Het werkt iteratief de modelparameters bij in de richting die de kosten het meest reduceert, de negatieve gradiënt. Conceptueel meet het de multivariabele helling van de kostenfunctie en stapt het bergafwaarts.
De update-regel is
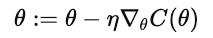
waar θ de modelparameters zijn, n de leersnelheid is, en  de gradiënt is van de kostenfunctie ten opzichte van de parameters.
De keuze van de leersnelheid is cruciaal. Als die te groot is, schieten updates over het minimum heen en gaan ze oscilleren of divergeren. Is die te klein, dan wordt de convergentie traag en kan deze vastlopen in lokale minima.
De belangrijkste varianten zijn batch, stochastisch en mini-batch.
- Batch gradient descent. Berekent de gradiënt met de volledige trainingsset. Het is stabiel maar traag en geheugenintensief voor grote datasets of online leren.
- Stochastic gradient descent (SGD). Werkt parameters bij na elk trainingsvoorbeeld. Het is snel en geheugenefficiënt, maar "ruisachtig" in de zin dat elke stap iets kan afwijken van het optimale pad. De willekeur kan echter helpen om aan lokale minima te ontsnappen.
- Mini-batch gradient descent. Een praktische middenweg. Het berekent gradiënten op kleine batches om snelheid en stabiliteit in balans te houden. Het maakt ook GPU-parallelisme mogelijk.
Adaptieve optimizers
Standaard gradient descent past een vaste leersnelheid toe op alle parameters. In complexe modellen hebben verschillende parameters mogelijk verschillende stapgroottes nodig. Adaptieve optimizers passen leersnelheden aan op basis van de geschiedenis van gradiëntgroottes.
- RMSProp gebruikt een exponentieel afnemend gemiddelde van recente gekwadrateerde gradiënten.
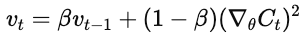
Het leren van elke parameter wordt omgekeerd evenredig met dit gemiddelde geschaald. Dit voorkomt oscillatie en maakt stabiele vooruitgang mogelijk, zelfs wanneer sommige parameters steile gradiënten hebben. RMSProp wordt veel gebruikt voor recurrente netwerken en rumoerige data.
- Adaptive Moment Estimation (Adam) volgt zowel het gemiddelde als de variantie van eerdere gradiënten en past stapgroottes dynamisch aan.
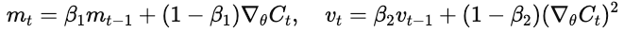
Het convergeert snel, is robuust tegen rumoerige data en is de standaardoptimizer voor deep learning-frameworks.
Feature scaling en initialisatie
Voordat je met gradient descent optimaliseert, schaal je features zodat ze vergelijkbare bereiken hebben. Juiste schaling verbetert de stabiliteit en efficiëntie van de optimalisatie.
Zonder schaling domineren features met grote numerieke bereiken de gradiënt. Gradient descent gaat dan zigzaggen in plaats van directe stappen naar het minimum te zetten.
Er zijn twee gangbare benaderingen.
- Standaardisatie. Centreert elke feature op nul en schaalt naar eenheidsvariantie.
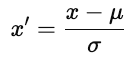
waar u het gemiddelde is en ơ de standaardafwijking is. Standaardisatie behoudt de structuur van de data.
- Normalisatie. Herschaal elke feature naar een vast bereik, meestal [0, 1].
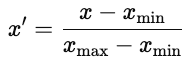
Normalisatie is gebruikelijk in neurale netwerken, waar activatiefuncties het best presteren met begrensde input.
Strategieën voor parameter-initialisatie
Parameter-initialisatie beïnvloedt de modeltraining sterk. Slechte initialisatie kan leiden tot trage convergentie, exploderende of verdwijnende gradiënten, of modellen die niet leren. Goede initialisatie plaatst parameters in een gebied van het kostoppervlak waar gradiënten stabiel zijn.
- Willekeurige initialisatie. Wijs kleine willekeurige waarden toe, meestal getrokken uit een uniforme of normale verdeling. Willekeur breekt symmetrie zodat parameters verschillende features leren. Als de variantie echter te hoog of te laag is, kunnen gradiënten exploderen of verdwijnen.
- Xavier (Glorot) initialisatie. Ontworpen voor niet-lineaire activatiefuncties zoals tanh of sigmoid, schaalt Xavier de variantie van de gewichten op basis van het aantal in- en uitgaande verbindingen.
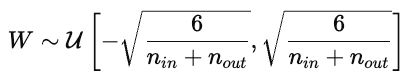
Dit houdt activaties en gradiënten ruwweg constant over lagen heen.
- He-initialisatie. Past de variantie aan voor ReLU-activaties, die negatieve waarden op nul zetten. De gewichten worden getrokken uit een normale verdeling met een gespecificeerde variantie:
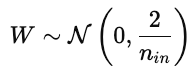
Dit voorkomt dat gradiënten te snel verdwijnen tijdens backpropagatie.
Monitoring, diagnostiek en visualisatie
Een trainingsverlies-curve toont de fout van het model op de trainingsdataset in de tijd. Het laat zien hoe goed het model zijn parameters bijwerkt om de fout te minimaliseren. Een gestaag dalende curve geeft aan dat het model patronen uit de data leert.
De validatieverlies-curve toont het vermogen van het model om te generaliseren naar onzichtbare data, zoals een hold-out- of validatieset. Het geeft het vermogen aan van het model om te voorspellen op eerder onzichtbare data.
Idealiter dalen beide curves aan het begin en vlakken vervolgens af. Dit toont aan dat het model zowel effectief leert als effectief generaliseert.
Overfitting treedt op wanneer het model ruis leert alsof het signaal is, en slecht generaliseert. Dit verschijnt in een grafiek met trainings- en validatiecurves wanneer het trainingsverlies daalt maar het validatieverlies stijgt. Oplossingen zijn onder meer het gebruiken van een grotere dataset, of regularisatie toepassen in het model.
Underfitting treedt op wanneer het model de onderliggende patronen in de data niet vastlegt. Zowel trainings- als validatiecurves blijven hoog. In dit geval probeer je meer data, een complexer model, of verlaag je de regularisatie.
Convergentie is het punt waarop de curve afvlakt en verder trainen weinig verbetering oplevert. Dit is het zoete punt tussen overfitting en underfitting.
Optimalisatie van kostenfuncties en besluitvormingstheorie
We hebben gezien hoe economie en machine learning vertrouwen op optimalisatie om besluitvorming en training te sturen. Beide vakgebieden proberen de beste beslissingen te nemen op basis van een metriek van kosten of verlies. Laten we algemener ingaan op optimalisatietheorie.
Objectiefuncties
Een objectiefunctie is een wiskundige functie die definieert wat we willen minimaliseren of maximaliseren. In de gevallen die we tot nu toe hebben gezien, hebben we kosten of fouten geminimaliseerd. Voor econ bekeken we kostencurves, en bij ML keken we naar regressieverliezen (MAE, RMSE, Huber) en classificatieverliezen (cross-entropy, hinge loss, KL-verlies). Dit zijn beide voorbeelden van het optimaliseren van een objectiefunctie.
Multi-objectieve optimalisatie
Vaak willen we meerdere, vaak conflicterende, doelen optimaliseren. Een bedrijf wil bijvoorbeeld de winst maximaliseren en tegelijkertijd het risico minimaliseren. Een data scientist wil mogelijk de modelnauwkeurigheid verbeteren zonder interpretatie of eerlijkheid op te offeren. Zulke concurrerende doelen definiëren een multi-objectief optimalisatieprobleem waarin het verbeteren van het ene doel een ander kan verslechteren.
Paretofront
Een oplossing is Pareto-optimaal als geen enkel doel verbeterd kan worden zonder ten minste één ander doel slechter te maken. De set van Pareto-optimale oplossingen vormt het Paretofront, een curve die bestaat uit de best haalbare afwegingen. Elk punt op deze curve vertegenwoordigt een andere balans van prioriteiten.
Het verhogen van de complexiteit van een model kan bijvoorbeeld de nauwkeurigheid verbeteren maar de interpreteerbaarheid verminderen. Eenvoudigere modellen zijn gemakkelijker uit te leggen maar presteren mogelijk slechter. Het Paretofront bevat de "beste afwegingen" en sluit oplossingen uit die gedomineerd worden door andere variabelen.
De juiste keuze hangt af van context en oordeel. Je kunt gewichten toekennen aan elk doel of beleidsbeperkingen gebruiken.
Verwacht verlies
Wanneer uitkomsten onzeker zijn, minimaliseert optimalisatie het verwachte verlies, het gemiddelde verlies over alle mogelijke scenario's. In ML verschijnt dit idee in de risicofunctie.
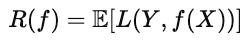
waar L(Y,f(x)) het verlies is voor een gegeven voorspelling, en de verwachting het gemiddelde neemt over de dataverdeling. Het doel is het model f te vinden dat dit verwachte verlies minimaliseert. Dit model presteert gemiddeld het best, niet alleen op individuele samples.
Bayes-risico
Het Bayes-risico is de theoretische ondergrens van het verwachte verlies. Formeel wordt het gegeven door de volgende formule.
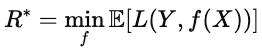
Intuïtief is het de "perfecte score", d.w.z. de kleinst haalbare waarde onder perfecte informatie over de dataverdeling. Hoe dichter de prestatie van een model bij het Bayes-risico ligt, hoe optimaler het is.
Toepassingen over disciplines heen
Kostenfuncties worden gebruikt in elke sector die datagedreven beslissingen neemt. Ze helpen concurrerende doelstellingen in balans te brengen en te formaliseren wat "beter" betekent. Deze functies balanceren concurrerende doelstellingen en sturen optimalisatie. Dezelfde logica die wordt gebruikt om ML-modellen te trainen, wordt gebruikt om processen in de echte wereld te optimaliseren.
Industrie-toepassingen en domeincases
In de maakindustrie kwantificeren kostenfuncties bijvoorbeeld verliezen, zoals voorraadverlies. Een voorraadkostenfunctie balanceert de kosten van overtollige voorraad tegen straffen voor tekorten. Vergelijkbare raamwerken worden gebruikt voor productieplanning of energieverbruik om de verwachte totale kosten onder onzekerheid te minimaliseren.
In de gezondheidszorg gebruiken voorspellende modellen kostenfuncties om nauwkeurigheid en resourceallocatie in balans te brengen. Een heropname-risicomodel identificeert bijvoorbeeld hoogrisicopatiënten vroeg, zodat clinici kunnen ingrijpen met follow-upgesprekken of huisbezoeken. Het missen van een hoogrisicopatiënt is kostbaarder dan het markeren van een laagrisicopatiënt, dus de functie bestraft die fouten verschillend.
Ook in de financiële sector worden objectiefuncties gebruikt. Kredietscoremodellen voorspellen bijvoorbeeld de kans dat een lener binnen een bepaalde periode, bijvoorbeeld twaalf maanden, een lening niet terugbetaalt. Een risicovolle lener goedkeuren leidt tot mogelijk financieel verlies, terwijl een veilige lener afwijzen mogelijk inkomsten kost. Het model minimaliseert de verwachte kosten.
In al deze domeinen vertalen kostenfuncties afwegingen naar meetbare grootheden waar besluitvormers mee uit de voeten kunnen.
Conclusie
Kostenfuncties bieden een methode om beslissingen te evalueren. In de economie modelleren ze de afweging tussen output en efficiëntie. In machine learning meten ze de kloof tussen voorspellingen en waarheid.
In ML zijn kostenfuncties de basis van modelontwerp. De keuze van verliesfuncties bepaalt wat het model als "succes" beschouwt. Mean squared error beloont algehele nauwkeurigheid, cross-entropy beloont gekalibreerde waarschijnlijkheden en hinge loss beloont zelfverzekerde scheiding.
In alle domeinen en sectoren werkt de onderliggende logica hetzelfde: definieer een objectief en optimaliseer het. Kostenfuncties vertalen vage doelen naar concrete getallen die optimalisatie sturen.
Kostenfuncties zijn nuttig in economie, machine learning, maakindustrie, financiën, gezondheidszorg en overal waar je afwegingen wilt kwantificeren.
Voor meer informatie raad ik deze DataCamp-bronnen aan.
Kostenfuncties: veelgestelde vragen
Wat is een kostenfunctie?
Een kostenfunctie bepaalt hoe goed de voorspellingen van een model overeenkomen met de data. Het aggregeert de fout tot één waarde. Optimalisatie-algoritmen minimaliseren vervolgens deze waarde om de prestaties te verbeteren.
Hoe verschillen kostenfuncties tussen regressie- en classificatietaken?
Regressiemodellen voorspellen continue waarden, dus hun verlies (bijv. MSE, MAE) meet de numerieke afstand tot het doel.
Classificatiemodellen voorspellen klassewaarschijnlijkheden; verliezen zoals cross-entropy vergelijken de voorspelde kansverdeling met de ware klasse en bestraffen zelfverzekerde fouten sterk.
Wat zijn enkele praktijktoepassingen van kostenfuncties in het bedrijfsleven?
Kostenfuncties zijn nuttig in elk bedrijfsproces dat afwegingen of optimalisatie omvat. Voorbeelden zijn prijs- en opbrengstoptimalisatie, voorraadbeheer, krediet- en risicomodellering, klantretentie of logistiek.
Hoe gaat de Huber-verliesfunctie om met uitschieters in data?
De Huber-verliesfunctie behandelt kleine fouten zoals MSE en grote fouten zoals MAE, waardoor ze minder gevoelig is voor uitschieters.
Wat is de relatie tussen marginale kosten en gemiddelde kosten?
Marginale kosten (MC) meten de kosten van het produceren van één extra eenheid. Gemiddelde kosten (AC) zijn de totale kosten gedeeld door het aantal eenheden. Wanneer MC < AC, verlaagt meer produceren de gemiddelde kosten; wanneer MC > AC, verhoogt meer produceren de gemiddelde kosten; en wanneer MC = AC, zijn de gemiddelde kosten minimaal.

Mark Pedigo, PhD, is een vooraanstaande data scientist met expertise in data science voor de gezondheidszorg, programmeren en onderwijs. Met een PhD in Wiskunde, een B.S. in Computer Science en een Professional Certificate in AI combineert Mark technische kennis met praktische probleemoplossing. In zijn loopbaan werkte hij onder meer aan fraudedetectie, het voorspellen van kindersterfte en financiële forecasting, en leverde hij bijdragen aan NASA’s software voor kostenraming. Als docent gaf hij les bij DataCamp en Washington University in St. Louis en begeleidde hij junior programmeurs. In zijn vrije tijd geniet Mark samen met zijn vrouw Mandy en hond Harley van de buitenlucht in Minnesota en speelt hij jazzpiano.


Kostenfuncties fungeren als de "scorekeeper" van beslissingen. Ze meten hoe ver voorspellingen afwijken van de werkelijke waarden van een dataset ten opzichte van voorspelde waarden. In machine learning sturen ze optimalisatie-algoritmen aan om fouten te minimaliseren en de modelnauwkeurigheid te verbeteren.
In dit artikel bouwen we stap voor stap intuïtie op. We beginnen met economische toepassingen, waar kostenfuncties de afweging tussen productie en efficiëntie beschrijven. Daarna gaan we naar machine learning, waar ze de modeltraining aansturen. Vervolgens bekijken we optimalisatie als de brug tussen beide. Tot slot verkennen we praktijkvoorbeelden.
Wat is een kostenfunctie?
Kostenfuncties zijn fundamenteel voor optimalisatie en evaluatie. Laten we kostenfuncties wiskundig definiëren en hun belangrijkste eigenschappen bekijken.
Een kostenfunctie (ook wel een "foutfunctie") zet één of meer invoervariabelen om in één numerieke waarde die de "kosten" van een beslissing of voorspelling weergeeft. In machine learning wordt deze meestal gedefinieerd als het gemiddelde van de verliesfunctie over alle samples in de dataset.
De kostenfunctie speelt twee rollen: ze dient als objectief dat een optimalisatie-algoritme minimaliseert, en als evaluatiemetriek om te meten hoe goed een model presteert.
Laten we naar een kostenfunctie als objectief kijken. Voor elk huis straft de verliesfunctie het verschil tussen de werkelijke verkoopprijs en de voorspelde prijs. De kostenfunctie aggregeert deze straffen over alle huizen:
Een lagere kost duidt op een betere algehele fit, terwijl een hogere kost wijst op een grotere gemiddelde fout. De optimizer past de parameters aan om deze kost te minimaliseren.
Als evaluatiemetriek meten kostenfuncties prestaties. Zo kan een classifier worden geëvalueerd met accuracy, of recall, of welke metriek passend is voor de toepassing. Op deze manier bieden kostenfuncties een manier om succes te beoordelen.
Eigenschappen van kostenfuncties
Drie wiskundige eigenschappen zijn vooral relevant.
Samen bepalen deze eigenschappen hoe hanteerbaar een kostenfunctie is voor optimalisatie. Als één van deze eigenschappen ontbreekt, kunnen speciale technieken nodig zijn om dat te compenseren.
Economische en zakelijke toepassingen van kostenfuncties
Kostenfuncties beschrijven de relatie tussen de hoeveelheid output en de totale kosten van producten. Ze zijn een essentieel hulpmiddel om het gedrag van bedrijven, prijsstrategieën en winstanalyse te begrijpen.
Typen economische kosten
Kostencurves
Kostencurves laten zien hoe kosten variëren als functie van de totale geproduceerde hoeveelheid. Vaste kosten zijn constant en worden dus weergegeven als een horizontale lijn, terwijl variabele kosten stijgen als functie van het aantal geproduceerde eenheden.
Wikipedia: Cost Curve
Korte versus lange termijn kosten
Op de korte termijn wordt ten minste één input, zoals kapitaal of fabriekgrootte, constant gehouden en variëren andere inputs. Kortetermijnkosten meten hoe efficiënt een bedrijf opereert met zijn huidige opzet. Voor een gegeven hoeveelheid q is de kost op korte termijn dus de som van de vaste kosten en de op hoeveelheid afhankelijke variabele kosten.
Op de korte termijn optimaliseer je binnen de huidige capaciteit.
Op de lange termijn zijn alle inputs variabel. Het bedrijf kan zijn productieprocessen opschalen. Langetermijnkosten meten efficiëntie wanneer de capaciteit zelf kan veranderen, en tonen de minimaal haalbare kosten voor elk outputniveau
Op de lange termijn optimaliseer je door de optimale capaciteit zelf te kiezen.
Productie- en winstanalyse
Kostenfuncties worden gebruikt om prijszettingsgedrag te analyseren. Bedrijven vergelijken kostencurves met marktprijzen om te beslissen of ze de productie moeten uitbreiden of inkrimpen. Als de marginale kost onder de marktprijs ligt, verhoogt meer produceren de winst; als de marginale kost lager is dan de marktprijs, kost meer produceren juist geld.
Kostenfuncties worden ook gebruikt in prijsstrategieën. Ze bepalen de minimaal haalbare prijs die een bedrijf kan vragen. Bedrijven kunnen boven de marginale kost rekenen om de winst te maximaliseren, of dichter bij de MC in sterk concurrerende sectoren. Zo informeert kostenanalyse break-even-prijzen, cost-plus pricing en dynamische prijsstrategieën.
Het break-evenpunt vindt plaats waar de totale opbrengst gelijk is aan de totale kost.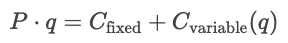
Op dit punt dekt het bedrijf alle kosten maar maakt geen winst. Minder produceren leidt tot verlies, terwijl meer produceren winst oplevert.
Winst is het verschil tussen totale opbrengst en totale kost.
Als de marginale opbrengst groter is dan de marginale kost (MR > MC), zal het bedrijf de output verhogen om meer winst te genereren. Als de marginale opbrengst kleiner is dan de marginale kost (MR < MC), zal het bedrijf de output verlagen om extra winst te behalen. Het bedrijf maximaliseert de winst door de hoeveelheid te produceren waarbij MR = MC.
Voor meer informatie over financiën raad ik deze DataCamp-bronnen aan.
Kostenfuncties in machine learning
In ML-toepassingen kwantificeren kostenfuncties de residuen (het verschil tussen voorspelde en werkelijke waarden) over de gehele dataset. In deze sectie verkennen we de belangrijkste families van kostenfuncties en hoe ze het modelgedrag sturen.
Regressieverliezen
In een machine learning-context is het doel van regressie (niet per se lineaire regressie) het voorspellen van een continue waarde. Een regressieverliesfunctie kwantificeert de fout tussen werkelijke en voorspelde waarden voor een specifieke sample; kostenfuncties aggregeren verliesfuncties tot een totale grootheid. Optimalisatieprocessen gebruiken kostenfuncties om de totale fout te minimaliseren.
We focussen op de vier belangrijkste families van kostenfuncties: mean absolute error (MAE), mean squared error (MSE), root mean square error (RMSE) en Huber-verlies.
Verschillende kostenfuncties gaan verschillend met fouten om. Feitelijk bepalen ze hoe zwaar afwijkingen tussen voorspelde en werkelijke waarden bestraft worden. De MAE past een uniforme straf toe, die mediaangedrag en robuustheid tegen uitschieters vertegenwoordigt. De MSE kwadreert elk residu, waardoor grote fouten domineren en zwaarder bestraft worden. Het Huber-verlies mengt deze twee: een kwadratische straf voor kleine fouten en een lineaire voor grote (boven een drempel δ).