

मीन एब्सलूट एरर (MAE)
मीन एब्सलूट एरर को अवशेषों के परिमाण (absolute value) के औसत के रूप में परिभाषित किया जाता है।
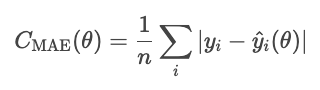
MAE सभी विचलनों को बराबर मानता है, इसलिए यह MSE जैसी अन्य विधियों की तुलना में बाहरी मानों से कम प्रभावित होता है। हालाँकि, एब्सलूट एरर गणितीय रूप से असुविधाजनक है और ग्रेडिएंट-आधारित ऑप्टिमाइज़ेशन को अधिक कठिन बना देता है।
फ़ंक्शन पैरामीटर पर एक टिप्पणी। θ मॉडल के पैरामीटर्स को दर्शाता है। ऑप्टिमाइज़र लागत को इन पैरामीटर्स के आधार पर नियंत्रित करता है, न कि सीधे उनसे उत्पन्न अनुमानित मानों पर। इसलिए, हम लागत को θ का फ़ंक्शन लिखते हैं, न कि Ŷi का।
MSE
मीन स्क्वेयर्ड एरर (MSE) निम्नलिखित सूत्र से दिया जाता है।
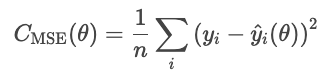
अवशेषों का वर्ग करना बड़ी त्रुटियों को बढ़ा-चढ़ाकर दिखाता है, जिससे MSE बाहरी मानों के प्रति संवेदनशील हो जाता है। हालाँकि, यह त्रुटि रूप अवकलनीय और उत्तल है, जो इसे ऑप्टिमाइज़ेशन के लिए अनुकूल बनाता है।
RMSE
MSE की एक कमी यह है कि इसकी इकाइयाँ वर्ग में होती हैं। उदाहरण के लिए, हाउसिंग प्राइस रिग्रेशन मॉडल में, लॉस डॉलर वर्ग में होता है, जिसका सहज अर्थ नहीं होता। RMSE इस समस्या को MSE का वर्गमूल लेकर ठीक करता है।
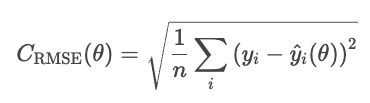
RMSE का व्यवहार MSE जैसा ही होता है, परन्तु इकाइयाँ समस्या की ही इकाइयों में होती हैं (डॉलर, न कि डॉलर वर्ग)।
Huber
Huber लॉस, MSE (या RMSE) की तुलना में, डेटा में बाहरी मानों के प्रति कम संवेदनशील है। यह MAE और MSE का संयोजन करता है, और संक्रमण को एक पैरामीटर δ के साथ नियंत्रित करता है।
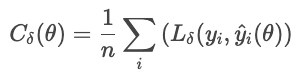
जहाँ
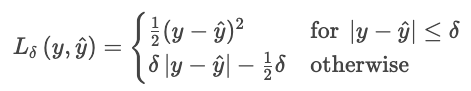
यह सूत्र कुछ बड़े अवशेषों को लॉस पर हावी होने से रोकता है। Huber लॉस शोरयुक्त वास्तविक दुनिया के डेटा के लिए अच्छा विकल्प है, जहाँ कभी-कभार अतिवादी मान आने की उम्मीद हो।
क्लासिफ़िकेशन लॉसेज़
क्लासिफ़िकेशन में विविक्त श्रेणियों की भविष्यवाणी की जाती है। ये कॉस्ट फ़ंक्शंस भविष्यवाणी की गई प्रायिकता वितरणों की तुलना सही लेबल से करते हैं और गलत या अतिआत्मविश्वासी भविष्यवाणियों को दंडित करते हैं।
क्रॉस-एंट्रॉपी लॉस
क्रॉस-एंट्रॉपी लॉस (लॉग लॉस) तब इनाम देता है जब मॉडल आत्मविश्वास के साथ सही हो, और तब दंडित करता है जब आत्मविश्वास के साथ गलत हो।
ऐसे क्लासिफ़ायर के लिए जो शुद्ध प्रायिकताएँ Ŷ आउटपुट करता है, प्रेक्षित लेबल Y की लाइकलीहुड यह है
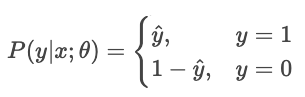
मैक्सिमम-लाइकलीहुड एस्टीमेशन (MLE) इस लाइकलीहुड को सभी सैम्पल्स पर अधिकतम करता है।
आइए इस विचार को लागत को न्यूनतम करने में बदलें। न्यूनतम करना नकारात्मक को अधिकतम करने के बराबर है, तो संकेत पलट दें। साथ ही, लॉग ले लें।
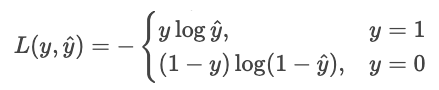
हम इसे एक ही जोड़ (sum) के रूप में और संक्षेप में लिख सकते हैं।
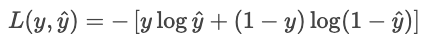
लॉग क्यों? लॉग के कई फायदे हैं
- यह गुणन को जोड़ में बदल देता है। छोटे अंकों का गुणन कर अंडरफ़्लो का जोखिम लेने के बजाय, हम प्रायिकताओं को जोड़ते हैं,
- यह फ़ंक्शन को अवतल (concave) बना देता है। लॉग लाइकलीहुड को एकल वैश्विक अधिकतम वाले अवतल फ़ंक्शन में बदल देता है।
- यह सार्थक दंड वक्र देता है।
- p = 1.0 पर लॉस 0 होता है,
- p = 0.9 पर लॉस 0.1 (छोटा)
- p = 0.2 पर लॉस 2.3 (बड़ा)
- p = 0.01 पर लॉस 4.6 (बहुत बड़ा)
- यह घुसे हुए घातांकों से बचाता है। लॉजिस्टिक रिग्रेशन और न्यूरल नेट्स में, लॉग घुसे हुए एक्सपोनेंशियल्स को "अनरैप" कर देता है, जिससे अवकलज सरल और स्थिर हो जाते हैं।
मान लीजिए कोई मॉडल दो विकल्पों के लिए प्रायिकताएँ भविष्यवाणी करता है: "dog" (विकल्प 0) या "cat" (विकल्प 1)। यदि वास्तविक उत्तर 1 ("cat") है और मॉडल 90% निश्चित है कि यह बिल्ली है, तो लॉस छोटा होगा क्योंकि मॉडल आत्मविश्वास से सही था। यदि मॉडल कहता है कि वह 10% निश्चित है कि यह बिल्ली है, तो लॉस बड़ा होगा, क्योंकि मॉडल आत्मविश्वास से गलत था।
मल्टी-क्लास क्लासिफ़िकेशन के लिए क्रॉस-एंट्रॉपी
जब दो से अधिक क्लास ("cat", "dog", "bird") हों, तो मॉडल प्रत्येक क्लास के लिए एक रॉ स्कोर ("logit") देता है, जिसे Zi द्वारा निरूपित किया जाता है। लॉजिट किसी भी वास्तविक संख्या हो सकते हैं, इसलिए उन्हें सॉफ़्टमैक्स फ़ंक्शन के माध्यम से ऐसी प्रायिकताओं में बदला जाता है जिनका योग एक हो।
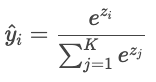
इसके बाद मॉडल की भविष्यवाणियों की तुलना वास्तविक लेबल्स से क्रॉस-एंट्रॉपी का उपयोग करके की जाती है।
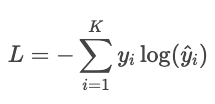
उदाहरण
मान लीजिए वास्तविक लेबल "cat" है और मॉडल प्रायिकताएँ देता है: cat: 80%, dog: 15%, bird: 5%। तब लॉस होगा
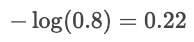
यदि "cat" के लिए अनुमानित प्रायिकता केवल 30% होती, तो लॉस कहीं अधिक होता:
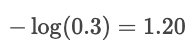
लॉग आत्मविश्वासी गलतियों को कड़ा दंड देता है और उच्च-आत्मविश्वास वाली सही भविष्यवाणियों को पुरस्कृत करता है।
हिंज लॉस
हिंज लॉस का उपयोग अधिकतर मैक्स-मार्जिन क्लासिफ़िकेशन (जैसे सपोर्ट वेक्टर मशीन—SVM) में होता है। लक्ष्य यह है कि भविष्यवाणियों को निर्णय सीमा से दूर रखकर आत्मविश्वास से वर्गीकृत किया जाए।
बाइनरी क्लासिफ़िकेशन के लिए, हिंज लॉस निम्नलिखित सूत्र से दिया जाता है।
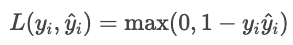
जहाँ
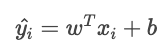
कुल कॉस्ट फ़ंक्शन है
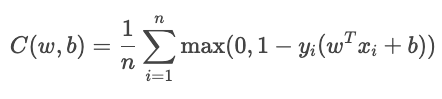
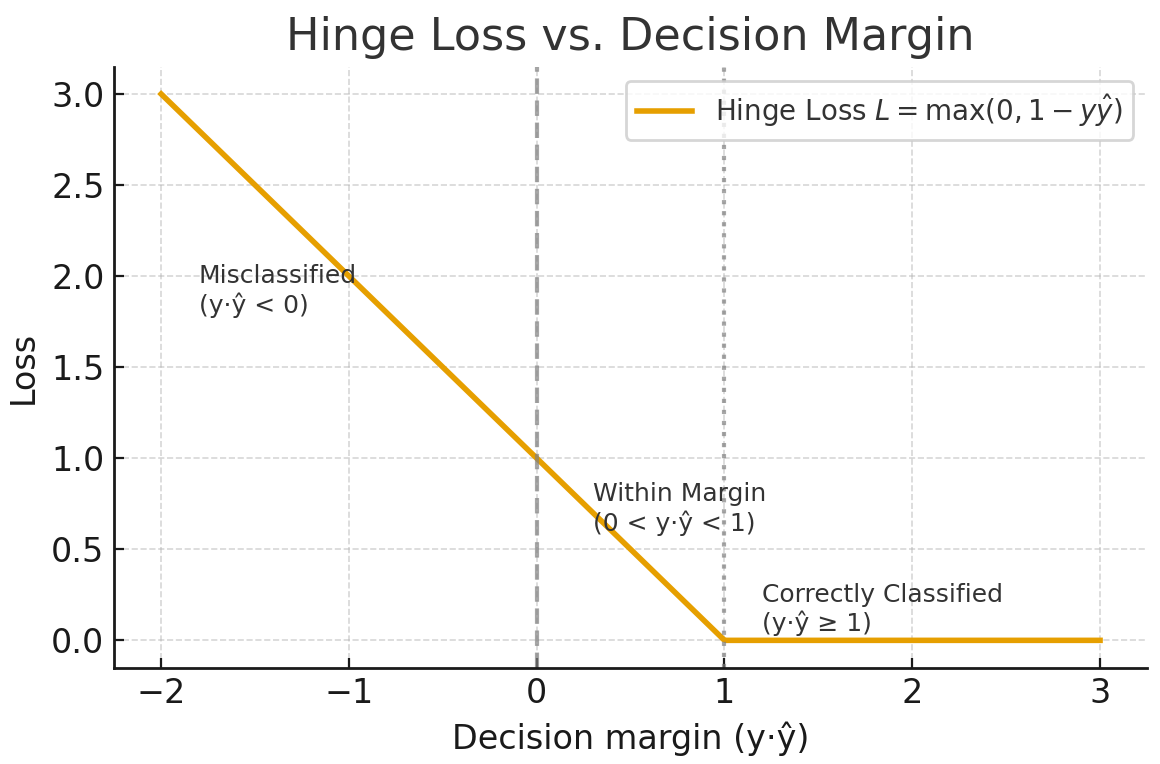
टर्म YiŶi मापता है कि सैंपल कितना अच्छे से वर्गीकृत हुआ है।
- जब यह 1 से बड़ा हो, तो सैंपल सीमा के सही तरफ़ होता है और कोई लॉस नहीं होता।
- जब यह 0 और 1 के बीच हो, तो बिंदु मार्जिन के भीतर होता है, इसलिए छोटा दंड लागू होता है।
- जब यह 0 से छोटा हो, तो मॉडल ने गलत वर्गीकरण किया है। सीमा से दूरी के साथ लॉस रैखिक रूप से बढ़ता है।
Generated by ChatGPT 5
Kullback-Leibler (KL)
Kullback-Leibler (KL) डाइवर्जेन्स यह मापता है कि अनुमापक प्रायिकता वितरण Q, दिए गए प्रायिकता वितरण P से कितना भिन्न है। इसे इस प्रकार परिभाषित किया जाता है
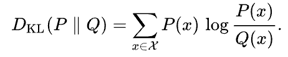
Wikipedia
KL डाइवर्जेन्स को इस रूप में व्याख्यायित किया जा सकता है कि Q के लिए अनुकूलित कोड का उपयोग करके P के सैम्पल्स को एन्कोड करने में औसतन कितने बिट्स का अंतर पड़ेगा।
नियमितीकरण (Regularization)
नियमितीकरण तकनीकें अत्यधिक जटिल समाधानों को दंडित करने वाला एक पद कॉस्ट फ़ंक्शन में जोड़कर, मॉडलों को ट्रेनिंग डेटा के शोर को फ़िट करने से रोकती हैं।
बिना नियमितीकरण के, मॉडल लॉस को न्यूनतम करता है:
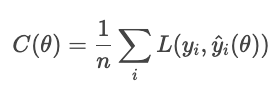
नियमितीकरण के साथ, मॉडल एक दंड पद जोड़ता है
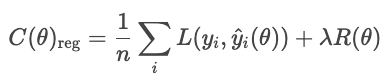
जहाँ
- L सामान्य लॉस है (जैसे, RMSE, क्रॉस-एंट्रॉपी)
- R(θ) मॉडल की जटिलता को मापता है
- λ फ़िट और सरलता के बीच संतुलन नियंत्रित करता है
नियमितीकरण के सामान्य प्रकार L1, L2, और एलास्टिक नेट हैं।
L1 नियमितीकरण (उर्फ़ lasso) प्रत्येक मॉडल वेट के परिमाण (absolute value) को कॉस्ट फ़ंक्शन में जोड़ता है।
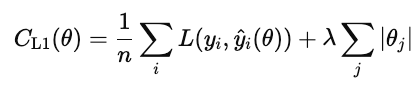
जब इस लागत को न्यूनतम किया जाता है, तो कई वेट शून्य पर आ जाते हैं। यह L1 को स्वचालित फ़ीचर चयन का एक रूप बनाता है। जो फ़ीचर्स योगदान नहीं देते, वे शून्य की ओर धकेल दिए जाते हैं।
L2 नियमितीकरण (उर्फ़ रिज रिग्रेशन) प्रत्येक मॉडल वेट के वर्ग को दंडित करता है।
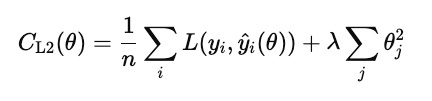
L1 के विपरीत, यह वेट्स को सटीक रूप से शून्य पर नहीं लाता, बल्कि उन्हें सुगमता से घटाता है। इससे सभी फ़ीचर्स मॉडल में बने रहते हैं लेकिन उनका प्रभाव घटकर भविष्यवाणियाँ स्थिर होती हैं।
एलास्टिक नेट L1 और L2 दोनों को जोड़ता है।
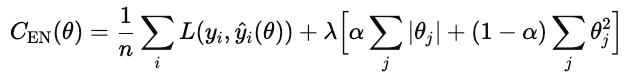
λ समग्र नियमितीकरण की तीव्रता नियंत्रित करता है। α 0 और 1 के बीच की संख्या है जो L1 बनाम L2 के प्रतिशतों को नियंत्रित करती है, जहाँ 1 शुद्ध L1 और 0 शुद्ध रिज है।
ट्रेड-ऑफ़्स
विभिन्न क्लासिफ़िकेशन लॉस रणनीतियों में समझौते (trade-offs) होते हैं।
क्रॉस-एंट्रॉपी आत्मविश्वास से गलत उत्तरों को दंडित करके सही प्रायिकता को अधिकतम करती है। समझौता यह है कि यह बाहरी मानों और गलत लेबल किए गए डेटा के प्रति संवेदनशील होती है। यह तब सबसे अच्छा काम करती है जब आपको आत्मविश्वास की गुणवत्ता की परवाह हो (जैसे, जोखिम मॉडल)।
हिंज लॉस एक मार्जिन लागू करती है ताकि सही वर्गीकरण केवल सही ही न हों, बल्कि आत्मविश्वास से सही हों। यह उन सैम्पल्स को नज़रअंदाज़ करती है जो मार्जिन से काफ़ी दूर सुरक्षित क्षेत्र में हैं, और उल्लंघनों के लिए रैखिक दंड देती है। यह क्रॉस-एंट्रॉपी की तुलना में बाहरी मानों के प्रति कम संवेदनशील है, लेकिन चिकनी तरह से ऑप्टिमाइज़ करना अधिक कठिन है, क्योंकि हिंज पर यह अवकलनीय नहीं है।
Kullback-Leibler (KL) डाइवर्जेन्स एक प्रायिकता वितरण को दूसरे से मिलाता है। यह क्रॉस-एंट्रॉपी माइनस सही वितरण की एंट्रॉपी के समतुल्य है।
अधिक जानकारी के लिए, ये लिंक देखें।
- Cross-Entropy Loss Function in Machine Learning: Enhancing Model Accuracy
- From Data to Dollars - Predicting Insurance Charges
- Optimize Pricing Predictions with Feature Engineering
- Data Quality Dimensions Cheat Sheet
- R Correlation Tutorial
मशीन लर्निंग में कॉस्ट फ़ंक्शन का इम्प्लीमेंटेशन और प्रैक्टिस
अब तक, हमने कॉस्ट फ़ंक्शंस को सिद्धांत में चर्चा की। व्यवहार में, किसी ML मॉडल की सफलता इस पर निर्भर करती है कि वह इन फ़ंक्शंस को कितनी कुशलता से न्यूनतम करता है। इस खंड में, हम मुख्य ऑप्टिमाइज़ेशन एल्गोरिदम और ट्यूनिंग रणनीतियों के व्यावहारिक विवरण प्रस्तुत करते हैं।
ऑप्टिमाइज़ेशन एल्गोरिदम और पैरामीटर ट्यूनिंग
ऑप्टिमाइज़ेशन वह प्रक्रिया है जिसमें कॉस्ट फ़ंक्शन को न्यूनतम करने वाले मॉडल पैरामीटर्स के इष्टतम मान खोजे जाते हैं। ML में, इसका मतलब ऐसे पैरामीटर्स खोजना है जो भविष्यवाणियों को वास्तविक मानों के जितना संभव हो सके निकट बना दें।
ग्रेडिएंट डिसेंट
ग्रेडिएंट डिसेंट कॉस्ट फ़ंक्शंस को ऑप्टिमाइज़ करने का मानक एल्गोरिदम है। यह क्रमागत (iteratively) रूप से मॉडल पैरामीटर्स को उस दिशा में अपडेट करता है जो लागत को सबसे अधिक घटाती है—नकारात्मक ग्रेडिएंट। वैचारिक रूप से, यह कॉस्ट फ़ंक्शन के बहु-चर ढाल को मापता है और ढलान के साथ नीचे की ओर कदम रखता है।
अपडेट नियम है
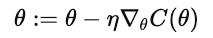
जहाँ θ मॉडल पैरामीटर्स हैं, n लर्निंग रेट है, और  कॉस्ट फ़ंक्शन का पैरामीटर्स के सापेक्ष ग्रेडिएंट है।
लर्निंग रेट का चुनाव महत्वपूर्ण है। बहुत बड़ा होने पर अपडेट्स न्यूनतम से आगे निकल जाते हैं और दोलन या विचलन करने लगते हैं। बहुत छोटा होने पर, अभिसरण धीमा हो जाता है और स्थानीय न्यूनतमों में फँस सकता है।
मुख्य प्रकार हैं बैच, स्टोकेस्टिक और मिनी-बैच।
- बैच ग्रेडिएंट डिसेंट। पूरे ट्रेनिंग सेट का उपयोग कर ग्रेडिएंट की गणना करता है। यह स्थिर है पर बड़े डेटासेट्स या ऑनलाइन लर्निंग के लिए धीमा और मेमोरी-इंटेंसिव है।
- स्टोकेस्टिक ग्रेडिएंट डिसेंट (SGD)। प्रत्येक ट्रेनिंग उदाहरण के बाद पैरामीटर्स अपडेट करता है। यह तेज़ और मेमोरी-कुशल है, पर प्रत्येक कदम थोड़ा-बहुत इष्टतम पथ से हट सकता है। फिर भी, यादृच्छिकता स्थानीय न्यूनतमों से निकलने में मदद कर सकती है।
- मिनी-बैच ग्रेडिएंट डिसेंट। एक व्यावहारिक समझौता। यह छोटे बैचों पर ग्रेडिएंट की गणना करता है ताकि गति और स्थिरता का संतुलन रहे। यह GPU पैरेललिज़्म को भी सक्षम करता है।
एडैप्टिव ऑप्टिमाइज़र्स
मानक ग्रेडिएंट डिसेंट सभी पैरामीटर्स पर एक निश्चित लर्निंग रेट लागू करता है। जटिल मॉडलों में अलग-अलग पैरामीटर्स को अलग-अलग स्टेप साइज़ की आवश्यकता हो सकती है। एडैप्टिव ऑप्टिमाइज़र्स ग्रेडिएंट परिमाणों के इतिहास के आधार पर लर्निंग रेट्स समायोजित करते हैं।
- RMSProp हाल के वर्ग ग्रेडिएंट्स के घातांकीय क्षयशील औसत का उपयोग करता है।
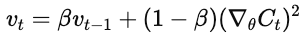
प्रत्येक पैरामीटर की लर्निंग इस औसत के व्युत्क्रमानुपाती स्केल होती है। यह दोलन को रोकता है और तब भी स्थिर प्रगति देता है जब कुछ पैरामीटर्स के ग्रेडिएंट तीक्ष्ण हों। RMSProp का व्यापक उपयोग रिकरेंट नेटवर्क्स और शोरयुक्त डेटा में होता है।
- एडैप्टिव मोमेंट एस्टीमेशन (Adam) पिछले ग्रेडिएंट्स के माध्य और विचरण दोनों को ट्रैक करता है और स्टेप साइज़ को गतिशील रूप से अनुकूलित करता है।
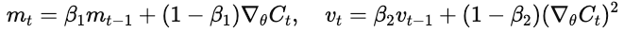
यह तेज़ी से अभिसरित होता है, शोरयुक्त डेटा के प्रति मज़बूत है, और डीप नेटवर्क फ़्रेमवर्क्स के लिए डिफ़ॉल्ट ऑप्टिमाइज़र है।
फ़ीचर स्केलिंग और इनिशियलाइज़ेशन
ग्रेडिएंट डिसेंट से पहले, फ़ीचर्स को स्केल करें ताकि वे तुलनीय दायरों में कार्य करें। उचित स्केलिंग ऑप्टिमाइज़ेशन की स्थिरता और दक्षता में सुधार करती है।
स्केलिंग के बिना, बड़े संख्यात्मक दायरों वाले फ़ीचर्स ग्रेडिएंट पर हावी हो जाते हैं। तब ग्रेडिएंट डिसेंट सीधे न्यूनतम की ओर कदम रखने के बजाय ज़िगज़ैग करता है।
दो सामान्य तरीके हैं।
- स्टैंडर्डाइज़ेशन। प्रत्येक फ़ीचर को शून्य पर केंद्रित करता है और इकाई विचरण में पुन:स्केल करता है।
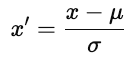
जहाँ u माध्य है और ơ मानक विचलन है। स्टैंडर्डाइज़ेशन डेटा की संरचना को संरक्षित रखता है।
- नॉर्मलाइज़ेशन। प्रत्येक फ़ीचर को एक निश्चित दायरे में पुन:स्केल करता है, आमतौर पर [0, 1]।
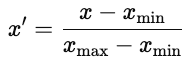
नॉर्मलाइज़ेशन न्यूरल नेटवर्क्स में सामान्य है, जहाँ एक्टिवेशन फ़ंक्शंस सीमाबद्ध इनपुट्स के साथ सबसे अच्छा प्रदर्शन करते हैं।
पैरामीटर इनिशियलाइज़ेशन रणनीतियाँ
पैरामीटर इनिशियलाइज़ेशन मॉडल ट्रेनिंग को काफ़ी प्रभावित करता है। खराब इनिशियलाइज़ेशन से धीमी अभिसरण, विस्फोटक या विलुप्त होते ग्रेडिएंट्स, या सीखने में विफल मॉडल हो सकते हैं। अच्छा इनिशियलाइज़ेशन पैरामीटर्स को कॉस्ट सतह के ऐसे क्षेत्र में रखता है जहाँ ग्रेडिएंट स्थिर हों।
- रैंडम इनिशियलाइज़ेशन। छोटे रैंडम मान असाइन करता है, जो आमतौर पर यूनिफ़ॉर्म या नॉर्मल वितरण से लिए जाते हैं। रैंडमाइज़ेशन सममिति तोड़ता है ताकि पैरामीटर्स अलग-अलग फ़ीचर्स सीखें। हालाँकि, यदि वैरिएंस बहुत अधिक या कम हो, तो ग्रेडिएंट्स विस्फोट कर सकते हैं या विलुप्त हो सकते हैं।
- Xavier (Glorot) इनिशियलाइज़ेशन। tanh या sigmoid जैसे नॉनलाइनियर एक्टिवेशंस के लिए डिज़ाइन किया गया, Xavier वेट्स के वैरिएंस को इनपुट और आउटपुट कनेक्शंस की संख्या के अनुसार स्केल करता है।
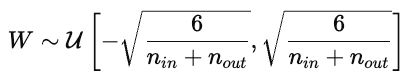
यह लेयर्स में एक्टिवेशंस और ग्रेडिएंट्स को मोटे तौर पर स्थिर रखता है।
- He इनिशियलाइज़ेशन। ReLU एक्टिवेशंस के लिए वैरिएंस समायोजित करता है, जो नकारात्मक मानों को शून्य कर देते हैं। वेट्स एक निर्दिष्ट वैरिएंस वाले नॉर्मल वितरण से लिए जाते हैं:
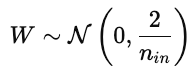
यह बैकप्रोपेगेशन के दौरान ग्रेडिएंट्स को बहुत जल्दी विलुप्त होने से रोकता है।
मॉनिटरिंग, डायग्नॉस्टिक्स, और विज़ुअलाइज़ेशन
एक ट्रेनिंग लॉस कर्व समय के साथ ट्रेनिंग डेटासेट पर मॉडल की त्रुटि को प्लॉट करता है। यह दिखाता है कि मॉडल त्रुटि को न्यूनतम करने के लिए अपने पैरामीटर्स को कितना अच्छी तरह अपडेट करता है। एक निरंतर घटती कर्व इंगित करती है कि मॉडल डेटा से पैटर्न सीख रहा है।
वैलिडेशन लॉस कर्व अनदेखे डेटा, जैसे होल्ड-आउट या वैलिडेशन सेट, पर मॉडल की सामान्यीकरण क्षमता दिखाती है। यह पहले न देखे गए डेटा पर मॉडल की भविष्यवाणी क्षमता का संकेत देती है।
आदर्श रूप में, दोनों कर्व्स शुरुआत में घटती हैं और फिर समतल हो जाती हैं। यह दर्शाता है कि मॉडल प्रभावी रूप से सीख भी रहा है और प्रभावी रूप से सामान्यीकरण भी कर रहा है।
ओवरफ़िटिंग तब होती है जब मॉडल शोर को सिग्नल की तरह सीखता है और अच्छी तरह सामान्यीकृत नहीं करता। यह उस ग्राफ़ में दिखता है जहाँ ट्रेनिंग लॉस घटता है पर वैलिडेशन लॉस बढ़ता है। उपायों में बड़ा डेटासेट उपयोग करना, या मॉडल में नियमितीकरण शामिल करना है।
अंडरफ़िटिंग तब होती है जब मॉडल डेटा के अंतर्निहित पैटर्न पकड़ने में विफल रहता है। ट्रेनिंग और वैलिडेशन दोनों कर्व्स ऊँची रहती हैं। ऐसे में, अधिक डेटा, अधिक जटिल मॉडल, या नियमितीकरण कम करने की कोशिश करें।
कनवर्जेन्स वह बिंदु है जहाँ कर्व समतल हो जाती है, और अधिक ट्रेनिंग बहुत कम सुधार देती है। यही ओवरफ़िटिंग और अंडरफ़िटिंग के बीच की उपयुक्त स्थिति है।
कॉस्ट फ़ंक्शन ऑप्टिमाइज़ेशन और निर्णय सिद्धांत
हमने देखा कि अर्थशास्त्र और मशीन लर्निंग दोनों निर्णय-निर्माण और ट्रेनिंग का मार्गदर्शन करने के लिए ऑप्टिमाइज़ेशन पर निर्भर करते हैं। दोनों क्षेत्र लागत या लॉस के किसी मीट्रिक के आधार पर सर्वश्रेष्ठ निर्णय लेने का प्रयास करते हैं। आइए सामान्य रूप से ऑप्टिमाइज़ेशन सिद्धांत में गहराई से उतरें।
ऑब्जेक्टिव फ़ंक्शंस
एक ऑब्जेक्टिव फ़ंक्शन वह गणितीय फ़ंक्शन है जो परिभाषित करता है कि हमें क्या न्यूनतम या अधिकतम करना है। अब तक देखे मामलों में, हमने लागत या त्रुटि को न्यूनतम किया है। इकोन में, हमने कॉस्ट कर्व्स देखे, और ML में, हमने रिग्रेशन लॉसेज़ (MAE, RMSE, Huber) और क्लासिफ़िकेशन लॉसेज़ (क्रॉस-एंट्रॉपी, हिंज लॉस, KL लॉस) देखे। ये दोनों ऑब्जेक्टिव फ़ंक्शन को ऑप्टिमाइज़ करने के उदाहरण हैं।
मल्टी-ऑब्जेक्टिव ऑप्टिमाइज़ेशन
अक्सर, हम अनेक, और अक्सर परस्पर-विरोधी, लक्ष्यों को ऑप्टिमाइज़ करना चाहते हैं। कोई कंपनी लाभ अधिकतम करना चाह सकती है जबकि जोखिम न्यूनतम करना भी। कोई डेटा वैज्ञानिक मॉडल की शुद्धता बेहतर करना चाहता है पर व्याख्येयता या निष्पक्षता का बलिदान नहीं। ऐसे प्रतिस्पर्धी लक्ष्य एक मल्टी-ऑब्जेक्टिव ऑप्टिमाइज़ेशन समस्या को परिभाषित करते हैं, जिसमें एक उद्देश्य सुधारने से दूसरा बिगड़ सकता है।
पारेटो फ़्रंटियर
किसी समाधान को पारेटो ऑप्टिमल कहा जाता है यदि किसी भी उद्देश्य को बेहतर किए बिना कम से कम एक अन्य उद्देश्य को बदतर किए बिना बेहतर नहीं किया जा सकता। पारेटो-ऑप्टिमल समाधानों का समूह पारेटो फ़्रंटियर बनाता है—एक वक्र जो सर्वश्रेष्ठ प्राप्त करने योग्य समझौतों का समूह होता है। इस वक्र का हर बिंदु प्राथमिकताओं के अलग संतुलन का प्रतिनिधित्व करता है।
उदाहरण के लिए, मॉडल की जटिलता बढ़ाने से शुद्धता में सुधार हो सकता है पर व्याख्येयता घट सकती है। सरल मॉडल समझाने में आसान होते हैं पर प्रदर्शन कमजोर हो सकता है। पारेटो फ़्रंटियर में "सबसे अच्छे समझौते" शामिल होते हैं और उन समाधानों को बाहर रखा जाता है जो अन्य चर द्वारा डोमिनेटेड हैं।
सही बिंदु का चयन संदर्भ और विवेक पर निर्भर करता है। आप प्रत्येक लक्ष्य को वेट्स दे सकते हैं या नीतिगत संयम (policy constraints) लागू कर सकते हैं।
अपेक्षित लॉस
जब परिणाम अनिश्चित हों, तो ऑप्टिमाइज़ेशन अपेक्षित लॉस को न्यूनतम करता है—सभी संभावित परिदृश्यों पर औसत लॉस। ML में, यह विचार रिस्क फ़ंक्शन में प्रकट होता है।
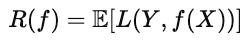
जहाँ L(Y,f(x)) किसी दी गई भविष्यवाणी के लिए लॉस है, और अपेक्षा (expectation) डेटा वितरण पर औसत लेती है। लक्ष्य ऐसे मॉडल f को खोजना है जो इस अपेक्षित लॉस को न्यूनतम करे। यह मॉडल औसतन सबसे अच्छा प्रदर्शन करता है, केवल व्यक्तिगत सैंपल्स पर नहीं।
बेयज़ रिस्क
बेयज़ रिस्क अपेक्षित लॉस की सैद्धांतिक निम्नतम सीमा है। औपचारिक रूप से, यह निम्न सूत्र से दी जाती है।
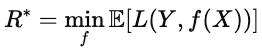
सहज रूप में, यह "परफेक्ट स्कोर" है, यानी डेटा वितरण के बारे में पूर्ण जानकारी होने पर प्राप्त होने वाला सबसे छोटा मान। किसी मॉडल का प्रदर्शन जितना बेयज़ रिस्क के क़रीब होगा, वह उतना ही इष्टतम होगा।
बहु-विषयक अनुप्रयोग
कॉस्ट फ़ंक्शंस का उपयोग किसी भी उद्योग में होता है जो डेटा-आधारित निर्णय लेता है। वे प्रतिस्पर्धी उद्देश्यों का संतुलन बनाने में मदद करते हैं और "बेहतर" का औपचारीकरण करते हैं। ये फ़ंक्शंस प्रतिस्पर्धी उद्देश्यों का संतुलन बनाते हैं और ऑप्टिमाइज़ेशन का मार्गदर्शन करते हैं। वही तर्क जो ML मॉडलों को ट्रेन करने में उपयोग होता है, वास्तविक दुनिया की प्रक्रियाओं को ऑप्टिमाइज़ करने में भी प्रयुक्त होता है।
उद्योग अनुप्रयोग और डोमेन उपयोग केस
उदाहरण के लिए, विनिर्माण में, कॉस्ट फ़ंक्शंस हानियों को मात्राबद्ध करते हैं, जैसे इन्वेंटरी लॉस। इन्वेंटरी कॉस्ट फ़ंक्शन अतिरिक्त स्टॉक के खर्च और कमी के दंड के बीच संतुलन बनाता है। समान ढाँचे उत्पादन शेड्यूलिंग या ऊर्जा उपयोग के लिए प्रयुक्त होते हैं ताकि अनिश्चितता के तहत अपेक्षित कुल लागत को न्यूनतम किया जा सके।
हेल्थकेयर में, प्रेडिक्टिव मॉडल्स शुद्धता और संसाधन आवंटन के बीच संतुलन बनाने हेतु कॉस्ट फ़ंक्शंस का उपयोग करते हैं। उदाहरण के लिए, रीडमिशन रिस्क मॉडल उच्च-जोखिम वाले रोगियों की जल्दी पहचान करता है ताकि चिकित्सक फ़ॉलो-अप कॉल या होम विज़िट से हस्तक्षेप कर सकें। उच्च-जोखिम रोगी को चूकना, कम-जोखिम वाले को फ़्लैग करने से अधिक महँगा होता है, इसलिए फ़ंक्शन इन त्रुटियों को अलग तरह से दंडित करता है।
वित्त में भी ऑब्जेक्टिव फ़ंक्शंस का उपयोग होता है। उदाहरण के लिए, क्रेडिट स्कोरिंग मॉडल यह अनुमान लगाते हैं कि उधारकर्ता एक निश्चित अवधि, जैसे बारह महीने, के भीतर ऋण डिफ़ॉल्ट करेगा या नहीं। जोखिम भरे उधारकर्ता को स्वीकृत करना संभावित वित्तीय नुकसान देता है, जबकि सुरक्षित उधारकर्ता को अस्वीकार करना संभावित राजस्व खो देता है। मॉडल अपेक्षित लागत को न्यूनतम करता है।
इन सभी डोमेन में, कॉस्ट फ़ंक्शंस समझौतों (trade-offs) को मापने योग्य मात्राओं में बदलते हैं जिनका निर्णयकर्ता उपयोग कर सकें और जिन पर तर्क कर सकें।
निष्कर्ष
कॉस्ट फ़ंक्शंस निर्णयों का आकलन करने की एक विधि प्रदान करते हैं। अर्थशास्त्र में, वे आउटपुट और दक्षता के बीच के संतुलन का मॉडल बनाते हैं। मशीन लर्निंग में, वे भविष्यवाणियों और सत्य के बीच के अंतर को मापते हैं।
ML में, कॉस्ट फ़ंक्शंस मॉडल डिज़ाइन की नींव हैं। लॉस फ़ंक्शंस का चुनाव यह निर्धारित करता है कि मॉडल "सफलता" को क्या मानता है। मीन स्क्वेयर्ड एरर समग्र शुद्धता को पुरस्कृत करता है, क्रॉस-एंट्रॉपी कैलिब्रेटेड प्रायिकताओं को, और हिंज लॉस आत्मविश्वासपूर्ण पृथक्करण को।
सभी डोमेन्स और उद्योगों में, अंतर्निहित तर्क समान रहता है: एक उद्देश्य परिभाषित करें और उसे ऑप्टिमाइज़ करें। कॉस्ट फ़ंक्शंस अस्पष्ट लक्ष्यों को ठोस संख्याओं में बदलते हैं जो ऑप्टिमाइज़ेशन का मार्गदर्शन करते हैं।
कॉस्ट फ़ंक्शंस अर्थशास्त्र, मशीन लर्निंग, विनिर्माण, वित्त, हेल्थकेयर और हर उस जगह उपयोगी हैं जहाँ आप समझौतों को मात्राबद्ध करना चाहते हैं।
अधिक जानकारी के लिए, मैं ये DataCamp संसाधन सुझाता/सुझाती हूँ।
कॉस्ट फ़ंक्शन FAQs
कॉस्ट फ़ंक्शन क्या है?
कॉस्ट फ़ंक्शन यह निर्धारित करता है कि किसी मॉडल की भविष्यवाणियाँ डेटा से कितनी मेल खाती हैं। यह त्रुटि को एक एकल मान में समेकित करता है। फिर ऑप्टिमाइज़ेशन एल्गोरिदम इस मान को न्यूनतम करते हैं ताकि प्रदर्शन सुधरे।
रिग्रेशन और क्लासिफ़िकेशन कार्यों में कॉस्ट फ़ंक्शंस कैसे भिन्न होते हैं?
रिग्रेशन मॉडल सतत मानों की भविष्यवाणी करते हैं, इसलिए उनका लॉस (जैसे MSE, MAE) लक्ष्य से संख्यात्मक दूरी को मापता है।
क्लासिफ़िकेशन मॉडल क्लास प्रायिकताएँ भविष्यवाणी करते हैं; क्रॉस-एंट्रॉपी जैसे लॉसेज़ भविष्यवाणी की गई वितरण की तुलना सही क्लास से करते हैं और आत्मविश्वास से की गई गलतियों को कड़ा दंड देते हैं।
व्यवसाय में कॉस्ट फ़ंक्शंस के कुछ वास्तविक अनुप्रयोग क्या हैं?
कॉस्ट फ़ंक्शंस किसी भी व्यावसायिक प्रक्रिया में उपयोगी हैं जिसमें समझौते या ऑप्टिमाइज़ेशन शामिल हो। उदाहरण हैं प्राइसिंग और रेवेन्यू ऑप्टिमाइज़ेशन, इन्वेंटरी प्रबंधन, क्रेडिट और जोखिम मॉडलिंग, कस्टमर रिटेंशन, या लॉजिस्टिक्स।
Huber लॉस फ़ंक्शन डेटा में बाहरी मानों को कैसे संभालता है?
Huber लॉस फ़ंक्शन छोटी त्रुटियों को MSE की तरह और बड़ी त्रुटियों को MAE की तरह व्यवहार में लाता है, जिससे यह बाहरी मानों के प्रति कम संवेदनशील हो जाता है।
सीमांत लागत और औसत लागत के बीच क्या संबंध है?
सीमांत लागत (MC) एक अतिरिक्त यूनिट का उत्पादन करने की लागत मापती है। औसत लागत (AC) कुल लागत को यूनिट्स की संख्या से भाग देने पर मिलती है। जब MC < AC हो, तो अधिक उत्पादन औसत लागत घटाता है; जब MC > AC हो, तो अधिक उत्पादन औसत लागत बढ़ाता है; और जब MC = AC हो, तो औसत लागत न्यूनतम पर होती है।

मार्क पेडिगो, PhD, स्वास्थ्यसेवा डेटा विज्ञान, प्रोग्रामिंग और शिक्षा में विशेषज्ञता वाले एक प्रतिष्ठित डेटा वैज्ञानिक हैं। गणित में PhD, कंप्यूटर साइंस में B.S., और AI में प्रोफेशनल सर्टिफिकेट रखने वाले मार्क तकनीकी ज्ञान को व्यावहारिक समस्या-समाधान से प्रभावी रूप से जोड़ते हैं। उनके करियर में धोखाधड़ी का पता लगाने, शिशु मृत्यु दर की भविष्यवाणी, और वित्तीय पूर्वानुमान से जुड़ी भूमिकाएँ शामिल रही हैं, साथ ही NASA के लागत आकलन सॉफ़्टवेयर में उनके योगदान भी हैं। एक शिक्षक के रूप में, उन्होंने DataCamp और वॉशिंगटन यूनिवर्सिटी इन सेंट लुईस में पढ़ाया है और कनिष्ठ प्रोग्रामरों का मार्गदर्शन किया है। खाली समय में, मार्क अपनी पत्नी मैंडी और कुत्ते हार्ले के साथ मिनेसोटा की प्राकृतिक सुंदरता का आनंद लेते हैं और जैज़ पियानो बजाते हैं।
कॉस्ट फ़ंक्शंस निर्णयों के "स्कोरकीपर" की तरह काम करते हैं। वे मापते हैं कि भविष्यवाणियाँ वास्तविक मानों से कितनी दूर हैं—डेटासेट के वास्तविक बनाम भविष्यवाणी किए गए मानों की तुलना में। मशीन लर्निंग में, वे त्रुटि को न्यूनतम करने और मॉडल की शुद्धता बढ़ाने के लिए ऑप्टिमाइज़ेशन एल्गोरिदम का मार्गदर्शन करते हैं।
इस लेख में, हम क्रमबद्ध तरीके से सहज समझ बनाते हैं। हम आर्थिक अनुप्रयोगों से शुरू करते हैं, जहाँ कॉस्ट फ़ंक्शंस उत्पादन और दक्षता के बीच के संतुलन का वर्णन करते हैं। फिर हम मशीन लर्निंग की ओर मुड़ते हैं, जहाँ वे मॉडल ट्रेनिंग को संचालित करते हैं। इसके बाद, हम ऑप्टिमाइज़ेशन को दोनों के बीच सेतु के रूप में देखते हैं। अंत में, हम वास्तविक दुनिया के उदाहरणों की पड़ताल करते हैं।
कॉस्ट फ़ंक्शन क्या है?
कॉस्ट फ़ंक्शंस ऑप्टिमाइज़ेशन और मूल्यांकन के लिए बुनियादी हैं। आइए कॉस्ट फ़ंक्शंस को गणितीय रूप से परिभाषित करें और उनकी मुख्य विशेषताओं की जाँच करें।
एक कॉस्ट फ़ंक्शन (जिसे "एरर फ़ंक्शन" भी कहते हैं) एक या अधिक इनपुट चर को एक एकल संख्यात्मक मान में मैप करता है जो किसी निर्णय या भविष्यवाणी की "लागत" दर्शाता है। मशीन लर्निंग में, इसे आमतौर पर पूरे डेटासेट के लॉस फ़ंक्शन के औसत के रूप में परिभाषित किया जाता है।
कॉस्ट फ़ंक्शन दो भूमिकाएँ निभाता है: यह एक लक्ष्य (objective) के रूप में काम करता है जिसे ऑप्टिमाइज़र न्यूनतम करता है, और एक मूल्यांकन मीट्रिक के रूप में जिससे मॉडल के प्रदर्शन को मापा जाता है।
आइए कॉस्ट फ़ंक्शन को एक उद्देश्य के रूप में देखें। प्रत्येक घर के लिए, लॉस फ़ंक्शन वास्तविक बिक्री मूल्य और अनुमानित मूल्य के अंतर को दंडित करता है। कॉस्ट फ़ंक्शन इन दंडों को सभी घरों में एकत्रित करता है:
छोटी लागत बेहतर समग्र फ़िट को दर्शाती है, जबकि बड़ी लागत औसत त्रुटि के अधिक होने को दर्शाती है। ऑप्टिमाइज़र इस लागत को न्यूनतम करने के लिए पैरामीटर्स समायोजित करता है।
एक मूल्यांकन मीट्रिक के रूप में, कॉस्ट फ़ंक्शंस प्रदर्शन को मापते हैं। उदाहरण के लिए, किसी क्लासिफ़ायर का आकलन सटीकता, या रिकॉल, या अनुप्रयोग के अनुरूप किसी भी मीट्रिक से किया जा सकता है। इस तरह, कॉस्ट फ़ंक्शंस सफलता का आकलन करने का तरीका प्रदान करते हैं।
कॉस्ट फ़ंक्शंस के गुण
तीन गणितीय गुण विशेष रूप से प्रासंगिक हैं.
ये गुण मिलकर निर्धारित करते हैं कि ऑप्टिमाइज़ेशन के लिए कोई कॉस्ट फ़ंक्शन कितना सुगम है। जब इनमें से कोई गुण अनुपस्थित हो, तो उसकी भरपाई के लिए विशेष तकनीकों की ज़रूरत पड़ सकती है।
अर्थशास्त्र और व्यवसाय में कॉस्ट फ़ंक्शंस के अनुप्रयोग
कॉस्ट फ़ंक्शंस आउटपुट की मात्रा और उत्पादों की कुल लागत के बीच के संबंध का वर्णन करते हैं। वे फर्म के व्यवहार, मूल्य निर्धारण रणनीतियों और लाभ विश्लेषण को समझने का एक आवश्यक उपकरण हैं।
आर्थिक लागतों के प्रकार
कॉस्ट कर्व्स
कॉस्ट कर्व्स दिखाते हैं कि कुल उत्पादित मात्रा के फ़ंक्शन के रूप में लागतें कैसे बदलती हैं। नियत लागतें स्थिर रहती हैं, इसलिए क्षैतिज रेखा के रूप में प्रदर्शित होती हैं, जबकि परिवर्ती लागतें उत्पादित यूनिट्स के फ़ंक्शन के रूप में बढ़ती हैं।
Wikipedia: Cost Curve
शॉर्ट-रन बनाम लॉन्ग-रन लागतें
अल्पावधि (short run) में, कम से कम एक इनपुट, जैसे पूंजी या संयंत्र आकार, स्थिर होता है, और अन्य इनपुट बदलते हैं। शॉर्ट-रन लागतें मापती हैं कि कोई फर्म अपनी वर्तमान व्यवस्था के साथ कितनी कुशलता से काम करती है। अतः, दी गई मात्रा q के लिए, अल्पावधि में लागत नियत लागतों और मात्रा-निर्भर परिवर्ती लागतों के योग के बराबर होती है।
अल्पावधि में, मौजूदा क्षमता के भीतर ही ऑप्टिमाइज़ करें।
दीर्घावधि (long run) में, सभी इनपुट परिवर्ती होते हैं। फर्म अपने उत्पादन प्रक्रियाओं का विस्तार कर सकती है। लॉन्ग-रन लागतें उस दक्षता को मापती हैं जब क्षमता स्वयं बदल सकती है, और किसी भी आउटपुट स्तर के लिए न्यूनतम संभव लागत दिखाती हैं।
दीर्घावधि में, इष्टतम क्षमता का चयन करके ऑप्टिमाइज़ करें।
उत्पादन और लाभ विश्लेषण
कॉस्ट फ़ंक्शंस का उपयोग मूल्य निर्धारण व्यवहार का विश्लेषण करने के लिए होता है। फर्में उत्पादन का विस्तार या संकुचन करने का निर्णय लेने में मदद के लिए कॉस्ट कर्व्स की तुलना बाज़ार कीमतों से करती हैं। यदि सीमांत लागत बाज़ार मूल्य से कम है, तो अधिक उत्पादन से लाभ बढ़ता है; यदि सीमांत लागत बाज़ार मूल्य से अधिक है, तो अधिक यूनिट्स बनाना महँगा पड़ता है।
कॉस्ट फ़ंक्शंस का उपयोग मूल्य निर्धारण रणनीतियों में भी होता है। वे उस न्यूनतम व्यवहार्य मूल्य को निर्धारित करते हैं जिसे फर्म चार्ज कर सकती है। अधिकतम लाभ के लिए फर्में सीमांत लागत से ऊपर चार्ज कर सकती हैं, या अत्यधिक प्रतिस्पर्धी उद्योगों में MC के क़रीब। इस प्रकार, कॉस्ट विश्लेषण ब्रेक-ईवन प्राइसिंग, कॉस्ट-प्लस प्राइसिंग, और डायनेमिक प्राइसिंग रणनीतियों को सूचित करता है।
ब्रेक-ईवन प्वाइंट वह है जहाँ कुल राजस्व कुल लागत के बराबर होता है।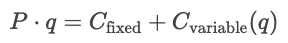
इस बिंदु पर, कंपनी सभी लागतें कवर करती है पर लाभ नहीं कमाती। कम उत्पादन से घाटा होता है, जबकि अधिक उत्पादन से लाभ उत्पन्न होता है।
लाभ कुल राजस्व और कुल लागत के बीच का अंतर है।
यदि सीमांत राजस्व सीमांत लागत से अधिक है (MR > MC), तो फर्म अधिक लाभ के लिए आउटपुट बढ़ाएगी। यदि सीमांत राजस्व सीमांत लागत से कम है (MR < MC), तो फर्म अतिरिक्त लाभ के लिए आउटपुट घटाएगी। फर्म MR = MC होने वाली मात्रा का उत्पादन करके लाभ अधिकतम करती है।
वित्त के बारे में अधिक जानकारी के लिए, मैं ये DataCamp संसाधन देखने की सलाह देता/देती हूँ।
मशीन लर्निंग में कॉस्ट फ़ंक्शंस
ML अनुप्रयोगों में, कॉस्ट फ़ंक्शंस पूरे डेटासेट में अवशेषों (भविष्यवाणी और वास्तविक मानों के बीच का अंतर) को मात्राबद्ध करते हैं। यह खंड कॉस्ट फ़ंक्शंस के प्रमुख परिवारों और वे मॉडल के व्यवहार को कैसे आकार देते हैं, की पड़ताल करता है।
रिग्रेशन लॉसेज़
मशीन लर्निंग संदर्भ में, रिग्रेशन का लक्ष्य (आवश्यक नहीं कि लाइनियर रिग्रेशन) एक सतत मान की भविष्यवाणी करना है। एक रिग्रेशन लॉस फ़ंक्शन किसी विशिष्ट सैंपल के लिए वास्तविक और अनुमानित मानों के बीच की त्रुटि को मात्राबद्ध करता है; कॉस्ट फ़ंक्शंस लॉस फ़ंक्शंस को समग्र मात्रा में समेकित करते हैं। ऑप्टिमाइज़ेशन प्रक्रियाएँ समग्र त्रुटि को न्यूनतम करने के लिए कॉस्ट फ़ंक्शंस का उपयोग करती हैं।
हम चार मुख्य परिवारों पर ध्यान केंद्रित करते हैं: मीन एब्सलूट एरर (MAE), मीन स्क्वेयर्ड एरर (MSE), रूट मीन स्क्वेयर एरर (RMSE), और Huber लॉस।
अलग-अलग कॉस्ट फ़ंक्शंस त्रुटियों को अलग-अलग तरह से संभालते हैं। वस्तुतः, वे यह परिभाषित करते हैं कि अनुमानित और वास्तविक मानों के बीच विचलन को कितना कड़ा दंड दिया जाए। MAE समान दंड लागू करता है, जो माध्यिका व्यवहार और बाहरी मानों के प्रति मजबूती दर्शाता है। MSE प्रत्येक अवशेष का वर्ग करता है, जिससे बड़ी त्रुटियाँ हावी हो जाती हैं और उन्हें अधिक कड़ा दंड मिलता है। Huber लॉस इन दोनों का मिश्रण है—छोटी त्रुटियों के लिए द्विघात दंड और बड़ी (किसी सीमा δ से परे) त्रुटियों के लिए रैखिक दंड।