Last chance! 50% off DataCamp Premium
Sale ends in
Python, dengan ekosistem pustaka yang kaya seperti NumPy, statsmodels, dan scikit-learn, telah menjadi bahasa andalan bagi data scientist. Kemudahan penggunaan dan fleksibilitasnya membuat Python ideal baik untuk memahami landasan teoretis regresi linear maupun menerapkannya pada skenario dunia nyata.
Dalam panduan ini, saya akan membahas semua yang perlu Anda ketahui tentang regresi linear di Python. Kita akan mulai dengan mendefinisikan apa itu regresi linear dan mengapa ini begitu penting. Lalu, kita akan menelaah mekanismenya, mengeksplorasi persamaan dan asumsi yang mendasarinya. Anda akan belajar cara melakukan regresi linear menggunakan berbagai pustaka Python, dari perhitungan manual dengan NumPy hingga implementasi yang ringkas dengan scikit-learn. Kita akan membahas regresi linear sederhana dan berganda, dan saya akan menunjukkan cara mengevaluasi model Anda serta meningkatkan kinerjanya.
Regresi linear adalah metode statistik yang digunakan untuk memodelkan hubungan antara variabel dependen (target) dan satu atau lebih variabel independen (prediktor). Tujuannya adalah menemukan persamaan linear yang paling tepat menggambarkan hubungan ini.
Regresi linear banyak digunakan untuk pemodelan prediktif, statistika inferensial, dan memahami hubungan dalam data. Aplikasinya mencakup peramalan penjualan, penilaian risiko, dan menganalisis dampak berbagai variabel terhadap hasil target.
Untuk regresi linear sederhana, bentuknya berupa garis pada ruang dua dimensi; untuk regresi linear berganda (dengan dua variabel independen), hubungan tersebut direpresentasikan oleh bidang pada ruang tiga dimensi; Untuk lebih banyak variabel independen, persamaan menggambarkan sebuah hiperbidang pada ruang berdimensi lebih tinggi.
Mari mulai dengan model regresi linear sederhana, yang, seperti saya sebutkan, hanya memiliki satu variabel prediktor. Model ini direpresentasikan oleh persamaan berikut:
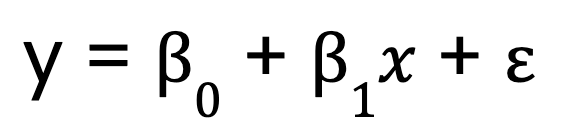
Dengan:
Sebaliknya, regresi linear berganda memperluas konsep ini untuk mencakup beberapa variabel prediktor:
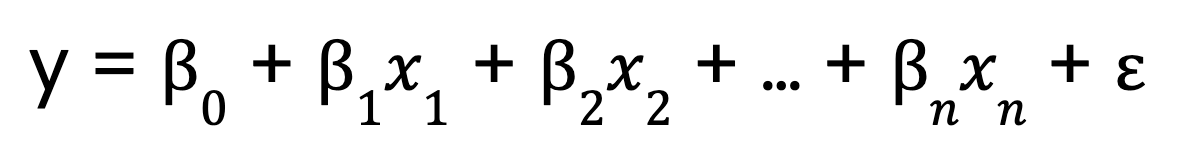
Dengan:
Untuk memahami cara kerja regresi linear, mari uraikan komponen utamanya.
Kita telah melihat persamaan untuk regresi linear di atas, baik dengan satu maupun banyak prediktor. Namun sekarang, izinkan saya membahas aspek penting dari persamaan tersebut.
Istilah linear dalam regresi linear merujuk pada bentuk fungsional model, bukan bentuk data secara harfiah. Secara khusus, artinya:
Untuk menentukan garis terbaik, regresi linear menggunakan metode ordinary least squares (OLS). OLS meminimalkan jumlah kuadrat galat:
OLS meminimalkan jumlah kuadrat galat:
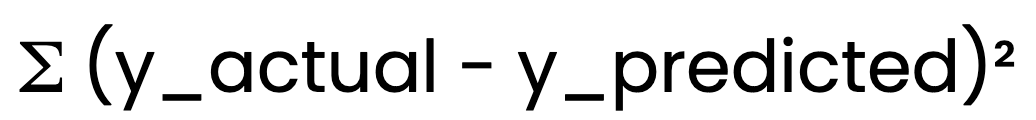
Ini memastikan model memberikan taksiran terbaik untuk B0 dan B1.
Agar regresi linear menghasilkan hasil yang andal, beberapa asumsi harus dipenuhi:
Memvalidasi asumsi-asumsi ini memastikan model kita andal dan valid. Misalnya, jika hubungan antara variabel tidak linear, prediksi model bisa tidak akurat. Jika terjadi heteroskedastisitas, interval kepercayaan bisa menjadi keliru.
Regresi linear dapat diimplementasikan di Python dengan berbagai pendekatan. Saya akan membahas tiga metode umum: perhitungan manual dengan NumPy, pemodelan statistik mendetail dengan statsmodels, dan machine learning yang ringkas dengan scikit-learn.
Untuk regresi linear sederhana (satu variabel prediktor), Anda dapat menghitung parameter regresi secara manual menggunakan NumPy. Ini melibatkan terlebih dahulu menghitung mean variabel independen dan dependen. Lalu kita menghitung kemiringan (B0):
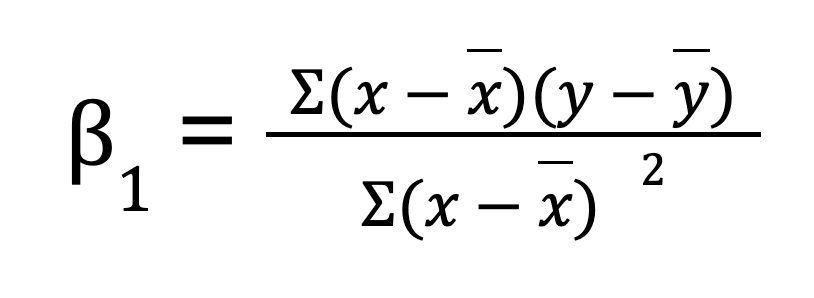
Setelah mendapatkan kemiringan, kita dapat menentukan intersep (B1):
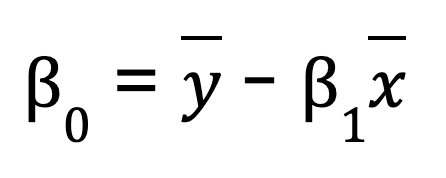
import numpy as np

# Sample data
x = np.array([1, 2, 3, 4, 5])
y = np.array([2, 4, 5, 4, 5])

# Compute means
x_mean = np.mean(x)
y_mean = np.mean(y)

# Compute slope (B1)
B1 = np.sum((x - x_mean) * (y - y_mean)) / np.sum((x - x_mean) ** 2)

# Compute intercept (B0)
B0 = y_mean - B1 * x_mean

print(f"Slope (B1): {B1}")
print(f"Intercept (B0): {B0}")

# Predicting values
y_pred = B0 + B1 * x
print("Predicted values:", y_pred)
Jika Anda ingin menyederhanakan prosesnya, NumPy juga menyediakan fungsi bawaan np.polyfit(), yang dapat melakukan regresi linear hanya dengan satu baris kode.
# Example of NumPy's polyfit
np.polyfit(x, y, 1)  # 1 stands for the degree of the polynomial (linear)
Meskipun metode ini berguna untuk memahami matematika di balik regresi linear sederhana, metode ini tidak praktis untuk dataset besar, memiliki presisi numerik yang lebih rendah, dan tidak berlaku untuk masalah regresi berganda.
Cara yang lebih efisien untuk melakukan regresi linear adalah dengan menggunakan statsmodels, pustaka yang menyediakan model statistik dan alat analisis.
Langkah-langkah untuk menyesuaikan model Ordinary Least Squares (OLS) menggunakan Statsmodels:
Siapkan data: Pastikan variabel independen terstruktur dengan benar.
Tambahkan konstanta: Ini merepresentasikan suku intersep dalam persamaan.
Sesuaikan model: Gunakan OLS() dari statsmodels untuk mengestimasi parameter regresi.
Analisis hasil: Fungsi .summary() memberikan wawasan model yang detail, termasuk koefisien, p-value, dan nilai R-squared.
import numpy as np
import statsmodels.api as sm

# Sample data
x = np.array([1, 2, 3, 4, 5])
y = np.array([2, 4, 5, 4, 5])

# Add constant for intercept term
X = sm.add_constant(x)

# Fit OLS model
model = sm.OLS(y, X).fit()

# Print summary
print(model.summary())scikit-learn banyak digunakan karena kesederhanaan, skalabilitas, dan integrasinya dengan alat machine learning lain. Pustaka ini menawarkan cara sederhana dan efisien untuk melakukan regresi linear menggunakan kelas LinearRegression.
Impor pustaka dan muat dataset Anda.
Ubah bentuk variabel prediktor jika diperlukan (untuk regresi satu variabel).
Buat instance model menggunakan LinearRegression().
Latih model pada data pelatihan.
Ambil parameter model: Atribut .coeff_ mengembalikan kemiringan, sedangkan .intercept_ memberikan intersep.
import numpy as np
from sklearn.linear_model import LinearRegression

# Sample data
x = np.array([1, 2, 3, 4, 5]).reshape(-1, 1)  # Reshape for scikit-learn
y = np.array([2, 4, 5, 4, 5])

# Create model instance
model = LinearRegression()

# Fit the model
model.fit(x, y)

# Get model parameters
print(f"Slope (B1): {model.coef_[0]}")
print(f"Intercept (B0): {model.intercept_}")

# Predict values
y_pred = model.predict(x)
print("Predicted values:", y_pred)Selain NumPy, statsmodels, dan scikit-learn, beberapa pustaka Python lain juga menyediakan kemampuan regresi:
Setiap pendekatan memiliki kelebihan. Pilihannya bergantung pada kompleksitas tugas regresi Anda.
Regresi linear dapat menangani hubungan yang sederhana maupun kompleks. Pada bagian ini, kita akan mengeksplorasi cara mengimplementasikan regresi linear dengan satu prediktor (sederhana) dan banyak prediktor (berganda) menggunakan Python.
Untuk regresi linear sederhana di Python, kita mengikuti langkah-langkah berikut:
Koefisien korelasi mengukur kekuatan hubungan antara x dan y. Kita menemukannya menggunakan NumPy:
import numpy as np

# Sample data
x = np.array([1, 2, 3, 4, 5])  # Independent variable
y = np.array([2, 4, 5, 4, 5])  # Dependent variable

correlation = np.corrcoef(x, y)[0, 1]
print("Correlation:", correlation)Kemiringan B1 dihitung sebagai:
beta_1 = correlation * (np.std(y) / np.std(x))Anda mungkin memperhatikan bahwa persamaan ini tampak sedikit berbeda dari yang sebelumnya, saat saya menemukan kemiringan dengan menjumlahkan hasil kali deviasi antara dan y, lalu membaginya dengan jumlah kuadrat deviasi pada . Metode baru ini, menggunakan korelasi dan simpangan baku, mungkin terlihat berbeda tetapi sebenarnya sama. Dengan menuliskan ulang persamaan sebelumnya, kita dapat menyatakan kemiringan sebagai dikalikan rasio simpangan baku dan , sehingga kedua bentuk tersebut setara secara aljabar.
Sekarang, untuk intersep:
beta_0 = np.mean(y) - beta_1 * np.mean(x)Sekarang setelah kita memiliki koefisiennya, kita dapat menemukan nilai prediksi.
y_pred = beta_0 + beta_1 * xMelalui langkah-langkah ini, menurut saya, membantu untuk memahami perhitungan yang mendasarinya sebelum menggunakan pustaka seperti scikit-learn.
Regresi linear berganda memperluas konsep regresi linear sederhana untuk memodelkan hubungan antara variabel dependen dan beberapa variabel independen. Ini memungkinkan kita menganalisis dataset yang lebih kompleks di mana satu prediktor saja tidak cukup menjelaskan variasi pada variabel dependen.
Untuk melakukan regresi linear berganda di Python, kita biasanya menggunakan aljabar matriks untuk menghitung koefisien yang meminimalkan jumlah kuadrat residual. Salah satu rumus yang umum diajarkan untuk menghitung koefisien dalam regresi linear berganda dikenal sebagai persamaan normal:
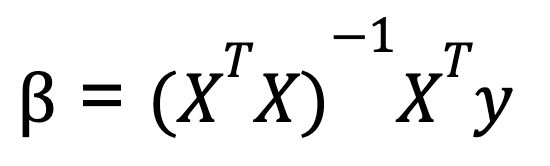
Dengan:
Persamaan ini memberikan nilai optimal untuk koefisien yang meminimalkan jumlah kuadrat galat.
Berikut contoh melakukan regresi linear berganda dengan Python, menggunakan NumPy untuk operasi matriks:
import numpy as np

# Sample data: two predictors and one dependent variable
X = np.array([[1, 1], [1, 2], [2, 2], [2, 3]])  # Independent variables
y = np.array([6, 8, 9, 11])  # Dependent variable

# Add a column of ones to include the intercept in the model
X = np.column_stack((np.ones(X.shape[0]), X))

# Calculate beta coefficients using the normal equation
beta = np.linalg.inv(X.T @ X) @ X.T @ y
print("Coefficients:", beta)
Metode ini bekerja dengan baik ketika para prediktor saling independen, tetapi jika prediktor sangat berkorelasi, inversi matriks menjadi tidak stabil. Karena itu, pustaka seperti scikit-learn menggunakan metode yang lebih stabil secara numerik berdasarkan dekomposisi QR untuk menghitung koefisien regresi. Jadi, meskipun kita bisa menghitung koefisien menggunakan persamaan normal, ketahuilah bahwa saat kita menggunakan fungsi LinearRegression() dari scikitlearn, dekomposisi QR bekerja di balik layar.
Sekarang saat yang tepat untuk menyebutkan satu hal yang sering menjadi perhatian dalam regresi linear berganda di Python. Multikolinearitas terjadi ketika dua atau lebih variabel independen sangat berkorelasi, sehingga sulit untuk mengisolasi pengaruh masing-masing. Ini dapat menyebabkan taksiran koefisien yang tidak stabil. Untuk mendeteksi dan mengurangi multikolinearitas, Anda dapat menghitung variance inflation factor (VIF). Anda juga dapat menghapus variabel yang sangat berkorelasi, atau menggunakan teknik regularisasi seperti ridge regression dan lasso regression.
Setelah membangun model regresi linear, langkah berikutnya adalah mengevaluasi kinerjanya dan memvalidasi bahwa model memenuhi asumsi yang mendasarinya. Ini memastikan keandalan prediksi Anda dan membantu mengidentifikasi potensi perbaikan.
Analisis residual adalah bagian inti dari diagnostik regresi linear. Ini membantu memeriksa asumsi regresi linear dan mengidentifikasi pelanggaran. Residual seharusnya tersebar acak di sekitar nol, tanpa pola yang jelas. Di sinilah alat visual seperti residual plot dan Q-Q plot berperan:
Di Python, kita dapat membuat plot ini dengan mudah menggunakan pustaka matplotlib, seaborn, dan statsmodels.
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
import statsmodels.api as sm

# Sample data and linear regression model
X = np.array([[1, 1], [1, 2], [2, 2], [2, 3]])  # Independent variables
y = np.array([6, 8, 9, 11])  # Dependent variable

# Add an intercept term
X = sm.add_constant(X)

# Fit the linear regression model
model = sm.OLS(y, X).fit()

# Get the residuals
residuals = model.resid

# 1. Residual Plot
plt.figure(figsize=(10, 5))
plt.subplot(1, 2, 1)
plt.scatter(model.fittedvalues, residuals)
plt.axhline(y=0, color='r', linestyle='--')
plt.xlabel('Fitted Values')
plt.ylabel('Residuals')
plt.title('Residual Plot')

# 2. Q-Q Plot
plt.subplot(1, 2, 2)
sm.qqplot(residuals, line ='45', ax=plt.gca())
plt.title('Q-Q Plot')

plt.tight_layout()
plt.show()Selain analisis visual, metrik kuantitatif penting untuk menilai seberapa baik model regresi linear menyesuaikan data. Beberapa metrik evaluasi kunci meliputi:
Metrik-metrik ini dapat dihitung dengan mudah di Python menggunakan statsmodels atau scikit-learn:
from sklearn.metrics import mean_squared_error, mean_absolute_error, r2_score
import numpy as np

# Make predictions using the model
y_pred = model.predict(X)

# R-squared
r_squared = r2_score(y, y_pred)
print("R-squared:", r_squared)

# Adjusted R-squared (calculated manually)
n = len(y)  # number of data points
p = X.shape[1] - 1  # number of predictors (excluding intercept)
adj_r_squared = 1 - (1 - r_squared) * (n - 1) / (n - p - 1)
print("Adjusted R-squared:", adj_r_squared)

# RMSE
rmse = np.sqrt(mean_squared_error(y, y_pred))
print("Root Mean Squared Error (RMSE):", rmse)

# MAE
mae = mean_absolute_error(y, y_pred)
print("Mean Absolute Error (MAE):", mae)
Dengan mengevaluasi metrik-metrik ini, Anda memperoleh wawasan tentang akurasi model, goodness of fit, dan seberapa baik model menggeneralisasi ke data baru.
Setelah Anda mengevaluasi model regresi linear, langkah berikutnya adalah mengeksplorasi cara untuk meningkatkan kinerjanya. Salah satu pendekatan umum adalah melalui transformasi fitur, yang dapat mengatasi hubungan non-linear dan membantu model menangkap pola mendasar dalam data dengan lebih baik.
Ingat bahwa, dalam regresi linear, model mengasumsikan hubungan linear antara variabel independen (prediktor) dan variabel dependen. Namun, banyak dataset dunia nyata memiliki hubungan non-linear yang mungkin tidak tertangkap dengan baik oleh model linear sederhana. Dengan menerapkan transformasi fitur, seperti transformasi logaritmik atau akar kuadrat, Anda terkadang dapat meningkatkan kinerja model.
Ini sering digunakan ketika sebuah fitur menunjukkan pertumbuhan eksponensial atau memiliki nilai positif yang besar. Misalnya, mentransformasikan data pendapatan yang sangat miring (di mana beberapa nilai pendapatan sangat tinggi mendominasi) dapat membuat distribusi lebih mendekati normal.
import numpy as np
df['log_income'] = np.log(df['income'] + 1) # +1 to avoid log(0)Ini berguna untuk fitur yang mengikuti hubungan kuadratik. Misalnya, fitur yang merepresentasikan hitungan (seperti jumlah kunjungan ke sebuah situs web) dapat memperoleh manfaat dari transformasi akar kuadrat.
df['sqrt_visits'] = np.sqrt(df['visits'])Dengan mentransformasikan fitur-fitur ini, Anda membantu model menangkap hubungan yang sebelumnya terlewat oleh pendekatan linear. Kuncinya adalah menguji berbagai transformasi dan mengamati dampaknya pada kinerja model. Tidak ada pendekatan yang serba cocok, dan ini memerlukan pengujian empiris.
Selain transformasi fitur, penting juga untuk memahami dampak normalisasi dan standardisasi pada model regresi Anda, terutama saat Anda berhadapan dengan fitur yang memiliki satuan atau skala berbeda. Normalisasi menskalakan ulang nilai fitur ke suatu rentang, biasanya [0, 1]. Standardisasi menskalakan ulang fitur agar memiliki mean 0 dan simpangan baku 1.
Saat Anda memiliki beberapa prediktor, menormalisasi atau menstandardisasi data membantu menginterpretasikan koefisien secara lebih bermakna. Artinya, ha ini membantu menunjukkan seberapa besar setiap variabel prediktor berkontribusi terhadap variabel dependen relatif terhadap prediktor lainnya. Ini sangat berguna ketika prediktor berada pada skala yang berbeda.
Mengembangkan pemahaman yang kuat tentang regresi linear memerlukan latihan dan eksplorasi yang berkelanjutan. Untuk memperdalam pengetahuan Anda, pertimbangkan untuk mempelajari lebih lanjut tentang penanganan multikolinearitas, heteroskedastisitas, dan teknik regularisasi seperti regresi Ridge dan Lasso. Memperkuat pemahaman Anda tentang dekomposisi QR dan variance inflation factor juga dapat meningkatkan diagnostik model. Selain itu, memahami normalisasi vs. standardisasi dapat memperbaiki keputusan penskalaan fitur.
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt