Last chance! 50% off DataCamp Premium
Sale ends in
NumPy, statsmodels ve scikit-learn gibi zengin kütüphane ekosistemiyle Python, veri bilimciler için başvurulan dil haline geldi. Kullanım kolaylığı ve çok yönlülüğü, doğrusal regresyonun kuramsal temellerini anlamak ve bunu gerçek dünyada uygulamak için idealdir.
Bu rehberde, Python’da doğrusal regresyon hakkında bilmeniz gereken her şeyi adım adım anlatacağım. Doğrusal regresyonun ne olduğunu ve neden bu kadar önemli olduğunu tanımlayarak başlayacağız. Ardından, işleyişine bakıp temel denklemleri ve varsayımları inceleyeceğiz. Doğrusal regresyonu çeşitli Python kütüphaneleriyle nasıl uygulayacağınızı öğreneceksiniz: NumPy ile elle hesaplamalardan scikit-learn ile yalın uygulamalara kadar. Basit ve çoklu doğrusal regresyonu ele alacağız; modellerinizi nasıl değerlendirip performanslarını nasıl artıracağınızı göstereceğim.
Doğrusal regresyon, bağımlı değişken (hedef) ile bir veya daha fazla bağımsız değişken (yordayıcı) arasındaki ilişkiyi modellemek için kullanılan istatistiksel bir yöntemdir. Amaç, bu ilişkiyi en iyi tanımlayan doğrusal bir denklem bulmaktır.
Doğrusal regresyon, öngörüsel modelleme, çıkarımsal istatistik ve verilerdeki ilişkileri anlamak için yaygın olarak kullanılır. Uygulama alanları arasında satış tahmini, risk değerlendirme ve farklı değişkenlerin hedef sonuç üzerindeki etkisinin analiz edilmesi yer alır.
Basit doğrusal regresyonda bu ilişki iki boyutlu uzayda bir doğru ile ifade edilir; çoklu doğrusal regresyonda (iki bağımsız değişkenle) ilişki üç boyutlu uzayda bir düzlemle gösterilir; daha fazla bağımsız değişkende denklem, daha yüksek boyutlu uzayda bir hiper düzlemi tanımlar.
Bir basit doğrusal regresyon modeliyle başlayalım; bahsettiğim gibi yalnızca bir yordayıcı değişkeni vardır. Şu denklemle gösterilir:
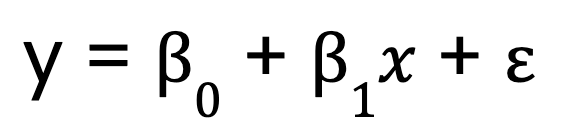
Burada:
Buna karşılık, çoklu doğrusal regresyon bu kavramı birden fazla yordayıcı değişkeni kapsayacak şekilde genişletir:
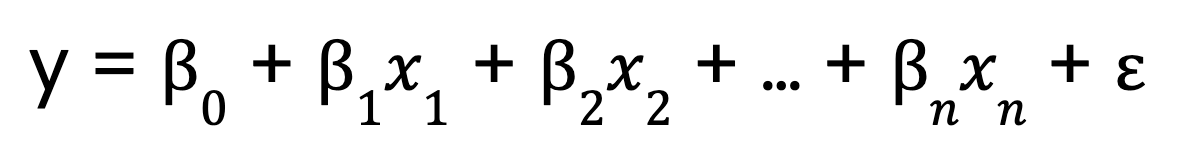
Burada:
Doğrusal regresyonun nasıl çalıştığını anlamak için temel bileşenlerini parçalayalım.
Yukarıda, tek ve çoklu yordayıcılar için doğrusal regresyon denklemlerini gördük. Şimdi bu denklemlerin önemli bir yönünden bahsedeyim.
Doğrusal regresyondaki doğrusal terimi, verinin şeklini değil, modelin işlevsel formunu ifade eder. Özellikle şu anlama gelir:
En iyi uyumlu doğruyu belirlemek için doğrusal regresyon en küçük kareler (OLS) yöntemini kullanır. OLS, kareler toplamı hataları en aza indirir:
OLS, kareler toplamı hataları en aza indirir:
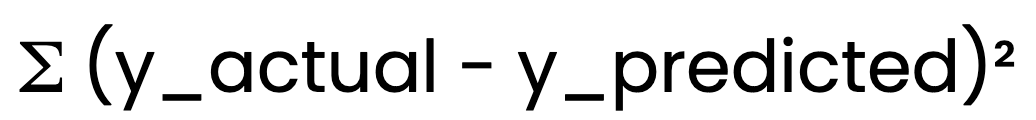
Bu, modelin B0 ve B1 için mümkün olan en iyi tahminleri sağlamasını güvence altına alır.
Doğrusal regresyonun güvenilir sonuçlar üretmesi için belirli varsayımların karşılanması gerekir:
Bu varsayımları doğrulamak, modelimizin hem güvenilir hem geçerli olmasını sağlar. Örneğin, değişkenler arasındaki ilişki doğrusal değilse modelin tahminleri hatalı olabilir. Heteroskedastisite varsa güven aralıkları yanlış olabilir.
Doğrusal regresyon Python’da farklı yaklaşımlarla uygulanabilir. Üç yaygın yöntemi adım adım anlatacağım: NumPy ile elle hesaplama, statsmodels ile ayrıntılı istatistiksel modelleme ve scikit-learn ile yalın makine öğrenimi.
Basit doğrusal regresyon (tek yordayıcı) için regresyon parametrelerini NumPy kullanarak elle hesaplayabilirsiniz. Bu, önce bağımsız ve bağımlı değişkenlerin ortalamasını hesaplamayı içerir. Ardından eğimi (B0) hesaplarız:
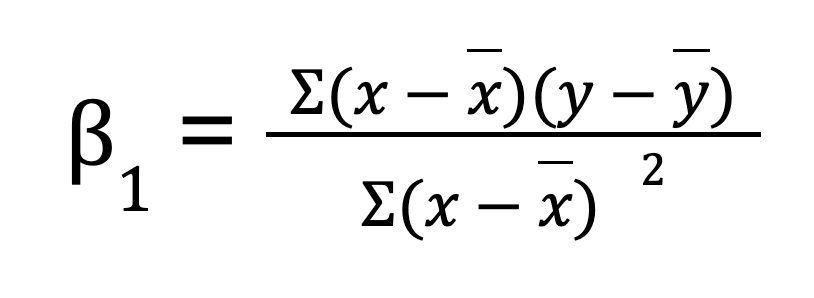
Eğimi bulduktan sonra kesişimi (B1) belirleyebiliriz:
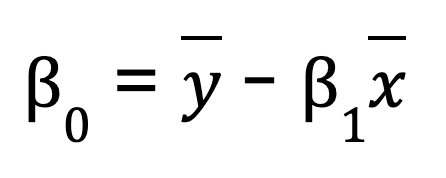
import numpy as np

# Sample data
x = np.array([1, 2, 3, 4, 5])
y = np.array([2, 4, 5, 4, 5])

# Compute means
x_mean = np.mean(x)
y_mean = np.mean(y)

# Compute slope (B1)
B1 = np.sum((x - x_mean) * (y - y_mean)) / np.sum((x - x_mean) ** 2)

# Compute intercept (B0)
B0 = y_mean - B1 * x_mean

print(f"Slope (B1): {B1}")
print(f"Intercept (B0): {B0}")

# Predicting values
y_pred = B0 + B1 * x
print("Predicted values:", y_pred)
Süreci basitleştirmek ilgilinizi çekiyorsa, NumPy tek satırda doğrusal regresyon yapabilen yerleşik np.polyfit() işlevini de sağlar.
# Example of NumPy's polyfit
np.polyfit(x, y, 1)  # 1 stands for the degree of the polynomial (linear)
Bu yöntem, basit doğrusal regresyonun arkasındaki matematiği anlamak için yararlı olsa da büyük veri setleri için pratik değildir, sayısal kesinliği daha düşüktür ve çoklu regresyon problemlerinde çalışmaz.
Doğrusal regresyonu gerçekleştirmenin daha verimli bir yolu, istatistiksel modeller ve analiz araçları sunan statsmodels kütüphanesini kullanmaktır.
En Küçük Kareler (OLS) modelini Statsmodels ile uydurma adımları:
Veriyi hazırlayın: Bağımsız değişkenin uygun şekilde yapılandırıldığından emin olun.
Sabit terim ekleyin: Denklemin kesişim terimini hesaba katar.
Modeli uydurun: Regresyon parametrelerini tahmin etmek için statsmodels içindeki OLS()’yi kullanın.
Sonuçları analiz edin: .summary() işlevi, katsayılar, p-değerleri ve R-kare değerleri dahil ayrıntılı içgörüler sunar.
import numpy as np
import statsmodels.api as sm

# Sample data
x = np.array([1, 2, 3, 4, 5])
y = np.array([2, 4, 5, 4, 5])

# Add constant for intercept term
X = sm.add_constant(x)

# Fit OLS model
model = sm.OLS(y, X).fit()

# Print summary
print(model.summary())scikit-learn sadeliği, ölçeklenebilirliği ve diğer makine öğrenimi araçlarıyla entegrasyonu nedeniyle yaygın olarak kullanılır. LinearRegression sınıfıyla doğrusal regresyonu basit ve verimli bir şekilde sunar.
Kütüphaneyi içe aktarın ve veri setinizi yükleyin.
Yordayıcı değişkeni yeniden şekillendirin (gerekirse, tek değişkenli regresyon için).
Bir model örneği oluşturun: LinearRegression() kullanın.
Modeli uydurun: Eğitim verisine uyarlayın.
Model parametrelerini alın: .coeff_ eğimi, .intercept_ ise kesişimi verir.
import numpy as np
from sklearn.linear_model import LinearRegression

# Sample data
x = np.array([1, 2, 3, 4, 5]).reshape(-1, 1)  # Reshape for scikit-learn
y = np.array([2, 4, 5, 4, 5])

# Create model instance
model = LinearRegression()

# Fit the model
model.fit(x, y)

# Get model parameters
print(f"Slope (B1): {model.coef_[0]}")
print(f"Intercept (B0): {model.intercept_}")

# Predict values
y_pred = model.predict(x)
print("Predicted values:", y_pred)NumPy, statsmodels ve scikit-learn’in ötesinde, çeşitli Python kütüphaneleri regresyon yetenekleri sunar:
Her yaklaşımın avantajları vardır. Regresyon görevinizin karmaşıklığına bağlıdır.
Doğrusal regresyon hem basit hem de karmaşık ilişkileri ele alabilir. Bu bölümde, Python kullanarak tek yordayıcıyla (basit) ve birden fazla yordayıcıyla (çoklu) doğrusal regresyonun nasıl uygulanacağını inceleyeceğiz.
Python’da basit doğrusal regresyon için şu adımları izleriz:
Korelasyon katsayısı, x ile y arasındaki ilişkinin gücünü ölçer. NumPy kullanarak buluruz:
import numpy as np

# Sample data
x = np.array([1, 2, 3, 4, 5])  # Independent variable
y = np.array([2, 4, 5, 4, 5])  # Dependent variable

correlation = np.corrcoef(x, y)[0, 1]
print("Correlation:", correlation)Eğim B1 şöyle hesaplanır:
beta_1 = correlation * (np.std(y) / np.std(x))Bu denklemin, daha önce ve y arasındaki sapmaların çarpımlarını toplayıp ’teki kareler toplamına böldüğüm önceki ifadeden biraz farklı göründüğünü fark edebilirsiniz. Korelasyon ve standart sapma kullanan bu yeni yöntem farklı gibi görünse de aslında aynıdır. Önceki denklemi yeniden yazarak, eğimi, ’nin ve ’in standart sapmalarının oranıyla çarpımı olarak ifade edebiliriz; böylece iki form cebirsel olarak eşdeğerdir.
Şimdi kesişim için:
beta_0 = np.mean(y) - beta_1 * np.mean(x)Artık katsayılara sahip olduğumuza göre, tahmin edilen değerleri bulabiliriz.
y_pred = beta_0 + beta_1 * xBu adımlardan geçmenin, scikit-learn gibi kütüphaneleri kullanmadan önce alttaki hesaplamaları anlamak açısından yararlı olduğunu düşünüyorum.
Çoklu doğrusal regresyon, basit doğrusal regresyonun kavramını genişleterek bağımlı değişken ile birden fazla bağımsız değişken arasındaki ilişkileri modellemeye olanak tanır. Bu, tek bir yordayıcının bağımlı değişkendeki değişimi yeterince açıklamadığı daha karmaşık veri setlerini analiz etmemizi sağlar.
Python’da çoklu doğrusal regresyon yapmak için genellikle artıklar kareler toplamını en aza indiren katsayıları hesaplamak üzere matris cebiri kullanırız. Çoklu doğrusal regresyonda katsayıları hesaplamak için sık öğretilen formüllerden biri normal denklem olarak bilinir:
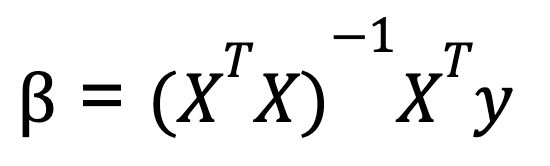
Burada:
Bu denklem, kareler toplamı hataları en aza indiren katsayıların en uygun değerlerini verir.
İşte matris işlemleri için NumPy kullanarak Python’da çoklu doğrusal regresyon örneği:
import numpy as np

# Sample data: two predictors and one dependent variable
X = np.array([[1, 1], [1, 2], [2, 2], [2, 3]])  # Independent variables
y = np.array([6, 8, 9, 11])  # Dependent variable

# Add a column of ones to include the intercept in the model
X = np.column_stack((np.ones(X.shape[0]), X))

# Calculate beta coefficients using the normal equation
beta = np.linalg.inv(X.T @ X) @ X.T @ y
print("Coefficients:", beta)
Bu yöntem, yordayıcılar bağımsız olduğunda iyi çalışır; ancak yordayıcılar yüksek derecede ilişkiliyse matris terslemesi kararsız hale gelir. Bu nedenle, scikit-learn gibi kütüphaneler, regresyon katsayılarını hesaplamak için QR ayrışımına dayalı daha sayısal olarak kararlı bir yöntemi kullanır; dolayısıyla katsayıları normal denklemle hesaplayabilsek de scikitlearn içinden LinearRegression() işlevini kullandığımızda, arka planda QR ayrışımı çalıştığını bilin.
Şimdi, Python’da çoklu doğrusal regresyonda endişe kaynağı olarak ortaya çıkan bir konusundan bahsetmek için iyi bir zaman. Çoklu doğrusal bağlantı, iki veya daha fazla bağımsız değişken yüksek düzeyde ilişkili olduğunda ortaya çıkar ve bireysel etkilerini izole etmeyi zorlaştırır. Bu durum, katsayı tahminlerinin kararsız olmasına yol açabilir. Çoklu doğrusal bağlantıyı tespit etmek ve azaltmak için varyans şişirme faktörünü (VIF) hesaplayabilirsiniz. Ayrıca yüksek korelasyonlu değişkenleri kaldırabilir ya da ridge ve lasso regresyonu gibi düzenlileştirme tekniklerini kullanabilirsiniz.
Doğrusal regresyon modelinizi oluşturduktan sonra, bir sonraki adım performansını değerlendirmek ve temel varsayımları karşıladığını doğrulamaktır. Bu, tahminlerinizin güvenilirliğini sağlar ve olası iyileştirmeleri belirlemenize yardımcı olur.
Artık analizi, doğrusal regresyon teşhislerinin temel bir parçasıdır. Doğrusal regresyon varsayımlarını kontrol etmeye ve ihlalleri belirlemeye yardımcı olur. Artıkların sıfır etrafında rastgele dağılması ve belirgin bir desen göstermemesi gerekir. İşte burada artık grafikleri ve Q-Q grafikleri gibi görsel araçlar devreye girer:
Python’da bu grafikleri matplotlib, seaborn ve statsmodels gibi kütüphanelerle kolayca oluşturabiliriz.
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
import statsmodels.api as sm

# Sample data and linear regression model
X = np.array([[1, 1], [1, 2], [2, 2], [2, 3]])  # Independent variables
y = np.array([6, 8, 9, 11])  # Dependent variable

# Add an intercept term
X = sm.add_constant(X)

# Fit the linear regression model
model = sm.OLS(y, X).fit()

# Get the residuals
residuals = model.resid

# 1. Residual Plot
plt.figure(figsize=(10, 5))
plt.subplot(1, 2, 1)
plt.scatter(model.fittedvalues, residuals)
plt.axhline(y=0, color='r', linestyle='--')
plt.xlabel('Fitted Values')
plt.ylabel('Residuals')
plt.title('Residual Plot')

# 2. Q-Q Plot
plt.subplot(1, 2, 2)
sm.qqplot(residuals, line ='45', ax=plt.gca())
plt.title('Q-Q Plot')

plt.tight_layout()
plt.show()Görsel analizin yanı sıra, doğrusal regresyon modelinin veriye ne kadar iyi uyduğunu değerlendirmek için nicel metrikler de gereklidir. Önemli değerlendirme metriklerinden bazıları şunlardır:
Bu metrikler, statsmodels veya scikit-learn kullanılarak Python’da kolayca hesaplanabilir:
from sklearn.metrics import mean_squared_error, mean_absolute_error, r2_score
import numpy as np

# Make predictions using the model
y_pred = model.predict(X)

# R-squared
y_squared = r2_score(y, y_pred)
print("R-squared:", r_squared)

# Adjusted R-squared (calculated manually)
n = len(y)  # number of data points
p = X.shape[1] - 1  # number of predictors (excluding intercept)
adj_r_squared = 1 - (1 - r_squared) * (n - 1) / (n - p - 1)
print("Adjusted R-squared:", adj_r_squared)

# RMSE
rmse = np.sqrt(mean_squared_error(y, y_pred))
print("Root Mean Squared Error (RMSE):", rmse)

# MAE
mae = mean_absolute_error(y, y_pred)
print("Mean Absolute Error (MAE):", mae)
Bu metrikleri değerlendirerek modelin doğruluğu, uyum iyiliği ve yeni verilere ne kadar iyi genellendiği hakkında içgörü elde edersiniz.
Doğrusal regresyon modelinizi değerlendirdikten sonra, performansını artırmanın yollarını keşfetme zamanı gelir. Yaygın yaklaşımlardan biri, özellik dönüşümleridir; bu sayede doğrusal olmayan ilişkiler ele alınabilir ve modelin verideki alttaki desenleri daha iyi yakalaması sağlanabilir.
Unutmayın, doğrusal regresyonda model, bağımsız değişkenler (yordayıcılar) ile bağımlı değişken arasında doğrusal bir ilişki varsayar. Ancak birçok gerçek dünya veri setinde basit bir doğrusal modelin iyi yakalayamayacağı doğrusal olmayan ilişkiler bulunur. Logaritmik veya karekök gibi özellik dönüşümleri uygulayarak bazen modelin performansını iyileştirebilirsiniz.
Bu, bir özelliğin üstel büyüme sergilediği veya büyük pozitif değerlere sahip olduğu durumlarda sık kullanılır. Örneğin, (birkaç çok yüksek gelir değerinin baskın olduğu) yüksek çarpıklığa sahip gelir verisini dönüştürmek dağılımı daha normal hale getirebilir.
import numpy as np
df['log_income'] = np.log(df['income'] + 1) # +1 to avoid log(0)Kare ilişkisi izleyen özellikler için kullanışlıdır. Örneğin, (bir web sitesine ziyaret sayısı gibi) sayımları temsil eden bir özellik karekök dönüşümünden fayda görebilir.
df['sqrt_visits'] = np.sqrt(df['visits'])Bu özellikleri dönüştürerek modelin, doğrusal yaklaşımın önce kaçırdığı ilişkileri daha iyi yakalamasına yardımcı olursunuz. Anahtar nokta, farklı dönüşümleri denemek ve model performansı üzerindeki etkisini gözlemlemektir. Tek tip bir çözüm yoktur ve ampirik test gerektirir.
Özellik dönüşümlerine ek olarak, özellikle farklı birim veya ölçeklere sahip özelliklerle uğraşırken, regresyon modeliniz üzerindeki normalizasyon ve standardizasyon etkisini anlamak da önemlidir. Normalizasyon, özellik değerlerini tipik olarak [0, 1] aralığına yeniden ölçeklendirir. Standardizasyon ise özellikleri ortalaması 0 ve standart sapması 1 olacak şekilde yeniden ölçeklendirir.
Birden fazla yordayıcı olduğunda veriyi normalize etmek veya standardize etmek, katsayıları daha anlamlı şekilde yorumlamaya yardımcı olur. Yani, her yordayıcı değişkenin diğer yordayıcılara göre bağımlı değişkene ne kadar katkıda bulunduğunu göstermeye yardımcı olur. Bu, yordayıcıların farklı ölçeklerde olduğu durumlarda özellikle yararlıdır.
Doğrusal regresyonu güçlü şekilde kavramak, sürekli pratik ve keşif gerektirir. Bilginizi derinleştirmek için çoklu doğrusal bağlantının ele alınması, heteroskedastisite ve Ridge ve Lasso regresyonu gibi düzenlileştirme teknikleri hakkında daha fazla öğrenmeyi düşünün. QR ayrışımı ve varyans şişirme faktörüne hakimiyetinizi güçlendirmek de model teşhislerini iyileştirebilir. Ayrıca, normalizasyon ve standardizasyon arasındaki farkı anlamak, özellik ölçeklendirme kararlarını geliştirebilir.
{count, plural, one {blog} other {blog}}
Dario Radečić
15 dk.
{count, plural, one {blog} other {blog}}
Abid Ali Awan
14 dk.
{count, plural, one {Eğitim} other {Eğitim}}
Adel Nehme
{count, plural, one {Eğitim} other {Eğitim}}
Kurtis Pykes
8 dk.