Last chance! 50% off DataCamp Premium
Sale ends in
Python, अपनी समृद्ध लाइब्रेरी इकोसिस्टम—जैसे NumPy, statsmodels और scikit-learn—की बदौलत डेटा वैज्ञानिकों की पसंदीदा भाषा बन गया है। इसकी सहजता और बहुमुखी प्रतिभा इसे linear regression के सैद्धांतिक आधारों को समझने और वास्तविक दुनिया की स्थितियों में उसे लागू करने—दोनों के लिए उपयुक्त बनाती है।
इस गाइड में, मैं आपको Python में linear regression से संबंधित हर जरूरी बात से परिचित कराऊंगा। हम शुरुआत करेंगे—linear regression क्या है और यह इतना महत्वपूर्ण क्यों है। फिर, हम इसकी कार्यप्रणाली देखेंगे—आधारभूत समीकरणों और मान्यताओं को समझते हुए। आप जानेंगे कि विभिन्न Python लाइब्रेरीज़ से linear regression कैसे किया जाता है—NumPy के साथ मैनुअल गणना से लेकर scikit-learn के साथ सुव्यवस्थित इम्प्लीमेंटेशन तक। हम simple और multiple दोनों linear regression कवर करेंगे, और मैं आपको दिखाऊंगा कि अपने मॉडलों का मूल्यांकन कैसे करें और उनका प्रदर्शन कैसे बेहतर बनाएं।
Linear regression एक सांख्यिकीय विधि है, जिसका उपयोग आश्रित चर (target) और एक या अधिक स्वतंत्र चरों (predictors) के बीच संबंध को मॉडल करने के लिए किया जाता है। उद्देश्य यह है कि एक रैखिक समीकरण खोजा जाए जो इस संबंध का सर्वोत्तम वर्णन करे।
Linear regression का व्यापक उपयोग predictive modeling, inferential statistics, और डेटा में अंतर्संबंधों को समझने के लिए होता है। इसके अनुप्रयोगों में बिक्री का पूर्वानुमान लगाना, जोखिम का आकलन करना, और लक्ष्य परिणाम पर विभिन्न चरों के प्रभाव का विश्लेषण करना शामिल है।
Simple linear regression के लिए, यह द्वि-आयामी स्थान में एक रेखा के रूप में होता है; multiple linear regression (दो स्वतंत्र चर के साथ) के लिए, संबंध त्रि-आयामी स्थान में एक समतल से दर्शाया जाता है; और अधिक स्वतंत्र चरों के लिए, समीकरण उच्च-आयामी स्थान में एक hyperplane का वर्णन करता है।
आइए simple linear regression मॉडल से शुरू करें, जिसमें, जैसा कि मैंने बताया, केवल एक predictor वेरिएबल होता है। इसे इस समीकरण से दर्शाया जाता है:
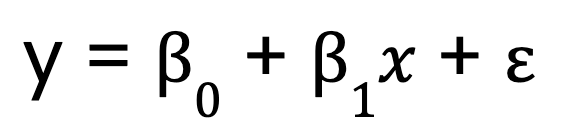
जहाँ:
इसके विपरीत, multiple linear regression इस अवधारणा को कई predictor वेरिएबल्स तक विस्तारित करता है:
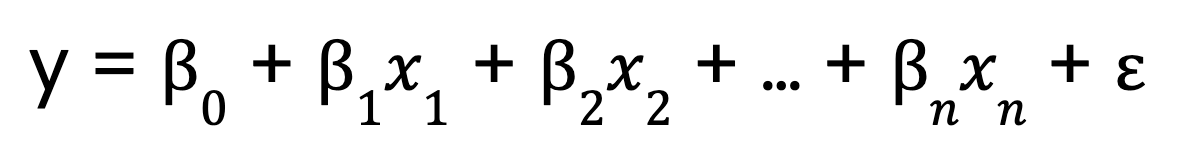
जहाँ:
यह समझने के लिए कि linear regression कैसे काम करता है, इसके प्रमुख घटकों को विभाजित करके देखते हैं।
हमने ऊपर, एकल और बहु predictor के साथ, linear regression की समीकरणें देखीं। अब, मैं इन समीकरणों के एक महत्वपूर्ण पहलू पर बात करना चाहता हूँ।
Linear शब्द, linear regression में, मॉडल के प्रकार्यात्मक रूप को संदर्भित करता है, जरूरी नहीं कि डेटा के आकार को। विशेष रूप से, इसका अर्थ है कि:
सर्वोत्तम-फिटिंग रेखा निर्धारित करने के लिए, linear regression ordinary least squares (OLS) विधि का उपयोग करता है। OLS वर्ग त्रुटि योग को न्यूनतम करता है:
OLS वर्ग त्रुटि योग को न्यूनतम करता है:
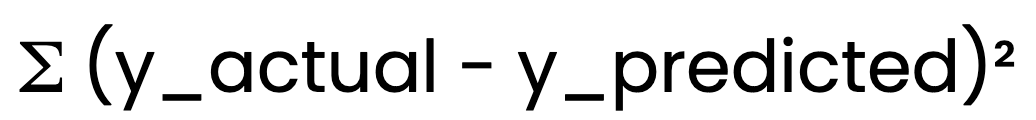
यह सुनिश्चित करता है कि मॉडल B0 और B1 के सर्वोत्तम संभव आकलन देता है।
विश्वसनीय परिणामों के लिए linear regression में कुछ मान्यताओं का पूरा होना आवश्यक है:
इन मान्यताओं का सत्यापन हमारे मॉडल को विश्वसनीय और मान्य बनाता है। उदाहरण के लिए, यदि चरों के बीच संबंध रैखिक नहीं है, तो मॉडल की भविष्यवाणियाँ गलत हो सकती हैं। यदि heteroscedasticity है, तो confidence intervals गलत हो सकते हैं।
Python में linear regression कई तरीकों से लागू किया जा सकता है। मैं आपको तीन सामान्य विधियों से ले चलूँगा: NumPy के साथ मैनुअल गणना, statsmodels के साथ विस्तृत सांख्यिकीय मॉडलिंग, और scikit-learn के साथ सुव्यवस्थित मशीन लर्निंग।
Simple linear regression (एक predictor वेरिएबल) के लिए, आप NumPy का उपयोग करके regression पैरामीटर्स को मैनुअल रूप से निकाल सकते हैं। इसमें पहले स्वतंत्र और आश्रित चरों का औसत निकालना शामिल है। फिर हम ढलान (B0) की गणना करते हैं:
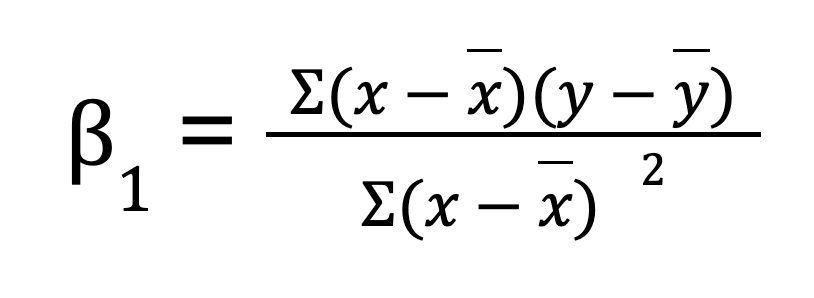
एक बार ढलान मिलने पर, हम इंटरसेप्ट (B1) निर्धारित कर सकते हैं:
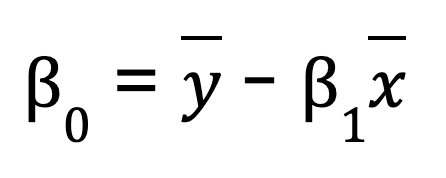
import numpy as np

# Sample data
x = np.array([1, 2, 3, 4, 5])
y = np.array([2, 4, 5, 4, 5])

# Compute means
x_mean = np.mean(x)
y_mean = np.mean(y)

# Compute slope (B1)
B1 = np.sum((x - x_mean) * (y - y_mean)) / np.sum((x - x_mean) ** 2)

# Compute intercept (B0)
B0 = y_mean - B1 * x_mean

print(f"Slope (B1): {B1}")
print(f"Intercept (B0): {B0}")

# Predicting values
y_pred = B0 + B1 * x
print("Predicted values:", y_pred)
यदि आप प्रक्रिया को सरल बनाना चाहते हैं, तो NumPy एक built-in फ़ंक्शन np.polyfit() भी प्रदान करता है, जो केवल एक पंक्ति के कोड में linear regression कर सकता है।
# Example of NumPy's polyfit
np.polyfit(x, y, 1)  # 1 stands for the degree of the polynomial (linear)
यह तरीका simple linear regression के पीछे के गणित को समझने में उपयोगी है, लेकिन बड़े डेटासेट्स के लिए अव्यावहारिक, कम संख्यात्मक-सटीक, और multiple regression समस्याओं के लिए उपयुक्त नहीं है।
Linear regression करने का एक अधिक सक्षम तरीका statsmodels का उपयोग है, जो सांख्यिकीय मॉडल और विश्लेषण उपकरण प्रदान करती है।
Statsmodels के साथ Ordinary Least Squares (OLS) मॉडल फिट करने के चरण:
डेटा तैयार करें: सुनिश्चित करें कि स्वतंत्र चर उचित रूप से संरचित हो।
Constant जोड़ें: यह समीकरण में इंटरसेप्ट पद का हिसाब रखता है।
मॉडल फिट करें: statsmodels से OLS() का उपयोग कर regression पैरामीटर्स का अनुमान लगाएँ।
परिणामों का विश्लेषण करें: .summary() फ़ंक्शन विस्तृत अंतर्दृष्टि देता है, जिनमें गुणांक, p-values, और R-squared शामिल हैं।
import numpy as np
import statsmodels.api as sm

# Sample data
x = np.array([1, 2, 3, 4, 5])
y = np.array([2, 4, 5, 4, 5])

# Add constant for intercept term
X = sm.add_constant(x)

# Fit OLS model
model = sm.OLS(y, X).fit()

# Print summary
print(model.summary())scikit-learn अपनी सरलता, स्केलेबिलिटी, और अन्य ML टूल्स के साथ इंटीग्रेशन के कारण व्यापक रूप से उपयोग होती है। यह LinearRegression क्लास का उपयोग कर linear regression करने का सरल और कुशल तरीका प्रदान करती है।
लाइब्रेरी इम्पोर्ट करें और अपना डेटासेट लोड करें।
Predictor वेरिएबल को reshape करें यदि आवश्यक हो (single-variable regression के लिए)।
मॉडल इंस्टेंस बनाएँ LinearRegression() का उपयोग करके।
मॉडल फिट करें प्रशिक्षण डेटा पर।
मॉडल पैरामीटर्स प्राप्त करें: .coeff_ ढलान देता है, जबकि .intercept_ इंटरसेप्ट देता है।
import numpy as np
from sklearn.linear_model import LinearRegression

# Sample data
x = np.array([1, 2, 3, 4, 5]).reshape(-1, 1)  # Reshape for scikit-learn
y = np.array([2, 4, 5, 4, 5])

# Create model instance
model = LinearRegression()

# Fit the model
model.fit(x, y)

# Get model parameters
print(f"Slope (B1): {model.coef_[0]}")
print(f"Intercept (B0): {model.intercept_}")

# Predict values
y_pred = model.predict(x)
print("Predicted values:", y_pred)NumPy, statsmodels, और scikit-learn से आगे, कई अन्य Python लाइब्रेरीज़ भी regression की क्षमता प्रदान करती हैं:
हर दृष्टिकोण के अपने फायदे हैं। यह आपके regression कार्य की जटिलता पर निर्भर करता है।
Linear regression सरल और जटिल दोनों प्रकार के संबंधों को संभाल सकता है। इस खंड में, हम Python का उपयोग करके एक predictor (simple) और कई predictors (multiple) के साथ linear regression को लागू करना सीखेंगे।
Python में simple linear regression के लिए, हम निम्न चरणों का पालन करते हैं:
Correlation coefficient, x और y के बीच संबंध की ताकत मापता है। हम इसे NumPy से निकालते हैं:
import numpy as np

# Sample data
x = np.array([1, 2, 3, 4, 5])  # Independent variable
y = np.array([2, 4, 5, 4, 5])  # Dependent variable

correlation = np.corrcoef(x, y)[0, 1]
print("Correlation:", correlation)ढलान B1 इस प्रकार निकाला जाता है:
beta_1 = correlation * (np.std(y) / np.std(x))आप देख सकते हैं कि यह समीकरण पहले वाले से थोड़ा भिन्न दिखता है, जहाँ मैंने ढलान को और y के विचलनों के गुणन के योग को जोड़कर, फिर में वर्ग-विचलनों के योग से भाग देकर पाया था। यह नया तरीका—correlation और standard deviation का उपयोग—अलग प्रतीत हो सकता है, पर वास्तव में वही है। पहले के समीकरण को पुनर्लेखित करके, हम ढलान को के रूप में, और के standard deviations के अनुपात से गुणा कर व्यक्त कर सकते हैं, जिससे दोनों रूप बीजगणितीय रूप से समतुल्य हो जाते हैं।
अब, इंटरसेप्ट के लिए:
beta_0 = np.mean(y) - beta_1 * np.mean(x)अब जबकि हमारे पास गुणांक हैं, हम अनुमानित मान निकाल सकते हैं।
y_pred = beta_0 + beta_1 * xइन चरणों से गुजरना, मेरी राय में, scikit-learn जैसी लाइब्रेरी का उपयोग करने से पहले अंतर्निहित गणनाओं को समझने में सहायक होता है।
Multiple linear regression, simple linear regression की अवधारणा को इस तरह विस्तृत करता है कि आश्रित चर और कई स्वतंत्र चरों के बीच संबंध मॉडल किया जा सके। यह हमें अधिक जटिल डेटा सेट्स का विश्लेषण करने देता है, जहाँ अकेला एक predictor आश्रित चर में भिन्नता को पर्याप्त रूप से नहीं समझा पाता।
Python में multiple linear regression करने के लिए, हम आम तौर पर मैट्रिक्स बीजगणित का उपयोग करके उन गुणांकों की गणना करते हैं जो residual sum of squares को न्यूनतम करें। कई बार पढ़ाया जाने वाला एक सूत्र, multiple linear regression के गुणांकों की गणना के लिए, normal equation कहलाता है:
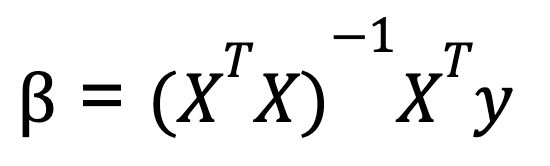
जहाँ:
यह समीकरण उन गुणांकों के इष्टतम मान देता है जो वर्ग त्रुटि योग को न्यूनतम करते हैं।
यहाँ Python में, मैट्रिक्स ऑपरेशंस के लिए NumPy का उपयोग करते हुए, multiple linear regression करने का एक उदाहरण है:
import numpy as np

# Sample data: two predictors and one dependent variable
X = np.array([[1, 1], [1, 2], [2, 2], [2, 3]])  # Independent variables
y = np.array([6, 8, 9, 11])  # Dependent variable

# Add a column of ones to include the intercept in the model
X = np.column_stack((np.ones(X.shape[0]), X))

# Calculate beta coefficients using the normal equation
beta = np.linalg.inv(X.T @ X) @ X.T @ y
print("Coefficients:", beta)
यह विधि तब अच्छी तरह काम करती है जब predictors स्वतंत्र हों, लेकिन जब predictors में उच्च सहसंबंध होता है, तो मैट्रिक्स इनवर्ज़न अस्थिर हो जाता है। इसी कारण, scikit-learn जैसी लाइब्रेरीज़, अधिक संख्यात्मक रूप से स्थिर विधि—QR decomposition—का उपयोग करती हैं ताकि regression गुणांक निकाले जा सकें। इसलिए, यद्यपि हम normal equation से गुणांक निकाल सकते हैं, यह जान लें कि जब हम scikitlearn की LinearRegression() फ़ंक्शन का उपयोग करते हैं, तो अंदर ही अंदर QR decomposition काम कर रहा होता है।
अब multiple linear regression in Python में एक चिंता के रूप में सामने आने वाली बात का उल्लेख करना उपयुक्त है। Multicollinearity तब होती है जब दो या अधिक स्वतंत्र चर अत्यधिक सहसंबद्ध हों, जिससे उनके व्यक्तिगत प्रभावों को अलग-अलग पहचानना कठिन हो जाता है। इससे गुणांक अनुमान अस्थिर हो सकते हैं। Multicollinearity का पता लगाने और उसे कम करने के लिए आप variance inflation factor (VIF) की गणना कर सकते हैं। आप अत्यधिक सहसंबद्ध चरों को हटा सकते हैं, या regularization तकनीकों—जैसे ridge regression और lasso regression—का उपयोग कर सकते हैं।
Linear regression मॉडल बनाने के बाद, अगला कदम उसके प्रदर्शन का मूल्यांकन करना और यह सत्यापित करना है कि वह आधारभूत मान्यताओं को पूरा करता है। यह आपकी भविष्यवाणियों की विश्वसनीयता सुनिश्चित करता है और संभावित सुधारों की पहचान में मदद करता है।
Residual विश्लेषण, linear regression डायग्नोस्टिक्स का मुख्य भाग है। यह linear regression की मान्यताओं की जाँच करने और संभावित उल्लंघनों की पहचान करने में मदद करता है। अवशेषों को शून्य के आसपास यादृच्छिक रूप से बिखरा होना चाहिए, बिना किसी स्पष्ट पैटर्न के। यहाँ residual plots और Q-Q plots जैसे विज़ुअल टूल्स काम आते हैं:
Python में, हम ये प्लॉट आसानी से matplotlib, seaborn, और statsmodels जैसी लाइब्रेरीज़ से बना सकते हैं।
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
import statsmodels.api as sm

# Sample data and linear regression model
X = np.array([[1, 1], [1, 2], [2, 2], [2, 3]])  # Independent variables
y = np.array([6, 8, 9, 11])  # Dependent variable

# Add an intercept term
X = sm.add_constant(X)

# Fit the linear regression model
model = sm.OLS(y, X).fit()

# Get the residuals
residuals = model.resid

# 1. Residual Plot
plt.figure(figsize=(10, 5))
plt.subplot(1, 2, 1)
plt.scatter(model.fittedvalues, residuals)
plt.axhline(y=0, color='r', linestyle='--')
plt.xlabel('Fitted Values')
plt.ylabel('Residuals')
plt.title('Residual Plot')

# 2. Q-Q Plot
plt.subplot(1, 2, 2)
sm.qqplot(residuals, line ='45', ax=plt.gca())
plt.title('Q-Q Plot')

plt.tight_layout()
plt.show()दृश्य विश्लेषण के अलावा, मात्रात्मक मीट्रिक्स यह आकलन करने के लिए आवश्यक हैं कि linear regression मॉडल डेटा पर कितना अच्छा फिट बैठता है। कुछ प्रमुख मूल्यांकन मीट्रिक्स हैं:
इन मीट्रिक्स को Python में statsmodels या scikit-learn के साथ आसानी से निकाला जा सकता है:
from sklearn.metrics import mean_squared_error, mean_absolute_error, r2_score
import numpy as np

# Make predictions using the model
y_pred = model.predict(X)

# R-squared
r_squared = r2_score(y, y_pred)
print("R-squared:", r_squared)

# Adjusted R-squared (calculated manually)
n = len(y)  # number of data points
p = X.shape[1] - 1  # number of predictors (excluding intercept)
adj_r_squared = 1 - (1 - r_squared) * (n - 1) / (n - p - 1)
print("Adjusted R-squared:", adj_r_squared)

# RMSE
rmse = np.sqrt(mean_squared_error(y, y_pred))
print("Root Mean Squared Error (RMSE):", rmse)

# MAE
mae = mean_absolute_error(y, y_pred)
print("Mean Absolute Error (MAE):", mae)
इन मीट्रिक्स का मूल्यांकन करके, आप मॉडल की सटीकता, goodness of fit, और नए डेटा पर उसके सामान्यीकरण की क्षमता के बारे में अंतर्दृष्टि प्राप्त करते हैं।
जब आप अपने linear regression मॉडल का मूल्यांकन कर लें, तो अगला कदम उसके प्रदर्शन को सुधारने के तरीकों की तलाश करना है। एक सामान्य तरीका है feature transformations, जो nonlinear संबंधों को संबोधित कर सकती हैं और मॉडल को डेटा में अंतर्निहित पैटर्न को बेहतर तरीके से कैप्चर करने में मदद करती हैं।
ध्यान दें कि linear regression में, मॉडल स्वतंत्र (predictors) और आश्रित चर के बीच रैखिक संबंध मान कर चलता है। हालांकि, कई वास्तविक-विश्व डेटा सेट्स में nonlinear संबंध होते हैं जिन्हें एक साधारण linear मॉडल ठीक से कैप्चर नहीं कर पाता। Logarithmic या square root जैसे रूपांतरण लागू करके, आप कभी-कभी मॉडल का प्रदर्शन सुधार सकते हैं।
इसे अक्सर तब उपयोग किया जाता है जब कोई फ़ीचर घातीय वृद्धि दिखाता है या उसके मान बहुत बड़े धनात्मक होते हैं। उदाहरण के लिए, अत्यधिक skewed आय (income) डेटा—जहाँ कुछ बहुत ऊँचे मान हावी हों—को रूपांतरित करने से वितरण अधिक सामान्य हो सकता है।
import numpy as np
df['log_income'] = np.log(df['income'] + 1) # +1 to avoid log(0)यह उन फ़ीचर्स के लिए उपयोगी है जो द्विघात (quadratic) संबंध का पालन करते हैं। उदाहरण के लिए, काउंट्स को दर्शाने वाला फ़ीचर (जैसे किसी वेबसाइट पर विज़िट्स की संख्या) square root रूपांतरण से लाभान्वित हो सकता है।
df['sqrt_visits'] = np.sqrt(df['visits'])इन फ़ीचर्स का रूपांतरण करके, आप मॉडल को उन संबंधों को बेहतर तरीके से कैप्चर करने में मदद करते हैं जिन्हें linear दृष्टिकोण पहले चूक रहा था। कुंजी है विभिन्न रूपांतरणों का परीक्षण करना और उनके प्रभाव को मॉडल के प्रदर्शन पर देखना। यह एक एक-आकार-सबके-लिए उपयुक्त तरीका नहीं है, और इसके लिए प्रायोगिक परीक्षण जरूरी है।
Feature transformations के अतिरिक्त, अपने regression मॉडल पर normalization और standardization के प्रभाव को समझना भी महत्वपूर्ण है, खासकर जब आप विभिन्न इकाइयों या स्केल वाले फ़ीचर्स के साथ काम कर रहे हों। Normalization में फ़ीचर मानों को एक रेंज—आमतौर पर [0, 1]—में rescale किया जाता है। Standardization में फ़ीचर्स को 0 माध्य (mean) और 1 मानक विचलन (standard deviation) पर rescale किया जाता है।
जब आपके पास कई predictors हों, तो डेटा को normalize या standardize करना गुणांकों की व्याख्या को अधिक सार्थक बनाता है। यानी, यह दिखाने में मदद करता है कि प्रत्येक predictor, अन्य predictors की तुलना में, आश्रित चर में कितना योगदान देता है। यह विशेष रूप से तब उपयोगी है जब predictors अलग-अलग स्केल पर हों।
Linear regression की गहरी समझ विकसित करने के लिए निरंतर अभ्यास और अन्वेषण आवश्यक है। अपने ज्ञान को और गहरा करने के लिए, multicollinearity को संभालना, heteroscedasticity, और Ridge और Lasso regression जैसी regularization तकनीकों के बारे में अधिक जानने पर विचार करें। QR decomposition और variance inflation factor की समझ मजबूत करना भी मॉडल डायग्नोस्टिक्स को बेहतर बना सकता है। साथ ही, normalization बनाम standardization को समझना feature scaling निर्णयों में सहायक होगा।