Python, met z’n rijke ecosysteem van bibliotheken zoals NumPy, statsmodels en scikit-learn, is uitgegroeid tot de favoriete taal voor data scientists. De gebruiksvriendelijkheid en veelzijdigheid maken het ideaal om zowel de theoretische basis van lineaire regressie te begrijpen als om het toe te passen in praktijksituaties.
In deze gids neem ik je mee door alles wat je moet weten over lineaire regressie in Python. We beginnen met wat lineaire regressie is en waarom het zo belangrijk is. Daarna duiken we in de mechanica: de onderliggende vergelijkingen en aannames. Je leert hoe je lineaire regressie uitvoert met verschillende Python-bibliotheken, van handmatige berekeningen met NumPy tot gestroomlijnde implementaties met scikit-learn. We behandelen zowel eenvoudige als multiple lineaire regressie, en ik laat je zien hoe je je modellen evalueert en hun prestaties verbetert.
Wat is lineaire regressie?
Lineaire regressie is een statistische methode om de relatie te modelleren tussen een afhankelijke variabele (target) en een of meer onafhankelijke variabelen (predictors). Het doel is een lineaire vergelijking te vinden die deze relatie het best beschrijft.
Lineaire regressie wordt veel gebruikt voor voorspellend modelleren, inferentiële statistiek en het begrijpen van relaties in data. Toepassingen zijn onder meer verkoopprognoses, risicobeoordeling en het analyseren van de impact van verschillende variabelen op een doeluitkomst.
Wat is eenvoudige lineaire regressie?
Bij eenvoudige lineaire regressie krijgt dit de vorm van een lijn in tweedimensionale ruimte; bij multiple lineaire regressie (met twee onafhankelijke variabelen) wordt de relatie weergegeven door een vlak in driedimensionale ruimte; bij nog meer onafhankelijke variabelen beschrijft de vergelijking een hypervlak in een ruimte met hogere dimensies.
Laten we beginnen met een model voor eenvoudige lineaire regressie, dat, zoals ik al zei, slechts één predictor heeft. Het wordt weergegeven door deze vergelijking:
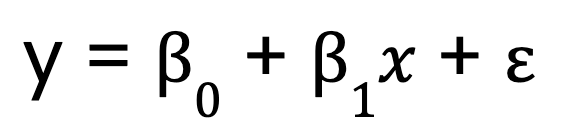
Waarbij:
- y de afhankelijke variabele is,
- x de onafhankelijke variabele is,
- B0 het intercept is,
- B1 de coëfficiënt (helling) van de onafhankelijke variabele is,
- het de foutterm voorstelt.
Wat is multiple lineaire regressie?
Daarentegen breidt multiple lineaire regressie dit concept uit met meerdere predictorvariabelen:
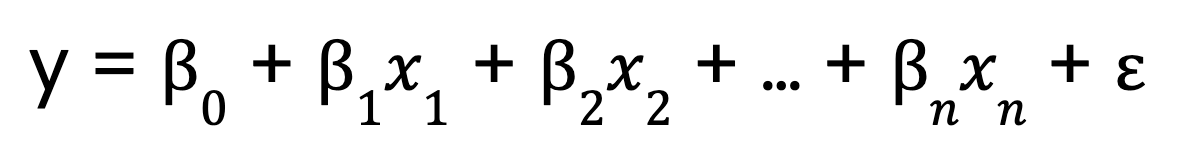
Waarbij:
- 0 het intercept is,
- x1, x2, ..., xn de predictorvariabelen zijn
- 1,2, ..., n de coëfficiënten zijn die bij elke predictor horen,
- de foutterm is.
De mechanica achter lineaire regressie
Om te begrijpen hoe lineaire regressie werkt, bekijken we de belangrijkste onderdelen.
De vergelijking van het lineaire model
We zagen hierboven vergelijkingen voor lineaire regressie, zowel met één als met meerdere predictors. Maar nu wil ik een belangrijk aspect van die vergelijkingen bespreken.
De term lineair in lineaire regressie verwijst naar de functionele vorm van het model, niet per se naar de vorm van de data. Concreet betekent dit dat:
- Het model lineair is in zijn parameters. Elke predictor wordt vermenigvuldigd met een coëfficiënt en opgeteld.
- De relatie tussen de afhankelijke variabele en de predictors additief is, wat betekent dat veranderingen in elke predictor een consistent effect hebben op de afhankelijke variabele.
- Er geen machtsverheffingen, vermenigvuldigingen tussen variabelen of niet-lineaire transformaties op de parameters worden toegepast.
Ordinary least squares (OLS)
Om de best passende lijn te bepalen, gebruikt lineaire regressie de ordinary least squares (OLS)-methode. OLS minimaliseert de som van de gekwadrateerde fouten:
OLS minimaliseert de som van de gekwadrateerde fouten:
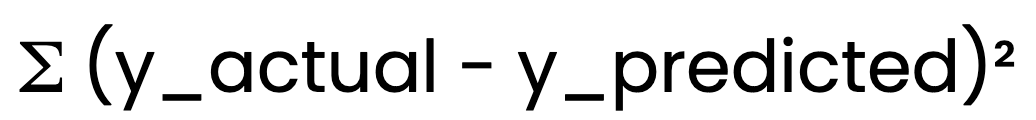
Dit zorgt ervoor dat het model de best mogelijke schattingen geeft van B0 en B1.
Aannames van lineaire regressie
Opdat lineaire regressie betrouwbare resultaten oplevert, moeten bepaalde aannames worden vervuld:
- Lineariteit: De relatie tussen de onafhankelijke en afhankelijke variabele moet lineair zijn.
- Onafhankelijkheid van fouten: De residuen (fouten) mogen niet met elkaar gecorreleerd zijn.
- Constante variantie (Homoscedasticiteit): De spreiding van residuen moet constant blijven over alle waarden.
- Normaliteit van residuen: De residuen moeten een normale verdeling volgen.
Het valideren van deze aannames zorgt ervoor dat ons model zowel betrouwbaar als valide is. Als de relatie tussen variabelen bijvoorbeeld niet lineair is, kunnen de voorspellingen van het model onnauwkeurig zijn. Als er sprake is van heteroscedasticiteit, kunnen de betrouwbaarheidsintervallen onjuist zijn.
Manieren om lineaire regressie in Python te doen
Lineaire regressie kan in Python op verschillende manieren worden geïmplementeerd. Ik laat je drie gangbare methoden zien: handmatige berekeningen met NumPy, gedetailleerd statistisch modelleren met statsmodels, en gestroomlijnd machine learning met scikit-learn.
Handmatige berekening (NumPy)
Voor een eenvoudige lineaire regressie (één predictor) kun je de regressieparameters handmatig berekenen met NumPy. Dit houdt in dat je eerst het gemiddelde van de onafhankelijke en afhankelijke variabele berekent. Vervolgens bepalen we de helling (B0):
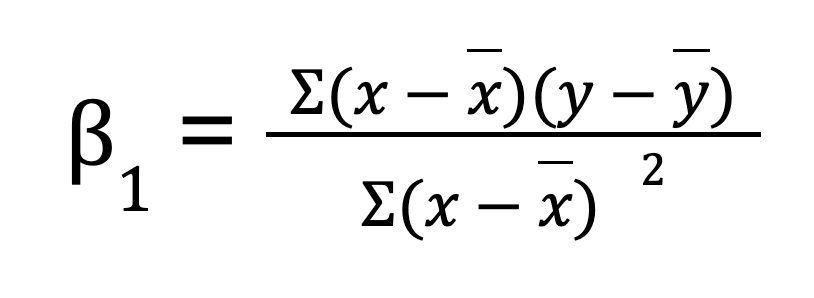
Zodra we de helling hebben, kunnen we het intercept bepalen (B1):
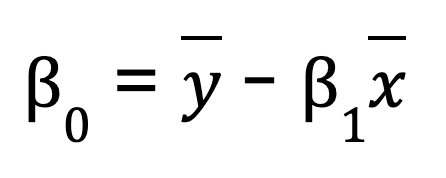
import numpy as np

# Sample data
x = np.array([1, 2, 3, 4, 5])
y = np.array([2, 4, 5, 4, 5])

# Compute means
x_mean = np.mean(x)
y_mean = np.mean(y)

# Compute slope (B1)
B1 = np.sum((x - x_mean) * (y - y_mean)) / np.sum((x - x_mean) ** 2)

# Compute intercept (B0)
B0 = y_mean - B1 * x_mean

print(f"Slope (B1): {B1}")
print(f"Intercept (B0): {B0}")

# Predicting values
y_pred = B0 + B1 * x
print("Predicted values:", y_pred)
Als je het proces wilt vereenvoudigen, biedt NumPy ook een ingebouwde functie np.polyfit(), die lineaire regressie voor je kan uitvoeren met één regel code.
# Example of NumPy's polyfit
np.polyfit(x, y, 1)  # 1 stands for the degree of the polynomial (linear)
Hoewel deze methode nuttig is om de wiskunde achter eenvoudige lineaire regressie te begrijpen, is ze onpraktisch voor grote datasets, minder numeriek precies en werkt ze niet voor multiple regressieproblemen.
Met een statistische bibliotheek (statsmodels)
Een efficiëntere manier om lineaire regressie uit te voeren is met statsmodels, een bibliotheek met statistische modellen en analysetools.
Stappen om een Ordinary Least Squares (OLS)-model te fitten met Statsmodels:
-
Bereid de data voor: Zorg dat de onafhankelijke variabele correct is gestructureerd.
-
Voeg een constante toe: Dit dekt de intercept-term in de vergelijking af.
-
Fit het model: Gebruik
OLS()uitstatsmodelsom de regressieparameters te schatten. -
Analyseer de resultaten: De functie
.summary()biedt gedetailleerde inzichten, waaronder coëfficiënten, p-waarden en R-kwadraat.
import numpy as np
import statsmodels.api as sm

# Sample data
x = np.array([1, 2, 3, 4, 5])
y = np.array([2, 4, 5, 4, 5])

# Add constant for intercept term
X = sm.add_constant(x)

# Fit OLS model
model = sm.OLS(y, X).fit()

# Print summary
print(model.summary())
Met een machine learning-bibliotheek (scikit-learn)
scikit-learn is veelgebruikt vanwege de eenvoud, schaalbaarheid en integratie met andere ML-tools. Het biedt een eenvoudige en efficiënte manier om lineaire regressie uit te voeren met de klasse LinearRegression.
-
Importeer de bibliotheek en laad je dataset.
-
Reshape de predictor indien nodig (voor regressie met één variabele).
-
Maak een modelinstance met
LinearRegression(). -
Fit het model op de trainingsdata.
-
Haal de modelparameters op: Het attribuut
.coeff_geeft de helling, terwijl.intercept_het intercept bevat.
import numpy as np
from sklearn.linear_model import LinearRegression

# Sample data
x = np.array([1, 2, 3, 4, 5]).reshape(-1, 1)  # Reshape for scikit-learn
y = np.array([2, 4, 5, 4, 5])

# Create model instance
model = LinearRegression()

# Fit the model
model.fit(x, y)

# Get model parameters
print(f"Slope (B1): {model.coef_[0]}")
print(f"Intercept (B0): {model.intercept_}")

# Predict values
y_pred = model.predict(x)
print("Predicted values:", y_pred)
Andere belangrijke methoden
Naast NumPy, statsmodels en scikit-learn bieden verschillende andere Python-bibliotheken regressiemogelijkheden:
- Pandas: Handig voor verkennende data-analyse en snelle trendmodellen.
- SciPy: Bevat statistische functies die je kunt gebruiken voor regressie-analyse.
- TensorFlow & PyTorch: Hoewel primair voor deep learning, kunnen ze ook lineaire regressie effectief afhandelen.
Elke aanpak heeft z’n voordelen. Het hangt af van de complexiteit van je regressietaak.
Lineaire regressie in Python met één of meer predictors
Lineaire regressie kan zowel eenvoudige als complexe relaties aan. In dit deel bekijken we hoe je lineaire regressie met één predictor (eenvoudig) en meerdere predictors (multiple) in Python implementeert.
Eenvoudige lineaire regressie in Python
Voor een eenvoudige lineaire regressie in Python volgen we deze stappen:
Stap 1: Bereken de correlatie
De correlatiecoëfficiënt meet de sterkte van de relatie tussen x en y. We bepalen die met NumPy:
import numpy as np

# Sample data
x = np.array([1, 2, 3, 4, 5])  # Independent variable
y = np.array([2, 4, 5, 4, 5])  # Dependent variable

correlation = np.corrcoef(x, y)[0, 1]
print("Correlation:", correlation)
Stap 2: Bereken de helling en het intercept
De helling B1 wordt als volgt berekend:
beta_1 = correlation * (np.std(y) / np.std(x))Je valt misschien op dat deze vergelijking iets anders lijkt dan de eerdere, waarin ik de helling vond door de producten van afwijkingen tussen en y te sommeren en daarna te delen door de som van gekwadrateerde afwijkingen in . Deze nieuwe methode, met correlatie en standaardafwijking, lijkt anders maar is in feite hetzelfde. Door de eerdere vergelijking te herschrijven, kunnen we de helling uitdrukken als vermenigvuldigd met de verhouding van de standaardafwijkingen van en , waardoor de twee vormen algebraïsch gelijkwaardig zijn.
Dan nu het intercept:
beta_0 = np.mean(y) - beta_1 * np.mean(x)Stap 3: Maak voorspellingen met de berekende parameters
Nu we de coëfficiënten hebben, kunnen we de voorspelde waarden bepalen.
y_pred = beta_0 + beta_1 * xDoor deze stappen te doorlopen, begrijp je de onderliggende berekeningen beter voordat je bibliotheken zoals scikit-learn gebruikt.
Multiple lineaire regressie in Python
Multiple lineaire regressie breidt het concept van eenvoudige lineaire regressie uit om relaties te modelleren tussen een afhankelijke variabele en meerdere onafhankelijke variabelen. Zo kunnen we complexere datasets analyseren waarbij één predictor de variatie in de afhankelijke variabele niet voldoende verklaart.
Om multiple lineaire regressie in Python uit te voeren, gebruiken we doorgaans matrixalgebra om de coëfficiënten te berekenen die de residuele som van kwadraten minimaliseren. Een vaak onderwezen formule om de coëfficiënten te berekenen staat bekend als de normale vergelijking:
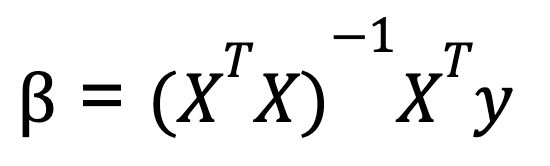
Waarbij:
- X de matrix van onafhankelijke variabelen is (met een kolom enen voor het intercept),
- y de vector met waarden van de afhankelijke variabele is.
- XT de getransponeerde matrix van X is.
- (XTX)-1 de inverse is van XTX.
Deze vergelijking geeft de optimale waarden voor de coëfficiënten die de som van gekwadrateerde fouten minimaliseren.
Hier is een voorbeeld van multiple lineaire regressie in Python, met NumPy voor de matrixbewerkingen:
import numpy as np

# Sample data: two predictors and one dependent variable
X = np.array([[1, 1], [1, 2], [2, 2], [2, 3]])  # Independent variables
y = np.array([6, 8, 9, 11])  # Dependent variable

# Add a column of ones to include the intercept in the model
X = np.column_stack((np.ones(X.shape[0]), X))

# Calculate beta coefficients using the normal equation
beta = np.linalg.inv(X.T @ X) @ X.T @ y
print("Coefficients:", beta)
Deze methode werkt goed wanneer de predictors onafhankelijk zijn, maar als predictors sterk gecorreleerd zijn, wordt matrixinversie onstabiel. Daarom gebruiken bibliotheken zoals scikit-learn een numeriek stabielere methode op basis van QR-decompositie om regressiecoëfficiënten te berekenen. Dus ook al kunnen we de coëfficiënten met de normale vergelijking bepalen, weet dat wanneer we de functie LinearRegression() uit scikitlearn gebruiken, QR-decompositie onder de motorkap draait.
Aanpakken van multicollineariteit
Dit is een goed moment om iets te noemen dat vaak speelt bij multiple lineaire regressie in Python. Multicollineariteit ontstaat wanneer twee of meer onafhankelijke variabelen sterk gecorreleerd zijn, waardoor hun individuele effecten lastig te isoleren zijn. Dit kan leiden tot onstabiele coëfficiëntschattingen. Om multicollineariteit op te sporen en te verminderen, kun je de variance inflation factor (VIF) berekenen. Je kunt ook sterk gecorreleerde variabelen verwijderen, of regularisatietechnieken zoals ridge- en lasso-regressie gebruiken.
Diagnostiek en evaluatie van lineaire regressiemodellen in Python
Na het bouwen van je lineaire regressiemodel is de volgende stap het evalueren van de prestaties en het valideren van de onderliggende aannames. Dit waarborgt de betrouwbaarheid van je voorspellingen en helpt potentiële verbeteringen te identificeren.
Residuanalyse
Residuanalyse is een kernonderdeel van diagnostiek bij lineaire regressie. Het helpt de aannames te controleren en eventuele schendingen te identificeren. De residuen zouden willekeurig rond nul moeten liggen, zonder herkenbaar patroon. Hier komen visuele hulpmiddelen zoals residuplots en Q-Q-plots van pas:
- Residuplot: Een scatterplot van de residuen tegenover de voorspelde waarden (of onafhankelijke variabelen) helpt te controleren of er nog een relatie is die het model niet heeft meegenomen. Idealiter toont de plot een willekeurige spreiding zonder duidelijk patroon, wat suggereert dat het model de lineaire relatie goed heeft vastgelegd.
- Q-Q-plot (Quantile-Quantile-plot): Een Q-Q-plot helpt te beoordelen of de residuen een normale verdeling volgen. Voor de geldigheid van lineaire regressie moeten de residuen ongeveer normaal verdeeld zijn. Een rechte lijn in de Q-Q-plot duidt op normaliteit.
In Python kunnen we deze plots eenvoudig maken met matplotlib, seaborn en statsmodels.
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
import statsmodels.api as sm

# Sample data and linear regression model
X = np.array([[1, 1], [1, 2], [2, 2], [2, 3]])  # Independent variables
y = np.array([6, 8, 9, 11])  # Dependent variable

# Add an intercept term
X = sm.add_constant(X)

# Fit the linear regression model
model = sm.OLS(y, X).fit()

# Get the residuals
residuals = model.resid

# 1. Residual Plot
plt.figure(figsize=(10, 5))
plt.subplot(1, 2, 1)
plt.scatter(model.fittedvalues, residuals)
plt.axhline(y=0, color='r', linestyle='--')
plt.xlabel('Fitted Values')
plt.ylabel('Residuals')
plt.title('Residual Plot')

# 2. Q-Q Plot
plt.subplot(1, 2, 2)
sm.qqplot(residuals, line ='45', ax=plt.gca())
plt.title('Q-Q Plot')

plt.tight_layout()
plt.show()
Evaluatiemetrics
Naast visuele analyse zijn kwantitatieve maatstaven essentieel om te beoordelen hoe goed het lineaire regressiemodel bij de data past. Enkele belangrijke evaluatiemetrics zijn:
- R-kwadraat (R²): Deze maatstaf geeft aan hoeveel van de variantie in de afhankelijke variabele verklaard wordt door de onafhankelijke variabelen. Een R²-waarde dichter bij 1 betekent dat het model een groot deel van de variantie verklaart; dichter bij 0 betekent dat het model niet goed past.
- Aangepast R-kwadraat: Past R² aan voor het aantal predictors in het model. Handig om modellen met verschillende aantallen predictors te vergelijken.
- Root Mean Squared Error (RMSE): RMSE meet de gemiddelde omvang van de fouten in de voorspellingen van het model, in dezelfde eenheden als de afhankelijke variabele. Een lagere RMSE duidt op betere voorspellende prestaties.
- Mean Absolute Error (MAE): MAE meet de gemiddelde omvang van de fouten in de voorspellingen van het model, maar in tegenstelling tot RMSE bestraft het grote fouten minder zwaar. Het is makkelijker te interpreteren omdat het in dezelfde eenheden is als de afhankelijke variabele.
Deze metrics kun je eenvoudig in Python berekenen met statsmodels of scikit-learn:
from sklearn.metrics import mean_squared_error, mean_absolute_error, r2_score
import numpy as np

# Make predictions using the model
y_pred = model.predict(X)

# R-squared
r_squared = r2_score(y, y_pred)
print("R-squared:", r_squared)

# Adjusted R-squared (calculated manually)
n = len(y)  # number of data points
p = X.shape[1] - 1  # number of predictors (excluding intercept)
adj_r_squared = 1 - (1 - r_squared) * (n - 1) / (n - p - 1)
print("Adjusted R-squared:", adj_r_squared)

# RMSE
rmse = np.sqrt(mean_squared_error(y, y_pred))
print("Root Mean Squared Error (RMSE):", rmse)

# MAE
mae = mean_absolute_error(y, y_pred)
print("Mean Absolute Error (MAE):", mae)
Door deze metrics te evalueren, krijg je inzicht in de nauwkeurigheid, de goodness-of-fit en hoe goed het model generaliseert naar nieuwe data.
Je regressiemodel verbeteren
Als je je lineaire regressiemodel hebt geëvalueerd, is de volgende stap manieren te verkennen om de prestaties te verbeteren. Een veelgebruikte aanpak is via featuretransformaties, die niet-lineaire relaties kunnen adresseren en het model helpen onderliggende patronen beter vast te leggen.
Featuretransformaties
Onthoud dat het model bij lineaire regressie uitgaat van een lineaire relatie tussen de onafhankelijke variabelen (predictors) en de afhankelijke variabele. Veel datasets uit de echte wereld hebben echter niet-lineaire relaties die een eenvoudig lineair model mogelijk niet goed vastlegt. Door featuretransformaties toe te passen, zoals logaritmische of worteltransformaties, kun je de modelprestaties soms verbeteren.
Logaritmische transformatie
Dit wordt vaak gebruikt wanneer een feature exponentiële groei vertoont of zeer grote positieve waarden heeft. Het transformeren van scheve inkomensdata (waarbij enkele zeer hoge inkomens domineren) kan de verdeling bijvoorbeeld normaler maken.
import numpy as np
df['log_income'] = np.log(df['income'] + 1)  # +1 to avoid log(0)
Worteltransformatie
Dit is nuttig voor features die een kwadratische relatie volgen. Een feature die tellingen weergeeft (zoals het aantal websitebezoeken) kan baat hebben bij een worteltransformatie.
df['sqrt_visits'] = np.sqrt(df['visits'])Door deze features te transformeren, help je het model relaties vast te leggen die eerder door de lineaire benadering werden gemist. Het belangrijkste is verschillende transformaties te testen en het effect op de modelprestaties te observeren. Het is geen one-size-fits-all-aanpak en vereist empirisch testen.
Normalisatie en standaardisatie
Naast featuretransformaties is het ook belangrijk het effect van normalisatie en standaardisatie op je regressiemodel te begrijpen, zeker wanneer je met features met verschillende eenheden of schalen werkt. Normalisatie schaalt de featurewaarden opnieuw naar een bereik, meestal [0, 1]. Standaardisatie schaalt de features zodat ze een gemiddelde van 0 en een standaardafwijking van 1 hebben.
Als je meerdere predictors hebt, helpt het normaliseren of standaardiseren van de data om de coëfficiënten betekenisvoller te interpreteren. Dat wil zeggen, h et laat zien hoeveel elke predictor bijdraagt aan de afhankelijke variabele ten opzichte van andere predictors. Dit is vooral nuttig wanneer de predictors op verschillende schalen staan.
Conclusie
Een goed begrip van lineaire regressie vraagt om voortdurende oefening en verkenning. Verdiep je verder in het aanpakken van multicollineariteit, heteroscedasticiteit en regularisatietechnieken zoals Ridge- en Lasso-regressie. Een beter begrip van QR-decompositie en de variance inflation factor kan de modeldiagnostiek verbeteren. Daarnaast kan inzicht in normalisatie versus standaardisatie je helpen bij beslissingen over schaaltransformaties.