Python, con il suo ricco ecosistema di librerie come NumPy, statsmodels e scikit-learn, è diventato il linguaggio di riferimento per i data scientist. La sua facilità d’uso e versatilità lo rendono perfetto sia per comprendere le basi teoriche della regressione lineare sia per implementarla in scenari reali.
In questa guida, ti accompagnerò in tutto ciò che devi sapere sulla regressione lineare in Python. Partiremo definendo che cos’è la regressione lineare e perché è così importante. Poi vedremo la meccanica, esplorando le equazioni e le assunzioni alla base. Imparerai come eseguire la regressione lineare usando diverse librerie Python, dai calcoli manuali con NumPy alle implementazioni snelle con scikit-learn. Tratteremo sia la regressione lineare semplice sia quella multipla e ti mostrerò come valutare i tuoi modelli e migliorarne le prestazioni.
Cos’è la regressione lineare?
La regressione lineare è un metodo statistico usato per modellare la relazione tra una variabile dipendente (target) e una o più variabili indipendenti (predittori). L’obiettivo è trovare un’equazione lineare che descriva al meglio questa relazione.
La regressione lineare è ampiamente utilizzata per il predictive modeling, le statistiche inferenziali e per comprendere le relazioni nei dati. Le sue applicazioni includono la previsione delle vendite, la valutazione del rischio e l’analisi dell’impatto di diverse variabili su un risultato target.
Che cos’è la regressione lineare semplice?
Per la regressione lineare semplice, la relazione assume la forma di una retta in uno spazio bidimensionale; per la regressione lineare multipla (con due variabili indipendenti), la relazione è rappresentata da un piano nello spazio tridimensionale; con ancora più variabili indipendenti, l’equazione descrive un iperpiano in uno spazio di dimensioni superiori.
Iniziamo con un modello di regressione lineare semplice che, come ho detto, ha un solo predittore. È rappresentato da questa equazione:
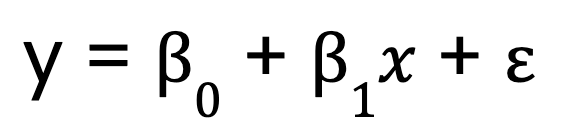
Dove:
- y è la variabile dipendente,
- x è la variabile indipendente,
- B0 è l’intercetta,
- B1 è il coefficiente (pendenza) della variabile indipendente,
- rappresenta il termine di errore.
Che cos’è la regressione lineare multipla?
Al contrario, la regressione lineare multipla estende questo concetto includendo più variabili predittive:
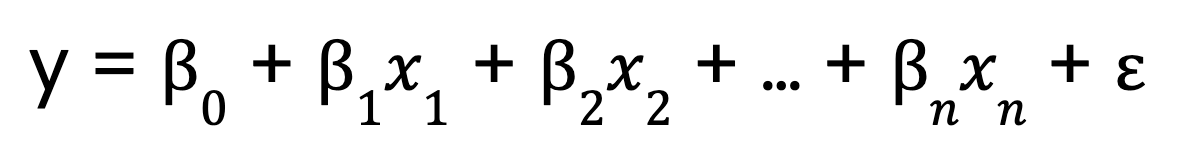
Dove:
- 0 è l’intercetta,
- x1, x2, ..., xn sono le variabili predittive
- 1,2, ..., n sono i coefficienti corrispondenti a ciascuna variabile predittiva,
- è il termine di errore.
La meccanica della regressione lineare
Per capire come funziona la regressione lineare, analizziamone i componenti chiave.
L’equazione del modello lineare
Abbiamo visto le equazioni per la regressione lineare, sopra, sia con un singolo predittore che con predittori multipli. Ora però voglio parlare di un aspetto importante delle equazioni.
Il termine lineare in regressione lineare si riferisce alla forma funzionale del modello, non necessariamente alla forma dei dati. In particolare, significa che:
- Il modello è lineare nei suoi parametri. Cioè ogni predittore è moltiplicato per un coefficiente e poi sommato.
- La relazione tra variabile dipendente e predittori è additiva, cioè le variazioni di ogni predittore hanno un effetto costante sulla variabile dipendente.
- Nessuna esponenziazione, moltiplicazione tra variabili o trasformazioni non lineari è applicata ai parametri.
Metodo dei minimi quadrati ordinari (OLS)
Per determinare la retta di miglior adattamento, la regressione lineare usa il metodo dei minimi quadrati ordinari (OLS). OLS minimizza la somma degli errori al quadrato:
OLS minimizza la somma degli errori al quadrato:
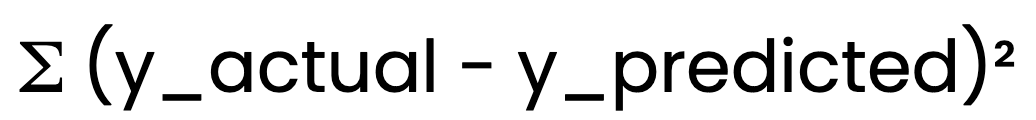
Questo garantisce che il modello fornisca le migliori stime possibili di B0 e B1.
Assunzioni della regressione lineare
Affinché la regressione lineare produca risultati affidabili, devono essere soddisfatte alcune assunzioni:
- Linearità: la relazione tra variabile indipendente e dipendente dovrebbe essere lineare.
- Indipendenza degli errori: i residui (errori) non dovrebbero essere correlati tra loro.
- Varianza costante (omoscedasticità): la dispersione dei residui dovrebbe rimanere costante su tutti i valori.
- Normalità dei residui: i residui dovrebbero seguire una distribuzione normale.
Validare queste assunzioni assicura che il nostro modello sia affidabile e valido. Ad esempio, se la relazione tra variabili non è lineare, le previsioni del modello potrebbero essere inaccurate. Se c’è eteroscedasticità, gli intervalli di confidenza potrebbero risultare errati.
Modi per fare la regressione lineare in Python
La regressione lineare può essere implementata in Python con approcci diversi. Ti guiderò attraverso tre metodi comuni: calcoli manuali con NumPy, modellazione statistica dettagliata con statsmodels e machine learning snello con scikit-learn.
Approccio di calcolo manuale (NumPy)
Per una regressione lineare semplice (una variabile predittiva), puoi calcolare manualmente i parametri della regressione usando NumPy. Questo comporta innanzitutto il calcolo della media delle variabili indipendente e dipendente. Poi calcoliamo la pendenza (B0):
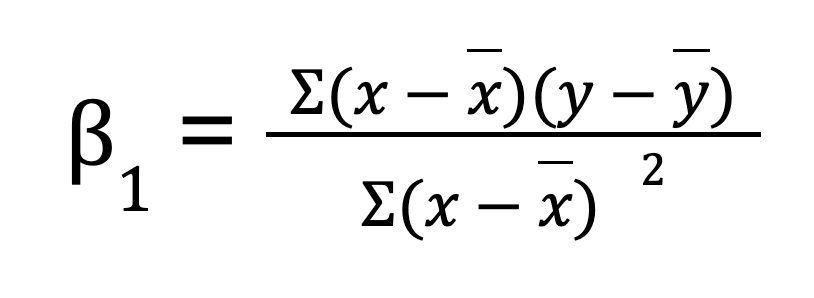
Una volta ottenuta la pendenza, possiamo determinare l’intercetta (B1):
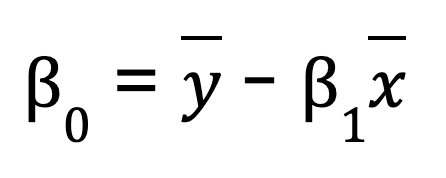
import numpy as np

# Sample data
x = np.array([1, 2, 3, 4, 5])
y = np.array([2, 4, 5, 4, 5])

# Compute means
x_mean = np.mean(x)
y_mean = np.mean(y)

# Compute slope (B1)
B1 = np.sum((x - x_mean) * (y - y_mean)) / np.sum((x - x_mean) ** 2)

# Compute intercept (B0)
B0 = y_mean - B1 * x_mean

print(f"Slope (B1): {B1}")
print(f"Intercept (B0): {B0}")

# Predicting values
y_pred = B0 + B1 * x
print("Predicted values:", y_pred)
Se vuoi semplificare il processo, NumPy offre anche una funzione integrata np.polyfit(), che può eseguire per te la regressione lineare con una sola riga di codice.
# Example of NumPy's polyfit
np.polyfit(x, y, 1)  # 1 stands for the degree of the polynomial (linear)
Sebbene questo metodo sia utile per comprendere la matematica alla base della regressione lineare semplice, è poco pratico per dataset di grandi dimensioni, ha minore precisione numerica e non funziona per problemi di regressione multipla.
Uso di una libreria statistica (statsmodels)
Un modo più efficiente per eseguire la regressione lineare è usare statsmodels, una libreria che fornisce modelli statistici e strumenti di analisi.
Passi per adattare un modello OLS (Ordinary Least Squares) usando Statsmodels:
-
Prepara i dati: assicurati che la variabile indipendente sia strutturata correttamente.
-
Aggiungi una costante: questo tiene conto del termine di intercetta nell’equazione.
-
Adatta il modello: usa
OLS()distatsmodelsper stimare i parametri della regressione. -
Analizza i risultati: la funzione
.summary()fornisce dettagli approfonditi sul modello, inclusi coefficienti, p-value e R-quadrato.
import numpy as np
import statsmodels.api as sm

# Sample data
x = np.array([1, 2, 3, 4, 5])
y = np.array([2, 4, 5, 4, 5])

# Add constant for intercept term
X = sm.add_constant(x)

# Fit OLS model
model = sm.OLS(y, X).fit()

# Print summary
print(model.summary())
Uso di una libreria di machine learning (scikit-learn)
scikit-learn è ampiamente usato per la sua semplicità, scalabilità e integrazione con altri strumenti di machine learning. Offre un modo semplice ed efficace per eseguire la regressione lineare tramite la classe LinearRegression.
-
Importa la libreria e carica il tuo dataset.
-
Ridimensiona la variabile predittiva se necessario (per la regressione a singola variabile).
-
Crea un’istanza del modello usando
LinearRegression(). -
Adatta il modello ai dati di training.
-
Recupera i parametri del modello: l’attributo
.coeff_restituisce la pendenza, mentre.intercept_fornisce l’intercetta.
import numpy as np
from sklearn.linear_model import LinearRegression

# Sample data
x = np.array([1, 2, 3, 4, 5]).reshape(-1, 1)  # Reshape for scikit-learn
y = np.array([2, 4, 5, 4, 5])

# Create model instance
model = LinearRegression()

# Fit the model
model.fit(x, y)

# Get model parameters
print(f"Slope (B1): {model.coef_[0]}")
print(f"Intercept (B0): {model.intercept_}")

# Predict values
y_pred = model.predict(x)
print("Predicted values:", y_pred)
Altri metodi importanti
Oltre a NumPy, statsmodels e scikit-learn, diverse altre librerie Python offrono funzionalità di regressione:
- Pandas: utile per l’analisi esplorativa dei dati e per modellare rapidamente le tendenze.
- SciPy: include funzioni statistiche che possono essere usate per l’analisi di regressione.
- TensorFlow & PyTorch: pur essendo principalmente per il deep learning, possono gestire efficacemente compiti di regressione lineare.
Ogni approccio ha i suoi vantaggi. Dipende dalla complessità del tuo compito di regressione.
Regressione lineare in Python con uno o più predittori
La regressione lineare può gestire relazioni sia semplici sia complesse. In questa sezione, vedremo come implementare la regressione lineare con un predittore (semplice) e con più predittori (multipla) usando Python.
Regressione lineare semplice in Python
Per una regressione lineare semplice in Python, seguiamo questi passaggi:
Passo 1: Calcola la correlazione
Il coefficiente di correlazione misura l’intensità della relazione tra x e y. Lo otteniamo usando NumPy:
import numpy as np

# Sample data
x = np.array([1, 2, 3, 4, 5])  # Independent variable
y = np.array([2, 4, 5, 4, 5])  # Dependent variable

correlation = np.corrcoef(x, y)[0, 1]
print("Correlation:", correlation)
Passo 2: Calcola pendenza e intercetta
La pendenza B1 si calcola come:
beta_1 = correlation * (np.std(y) / np.std(x))Potresti notare che questa equazione sembra leggermente diversa da quella precedente, in cui ho trovato la pendenza sommando i prodotti degli scostamenti tra e y, per poi dividere per la somma degli scostamenti al quadrato in . Questo nuovo metodo, che usa correlazione e deviazione standard, può sembrare diverso ma in realtà è lo stesso. Riscrivendo l’equazione precedente, possiamo esprimere la pendenza come moltiplicata per il rapporto tra le deviazioni standard di e , rendendo le due forme algebricamente equivalenti.
Ora, per l’intercetta:
beta_0 = np.mean(y) - beta_1 * np.mean(x)Passo 3: Fai previsioni usando i parametri calcolati
Ora che abbiamo i coefficienti, possiamo ricavare i valori previsti.
y_pred = beta_0 + beta_1 * xRipercorrere questi passaggi, secondo me, è utile per comprendere i calcoli sottostanti prima di usare librerie come scikit-learn.
Regressione lineare multipla in Python
La regressione lineare multipla estende il concetto di regressione lineare semplice per modellare la relazione tra una variabile dipendente e più variabili indipendenti. Questo ci permette di analizzare dataset più complessi in cui un solo predittore non spiega a sufficienza la variazione della variabile dipendente.
Per eseguire la regressione lineare multipla in Python, in genere usiamo l’algebra matriciale per calcolare i coefficienti che minimizzano la somma dei quadrati dei residui. Una formula comunemente insegnata per calcolare i coefficienti nella regressione multipla è nota come equazione normale:
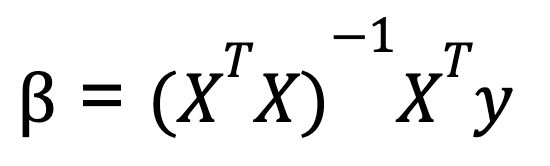
Dove:
- X è la matrice delle variabili indipendenti (con una colonna di 1 per l’intercetta),
- y è il vettore dei valori della variabile dipendente.
- XT è la trasposta della matrice X.
- (XTX)-1 è l’inversa di XTX.
Questa equazione fornisce i valori ottimali dei coefficienti che minimizzano la somma degli errori al quadrato.
Ecco un esempio di regressione lineare multipla con Python, usando NumPy per le operazioni matriciali:
import numpy as np

# Sample data: two predictors and one dependent variable
X = np.array([[1, 1], [1, 2], [2, 2], [2, 3]])  # Independent variables
y = np.array([6, 8, 9, 11])  # Dependent variable

# Add a column of ones to include the intercept in the model
X = np.column_stack((np.ones(X.shape[0]), X))

# Calculate beta coefficients using the normal equation
beta = np.linalg.inv(X.T @ X) @ X.T @ y
print("Coefficients:", beta)
Questo metodo funziona bene quando i predittori sono indipendenti, ma se i predittori sono altamente correlati, l’inversione della matrice diventa instabile. Per questo motivo, librerie come scikit-learn usano un metodo più stabile numericamente basato sulla decomposizione QR per calcolare i coefficienti di regressione. Quindi, anche se possiamo calcolare i coefficienti usando l’equazione normale, sappi che quando usiamo la funzione LinearRegression() di scikitlearn, sotto il cofano lavora la QR decomposition.
Affrontare la multicollinearità
Ora è un buon momento per menzionare un aspetto critico nella regressione lineare multipla in Python. La multicollinearità si verifica quando due o più variabili indipendenti sono altamente correlate, rendendo difficile isolarne gli effetti individuali. Questo può portare a stime dei coefficienti instabili. Per rilevare e mitigare la multicollinearità, puoi calcolare il variance inflation factor (VIF). Puoi anche rimuovere variabili altamente correlate, oppure usare tecniche di regolarizzazione come la ridge regression e la lasso regression.
Diagnostica ed evaluation del modello di regressione lineare in Python
Dopo aver costruito il tuo modello di regressione lineare, il passo successivo è valutarne le prestazioni e verificare che soddisfi le assunzioni sottostanti. Questo assicura l’affidabilità delle previsioni e ti aiuta a individuare possibili miglioramenti.
Analisi dei residui
L’analisi dei residui è una parte fondamentale della diagnostica della regressione lineare. Aiuta a verificare le assunzioni della regressione lineare e a identificare eventuali violazioni. I residui dovrebbero essere distribuiti casualmente intorno a zero, senza pattern evidenti. Qui entrano in gioco strumenti visivi come i residual plot e i Q-Q plot:
- Residual Plot: uno scatter plot dei residui rispetto ai valori previsti (o alle variabili indipendenti) aiuta a verificare se c’è qualche relazione che il modello non ha catturato. Idealmente, il grafico dovrebbe mostrare una dispersione casuale senza pattern evidenti, il che suggerisce che il modello ha ben catturato la relazione lineare.
- Q-Q Plot (Quantile-Quantile Plot): un Q-Q plot aiuta a valutare se i residui seguono una distribuzione normale. Perché la regressione lineare sia valida, i residui dovrebbero essere approssimativamente normali. Una linea retta nel Q-Q plot indica normalità.
In Python, possiamo creare facilmente questi grafici con librerie come matplotlib, seaborn e statsmodels.
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
import statsmodels.api as sm

# Sample data and linear regression model
X = np.array([[1, 1], [1, 2], [2, 2], [2, 3]])  # Independent variables
y = np.array([6, 8, 9, 11])  # Dependent variable

# Add an intercept term
X = sm.add_constant(X)

# Fit the linear regression model
model = sm.OLS(y, X).fit()

# Get the residuals
residuals = model.resid

# 1. Residual Plot
plt.figure(figsize=(10, 5))
plt.subplot(1, 2, 1)
plt.scatter(model.fittedvalues, residuals)
plt.axhline(y=0, color='r', linestyle='--')
plt.xlabel('Fitted Values')
plt.ylabel('Residuals')
plt.title('Residual Plot')

# 2. Q-Q Plot
plt.subplot(1, 2, 2)
sm.qqplot(residuals, line ='45', ax=plt.gca())
plt.title('Q-Q Plot')

plt.tight_layout()
plt.show()
Metriche di valutazione
Oltre all’analisi visiva, le metriche quantitative sono essenziali per valutare quanto bene il modello di regressione lineare si adatti ai dati. Alcune metriche chiave includono:
- R-quadrato (R²): indica quanta parte della varianza della variabile dipendente può essere spiegata dalle variabili indipendenti. Un valore di R² vicino a 1 indica che il modello spiega una grande porzione della varianza, mentre un valore vicino a 0 significa che il modello non si adatta bene ai dati.
- R-quadrato aggiustato: questa metrica corregge R² per il numero di predittori nel modello. È utile per confrontare modelli con numeri diversi di predittori.
- Root Mean Squared Error (RMSE): l’RMSE misura l’ampiezza media degli errori nelle previsioni del modello, con le stesse unità della variabile dipendente. Un RMSE più basso indica migliori prestazioni predittive.
- Mean Absolute Error (MAE): il MAE misura l’ampiezza media degli errori nelle previsioni del modello, ma a differenza dell’RMSE, non penalizza tanto gli errori grandi. È più facile da interpretare perché ha le stesse unità della variabile dipendente.
Queste metriche possono essere calcolate facilmente in Python usando statsmodels o scikit-learn:
from sklearn.metrics import mean_squared_error, mean_absolute_error, r2_score
import numpy as np

# Make predictions using the model
y_pred = model.predict(X)

# R-squared
r_squared = r2_score(y, y_pred)
print("R-squared:", r_squared)

# Adjusted R-squared (calculated manually)
n = len(y)  # number of data points
p = X.shape[1] - 1  # number of predictors (excluding intercept)
adj_r_squared = 1 - (1 - r_squared) * (n - 1) / (n - p - 1)
print("Adjusted R-squared:", adj_r_squared)

# RMSE
rmse = np.sqrt(mean_squared_error(y, y_pred))
print("Root Mean Squared Error (RMSE):", rmse)

# MAE
mae = mean_absolute_error(y, y_pred)
print("Mean Absolute Error (MAE):", mae)
Valutando queste metriche, ottieni insight su accuratezza del modello, bontà dell’adattamento e capacità del modello di generalizzare a nuovi dati.
Migliorare il tuo modello di regressione
Dopo aver valutato il tuo modello di regressione lineare, il passo successivo è esplorare modi per migliorarne le prestazioni. Un approccio comune è tramite trasformazioni delle feature, che possono affrontare relazioni non lineari e aiutare il modello a catturare meglio i pattern sottostanti nei dati.
Trasformazioni delle feature
Ricorda che, nella regressione lineare, il modello assume una relazione lineare tra le variabili indipendenti (predittori) e la variabile dipendente. Tuttavia, molti dataset reali presentano relazioni non lineari che un semplice modello lineare potrebbe non catturare bene. Applicando trasformazioni delle feature, come trasformazioni logaritmiche o radice quadrata, puoi talvolta migliorare le prestazioni del modello.
Trasformazione logaritmica
È spesso usata quando una feature mostra crescita esponenziale o ha valori positivi molto grandi. Ad esempio, trasformare dati di reddito altamente asimmetrici (dove pochi redditi molto alti dominano) può rendere la distribuzione più normale.
import numpy as np
df['log_income'] = np.log(df['income'] + 1)  # +1 to avoid log(0)
Trasformazione a radice quadrata
È utile per feature che seguono una relazione quadratica. Ad esempio, una feature che rappresenta conteggi (come il numero di visite a un sito web) può beneficiare di una trasformazione a radice quadrata.
df['sqrt_visits'] = np.sqrt(df['visits'])Trasformando queste feature, aiuti il modello a catturare meglio relazioni che prima venivano perse dall’approccio lineare. La chiave è testare diverse trasformazioni e osservare l’effetto sulle prestazioni del modello. Non esiste una soluzione valida per tutti i casi e richiede test empirici.
Normalizzazione e standardizzazione
Oltre alle trasformazioni delle feature, è anche importante comprendere l’impatto di normalizzazione e standardizzazione sul tuo modello di regressione, soprattutto quando lavori con feature che hanno unità o scale diverse. La normalizzazione riscalava i valori delle feature in un intervallo, tipicamente [0, 1]. La standardizzazione riscalava le feature in modo che abbiano media 0 e deviazione standard 1.
Quando hai più predittori, normalizzare o standardizzare i dati aiuta a interpretare i coefficienti in modo più significativo. Cioè, a mostrare quanto ogni variabile predittiva contribuisce alla variabile dipendente rispetto agli altri predittori. Questo è particolarmente utile quando i predittori sono su scale diverse.
Conclusione
Sviluppare una solida comprensione della regressione lineare richiede pratica continua ed esplorazione. Per approfondire, valuta di imparare di più su gestione della multicollinearità, eteroscedasticità e tecniche di regolarizzazione come la regressione Ridge e Lasso. Rafforzare la comprensione di decomposizione QR e variance inflation factor può migliorare anche la diagnostica del modello. Inoltre, comprendere la normalizzazione vs. standardizzazione può affinare le scelte di scaling delle feature.