
{count, plural, one {Kursus} other {Kursus}}
Aljabar Linear untuk Data Science di R
{hours} jam
21.8K
Pernahkah Anda bertanya-tanya bagaimana komputer sebenarnya menghitung fungsi seperti sin(x) atau eˣ?
Komputer tidak dapat langsung mengevaluasi sebagian besar fungsi matematika. Komputer hanya bisa menjumlah, mengurang, mengali, dan membagi. Jadi saat Anda memanggil math.sin(0.5) di Python, sesuatu harus mengonversinya menjadi rangkaian operasi aritmetika dasar. Sesuatu itu adalah aproksimasi polinomial, dan deret Taylor adalah fondasi matematis di baliknya.
Deret Taylor memungkinkan Anda menulis ulang hampir semua fungsi mulus sebagai jumlah tak hingga dari suku-suku yang lebih sederhana, masing-masing dibangun dari turunan fungsi di satu titik. Setelah Anda memahami gagasan ini, banyak hal dalam data science dan machine learning mulai terasa masuk akal — dari cara kerja gradient descent hingga alasan perilaku fungsi aktivasi tertentu.
Dalam artikel ini, saya akan memandu Anda memahami apa itu deret Taylor, bagaimana cara kerjanya secara matematis, di mana ia muncul dalam data science dan machine learning, serta bagaimana keterkaitannya dengan jenis deret lain yang akan Anda temui.
Deret Taylor sudah ada selama berabad-abad. Brook Taylor memperkenalkannya pada tahun 1715, meskipun James Gregory dan Colin Maclaurin juga memberi kontribusi penting pada gagasan ini.
Tujuannya adalah menemukan cara merepresentasikan fungsi kompleks menggunakan polinom, yang jauh lebih mudah dikerjakan.
Deret Taylor mengaproksimasi sebuah fungsi dengan mengekspresikannya sebagai jumlah tak hingga dari suku-suku yang masing-masing diturunkan dari turunan fungsi di satu titik. Semakin banyak suku yang Anda sertakan, semakin dekat aproksimasi tersebut dengan fungsi aslinya.
Rumus umumnya adalah sebagai berikut:
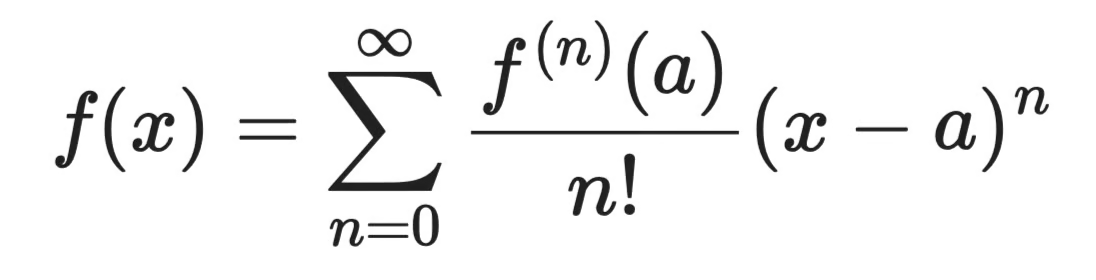
Rumus umum deret Taylor
Tiga komponen membentuk setiap suku dalam jumlah ini:
f⁽ⁿ⁾(a) - turunan ke-n dari fungsi yang dievaluasi di titik pusat a
n! - faktorial dari n, yang mencegah suku-suku tumbuh tak terkendali
(x - a)ⁿ - suku pengembangan, yang mengukur seberapa jauh x dari titik pusat
Titik pusat a adalah tempat Anda menambatkan deret. Ketika a = 0, Anda mendapatkan kasus khusus yang disebut deret Maclaurin — lebih lanjut tentang itu nanti.
Fungsi eksponensial eˣ adalah contoh pertama yang sempurna. Turunannya adalah dirinya sendiri, sehingga f⁽ⁿ⁾(0) = 1 untuk setiap n. Dipusatkan di a = 0, deret Taylor menjadi:
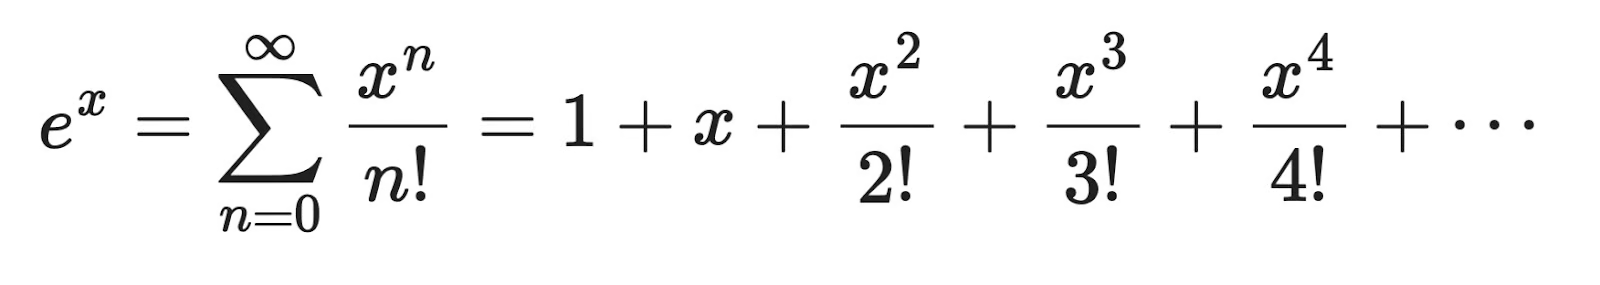
Contoh konkret
Misalkan Anda ingin mengaproksimasi e⁰·⁵. Cukup masukkan x = 0.5 ke empat suku pertama — berikut contoh Python:
x = 0.5
approx = 1 + x + x**2/2 + x**3/6
print(approx)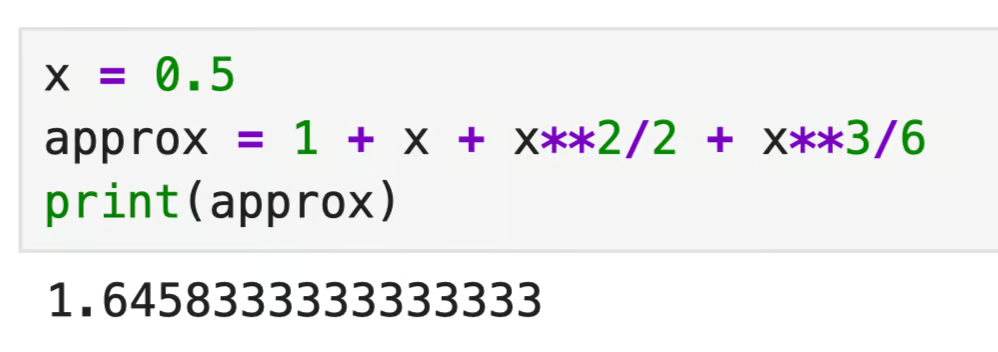
Contoh konkret di Python
Nilai sebenarnya dari e⁰·⁵ kira-kira 1.6487. Hanya dengan empat suku, Anda sudah berada dalam 0,2% dari jawaban sebenarnya. Tambahkan lebih banyak suku, dan aproksimasi menjadi semakin ketat.
Itulah kekuatan deret Taylor.
Fungsi seperti eˣ, sin(x), dan cos(x) sulit dievaluasi secara langsung, tetapi deret Taylor mereduksinya menjadi aritmetika dasar. Inilah yang bisa dikerjakan komputer.
Deret Taylor hanya berguna jika benar-benar konvergen ke fungsi yang Anda coba aproksimasi. Mari kita lihat apa artinya itu dan apa yang terjadi ketika tidak konvergen.
Saat Anda mengekspansi deret Taylor, Anda membangun sebuah polinom satu suku demi satu. Setiap suku menambah informasi tentang perilaku fungsi di dekat titik pusat a.
Ambil sin(x) yang dipusatkan di a = 0:
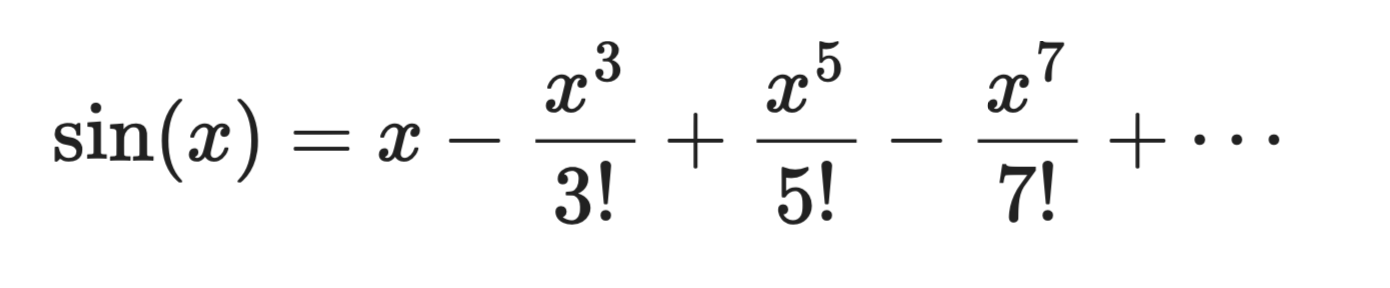
Ekspansi deret Taylor
Suku pertama, x, adalah aproksimasi linear yang kasar. Tambahkan suku kedua dan kurvanya makin mendekat. Tambahkan lebih banyak suku, dan polinom mulai terlihat persis seperti sin(x) di dekat x = 0.
Secara sederhana, ekspansi berarti Anda menukar fungsi yang tepat tetapi sulit dihitung dengan polinom yang benar-benar bisa Anda kerjakan.
Anda tidak akan pernah menghitung suku tak hingga. Dalam praktiknya, Anda berhenti setelah beberapa suku dan menerima galat kecil. Hasilnya disebut deret Taylor terpangkas (truncated), dan galat yang ditimbulkannya disebut galat pemangkasan (truncation error).
Sisa Lagrange memberi Anda batas atas untuk galat tersebut. Untuk deret yang dipangkas setelah n suku:
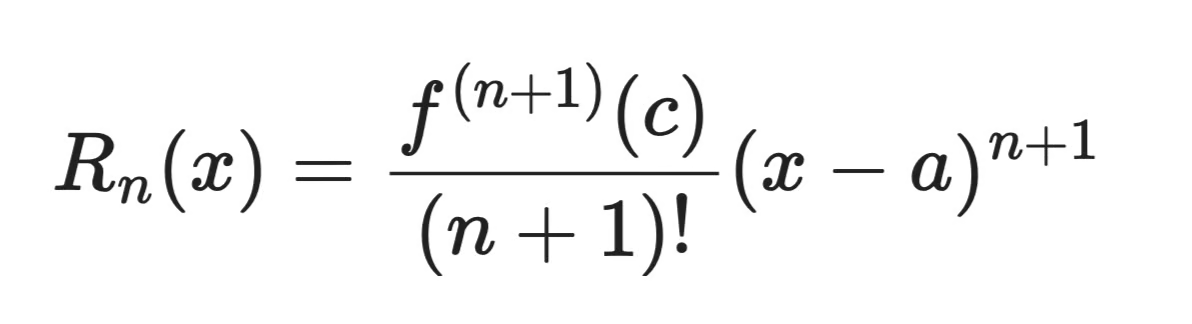
Sisa Lagrange
Di mana c adalah suatu titik antara x dan a. Anda tidak tahu c secara tepat, tetapi Anda bisa membatasi f⁽ⁿ⁺¹⁾(c) jika Anda mengetahui seberapa besar turunan-turunan fungsi Anda dapat menjadi.
Berikut cara menafsirkannya
Semakin jauh x dari titik pusat a, semakin besar galatnya
Semakin banyak suku yang Anda sertakan, semakin kecil galatnya
Fungsi dengan turunan yang besar dan cepat tumbuh lebih sulit untuk diaproksimasi secara akurat
Misalkan Anda mengaproksimasi sin(0.1) dengan tiga suku:
x = 0.1
approx = x - x**3/6 + x**5/120
print(approx)
print(np.sin(0.1)) 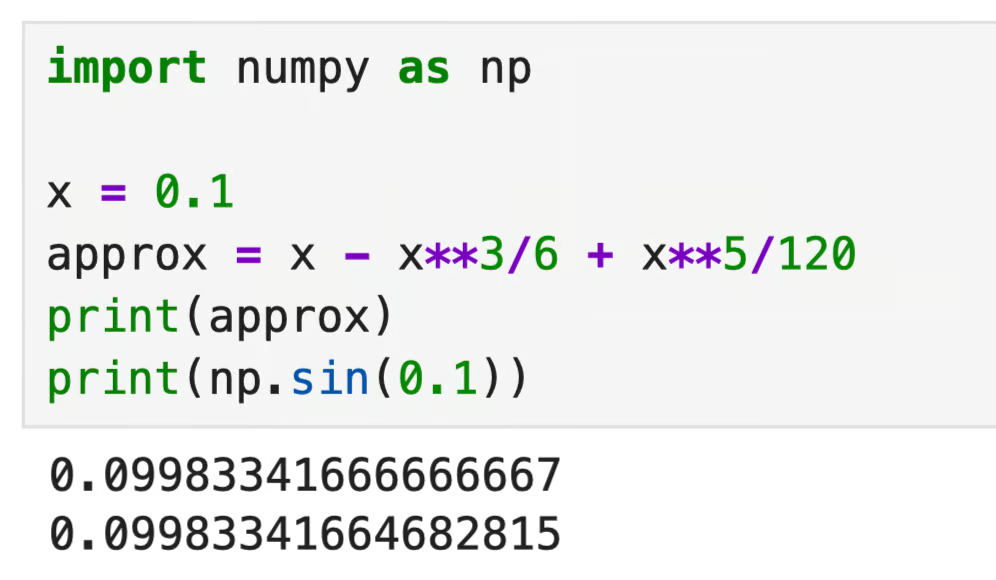
Aproksimasi di Python
Tiga suku memberi Anda ketelitian hingga sepuluh angka desimal saat x dekat dengan 0. Itulah galat pemangkasan dalam aksi — kecil, tetapi tidak nol.
Deret Taylor dikatakan konvergen di suatu titik x jika jumlah parsialnya semakin mendekati suatu nilai tetap saat Anda menambahkan lebih banyak suku. Nilai tetap itu seharusnya f(x) — tetapi itu tidak selalu terjamin.
Jari-jari konvergensi R memberi tahu Anda seberapa jauh dari titik pusat deret tetap valid. Di dalam jari-jari itu, deret konvergen. Di luar itu, suku-suku tumbuh alih-alih menyusut, dan aproksimasi runtuh.
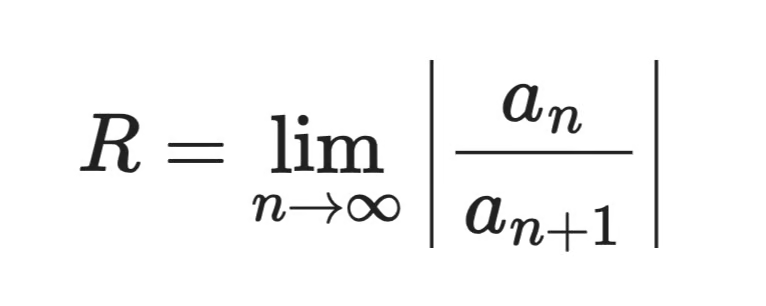
Rumus konvergensi
Fungsi yang berbeda memiliki jari-jari yang berbeda:
eˣ, sin(x), dan cos(x) konvergen untuk semua nilai x, sehingga R = ∞
ln(1 + x) hanya konvergen untuk -1 < x <= 1, sehingga R = 1
1/1-x konvergen untuk |x| < 1, sehingga R = 1
Sebuah fungsi juga dapat memiliki jari-jari konvergensi tak hingga namun tetap gagal sama dengan deret Taylornya pada titik-titik tertentu. Ini disebut fungsi non-analitik, dan ini adalah kasus tepi yang layak diketahui, meskipun jarang Anda temui dalam data science.
Jadi, selalu periksa apakah x berada dalam jari-jari konvergensi sebelum mempercayai aproksimasi Taylor.
Deret Taylor muncul di lebih banyak tempat daripada yang Anda kira — dari simulasi fisika hingga penyelesaian persamaan diferensial. Namun dampak terbesarnya dalam pekerjaan sehari-hari Anda sebagai data scientist adalah dalam optimisasi dan aproksimasi model.
Setiap kali Anda melatih model machine learning, Anda menjalankan suatu bentuk optimisasi. Dan deret Taylor sering berada di balik optimisasi tersebut
Gradient descent menggunakan aproksimasi Taylor orde pertama. Saat Anda menghitung gradien dari fungsi rugi L(θ) pada parameter saat ini θ, pada dasarnya Anda bertanya: "jika saya bergerak selangkah kecil ke arah ini, seberapa besar perubahan loss?" Itu adalah ekspansi Taylor orde pertama di sekitar titik saat ini:
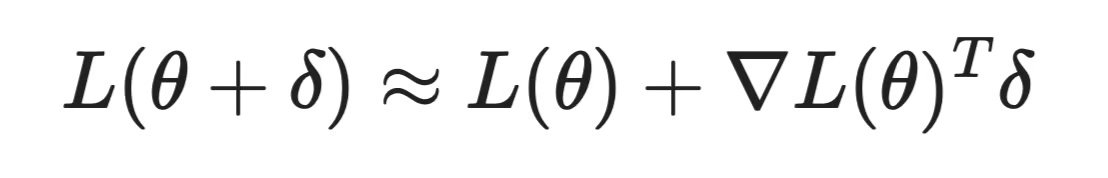
Deret Taylor dalam optimisasi
Ini berhasil, tetapi mengabaikan kelengkungan. Jika permukaan loss melengkung, aproksimasi orde pertama bisa melampaui atau mengambil langkah yang tidak efisien.
Metode Newton memperbaiki ini dengan memasukkan suku orde kedua — matriks Hessian H, yang melacak kelengkungan:
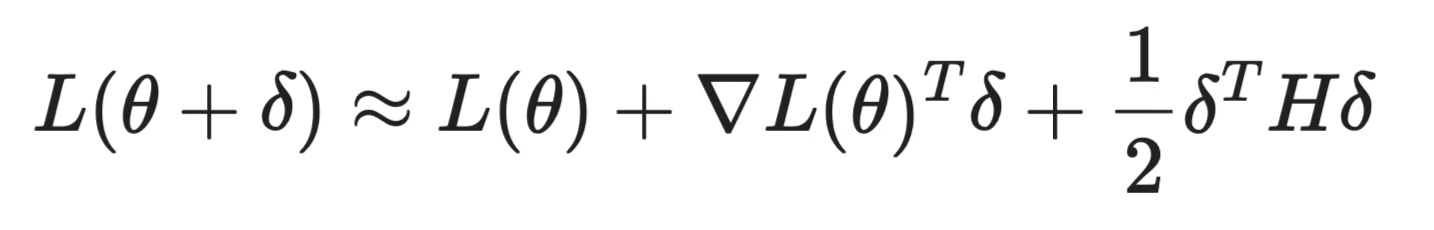
Deret Taylor dalam optimisasi (2)
Menyetel turunan dari ekspresi ini ke nol memberi Anda langkah optimal yang harus diambil. Komprominya adalah menghitung Hessian penuh mahal untuk model besar. Metode seperti L-BFGS mengaproksimasi Hessian, yang memberi sebagian besar manfaat dengan sebagian kecil biaya.
Beberapa fungsi aktivasi mahal untuk dihitung. Deret Taylor memberi Anda alternatif yang lebih murah namun cukup akurat untuk sebagian besar tujuan.
Fungsi sigmoid σ(x) = 1 / (1 + e⁻ˣ) memerlukan perhitungan eksponensial, yang mahal. Di dekat x = 0, ekspansi Taylornya adalah:
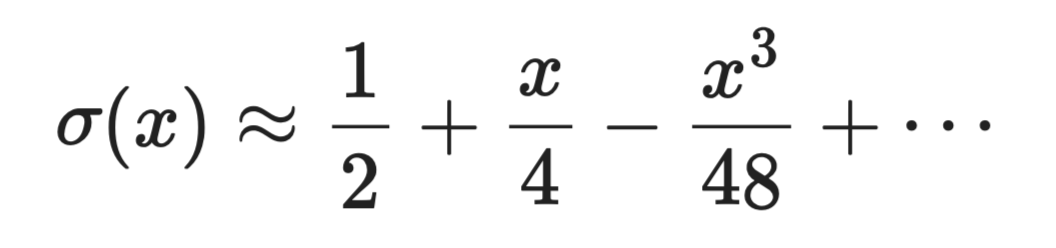
Deret Taylor dalam aproksimasi
Untuk lingkungan dengan keterbatasan perangkat keras seperti perangkat edge atau FPGA, aproksimasi polinomial seperti ini dapat menggantikan perhitungan eksak dengan beberapa operasi kali-tambah.
GELU, yang digunakan dalam model transformer seperti BERT dan GPT, sering diimplementasikan melalui aproksimasi berbasis Taylor dari fungsi galat erf(x), karena bentuk eksaknya melibatkan integral tanpa solusi bentuk tertutup.
XGBoost adalah salah satu pustaka gradient boosting yang paling banyak digunakan dan menggunakan ekspansi Taylor orde kedua dari fungsi rugi untuk menyesuaikan setiap pohon baru.
Pada setiap langkah boosting, XGBoost mengaproksimasi loss sebagai:
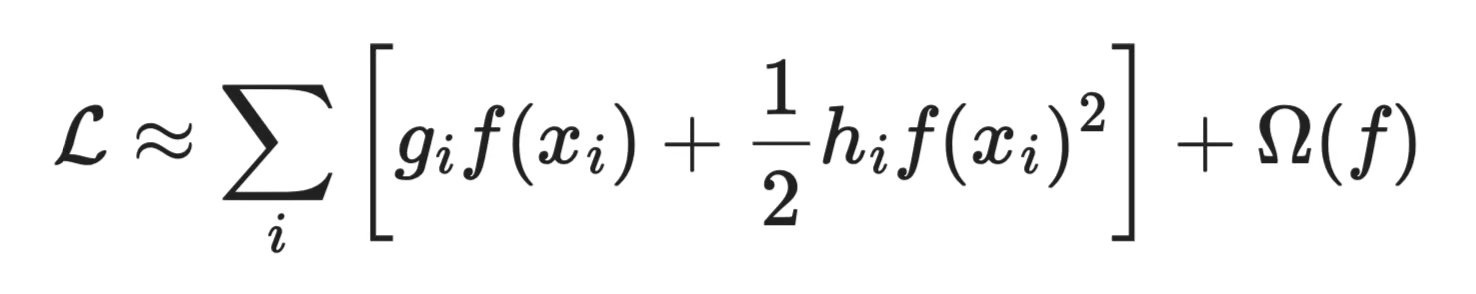
Aproksimasi loss XGBoost
Di mana g_i adalah gradien orde pertama dan h_i adalah gradien orde kedua (Hessian) dari loss terhadap prediksi saat ini. Penggunaan kedua suku memungkinkan XGBoost menyesuaikan pohon lebih cepat dan lebih akurat daripada metode orde pertama, yang menjadi alasan utama kinerjanya sangat baik pada data tabular.
Hanya karena deret Taylor bisa digunakan di mana-mana dalam data science, bukan berarti ia menjadi palu metaforis untuk setiap paku yang Anda lihat. Ada beberapa hal yang bisa salah.
Galat aproksimasi terakumulasi: Dalam jaringan dalam, Anda merangkai banyak operasi. Galat aproksimasi Taylor kecil pada satu lapisan akan berganda di seluruh lapisan, yang dapat memengaruhi stabilitas pelatihan
Jari-jari konvergensi itu penting: Aproksimasi Taylor hanya andal di dekat titik pengembangan. Jika masukan Anda menyimpang jauh dari tempat aproksimasi dibangun — misalnya, saat inferensi pada data di luar distribusi — aproksimasi dapat rusak
Hessian berdimensi tinggi itu mahal: Metode orde kedua itu kuat namun tidak skala dengan baik. Model dengan n parameter memiliki Hessian berukuran n × n. Untuk model dengan jutaan parameter, menyimpan dan membalik matriks itu tidak praktis tanpa aproksimasi.
Jika Anda memahami kompromi ini, Anda akan tahu kapan pendekatan berbasis Taylor layak diterapkan dan kapan metode orde pertama yang lebih sederhana sudah cukup.
Beberapa deret Taylor muncul di mana-mana dalam matematika, fisika, dan machine learning. Inilah yang layak diketahui jika Anda serius di bidang data science.
Fungsi eksponensial eˣ adalah deret Taylor tersederhana untuk diturunkan, karena setiap turunannya dari eˣ adalah eˣ itu sendiri. Dievaluasi pada a = 0, setiap koefisiennya 1:
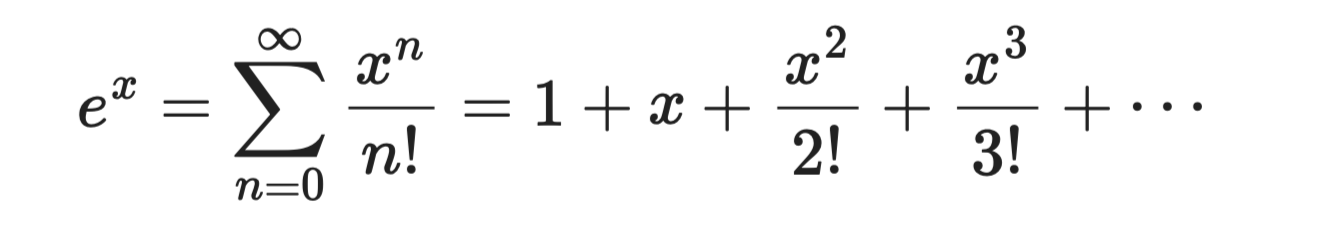
Fungsi eksponensial
Deret ini konvergen untuk semua nilai x, yang membuatnya andal dan mudah digunakan. Ini adalah fondasi bagi fungsi sigmoid dan softmax yang digunakan dalam model klasifikasi.
Fungsi sinus hanya berisi pangkat ganjil, sesuai dengan fakta bahwa sin(x) adalah fungsi ganjil — artinya sin(-x) = -sin(x):
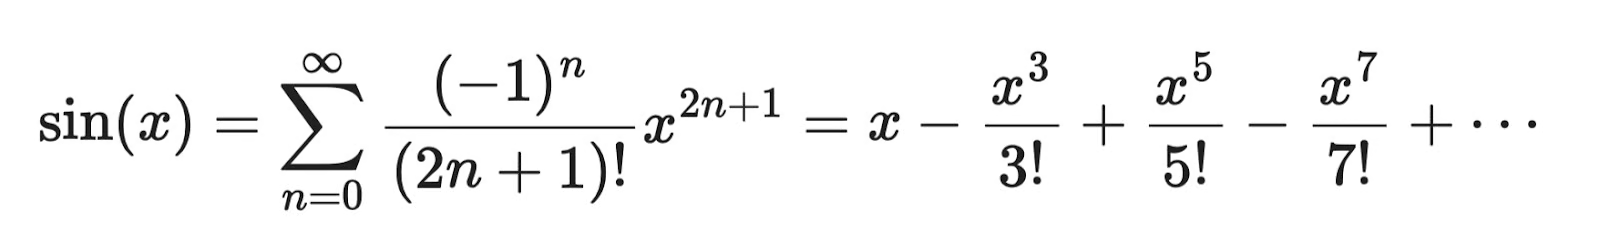
Fungsi sinus
Seperti eˣ, ini konvergen untuk semua x. Tanda yang berganti-ganti berasal dari fakta bahwa turunan sin(x) berputar melalui cos(x), -sin(x), -cos(x), dan kembali lagi.
Kosinus adalah pasangan genap dari sinus — hanya berisi pangkat genap:
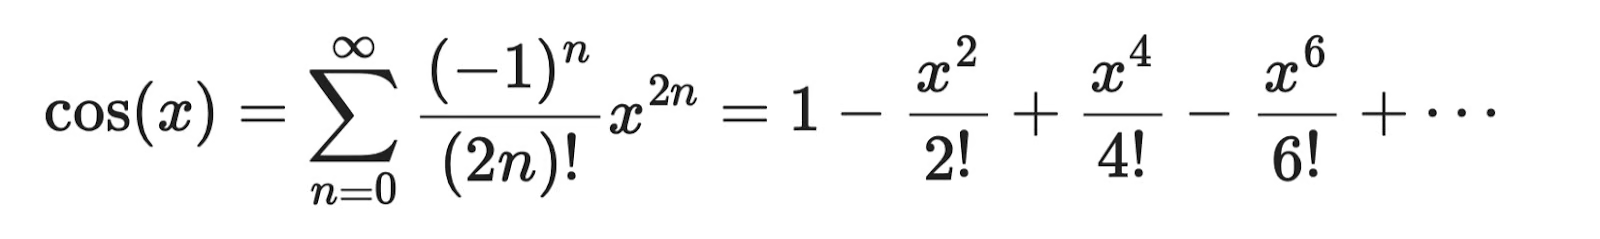
Fungsi kosinus
Jika Anda melihat deret sinus dan kosinus bersama-sama, Anda akan melihat keduanya saling melengkapi. Hubungan ini mengarah pada identitas terkenal Euler: eⁱˣ = cos(x) + i·sin(x).
Logaritma natural ln(1 + x) memiliki deret Taylor yang dipusatkan di x = 0:
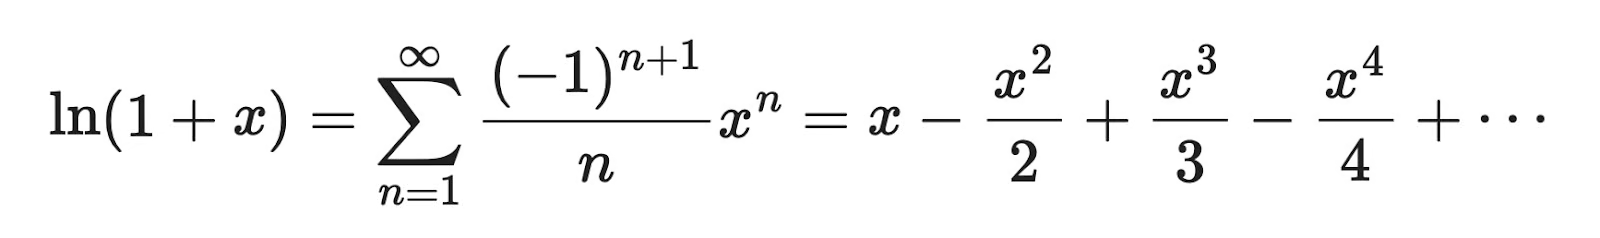
Fungsi logaritma natural
Berbeda dengan tiga sebelumnya, yang ini hanya konvergen untuk -1 < x <= 1. Jika Anda mendorong x keluar dari rentang itu, deretnya divergen. Ini muncul dalam loss entropi silang, di mana log probabilitas harus tetap dalam rentang yang valid.
Deret geometri adalah salah satu hasil tertua dan paling sering digunakan dalam matematika:
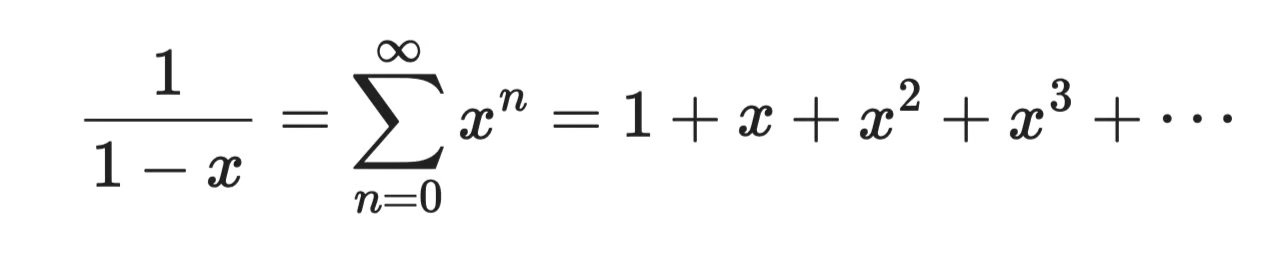
Deret geometri
Ini hanya konvergen untuk |x| < 1. Ini adalah titik awal untuk menurunkan banyak deret Taylor lain, dan muncul dalam teori probabilitas, pemrosesan sinyal, dan di mana pun Anda menjumlahkan nilai masa depan yang didiskonto.
Jika Anda mencari sesuatu yang nyata, dapat dicetak, untuk ditempel di dinding sebelah tempat tidur Anda, saya punya untuk Anda:
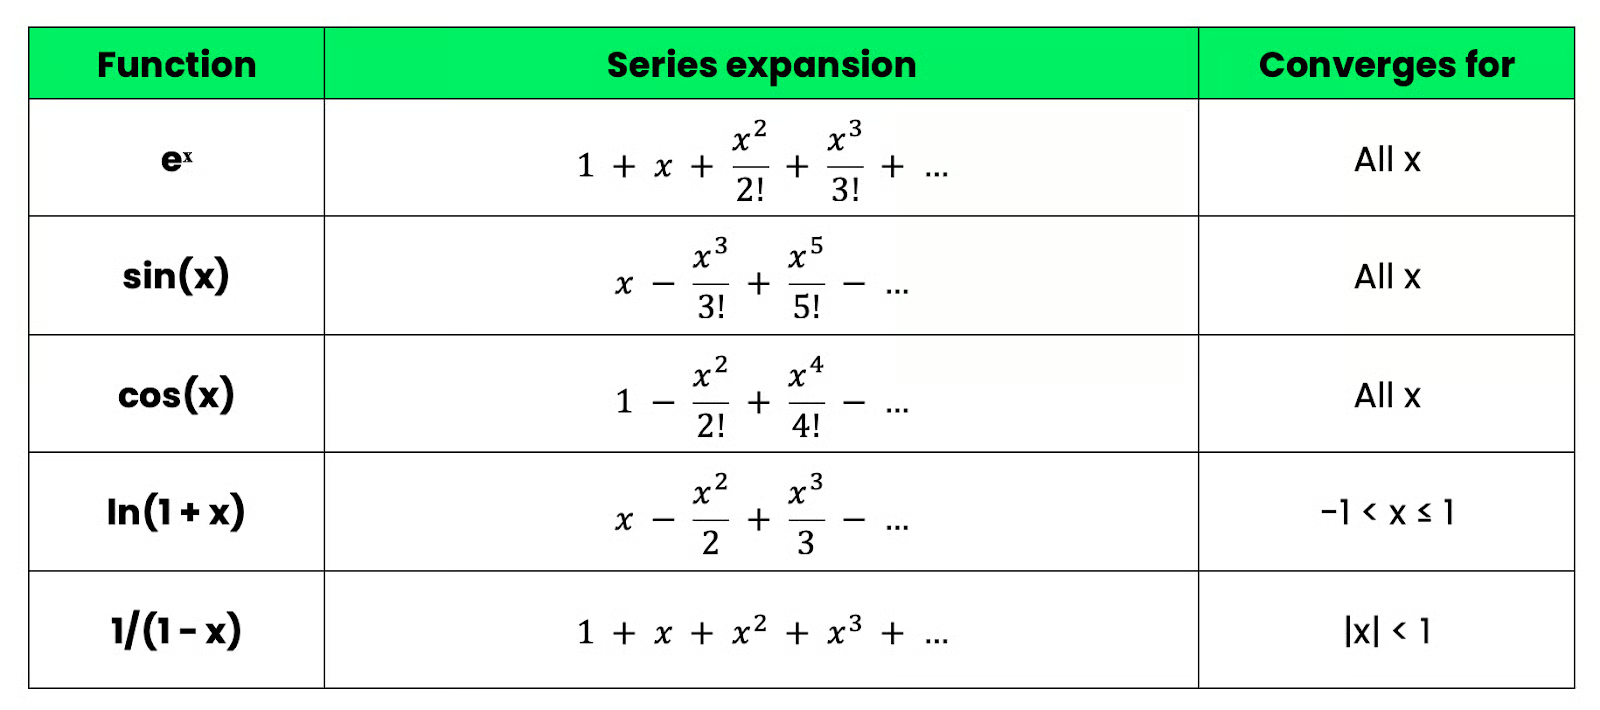
Referensi cepat deret Taylor
Lima deret ini mencakup sebagian besar kasus yang akan Anda temui dalam data science dan machine learning.
Taylor, Fourier, dan Maclaurin semuanya mengaproksimasi fungsi, tetapi mereka menyelesaikan masalah yang berbeda dan paling baik digunakan dalam konteks yang berbeda.
Deret Taylor dan Fourier sama-sama merepresentasikan fungsi sebagai jumlah tak hingga, tetapi mereka melakukannya dengan cara yang benar-benar berbeda.
Deret Taylor membangun fungsi dari polinom — pangkat dari (x - a). Ia bekerja dengan memperbesar satu titik dan menangkap perilaku lokal fungsi melalui turunannya. Hasilnya akurat di dekat titik pusat a, tetapi akurasinya menurun saat Anda menjauh.
Deret Fourier menggunakan sinus dan kosinus sebagai blok pembangun:
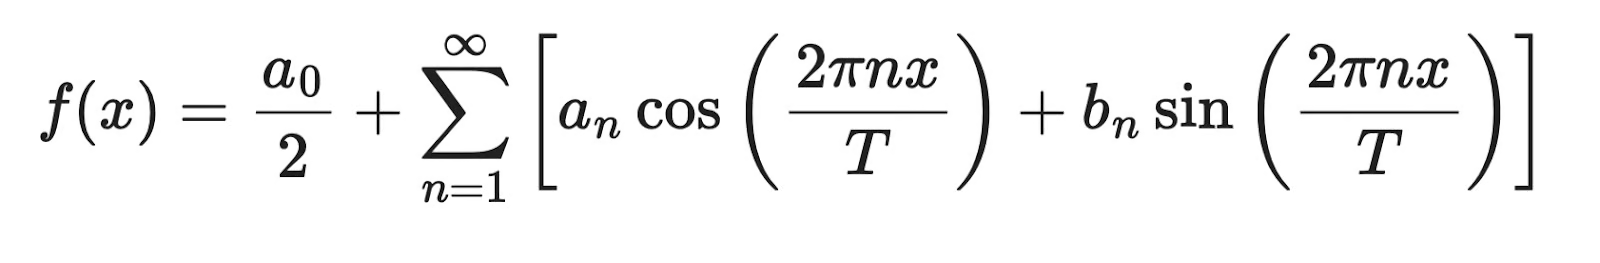
Deret Fourier
Alih-alih menangkap perilaku lokal di satu titik, deret Fourier menangkap perilaku periodik global di seluruh suatu interval. Deret ini dirancang untuk fungsi yang berulang — pikirkan sinyal audio, pola musiman, atau apa pun yang berosilasi.
Berikut perbandingan keduanya secara berdampingan:
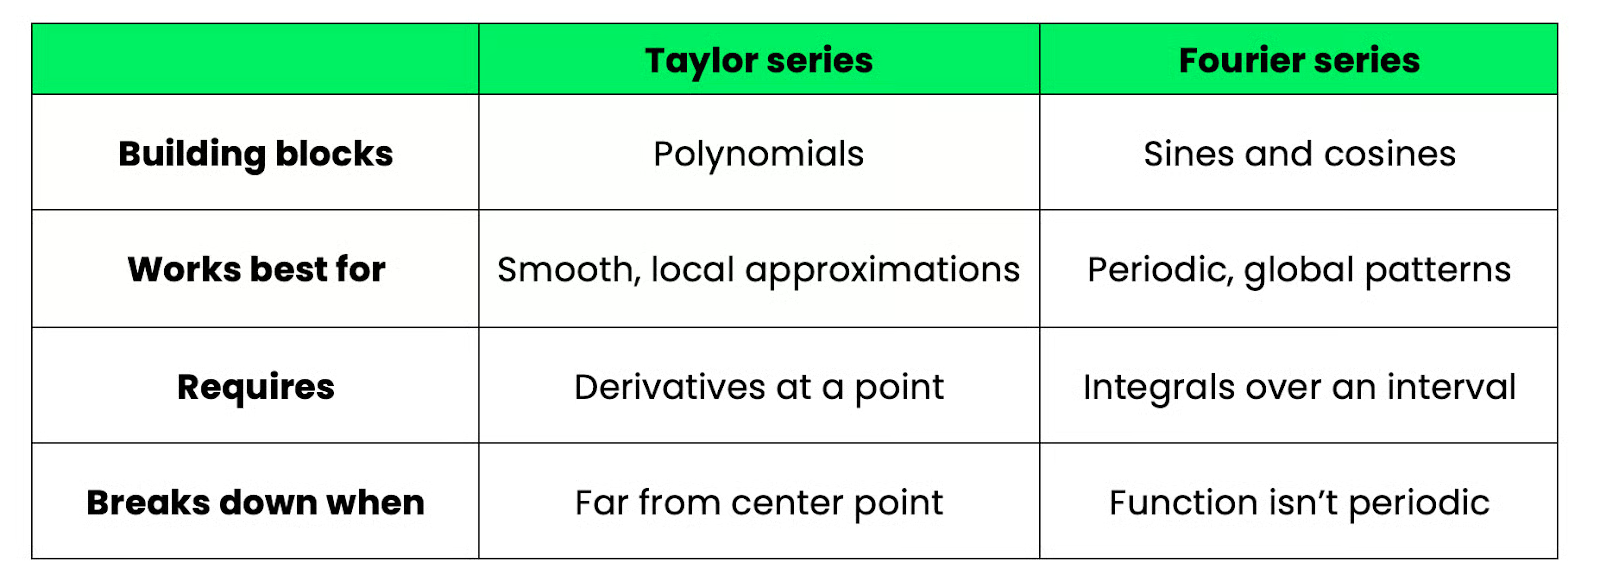
Perbandingan Taylor vs. Fourier
Deret Fourier muncul dalam pemrosesan sinyal dan analisis deret waktu — analisis spektral, dekomposisi frekuensi, dan bahkan beberapa arsitektur neural seperti FNet, yang menggantikan attention dengan transformasi Fourier.
Jika Anda bekerja dengan data tabular, gambar, atau optimisasi, deret Taylor adalah alat yang lebih relevan. Jika Anda bekerja dengan audio, deret waktu, atau apa pun dengan struktur periodik, deret Fourier lebih cocok.
Yang ini sederhana. Deret Maclaurin hanyalah deret Taylor yang dipusatkan di a = 0.
Rumus umum deret Taylor adalah:
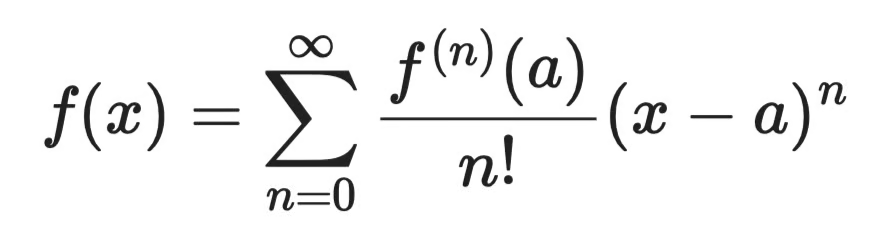
Deret Maclaurin
Tetapkan a = 0 dan Anda mendapatkan:
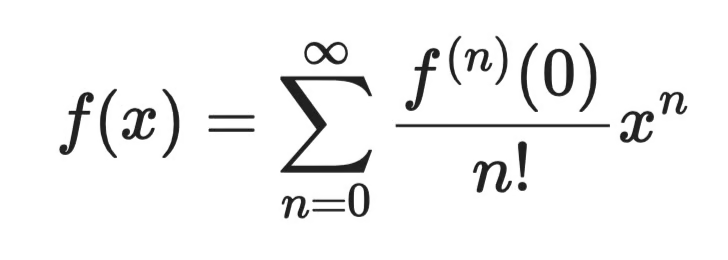
Deret Maclaurin pada a = 0
Colin Maclaurin begitu sering menggunakan kasus khusus ini dalam karyanya sehingga mendapatkan namanya sendiri, tetapi secara matematis ini tidak lebih dari deret Taylor pada titik pusat tertentu.
Dalam praktiknya, sebagian besar deret yang akan Anda lihat — eˣ, sin(x), cos(x), ln(1 + x) — adalah deret Maclaurin, karena memusatkan di nol membuat aljabarnya rapi. Saat Anda perlu mengaproksimasi fungsi di dekat titik lain, Anda menggeser pusat ke a ≠ 0 dan mendapatkan deret Taylor umum.
Sebagai penutup, setiap deret Maclaurin adalah deret Taylor, tetapi tidak setiap deret Taylor adalah deret Maclaurin.
Deret Taylor dan model linear mungkin tampak tidak terkait pada awalnya, tetapi ada keterkaitan yang layak diketahui, dan itu dimulai dengan aproksimasi Taylor orde pertama.
Saat Anda memangkas deret Taylor setelah suku pertama, Anda mendapatkan aproksimasi linear dari suatu fungsi di dekat titik a:
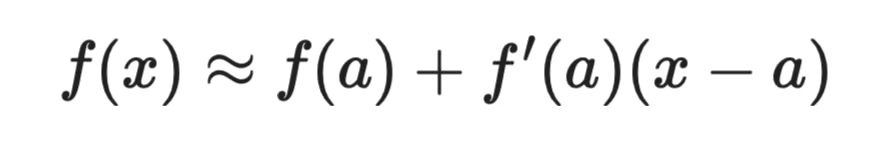
Deret Taylor dan model linear (1)
Ini adalah garis lurus. Ia memiliki kemiringan (f'(a)) dan intersep (f(a) - f'(a) ⋅ a). Kedengarannya familiar? Itu struktur yang sama dengan model regresi linear sederhana:
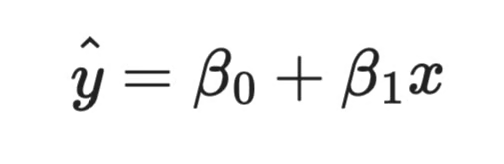
Deret Taylor dan model linear (2)
Perbedaannya adalah asal-usul masing-masing. Dalam aproksimasi Taylor, kemiringan dan intersep ditentukan oleh turunan fungsi di satu titik. Dalam regresi linear, keduanya diestimasi dari data untuk meminimalkan galat prediksi. Namun secara struktural, keduanya melakukan hal yang sama.
Ini menjelaskan mengapa model linear bekerja dengan baik dalam situasi tertentu dan gagal dalam situasi lain.
Regresi linear mengasumsikan hubungan antara masukan dan keluaran Anda adalah — atau dapat diperlakukan sebagai — linear. Deret Taylor memberi tahu Anda tepat kapan asumsi itu berlaku — ketika masukan Anda tetap dekat dengan suatu titik tetap, dan fungsi yang Anda aproksimasi mulus. Jika Anda mendorong masukan jauh dari titik itu, aproksimasi linear menjadi rusak, yang merupakan alasan yang sama mengapa regresi linear sering gagal pada data dengan pola nonlinier yang kuat.
Model linear umum (GLM) membuat keterkaitan ini semakin eksplisit.
Regresi logistik, misalnya, memodelkan log-odds dari suatu keluaran sebagai fungsi linear. Keterkaitan antara prediktor linear dan probabilitas keluaran melewati fungsi sigmoid — dan seperti yang Anda lihat sebelumnya, sigmoid memiliki ekspansi Taylor yang tertib di dekat nol.
Setelah Anda memahami bahwa ekspansi Taylor orde pertama memberi Anda model linear, langkah berikutnya adalah memasukkan lebih banyak suku, dan Anda mendapatkan model polinomial.
Ekspansi Taylor orde kedua memberi Anda:
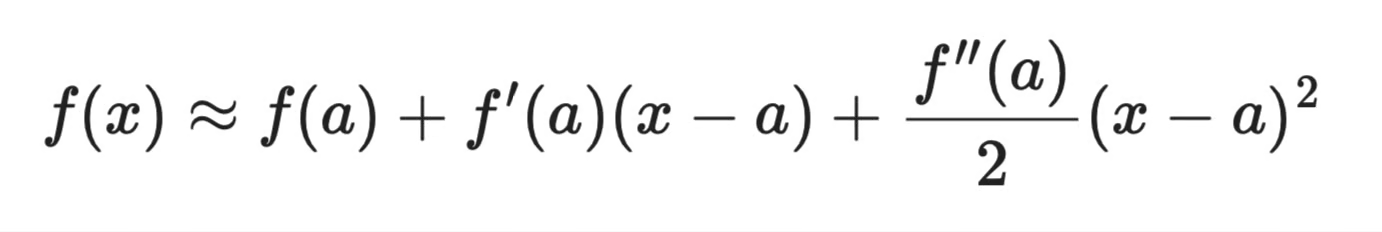
Deret Taylor orde kedua
Ini adalah kuadratik — model regresi polinomial dengan suku kuadrat. Setiap suku Taylor tambahan sesuai dengan polinom berderajat lebih tinggi, yang merupakan cara regresi polinomial memperluas regresi linear untuk menangkap hubungan melengkung.
Jadi deret Taylor memberi Anda cara berprinsip untuk memikirkan trade-off bias-variance dalam regresi. Aproksimasi orde pertama (model linear) cepat dan mudah diinterpretasikan tetapi memiliki bias tinggi jika hubungan sebenarnya nonlinier. Aproksimasi orde lebih tinggi lebih pas dengan data di dekat titik pengembangan tetapi berisiko overfitting saat Anda menambah suku.
Jika Anda ingin mendalami regresi linear dan kapan ia bekerja, tutorial Essentials of Linear Regression in Python adalah langkah lanjutan yang bagus. Untuk pengguna R, kursus Intermediate Regression in R membahas regresi polinomial dan diagnostik model secara mendalam.
Deret Taylor adalah salah satu alat matematika yang akan terus bermunculan setelah Anda tahu apa yang harus dicari.
Anda telah melihat bagaimana deret ini memungkinkan komputer mengevaluasi fungsi seperti eˣ dan sin(x) melalui aritmetika dasar, bagaimana konvergensi dan galat pemangkasan menentukan seberapa akurat suatu aproksimasi, dan bagaimana gagasan yang sama menggerakkan gradient descent, XGBoost, dan aproksimasi fungsi aktivasi dalam machine learning modern.
Lima deret yang dikenal luas — eksponensial, sinus, kosinus, logaritma, geometri — layak dihafal. Mereka cukup sering muncul sehingga mengenalinya sekilas akan menghemat waktu nyata.
Dari sini, langkah berikutnya adalah merasa nyaman dengan pola pikir algoritmik yang berjalan beriringan dengan jenis matematika seperti ini. Kursus Data Structures and Algorithms in Python kami adalah tempat yang solid untuk membangun fondasi itu. Kursus ini akan membantu Anda memahami bagaimana ide-ide matematis diterjemahkan ke dalam kode yang bekerja dan dapat diskalakan.
Belajar bersama DataCamp
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {blog} other {blogs}}
David Woods
13 mnt
{count, plural, one {blog} other {blogs}}
Hugo Bowne-Anderson
13 mnt
{count, plural, one {blog} other {blogs}}
Javier Canales Luna
14 mnt
{count, plural, one {blog} other {blogs}}
Dario Radečić
15 mnt




