
Corso
Algebra lineare per la Data Science in R
4 ore
21.8K
Ti sei mai chiesto come faccia un computer a calcolare realmente una funzione come sin(x) o eˣ?
I computer non possono valutare direttamente la maggior parte delle funzioni matematiche. Possono solo sommare, sottrarre, moltiplicare e dividere. Quindi, quando in Python chiami math.sin(0.5), qualcosa deve convertire tutto in una sequenza di operazioni aritmetiche di base. Quel qualcosa è l’approssimazione polinomiale, e le serie di Taylor ne sono il fondamento matematico.
Una serie di Taylor ti permette di riscrivere quasi ogni funzione regolare come una somma infinita di termini più semplici, ciascuno costruito dalle derivate della funzione in un singolo punto. Una volta capita l’idea, molte cose in data science e machine learning iniziano a quadrare: da come funziona il gradient descent al perché certe funzioni di attivazione si comportano in un certo modo.
In questo articolo, ti guiderò su cosa sono le serie di Taylor, come funzionano matematicamente, dove compaiono in data science e machine learning e come si relazionano ad altri tipi di serie che incontrerai.
Le serie di Taylor esistono da secoli. Brook Taylor le introdusse nel 1715, anche se James Gregory e Colin Maclaurin diedero contributi significativi all’idea.
L’obiettivo era trovare un modo per rappresentare funzioni complesse usando i polinomi, che sono molto più facili da trattare.
Una serie di Taylor approssima una funzione esprimendola come una somma infinita di termini, ognuno derivato dalle derivate della funzione in un singolo punto. Più termini includi, più l’approssimazione si avvicina alla funzione reale.
La formula generale è questa:
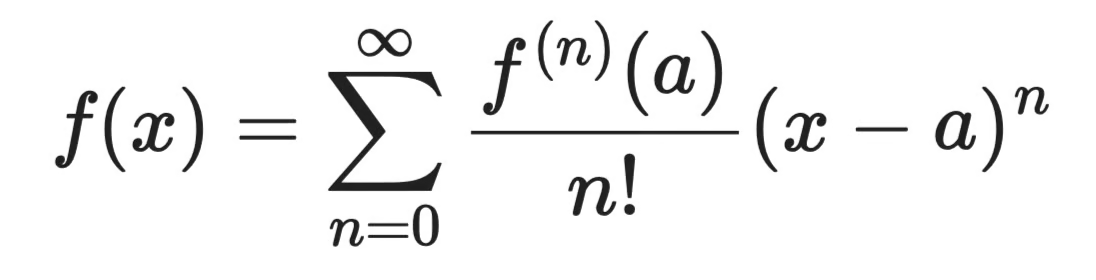
Formula generale della serie di Taylor
Ogni termine di questa somma ha tre componenti:
f⁽ⁿ⁾(a) - la n‑esima derivata della funzione valutata nel punto centrale a
n! - il fattoriale di n, che impedisce ai termini di crescere senza controllo
(x - a)ⁿ - il termine di espansione, che misura quanto x è distante dal punto centrale
Il punto centrale a è dove “ancori” la serie. Quando a = 0, ottieni un caso speciale chiamato serie di Maclaurin — ne parleremo più avanti.
La funzione esponenziale eˣ è un perfetto primo esempio. La sua derivata è se stessa, quindi f⁽ⁿ⁾(0) = 1 per ogni n. Centrata in a = 0, la serie di Taylor diventa:
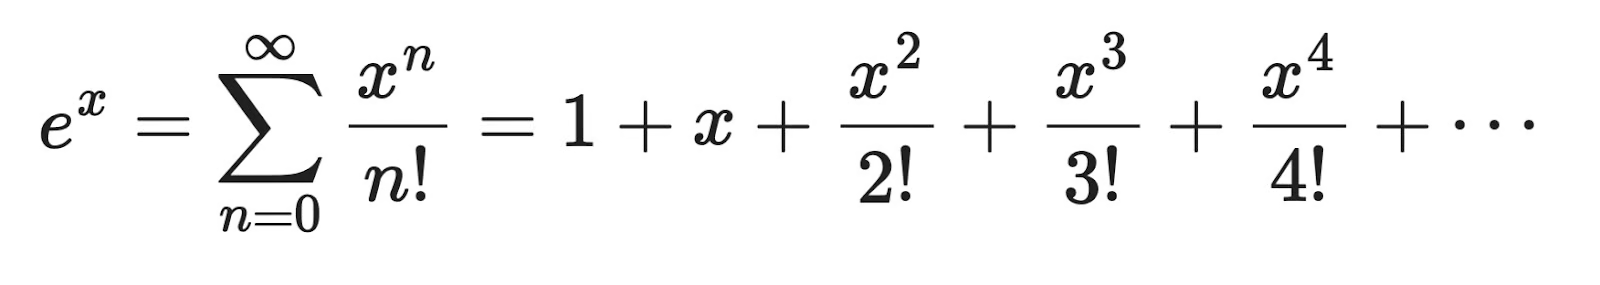
Esempio concreto
Diciamo che vuoi approssimare e⁰·⁵. Inserisci semplicemente x = 0.5 nei primi quattro termini: ecco un esempio in Python:
x = 0.5
approx = 1 + x + x**2/2 + x**3/6
print(approx)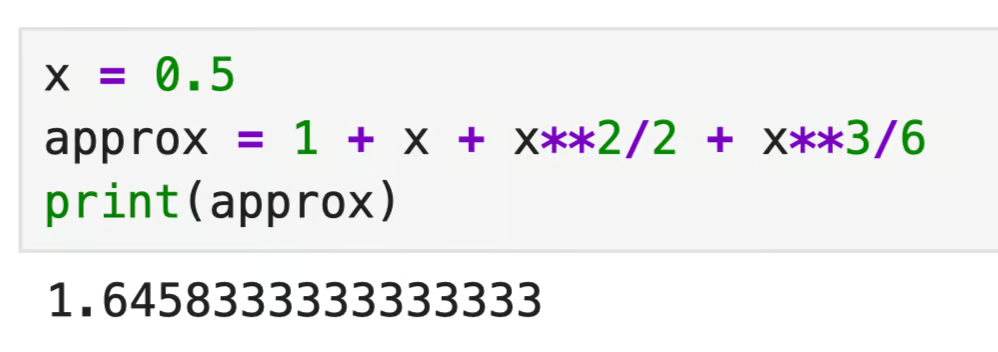
Esempio concreto in Python
Il valore reale di e⁰·⁵ è circa 1.6487. Con soli quattro termini sei già entro lo 0,2% dalla risposta esatta. Aggiungi altri termini e l’approssimazione diventa ancora più precisa.
Questa è la potenza delle serie di Taylor.
Funzioni come eˣ, sin(x) e cos(x) sono difficili da valutare direttamente, ma le loro serie di Taylor le riducono ad aritmetica di base. Esattamente ciò con cui un computer può lavorare.
Una serie di Taylor è utile solo se converge davvero alla funzione che stai cercando di approssimare. Vediamo cosa significa e cosa succede quando non accade.
Quando espandi una serie di Taylor, costruisci un polinomio un termine alla volta. Ogni termine aggiunge informazioni sul comportamento della funzione vicino al punto centrale a.
Prendi sin(x) centrata in a = 0:
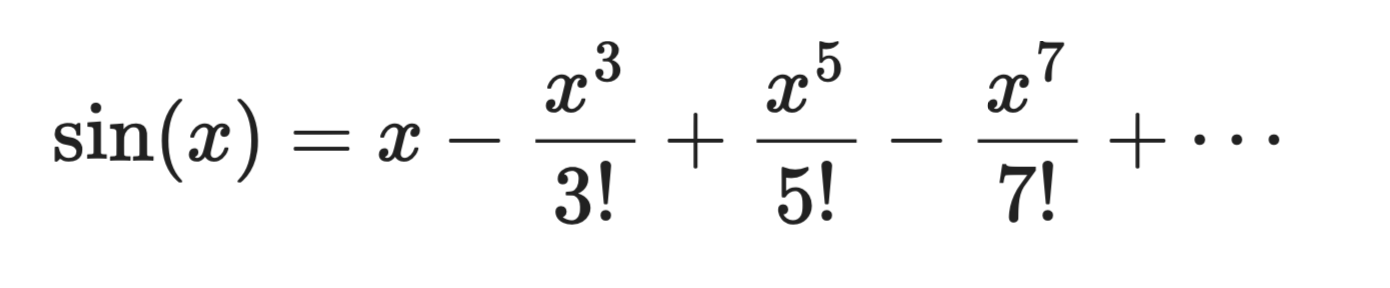
Espansione della serie di Taylor
Il primo termine, x, è una grezza approssimazione lineare. Aggiungi il secondo termine e la curva si avvicina. Aggiungi più termini e il polinomio inizia a sembrare esattamente sin(x) vicino a x = 0.
In parole semplici, l’espansione significa che stai scambiando una funzione esatta ma difficile da calcolare con un polinomio con cui puoi effettivamente lavorare.
Non calcolerai mai infiniti termini. In pratica, ti fermi dopo alcuni e accetti un piccolo errore. Il risultato si chiama serie di Taylor troncata, e l’errore che introduce si chiama errore di troncamento.
Il resto di Lagrange ti fornisce un limite a quell’errore. Per una serie troncata dopo n termini:
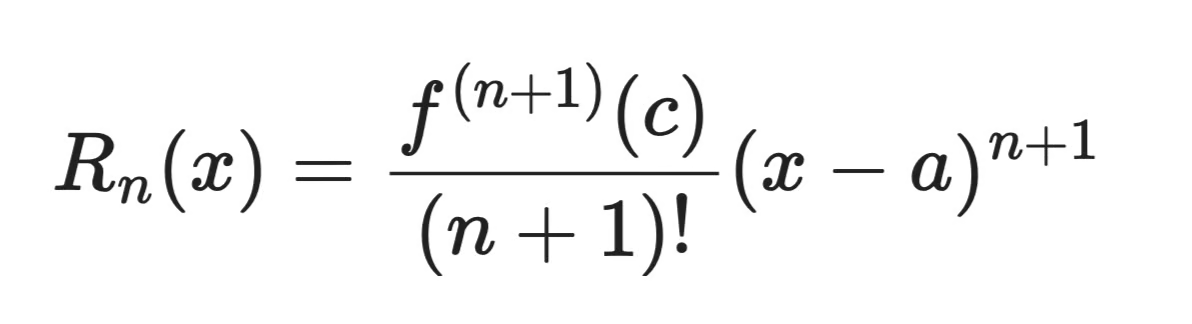
Resto di Lagrange
Dove c è un punto tra x e a. Non conosci esattamente c, ma puoi limitare f⁽ⁿ⁺¹⁾(c) se sai quanto possono diventare grandi le derivate della tua funzione.
Ecco come interpretarlo
Più x è lontano dal punto centrale a, maggiore è l’errore
Più termini includi, più l’errore diminuisce
Le funzioni con derivate grandi e a crescita rapida sono più difficili da approssimare con precisione
Supponiamo che tu stia approssimando sin(0.1) con tre termini:
x = 0.1
approx = x - x**3/6 + x**5/120
print(approx)
print(np.sin(0.1)) 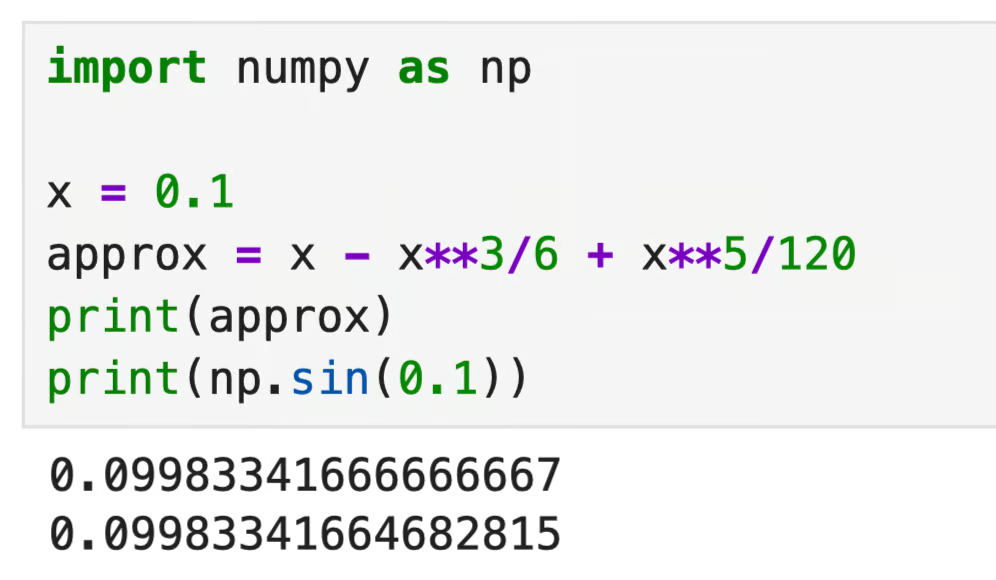
Approssimazione in Python
Tre termini ti danno un’accuratezza fino alla decima cifra decimale quando x è vicino a 0. Questo è l’errore di troncamento in azione: piccolo, ma non nullo.
Una serie di Taylor converge in un punto x se le somme parziali si avvicinano sempre più a un valore fisso man mano che aggiungi termini. Quel valore fisso dovrebbe essere f(x) — ma non è sempre garantito.
Il raggio di convergenza R ti dice fino a che distanza dal punto centrale la serie rimane valida. All’interno di quel raggio, la serie converge. Fuori, i termini crescono invece di ridursi e l’approssimazione crolla.
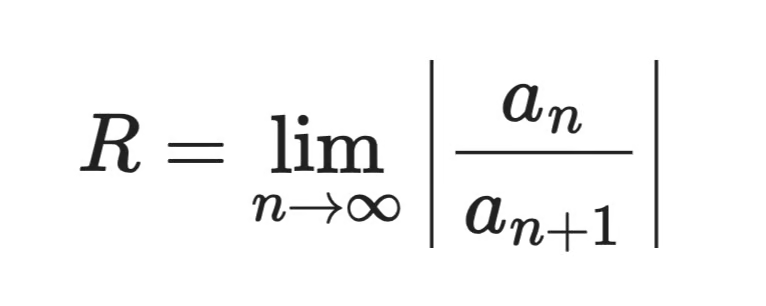
Formula di convergenza
Funzioni diverse hanno raggi diversi:
eˣ, sin(x) e cos(x) convergono per tutti i valori di x, quindi R = ∞
ln(1 + x) converge solo per -1 < x <= 1, quindi R = 1
1/1-x converge per |x| < 1, quindi R = 1
Una funzione può anche avere un raggio di convergenza infinito ma non coincidere comunque con la propria serie di Taylor in certi punti. Si chiamano funzioni non analitiche, e sono un caso limite da conoscere, anche se raramente le vedrai in data science.
Quindi, verifica sempre se x rientra nel raggio di convergenza prima di fidarti di un’approssimazione di Taylor.
Le serie di Taylor compaiono in più ambiti di quanto ti aspetteresti — dalle simulazioni fisiche alla risoluzione di equazioni differenziali. Ma il loro impatto più grande nel lavoro quotidiano di un data scientist è nell’ottimizzazione e nell’approssimazione dei modelli.
Ogni volta che alleni un modello di machine learning, stai eseguendo una qualche forma di ottimizzazione. E spesso dietro quell’ottimizzazione c’è la serie di Taylor.
Il gradient descent usa un’approssimazione di Taylor del primo ordine. Quando calcoli il gradiente di una funzione di perdita L(θ) all’attuale valore dei parametri θ, in sostanza stai chiedendo: "se mi muovo di un piccolo passo in questa direzione, quanto cambia la loss?" Questa è un’espansione di Taylor del primo ordine attorno al punto corrente:
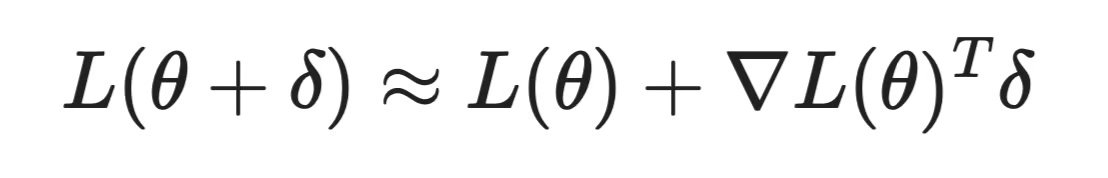
Serie di Taylor nell’ottimizzazione
Funziona, ma ignora la curvatura. Se la superficie della loss curva, un’approssimazione di primo ordine può andare oltre il minimo o fare passi inefficienti.
Il metodo di Newton risolve includendo il termine di secondo ordine — la matrice Hessiana H, che tiene traccia della curvatura:
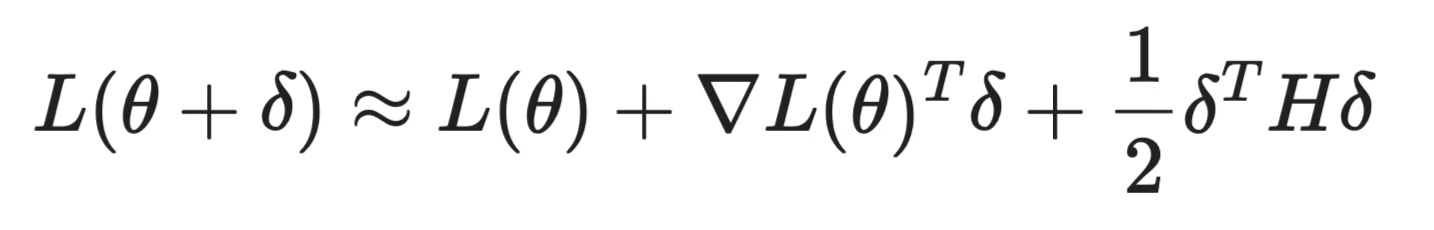
Serie di Taylor nell’ottimizzazione (2)
Porre a zero la derivata di questa espressione ti dà il passo ottimale da compiere. Il compromesso è che calcolare l’Hessiana completa è costoso per modelli grandi. Metodi come L-BFGS la approssimano, ottenendo gran parte del beneficio a una frazione del costo.
Alcune funzioni di attivazione sono costose da calcolare. Le serie di Taylor offrono alternative più economiche, sufficientemente accurate per la maggior parte degli scopi.
La funzione sigmoide σ(x) = 1 / (1 + e⁻ˣ) richiede il calcolo di un’esponenziale, che è costoso. Vicino a x = 0, la sua espansione di Taylor è:
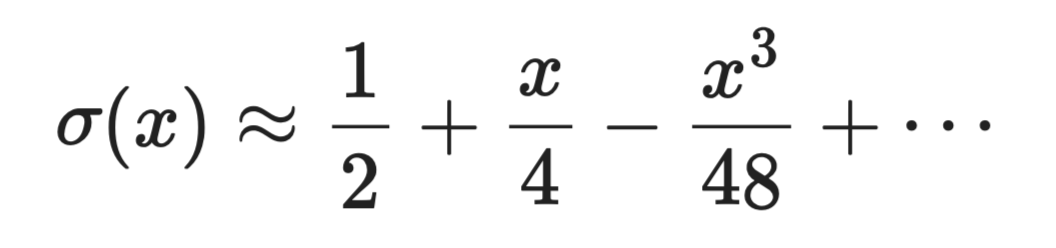
Serie di Taylor nell’approssimazione
Per ambienti con vincoli hardware come dispositivi edge o FPGA, approssimazioni polinomiali come questa possono sostituire calcoli esatti con una manciata di operazioni di moltiplicazione-somma.
GELU, usata in modelli transformer come BERT e GPT, è spesso implementata tramite un’approssimazione basata su Taylor della funzione errore erf(x), poiché la forma esatta coinvolge un integrale senza soluzione in forma chiusa.
XGBoost è una delle librerie di gradient boosting più usate e utilizza un’espansione di Taylor di secondo ordine della funzione di perdita per adattare ogni nuovo albero.
A ogni passo di boosting, XGBoost approssima la loss come:
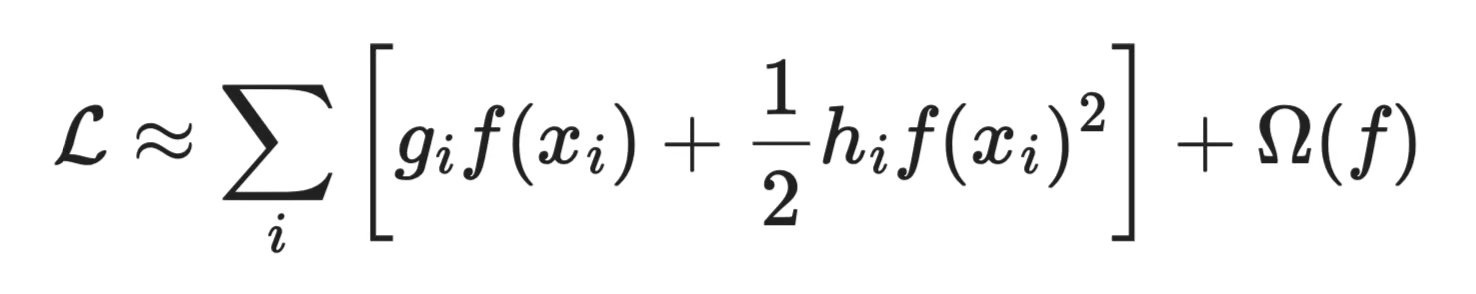
Approssimazione della loss in XGBoost
Dove g_i è il gradiente di primo ordine e h_i è il gradiente di secondo ordine (Hessiana) della loss rispetto alla previsione corrente. Usare entrambi i termini consente a XGBoost di adattare gli alberi più velocemente e con maggiore precisione rispetto ai metodi di primo ordine, il che è una parte importante del suo ottimo rendimento sui dati tabellari.
Solo perché le serie di Taylor possono essere usate ovunque in data science, non significa che siano il proverbiale martello per ogni chiodo che vedi. Ci sono un paio di cose che possono andare storte.
L’errore di approssimazione si accumula: nelle reti profonde stai concatenando molte operazioni. Un piccolo errore di approssimazione di Taylor in un layer si compone attraverso i layer, e può influire sulla stabilità dell’addestramento
Il raggio di convergenza conta: le approssimazioni di Taylor sono affidabili solo vicino al punto di espansione. Se i tuoi input si allontanano molto dal punto in cui l’approssimazione è stata costruita — ad esempio in inferenza su dati out-of-distribution — l’approssimazione può rompersi
Hessiane ad alta dimensionalità sono costose: i metodi di secondo ordine sono potenti ma non scalano bene. Un modello con n parametri ha un’Hessiana n × n. Per un modello con milioni di parametri, memorizzare e invertire quella matrice non è pratico senza approssimazioni.
Se capisci questi compromessi, saprai quando un approccio basato su Taylor vale la pena e quando un metodo più semplice di primo ordine è sufficiente.
Alcune serie di Taylor compaiono ovunque in matematica, fisica e machine learning. Queste sono quelle da conoscere se prendi sul serio la data science.
La funzione esponenziale eˣ è la serie di Taylor più semplice da derivare, dato che ogni derivata di eˣ è eˣ stessa. Valutata in a = 0, ogni coefficiente è 1:
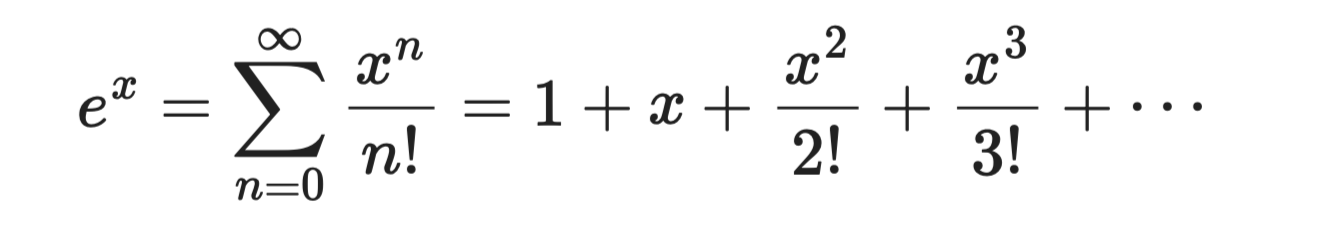
Funzione esponenziale
Questa serie converge per tutti i valori di x, il che la rende affidabile e facile da usare. È la base delle funzioni sigmoide e softmax usate nei modelli di classificazione.
La funzione seno contiene solo potenze dispari, il che discende dal fatto che sin(x) è una funzione dispari — cioè sin(-x) = -sin(x):
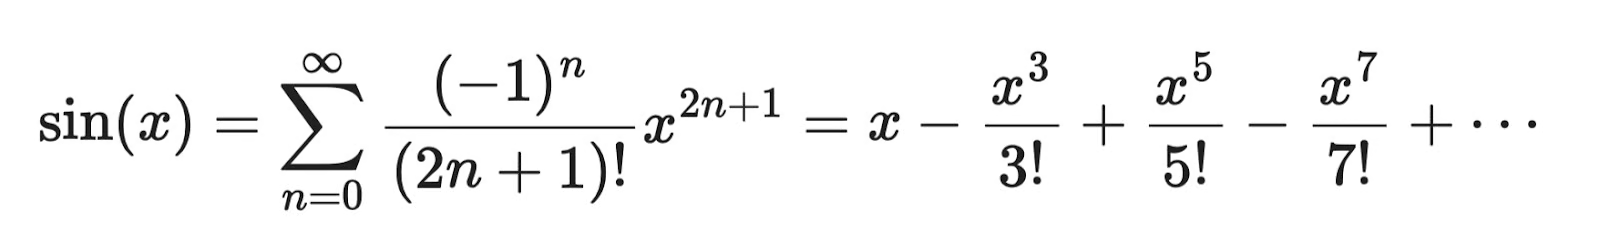
Funzione seno
Come eˣ, converge per ogni x. I segni alternati derivano dal fatto che le derivate di sin(x) ciclicamente diventano cos(x), -sin(x), -cos(x) e di nuovo punto e a capo.
Il coseno è il controparte pari del seno — contiene solo potenze pari:
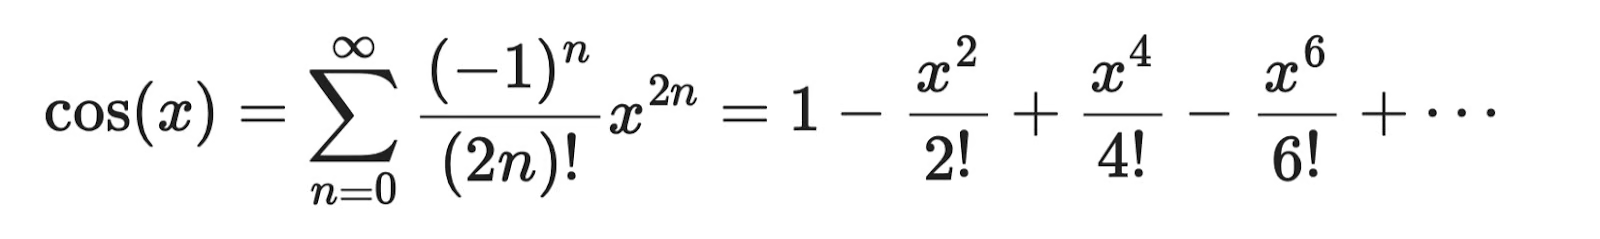
Funzione coseno
Se guardi insieme le serie di seno e coseno, noterai che sono complementari. Questa relazione porta alla famosa identità di Eulero: eⁱˣ = cos(x) + i·sin(x).
Il logaritmo naturale ln(1 + x) ha una serie di Taylor centrata in x = 0:
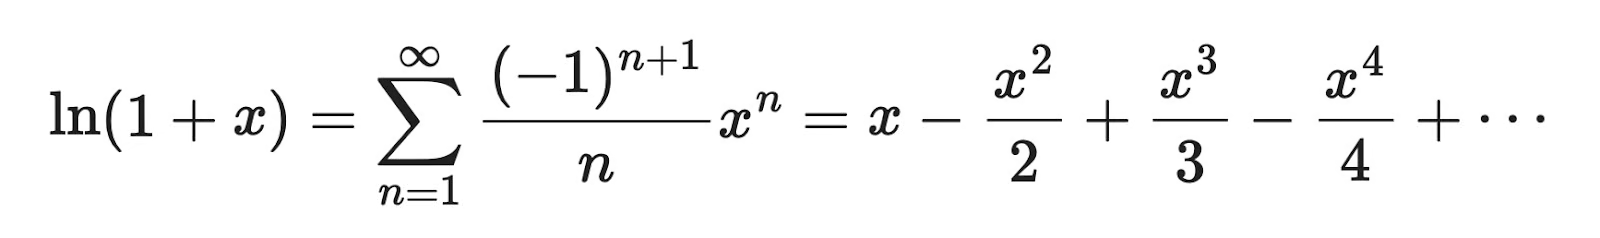
Funzione logaritmo naturale
A differenza dei tre precedenti, converge solo per -1 < x <= 1. Se spingi x fuori da quell’intervallo, la serie diverge. Questo emerge nella loss di entropia incrociata, dove le probabilità log devono rimanere in un intervallo valido.
La serie geometrica è uno dei risultati più antichi e usati in matematica:
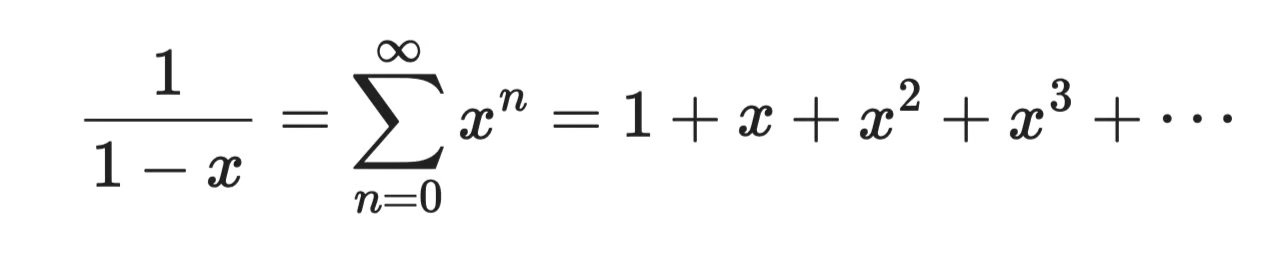
Serie geometrica
Questa converge solo per |x| < 1. È il punto di partenza per derivare molte altre serie di Taylor, e compare in teoria della probabilità, elaborazione del segnale e ovunque si sommino valori futuri scontati.
Se cerchi qualcosa di tangibile, stampabile, da appendere al muro accanto al letto, ci ho pensato io:
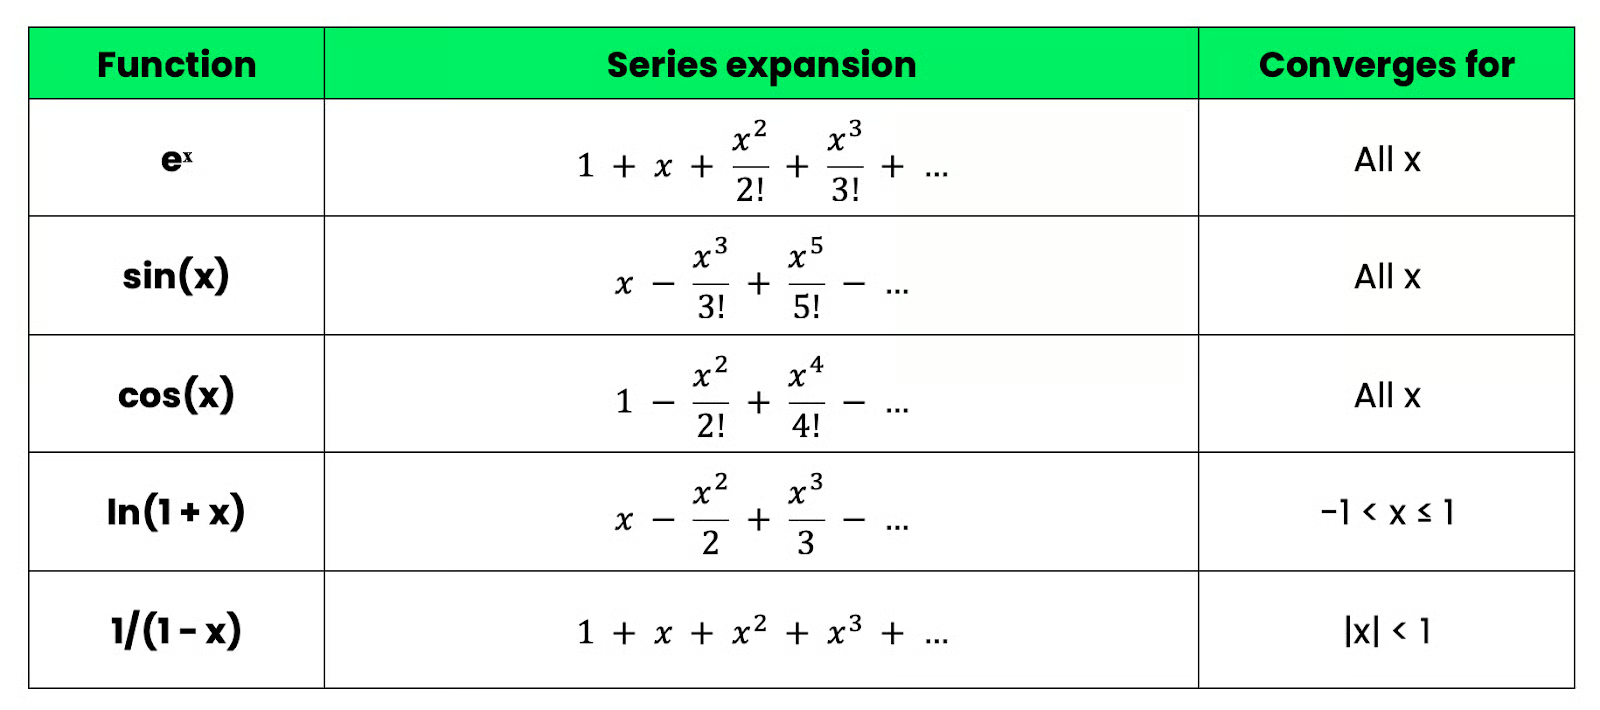
Riferimento rapido alle serie di Taylor
Queste cinque serie coprono la maggior parte dei casi che incontrerai in data science e machine learning.
Taylor, Fourier e Maclaurin approssimano tutte funzioni, ma risolvono problemi diversi e funzionano al meglio in contesti differenti.
Le serie di Taylor e di Fourier rappresentano entrambe le funzioni come somme infinite, ma lo fanno in modi completamente diversi.
Una serie di Taylor costruisce una funzione a partire da polinomi — potenze di (x - a). Funziona facendo zoom su un singolo punto e catturando il comportamento locale della funzione tramite le sue derivate. Il risultato è accurato vicino al punto centrale a, ma l’accuratezza cala allontanandosi.
Una serie di Fourier usa seni e coseni come mattoni di base:
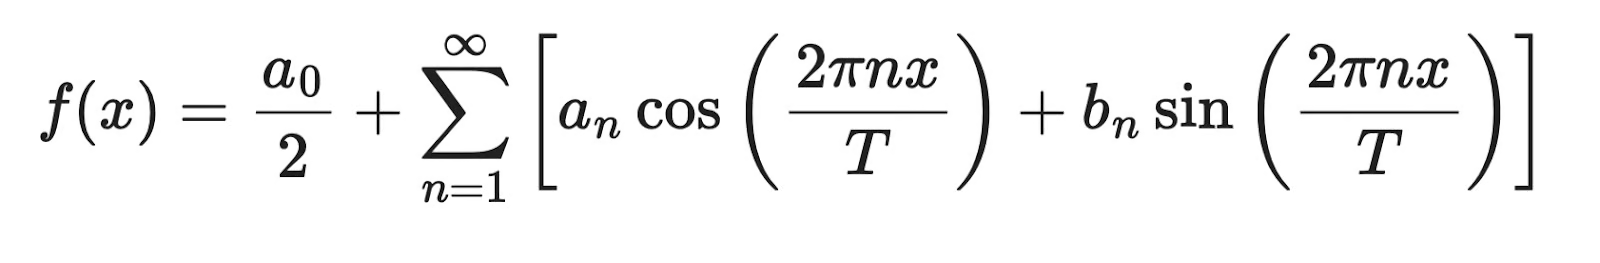
Serie di Fourier
Invece di catturare il comportamento locale in un punto, le serie di Fourier catturano il comportamento periodico globale su un intero intervallo. Sono pensate per funzioni che si ripetono — pensa a segnali audio, pattern stagionali o qualsiasi cosa oscilli.
Ecco come si confrontano fianco a fianco:
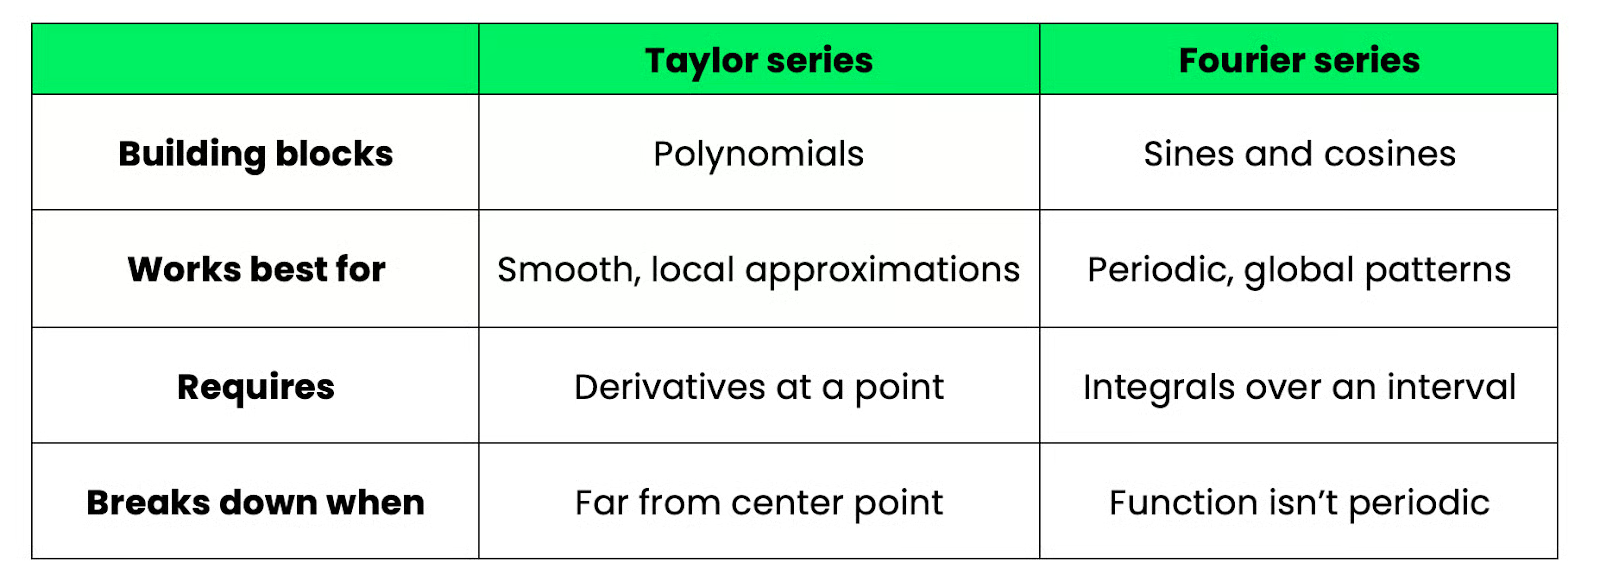
Confronto Taylor vs. Fourier
Le serie di Fourier compaiono nell’elaborazione dei segnali e nell’analisi delle serie temporali — analisi spettrale, decomposizione in frequenza e persino in alcune architetture di reti neurali come FNet, che sostituisce l’attenzione con le trasformate di Fourier.
Se lavori con dati tabellari, immagini o ottimizzazione, le serie di Taylor sono lo strumento più rilevante. Se lavori con audio, serie temporali o qualsiasi cosa con struttura periodica, le serie di Fourier sono più adatte.
Questa è semplice. Una serie di Maclaurin è solo una serie di Taylor centrata in a = 0.
La formula generale della serie di Taylor è:
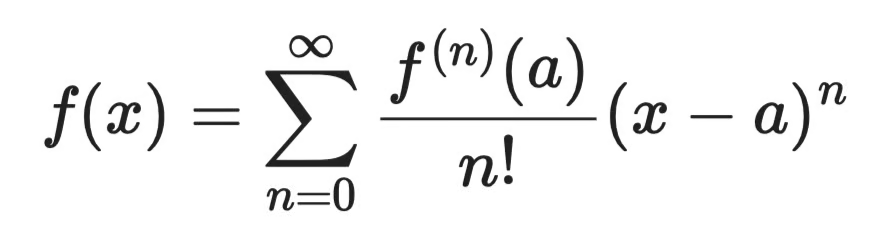
Serie di Maclaurin
Imposta a = 0 e ottieni:
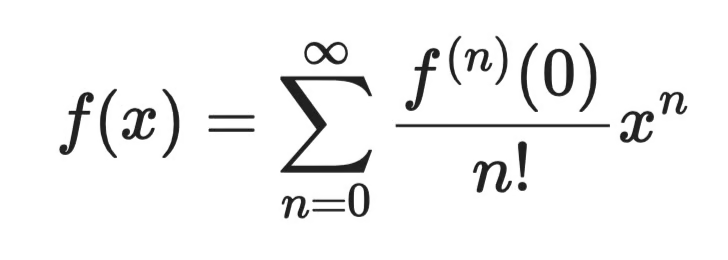
Serie di Maclaurin con a = 0
Colin Maclaurin usò così spesso questo caso specifico nel suo lavoro che ha ricevuto un nome proprio, ma matematicamente non è altro che una serie di Taylor con un particolare punto centrale.
In pratica, la maggior parte delle serie che vedrai — eˣ, sin(x), cos(x), ln(1 + x) — sono serie di Maclaurin, perché centrare in zero mantiene l’algebra pulita. Quando devi approssimare una funzione vicino a un punto diverso, sposti il centro a a ≠ 0 e ottieni una serie di Taylor generale.
In conclusione, ogni serie di Maclaurin è una serie di Taylor, ma non ogni serie di Taylor è una serie di Maclaurin.
Serie di Taylor e modelli lineari possono sembrare scollegati all’inizio, ma c’è una connessione che vale la pena conoscere, e parte dall’approssimazione di Taylor del primo ordine.
Quando tronchi una serie di Taylor dopo il primo termine, ottieni un’approssimazione lineare di una funzione vicino a un punto a:
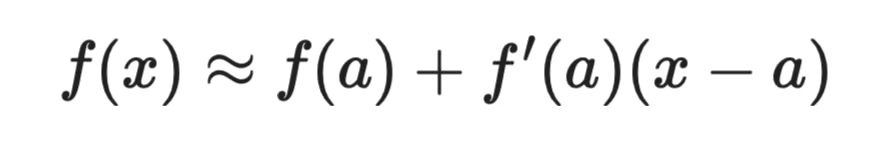
Serie di Taylor e modelli lineari (1)
Questa è una retta. Ha una pendenza (f'(a)) e un’intercetta (f(a) - f'(a) ⋅ a). Ti suona familiare? È la stessa struttura di un modello di regressione lineare semplice:
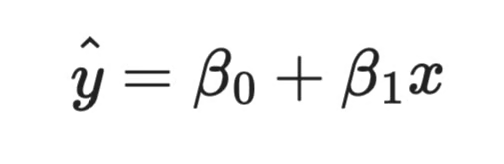
Serie di Taylor e modelli lineari (2)
La differenza sta nell’origine. In un’approssimazione di Taylor, pendenza e intercetta sono determinate dalle derivate della funzione in un singolo punto. Nella regressione lineare, sono stimate dai dati per minimizzare l’errore di previsione. Ma, strutturalmente, fanno la stessa cosa.
Spiega perché i modelli lineari funzionano bene in certe situazioni e falliscono in altre.
La regressione lineare assume che la relazione tra input e output sia — o possa essere trattata come — lineare. Le serie di Taylor ti dicono esattamente quando questa assunzione regge: quando i tuoi input restano vicino a un punto fisso e la funzione che stai approssimando è regolare. Se spingi gli input lontano da quel punto, l’approssimazione lineare crolla, per lo stesso motivo per cui la regressione lineare spesso fallisce su dati con forti pattern non lineari.
I modelli lineari generalizzati (GLM) rendono questa connessione ancora più esplicita.
La regressione logistica, ad esempio, modella il log-odds di un esito come funzione lineare. Il legame tra il predittore lineare e la probabilità in uscita passa dalla funzione sigmoide — e, come visto prima, la sigmoide ha un’espansione di Taylor ben comportata vicino a zero.
Una volta capito che un’espansione di Taylor di primo ordine ti dà un modello lineare, il passo successivo è includere più termini, ottenendo un modello polinomiale.
Un’espansione di Taylor di secondo ordine ti dà:
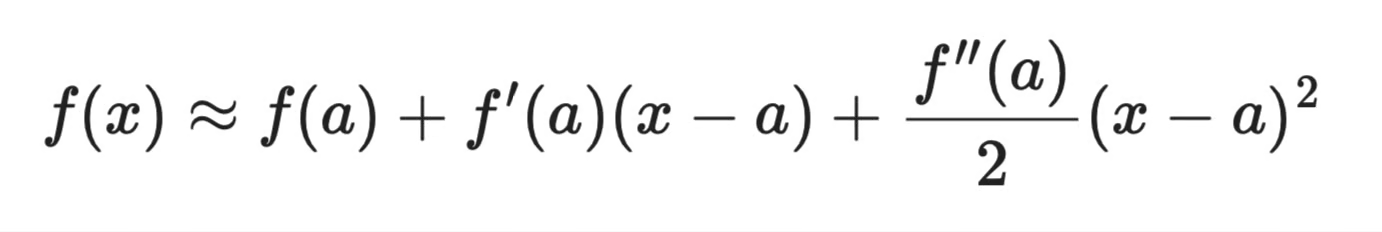
Serie di Taylor di secondo ordine
Questa è una quadratica — un modello di regressione polinomiale con un termine al quadrato. Ogni termine aggiuntivo di Taylor corrisponde a un polinomio di grado superiore, che è come la regressione polinomiale estende la regressione lineare per catturare relazioni curve.
Le serie di Taylor ti offrono quindi un modo rigoroso per pensare al trade-off bias-varianza nella regressione. Un’approssimazione di primo ordine (modello lineare) è veloce e interpretabile ma ha alto bias se la relazione vera è non lineare. Approssimazioni di ordine superiore si adattano meglio ai dati vicino al punto di espansione ma rischiano l’overfitting man mano che aggiungi termini.
Se vuoi approfondire la regressione lineare e quando funziona, il tutorial Essentials of Linear Regression in Python è un buon passo successivo. Per chi usa R, il corso Intermediate Regression in R copre in dettaglio regressione polinomiale e diagnostica del modello.
Le serie di Taylor sono uno di quegli strumenti matematici che continuano a ricomparire una volta che sai cosa cercare.
Hai visto come permettono ai computer di valutare funzioni come eˣ e sin(x) tramite aritmetica di base, come convergenza ed errore di troncamento determinano l’accuratezza di un’approssimazione, e come la stessa idea alimenta il gradient descent, XGBoost e le approssimazioni delle funzioni di attivazione nel machine learning moderno.
Le cinque serie più note — esponenziale, seno, coseno, logaritmica, geometrica — meritano di essere memorizzate. Compaiono così spesso che riconoscerle al volo fa risparmiare tempo reale.
Da qui, il passo successivo è prendere dimestichezza con il pensiero algoritmico che affianca questo tipo di matematica. Il nostro corso Data Structures and Algorithms in Python è un’ottima base per costruire quel fondamento. Ti aiuterà a capire come le idee matematiche si traducono in codice che funziona e scala.
Impara con DataCamp
Corso
Corso
Corso