
Curso
Álgebra Linear para Data Science em R
4 h
21.6K
Você já se perguntou como um computador realmente calcula uma função como sin(x) ou eˣ?
Computadores não conseguem avaliar diretamente a maioria das funções matemáticas. Eles só sabem somar, subtrair, multiplicar e dividir. Então, quando você chama math.sin(0.5) em Python, algo precisa converter isso em uma sequência de operações aritméticas básicas. Esse algo é a aproximação polinomial, e as séries de Taylor são a base matemática por trás dela.
Uma série de Taylor permite reescrever quase qualquer função suave como uma soma infinita de termos mais simples, cada um construído a partir das derivadas da função em um único ponto. Quando você entende essa ideia, muita coisa em data science e machine learning começa a fazer sentido — desde como o gradient descent funciona até por que certas funções de ativação se comportam do jeito que se comportam.
Neste artigo, vou apresentar o que são séries de Taylor, como funcionam matematicamente, onde aparecem em data science e machine learning e como se relacionam com outros tipos de séries que você vai encontrar.
As séries de Taylor existem há séculos. Brook Taylor as apresentou em 1715, embora James Gregory e Colin Maclaurin também tenham contribuído bastante para a ideia.
O objetivo era encontrar uma forma de representar funções complexas usando polinômios, que são muito mais fáceis de manipular.
Uma série de Taylor aproxima uma função ao expressá-la como uma soma infinita de termos, cada um derivado das derivadas da função em um único ponto. Quanto mais termos você inclui, mais a aproximação se aproxima da função real.
A fórmula geral é esta:
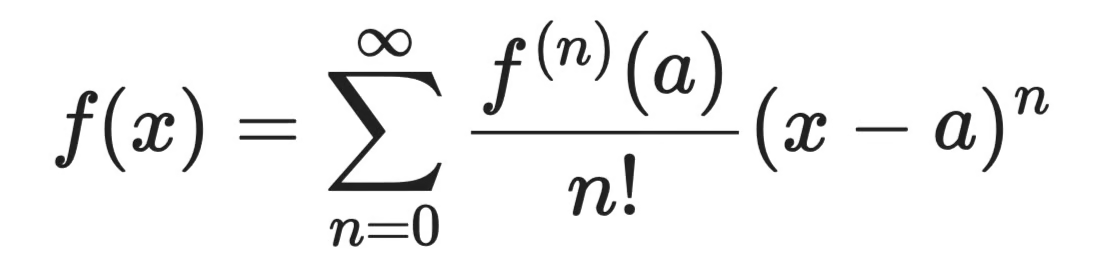
Fórmula geral da série de Taylor
Três componentes formam cada termo dessa soma:
f⁽ⁿ⁾(a) — a n-ésima derivada da função avaliada no ponto central a
n! — o fatorial de n, que impede que os termos cresçam sem controle
(x - a)ⁿ — o termo de expansão, que mede o quão distante x está do ponto central
O ponto central a é onde você ancora a série. Quando a = 0, você tem um caso especial chamado de série de Maclaurin — falaremos disso mais adiante.
A função exponencial eˣ é um primeiro exemplo perfeito. Sua derivada é ela mesma, então f⁽ⁿ⁾(0) = 1 para todo n. Centralizada em a = 0, a série de Taylor fica:
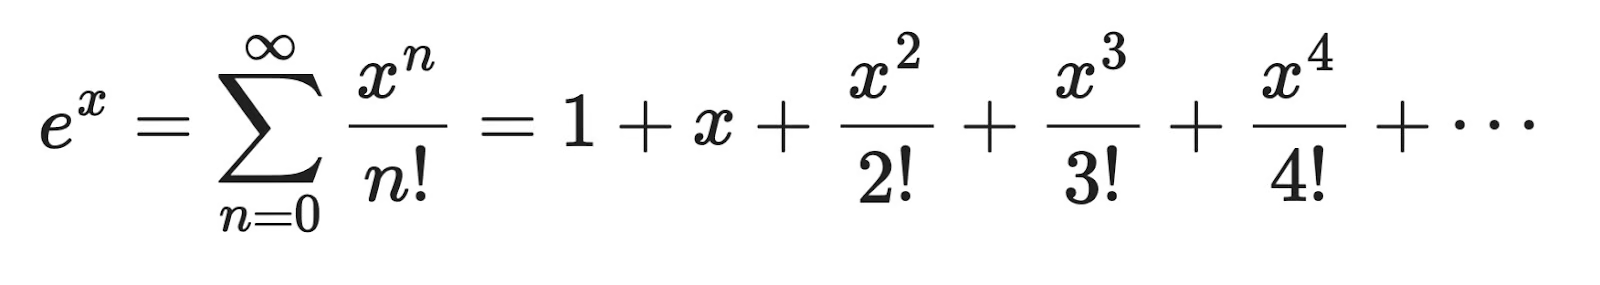
Exemplo concreto
Digamos que você queira aproximar e⁰·⁵. Basta substituir x = 0.5 nos quatro primeiros termos — aqui vai um exemplo em Python:
x = 0.5
approx = 1 + x + x**2/2 + x**3/6
print(approx)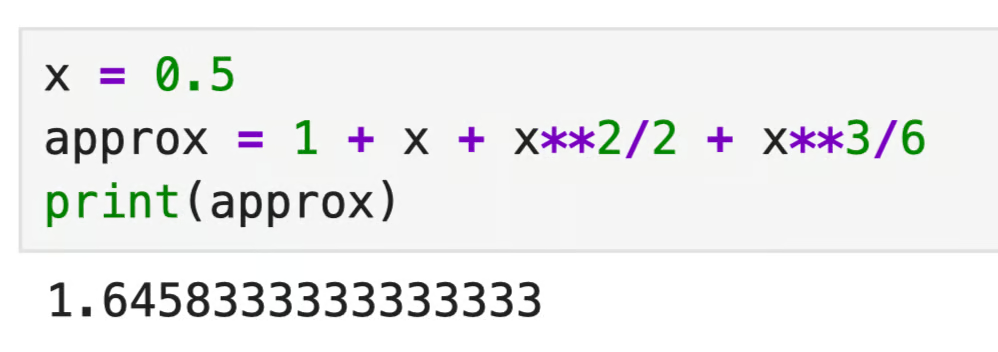
Exemplo concreto em Python
O valor real de e⁰·⁵ é aproximadamente 1.6487. Com apenas quatro termos, você já fica a menos de 0,2% da resposta exata. Adicione mais termos e a aproximação fica ainda mais precisa.
Esse é o poder das séries de Taylor.
Funções como eˣ, sin(x) e cos(x) são difíceis de avaliar diretamente, mas suas séries de Taylor as reduzem à aritmética básica. Exatamente o tipo de coisa com que um computador sabe lidar.
Uma série de Taylor só é útil se realmente convergir para a função que você está tentando aproximar. Vamos ver o que isso significa e o que acontece quando não converge.
Ao expandir uma série de Taylor, você está construindo um polinômio termo a termo. Cada termo adiciona mais informação sobre o comportamento da função perto do ponto central a.
Considere sin(x) centralizada em a = 0:
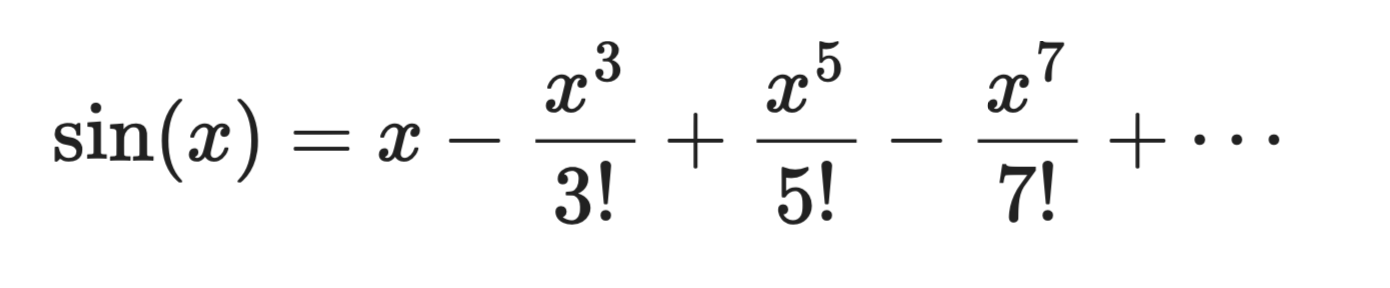
Expansão da série de Taylor
O primeiro termo, x, é uma aproximação linear grosseira. Some o segundo termo e a curva chega mais perto. Adicione mais termos e o polinômio começa a parecer exatamente com sin(x) perto de x = 0.
Em bom português: ao expandir, você troca uma função exata mas difícil de computar por um polinômio com o qual dá para trabalhar de fato.
Você nunca vai calcular infinitos termos. Na prática, para depois de alguns e aceita um pequeno erro. O resultado é uma série de Taylor truncada, e o erro introduzido é o erro de truncamento.
O resto de Lagrange fornece um limite para esse erro. Para uma série truncada após n termos:
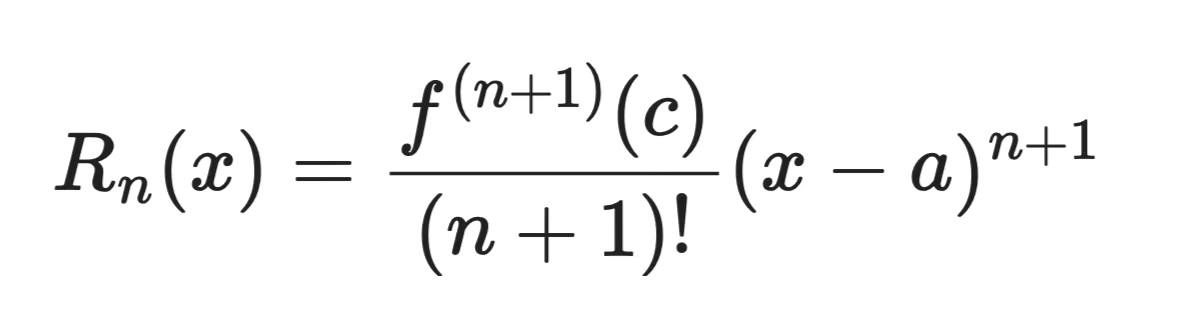
Resto de Lagrange
Em que c é algum ponto entre x e a. Você não sabe c exatamente, mas consegue limitar f⁽ⁿ⁺¹⁾(c) se souber quão grandes podem ser as derivadas da sua função.
Veja como interpretar:
Quanto mais longe x estiver do ponto central a, maior o erro
Quanto mais termos você inclui, menor o erro
Funções com derivadas grandes e que crescem rápido são mais difíceis de aproximar com precisão
Suponha que você esteja aproximando sin(0.1) com três termos:
x = 0.1
approx = x - x**3/6 + x**5/120
print(approx)
print(np.sin(0.1)) 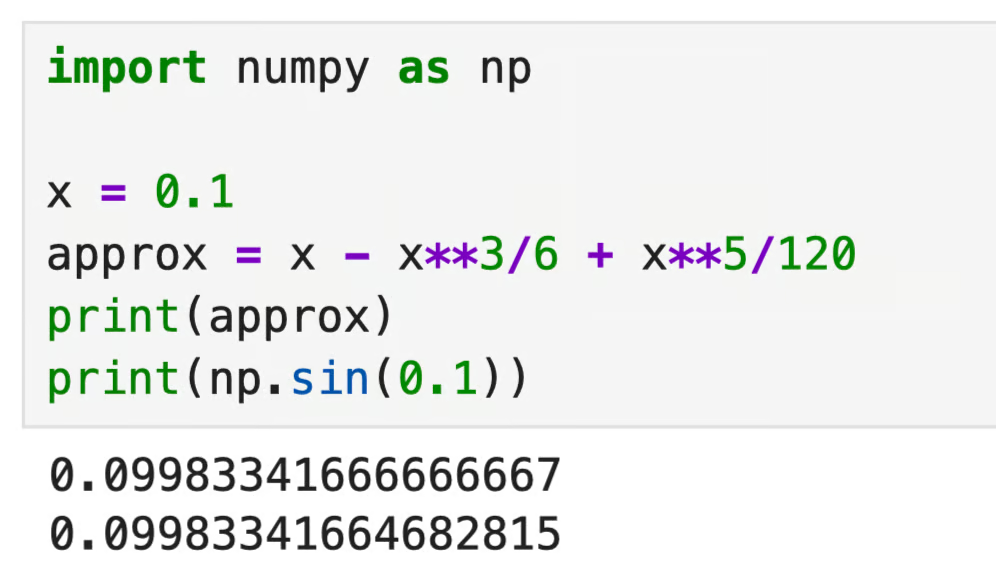
Aproximação em Python
Três termos dão precisão de dez casas decimais quando x está próximo de 0. Isso é erro de truncamento em ação — pequeno, mas não zero.
Uma série de Taylor converge em um ponto x se as somas parciais se aproximam cada vez mais de um valor fixo conforme você adiciona termos. Esse valor fixo deve ser f(x) — mas isso nem sempre é garantido.
O raio de convergência R indica até onde, a partir do ponto central, a série continua válida. Dentro desse raio, a série converge. Fora dele, os termos crescem em vez de diminuir, e a aproximação desmorona.
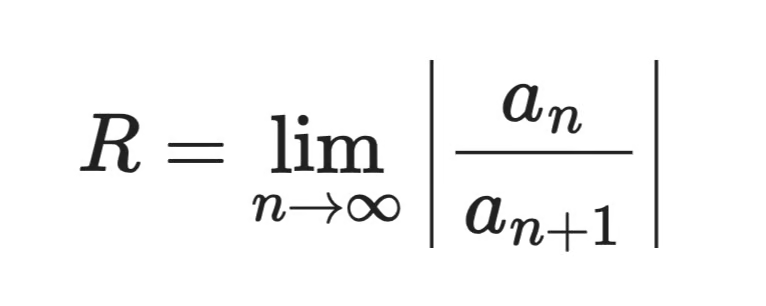
Fórmula de convergência
Funções diferentes têm raios diferentes:
eˣ, sin(x) e cos(x) convergem para todos os valores de x, então R = ∞
ln(1 + x) só converge para -1 < x <= 1, então R = 1
1/1-x converge para |x| < 1, então R = 1
Uma função também pode ter raio de convergência infinito e mesmo assim não coincidir com sua série de Taylor em certos pontos. São as funções não analíticas — um caso de borda que vale conhecer, embora raramente apareça em data science.
Portanto, sempre confira se x está dentro do raio de convergência antes de confiar em uma aproximação de Taylor.
Séries de Taylor aparecem em mais lugares do que você imagina — de simulações de física à resolução de equações diferenciais. Mas o maior impacto no seu dia a dia como cientista de dados está em otimização e aproximação de modelos.
Sempre que você treina um modelo de machine learning, está executando algum tipo de otimização. E muitas vezes há uma série de Taylor por trás disso.
Gradient descent usa uma aproximação de Taylor de primeira ordem. Ao calcular o gradiente de uma função de perda L(θ) nos parâmetros atuais θ, você está essencialmente perguntando: "se eu der um passo pequeno nessa direção, quanto a perda muda?" Isso é uma expansão de Taylor de primeira ordem ao redor do ponto atual:
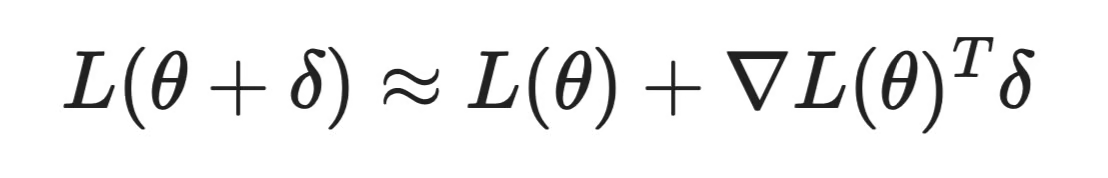
Série de Taylor em otimização
Funciona, mas ignora a curvatura. Se a superfície de perda curva, uma aproximação de primeira ordem pode passar do ponto ideal ou dar passos ineficientes.
O método de Newton resolve isso ao incluir o termo de segunda ordem — a matriz Hessiana H, que captura a curvatura:
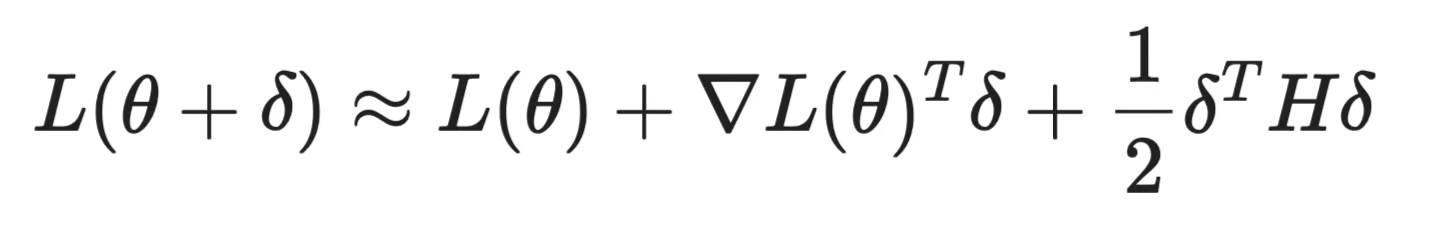
Série de Taylor em otimização (2)
Zerar a derivada dessa expressão dá o passo ótimo a ser dado. A troca é que calcular a Hessiana completa é caro em modelos grandes. Métodos como L-BFGS a aproximam, obtendo grande parte do benefício a uma fração do custo.
Algumas funções de ativação são custosas de computar. Séries de Taylor oferecem alternativas mais baratas, com precisão suficiente para a maioria dos casos.
A função sigmoide σ(x) = 1 / (1 + e⁻ˣ) exige calcular um exponencial, o que é caro. Perto de x = 0, sua expansão de Taylor é:
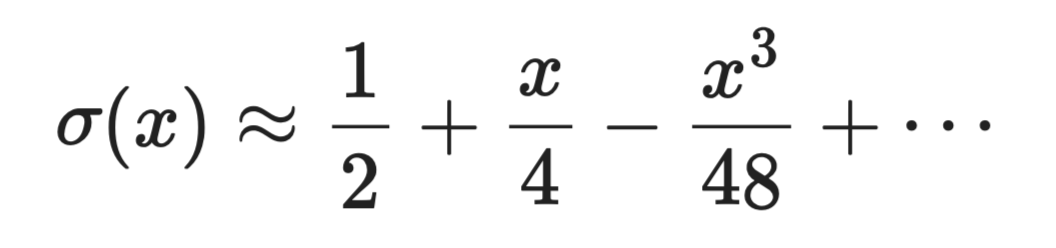
Série de Taylor em aproximação
Para ambientes com restrição de hardware, como dispositivos de borda ou FPGAs, aproximações polinomiais como esta podem substituir cálculos exatos por algumas operações de multiplicar e somar.
GELU, usada em modelos transformadores como BERT e GPT, costuma ser implementada via uma aproximação baseada em Taylor da função erro erf(x), já que a forma exata envolve uma integral sem solução fechada.
XGBoost é uma das bibliotecas de gradient boosting mais usadas e emprega uma expansão de Taylor de segunda ordem da função de perda para ajustar cada nova árvore.
A cada etapa de boosting, o XGBoost aproxima a perda como:
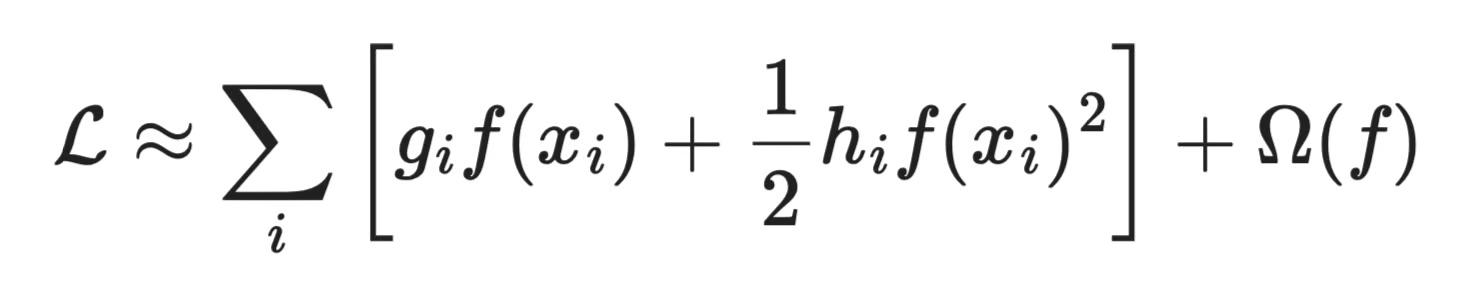
Aproximação da perda no XGBoost
Em que g_i é o gradiente de primeira ordem e h_i é o gradiente de segunda ordem (Hessiano) da perda em relação à predição atual. Usar ambos permite ao XGBoost ajustar árvores mais rápido e com mais precisão do que métodos de primeira ordem — parte importante do porquê ele performa tão bem em dados tabulares.
Só porque séries de Taylor podem ser usadas em toda parte em data science, não significa que sejam um martelo metafórico para qualquer prego que você veja. Algumas coisas podem dar errado.
Erro de aproximação se acumula: em redes profundas, você encadeia muitas operações. Um pequeno erro de Taylor em uma camada se compõe nas seguintes, podendo afetar a estabilidade do treinamento
O raio de convergência importa: aproximações de Taylor só são confiáveis perto do ponto de expansão. Se suas entradas se afastarem do ponto onde a aproximação foi construída — por exemplo, durante inferência em dados fora da distribuição — a aproximação pode falhar
Hessianos de alta dimensão são caros: métodos de segunda ordem são poderosos, mas não escalam tão bem. Um modelo com n parâmetros tem um Hessiano n × n. Para modelos com milhões de parâmetros, armazenar e inverter essa matriz é impraticável sem aproximações.
Entendendo esses trade-offs, você sabe quando uma abordagem baseada em Taylor vale a pena e quando um método mais simples de primeira ordem é suficiente.
Algumas séries de Taylor aparecem em toda a matemática, física e machine learning. Estas valem conhecer se você leva data science a sério.
A função exponencial eˣ é a série de Taylor mais simples de derivar, pois toda derivada de eˣ é a própria eˣ. Avaliada em a = 0, todo coeficiente é 1:
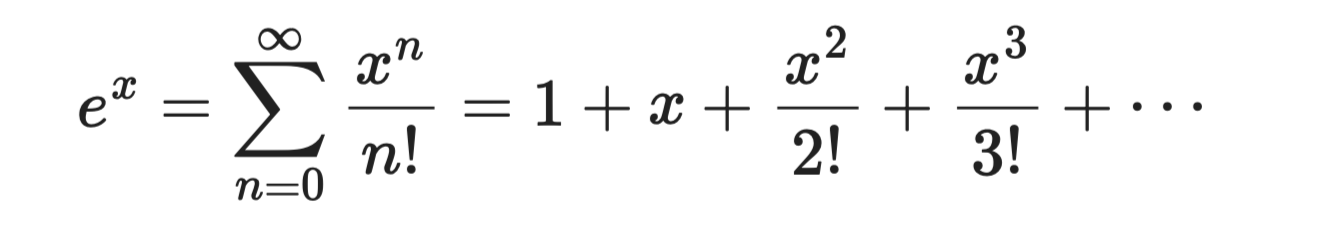
Função exponencial
Essa série converge para todos os valores de x, o que a torna confiável e fácil de trabalhar. É a base para as funções sigmoide e softmax usadas em modelos de classificação.
A função seno contém apenas potências ímpares, o que decorre do fato de que sin(x) é ímpar — isto é, sin(-x) = -sin(x):
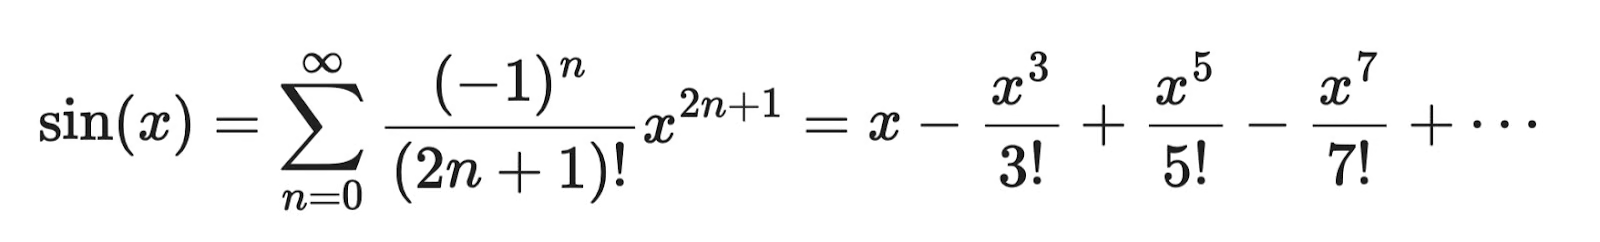
Função seno
Assim como eˣ, ela converge para todo x. Os sinais alternados vêm do fato de as derivadas de sin(x) ciclares entre cos(x), -sin(x), -cos(x) e volta.
O cosseno é o par ímpar do seno — só contém potências pares:
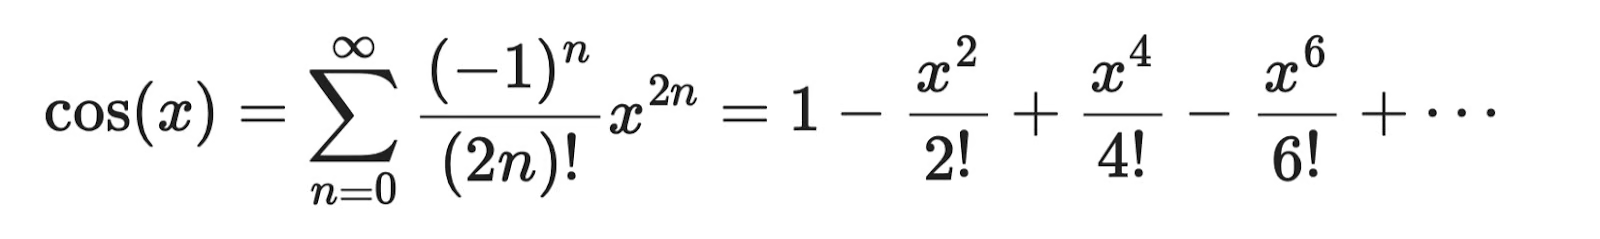
Função cosseno
Observando as séries de seno e cosseno juntas, dá para notar que são complementares. Essa relação leva à famosa identidade de Euler: eⁱˣ = cos(x) + i·sin(x).
O logaritmo natural ln(1 + x) tem uma série de Taylor centrada em x = 0:
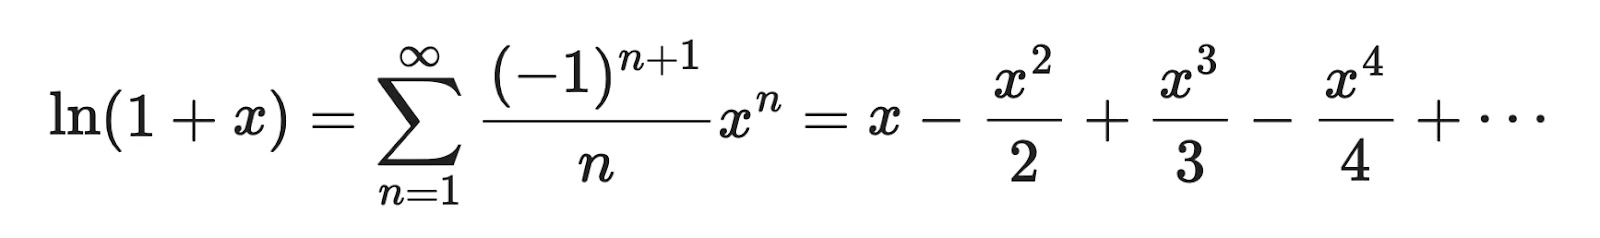
Função logaritmo natural
Ao contrário das três anteriores, esta só converge para -1 < x <= 1. Se você empurra x para fora desse intervalo, a série diverge. Isso aparece, por exemplo, na perda de entropia cruzada, em que probabilidades log precisam permanecer em uma faixa válida.
A série geométrica é um dos resultados mais antigos e usados da matemática:
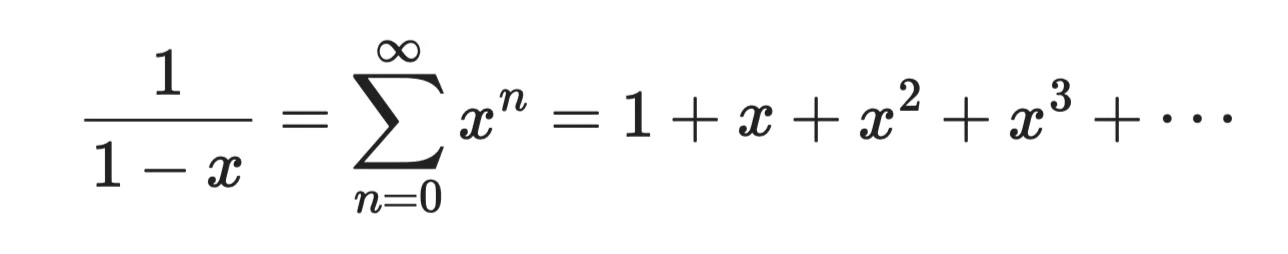
Série geométrica
Ela só converge para |x| < 1. É o ponto de partida para deduzir muitas outras séries de Taylor e aparece em teoria das probabilidades, processamento de sinais e em qualquer lugar onde você soma valores futuros descontados.
Se você quer algo palpável, imprimível, para colar na parede ao lado da cama, tá na mão:
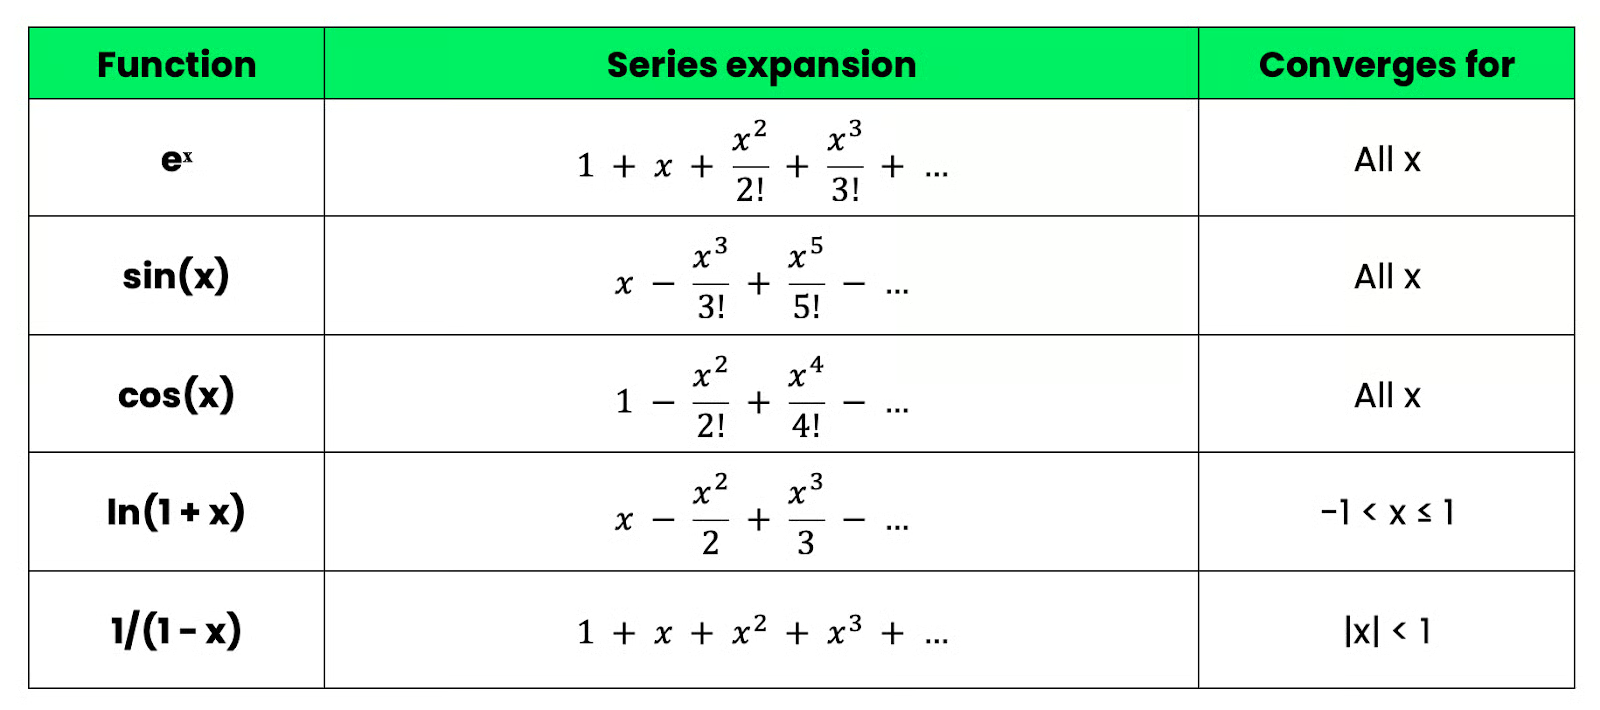
Guia rápido de séries de Taylor
Essas cinco séries cobrem a maioria dos casos que você vai encontrar em data science e machine learning.
Taylor, Fourier e Maclaurin aproximam funções, mas resolvem problemas diferentes e funcionam melhor em contextos distintos.
Séries de Taylor e de Fourier representam funções como somas infinitas, mas fazem isso de modos completamente diferentes.
Uma série de Taylor constrói a função com polinômios — potências de (x - a). Ela funciona aproximando um ponto e capturando o comportamento local da função por meio de suas derivadas. O resultado é preciso perto do ponto central a, mas a precisão cai à medida que você se afasta.
Uma série de Fourier usa senos e cossenos como blocos de construção:
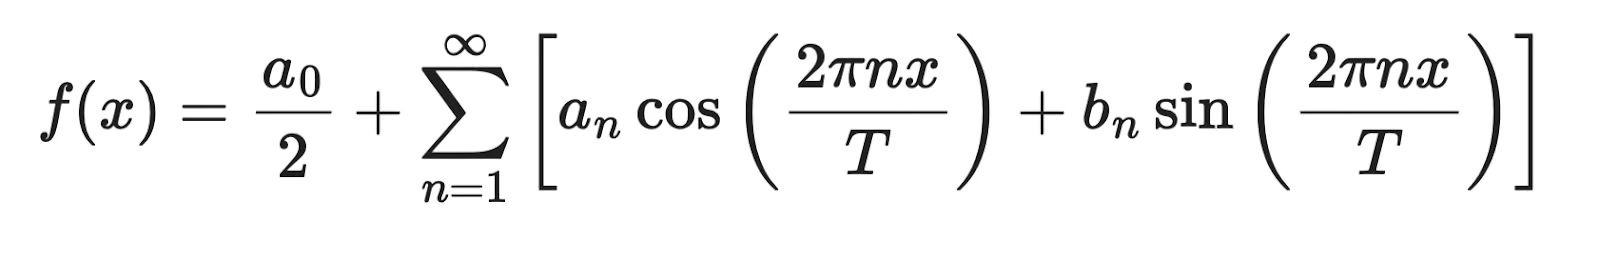
Série de Fourier
Em vez de capturar o comportamento local em um ponto, séries de Fourier capturam o comportamento periódico global em todo um intervalo. São feitas para funções que se repetem — pense em sinais de áudio, padrões sazonais ou qualquer coisa que oscile.
Veja a comparação lado a lado:
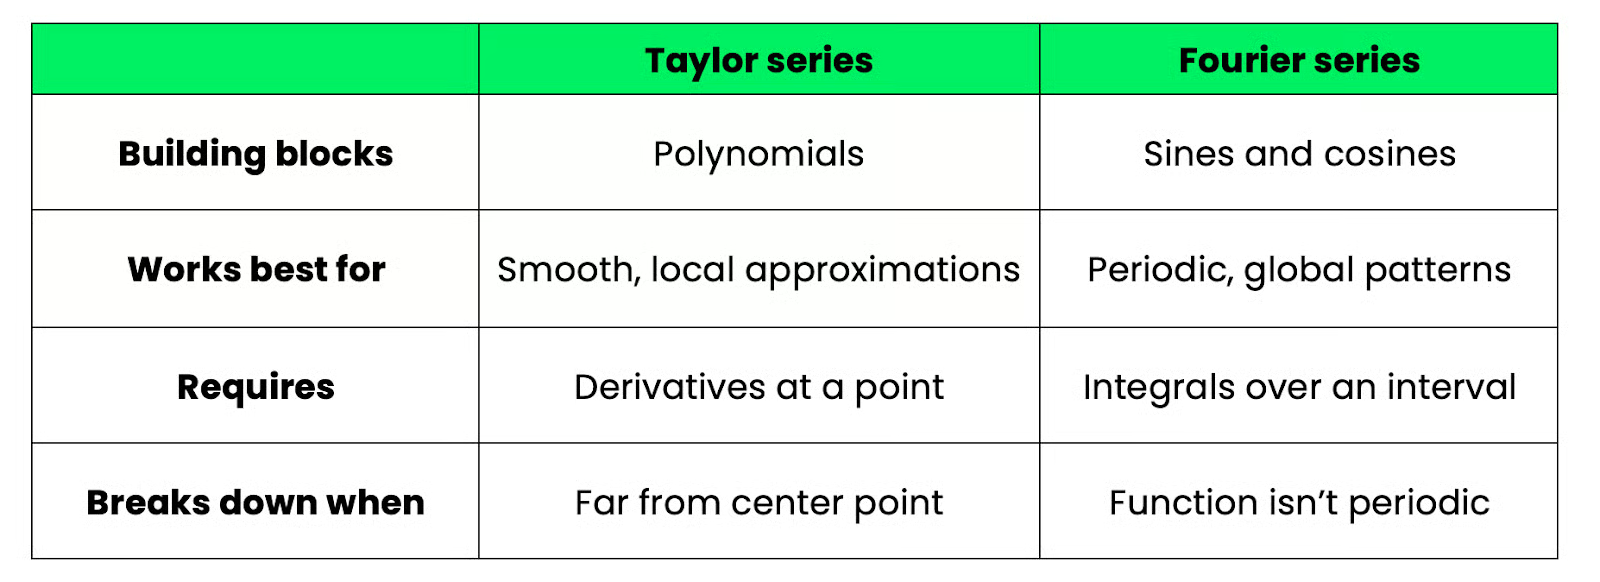
Comparação: Taylor vs. Fourier
Séries de Fourier aparecem em processamento de sinais e análise de séries temporais — análise espectral, decomposição em frequências e até algumas arquiteturas de redes neurais como a FNet, que substitui atenção por transformadas de Fourier.
Se você trabalha com dados tabulares, imagens ou otimização, séries de Taylor são mais relevantes. Se trabalha com áudio, séries temporais ou qualquer coisa com estrutura periódica, séries de Fourier são a melhor escolha.
Esta é simples: uma série de Maclaurin é apenas uma série de Taylor centrada em a = 0.
A fórmula geral da série de Taylor é:
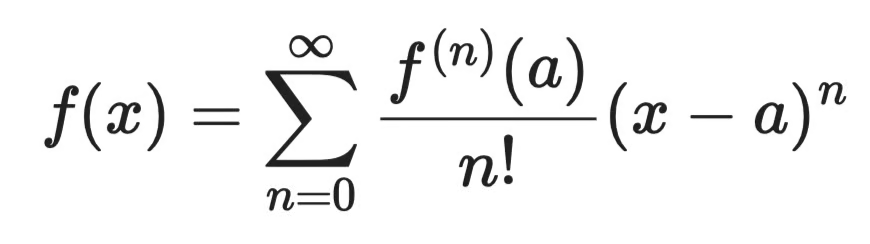
Série de Maclaurin
Defina a = 0 e você obtém:
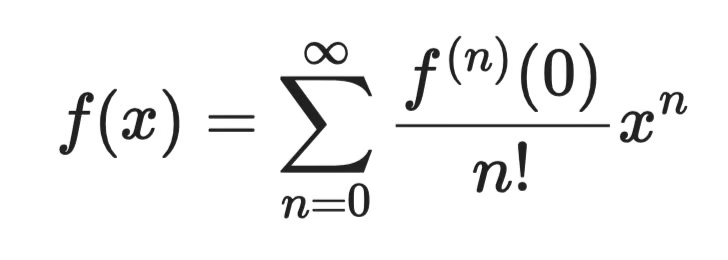
Série de Maclaurin em a = 0
Colin Maclaurin usou esse caso específico tantas vezes em seu trabalho que ele ganhou um nome próprio, mas, matematicamente, não é mais do que uma série de Taylor em um ponto central particular.
Na prática, a maioria das séries que você vai ver — eˣ, sin(x), cos(x), ln(1 + x) — são séries de Maclaurin, porque centralizar em zero simplifica a álgebra. Quando você precisa aproximar uma função perto de outro ponto, desloca o centro para a ≠ 0 e obtém uma série de Taylor geral.
Resumindo: toda série de Maclaurin é uma série de Taylor, mas nem toda série de Taylor é de Maclaurin.
Séries de Taylor e modelos lineares podem parecer desconectados à primeira vista, mas há uma relação bem útil aqui, que começa com a aproximação de Taylor de primeira ordem.
Quando você trunca uma série de Taylor após o primeiro termo, obtém uma aproximação linear de uma função perto de um ponto a:
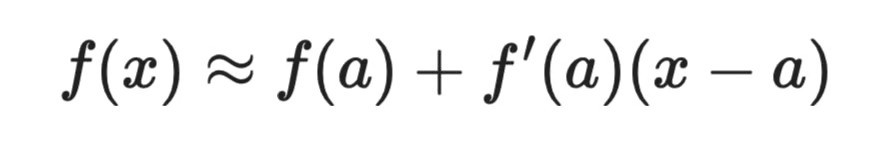
Séries de Taylor e modelos lineares (1)
Isso é uma reta. Tem inclinação (f'(a)) e intercepto (f(a) - f'(a) ⋅ a). Soa familiar? É a mesma estrutura de um modelo de regressão linear simples:
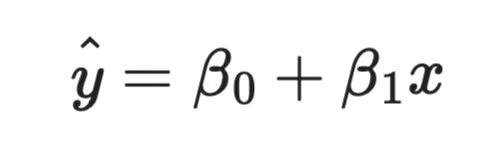
Séries de Taylor e modelos lineares (2)
A diferença está na origem de cada um. Na aproximação de Taylor, a inclinação e o intercepto são determinados pelas derivadas da função em um único ponto. Na regressão linear, eles são estimados a partir dos dados para minimizar o erro de previsão. Mas, estruturalmente, fazem a mesma coisa.
Ela explica por que modelos lineares funcionam bem em certas situações e falham em outras.
A regressão linear assume que a relação entre entrada e saída é — ou pode ser tratada como — linear. Séries de Taylor dizem exatamente quando essa suposição vale: quando suas entradas permanecem próximas de um ponto fixo e a função que você aproxima é suave. Se você empurra as entradas para longe desse ponto, a aproximação linear desmorona — o mesmo motivo pelo qual a regressão linear costuma falhar em dados com padrões fortemente não lineares.
Os modelos lineares generalizados (GLMs) deixam essa conexão ainda mais explícita.
A regressão logística, por exemplo, modela o log-odds de um desfecho como uma função linear. A ponte entre o preditor linear e a probabilidade de saída passa pela função sigmoide — e, como você viu, a sigmoide tem uma expansão de Taylor bem comportada perto de zero.
Quando você entende que uma expansão de Taylor de primeira ordem te dá um modelo linear, o próximo passo é incluir mais termos — e você obtém um modelo polinomial.
Uma expansão de Taylor de segunda ordem dá:
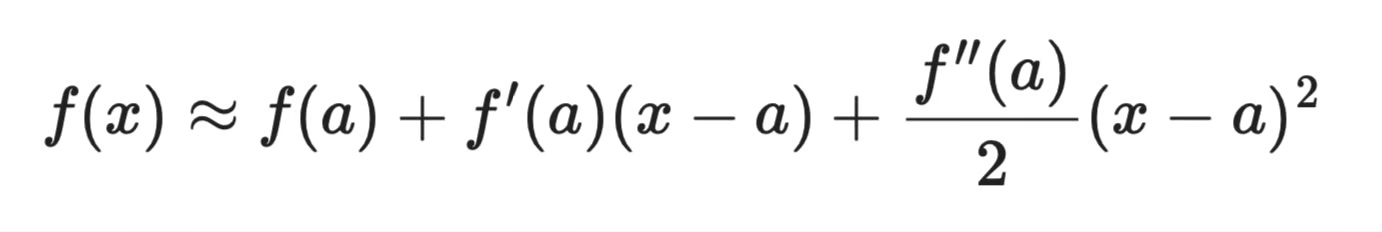
Série de Taylor de segunda ordem
Isso é um quadrático — um modelo de regressão polinomial com termo ao quadrado. Cada termo adicional de Taylor corresponde a um polinômio de grau maior, que é como a regressão polinomial estende a regressão linear para capturar relações curvas.
Assim, séries de Taylor oferecem um jeito estruturado de pensar sobre o trade-off viés-variância em regressão. Uma aproximação de primeira ordem (modelo linear) é rápida e interpretável, mas tem alto viés se a relação verdadeira for não linear. Aproximações de ordem mais alta ajustam melhor os dados perto do ponto de expansão, mas aumentam o risco de overfitting conforme você adiciona termos.
Se quiser se aprofundar em regressão linear e quando ela funciona, o tutorial Essentials of Linear Regression in Python é um bom próximo passo. Para quem usa R, o curso Intermediate Regression in R cobre regressão polinomial e diagnósticos de modelos em detalhe.
Séries de Taylor são uma daquelas ferramentas matemáticas que você começa a ver em todo lugar quando sabe o que procurar.
Você viu como elas permitem que computadores avaliem funções como eˣ e sin(x) por meio de aritmética básica, como convergência e erro de truncamento determinam a precisão de uma aproximação e como a mesma ideia impulsiona o gradient descent, o XGBoost e aproximações de funções de ativação no machine learning moderno.
As cinco séries clássicas — exponencial, seno, cosseno, logaritmo e geométrica — valem ser memorizadas. Elas aparecem com tanta frequência que reconhecê-las de cara economiza tempo de verdade.
Daqui, o próximo passo é ganhar confiança no pensamento algorítmico que anda de mãos dadas com esse tipo de matemática. Nosso curso Data Structures and Algorithms in Python é um ótimo lugar para construir essa base. Ele ajuda você a entender como ideias matemáticas viram código que funciona e escala.
Aprenda com a DataCamp
Curso
Curso
Curso