
Last chance! 50% off DataCamp Premium
Sale ends in
Bayangkan Anda berkata kepada seseorang, “Ambil mug itu dan letakkan di rak.” Mereka tidak butuh diagram; mereka cukup melihat mug, memahami kalimatnya, dan tangan mereka bergerak ke sana.
Tiga hal berbeda terjadi hampir bersamaan. Melihat, memahami, dan bergerak berlangsung nyaris serentak bagi orang itu, bukan tiga langkah terpisah yang diserahkan antarbagian otak yang berbeda.
Sepanjang sebagian besar sejarah AI robotik, mesin tidak bekerja seperti itu sama sekali.
Dulu, kita memiliki model vision-language yang dapat melihat meja kerja berantakan dan menjelaskan dengan tepat apa yang ada di atasnya, termasuk detail halus seperti merek sebuah alat.
Pengendali robot klasik bisa mengangkat obeng itu dengan andal, asalkan tidak ada yang menggesernya dua sentimeter ke kiri. Dua sisi masalah—melihat dan memahami di satu sisi, dan bertindak di sisi lain—berkembang hampir sepenuhnya terpisah.
Di sinilah model Vision-language-action (VLA) hadir – upaya untuk menutup kesenjangan itu.
Dalam artikel ini, kita akan melihat apa itu model VLA dan bagaimana arsitektur tiga bagiannya bekerja. Kita akan membahas perbedaannya dengan model vision-language (VLM) dan kontrol robot klasik, model-model yang benar-benar relevan pada 2026, serta di mana model itu digunakan. Terakhir, kita akan melihat apa saja yang masih keliru pada mode CLA.
Mari mulai dengan mendefinisikan secara formal apa itu model VLA:
Model vision-language-action adalah sistem AI yang memproses feed kamera, instruksi bahasa alami, dan status robot itu sendiri, lalu menghasilkan perintah motorik, dengan modul visi, bahasa, dan aksinya dilatih secara bersama dan dijalankan dalam satu forward pass alih-alih sebagai pipeline klasik persepsi-lalu-perencanaan-lalu-kontrol.
Intinya adalah persepsi, bahasa, dan aksi bukan sistem terpisah yang dijahit dengan kode perekat buatan tangan.
Submodul dilatih bersama. Jadi, kesalahan visi atau bahasa yang akan menggagalkan serah terima pada pipeline klasik dikoreksi oleh gradient descent, bukan ditangkap—atau terlewat—oleh antarmuka yang di-hard-code.
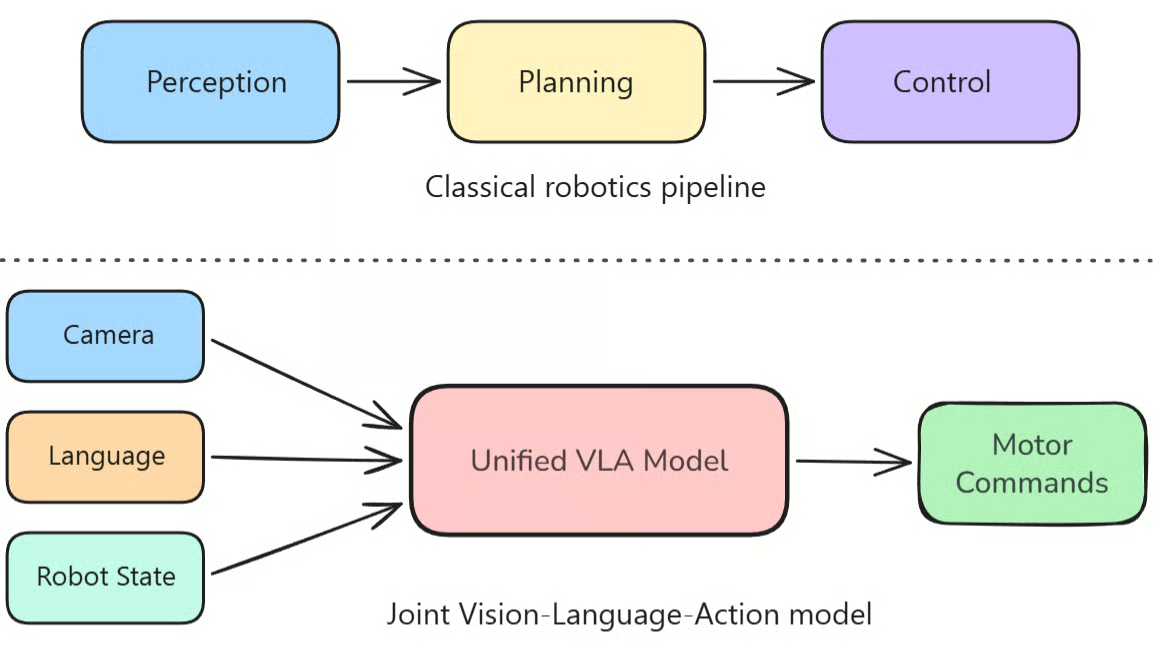
Tiga kotak dan dua serah terima rapuh di atas, satu model terpadu di bawah. Inilah perbedaan struktural yang saya maksud. Gambar oleh Penulis.
Saya suka membedakannya begini: VLM adalah otak tanpa tubuh, dan VLA memberinya tubuh.
Persepsi bukan layanan terpisah yang dipanggil robot, melainkan terhubung ke pipeline yang dilatih bersama dan memutuskan seberapa jauh gripper harus bergerak.
Sejauh ini saya juga menyebut VLM, jadi mari bandingkan kedua arsitektur ini.
VLM (Vision-Language Model) menerima gambar dan teks serta menghasilkan teks atau embedding.
Sementara VLA (Vision-Language-Action Model) menerima jenis input yang sama dan menghasilkan tindakan sebagai gantinya.
Kedengarannya perubahan kecil sampai Anda melihat dampaknya di hilir:
|
Vision-language model (VLM) |
Vision-language-action model (VLA) |
|
|---|---|---|
|
Input |
Gambar, video, teks |
Gambar (sering dari banyak kamera), teks, status propioseptif robot |
|
Output |
Teks, embedding |
Perintah motorik kontinu atau yang didiskretisasi |
|
Kemampuan utama |
Mendeskripsikan dan menalar tentang sebuah skena |
Bertindak pada sebuah skena |
|
Bisakah bertindak di dunia nyata? |
Tidak |
Ya |
|
Data pelatihan |
Pasangan gambar-teks yang di-scrape dari web |
Data web plus trajektori demonstrasi robot |
|
Aplikasi tipikal |
Visual question answering, captioning, parsing dokumen |
Manipulasi, navigasi, kontrol humanoid |
Anda mungkin pernah mendengar model seperti GPT-4V, Gemini, atau LLaVA.
Asumsi yang sangat umum adalah bahwa VLA hanyalah salah satunya yang dipasangi lengan robot.
Namun, tidak sesederhana itu.
Model harus mempelajari ruang output yang benar-benar baru, di mana sebuah token berkaitan dengan besaran fisik nyata, seperti perpindahan end-effector atau bukaan gripper, dan ketika salah, dampaknya bisa menyingkirkan cangkir dari meja alih-alih hanya menghasilkan kalimat yang agak janggal.
Jika Anda ingin melihat bagaimana GPT-4V, Gemini, dan LLaVA dibandingkan dengan model lain, artikel DataCamp Top 10 Vision Language Models in 2026 merangkum para pemimpin saat ini.
Ada juga konsekuensi dari sisi data.
VLM dapat berlatih pada miliaran pasangan gambar-teks karena internet menyediakannya secara gratis.
Namun, trajektori robot harus dikumpulkan oleh robot nyata yang melakukan tugas nyata, biasanya di bawah teleoperasi. Itulah tepatnya mengapa dataset robotika terbuka terbesar, Open X-Embodiment, berhenti di sekitar 1 juta trajektori, bukan 1 miliar.
Mengumpulkan trajektori semacam itu secara manual juga sangat mahal dan lambat.
22 perwujudan, satu dataset, dan totalnya tetap di bawah 1 juta trajektori. Inilah yang saya maksud saat mengatakan data robot tidak dapat diskalakan seperti teks web. Sumber: laman proyek Open X-Embodiment.
Sebelum membahas cara kerja Arsitektur VLA, saya juga ingin mengeksplorasi dan membandingkannya dengan kontrol robot klasik.
Kontrol robot klasik dibuat untuk satu tugas di satu tempat, dalam kondisi yang dikunci terlebih dahulu.
Ambil contoh lengan mesin penjual otomatis.
Lengan itu mengambil camilan yang sama dari rak yang sama di lokasi yang sama setiap kali karena pencahayaan, posisi objek, dan gerakan yang diperlukan tidak berubah antar pengambilan.
Pengaturan yang sempit dan tidak berubah itulah yang membuat sistem kendali bisa kaku sekaligus andal.
Namun kini ubah konfigurasi internal mesin penjual, atau ubah pencahayaan, atau jatuhkan benda yang tidak pernah masuk rencana ke dalam skena.
Kini pengendali akan benar-benar gagal karena belum pernah melihat lingkungan seperti ini.
VLA melakukan generalisasi lebih baik ke kondisi yang tidak pernah secara eksplisit dilatih, karena backbone VLM yang mendasarinya sudah tahu seperti apa rupa mug, handuk, atau laci dari pretraining berskala web sebelum model melihat demonstrasi robot sama sekali.
Fine-tuning pada seratus contoh melipat handuk memungkinkan model belajar bagaimana bergerak untuk objek yang sudah dikenali.
Transfer itulah terobosan sebenarnya di sini, bukan presisi mentah, dan saya ingin menekankan bahwa pengendali klasik yang disetel baik masih bisa mengalahkan VLA dalam hal presisi pada lingkungan yang tetap dan terkontrol.
Mari menyelami arsitekturnya.
Untuk artikel ini, saya memilih Arsitektur OpenVLA karena mudah dipahami.
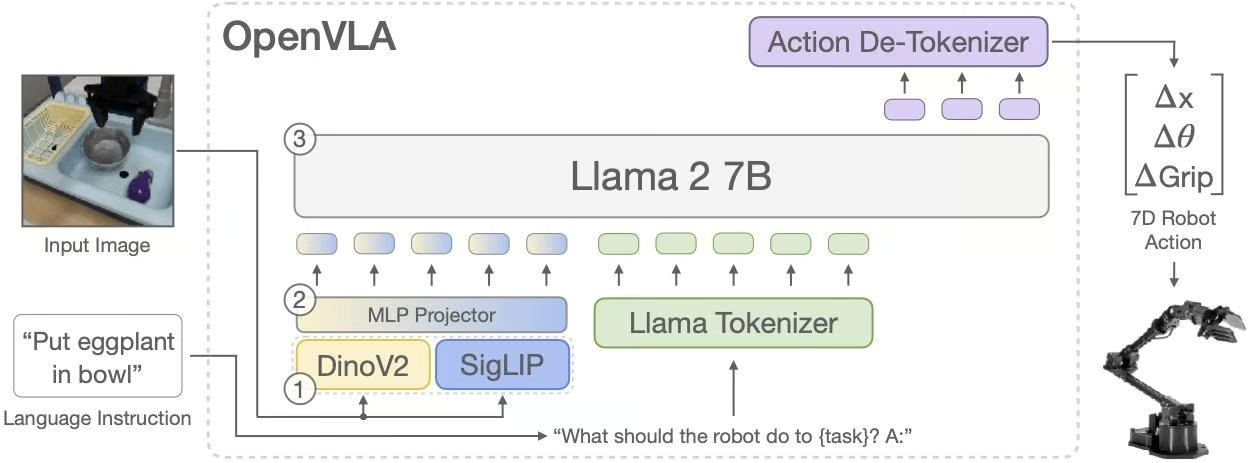
Inilah pipeline yang saya jelaskan di bawah: DINOv2 dan SigLIP memberi masukan ke backbone Llama 2, dengan action decoder memprediksi token terdiskretisasi di sisi keluaran. Sumber: laman proyek OpenVLA.
VLA memiliki tiga modul terpisah:
Ketiganya dilatih end-to-end secara bersama.
Representasi visi dan bahasa digabungkan, dan representasi gabungan inilah yang diubah action decoder menjadi perintah motorik.
Penting dicatat, ketiga bagian terkait erat alih-alih berpipeline—ini keputusan desain yang membedakan VLA dari VLM yang dibautkan ke pengendali.
Jika membantu, anggaplah seperti yang saya jelaskan tentang pemisahan visi, memori, dan pengendali dalam makalah World Models asli: ia melihat, ia memahami, ia bertindak.
Bedanya, VLA mempelajari ketiganya bersama, end-to-end, dari demonstrasi, alih-alih melatih setiap bagian secara terpisah lalu menjahitnya kemudian.
Sekarang mari kita bahas masing-masing secara terpisah.
Vision encoder mengubah frame kamera mentah menjadi representasi padat yang dapat benar-benar digunakan oleh jaringan lainnya.
VLA modern menggunakan vision transformer pralatih seperti DINOv2 atau SigLIP, dan cukup sering keduanya sekaligus.
OpenVLA adalah contoh baik penggunaan keduanya.
Ia menggabungkan DINOv2, yang kuat pada detail spasial dan geometris, dengan SigLIP, yang lebih kuat pada fitur semantik yang selaras baik dengan bahasa.
Dua set fitur ini dikonkatenasi per patch gambar dan diproyeksikan ke ruang embedding model bahasa (dalam hal ini LLama 2 7B).
Perlu saya sebutkan bahwa menggunakan lebih dari satu kamera adalah standar pada penerapan nyata.
Misalnya, kamera yang dipasang di pergelangan tangan memberi detail jarak dekat saat pendekatan akhir ke objek, kamera di atas kepala memberikan tata letak skena, dan tampak samping membantu kedalaman yang tidak bisa dipulihkan oleh satu kamera saja.
pi0 (dibahas di bawah) mengambil banyak tampak kamera plus status propioseptif robot.
Harap dicatat bahwa input status lebih penting daripada kedengarannya, karena foto lengan tidak memberi tahu torsi yang saat ini ada di sendi.
Sisi bahasa mengenkode sebuah instruksi, seperti “angkat balok merah dan letakkan di kotak biru,” menjadi representasi yang selaras dengan fitur visual dalam ruang yang sama.
Hampir setiap VLA menggunakan ulang backbone large language model (LLM) pralatih alih-alih melatih encoder teks dari nol.
Dalam kasus kita, OpenVLA menggunakan Llama 2 7B. pi0 dan pi0.5 dibangun di atas PaliGemma, VLM 3 miliar parameter. SmolVLA menggunakan tumpukan SmolVLM2 yang dimodifikasi.
Menggunakan ulang LLM seperti ini pada dasarnya soal pewarisan.
Anda mendapatkan kemampuan mengikuti instruksi dan pemahaman komposisional, itulah sebabnya VLA sering dapat menangani “masukkan buah ke dalam mangkuk” meski tidak pernah melihat frasa persis itu saat pelatihan robot.
Action decoder adalah tempat representasi gabungan benar-benar menjadi perintah motorik, dan di sinilah desain VLA paling banyak berbeda satu sama lain. Saat ini ada tiga pendekatan besar.
Anda memotong setiap dimensi aksi menjadi bin diskret dan memprediksinya satu per satu, sama seperti setup next-token yang sudah dikenal LLM saat berlatih.
OpenVLA menggunakan 256 bin per dimensi dan loss next-token biasa, sehingga Anda bisa tetap memakai peranti LLM yang umum.
Komprominya adalah resolusi dan kecepatan—pembinning meninggalkan gerak bergerigi, dan sampling token demi token terlalu lambat untuk apa pun yang cepat atau kaya kontak.
Alih-alih memprediksi satu token sekaligus, model memperlakukan generasi aksi sebagai proses denoising dan menghasilkan satu potong aksi kontinu sekaligus.
pi0 adalah VLA pertama yang dibangun di sekitar kepala aksi flow-matching, di mana mereka melakukan denoising sekitar 10 langkah untuk menghasilkan potongan hingga 50 aksi ke depan.
Hasilnya gerak menjadi jauh lebih halus daripada pendekatan berbasis token.
Model yang lebih besar menangani penalaran tingkat tinggi dan memecah tugas menjadi langkah-langkah, sementara pengendali yang lebih kecil dan cepat menangani eksekusi presisi berfrekuensi tinggi.
Contoh yang sangat baik menurut saya adalah Gemini Robotics 1.5, yang memasangkan model penalaran dengan model aksi.
Menurut saya pribadi, setelah membaca banyak makalah ini, orang lebih banyak memperdebatkan ukuran backbone ketimbang kepala aksi, dan saya rasa itu terbalik.
Jika decoder Anda memampatkan aksi kontinu 7 dimensi menjadi 256 bin diskret, kualitas backbone sebaik apa pun tidak akan mengembalikan kehalusan itu!
Sekarang saya ingin menyajikan tabel yang menampilkan beberapa Model VLA penting yang kemungkinan akan Anda temui:
|
Model |
Pengembang |
Parameter |
Kepala aksi |
Lisensi |
Perangkat keras |
Terbaik untuk |
|---|---|---|---|---|---|---|
|
OpenVLA |
Stanford, Berkeley, dan kolaborator |
7B |
Token autoregresif |
MIT |
A100 atau H100, atau 24GB dengan kuantisasi 4-bit |
Baseline riset terbuka |
|
Octo |
UC Berkeley |
27M atau 93M |
Kebijakan difusi |
MIT |
Satu RTX 4090 |
Pekerjaan dengan komputasi terbatas |
|
pi0 / pi0.5 / pi0.6 |
Physical Intelligence |
3,3B (backbone 3B plus 300M action expert) |
Flow matching |
Checkpoint terbuka (openpi) |
Multi-GPU atau satu A100 |
Tugas lincah dan horizon panjang |
|
Gemini Robotics 1.5 |
Google DeepMind |
Tidak diungkap |
Hibrida, cloud plus edge |
Tertutup |
Terikat cloud |
Baseline kepemilikan frontier |
|
SmolVLA |
Hugging Face |
450M |
Flow matching |
Apache 2.0 |
RTX 3060, GPU laptop, atau Jetson |
Robotika hobi dan edge |
Sekarang mari kita bahas masing-masing di bawah ini, dimulai dari baseline riset yang masih paling sering dijadikan pembanding.
OpenVLA adalah model 7 miliar parameter yang dilatih pada 970.000 demonstrasi robot dunia nyata yang diambil dari Open X-Embodiment.
Model ini menggabungkan backbone Llama 2 7B dengan vision encoder gabungan DINOv2 dan SigLIP yang sudah saya jelaskan, dan keseluruhan model bersifat open source.
Hasil yang mengejutkan adalah model ini mengalahkan model tertutup RT-2-X sebesar 16,5 poin persentase keberhasilan tugas di 29 tugas, padahal RT-2-X menjalankan 55 miliar parameter dibanding 7 miliar pada OpenVLA!
Pelatihan total menggunakan 64 GPU A100 selama 15 hari.
Alasan model ini masih populer adalah karena fine-tuning LoRA dan kuantisasi 4-bit sama-sama bekerja baik padanya.
Artinya RTX 4090 24GB dapat menjalankan versi terkuantisasi, dan sebagian besar karya yang dipublikasikan tentang serangan, pertahanan, dan pruning VLA menggunakan OpenVLA sebagai target karena sangat mudah diakses.
Tindak lanjut—OpenVLA-OFT memperbaiki resep fine-tuning untuk kecepatan dan tingkat keberhasilan.
Octo adalah VLA kecil dengan dua ukuran—27 juta dan 93 juta parameter di atas backbone ViT-S dan ViT-B—dan dapat dijalankan pada satu RTX 4090 di 20 hingga 30 Hz.
Model ini dilatih pada sekitar 800.000 trajektori dari Open X-Embodiment di 22 perwujudan robot, dan arsitektur transformernya benar-benar modular.
Anda dapat menambah input observasi baru atau menukar kepala aksi saat fine-tuning tanpa membangun ulang model dari nol, dan model ini mendukung token diskret dan aksi kontinu berbasis difusi sesuai kebutuhan.
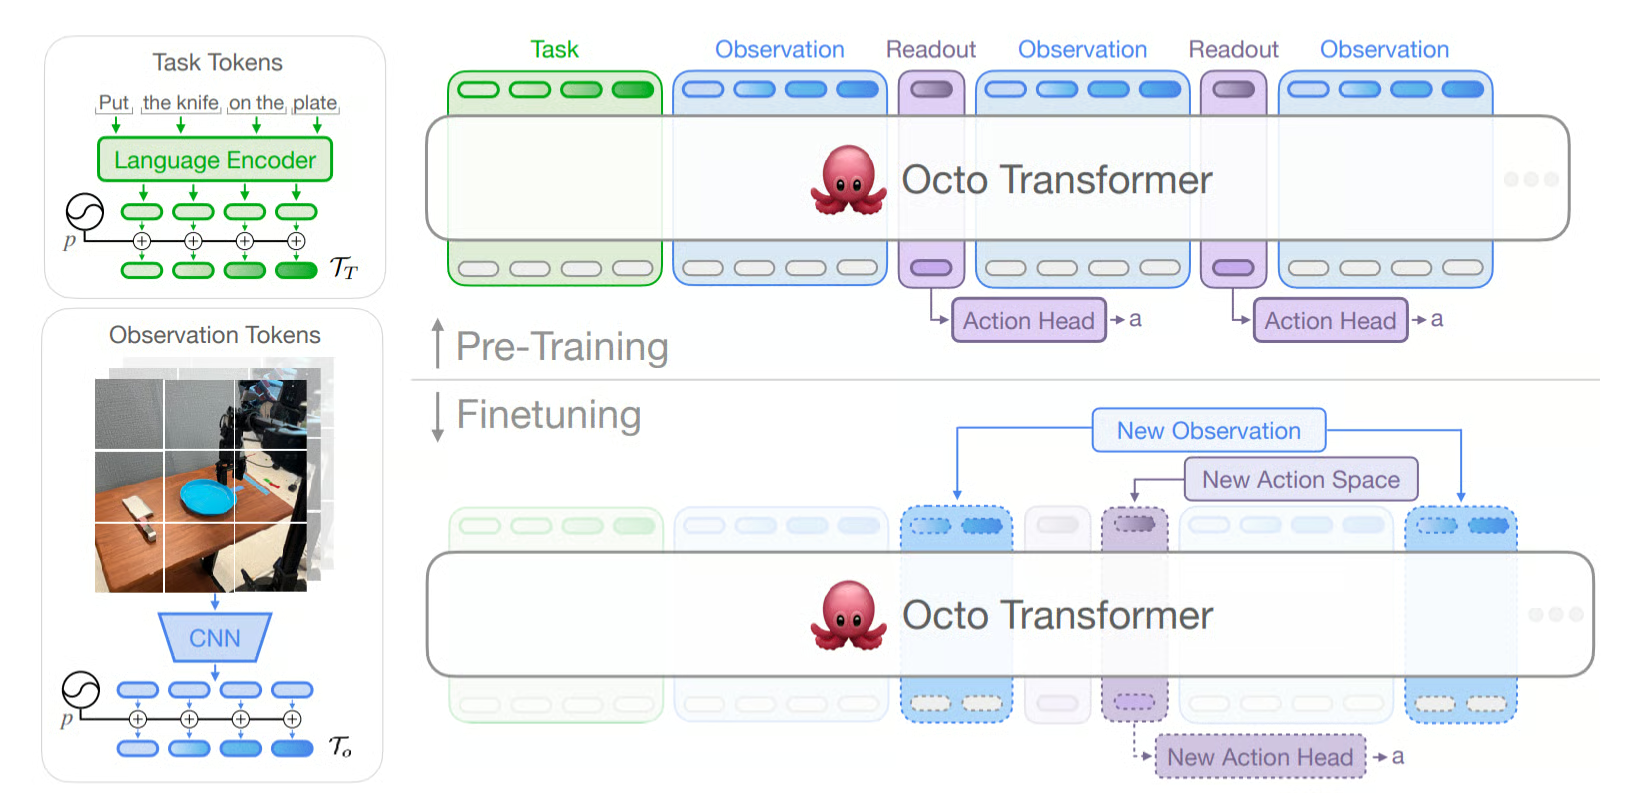
Transformer Octo: token tugas dan observasi masuk, token readout keluar ke kepala aksi, dengan ruang untuk menambah sensor atau ruang aksi baru saat fine-tuning. Sumber: makalah Octo.
Saya pribadi menggunakan Octo setiap kali faktor pembatasnya adalah komputasi, bukan kesulitan tugas.
Model ini juga mendukung pengkondisian gambar tujuan, yang berguna saat mendeskripsikan keadaan target dengan kata-kata lebih canggung ketimbang menunjukkan foto yang diinginkan.
pi0 dari Physical Intelligence sangat andal dalam kelincahan tangan. Model ini berangkat dari PaliGemma, sebuah VLM terbuka 3 miliar parameter, dan menambahkan action expert 300 juta parameter yang dilatih dari nol, menghasilkan total 3,3 miliar parameter.
Model ini menggunakan flow matching untuk menghasilkan potongan hingga 50 aksi ke depan sekaligus, bukan selangkah demi selangkah.
Hasil kunci adalah tugas bimanual seperti melipat cucian, mengemas bahan belanja, dan merakit kotak, semuanya ditangani dengan tingkat kelincahan yang belum pernah ditunjukkan sebelumnya.
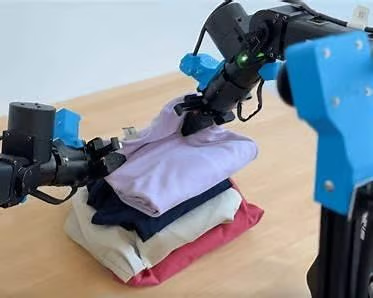
Robot pi0 melipat cucian menggunakan dua lengan. Ini salah satu tugas bimanual yang saya sebut, melipat cucian, dan layak ditonton, bukan sekadar dibaca. Sumber: Physical Intelligence, “pi0: Our First Generalist Policy”.
Flow matching adalah kunci utamanya di sini, karena mengoordinasikan dua lengan sekaligus membutuhkan output kontinu 16 dimensi yang halus, dan baik token diskret maupun sampling difusi yang lambat tidak bisa memberikannya pada kecepatan yang dapat digunakan.
Keluarga pi0 terus berkembang:
Satu catatan yang ingin saya tekankan adalah bahwa hasil terkuat pi0 bergantung pada data kepemilikan yang dikumpulkan di armada robot mereka sendiri.
Tidak ada pihak luar yang mereplikasi angka persis itu hanya dengan data publik, jadi seberapa besar kinerja berasal dari arsitektur versus keunggulan data masih benar-benar belum terjawab.
Gemini Robotics 1.5 dari Google DeepMind paling tepat dipahami sebagai dua model yang bekerja bersama, bukan satu.
Gemini Robotics-ER 1.5 adalah model embodied reasoning yang merencanakan, memanggil alat seperti Google Search, dan dapat mengestimasi kemajuan tugasnya sendiri.
Gemini Robotics 1.5 adalah VLA yang mengeksekusi keputusan model penalaran tersebut.
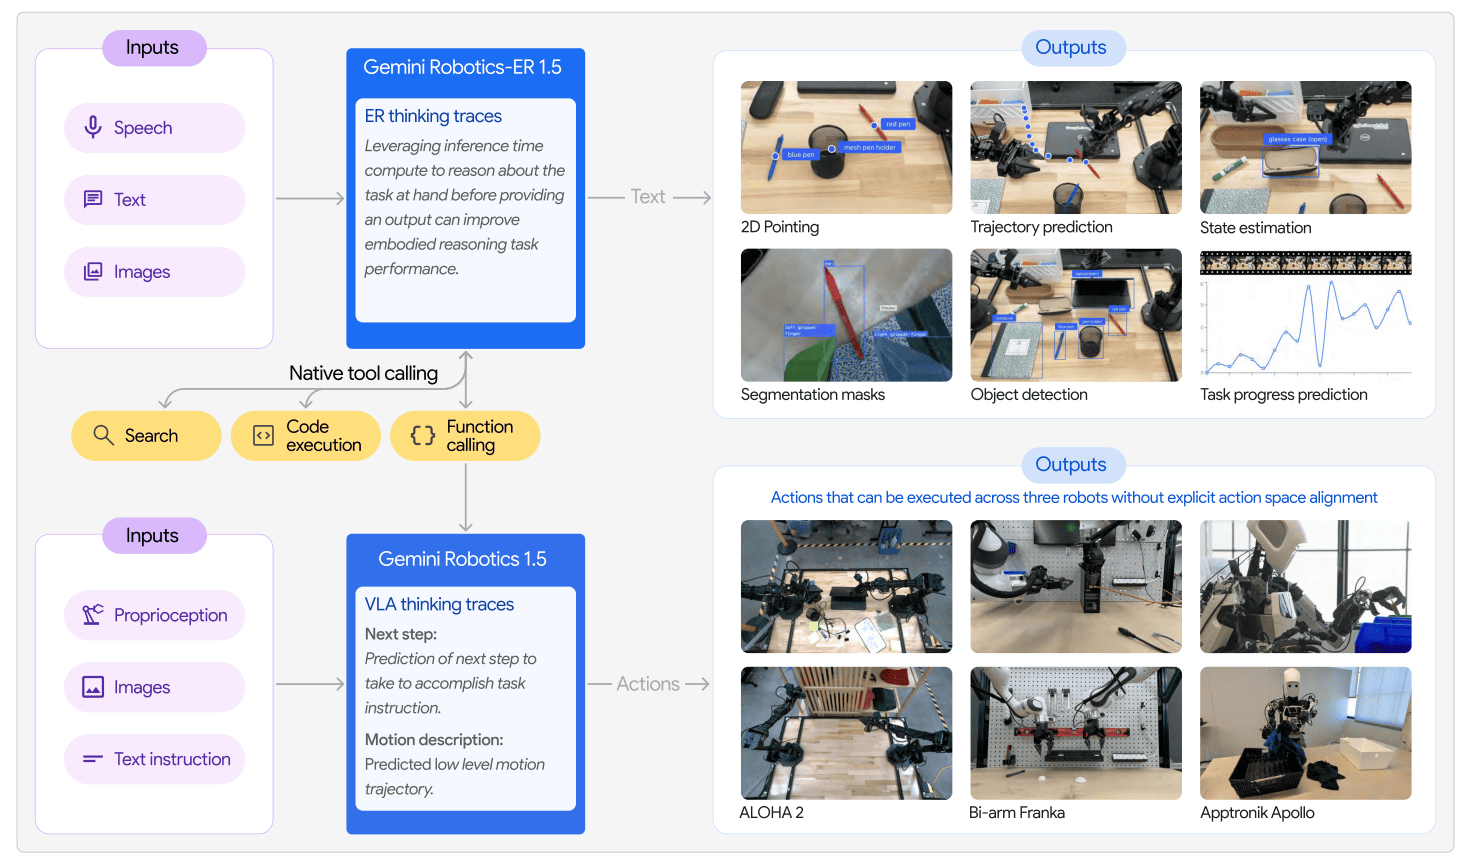
Gemini Robotics-ER 1.5 di atas untuk embodied reasoning, Gemini Robotics 1.5 di bawah sebagai VLA, pemanggilan alat bersama di tengah, dan aksi berjalan pada ALOHA 2, Franka, dan Apollo tanpa penyelarasan ruang aksi. Sumber: makalah Gemini Robotics 1.5.
Bagian yang berguna adalah pencampuran aksi dengan proses penalaran internal yang ditulis dalam bahasa alami, sehingga robot berpikir sebelum bertindak dan dapat menjelaskan keputusannya sesudahnya.
Diberi instruksi seperti “pilah cucian saya berdasarkan warna”, model ini terlebih dulu menyimpulkan bahwa pakaian putih masuk ke satu kotak dan sisanya ke kotak lain, lalu merencanakan pengambilan satu per satu.
DeepMind melaporkan sekitar 250 milidetik dari observasi ke aksi, frekuensi kendali efektif 50Hz, dicapai dengan menaruh penalaran berat di cloud dan menjaga action decoder ringan tetap lokal pada robot.
Hasil lain yang ingin saya tekankan adalah Motion Transfer, yaitu tugas yang dipelajari pada platform dual-arm ALOHA 2 dibawa langsung ke setup bi-arm Franka dan humanoid Apollo dari Apptronik, tanpa pelatihan ulang pada keduanya.
Bobot modelnya tertutup, jadi anggap ini sebagai baseline frontier kepemilikan alih-alih sesuatu yang bisa Anda unduh dan fine-tune sendiri.
SmolVLA dari Hugging Face memiliki 450 juta parameter (di bawah lisensi Apache 2.0). Model ini memasangkan backbone SmolVLM2 yang dimodifikasi dengan action expert flow-matching, menggunakan layer skipping dan pengurangan jumlah token visual untuk menjaga inferensi tetap hemat untuk perangkat keras kecil.
Model ini berjalan pada satu GPU konsumen, termasuk RTX 3060, pada CPU MacBook (meski lambat), dan dapat diterapkan di Jetson Orin untuk inferensi onboard.
Fine-tuning selama 20.000 langkah memakan waktu sekitar 4 hingga 5 jam pada satu GPU A100.
Meski dilatih pada kurang dari 30.000 episode, model ini menyamai atau mengalahkan model yang jauh lebih besar pada LIBERO, Meta-World, dan lengan robot nyata SO-100 dan SO-101.
Yang terbaik adalah keseluruhan model dipralatih pada dataset kontribusi komunitas melalui kerangka LeRobot.
Setelah memaparkan beberapa Model VLA, mari bahas mana yang perlu dipilih untuk proyek spesifik Anda.
Memilih di antara kelimanya terutama soal mencocokkan frekuensi kendali dan perangkat keras dengan setup Anda yang sebenarnya, bukan mengejar siapa yang berada di puncak leaderboard bulan lalu.
Kira-kira begini cara saya memikirkannya:
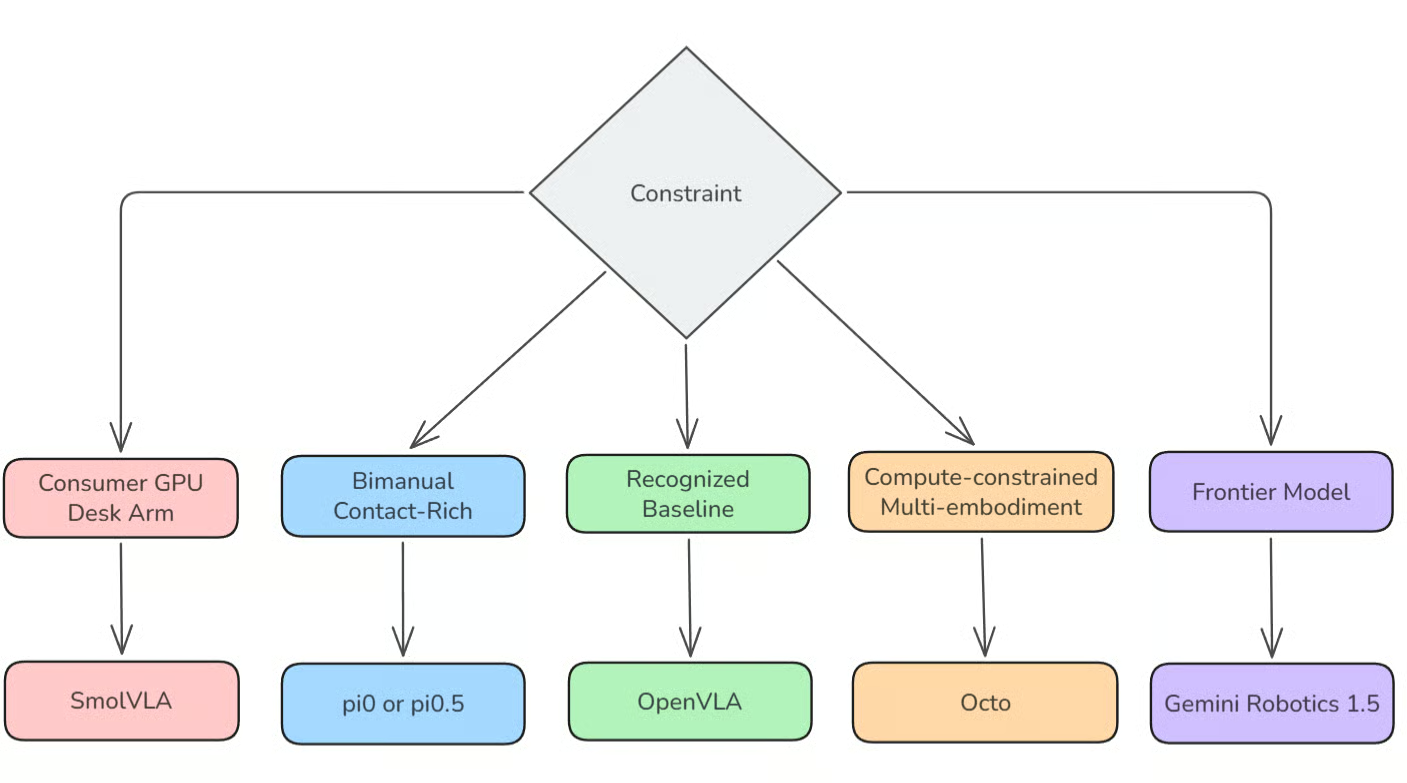
Lima kendala, lima model. Jika Anda hanya mengingat satu diagram dari artikel ini, jadikan yang ini. Gambar oleh Penulis.
Jika Anda memiliki GPU konsumen atau lengan SO-101 di meja, mulailah dengan SmolVLA. Tidak ada yang lain di ekosistem terbuka yang memberi kebijakan kerja semurah ini.
Dan poin besar terakhir yang ingin saya tekankan adalah seratus demonstrasi rapi pada SmolVLA hampir selalu mengalahkan lima puluh yang berantakan pada OpenVLA.
Maksud saya, habiskan 60 hingga 70 persen waktu proyek untuk pengumpulan data dan kontrol kualitas, sisanya untuk pelatihan.
VLA telah bergerak keluar dari video demo dan masuk ke sejumlah penerapan nyata, meski belum merata.
Pola yang saya lihat adalah mereka pertama kali hadir di lingkungan yang variasinya terlalu besar untuk diskrip, tetapi manusia masih dapat turun tangan saat terjadi masalah. Berikut beberapa contohnya:
Ini adalah medan utama, dengan tugas seperti pick-and-place, kitting, pengemasan, penyortiran, perakitan, dan sebagainya.
Ini adalah tugas di mana robot harus mengidentifikasi, mencengkeram, dan memosisikan ulang objek yang posisi dan orientasinya berubah di setiap percobaan—tepat kondisi yang buruk ditangani sistem terskrip.
Pekerjaan gudang dan pemenuhan adalah kasus komersial paling jelas saat ini. Pengambil terskrip butuh item disajikan dengan cara yang sama setiap kali, sementara yang berbasis VLA dapat bekerja dengan tote berisi empat puluh SKU berbeda yang tercampur.
Perusahaan termasuk Figure, 1X, dan Apptronik membangun fondasinya pada VLA, dan alasannya sederhana: robot berkaki dua dengan dua tangan fungsional memiliki terlalu banyak kemungkinan tugas untuk diskrip satu per satu.
Hasil Gemini Robotics Motion Transfer, di mana keterampilan yang dilatih di ALOHA 2 dibawa langsung ke humanoid Apollo dari Apptronik, adalah sifat yang tepat dibutuhkan program humanoid jika ingin berskala.
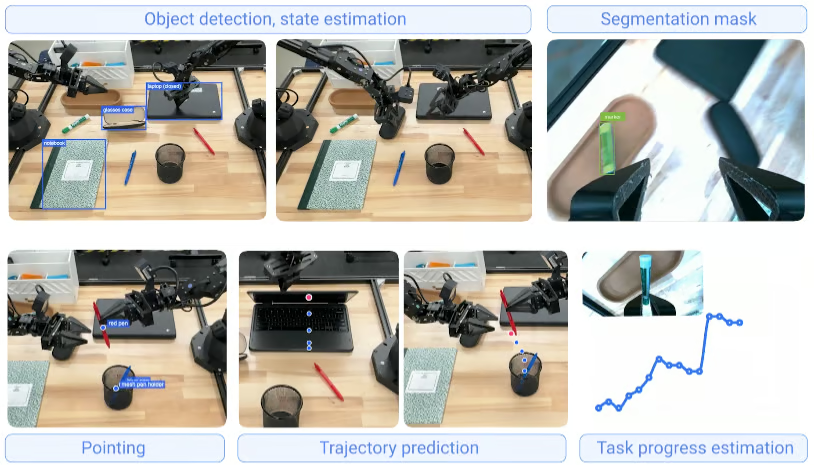
Keterampilan yang sama, dilatih sekali di ALOHA 2, berjalan di humanoid Apollo milik Apptronik tanpa pelatihan ulang. Sumber: Google DeepMind, “Gemini Robotics 1.5 brings AI agents into the physical world”.
Stack berkendara mulai mengadopsi arsitektur bergaya VLA untuk menghubungkan apa yang dilihat mobil dengan apa yang harus dilakukan selanjutnya, dalam satu loop penalaran alih-alih serah terima persepsi-ke-perencana.
Daya tariknya sama seperti pada manipulasi: situasi langka yang tak pernah diantisipasi aturan mana pun, ditangani oleh model yang telah melihat cukup dunia untuk menalarnya alih-alih membeku.
Perlu saya sebutkan ini adalah aplikasi paling awal tahapnya dalam daftar ini.
Gagasannya adalah sistem yang mampu mengikuti instruksi lisan dokter bedah dan menyesuaikan dengan kondisi jaringan yang bervariasi akan mengungguli sistem yang diprogram kaku, namun persetujuan regulatori adalah kendala utama di sini, bukan kapabilitas modelnya.
Saya memperkirakan aplikasi asistif dan pelatihan jauh sebelum apa pun yang mendekati otonom.
Meski VLA hebat, mereka masih memiliki kelemahan, khususnya pada empat aspek berikut:
VLA menangani variasi di awal tugas dengan cukup baik, tetapi ketika cengkeraman meleset di tengah jalan, atau objek bergeser di bawah gripper, pemulihannya tidak konsisten.
Sebagian besar data demonstrasi menangkap upaya yang berhasil, sehingga model sangat sedikit melihat contoh seperti apa pemulihan dari kesalahan itu sebenarnya.
Manipulasi halus membutuhkan loop kendali berjalan pada 10 hingga 100Hz, dan membuat model 7 miliar parameter atau lebih mencapai laju itu pada perangkat keras robot sendiri masih berupa aspirasi, belum rekayasa yang tuntas.
Inilah mengapa sebagian besar sistem terpasang menambat ke server edge atau memisahkan penalaran dari kontrol, seperti Gemini Robotics 1.5.
Kuantisasi, layer skipping, dan distilasi semuanya membantu, tetapi itu masih solusi sementara yang terus diiterasi, bukan jawaban final.
Kini bobot terbuka yang andal tersedia untuk siapa pun, data menjadi pembeda sebenarnya.
Mengumpulkan data teleoperasi yang beragam dan beranotasi baik itu lambat dan mahal, tidak seperti scraping web, dan jarak antara hasil terpublikasi pi0 dan apa yang direplikasi dengan data publik saja adalah bukti paling jelas tentang apa yang dibeli oleh keunggulan data privat.
VLA saat ini melakukan generalisasi dengan baik di dalam distribusi pelatihannya dan menurun terlihat di luar itu.
Model yang dilatih pada 22 perwujudan untuk manipulasi tabletop masih dapat berkinerja buruk pada bentuk tugas yang benar-benar belum pernah dilihat.
Seperti yang Anda lihat, model VLA menyatukan persepsi, pemahaman bahasa, dan generasi aksi dalam satu arsitektur—sebuah pergeseran struktural, bukan inkremental.
Hal yang bisa mereka lakukan dan tidak dapat dicapai kontrol klasik adalah melakukan generalisasi ke kondisi yang tidak pernah secara eksplisit dilatihkan, karena backbone bahasa dan visi sudah membawa model kerja tentang dunia fisik ke dalam robot sebelum melihat demonstrasi.
Yang paling mengejutkan saya tentang keadaan pada 2026 adalah betapa banyak pertanyaan tersulit telah bergeser.
Tiga tahun lalu, pertanyaan tersulit adalah arsitektur.
Kini, setelah OpenVLA, Octo, pi0, dan SmolVLA ada di GitHub untuk diunduh siapa pun, pertanyaan tersulit adalah kualitas data, perilaku pemulihan, dan apakah Anda benar-benar bisa menjalankan semua ini di 50Hz pada robot itu sendiri alih-alih di pusat data.
Jika Anda ingin melanjutkan, kursus Introduction to AI Agents dari DataCamp membahas konteks agen yang lebih luas, dan Large Language Models (LLMs) Concepts membahas sisi backbone.
Kursus Teratas di DataCamp
Kursus
Kursus
Kursus
blogs
Dario Radečić
15 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Javier Canales Luna
14 mnt



