Imaginez que vous disiez à quelqu'un : « Prends la tasse et pose-la sur l'étagère. » Pas besoin de schéma : la personne regarde la tasse, comprend la phrase, et sa main se dirige au bon endroit.
Trois choses différentes se produisent presque simultanément : voir, comprendre et bouger arrivent quasiment en même temps, et non comme trois étapes distinctes transmises entre différentes parties du cerveau.
Pendant la majeure partie de l'histoire de l'IA robotique, ce n'est pas du tout ainsi que fonctionnaient les machines.
Jusqu'ici, nous avions des modèles vision-langage capables d'observer un établi en désordre et de décrire précisément ce qui s'y trouvait, y compris des détails fins comme la marque d'un outil.
Des contrôleurs robotiques classiques savaient saisir ce tournevis de manière fiable, à condition que personne ne le déplace de deux centimètres vers la gauche. Les deux moitiés du problème — voir et comprendre d'un côté, agir de l'autre — ont été développées presque entièrement séparément.
C'est là qu'interviennent les modèles vision-langage-action (VLA) : ils visent à combler cet écart.
Dans cet article, nous allons voir ce que sont les VLA et comment fonctionne leur architecture en trois parties. Nous comparerons leurs différences avec les modèles vision-langage (VLM) et avec le contrôle robotique classique, puis nous passerons en revue les modèles qui comptent réellement en 2026 et leurs usages. Enfin, nous verrons ce que les VLA n'arrivent pas encore à faire correctement.
Qu'est-ce qu'un modèle vision-langage-action (VLA) ?
Commençons par une définition formelle :
Un modèle vision-langage-action est un système d'IA qui ingère un flux caméra, une instruction en langage naturel et l'état proprioceptif du robot, puis produit des commandes motrices. Ses modules de vision, de langage et d'action sont entraînés conjointement et exécutés en un seul passage avant (forward pass), au lieu d'une chaîne classique perception–planification–contrôle.
L'essentiel, c'est que la perception, le langage et l'action ne sont pas des systèmes séparés reliés par du code « colle » écrit à la main.
Ce sont des sous-modules entraînés ensemble. Ainsi, une erreur de vision ou de langage qui aurait fait dérailler une chaîne classique est corrigée par la descente de gradient, au lieu d'être interceptée — ou manquée — par une interface codée en dur.
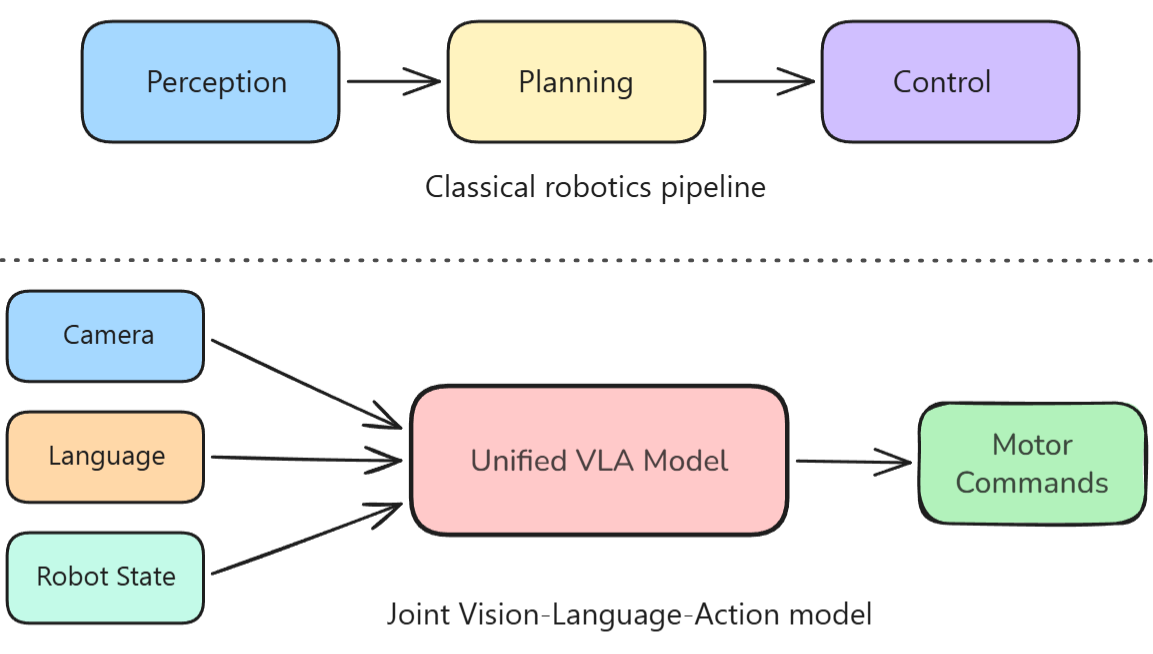
Trois boîtes et deux passages fragiles en haut, un modèle fusionné en bas. C'est la différence structurelle dont je parle. Image de l'auteur.
J'aime résumer la distinction ainsi : un VLM est un cerveau sans corps, un VLA lui en donne un.
La perception n'est pas un service séparé auquel le robot fait appel : elle est câblée dans la chaîne conjointement entraînée qui décide de combien déplacer la pince.
J'ai mentionné les VLM ; comparons donc ces deux architectures.
VLA vs vision-language model (VLM)
Un VLM (vision-language model) prend des images et du texte en entrée et produit du texte ou des embeddings.
Un VLA (vision-langage-action), lui, prend le même type d'entrée et produit à la place une action.
Cela paraît mineur jusqu'à ce que l'on voie l'impact en aval :
| |
Vision-language model (VLM)
|
Vision-language-action model (VLA)
|
|---|
|
Entrée
|
Images, vidéo, texte
|
Images (souvent plusieurs caméras), texte, état proprioceptif du robot
|
|
Sortie
|
Texte, embeddings
|
Commandes motrices continues ou discrétisées
|
|
Capacité principale
|
Décrire et raisonner sur une scène
|
Agir sur une scène
|
|
Peut-il agir dans le monde réel ?
|
Non
|
Oui
|
|
Données d'entraînement
|
Paires image–texte collectées sur le web
|
Données web plus trajectoires de démonstration robotique
|
|
Application type
|
VQA, légendage, analyse de documents
|
Manipulation, navigation, contrôle humanoïde
|
Vous avez sans doute déjà entendu parler de GPT-4V, Gemini ou LLaVA.
On suppose souvent qu'un VLA, c'est un de ces modèles avec un bras robotique branché dessus.
Ce n'est pas si simple.
Le modèle doit apprendre un nouvel espace de sortie, où un « token » correspond à une grandeur physique réelle (déplacement de l'effecteur, ouverture de pince, etc.), et où une erreur fait tomber une tasse de la table plutôt que de produire une phrase un peu étrange.
Si vous voulez comparer GPT-4V, Gemini et LLaVA au reste du paysage, Top 10 Vision Language Models in 2026 de DataCamp présente les leaders actuels.
Il y a aussi une conséquence côté données.
Un VLM peut s'entraîner sur des milliards de paires image–texte, car Internet les fournit gratuitement.
Les trajectoires robotiques, elles, doivent être collectées par un vrai robot exécutant une vraie tâche, souvent en téléopération : c'est précisément pourquoi le plus grand jeu de données ouvert en robotique, Open X-Embodiment, plafonne à environ 1 million de trajectoires et non 1 milliard.
La collecte manuelle de telles trajectoires est aussi très coûteuse et lente.
22 corps robotiques, un jeu de données, et toujours moins d'1 million de trajectoires au total. C'est ce que j'entends par « les données robotiques ne passent pas à l'échelle comme le texte web ». Source : page du projet Open X-Embodiment.
VLA vs contrôle robotique classique
Avant de détailler l'architecture VLA, comparons-la au contrôle robotique classique.
Le contrôle classique est conçu pour une tâche, dans un lieu, avec des conditions verrouillées à l'avance.
Prenez le bras d'un distributeur automatique, par exemple.
Il attrape toujours le même snack au même endroit sur la même étagère, car l'éclairage, la position des objets et les mouvements requis ne varient pas d'un prélèvement à l'autre.
Cet environnement étroit et immuable permet au système de contrôle d'être rigide et fiable.
Mais changez l'agencement interne, l'éclairage, ou ajoutez un objet non prévu dans la scène…
Le contrôleur s'effondre, car il n'a jamais vu cet environnement.
Un VLA généralise mieux à des conditions non vues explicitement à l'entraînement, car son épine dorsale VLM « sait » déjà à quoi ressemble une tasse, une serviette ou un tiroir grâce au préentraînement à l'échelle du web, avant même d'avoir vu une démonstration robotique.
Le peaufiner sur une centaine d'exemples de pliage de serviettes lui apprend comment bouger pour un objet qu'il reconnaît déjà.
C'est ce transfert qui est la vraie avancée, pas la précision brute, et je précise qu'un contrôleur classique bien réglé peut encore battre un VLA en précision dans un cadre fixe et contrôlé.
Plongeons dans l'architecture.
Pour cet article, je m'appuie sur l'architecture d'OpenVLA, car elle est facile à appréhender.
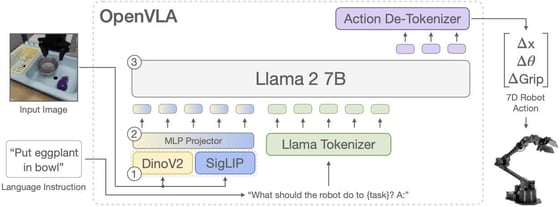
Voici la chaîne décrite ci-dessous : DINOv2 et SigLIP alimentent un backbone Llama 2, et le décodeur d'actions prédit des tokens discrétisés. Source : page du projet OpenVLA.
Un VLA comporte trois modules distincts :
- Un encodeur de vision
- Un backbone de langage
- Un décodeur d'actions
Ces trois parties sont entraînées de bout en bout, ensemble.
Les représentations visuelles et linguistiques sont fusionnées, et cette représentation combinée est convertie par le décodeur d'actions en commandes motrices.
Point important : les trois parties sont étroitement couplées et non chaînées, c'est précisément ce qui distingue un VLA d'un VLM « boulonné » à un contrôleur.
Si cela aide, pensez-le comme la séparation vision–mémoire–contrôleur décrite dans World Models : il voit, il comprend, il agit.
La différence ici : un VLA apprend ces trois fonctions ensemble, de bout en bout, à partir de démonstrations, plutôt que d'entraîner chaque pièce séparément puis de les assembler après coup.
Voyons-les maintenant individuellement.
Encodeur de vision : ce que le modèle voit
L'encodeur de vision transforme une image brute en une représentation dense exploitable par le reste du réseau.
Les VLA modernes utilisent des transformers de vision préentraînés, tels que DINOv2 ou SigLIP — souvent les deux.
OpenVLA illustre bien cette combinaison.
Il fusionne DINOv2, fort en détails spatiaux et géométriques, avec SigLIP, plus performant sur les caractéristiques sémantiques alignées avec le langage.
Ces deux jeux de caractéristiques sont concaténés par patch d'image et projetés dans l'espace d'embedding du modèle de langage (ici, Llama 2 7B).
Notez qu'utiliser plus d'une caméra est standard en production.
Par exemple, une caméra au poignet apporte un gros plan lors de l'approche finale, une vue zénithale donne la disposition de la scène, et une vue latérale aide pour la profondeur qu'une seule caméra ne peut estimer correctement.
pi0 (voir plus bas) prend plusieurs vues caméras plus l'état proprioceptif du robot.
Cet état compte plus qu'on ne le croit : une image du bras ne révèle pas le couple actuellement présent dans les articulations.
Encodeur de langage : ce qu'on dit au modèle
Le côté langage encode une instruction, par exemple « prends le bloc rouge et place-le dans le bac bleu », en une représentation alignée avec les caractéristiques visuelles dans le même espace.
Presque tous les VLA réutilisent un grand modèle de langage (LLM) préentraîné plutôt que d'entraîner un encodeur de texte à partir de zéro.
Dans notre cas, OpenVLA utilise Llama 2 7B. pi0 et pi0.5 s'appuient sur PaliGemma, un VLM de 3 milliards de paramètres. SmolVLA utilise une pile SmolVLM2 modifiée.
Réutiliser un LLM, c'est hériter de compétences.
On obtient le suivi d'instructions et la compréhension compositionnelle, ce qui permet à un VLA de gérer souvent « mets les fruits dans le bol » sans avoir vu exactement cette phrase pendant l'entraînement robotique.
Décodeur d'actions : ce que le modèle fait
Le décodeur d'actions convertit la représentation fusionnée en commande motrice. C'est aussi l'endroit où les conceptions de VLA divergent le plus. Trois approches dominent aujourd'hui.
Prédiction autoregressive de tokens
On découpe chaque dimension d'action en bacs discrets et on les prédit l'une après l'autre, comme la prédiction du token suivant que connaît déjà un LLM.
OpenVLA utilise 256 bacs par dimension et une perte standard « next-token », ce qui permet de conserver l'outillage LLM habituel.
On sacrifie toutefois la résolution et la vitesse : la discrétisation induit des mouvements en escalier, et l'échantillonnage token par token est trop lent pour des tâches rapides ou riches en contacts.
Décodage par diffusion et flow matching
Au lieu de prédire un token à la fois, le modèle traite la génération d'actions comme un processus de débruitage et produit d'un coup un segment d'actions continues.
pi0 a été le premier VLA construit autour d'une tête d'action « flow matching », avec ~10 étapes de débruitage pour générer jusqu'à 50 actions futures.
Le mouvement obtenu est sensiblement plus fluide que tout ce qui est basé sur des tokens.
Architectures hybrides à deux niveaux
Un grand modèle gère le raisonnement de haut niveau et découpe la tâche en étapes, tandis qu'un contrôleur plus petit et rapide gère l'exécution précise et à haute fréquence.
Un excellent exemple est Gemini Robotics 1.5, où un modèle de raisonnement est associé à un modèle d'action.
À mon avis, après avoir lu nombre de ces articles, on débat bien plus de la taille du backbone que de la tête d'action — et c'est prendre le problème à l'envers.
Si votre décodeur écrase une action continue en 7 dimensions dans 256 bacs discrets, aucune qualité de backbone ne vous rendra la fluidité perdue !
Les modèles VLA clés en 2026
Voici un tableau des modèles VLA importants que vous êtes susceptible de rencontrer :
|
Modèle
|
Développeur
|
Paramètres
|
Tête d'action
|
Licence
|
Matériel
|
Idéal pour
|
|---|
|
OpenVLA
|
Stanford, Berkeley et partenaires
|
7B
|
Tokens autoregressifs
|
MIT
|
A100 ou H100, ou 24 Go avec quantification 4 bits
|
Référence de recherche ouverte
|
|
Octo
|
UC Berkeley
|
27M ou 93M
|
Politique de diffusion
|
MIT
|
Une seule RTX 4090
|
Projets contraints en calcul
|
|
pi0 / pi0.5 / pi0.6
|
Physical Intelligence
|
3,3B (backbone 3B + expert d'action 300M)
|
Flow matching
|
Checkpoints ouverts (openpi)
|
Multi-GPU ou une A100
|
Tâches dextres et longues
|
|
Gemini Robotics 1.5
|
Google DeepMind
|
Non divulgué
|
Hybride, cloud + edge
|
Fermée
|
Dépendant du cloud
|
Référence propriétaire de pointe
|
|
SmolVLA
|
Hugging Face
|
450M
|
Flow matching
|
Apache 2.0
|
RTX 3060, GPU d'ordinateur portable ou Jetson
|
Robotique edge et hobby
|
Passons maintenant en revue chacun d'eux, en commençant par la référence de recherche à laquelle la plupart se comparent encore.
OpenVLA
OpenVLA est un modèle de 7 milliards de paramètres entraîné sur 970 000 démonstrations robotiques réelles issues d'Open X-Embodiment.
Il combine un backbone Llama 2 7B avec les encodeurs de vision fusionnés DINOv2 et SigLIP décrits plus haut, et l'ensemble est open source.
Résultat marquant : il dépasse le modèle fermé RT-2-X de 16,5 points de pourcentage de réussite sur 29 tâches, alors même que RT-2-X fait tourner 55 milliards de paramètres contre 7 milliards pour OpenVLA !
L'entraînement a mobilisé 64 GPU A100 pendant 15 jours.
S'il reste populaire, c'est parce que le fine-tuning LoRA et la quantification en 4 bits fonctionnent très bien dessus.
Concrètement, une RTX 4090 24 Go peut exécuter une version quantifiée, et la plupart des travaux publiés sur les attaques, défenses et élagages de VLA utilisent OpenVLA comme cible parce qu'il est très accessible.
Une suite — OpenVLA-OFT — a amélioré la recette de fine-tuning, à la fois en vitesse et en taux de réussite.
Octo
Octo est un VLA compact, proposé en deux tailles — 27 millions et 93 millions de paramètres sur backbones ViT-S et ViT-B — et peut tourner à 20–30 Hz sur une seule RTX 4090.
Entraîné sur ~800 000 trajectoires d'Open X-Embodiment couvrant 22 corps robotiques, son architecture transformer est réellement modulaire.
Vous pouvez ajouter une nouvelle entrée capteur ou remplacer la tête d'action lors du fine-tuning sans reconstruire le modèle, et il supporte aussi bien des tokens discrets que des actions continues basées sur la diffusion, selon le besoin.
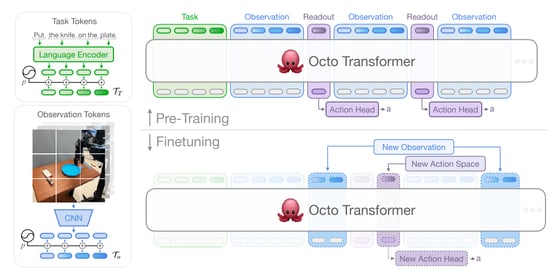
Le transformer d'Octo : tokens de tâche et d'observation en entrée, tokens de lecture en sortie vers la tête d'action, avec la possibilité d'ajouter de nouveaux capteurs ou espaces d'action au fine-tuning. Source : article Octo.
Je choisis personnellement Octo lorsque la contrainte est le calcul, plus que la difficulté de la tâche.
Il prend aussi en charge le conditionnement par image-cible, pratique quand décrire l'état final en mots est plus pénible que montrer une photo.
pi0 et la famille Physical Intelligence
pi0 de Physical Intelligence excelle en dextérité. Il part de PaliGemma, un VLM ouvert de 3 milliards de paramètres, et ajoute un expert d'action de 300 millions de paramètres entraîné from scratch, pour un total de 3,3 milliards.
Il utilise le flow matching pour produire jusqu'à 50 actions futures d'un coup, au lieu d'une à la fois.
Le résultat clé : des tâches bimanuales comme plier du linge, préparer des colis ou assembler des boîtes, avec un niveau de dextérité inédit.
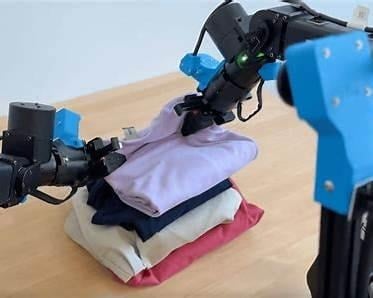
pi0 pliant du linge avec deux bras. C'est l'une des tâches bimanuales mentionnées ; à voir en vidéo. Source : Physical Intelligence, « pi0: Our First Generalist Policy ».
Le flow matching fait ici l'essentiel du travail, car coordonner deux bras exige une sortie continue lisse en 16 dimensions ; ni des tokens discrets ni un échantillonnage par diffusion lent ne permettent d'atteindre une vitesse exploitable.
La famille pi0 a continué d'évoluer :
- pi0.5 (avril 2025) : a ajouté la généralisation « open-world » via un processus en deux étapes : prédire d'abord un sous-objectif en langage, puis l'action de bas niveau
- pi0.6 (novembre 2025) : apprend à partir de l'expérience propre du robot et pas seulement de démonstrations
- openpi : des checkpoints et une chaîne d'entraînement approchée sont publiés dans le référentiel openpi, préentraînés sur plus de 10 000 heures de données robotiques
Un bémol : les meilleurs résultats de pi0 reposent sur des données propriétaires collectées sur leur propre flotte de robots.
Personne en dehors de l'entreprise n'a reproduit exactement ces chiffres uniquement avec des données publiques ; il reste donc difficile d'isoler la part de l'architecture de celle de l'avantage data.
Gemini Robotics 1.5
Gemini Robotics 1.5 de Google DeepMind s'appréhende mieux comme deux modèles coopérant qu'un seul.
Gemini Robotics-ER 1.5 est un modèle de raisonnement incarné qui planifie, appelle des outils comme Google Search et estime sa progression sur une tâche.
Gemini Robotics 1.5 est le VLA qui exécute ce que le modèle de raisonnement décide.

Gemini Robotics-ER 1.5 au-dessus pour le raisonnement incarné, Gemini Robotics 1.5 en dessous comme VLA, appels d'outils partagés au milieu, et actions tournant sur ALOHA 2, Franka et Apollo sans alignement d'espace d'action. Source : article Gemini Robotics 1.5.
L'intérêt : il mélange actions et raisonnement interne en langage naturel ; le robot réfléchit avant d'agir et peut expliquer ses choix après coup.
Face à « trie mon linge par couleur », il déduit d'abord que le blanc va dans un bac et le reste dans un autre, puis planifie les prises individuelles.
DeepMind annonce environ 250 millisecondes de l'observation à l'action (50 Hz), en plaçant le raisonnement lourd dans le cloud et en gardant un décodeur d'actions léger en local sur le robot.
Autre point marquant : Motion Transfer : une tâche apprise sur le bi-bras ALOHA 2 transférée telle quelle vers un setup bi-bras Franka et l'humanoïde Apollo d'Apptronik, sans réentraînement.
Les poids étant fermés, considérez-le comme la référence propriétaire de pointe, non auto-hébergeable.
SmolVLA
SmolVLA de Hugging Face compte 450 millions de paramètres (licence Apache 2.0). Il associe un backbone SmolVLM2 modifié à un expert d'action en flow matching, en utilisant du saut de couches et moins de tokens visuels pour réduire le coût d'inférence sur petit matériel.
Il tourne sur un GPU grand public (y compris RTX 3060), sur le CPU d'un MacBook (lent), et peut être déployé sur un Jetson Orin en embarqué.
Un fine-tuning de 20 000 pas prend environ 4–5 heures sur une seule A100.
Malgré moins de 30 000 épisodes d'entraînement, il égale ou dépasse des modèles bien plus gros sur LIBERO, Meta-World et sur des bras réels SO-100 et SO-101.
Le meilleur : tout est préentraîné sur des jeux de données communautaires via le framework LeRobot.
Maintenant que nous avons vu quelques modèles, passons au choix du bon VLA pour votre projet.
Le choix entre ces cinq dépend surtout de la fréquence de contrôle requise et du matériel disponible, pas de la dernière tête de classement.
Voici ma grille de décision approximative :
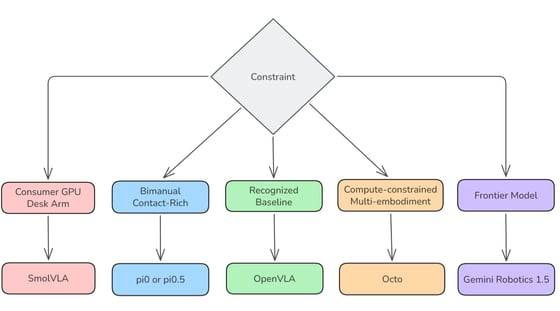
Cinq contraintes, cinq modèles. S'il ne fallait retenir qu'un seul schéma, ce serait celui-ci. Image de l'auteur.
Si vous avez un GPU grand public ou un bras SO-101 sur votre bureau, commencez par SmolVLA. Rien d'autre dans l'écosystème ouvert ne vous donne une politique opérationnelle à si faible coût.
- Si la tâche implique des contacts riches ou du bimanuel, allez directement sur pi0 ou pi0.5. La tête flow matching est idéale pour la dextérité.
- Si vous écrivez un article et avez besoin d'une référence reconnue par les reviewers, choisissez OpenVLA parce que tout le monde l'a déjà.
- Si la contrainte est le calcul mais que vous avez besoin du support multi-corps robotiques, Octo est le choix logique.
- Si vous voulez voir l'état de l'art, regardez Gemini Robotics 1.5, en gardant à l'esprit qu'il n'est pas auto-hébergeable.
Dernier point majeur : cent démonstrations propres sur SmolVLA battront presque toujours cinquante démos brouillonnes sur OpenVLA.
Consacrez 60 à 70 % du temps de projet à la collecte et à la qualité des données, et le reste à l'entraînement.
Applications des modèles VLA
Les VLA ont quitté les vidéos de démo pour quelques déploiements réels — de manière inégale toutefois.
Ils s'installent d'abord là où l'environnement varie trop pour être scripté, mais où un humain peut intervenir en cas de problème. Exemples :
Manipulation robotique
Domaine principal : pick-and-place, kitting, emballage, tri, assemblage, etc.
Le robot doit identifier, saisir et repositionner des objets dont la position et l'orientation changent entre les tentatives — exactement ce que les systèmes scriptés gèrent mal.
Les entrepôts et la préparation de commandes sont aujourd'hui le cas commercial le plus clair : un pickeur scripté exige une présentation identique à chaque fois, un VLA peut traiter un bac avec quarante références mélangées.
Robots humanoïdes
Des entreprises comme Figure, 1X et Apptronik s'appuient sur des fondations VLA pour une raison simple : un bipède avec deux mains fonctionnelles a trop de tâches possibles pour être scriptées une à une.
Le résultat Motion Transfer de Gemini Robotics, où une compétence apprise sur ALOHA 2 s'exécute directement sur l'humanoïde Apollo d'Apptronik, illustre exactement la propriété nécessaire pour passer à l'échelle.
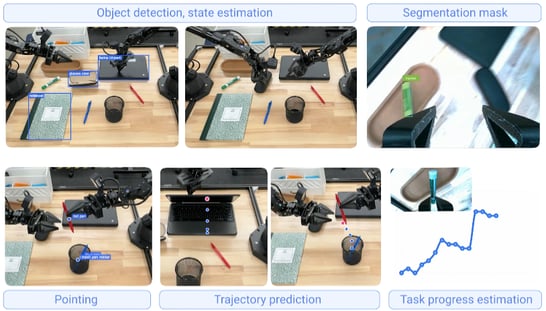
La même compétence, entraînée une fois sur ALOHA 2, exécutée sur l'humanoïde Apollo sans réentraînement. Source : Google DeepMind, « Gemini Robotics 1.5 brings AI agents into the physical world ».
Véhicules autonomes
Les piles de conduite adoptent des architectures type VLA pour relier ce que la voiture voit et ce qu'elle doit faire, dans une seule boucle de raisonnement plutôt qu'un passage perception–planification.
L'attrait est le même que pour la manipulation : des situations rares, non anticipées par des règles, gérées par un modèle ayant assez « vu » du monde pour raisonner au lieu de se figer.
Robotique chirurgicale et médicale
C'est l'application la plus amont de cette liste.
L'idée : un système capable de suivre l'instruction orale d'un chirurgien et de s'adapter aux tissus variables est supérieur à un système rigide, mais les contraintes réglementaires priment ici sur la capacité du modèle.
On peut attendre des usages d'assistance et de formation bien avant une quelconque autonomie.
Modèles vision-langage-action : défis et limites
Malgré leurs atouts, les VLA présentent encore des faiblesses, notamment sur quatre points :
Récupération en cours de tâche
Les VLA gèrent correctement la variabilité au démarrage, mais quand une prise glisse en milieu de tâche ou qu'un objet bouge sous la pince, la récupération est inconstante.
La plupart des données de démonstration ne montrent que des réussites, si bien que le modèle a vu peu d'exemples de rattrapage d'erreurs.
Inférence embarquée
La manipulation fine requiert une boucle de contrôle à 10–100 Hz, et faire tourner un modèle de 7 milliards de paramètres (ou plus) à ce rythme sur le matériel du robot reste un objectif plus qu'un acquis.
C'est pourquoi la plupart des systèmes soit se connectent à un serveur edge, soit séparent raisonnement et contrôle, comme Gemini Robotics 1.5.
Quantification, saut de couches et distillation aident, mais restent des palliatifs en cours d'itération.
Goulot d'étranglement des données
À présent que des poids ouverts performants existent pour tous, la donnée devient le vrai différenciateur.
Collecter des données de téléopération diversifiées et bien annotées est lent et coûteux — rien à voir avec le scraping web. L'écart entre les résultats publiés de pi0 et ce que l'on a reproduit avec des données publiques illustre parfaitement l'avantage d'un jeu de données privé.
Limites de généralisation
Les VLA actuels généralisent bien dans leur distribution d'entraînement et se dégradent nettement au-delà.
Un modèle entraîné sur 22 corps robotiques en manipulation de table peut encore mal performer sur une forme de tâche réellement inédite.
Mot de la fin
Les VLA unifient perception, compréhension du langage et génération d'actions dans une seule architecture : c'est un changement structurel, pas incrémental.
Ce qu'ils réussissent que le contrôle classique n'a jamais su faire, c'est généraliser à des conditions non explicitement entraînées, parce que les backbones de vision et de langage embarquent déjà un modèle opérant du monde physique dans le robot avant toute démonstration.
Ce qui me frappe le plus en 2026, c'est le déplacement des questions difficiles.
Il y a trois ans, la difficulté portait sur l'architecture.
Aujourd'hui qu'OpenVLA, Octo, pi0 et SmolVLA sont sur GitHub pour tous, les questions difficiles sont la qualité des données, les comportements de récupération, et la capacité réelle à faire tourner tout cela à 50 Hz sur le robot lui-même plutôt que dans un data center.
Pour aller plus loin, le cours Introduction to AI Agents de DataCamp couvre le contexte agentique, et Large Language Models (LLMs) Concepts traite de l'épine dorsale des modèles.







Imaginez que vous disiez à quelqu'un : « Prends la tasse et pose-la sur l'étagère. » Pas besoin de schéma : la personne regarde la tasse, comprend la phrase, et sa main se dirige au bon endroit.
Trois choses différentes se produisent presque simultanément : voir, comprendre et bouger arrivent quasiment en même temps, et non comme trois étapes distinctes transmises entre différentes parties du cerveau.
Pendant la majeure partie de l'histoire de l'IA robotique, ce n'est pas du tout ainsi que fonctionnaient les machines.
Jusqu'ici, nous avions des modèles vision-langage capables d'observer un établi en désordre et de décrire précisément ce qui s'y trouvait, y compris des détails fins comme la marque d'un outil.
Des contrôleurs robotiques classiques savaient saisir ce tournevis de manière fiable, à condition que personne ne le déplace de deux centimètres vers la gauche. Les deux moitiés du problème — voir et comprendre d'un côté, agir de l'autre — ont été développées presque entièrement séparément.
C'est là qu'interviennent les modèles vision-langage-action (VLA) : ils visent à combler cet écart.
Dans cet article, nous allons voir ce que sont les VLA et comment fonctionne leur architecture en trois parties. Nous comparerons leurs différences avec les modèles vision-langage (VLM) et avec le contrôle robotique classique, puis nous passerons en revue les modèles qui comptent réellement en 2026 et leurs usages. Enfin, nous verrons ce que les VLA n'arrivent pas encore à faire correctement.
Qu'est-ce qu'un modèle vision-langage-action (VLA) ?
Commençons par une définition formelle :
Un modèle vision-langage-action est un système d'IA qui ingère un flux caméra, une instruction en langage naturel et l'état proprioceptif du robot, puis produit des commandes motrices. Ses modules de vision, de langage et d'action sont entraînés conjointement et exécutés en un seul passage avant (forward pass), au lieu d'une chaîne classique perception–planification–contrôle.
L'essentiel, c'est que la perception, le langage et l'action ne sont pas des systèmes séparés reliés par du code « colle » écrit à la main.
Ce sont des sous-modules entraînés ensemble. Ainsi, une erreur de vision ou de langage qui aurait fait dérailler une chaîne classique est corrigée par la descente de gradient, au lieu d'être interceptée — ou manquée — par une interface codée en dur.
Trois boîtes et deux passages fragiles en haut, un modèle fusionné en bas. C'est la différence structurelle dont je parle. Image de l'auteur.
J'aime résumer la distinction ainsi : un VLM est un cerveau sans corps, un VLA lui en donne un.
La perception n'est pas un service séparé auquel le robot fait appel : elle est câblée dans la chaîne conjointement entraînée qui décide de combien déplacer la pince.
J'ai mentionné les VLM ; comparons donc ces deux architectures.
VLA vs vision-language model (VLM)
Un VLM (vision-language model) prend des images et du texte en entrée et produit du texte ou des embeddings.
Un VLA (vision-langage-action), lui, prend le même type d'entrée et produit à la place une action.
Cela paraît mineur jusqu'à ce que l'on voie l'impact en aval :
Vision-language model (VLM)
Vision-language-action model (VLA)
Entrée
Images, vidéo, texte
Images (souvent plusieurs caméras), texte, état proprioceptif du robot
Sortie
Texte, embeddings
Commandes motrices continues ou discrétisées
Capacité principale
Décrire et raisonner sur une scène
Agir sur une scène
Peut-il agir dans le monde réel ?
Non
Oui
Données d'entraînement
Paires image–texte collectées sur le web
Données web plus trajectoires de démonstration robotique
Application type
VQA, légendage, analyse de documents
Manipulation, navigation, contrôle humanoïde
Vous avez sans doute déjà entendu parler de GPT-4V, Gemini ou LLaVA.
On suppose souvent qu'un VLA, c'est un de ces modèles avec un bras robotique branché dessus.
Ce n'est pas si simple.
Le modèle doit apprendre un nouvel espace de sortie, où un « token » correspond à une grandeur physique réelle (déplacement de l'effecteur, ouverture de pince, etc.), et où une erreur fait tomber une tasse de la table plutôt que de produire une phrase un peu étrange.
Si vous voulez comparer GPT-4V, Gemini et LLaVA au reste du paysage, Top 10 Vision Language Models in 2026 de DataCamp présente les leaders actuels.
Il y a aussi une conséquence côté données.
Un VLM peut s'entraîner sur des milliards de paires image–texte, car Internet les fournit gratuitement.
Les trajectoires robotiques, elles, doivent être collectées par un vrai robot exécutant une vraie tâche, souvent en téléopération : c'est précisément pourquoi le plus grand jeu de données ouvert en robotique, Open X-Embodiment, plafonne à environ 1 million de trajectoires et non 1 milliard.
La collecte manuelle de telles trajectoires est aussi très coûteuse et lente.
22 corps robotiques, un jeu de données, et toujours moins d'1 million de trajectoires au total. C'est ce que j'entends par « les données robotiques ne passent pas à l'échelle comme le texte web ». Source : page du projet Open X-Embodiment.
VLA vs contrôle robotique classique
Avant de détailler l'architecture VLA, comparons-la au contrôle robotique classique.
Le contrôle classique est conçu pour une tâche, dans un lieu, avec des conditions verrouillées à l'avance.
Prenez le bras d'un distributeur automatique, par exemple.
Il attrape toujours le même snack au même endroit sur la même étagère, car l'éclairage, la position des objets et les mouvements requis ne varient pas d'un prélèvement à l'autre.
Cet environnement étroit et immuable permet au système de contrôle d'être rigide et fiable.
Mais changez l'agencement interne, l'éclairage, ou ajoutez un objet non prévu dans la scène…
Le contrôleur s'effondre, car il n'a jamais vu cet environnement.
Un VLA généralise mieux à des conditions non vues explicitement à l'entraînement, car son épine dorsale VLM « sait » déjà à quoi ressemble une tasse, une serviette ou un tiroir grâce au préentraînement à l'échelle du web, avant même d'avoir vu une démonstration robotique.
Le peaufiner sur une centaine d'exemples de pliage de serviettes lui apprend comment bouger pour un objet qu'il reconnaît déjà.
C'est ce transfert qui est la vraie avancée, pas la précision brute, et je précise qu'un contrôleur classique bien réglé peut encore battre un VLA en précision dans un cadre fixe et contrôlé.
Comment fonctionnent les modèles VLA ?
Plongeons dans l'architecture.
Pour cet article, je m'appuie sur l'architecture d'OpenVLA, car elle est facile à appréhender.
Voici la chaîne décrite ci-dessous : DINOv2 et SigLIP alimentent un backbone Llama 2, et le décodeur d'actions prédit des tokens discrétisés. Source : page du projet OpenVLA.
Un VLA comporte trois modules distincts :
Ces trois parties sont entraînées de bout en bout, ensemble.
Les représentations visuelles et linguistiques sont fusionnées, et cette représentation combinée est convertie par le décodeur d'actions en commandes motrices.
Point important : les trois parties sont étroitement couplées et non chaînées, c'est précisément ce qui distingue un VLA d'un VLM « boulonné » à un contrôleur.
Si cela aide, pensez-le comme la séparation vision–mémoire–contrôleur décrite dans World Models : il voit, il comprend, il agit.
La différence ici : un VLA apprend ces trois fonctions ensemble, de bout en bout, à partir de démonstrations, plutôt que d'entraîner chaque pièce séparément puis de les assembler après coup.
Voyons-les maintenant individuellement.
Encodeur de vision : ce que le modèle voit
L'encodeur de vision transforme une image brute en une représentation dense exploitable par le reste du réseau.
Les VLA modernes utilisent des transformers de vision préentraînés, tels que DINOv2 ou SigLIP — souvent les deux.
OpenVLA illustre bien cette combinaison.
Il fusionne DINOv2, fort en détails spatiaux et géométriques, avec SigLIP, plus performant sur les caractéristiques sémantiques alignées avec le langage.
Ces deux jeux de caractéristiques sont concaténés par patch d'image et projetés dans l'espace d'embedding du modèle de langage (ici, Llama 2 7B).
Notez qu'utiliser plus d'une caméra est standard en production.
Par exemple, une caméra au poignet apporte un gros plan lors de l'approche finale, une vue zénithale donne la disposition de la scène, et une vue latérale aide pour la profondeur qu'une seule caméra ne peut estimer correctement.
pi0 (voir plus bas) prend plusieurs vues caméras plus l'état proprioceptif du robot.
Cet état compte plus qu'on ne le croit : une image du bras ne révèle pas le couple actuellement présent dans les articulations.
Encodeur de langage : ce qu'on dit au modèle
Le côté langage encode une instruction, par exemple « prends le bloc rouge et place-le dans le bac bleu », en une représentation alignée avec les caractéristiques visuelles dans le même espace.
Presque tous les VLA réutilisent un grand modèle de langage (LLM) préentraîné plutôt que d'entraîner un encodeur de texte à partir de zéro.
Dans notre cas, OpenVLA utilise Llama 2 7B. pi0 et pi0.5 s'appuient sur PaliGemma, un VLM de 3 milliards de paramètres. SmolVLA utilise une pile SmolVLM2 modifiée.
Réutiliser un LLM, c'est hériter de compétences.
On obtient le suivi d'instructions et la compréhension compositionnelle, ce qui permet à un VLA de gérer souvent « mets les fruits dans le bol » sans avoir vu exactement cette phrase pendant l'entraînement robotique.
Décodeur d'actions : ce que le modèle fait
Le décodeur d'actions convertit la représentation fusionnée en commande motrice. C'est aussi l'endroit où les conceptions de VLA divergent le plus. Trois approches dominent aujourd'hui.
Prédiction autoregressive de tokens
On découpe chaque dimension d'action en bacs discrets et on les prédit l'une après l'autre, comme la prédiction du token suivant que connaît déjà un LLM.
OpenVLA utilise 256 bacs par dimension et une perte standard « next-token », ce qui permet de conserver l'outillage LLM habituel.
On sacrifie toutefois la résolution et la vitesse : la discrétisation induit des mouvements en escalier, et l'échantillonnage token par token est trop lent pour des tâches rapides ou riches en contacts.
Décodage par diffusion et flow matching
Au lieu de prédire un token à la fois, le modèle traite la génération d'actions comme un processus de débruitage et produit d'un coup un segment d'actions continues.
pi0 a été le premier VLA construit autour d'une tête d'action « flow matching », avec ~10 étapes de débruitage pour générer jusqu'à 50 actions futures.
Le mouvement obtenu est sensiblement plus fluide que tout ce qui est basé sur des tokens.
Architectures hybrides à deux niveaux
Un grand modèle gère le raisonnement de haut niveau et découpe la tâche en étapes, tandis qu'un contrôleur plus petit et rapide gère l'exécution précise et à haute fréquence.
Un excellent exemple est Gemini Robotics 1.5, où un modèle de raisonnement est associé à un modèle d'action.
À mon avis, après avoir lu nombre de ces articles, on débat bien plus de la taille du backbone que de la tête d'action — et c'est prendre le problème à l'envers.
Si votre décodeur écrase une action continue en 7 dimensions dans 256 bacs discrets, aucune qualité de backbone ne vous rendra la fluidité perdue !
Les modèles VLA clés en 2026
Voici un tableau des modèles VLA importants que vous êtes susceptible de rencontrer :
Modèle
Développeur
Paramètres
Tête d'action
Licence
Matériel
Idéal pour
OpenVLA
Stanford, Berkeley et partenaires
7B
Tokens autoregressifs
MIT
A100 ou H100, ou 24 Go avec quantification 4 bits
Référence de recherche ouverte
Octo
UC Berkeley
27M ou 93M
Politique de diffusion
MIT
Une seule RTX 4090
Projets contraints en calcul
pi0 / pi0.5 / pi0.6
Physical Intelligence
3,3B (backbone 3B + expert d'action 300M)
Flow matching
Checkpoints ouverts (openpi)
Multi-GPU ou une A100
Tâches dextres et longues
Gemini Robotics 1.5
Google DeepMind
Non divulgué
Hybride, cloud + edge
Fermée
Dépendant du cloud
Référence propriétaire de pointe
SmolVLA
Hugging Face
450M
Flow matching
Apache 2.0
RTX 3060, GPU d'ordinateur portable ou Jetson
Robotique edge et hobby
Passons maintenant en revue chacun d'eux, en commençant par la référence de recherche à laquelle la plupart se comparent encore.
OpenVLA
OpenVLA est un modèle de 7 milliards de paramètres entraîné sur 970 000 démonstrations robotiques réelles issues d'Open X-Embodiment.
Il combine un backbone Llama 2 7B avec les encodeurs de vision fusionnés DINOv2 et SigLIP décrits plus haut, et l'ensemble est open source.
Résultat marquant : il dépasse le modèle fermé RT-2-X de 16,5 points de pourcentage de réussite sur 29 tâches, alors même que RT-2-X fait tourner 55 milliards de paramètres contre 7 milliards pour OpenVLA !
L'entraînement a mobilisé 64 GPU A100 pendant 15 jours.
S'il reste populaire, c'est parce que le fine-tuning LoRA et la quantification en 4 bits fonctionnent très bien dessus.
Concrètement, une RTX 4090 24 Go peut exécuter une version quantifiée, et la plupart des travaux publiés sur les attaques, défenses et élagages de VLA utilisent OpenVLA comme cible parce qu'il est très accessible.
Une suite — OpenVLA-OFT — a amélioré la recette de fine-tuning, à la fois en vitesse et en taux de réussite.
Octo
Octo est un VLA compact, proposé en deux tailles — 27 millions et 93 millions de paramètres sur backbones ViT-S et ViT-B — et peut tourner à 20–30 Hz sur une seule RTX 4090.
Entraîné sur ~800 000 trajectoires d'Open X-Embodiment couvrant 22 corps robotiques, son architecture transformer est réellement modulaire.
Vous pouvez ajouter une nouvelle entrée capteur ou remplacer la tête d'action lors du fine-tuning sans reconstruire le modèle, et il supporte aussi bien des tokens discrets que des actions continues basées sur la diffusion, selon le besoin.
Le transformer d'Octo : tokens de tâche et d'observation en entrée, tokens de lecture en sortie vers la tête d'action, avec la possibilité d'ajouter de nouveaux capteurs ou espaces d'action au fine-tuning. Source : article Octo.
Je choisis personnellement Octo lorsque la contrainte est le calcul, plus que la difficulté de la tâche.
Il prend aussi en charge le conditionnement par image-cible, pratique quand décrire l'état final en mots est plus pénible que montrer une photo.
pi0 et la famille Physical Intelligence
pi0 de Physical Intelligence excelle en dextérité. Il part de PaliGemma, un VLM ouvert de 3 milliards de paramètres, et ajoute un expert d'action de 300 millions de paramètres entraîné from scratch, pour un total de 3,3 milliards.
Il utilise le flow matching pour produire jusqu'à 50 actions futures d'un coup, au lieu d'une à la fois.
Le résultat clé : des tâches bimanuales comme plier du linge, préparer des colis ou assembler des boîtes, avec un niveau de dextérité inédit.
pi0 pliant du linge avec deux bras. C'est l'une des tâches bimanuales mentionnées ; à voir en vidéo. Source : Physical Intelligence, « pi0: Our First Generalist Policy ».
Le flow matching fait ici l'essentiel du travail, car coordonner deux bras exige une sortie continue lisse en 16 dimensions ; ni des tokens discrets ni un échantillonnage par diffusion lent ne permettent d'atteindre une vitesse exploitable.
La famille pi0 a continué d'évoluer :
Un bémol : les meilleurs résultats de pi0 reposent sur des données propriétaires collectées sur leur propre flotte de robots.
Personne en dehors de l'entreprise n'a reproduit exactement ces chiffres uniquement avec des données publiques ; il reste donc difficile d'isoler la part de l'architecture de celle de l'avantage data.
Gemini Robotics 1.5
Gemini Robotics 1.5 de Google DeepMind s'appréhende mieux comme deux modèles coopérant qu'un seul.
Gemini Robotics-ER 1.5 est un modèle de raisonnement incarné qui planifie, appelle des outils comme Google Search et estime sa progression sur une tâche.
Gemini Robotics 1.5 est le VLA qui exécute ce que le modèle de raisonnement décide.
Gemini Robotics-ER 1.5 au-dessus pour le raisonnement incarné, Gemini Robotics 1.5 en dessous comme VLA, appels d'outils partagés au milieu, et actions tournant sur ALOHA 2, Franka et Apollo sans alignement d'espace d'action. Source : article Gemini Robotics 1.5.
L'intérêt : il mélange actions et raisonnement interne en langage naturel ; le robot réfléchit avant d'agir et peut expliquer ses choix après coup.
Face à « trie mon linge par couleur », il déduit d'abord que le blanc va dans un bac et le reste dans un autre, puis planifie les prises individuelles.
DeepMind annonce environ 250 millisecondes de l'observation à l'action (50 Hz), en plaçant le raisonnement lourd dans le cloud et en gardant un décodeur d'actions léger en local sur le robot.
Autre point marquant : Motion Transfer : une tâche apprise sur le bi-bras ALOHA 2 transférée telle quelle vers un setup bi-bras Franka et l'humanoïde Apollo d'Apptronik, sans réentraînement.
Les poids étant fermés, considérez-le comme la référence propriétaire de pointe, non auto-hébergeable.
SmolVLA
SmolVLA de Hugging Face compte 450 millions de paramètres (licence Apache 2.0). Il associe un backbone SmolVLM2 modifié à un expert d'action en flow matching, en utilisant du saut de couches et moins de tokens visuels pour réduire le coût d'inférence sur petit matériel.
Il tourne sur un GPU grand public (y compris RTX 3060), sur le CPU d'un MacBook (lent), et peut être déployé sur un Jetson Orin en embarqué.
Un fine-tuning de 20 000 pas prend environ 4–5 heures sur une seule A100.
Malgré moins de 30 000 épisodes d'entraînement, il égale ou dépasse des modèles bien plus gros sur LIBERO, Meta-World et sur des bras réels SO-100 et SO-101.
Le meilleur : tout est préentraîné sur des jeux de données communautaires via le framework LeRobot.
Comment choisir un VLA pour votre projet
Maintenant que nous avons vu quelques modèles, passons au choix du bon VLA pour votre projet.
Le choix entre ces cinq dépend surtout de la fréquence de contrôle requise et du matériel disponible, pas de la dernière tête de classement.
Voici ma grille de décision approximative :
Cinq contraintes, cinq modèles. S'il ne fallait retenir qu'un seul schéma, ce serait celui-ci. Image de l'auteur.
Si vous avez un GPU grand public ou un bras SO-101 sur votre bureau, commencez par SmolVLA. Rien d'autre dans l'écosystème ouvert ne vous donne une politique opérationnelle à si faible coût.
Dernier point majeur : cent démonstrations propres sur SmolVLA battront presque toujours cinquante démos brouillonnes sur OpenVLA.
Consacrez 60 à 70 % du temps de projet à la collecte et à la qualité des données, et le reste à l'entraînement.
Applications des modèles VLA
Les VLA ont quitté les vidéos de démo pour quelques déploiements réels — de manière inégale toutefois.
Ils s'installent d'abord là où l'environnement varie trop pour être scripté, mais où un humain peut intervenir en cas de problème. Exemples :
Manipulation robotique
Domaine principal : pick-and-place, kitting, emballage, tri, assemblage, etc.
Le robot doit identifier, saisir et repositionner des objets dont la position et l'orientation changent entre les tentatives — exactement ce que les systèmes scriptés gèrent mal.
Les entrepôts et la préparation de commandes sont aujourd'hui le cas commercial le plus clair : un pickeur scripté exige une présentation identique à chaque fois, un VLA peut traiter un bac avec quarante références mélangées.
Robots humanoïdes
Des entreprises comme Figure, 1X et Apptronik s'appuient sur des fondations VLA pour une raison simple : un bipède avec deux mains fonctionnelles a trop de tâches possibles pour être scriptées une à une.
Le résultat Motion Transfer de Gemini Robotics, où une compétence apprise sur ALOHA 2 s'exécute directement sur l'humanoïde Apollo d'Apptronik, illustre exactement la propriété nécessaire pour passer à l'échelle.
La même compétence, entraînée une fois sur ALOHA 2, exécutée sur l'humanoïde Apollo sans réentraînement. Source : Google DeepMind, « Gemini Robotics 1.5 brings AI agents into the physical world ».
Véhicules autonomes
Les piles de conduite adoptent des architectures type VLA pour relier ce que la voiture voit et ce qu'elle doit faire, dans une seule boucle de raisonnement plutôt qu'un passage perception–planification.
L'attrait est le même que pour la manipulation : des situations rares, non anticipées par des règles, gérées par un modèle ayant assez « vu » du monde pour raisonner au lieu de se figer.
Robotique chirurgicale et médicale
C'est l'application la plus amont de cette liste.
L'idée : un système capable de suivre l'instruction orale d'un chirurgien et de s'adapter aux tissus variables est supérieur à un système rigide, mais les contraintes réglementaires priment ici sur la capacité du modèle.
On peut attendre des usages d'assistance et de formation bien avant une quelconque autonomie.
Modèles vision-langage-action : défis et limites
Malgré leurs atouts, les VLA présentent encore des faiblesses, notamment sur quatre points :
Récupération en cours de tâche
Les VLA gèrent correctement la variabilité au démarrage, mais quand une prise glisse en milieu de tâche ou qu'un objet bouge sous la pince, la récupération est inconstante.
La plupart des données de démonstration ne montrent que des réussites, si bien que le modèle a vu peu d'exemples de rattrapage d'erreurs.
Inférence embarquée
La manipulation fine requiert une boucle de contrôle à 10–100 Hz, et faire tourner un modèle de 7 milliards de paramètres (ou plus) à ce rythme sur le matériel du robot reste un objectif plus qu'un acquis.
C'est pourquoi la plupart des systèmes soit se connectent à un serveur edge, soit séparent raisonnement et contrôle, comme Gemini Robotics 1.5.
Quantification, saut de couches et distillation aident, mais restent des palliatifs en cours d'itération.
Goulot d'étranglement des données
À présent que des poids ouverts performants existent pour tous, la donnée devient le vrai différenciateur.
Collecter des données de téléopération diversifiées et bien annotées est lent et coûteux — rien à voir avec le scraping web. L'écart entre les résultats publiés de pi0 et ce que l'on a reproduit avec des données publiques illustre parfaitement l'avantage d'un jeu de données privé.
Limites de généralisation
Les VLA actuels généralisent bien dans leur distribution d'entraînement et se dégradent nettement au-delà.
Un modèle entraîné sur 22 corps robotiques en manipulation de table peut encore mal performer sur une forme de tâche réellement inédite.
Mot de la fin
Les VLA unifient perception, compréhension du langage et génération d'actions dans une seule architecture : c'est un changement structurel, pas incrémental.
Ce qu'ils réussissent que le contrôle classique n'a jamais su faire, c'est généraliser à des conditions non explicitement entraînées, parce que les backbones de vision et de langage embarquent déjà un modèle opérant du monde physique dans le robot avant toute démonstration.
Ce qui me frappe le plus en 2026, c'est le déplacement des questions difficiles.
Il y a trois ans, la difficulté portait sur l'architecture.
Aujourd'hui qu'OpenVLA, Octo, pi0 et SmolVLA sont sur GitHub pour tous, les questions difficiles sont la qualité des données, les comportements de récupération, et la capacité réelle à faire tourner tout cela à 50 Hz sur le robot lui-même plutôt que dans un data center.
Pour aller plus loin, le cours Introduction to AI Agents de DataCamp couvre le contexte agentique, et Large Language Models (LLMs) Concepts traite de l'épine dorsale des modèles.