Hãy tưởng tượng bạn bảo ai đó: “Lấy cái cốc và đặt lên kệ.” Họ không cần sơ đồ; chỉ cần nhìn thấy cái cốc, hiểu câu nói, và tay họ đi đến đó.
Ba điều khác nhau đã xảy ra gần như đồng thời. Nhìn, hiểu và di chuyển gần như diễn ra cùng lúc đối với người đó, không phải ba bước tách rời chuyển qua lại giữa các phần khác nhau của não.
Trong phần lớn lịch sử AI cho robot, máy móc không hề hoạt động như vậy.
Trước đây, chúng ta có các mô hình thị giác-ngôn ngữ có thể nhìn một bàn làm việc lộn xộn và mô tả chính xác những gì có trên đó, bao gồm cả chi tiết như tên thương hiệu của một dụng cụ.
Bộ điều khiển robot cổ điển có thể nhặt chiếc tua vít đó một cách ổn định, miễn là không ai di chuyển nó lệch sang trái hai centimet. Hai nửa của vấn đề—nhìn và hiểu ở một phía, và hành động ở phía kia—phát triển gần như hoàn toàn tách biệt.
Đây là lúc các mô hình Vision-language-action (VLA) xuất hiện – chúng là nỗ lực để thu hẹp khoảng cách đó.
Trong bài viết này, chúng ta sẽ xem VLA là gì và kiến trúc ba phần của chúng hoạt động ra sao. Chúng ta sẽ khám phá cách chúng khác với mô hình thị giác-ngôn ngữ (VLM) và so với điều khiển robot cổ điển, điểm qua những mô hình thực sự quan trọng vào năm 2026 và nơi chúng được sử dụng. Cuối cùng, chúng ta sẽ xem các chế độ CLA vẫn còn sai ở đâu.
Mô hình Vision-Language-Action (VLA) là gì?
Hãy bắt đầu bằng cách định nghĩa chính thức VLA là gì:
Mô hình vision-language-action là một hệ thống AI xử lý luồng camera, chỉ dẫn ngôn ngữ tự nhiên và trạng thái của chính robot, sau đó xuất ra lệnh động cơ, với các mô-đun thị giác, ngôn ngữ và hành động được huấn luyện chung và chạy trong một lượt suy luận thay vì theo tuyến ống cổ điển nhận thức–lập kế hoạch–điều khiển.
Điểm chính là nhận thức, ngôn ngữ và hành động không phải là các hệ thống riêng lẻ được vá lại với nhau bằng mã “keo” viết tay.
Chúng là các phân mô-đun được huấn luyện chung. Vì vậy, một lỗi thị giác hoặc ngôn ngữ vốn sẽ làm trệch việc bàn giao trong tuyến ống cổ điển sẽ được sửa bằng gradient descent thay vì bị bắt (hoặc bị bỏ sót) qua một giao diện mã cứng.
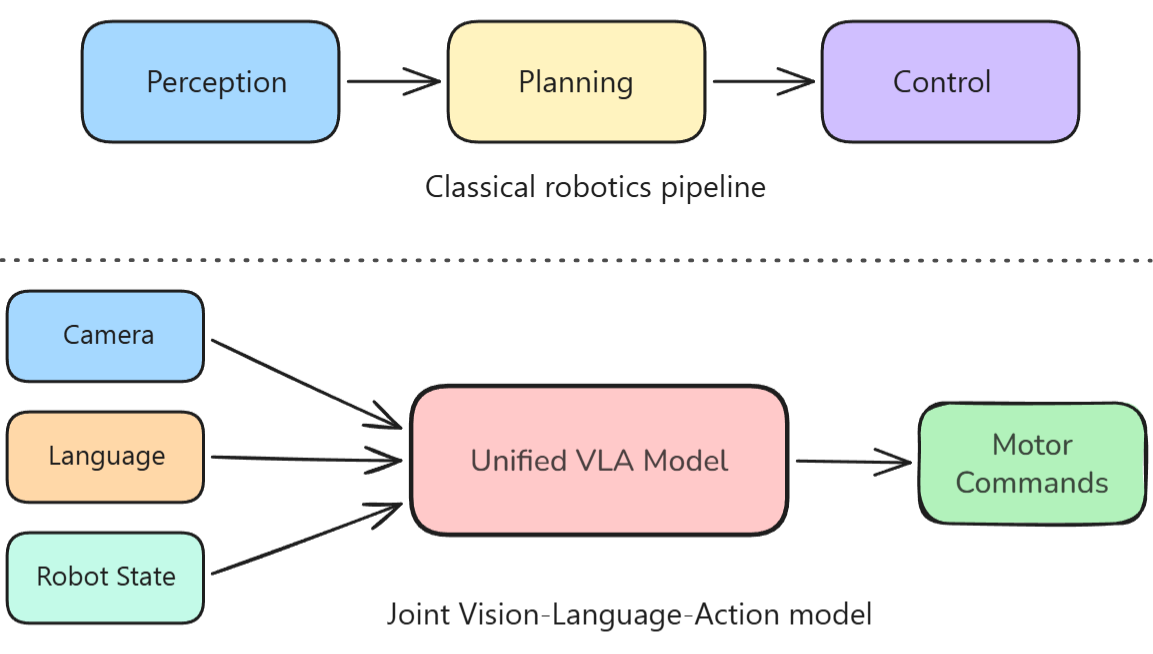
Ba khối và hai lần bàn giao mong manh ở trên, một mô hình hợp nhất ở dưới. Đây là khác biệt cấu trúc thực sự mà tôi vẫn nhắc đến. Ảnh: Tác giả.
Tôi thích diễn đạt sự khác biệt thế này: một VLM là bộ não không có cơ thể, còn VLA trao cho nó một cơ thể.
Nhận thức không phải là một dịch vụ riêng lẻ mà robot gọi ra, mà được gắn vào tuyến ống huấn luyện chung quyết định di chuyển ngàm kẹp bao xa.
Tôi đã nhắc đến VLM, vậy hãy so sánh hai kiến trúc này.
VLA so với Mô hình Thị giác-Ngôn ngữ (VLM)
Một VLM (Vision-Language Model) nhận ảnh và văn bản rồi tạo ra văn bản hoặc embedding.
Ngược lại, một VLA (Vision-Language-Action Model) nhận cùng loại đầu vào nhưng xuất ra hành động.
Nghe có vẻ là thay đổi nhỏ cho đến khi bạn thấy tác động ở hạ nguồn:
| |
Mô hình thị giác-ngôn ngữ (VLM)
|
Mô hình thị giác-ngôn ngữ-hành động (VLA)
|
|---|
|
Đầu vào
|
Ảnh, video, văn bản
|
Ảnh (thường từ nhiều camera), văn bản, trạng thái cảm nhận cơ thể của robot
|
|
Đầu ra
|
Văn bản, embedding
|
Lệnh động cơ liên tục hoặc rời rạc
|
|
Năng lực chính
|
Mô tả và suy luận về cảnh
|
Hành động trên cảnh
|
|
Có thể hành động trong thế giới thực?
|
Không
|
Có
|
|
Dữ liệu huấn luyện
|
Cặp ảnh-văn bản thu thập từ web
|
Dữ liệu web cộng quỹ đạo minh họa từ robot
|
|
Ứng dụng điển hình
|
Hỏi đáp trực quan, chú thích ảnh, phân tích tài liệu
|
Thao tác, điều hướng, điều khiển humanoid
|
Bạn có thể đã nghe về các mô hình như GPT-4V, Gemini, hoặc LLaVA trước đây.
Một giả định rất phổ biến là VLA chỉ là một trong số đó gắn thêm cánh tay robot.
Tuy nhiên, không đơn giản như vậy.
Mô hình phải học một không gian đầu ra hoàn toàn mới, nơi một token tương ứng với một đại lượng vật lý thực, như độ dịch chuyển của đầu công tác hoặc độ mở của ngàm kẹp, và nếu sai, nó làm đổ một chiếc cốc khỏi bàn chứ không chỉ tạo ra một câu hơi lạ.
Nếu bạn muốn xem GPT-4V, Gemini và LLaVA so kè với phần còn lại thế nào, Top 10 Vision Language Models năm 2026 của DataCamp tổng hợp các ứng viên dẫn đầu hiện tại.
Cũng có hệ quả về phía dữ liệu.
VLM có thể huấn luyện trên hàng tỷ cặp ảnh-văn bản vì internet cung cấp miễn phí.
Tuy nhiên, quỹ đạo robot phải được thu thập bằng một robot thật thực hiện một tác vụ thật, thường dưới điều khiển từ xa, đó là lý do vì sao bộ dữ liệu robot mở lớn nhất, Open X-Embodiment, dừng ở khoảng 1 triệu quỹ đạo thay vì 1 tỷ.
Việc thu thập thủ công những quỹ đạo như vậy cũng rất tốn kém và chậm.
22 dạng hiện thân, một bộ dữ liệu, và tổng cộng vẫn dưới 1 triệu quỹ đạo. Ý tôi muốn nói là dữ liệu robot không mở rộng như văn bản web. Nguồn: trang dự án Open X-Embodiment.
VLA so với điều khiển robot cổ điển
Trước khi nói về cách kiến trúc VLA hoạt động, tôi cũng muốn so sánh với điều khiển robot cổ điển.
Điều khiển robot cổ điển được xây dựng cho một tác vụ tại một nơi, trong các điều kiện đã được cố định trước.
Lấy ví dụ cánh tay máy trong máy bán hàng tự động.
Nó nhặt cùng một món ăn nhẹ từ cùng một kệ tại cùng một vị trí mỗi lần vì ánh sáng, vị trí vật thể và chuyển động cần thiết không thay đổi giữa các lần lấy.
Chính cấu hình hẹp và bất biến đó cho phép hệ thống điều khiển cứng nhắc nhưng đáng tin cậy.
Nhưng giờ hãy thay đổi cấu hình bên trong máy, hoặc thay đổi ánh sáng, hoặc thả vào cảnh một vật thể chưa từng có trong kế hoạch.
Khi đó bộ điều khiển sẽ hoàn toàn thất bại vì chưa bao giờ thấy môi trường như vậy.
VLA khái quát hóa tốt hơn đến các điều kiện chưa từng được huấn luyện tường minh, bởi vì backbone VLM nền tảng vốn đã biết cốc, khăn hay ngăn kéo trông như thế nào từ tiền huấn luyện quy mô web trước khi nó thấy một minh họa robot nào.
Tinh chỉnh trên vài trăm ví dụ gấp khăn cho phép nó học cách di chuyển với một vật thể mà nó đã nhận ra.
Chuyển giao đó mới là đột phá thực sự, không phải độ chính xác thuần túy, và tôi muốn nhấn mạnh rằng một bộ điều khiển cổ điển được tinh chỉnh tốt vẫn có thể vượt VLA về độ chính xác trong bối cảnh cố định, được kiểm soát.
Mô hình VLA hoạt động như thế nào?
Hãy đi sâu vào kiến trúc.
Trong bài viết này, tôi chọn kiến trúc OpenVLA vì dễ hiểu.
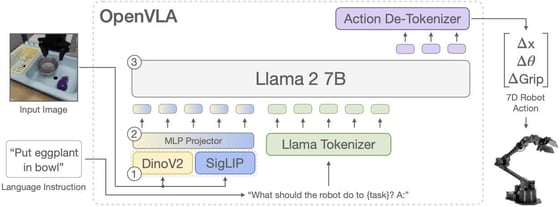
Đây là tuyến ống tôi mô tả bên dưới: DINOv2 và SigLIP cấp vào backbone Llama 2, với bộ giải mã hành động dự đoán các token rời rạc ở đầu ra. Nguồn: trang dự án OpenVLA.
Một VLA có ba mô-đun riêng:
- Bộ mã hóa thị giác
- Backbone ngôn ngữ
- Bộ giải mã hành động
Chúng được huấn luyện đầu-cuối cùng nhau.
Biểu diễn thị giác và ngôn ngữ được hợp nhất, và biểu diễn kết hợp này được bộ giải mã hành động chuyển thành lệnh động cơ.
Quan trọng là ba phần gắn kết chặt thay vì nối tuyến, đây chính là quyết định thiết kế tách VLA khỏi việc ghép VLM vào bộ điều khiển.
Nếu hữu ích, hãy nghĩ nó giống như cách tôi mô tả phân tách thị giác, trí nhớ và bộ điều khiển trong bài World Models gốc: nó nhìn, nó hiểu, nó hành động.
Điểm khác là VLA học cả ba nhiệm vụ cùng nhau, đầu-cuối, từ các minh họa, thay vì huấn luyện từng phần riêng rồi khâu lại sau đó.
Giờ hãy xem từng phần một.
Bộ mã hóa thị giác: những gì mô hình nhìn thấy
Bộ mã hóa thị giác biến khung hình camera thô thành biểu diễn đặc dày mà phần còn lại của mạng có thể dùng được.
Các VLA hiện đại dùng transformer thị giác tiền huấn luyện như DINOv2 hoặc SigLIP, và khá thường là cả hai.
OpenVLA là ví dụ tốt về việc dùng cả hai.
Nó hợp nhất DINOv2, mạnh về chi tiết không gian và hình học, với SigLIP, mạnh về đặc trưng ngữ nghĩa ăn khớp tốt với ngôn ngữ.
Hai tập đặc trưng được nối theo từng mảnh ảnh và chiếu vào không gian embedding của mô hình ngôn ngữ (trong trường hợp này là LLama 2 7B).
Tôi muốn nhắc rằng dùng hơn một camera là tiêu chuẩn trong triển khai thực tế.
Ví dụ, camera gắn cổ tay cho chi tiết cận cảnh khi tiếp cận cuối cùng tới vật thể, camera trên cao cho bố cục cảnh, còn góc nhìn bên giúp về chiều sâu mà một camera đơn không thể tự khôi phục.
pi0 (thêm chi tiết bên dưới) nhận nhiều góc nhìn camera cộng với trạng thái cảm nhận cơ thể của robot.
Lưu ý là đầu vào trạng thái quan trọng hơn bạn tưởng, vì một bức ảnh cánh tay không cho biết mô-men xoắn hiện tại trong các khớp.
Bộ mã hóa ngôn ngữ: những gì mô hình được chỉ dẫn
Phía ngôn ngữ mã hóa một chỉ dẫn, kiểu như “nhặt khối đỏ và đặt vào thùng xanh”, thành một biểu diễn ăn khớp với đặc trưng hình ảnh trong cùng không gian.
Hầu như mọi VLA đều tái sử dụng một backbone mô hình ngôn ngữ lớn (LLM) đã tiền huấn luyện thay vì huấn luyện bộ mã hóa văn bản từ đầu.
Trong trường hợp của chúng ta, OpenVLA dùng Llama 2 7B. pi0 và pi0.5 xây dựng trên PaliGemma, một VLM 3 tỷ tham số. SmolVLA dùng bộ SmolVLM2 đã chỉnh sửa.
Tái sử dụng LLM theo cách này thực chất là thừa hưởng năng lực.
Bạn nhận được khả năng theo chỉ dẫn và hiểu thành phần, đó là lý do VLA thường xử lý được “đặt trái cây vào bát” dù chưa từng thấy cụm từ y hệt đó trong huấn luyện robot.
Bộ giải mã hành động: những gì mô hình thực hiện
Bộ giải mã hành động là nơi biểu diễn hợp nhất trở thành lệnh động cơ, và cũng là nơi thiết kế VLA khác nhau nhiều nhất. Hiện có ba hướng tiếp cận chính.
Dự đoán token tự hồi quy
Bạn chia nhỏ mỗi chiều hành động thành các bin rời rạc và dự đoán lần lượt, giống thiết lập dự đoán token tiếp theo mà LLM vốn đã thành thạo.
OpenVLA dùng 256 bin mỗi chiều và loss dự đoán token tiếp theo thông thường, nên bạn giữ được công cụ LLM quen thuộc.
Đổi lại, bạn mất độ phân giải và tốc độ vì việc chia bin tạo chuyển động khúc khuỷu, và lấy mẫu từng token quá chậm cho các tác vụ nhanh hoặc giàu tiếp xúc.
Giải mã bằng diffusion và flow-matching
Thay vì dự đoán từng token, mô hình coi việc sinh hành động là quá trình khử nhiễu và tạo ra cả một đoạn hành động liên tục cùng lúc.
pi0 là VLA đầu tiên xây dựng quanh đầu hành động flow-matching, nơi họ khử nhiễu khoảng 10 bước để tạo ra một đoạn tối đa 50 hành động tương lai.
Điều này khiến chuyển động mượt mà hơn đáng kể so với mọi thứ dựa trên token.
Kiến trúc lai hai tầng
Một mô hình lớn xử lý suy luận cấp cao và chia nhỏ nhiệm vụ thành các bước, trong khi một bộ điều khiển nhỏ, nhanh đảm nhiệm thi hành chính xác, tần số cao.
Ví dụ rất điển hình là Gemini Robotics 1.5, nơi họ ghép một mô hình suy luận với một mô hình hành động.
Theo quan điểm cá nhân của tôi, sau khi đọc nhiều bài báo, mọi người dành quá nhiều năng lượng tranh luận về kích thước backbone hơn là về đầu hành động, và tôi nghĩ đó là ngược.
Nếu bộ giải mã của bạn đang ép một hành động liên tục 7 chiều vào 256 bin rời rạc, thì backbone có tốt đến mấy cũng không lấy lại được độ mượt!
Các mô hình VLA chủ chốt năm 2026
Giờ tôi xin trình bày bảng một số mô hình VLA quan trọng mà bạn có thể gặp:
|
Mô hình
|
Đơn vị phát triển
|
Tham số
|
Đầu hành động
|
Giấy phép
|
Phần cứng
|
Phù hợp nhất cho
|
|---|
|
OpenVLA
|
Stanford, Berkeley và cộng tác viên
|
7B
|
Token tự hồi quy
|
MIT
|
A100 hoặc H100, hoặc 24GB với lượng tử hóa 4-bit
|
Chuẩn nghiên cứu mở
|
|
Octo
|
UC Berkeley
|
27M hoặc 93M
|
Chính sách diffusion
|
MIT
|
Một RTX 4090
|
Công việc hạn chế tài nguyên tính toán
|
|
pi0 / pi0.5 / pi0.6
|
Physical Intelligence
|
3,3B (backbone 3B cộng chuyên gia hành động 300M)
|
Flow matching
|
Checkpoint mở (openpi)
|
Multi-GPU hoặc một A100
|
Nhiệm vụ khéo léo, tầm nhìn dài
|
|
Gemini Robotics 1.5
|
Google DeepMind
|
Không tiết lộ
|
Lai, đám mây cộng biên
|
Đóng
|
Kết nối đám mây
|
Chuẩn độc quyền tuyến đầu
|
|
SmolVLA
|
Hugging Face
|
450M
|
Flow matching
|
Apache 2.0
|
RTX 3060, GPU laptop, hoặc Jetson
|
Robot hobby và biên
|
Giờ hãy đi qua từng mô hình, bắt đầu với chuẩn nghiên cứu mà hầu hết mọi người vẫn lấy để so sánh.
OpenVLA
OpenVLA là một mô hình 7 tỷ tham số được huấn luyện trên 970.000 minh họa robot ngoài đời thực lấy từ Open X-Embodiment.
Nó kết hợp Llama 2 7B làm backbone với bộ mã hóa thị giác hợp nhất DINOv2 và SigLIP như tôi đã mô tả, và toàn bộ mô hình là mã nguồn mở.
Kết quả gây bất ngờ là nó vượt mô hình đóng RT-2-X 16,5 điểm phần trăm tỉ lệ thành công tác vụ trên 29 tác vụ, trong khi RT-2-X chạy 55 tỷ tham số so với 7 tỷ của OpenVLA!
Tổng huấn luyện mất 64 GPU A100 trong 15 ngày.
Lý do nó vẫn phổ biến là tinh chỉnh LoRA và lượng tử hóa 4-bit đều hoạt động tốt trên nó.
Điều này có nghĩa một RTX 4090 24GB có thể chạy phiên bản đã lượng tử hóa và phần lớn các công trình đã công bố về tấn công, phòng thủ và cắt tỉa VLA đều dùng OpenVLA làm mục tiêu vì nó quá dễ tiếp cận.
Bản tiếp theo - OpenVLA-OFT cải thiện công thức tinh chỉnh cả về tốc độ lẫn tỉ lệ thành công.
Octo
Octo là một VLA nhỏ, có hai kích cỡ - 27 triệu và 93 triệu tham số trên backbone ViT-S và ViT-B, và có thể chạy trên một RTX 4090 ở 20 đến 30 Hz.
Nó được huấn luyện trên khoảng 800.000 quỹ đạo từ Open X-Embodiment qua 22 dạng hiện thân của robot, và kiến trúc transformer của nó thực sự dạng mô-đun.
Bạn có thể thêm đầu vào quan sát mới hoặc thay đầu hành động trong khi tinh chỉnh mà không phải xây lại mô hình từ đầu, và nó hỗ trợ cả token rời rạc lẫn hành động liên tục dựa trên diffusion tùy nhu cầu.
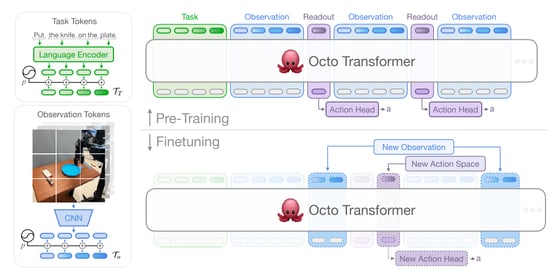
Transformer của Octo: token nhiệm vụ và quan sát vào, token đọc ra đưa đến đầu hành động, với chỗ để thêm cảm biến hoặc không gian hành động khi tinh chỉnh. Nguồn: bài báo Octo.
Tôi thường dùng Octo khi giới hạn là tính toán chứ không phải độ khó của tác vụ.
Nó cũng hỗ trợ điều kiện hóa bằng ảnh mục tiêu, rất tiện khi mô tả trạng thái đích bằng lời vụng về hơn là đưa ảnh chụp điều bạn muốn.
pi0 và gia đình Physical Intelligence
pi0 từ Physical Intelligence rất giỏi về khéo léo. Nó bắt đầu từ PaliGemma, một VLM mở 3 tỷ tham số, và thêm một chuyên gia hành động 300 triệu tham số huấn luyện từ đầu, tổng cộng 3,3 tỷ tham số.
Nó dùng flow matching để tạo một đoạn tối đa 50 hành động tương lai cùng lúc thay vì từng bước một.
Kết quả chủ chốt là các tác vụ hai tay như gấp đồ giặt, đóng gói hàng tạp hóa và lắp ráp hộp, tất cả được xử lý với mức độ khéo léo chưa từng có trước đó.
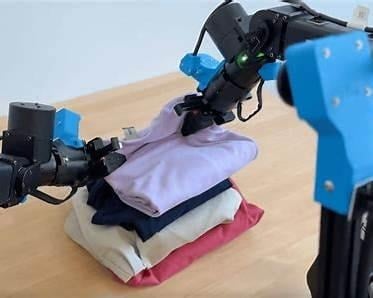
Robot pi0 gấp đồ giặt bằng hai tay. Đây là một trong các tác vụ hai tay tôi đã nhắc, gấp đồ giặt, và đáng để xem video hơn là chỉ đọc. Nguồn: Physical Intelligence, “pi0: Chính sách tổng quát đầu tiên của chúng tôi”.
Flow matching là thành phần làm việc thực sự ở đây, bởi vì phối hợp hai tay cùng lúc cần đầu ra liên tục 16 chiều mượt mà, và cả token rời rạc lẫn diffusion chậm đều không cho tốc độ sử dụng được.
Gia đình pi0 tiếp tục phát triển:
- pi0.5 (Tháng 4/2025): thêm khả năng khái quát hóa thế giới mở với quy trình hai giai đoạn dự đoán tiểu tác vụ cấp cao bằng lời trước khi dự đoán hành động cấp thấp
- pi0.6 (Tháng 11/2025): học từ trải nghiệm của chính robot thay vì chỉ từ minh họa
- openpi: checkpoint và một tuyến huấn luyện xấp xỉ có trong kho openpi, tiền huấn luyện trên hơn 10.000 giờ dữ liệu robot
Một lưu ý tôi muốn nêu là các kết quả mạnh nhất của pi0 phụ thuộc vào dữ liệu độc quyền thu thập trên đội robot riêng của họ.
Không ai ngoài công ty tái lập đúng các con số đó chỉ với dữ liệu công khai, nên mức độ hiệu năng đến từ kiến trúc so với lợi thế dữ liệu vẫn chưa ngã ngũ.
Gemini Robotics 1.5
Gemini Robotics 1.5 từ Google DeepMind nên được hiểu là hai mô hình làm việc cùng nhau thay vì một.
Gemini Robotics-ER 1.5 là mô hình suy luận nhập thể có thể lập kế hoạch, gọi công cụ như Google Search, và ước lượng tiến độ của chính nó trên một tác vụ.
Gemini Robotics 1.5 là VLA thực thi những gì mô hình suy luận quyết định.
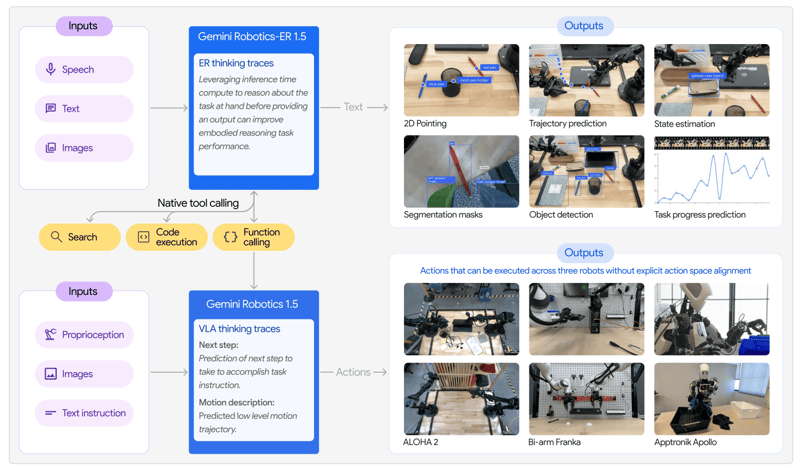
Gemini Robotics-ER 1.5 phía trên để suy luận nhập thể, Gemini Robotics 1.5 phía dưới là VLA, gọi công cụ chung ở giữa, và hành động chạy trên ALOHA 2, Franka và Apollo mà không cần căn chỉnh không gian hành động. Nguồn: bài báo Gemini Robotics 1.5.
Điểm hữu ích là nó trộn hành động với quá trình suy luận nội bộ bằng ngôn ngữ tự nhiên, nên robot suy nghĩ trước khi hành động và có thể giải thích quyết định sau đó.
Với chỉ dẫn như “phân loại đồ giặt theo màu”, nó trước tiên suy ra đồ trắng vào một thùng và phần còn lại vào thùng khác, rồi lên kế hoạch cho từng lần nhặt.
DeepMind báo cáo khoảng 250 mili giây từ quan sát đến hành động, tương đương tần số điều khiển 50Hz, đạt được bằng cách đặt phần suy luận nặng trên đám mây và giữ bộ giải mã hành động nhẹ tại chỗ robot.
Kết quả khác tôi muốn nêu là Motion Transfer, tức một tác vụ học trên nền tảng hai tay ALOHA 2 được chuyển thẳng sang thiết lập hai tay Franka và robot hình người Apollo của Apptronik mà không cần tái huấn luyện.
Trọng số bị đóng, nên tôi xem đây là chuẩn độc quyền tuyến đầu hơn là thứ bạn có thể tải về và tự tinh chỉnh.
SmolVLA
SmolVLA từ Hugging Face có 450 triệu tham số (theo giấy phép Apache 2.0). Nó ghép backbone SmolVLM2 đã chỉnh sửa với một chuyên gia hành động flow-matching, dùng bỏ qua lớp và giảm số token hình ảnh để giữ chi phí suy luận đủ thấp cho phần cứng nhỏ.
Nó chạy trên một GPU phổ thông đơn, kể cả RTX 3060, trên CPU MacBook (dù chậm), và triển khai lên Jetson Orin để suy luận trên thiết bị.
Tinh chỉnh 20.000 bước mất khoảng 4 đến 5 giờ trên một GPU A100.
Dù chỉ huấn luyện trên dưới 30.000 tập, nó sánh ngang hoặc vượt các mô hình lớn hơn nhiều trên LIBERO, Meta-World và robot tay thực SO-100 và SO-101.
Phần hay nhất là toàn bộ mô hình được tiền huấn luyện trên các bộ dữ liệu do cộng đồng đóng góp thông qua khung LeRobot.
Cách chọn VLA cho dự án của bạn
Sau khi giới thiệu một số mô hình VLA, hãy bàn về việc chọn mô hình nào cho dự án cụ thể của bạn.
Việc chọn giữa năm mô hình này chủ yếu là ghép tần số điều khiển và phần cứng với thiết lập thực tế của bạn, không phải chạy theo mô hình vừa đứng đầu bảng xếp hạng tháng trước.
Đây là cách tôi sẽ suy nghĩ:
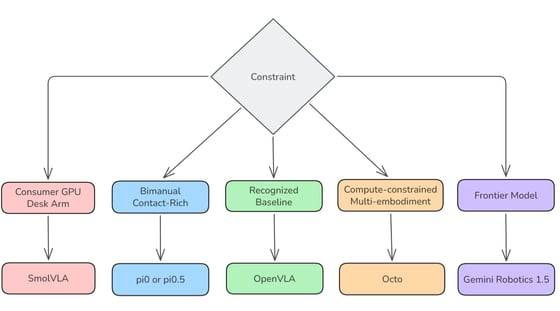
Năm ràng buộc, năm mô hình. Nếu bạn chỉ nhớ một sơ đồ từ bài này, hãy nhớ sơ đồ này. Ảnh: Tác giả.
Nếu bạn có GPU phổ thông hoặc cánh tay SO-101 trên bàn, hãy bắt đầu với SmolVLA. Không có gì khác trong hệ sinh thái mở giúp bạn có chính sách hoạt động với chi phí thấp như vậy.
- Nếu tác vụ cần thao tác giàu tiếp xúc hoặc hai tay, hãy chuyển thẳng sang pi0 hoặc pi0.5. Đầu flow-matching rất phù hợp cho các nhiệm vụ khéo léo như vậy.
- Nếu bạn viết bài báo và cần chuẩn so sánh mà phản biện sẽ nhận ra, hãy dùng OpenVLA đơn giản vì ai cũng đã có nó.
- Nếu tính toán là rào cản, nhưng bạn vẫn cần hỗ trợ đa hiện thân, Octo là lựa chọn hợp lý.
- Nếu bạn muốn xem ranh giới năng lực hiện tại, hãy xem Gemini Robotics 1.5, với hiểu rằng bạn không thể tự lưu trữ.
Và điểm lớn cuối cùng tôi muốn nêu là một trăm minh họa sạch trên SmolVLA sẽ đánh bại năm mươi minh họa lộn xộn trên OpenVLA gần như mọi lần.
Ý tôi là hãy dành 60 đến 70 phần trăm thời gian dự án cho thu thập dữ liệu và kiểm soát chất lượng, phần còn lại cho huấn luyện.
Ứng dụng của các mô hình VLA
VLA đã bước ra khỏi các video demo và đi vào một số triển khai thực tế, dù chưa đồng đều.
Mẫu hình tôi nhận thấy là chúng xuất hiện trước ở nơi môi trường có quá nhiều biến thiên để lập trình theo kịch bản, nhưng con người vẫn có thể can thiệp khi có sự cố. Dưới đây là vài ví dụ:
Thao tác robot
Đây là địa hạt chính, với các tác vụ như nhặt-và-đặt, kitting, đóng gói, phân loại, lắp ráp, v.v.
Đây là các tác vụ mà robot phải nhận diện, nắm và tái định vị vật thể có vị trí và hướng thay đổi giữa các lần thử, đúng điều kiện mà hệ thống lập trình kịch bản xử lý kém.
Kho bãi và hoàn tất đơn hàng là trường hợp thương mại rõ ràng nhất hiện nay. Một cánh tay lập trình kịch bản cần vật phẩm được trình bày như nhau mỗi lần, trong khi cánh tay dựa trên VLA có thể làm việc với một thùng lẫn lộn bốn mươi SKU khác nhau.
Robot hình người
Các công ty gồm Figure, 1X và Apptronik đang xây dựng trên nền tảng VLA, lý do đơn giản: một robot hai chân với hai bàn tay hoạt động có quá nhiều tác vụ khả dĩ để lập trình từng cái một.
Kết quả Motion Transfer của Gemini Robotics, nơi kỹ năng huấn luyện trên ALOHA 2 chuyển thẳng sang robot hình người Apollo của Apptronik, chính là thuộc tính một chương trình humanoid cần nếu muốn mở rộng.
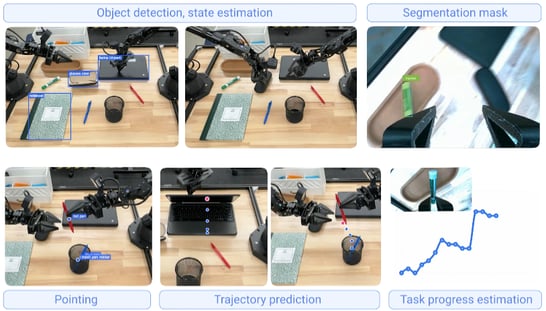
Cùng một kỹ năng, huấn luyện một lần trên ALOHA 2, chạy trên robot hình người Apollo của Apptronik mà không cần tái huấn luyện. Nguồn: Google DeepMind, “Gemini Robotics 1.5 đưa tác tử AI vào thế giới vật lý”.
Xe tự hành
Các ngăn xếp lái xe đang bắt đầu áp dụng kiến trúc kiểu VLA để kết nối những gì xe thấy với việc nó nên làm gì tiếp theo, trong một vòng suy luận thống nhất thay vì bàn giao từ nhận thức sang lập kế hoạch.
Sức hấp dẫn giống với thao tác: tình huống hiếm mà không quy tắc nào lường trước, được xử lý bởi mô hình đã thấy đủ thế giới để suy luận thay vì “đứng hình”.
Robot phẫu thuật và y tế
Tôi muốn nói đây là ứng dụng ở giai đoạn sớm nhất trong danh sách này.
Ý tưởng là hệ thống có thể theo chỉ dẫn bằng lời của bác sĩ phẫu thuật và điều chỉnh theo điều kiện mô thay đổi sẽ vượt hệ thống lập trình cứng nhắc, nhưng phê duyệt quy định mới là rào cản chính ở đây, không phải năng lực mô hình.
Tôi kỳ vọng ứng dụng hỗ trợ và đào tạo sẽ đến trước rất lâu so với bất cứ thứ gì gần tự động hoàn toàn.
Mô hình Vision Language Action: Thách thức và hạn chế
Dù VLA rất tốt, chúng vẫn còn điểm yếu, đặc biệt ở bốn chỗ cụ thể:
Phục hồi giữa tác vụ
VLA xử lý biến thiên ở đầu tác vụ khá ổn, nhưng khi kẹp trượt giữa chừng, hoặc vật thể dịch chuyển dưới ngàm kẹp, khả năng phục hồi không ổn định.
Phần lớn dữ liệu minh họa ghi lại các lần thành công, nên mô hình rất ít thấy ví dụ về việc phục hồi sau sai sót trông ra sao.
Suy luận trên thiết bị
Thao tác tinh cần vòng điều khiển chạy 10–100Hz, và khiến một mô hình 7 tỷ tham số hoặc hơn đạt tốc độ đó trên phần cứng của chính robot vẫn là mục tiêu hơn là kỹ thuật đã giải xong.
Vì vậy, hầu hết hệ thống triển khai đều nối với máy chủ biên hoặc tách suy luận khỏi điều khiển, như Gemini Robotics 1.5.
Lượng tử hóa, bỏ qua lớp và chưng cất đều hữu ích, nhưng vẫn là các giải pháp tạm thời đang tiếp tục hoàn thiện chứ chưa phải câu trả lời dứt điểm.
Nút thắt dữ liệu
Giờ đây trọng số mở đủ mạnh đã tồn tại cho bất kỳ ai tải xuống, dữ liệu trở thành yếu tố khác biệt thực sự.
Thu thập dữ liệu điều khiển từ xa đa dạng, được chú thích tốt thì chậm và đắt theo cách mà thu thập web chưa từng có, và khoảng cách giữa kết quả công bố của pi0 và những gì ai đó tái lập chỉ với dữ liệu công khai là bằng chứng rõ ràng nhất về việc lợi thế dữ liệu riêng đem lại điều gì.
Giới hạn khái quát hóa
Các VLA hiện tại khái quát hóa tốt bên trong phân phối huấn luyện và suy giảm thấy rõ khi ra ngoài nó.
Một mô hình được huấn luyện trên 22 hiện thân về thao tác trên mặt bàn vẫn có thể kém trên một hình dạng tác vụ mà nó thực sự chưa từng thấy.
Lời kết
Như bạn thấy, các mô hình VLA đưa nhận thức, hiểu ngôn ngữ và sinh hành động vào một kiến trúc, và đó là sự chuyển dịch cấu trúc chứ không phải cải tiến nhỏ.
Điều chúng làm được mà điều khiển cổ điển không làm nổi là khái quát hóa tới những điều kiện không ai huấn luyện tường minh, vì các backbone ngôn ngữ và thị giác đã mang một mô hình hoạt động về thế giới vật lý vào robot trước khi nó thấy một minh họa nào.
Điều khiến tôi ngạc nhiên nhất về tình hình năm 2026 là câu hỏi khó đã dịch chuyển đến mức nào.
Ba năm trước, câu hỏi khó là kiến trúc.
Giờ khi OpenVLA, Octo, pi0 và SmolVLA đều nằm trên GitHub cho bất kỳ ai tải về, câu hỏi khó là chất lượng dữ liệu, hành vi phục hồi, và liệu bạn có thể thực sự chạy bất kỳ thứ gì trong số này ở 50Hz ngay trên robot chứ không phải trong trung tâm dữ liệu hay không.
Nếu bạn muốn tiếp tục, khóa Giới thiệu về Tác tử AI của DataCamp bao quát bối cảnh tác tử rộng hơn, và Khái niệm Mô hình Ngôn ngữ Lớn (LLMs) bao quát phần backbone.




Hãy tưởng tượng bạn bảo ai đó: “Lấy cái cốc và đặt lên kệ.” Họ không cần sơ đồ; chỉ cần nhìn thấy cái cốc, hiểu câu nói, và tay họ đi đến đó.
Ba điều khác nhau đã xảy ra gần như đồng thời. Nhìn, hiểu và di chuyển gần như diễn ra cùng lúc đối với người đó, không phải ba bước tách rời chuyển qua lại giữa các phần khác nhau của não.
Trong phần lớn lịch sử AI cho robot, máy móc không hề hoạt động như vậy.
Trước đây, chúng ta có các mô hình thị giác-ngôn ngữ có thể nhìn một bàn làm việc lộn xộn và mô tả chính xác những gì có trên đó, bao gồm cả chi tiết như tên thương hiệu của một dụng cụ.
Bộ điều khiển robot cổ điển có thể nhặt chiếc tua vít đó một cách ổn định, miễn là không ai di chuyển nó lệch sang trái hai centimet. Hai nửa của vấn đề—nhìn và hiểu ở một phía, và hành động ở phía kia—phát triển gần như hoàn toàn tách biệt.
Đây là lúc các mô hình Vision-language-action (VLA) xuất hiện – chúng là nỗ lực để thu hẹp khoảng cách đó.
Trong bài viết này, chúng ta sẽ xem VLA là gì và kiến trúc ba phần của chúng hoạt động ra sao. Chúng ta sẽ khám phá cách chúng khác với mô hình thị giác-ngôn ngữ (VLM) và so với điều khiển robot cổ điển, điểm qua những mô hình thực sự quan trọng vào năm 2026 và nơi chúng được sử dụng. Cuối cùng, chúng ta sẽ xem các chế độ CLA vẫn còn sai ở đâu.
Mô hình Vision-Language-Action (VLA) là gì?
Hãy bắt đầu bằng cách định nghĩa chính thức VLA là gì:
Mô hình vision-language-action là một hệ thống AI xử lý luồng camera, chỉ dẫn ngôn ngữ tự nhiên và trạng thái của chính robot, sau đó xuất ra lệnh động cơ, với các mô-đun thị giác, ngôn ngữ và hành động được huấn luyện chung và chạy trong một lượt suy luận thay vì theo tuyến ống cổ điển nhận thức–lập kế hoạch–điều khiển.
Điểm chính là nhận thức, ngôn ngữ và hành động không phải là các hệ thống riêng lẻ được vá lại với nhau bằng mã “keo” viết tay.
Chúng là các phân mô-đun được huấn luyện chung. Vì vậy, một lỗi thị giác hoặc ngôn ngữ vốn sẽ làm trệch việc bàn giao trong tuyến ống cổ điển sẽ được sửa bằng gradient descent thay vì bị bắt (hoặc bị bỏ sót) qua một giao diện mã cứng.
Ba khối và hai lần bàn giao mong manh ở trên, một mô hình hợp nhất ở dưới. Đây là khác biệt cấu trúc thực sự mà tôi vẫn nhắc đến. Ảnh: Tác giả.
Tôi thích diễn đạt sự khác biệt thế này: một VLM là bộ não không có cơ thể, còn VLA trao cho nó một cơ thể.
Nhận thức không phải là một dịch vụ riêng lẻ mà robot gọi ra, mà được gắn vào tuyến ống huấn luyện chung quyết định di chuyển ngàm kẹp bao xa.
Tôi đã nhắc đến VLM, vậy hãy so sánh hai kiến trúc này.
VLA so với Mô hình Thị giác-Ngôn ngữ (VLM)
Một VLM (Vision-Language Model) nhận ảnh và văn bản rồi tạo ra văn bản hoặc embedding.
Ngược lại, một VLA (Vision-Language-Action Model) nhận cùng loại đầu vào nhưng xuất ra hành động.
Nghe có vẻ là thay đổi nhỏ cho đến khi bạn thấy tác động ở hạ nguồn:
Mô hình thị giác-ngôn ngữ (VLM)
Mô hình thị giác-ngôn ngữ-hành động (VLA)
Đầu vào
Ảnh, video, văn bản
Ảnh (thường từ nhiều camera), văn bản, trạng thái cảm nhận cơ thể của robot
Đầu ra
Văn bản, embedding
Lệnh động cơ liên tục hoặc rời rạc
Năng lực chính
Mô tả và suy luận về cảnh
Hành động trên cảnh
Có thể hành động trong thế giới thực?
Không
Có
Dữ liệu huấn luyện
Cặp ảnh-văn bản thu thập từ web
Dữ liệu web cộng quỹ đạo minh họa từ robot
Ứng dụng điển hình
Hỏi đáp trực quan, chú thích ảnh, phân tích tài liệu
Thao tác, điều hướng, điều khiển humanoid
Bạn có thể đã nghe về các mô hình như GPT-4V, Gemini, hoặc LLaVA trước đây.
Một giả định rất phổ biến là VLA chỉ là một trong số đó gắn thêm cánh tay robot.
Tuy nhiên, không đơn giản như vậy.
Mô hình phải học một không gian đầu ra hoàn toàn mới, nơi một token tương ứng với một đại lượng vật lý thực, như độ dịch chuyển của đầu công tác hoặc độ mở của ngàm kẹp, và nếu sai, nó làm đổ một chiếc cốc khỏi bàn chứ không chỉ tạo ra một câu hơi lạ.
Nếu bạn muốn xem GPT-4V, Gemini và LLaVA so kè với phần còn lại thế nào, Top 10 Vision Language Models năm 2026 của DataCamp tổng hợp các ứng viên dẫn đầu hiện tại.
Cũng có hệ quả về phía dữ liệu.
VLM có thể huấn luyện trên hàng tỷ cặp ảnh-văn bản vì internet cung cấp miễn phí.
Tuy nhiên, quỹ đạo robot phải được thu thập bằng một robot thật thực hiện một tác vụ thật, thường dưới điều khiển từ xa, đó là lý do vì sao bộ dữ liệu robot mở lớn nhất, Open X-Embodiment, dừng ở khoảng 1 triệu quỹ đạo thay vì 1 tỷ.
Việc thu thập thủ công những quỹ đạo như vậy cũng rất tốn kém và chậm.
22 dạng hiện thân, một bộ dữ liệu, và tổng cộng vẫn dưới 1 triệu quỹ đạo. Ý tôi muốn nói là dữ liệu robot không mở rộng như văn bản web. Nguồn: trang dự án Open X-Embodiment.
VLA so với điều khiển robot cổ điển
Trước khi nói về cách kiến trúc VLA hoạt động, tôi cũng muốn so sánh với điều khiển robot cổ điển.
Điều khiển robot cổ điển được xây dựng cho một tác vụ tại một nơi, trong các điều kiện đã được cố định trước.
Lấy ví dụ cánh tay máy trong máy bán hàng tự động.
Nó nhặt cùng một món ăn nhẹ từ cùng một kệ tại cùng một vị trí mỗi lần vì ánh sáng, vị trí vật thể và chuyển động cần thiết không thay đổi giữa các lần lấy.
Chính cấu hình hẹp và bất biến đó cho phép hệ thống điều khiển cứng nhắc nhưng đáng tin cậy.
Nhưng giờ hãy thay đổi cấu hình bên trong máy, hoặc thay đổi ánh sáng, hoặc thả vào cảnh một vật thể chưa từng có trong kế hoạch.
Khi đó bộ điều khiển sẽ hoàn toàn thất bại vì chưa bao giờ thấy môi trường như vậy.
VLA khái quát hóa tốt hơn đến các điều kiện chưa từng được huấn luyện tường minh, bởi vì backbone VLM nền tảng vốn đã biết cốc, khăn hay ngăn kéo trông như thế nào từ tiền huấn luyện quy mô web trước khi nó thấy một minh họa robot nào.
Tinh chỉnh trên vài trăm ví dụ gấp khăn cho phép nó học cách di chuyển với một vật thể mà nó đã nhận ra.
Chuyển giao đó mới là đột phá thực sự, không phải độ chính xác thuần túy, và tôi muốn nhấn mạnh rằng một bộ điều khiển cổ điển được tinh chỉnh tốt vẫn có thể vượt VLA về độ chính xác trong bối cảnh cố định, được kiểm soát.
Mô hình VLA hoạt động như thế nào?
Hãy đi sâu vào kiến trúc.
Trong bài viết này, tôi chọn kiến trúc OpenVLA vì dễ hiểu.
Đây là tuyến ống tôi mô tả bên dưới: DINOv2 và SigLIP cấp vào backbone Llama 2, với bộ giải mã hành động dự đoán các token rời rạc ở đầu ra. Nguồn: trang dự án OpenVLA.
Một VLA có ba mô-đun riêng:
Chúng được huấn luyện đầu-cuối cùng nhau.
Biểu diễn thị giác và ngôn ngữ được hợp nhất, và biểu diễn kết hợp này được bộ giải mã hành động chuyển thành lệnh động cơ.
Quan trọng là ba phần gắn kết chặt thay vì nối tuyến, đây chính là quyết định thiết kế tách VLA khỏi việc ghép VLM vào bộ điều khiển.
Nếu hữu ích, hãy nghĩ nó giống như cách tôi mô tả phân tách thị giác, trí nhớ và bộ điều khiển trong bài World Models gốc: nó nhìn, nó hiểu, nó hành động.
Điểm khác là VLA học cả ba nhiệm vụ cùng nhau, đầu-cuối, từ các minh họa, thay vì huấn luyện từng phần riêng rồi khâu lại sau đó.
Giờ hãy xem từng phần một.
Bộ mã hóa thị giác: những gì mô hình nhìn thấy
Bộ mã hóa thị giác biến khung hình camera thô thành biểu diễn đặc dày mà phần còn lại của mạng có thể dùng được.
Các VLA hiện đại dùng transformer thị giác tiền huấn luyện như DINOv2 hoặc SigLIP, và khá thường là cả hai.
OpenVLA là ví dụ tốt về việc dùng cả hai.
Nó hợp nhất DINOv2, mạnh về chi tiết không gian và hình học, với SigLIP, mạnh về đặc trưng ngữ nghĩa ăn khớp tốt với ngôn ngữ.
Hai tập đặc trưng được nối theo từng mảnh ảnh và chiếu vào không gian embedding của mô hình ngôn ngữ (trong trường hợp này là LLama 2 7B).
Tôi muốn nhắc rằng dùng hơn một camera là tiêu chuẩn trong triển khai thực tế.
Ví dụ, camera gắn cổ tay cho chi tiết cận cảnh khi tiếp cận cuối cùng tới vật thể, camera trên cao cho bố cục cảnh, còn góc nhìn bên giúp về chiều sâu mà một camera đơn không thể tự khôi phục.
pi0 (thêm chi tiết bên dưới) nhận nhiều góc nhìn camera cộng với trạng thái cảm nhận cơ thể của robot.
Lưu ý là đầu vào trạng thái quan trọng hơn bạn tưởng, vì một bức ảnh cánh tay không cho biết mô-men xoắn hiện tại trong các khớp.
Bộ mã hóa ngôn ngữ: những gì mô hình được chỉ dẫn
Phía ngôn ngữ mã hóa một chỉ dẫn, kiểu như “nhặt khối đỏ và đặt vào thùng xanh”, thành một biểu diễn ăn khớp với đặc trưng hình ảnh trong cùng không gian.
Hầu như mọi VLA đều tái sử dụng một backbone mô hình ngôn ngữ lớn (LLM) đã tiền huấn luyện thay vì huấn luyện bộ mã hóa văn bản từ đầu.
Trong trường hợp của chúng ta, OpenVLA dùng Llama 2 7B. pi0 và pi0.5 xây dựng trên PaliGemma, một VLM 3 tỷ tham số. SmolVLA dùng bộ SmolVLM2 đã chỉnh sửa.
Tái sử dụng LLM theo cách này thực chất là thừa hưởng năng lực.
Bạn nhận được khả năng theo chỉ dẫn và hiểu thành phần, đó là lý do VLA thường xử lý được “đặt trái cây vào bát” dù chưa từng thấy cụm từ y hệt đó trong huấn luyện robot.
Bộ giải mã hành động: những gì mô hình thực hiện
Bộ giải mã hành động là nơi biểu diễn hợp nhất trở thành lệnh động cơ, và cũng là nơi thiết kế VLA khác nhau nhiều nhất. Hiện có ba hướng tiếp cận chính.
Dự đoán token tự hồi quy
Bạn chia nhỏ mỗi chiều hành động thành các bin rời rạc và dự đoán lần lượt, giống thiết lập dự đoán token tiếp theo mà LLM vốn đã thành thạo.
OpenVLA dùng 256 bin mỗi chiều và loss dự đoán token tiếp theo thông thường, nên bạn giữ được công cụ LLM quen thuộc.
Đổi lại, bạn mất độ phân giải và tốc độ vì việc chia bin tạo chuyển động khúc khuỷu, và lấy mẫu từng token quá chậm cho các tác vụ nhanh hoặc giàu tiếp xúc.
Giải mã bằng diffusion và flow-matching
Thay vì dự đoán từng token, mô hình coi việc sinh hành động là quá trình khử nhiễu và tạo ra cả một đoạn hành động liên tục cùng lúc.
pi0 là VLA đầu tiên xây dựng quanh đầu hành động flow-matching, nơi họ khử nhiễu khoảng 10 bước để tạo ra một đoạn tối đa 50 hành động tương lai.
Điều này khiến chuyển động mượt mà hơn đáng kể so với mọi thứ dựa trên token.
Kiến trúc lai hai tầng
Một mô hình lớn xử lý suy luận cấp cao và chia nhỏ nhiệm vụ thành các bước, trong khi một bộ điều khiển nhỏ, nhanh đảm nhiệm thi hành chính xác, tần số cao.
Ví dụ rất điển hình là Gemini Robotics 1.5, nơi họ ghép một mô hình suy luận với một mô hình hành động.
Theo quan điểm cá nhân của tôi, sau khi đọc nhiều bài báo, mọi người dành quá nhiều năng lượng tranh luận về kích thước backbone hơn là về đầu hành động, và tôi nghĩ đó là ngược.
Nếu bộ giải mã của bạn đang ép một hành động liên tục 7 chiều vào 256 bin rời rạc, thì backbone có tốt đến mấy cũng không lấy lại được độ mượt!
Các mô hình VLA chủ chốt năm 2026
Giờ tôi xin trình bày bảng một số mô hình VLA quan trọng mà bạn có thể gặp:
Mô hình
Đơn vị phát triển
Tham số
Đầu hành động
Giấy phép
Phần cứng
Phù hợp nhất cho
OpenVLA
Stanford, Berkeley và cộng tác viên
7B
Token tự hồi quy
MIT
A100 hoặc H100, hoặc 24GB với lượng tử hóa 4-bit
Chuẩn nghiên cứu mở
Octo
UC Berkeley
27M hoặc 93M
Chính sách diffusion
MIT
Một RTX 4090
Công việc hạn chế tài nguyên tính toán
pi0 / pi0.5 / pi0.6
Physical Intelligence
3,3B (backbone 3B cộng chuyên gia hành động 300M)
Flow matching
Checkpoint mở (openpi)
Multi-GPU hoặc một A100
Nhiệm vụ khéo léo, tầm nhìn dài
Gemini Robotics 1.5
Google DeepMind
Không tiết lộ
Lai, đám mây cộng biên
Đóng
Kết nối đám mây
Chuẩn độc quyền tuyến đầu
SmolVLA
Hugging Face
450M
Flow matching
Apache 2.0
RTX 3060, GPU laptop, hoặc Jetson
Robot hobby và biên
Giờ hãy đi qua từng mô hình, bắt đầu với chuẩn nghiên cứu mà hầu hết mọi người vẫn lấy để so sánh.
OpenVLA
OpenVLA là một mô hình 7 tỷ tham số được huấn luyện trên 970.000 minh họa robot ngoài đời thực lấy từ Open X-Embodiment.
Nó kết hợp Llama 2 7B làm backbone với bộ mã hóa thị giác hợp nhất DINOv2 và SigLIP như tôi đã mô tả, và toàn bộ mô hình là mã nguồn mở.
Kết quả gây bất ngờ là nó vượt mô hình đóng RT-2-X 16,5 điểm phần trăm tỉ lệ thành công tác vụ trên 29 tác vụ, trong khi RT-2-X chạy 55 tỷ tham số so với 7 tỷ của OpenVLA!
Tổng huấn luyện mất 64 GPU A100 trong 15 ngày.
Lý do nó vẫn phổ biến là tinh chỉnh LoRA và lượng tử hóa 4-bit đều hoạt động tốt trên nó.
Điều này có nghĩa một RTX 4090 24GB có thể chạy phiên bản đã lượng tử hóa và phần lớn các công trình đã công bố về tấn công, phòng thủ và cắt tỉa VLA đều dùng OpenVLA làm mục tiêu vì nó quá dễ tiếp cận.
Bản tiếp theo - OpenVLA-OFT cải thiện công thức tinh chỉnh cả về tốc độ lẫn tỉ lệ thành công.
Octo
Octo là một VLA nhỏ, có hai kích cỡ - 27 triệu và 93 triệu tham số trên backbone ViT-S và ViT-B, và có thể chạy trên một RTX 4090 ở 20 đến 30 Hz.
Nó được huấn luyện trên khoảng 800.000 quỹ đạo từ Open X-Embodiment qua 22 dạng hiện thân của robot, và kiến trúc transformer của nó thực sự dạng mô-đun.
Bạn có thể thêm đầu vào quan sát mới hoặc thay đầu hành động trong khi tinh chỉnh mà không phải xây lại mô hình từ đầu, và nó hỗ trợ cả token rời rạc lẫn hành động liên tục dựa trên diffusion tùy nhu cầu.
Transformer của Octo: token nhiệm vụ và quan sát vào, token đọc ra đưa đến đầu hành động, với chỗ để thêm cảm biến hoặc không gian hành động khi tinh chỉnh. Nguồn: bài báo Octo.
Tôi thường dùng Octo khi giới hạn là tính toán chứ không phải độ khó của tác vụ.
Nó cũng hỗ trợ điều kiện hóa bằng ảnh mục tiêu, rất tiện khi mô tả trạng thái đích bằng lời vụng về hơn là đưa ảnh chụp điều bạn muốn.
pi0 và gia đình Physical Intelligence
pi0 từ Physical Intelligence rất giỏi về khéo léo. Nó bắt đầu từ PaliGemma, một VLM mở 3 tỷ tham số, và thêm một chuyên gia hành động 300 triệu tham số huấn luyện từ đầu, tổng cộng 3,3 tỷ tham số.
Nó dùng flow matching để tạo một đoạn tối đa 50 hành động tương lai cùng lúc thay vì từng bước một.
Kết quả chủ chốt là các tác vụ hai tay như gấp đồ giặt, đóng gói hàng tạp hóa và lắp ráp hộp, tất cả được xử lý với mức độ khéo léo chưa từng có trước đó.
Robot pi0 gấp đồ giặt bằng hai tay. Đây là một trong các tác vụ hai tay tôi đã nhắc, gấp đồ giặt, và đáng để xem video hơn là chỉ đọc. Nguồn: Physical Intelligence, “pi0: Chính sách tổng quát đầu tiên của chúng tôi”.
Flow matching là thành phần làm việc thực sự ở đây, bởi vì phối hợp hai tay cùng lúc cần đầu ra liên tục 16 chiều mượt mà, và cả token rời rạc lẫn diffusion chậm đều không cho tốc độ sử dụng được.
Gia đình pi0 tiếp tục phát triển:
Một lưu ý tôi muốn nêu là các kết quả mạnh nhất của pi0 phụ thuộc vào dữ liệu độc quyền thu thập trên đội robot riêng của họ.
Không ai ngoài công ty tái lập đúng các con số đó chỉ với dữ liệu công khai, nên mức độ hiệu năng đến từ kiến trúc so với lợi thế dữ liệu vẫn chưa ngã ngũ.
Gemini Robotics 1.5
Gemini Robotics 1.5 từ Google DeepMind nên được hiểu là hai mô hình làm việc cùng nhau thay vì một.
Gemini Robotics-ER 1.5 là mô hình suy luận nhập thể có thể lập kế hoạch, gọi công cụ như Google Search, và ước lượng tiến độ của chính nó trên một tác vụ.
Gemini Robotics 1.5 là VLA thực thi những gì mô hình suy luận quyết định.
Gemini Robotics-ER 1.5 phía trên để suy luận nhập thể, Gemini Robotics 1.5 phía dưới là VLA, gọi công cụ chung ở giữa, và hành động chạy trên ALOHA 2, Franka và Apollo mà không cần căn chỉnh không gian hành động. Nguồn: bài báo Gemini Robotics 1.5.
Điểm hữu ích là nó trộn hành động với quá trình suy luận nội bộ bằng ngôn ngữ tự nhiên, nên robot suy nghĩ trước khi hành động và có thể giải thích quyết định sau đó.
Với chỉ dẫn như “phân loại đồ giặt theo màu”, nó trước tiên suy ra đồ trắng vào một thùng và phần còn lại vào thùng khác, rồi lên kế hoạch cho từng lần nhặt.
DeepMind báo cáo khoảng 250 mili giây từ quan sát đến hành động, tương đương tần số điều khiển 50Hz, đạt được bằng cách đặt phần suy luận nặng trên đám mây và giữ bộ giải mã hành động nhẹ tại chỗ robot.
Kết quả khác tôi muốn nêu là Motion Transfer, tức một tác vụ học trên nền tảng hai tay ALOHA 2 được chuyển thẳng sang thiết lập hai tay Franka và robot hình người Apollo của Apptronik mà không cần tái huấn luyện.
Trọng số bị đóng, nên tôi xem đây là chuẩn độc quyền tuyến đầu hơn là thứ bạn có thể tải về và tự tinh chỉnh.
SmolVLA
SmolVLA từ Hugging Face có 450 triệu tham số (theo giấy phép Apache 2.0). Nó ghép backbone SmolVLM2 đã chỉnh sửa với một chuyên gia hành động flow-matching, dùng bỏ qua lớp và giảm số token hình ảnh để giữ chi phí suy luận đủ thấp cho phần cứng nhỏ.
Nó chạy trên một GPU phổ thông đơn, kể cả RTX 3060, trên CPU MacBook (dù chậm), và triển khai lên Jetson Orin để suy luận trên thiết bị.
Tinh chỉnh 20.000 bước mất khoảng 4 đến 5 giờ trên một GPU A100.
Dù chỉ huấn luyện trên dưới 30.000 tập, nó sánh ngang hoặc vượt các mô hình lớn hơn nhiều trên LIBERO, Meta-World và robot tay thực SO-100 và SO-101.
Phần hay nhất là toàn bộ mô hình được tiền huấn luyện trên các bộ dữ liệu do cộng đồng đóng góp thông qua khung LeRobot.
Cách chọn VLA cho dự án của bạn
Sau khi giới thiệu một số mô hình VLA, hãy bàn về việc chọn mô hình nào cho dự án cụ thể của bạn.
Việc chọn giữa năm mô hình này chủ yếu là ghép tần số điều khiển và phần cứng với thiết lập thực tế của bạn, không phải chạy theo mô hình vừa đứng đầu bảng xếp hạng tháng trước.
Đây là cách tôi sẽ suy nghĩ:
Năm ràng buộc, năm mô hình. Nếu bạn chỉ nhớ một sơ đồ từ bài này, hãy nhớ sơ đồ này. Ảnh: Tác giả.
Nếu bạn có GPU phổ thông hoặc cánh tay SO-101 trên bàn, hãy bắt đầu với SmolVLA. Không có gì khác trong hệ sinh thái mở giúp bạn có chính sách hoạt động với chi phí thấp như vậy.
Và điểm lớn cuối cùng tôi muốn nêu là một trăm minh họa sạch trên SmolVLA sẽ đánh bại năm mươi minh họa lộn xộn trên OpenVLA gần như mọi lần.
Ý tôi là hãy dành 60 đến 70 phần trăm thời gian dự án cho thu thập dữ liệu và kiểm soát chất lượng, phần còn lại cho huấn luyện.
Ứng dụng của các mô hình VLA
VLA đã bước ra khỏi các video demo và đi vào một số triển khai thực tế, dù chưa đồng đều.
Mẫu hình tôi nhận thấy là chúng xuất hiện trước ở nơi môi trường có quá nhiều biến thiên để lập trình theo kịch bản, nhưng con người vẫn có thể can thiệp khi có sự cố. Dưới đây là vài ví dụ:
Thao tác robot
Đây là địa hạt chính, với các tác vụ như nhặt-và-đặt, kitting, đóng gói, phân loại, lắp ráp, v.v.
Đây là các tác vụ mà robot phải nhận diện, nắm và tái định vị vật thể có vị trí và hướng thay đổi giữa các lần thử, đúng điều kiện mà hệ thống lập trình kịch bản xử lý kém.
Kho bãi và hoàn tất đơn hàng là trường hợp thương mại rõ ràng nhất hiện nay. Một cánh tay lập trình kịch bản cần vật phẩm được trình bày như nhau mỗi lần, trong khi cánh tay dựa trên VLA có thể làm việc với một thùng lẫn lộn bốn mươi SKU khác nhau.
Robot hình người
Các công ty gồm Figure, 1X và Apptronik đang xây dựng trên nền tảng VLA, lý do đơn giản: một robot hai chân với hai bàn tay hoạt động có quá nhiều tác vụ khả dĩ để lập trình từng cái một.
Kết quả Motion Transfer của Gemini Robotics, nơi kỹ năng huấn luyện trên ALOHA 2 chuyển thẳng sang robot hình người Apollo của Apptronik, chính là thuộc tính một chương trình humanoid cần nếu muốn mở rộng.
Cùng một kỹ năng, huấn luyện một lần trên ALOHA 2, chạy trên robot hình người Apollo của Apptronik mà không cần tái huấn luyện. Nguồn: Google DeepMind, “Gemini Robotics 1.5 đưa tác tử AI vào thế giới vật lý”.
Xe tự hành
Các ngăn xếp lái xe đang bắt đầu áp dụng kiến trúc kiểu VLA để kết nối những gì xe thấy với việc nó nên làm gì tiếp theo, trong một vòng suy luận thống nhất thay vì bàn giao từ nhận thức sang lập kế hoạch.
Sức hấp dẫn giống với thao tác: tình huống hiếm mà không quy tắc nào lường trước, được xử lý bởi mô hình đã thấy đủ thế giới để suy luận thay vì “đứng hình”.
Robot phẫu thuật và y tế
Tôi muốn nói đây là ứng dụng ở giai đoạn sớm nhất trong danh sách này.
Ý tưởng là hệ thống có thể theo chỉ dẫn bằng lời của bác sĩ phẫu thuật và điều chỉnh theo điều kiện mô thay đổi sẽ vượt hệ thống lập trình cứng nhắc, nhưng phê duyệt quy định mới là rào cản chính ở đây, không phải năng lực mô hình.
Tôi kỳ vọng ứng dụng hỗ trợ và đào tạo sẽ đến trước rất lâu so với bất cứ thứ gì gần tự động hoàn toàn.
Mô hình Vision Language Action: Thách thức và hạn chế
Dù VLA rất tốt, chúng vẫn còn điểm yếu, đặc biệt ở bốn chỗ cụ thể:
Phục hồi giữa tác vụ
VLA xử lý biến thiên ở đầu tác vụ khá ổn, nhưng khi kẹp trượt giữa chừng, hoặc vật thể dịch chuyển dưới ngàm kẹp, khả năng phục hồi không ổn định.
Phần lớn dữ liệu minh họa ghi lại các lần thành công, nên mô hình rất ít thấy ví dụ về việc phục hồi sau sai sót trông ra sao.
Suy luận trên thiết bị
Thao tác tinh cần vòng điều khiển chạy 10–100Hz, và khiến một mô hình 7 tỷ tham số hoặc hơn đạt tốc độ đó trên phần cứng của chính robot vẫn là mục tiêu hơn là kỹ thuật đã giải xong.
Vì vậy, hầu hết hệ thống triển khai đều nối với máy chủ biên hoặc tách suy luận khỏi điều khiển, như Gemini Robotics 1.5.
Lượng tử hóa, bỏ qua lớp và chưng cất đều hữu ích, nhưng vẫn là các giải pháp tạm thời đang tiếp tục hoàn thiện chứ chưa phải câu trả lời dứt điểm.
Nút thắt dữ liệu
Giờ đây trọng số mở đủ mạnh đã tồn tại cho bất kỳ ai tải xuống, dữ liệu trở thành yếu tố khác biệt thực sự.
Thu thập dữ liệu điều khiển từ xa đa dạng, được chú thích tốt thì chậm và đắt theo cách mà thu thập web chưa từng có, và khoảng cách giữa kết quả công bố của pi0 và những gì ai đó tái lập chỉ với dữ liệu công khai là bằng chứng rõ ràng nhất về việc lợi thế dữ liệu riêng đem lại điều gì.
Giới hạn khái quát hóa
Các VLA hiện tại khái quát hóa tốt bên trong phân phối huấn luyện và suy giảm thấy rõ khi ra ngoài nó.
Một mô hình được huấn luyện trên 22 hiện thân về thao tác trên mặt bàn vẫn có thể kém trên một hình dạng tác vụ mà nó thực sự chưa từng thấy.
Lời kết
Như bạn thấy, các mô hình VLA đưa nhận thức, hiểu ngôn ngữ và sinh hành động vào một kiến trúc, và đó là sự chuyển dịch cấu trúc chứ không phải cải tiến nhỏ.
Điều chúng làm được mà điều khiển cổ điển không làm nổi là khái quát hóa tới những điều kiện không ai huấn luyện tường minh, vì các backbone ngôn ngữ và thị giác đã mang một mô hình hoạt động về thế giới vật lý vào robot trước khi nó thấy một minh họa nào.
Điều khiến tôi ngạc nhiên nhất về tình hình năm 2026 là câu hỏi khó đã dịch chuyển đến mức nào.
Ba năm trước, câu hỏi khó là kiến trúc.
Giờ khi OpenVLA, Octo, pi0 và SmolVLA đều nằm trên GitHub cho bất kỳ ai tải về, câu hỏi khó là chất lượng dữ liệu, hành vi phục hồi, và liệu bạn có thể thực sự chạy bất kỳ thứ gì trong số này ở 50Hz ngay trên robot chứ không phải trong trung tâm dữ liệu hay không.
Nếu bạn muốn tiếp tục, khóa Giới thiệu về Tác tử AI của DataCamp bao quát bối cảnh tác tử rộng hơn, và Khái niệm Mô hình Ngôn ngữ Lớn (LLMs) bao quát phần backbone.