Curso
Aprendizagem profunda intermediária com PyTorch
4 h
29.9K
Imagine que você diga a alguém: “Pegue a caneca e coloque na prateleira”. Essa pessoa não precisa de um diagrama; ela olha para a caneca, entende a frase e a mão vai direto até lá.
Três coisas diferentes acontecem quase ao mesmo tempo aqui. Ver, entender e se mover acontecem praticamente juntas para essa pessoa, não como três etapas separadas repassadas entre partes distintas do cérebro.
Durante a maior parte da história da IA em robótica, as máquinas não funcionavam assim.
No passado, tínhamos modelos de visão e linguagem que olhavam para uma bancada bagunçada e descreviam exatamente o que havia ali, incluindo detalhes como a marca de uma ferramenta.
Controladores robóticos clássicos conseguiam pegar aquela chave de fenda com confiabilidade — desde que ninguém a movesse dois centímetros para a esquerda. As duas metades do problema, ver/entender de um lado e agir do outro, evoluíram quase totalmente separadas.
É aí que entram os modelos de visão-linguagem-ação (VLA) — uma tentativa de fechar esse gap.
Neste artigo, vamos ver o que são os VLAs e como funciona sua arquitetura de três partes. Vamos explorar como eles diferem dos VLMs (vision-language models) e do controle robótico clássico, quais modelos realmente importam em 2026 e onde são usados. Por fim, veremos o que os VLAs ainda erram.
Vamos começar definindo formalmente o que são VLAs:
Um modelo de visão-linguagem-ação é um sistema de IA que processa o feed da câmera, uma instrução em linguagem natural e o próprio estado do robô, e então produz comandos motores. Seus módulos de visão, linguagem e ação são treinados em conjunto e executados em uma única passada forward, em vez de um pipeline clássico de percepção-planejamento-controle.
O ponto principal é que percepção, linguagem e ação não são sistemas separados unidos por “gambiarras” escritas à mão.
São submódulos treinados conjuntamente. Assim, um erro de visão ou linguagem que desmontaria a transferência de um pipeline clássico é corrigido por gradiente descendente, e não pego — ou perdido — por uma interface hardcoded.
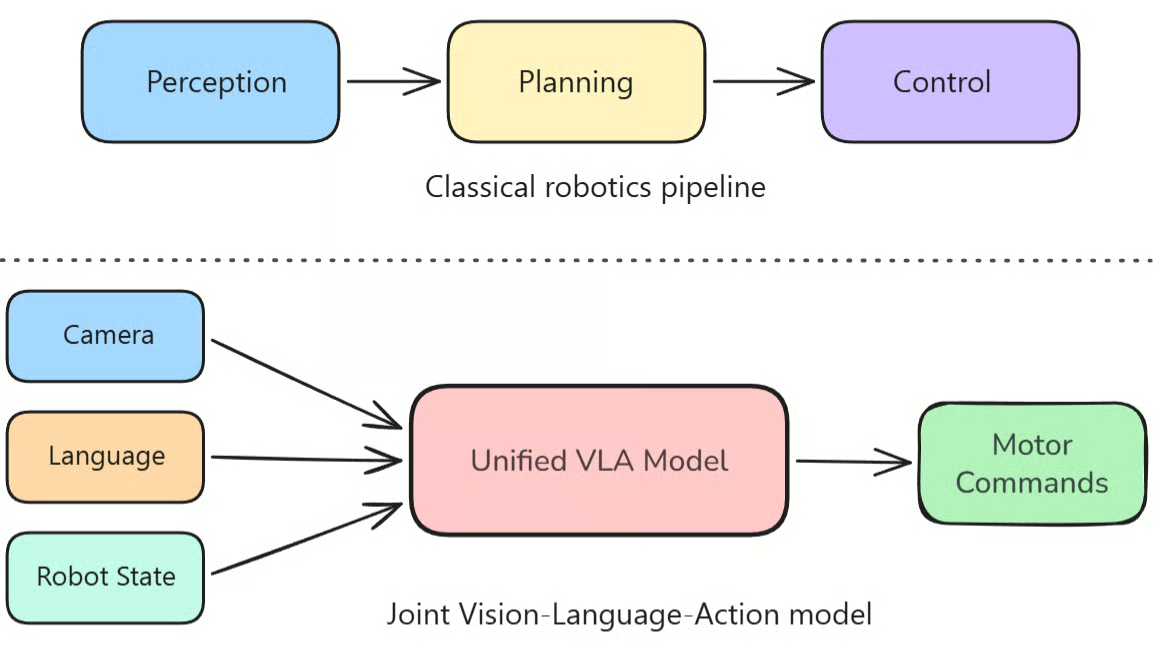
Três caixas e duas passagens frágeis em cima; um modelo fundido embaixo. Esta é a diferença estrutural real de que venho falando. Imagem do autor.
Gosto de colocar a distinção assim: um VLM é um cérebro sem corpo, e um VLA dá esse corpo a ele.
A percepção não é um serviço separado ao qual o robô “chama”, e sim parte integrada do pipeline treinado conjuntamente que decide o quanto mover a garra.
Como mencionei VLMs também, vamos comparar essas 2 arquiteturas.
Um VLM (vision-language model) recebe imagens e texto e produz texto ou embeddings.
Já um VLA (vision-language-action model) recebe o mesmo tipo de entrada e produz uma ação.
Parece uma mudança pequena — até você ver o impacto no restante do sistema:
|
Vision-language model (VLM) |
Vision-language-action model (VLA) |
|
|---|---|---|
|
Entrada |
Imagens, vídeo, texto |
Imagens (muitas vezes de várias câmeras), texto, estado proprioceptivo do robô |
|
Saída |
Texto, embeddings |
Comandos motores contínuos ou discretizados |
|
Capacidade principal |
Descrever e raciocinar sobre uma cena |
Agir sobre uma cena |
|
Consegue agir no mundo? |
Não |
Sim |
|
Dados de treinamento |
Pares imagem-texto coletados na web |
Dados da web mais trajetórias de demonstração robótica |
|
Aplicação típica |
Visual question answering, legendagem, parsing de documentos |
Manipulação, navegação, controle humanoide |
Você provavelmente já ouviu falar de modelos como GPT-4V, Gemini ou LLaVA.
É comum supor que um VLA é só um desses com um braço robótico acoplado.
Mas não é tão simples assim.
O modelo precisa aprender um espaço de saída totalmente novo, no qual um token corresponde a uma quantidade física real, como deslocamento do efetuador final ou abertura da garra — e errar nisso derruba um copo da mesa, em vez de gerar uma frase apenas estranha.
Se você quiser ver como GPT-4V, Gemini e LLaVA se comparam ao restante do campo, o top 10 de vision-language models de 2026 da DataCamp reúne os líderes atuais.
Há também uma consequência do lado dos dados.
Um VLM pode treinar em bilhões de pares imagem-texto porque a internet os fornece de graça.
Já trajetórias robóticas precisam ser coletadas por um robô real executando uma tarefa real, geralmente sob teleoperação, motivo pelo qual o maior dataset aberto de robótica, o Open X-Embodiment, chega a cerca de 1 milhão de trajetórias — e não 1 bilhão.
Coletar essas trajetórias manualmente também é caro e lento.
22 corpos, um dataset, e ainda abaixo de 1 milhão de trajetórias no total. É isso que quero dizer quando afirmo que dados robóticos não escalam como texto da web. Fonte: página do projeto Open X-Embodiment.
Antes de falar sobre como funciona a arquitetura VLA, quero comparar também com o controle robótico clássico.
O controle clássico é feito para uma tarefa em um lugar, sob condições pré-definidas e estáveis.
Pense no braço de uma máquina de vendas, por exemplo.
Ele pega o mesmo snack da mesma prateleira no mesmo ponto toda vez, porque iluminação, posição dos objetos e movimentos necessários não mudam entre as tentativas.
Esse cenário estreito e imutável é exatamente o que permite um sistema de controle rígido e confiável.
Agora mude a configuração interna da máquina, altere a iluminação ou coloque na cena um item fora do plano.
O controlador falhará completamente — ele nunca viu o ambiente assim.
Um VLA generaliza melhor para condições não vistas explicitamente no treino, porque o backbone VLM subjacente já “sabe” como são uma caneca, uma toalha ou uma gaveta, graças ao pré-treinamento em escala web — antes mesmo de ver uma demonstração robótica.
Ao ajustá-lo em cem exemplos de dobrar toalhas, ele aprende como se mover dado algo que já reconhece.
Essa transferência é o verdadeiro avanço aqui, não a precisão bruta, e vale dizer que um controlador clássico bem ajustado ainda pode superar um VLA em precisão num ambiente fixo e controlado.
Vamos mergulhar na arquitetura.
Para este artigo, escolhi a arquitetura do OpenVLA por ser fácil de entender.
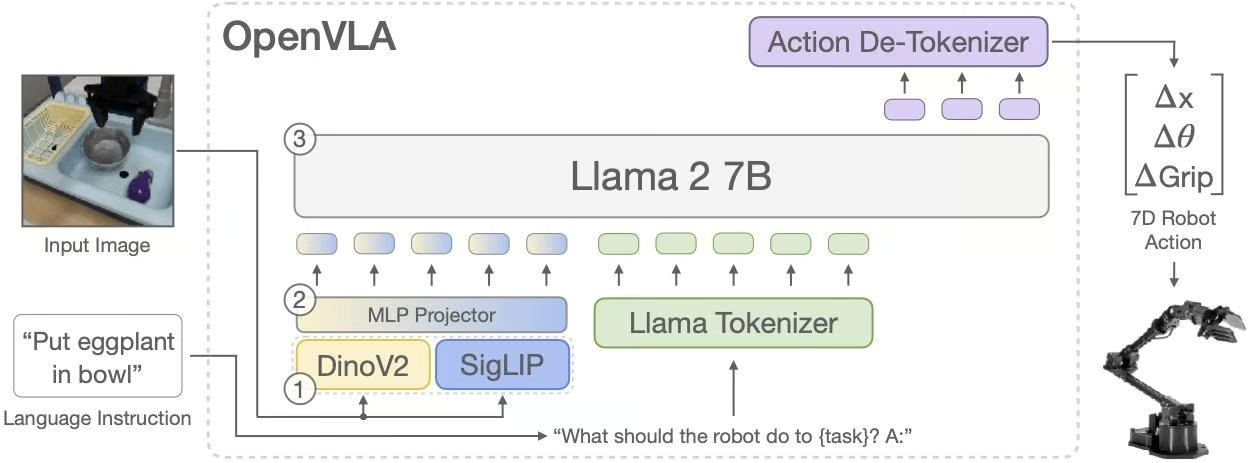
Este é o pipeline descrito abaixo: DINOv2 e SigLIP alimentando um backbone Llama 2, com o decodificador de ação prevendo tokens discretizados na outra ponta. Fonte: página do projeto OpenVLA.
Um VLA tem três módulos separados:
Eles são treinados de ponta a ponta, juntos.
As representações de visão e linguagem são fundidas, e essa representação combinada é o que o decodificador de ação transforma em comandos motores.
Importante: as três partes são fortemente acopladas, e não encadeadas em pipeline. Essa é a decisão de design que separa um VLA de um VLM acoplado a um controlador.
Se ajudar, pense como na divisão visão, memória e controlador do paper World Models: ele vê, entende e age.
A diferença aqui é que um VLA aprende os três trabalhos juntos, de ponta a ponta, a partir de demonstrações — e não treina cada peça separadamente para depois costurá-las.
Agora, vamos explorar cada parte individualmente.
O encoder de visão transforma um frame bruto de câmera em uma representação densa que o restante da rede consegue usar.
Os VLAs modernos usam vision transformers pré-treinados como DINOv2 ou SigLIP — muitas vezes ambos.
O OpenVLA é um bom exemplo do uso combinado.
Ele funde o DINOv2, forte em detalhes espaciais e geométricos, com o SigLIP, mais forte em recursos semânticos que se alinham bem com linguagem.
Os dois conjuntos de features são concatenados por patch da imagem e projetados no espaço de embedding do modelo de linguagem (neste caso, o LLama 2 7B).
Vale dizer que usar mais de uma câmera é padrão em implantações reais.
Por exemplo, uma câmera no punho dá detalhes de curta distância na aproximação final de um objeto; uma câmera aérea oferece o layout da cena; e uma lateral ajuda com profundidade que uma única câmera não recupera sozinha.
O pi0 (mais sobre isso abaixo) recebe múltiplas visões de câmera mais o estado proprioceptivo do robô.
Observe que a entrada de estado importa mais do que parece: uma foto do braço não informa o torque atual nas juntas.
O lado de linguagem codifica uma instrução — algo como “pegue o bloco vermelho e coloque na caixa azul” — em uma representação que se alinha com os recursos visuais no mesmo espaço.
Praticamente todo VLA reutiliza um large language model (LLM) pré-treinado, em vez de treinar um codificador de texto do zero.
No nosso caso, o OpenVLA usou o Llama 2 7B. pi0 e pi0.5 se basearam no PaliGemma, um VLM de 3 bilhões de parâmetros. O SmolVLA usou uma pilha SmolVLM2 modificada.
Reutilizar um LLM é, no fundo, herança.
Você ganha follow-up de instruções e entendimento composicional — por isso um VLA costuma lidar com comandos como “coloque as frutas na tigela” mesmo sem ter visto exatamente essa frase durante o treino robótico.
O decodificador de ação é onde a representação fundida vira de fato um comando motor — e é também onde os projetos de VLA mais divergem. Existem três abordagens principais hoje.
Você divide cada dimensão de ação em bins discretos e as prevê uma após a outra, no mesmo esquema de próximo token que um LLM já sabe treinar.
O OpenVLA usa 256 bins por dimensão e uma perda normal de próximo token, então você mantém a instrumentação usual de LLM.
O que se perde é resolução e velocidade: a discretização deixa o movimento serrilhado, e amostrar token a token é lento demais para qualquer coisa rápida ou com muito contato.
Em vez de prever um token por vez, o modelo trata a geração de ação como um processo de remoção de ruído e produz um bloco inteiro de ações contínuas de uma vez.
O pi0 foi o primeiro VLA construído com um head de ação por flow matching, removendo ruído em cerca de 10 passos para produzir um bloco de até 50 ações futuras.
O resultado é um movimento visivelmente mais suave do que qualquer abordagem baseada em tokens.
Um modelo maior cuida do raciocínio de alto nível e quebra a tarefa em etapas, enquanto um controlador menor e mais rápido executa a parte precisa e em alta frequência.
Um ótimo exemplo é o Gemini Robotics 1.5, que emparelha um modelo de raciocínio com um modelo de ação.
Na minha opinião, depois de ler vários artigos, as pessoas gastam muito mais energia discutindo o tamanho do backbone do que o head de ação — e isso me parece o inverso.
Se o seu decodificador está comprimindo uma ação contínua de 7 dimensões em 256 bins discretos, nenhum backbone melhor recupera essa suavidade!
A seguir, uma tabela com VLAs importantes que você provavelmente vai encontrar:
|
Modelo |
Desenvolvedor |
Parâmetros |
Head de ação |
Licença |
Hardware |
Melhor para |
|---|---|---|---|---|---|---|
|
OpenVLA |
Stanford, Berkeley e colaboradores |
7B |
Tokens autoregressivos |
MIT |
A100 ou H100, ou 24GB com quantização 4-bit |
Baseline aberto de pesquisa |
|
Octo |
UC Berkeley |
27M ou 93M |
Política de difusão |
MIT |
Uma única RTX 4090 |
Cenários com pouco compute |
|
pi0 / pi0.5 / pi0.6 |
Physical Intelligence |
3,3B (3B de backbone + 300M expert de ação) |
Flow matching |
Checkpoints abertos (openpi) |
Multi-GPU ou uma única A100 |
Tarefas longas e com destreza |
|
Gemini Robotics 1.5 |
Google DeepMind |
Não divulgado |
Híbrido, nuvem + borda |
Fechado |
Conectado à nuvem |
Baseline proprietário de fronteira |
|
SmolVLA |
Hugging Face |
450M |
Flow matching |
Apache 2.0 |
RTX 3060, GPU de notebook ou Jetson |
Robótica hobby e de borda |
Agora vamos passar por cada um, começando pelo baseline de pesquisa com que a maioria ainda se compara.
OpenVLA é um modelo de 7 bilhões de parâmetros treinado em 970.000 demonstrações robóticas reais do Open X-Embodiment.
Ele combina um backbone Llama 2 7B com os encoders de visão DINOv2 e SigLIP fundidos, como descrevi acima, e o modelo é todo open source.
O resultado surpreendente foi ter superado o modelo fechado RT-2-X em 16,5 pontos percentuais de sucesso de tarefa em 29 tarefas, enquanto o RT-2-X rodava com 55 bilhões de parâmetros contra 7 bilhões do OpenVLA!
O treinamento total usou 64 GPUs A100 por 15 dias.
Ele segue popular porque fine-tuning com LoRA e quantização em 4 bits funcionam bem nele.
Isso significa que uma RTX 4090 de 24GB consegue rodar a versão quantizada, e a maior parte dos trabalhos publicados sobre ataques, defesas e pruning em VLA usam o OpenVLA como alvo justamente por ser tão acessível.
Uma continuação — o OpenVLA-OFT — melhorou a receita de fine-tuning em velocidade e taxa de sucesso.
O Octo é um VLA pequeno, em dois tamanhos — 27 milhões e 93 milhões de parâmetros nos backbones ViT-S e ViT-B, respectivamente — e roda em uma única RTX 4090 a 20–30 Hz.
Ele foi treinado em cerca de 800.000 trajetórias do Open X-Embodiment, cobrindo 22 corpos robóticos, e sua arquitetura transformer é genuinamente modular.
Você pode adicionar uma nova entrada de sensor ou trocar o head de ação durante o fine-tuning sem reconstruir o modelo do zero, e ele suporta tokens discretos e ações contínuas por difusão, conforme a necessidade.
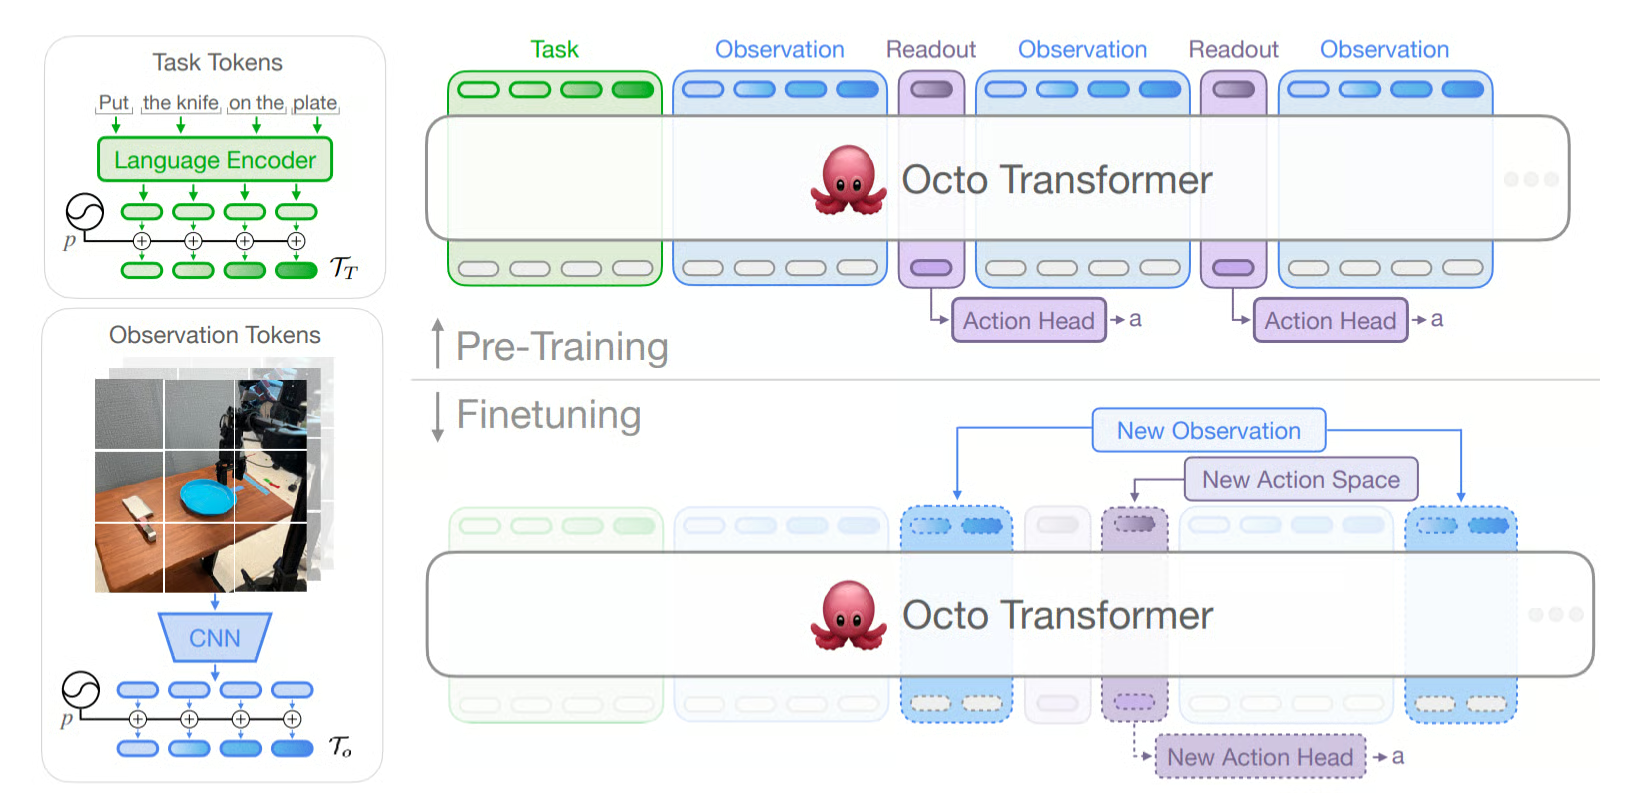
Transformer do Octo: tokens de tarefa e observação entram, readout tokens saem para o head de ação, com espaço para adicionar novos sensores ou espaços de ação no fine-tuning. Fonte: artigo do Octo.
Eu pessoalmente uso o Octo quando o limitador é compute — não a dificuldade da tarefa.
Ele também suporta condicionamento por imagem-objetivo, ótimo quando descrever o estado alvo em palavras é mais chato do que só mostrar uma foto do que você quer.
pi0, da Physical Intelligence, é muito bom em destreza. Ele parte do PaliGemma, um VLM aberto de 3 bilhões de parâmetros, e adiciona um expert de ação com 300 milhões de parâmetros treinado do zero — somando 3,3 bilhões ao todo.
Ele usa flow matching para produzir um bloco de até 50 ações futuras de uma vez, em vez de um passo por vez.
Os resultados-chave foram tarefas bimanipulares como dobrar roupas, embalar compras e montar caixas — com um nível de destreza sem precedentes.
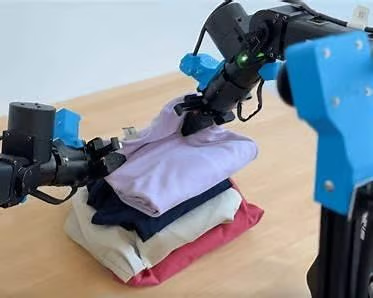
Robô pi0 dobrando roupas com dois braços. Uma das tarefas bimanipulares citadas; vale mais assistir do que só ler. Fonte: Physical Intelligence, “pi0: Our First Generalist Policy”.
O flow matching é o que faz a diferença aqui, porque coordenar dois braços de uma vez exige saída contínua suave em 16 dimensões — nem tokens discretos nem amostragem lenta por difusão entregam isso em velocidade utilizável.
A família pi0 continuou evoluindo:
Um ponto de atenção: os resultados mais fortes do pi0 dependem de dados proprietários coletados pela própria frota da empresa.
Ninguém fora da empresa reproduziu exatamente aqueles números usando apenas dados públicos, então o quanto vem da arquitetura versus da vantagem de dados ainda não está resolvido.
Gemini Robotics 1.5, do Google DeepMind, é melhor entendido como dois modelos trabalhando juntos, e não um só.
O Gemini Robotics-ER 1.5 é um modelo de raciocínio incorporado que planeja, chama ferramentas como o Google Search e estima o próprio progresso na tarefa.
O Gemini Robotics 1.5 é o VLA que executa o que o modelo de raciocínio decide.
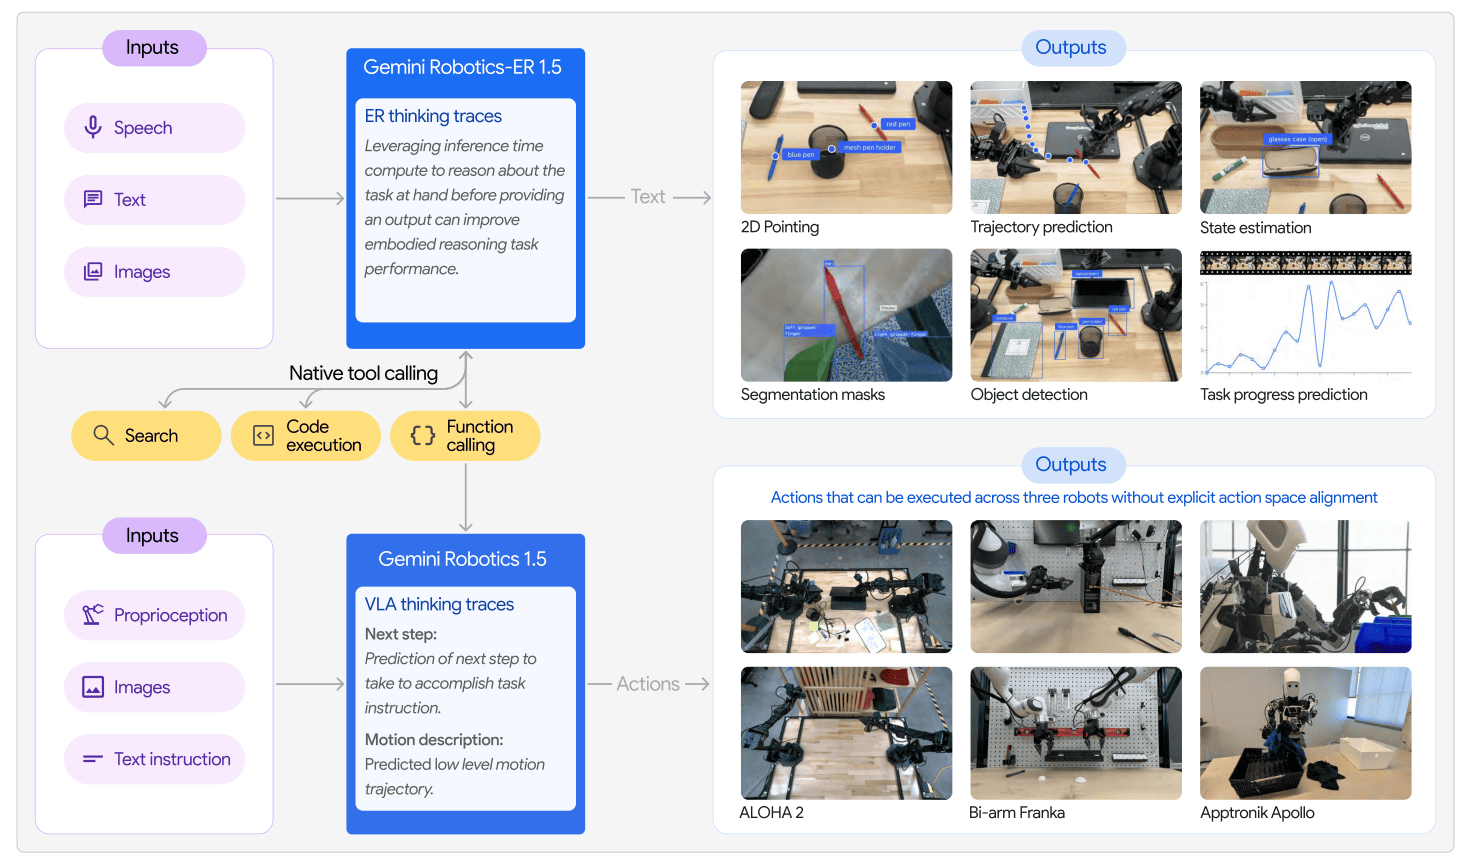
Gemini Robotics-ER 1.5 no topo para raciocínio incorporado; Gemini Robotics 1.5 abaixo como VLA; tool calling compartilhado no meio; e ações rodando em ALOHA 2, Franka e Apollo sem alinhamento de espaço de ação. Fonte: artigo do Gemini Robotics 1.5.
O útil aqui é misturar ações com um processo interno de raciocínio escrito em linguagem natural: o robô pensa antes de agir e consegue explicar depois o que decidiu.
Dada uma instrução como “separe minhas roupas por cor”, ele primeiro deduz que brancas vão em um cesto e o restante em outro, e então planeja as pegas individuais.
A DeepMind reporta cerca de 250 ms do observável à ação — frequência efetiva de 50 Hz — colocando o raciocínio pesado na nuvem e mantendo um decodificador de ação leve no robô.
Outro resultado foi o Motion Transfer: uma tarefa aprendida no ALOHA 2 (duplo braço) transferida diretamente para um setup Franka bi-arm e para o humanoide Apollo da Apptronik — sem retreino em nenhum dos dois.
Os pesos são fechados, então trate-o como o baseline proprietário de fronteira, não algo que você possa baixar e ajustar por conta própria.
SmolVLA, da Hugging Face, tem 450 milhões de parâmetros (licença Apache 2.0). Ele combina um backbone SmolVLM2 modificado com um expert de ação por flow matching, usando layer skipping e menos tokens visuais para baratear a inferência em hardwares menores.
Roda em uma GPU de consumo (incluindo RTX 3060), em CPU de MacBook (mais lento) e em Jetson Orin onboard.
O fine-tuning por 20.000 passos leva cerca de 4 a 5 horas em uma única A100.
Mesmo treinado em menos de 30.000 episódios, ele iguala ou supera modelos bem maiores no LIBERO, Meta-World e em braços reais SO-100 e SO-101.
O melhor é que tudo é pré-treinado com datasets da comunidade via framework LeRobot.
Agora que apresentei alguns VLAs, vamos falar sobre qual escolher para o seu caso.
Escolher entre esses cinco é, sobretudo, alinhar frequência de controle e hardware ao seu setup real — e não correr atrás de quem liderou um ranking no mês passado.
Eu pensaria mais ou menos assim:
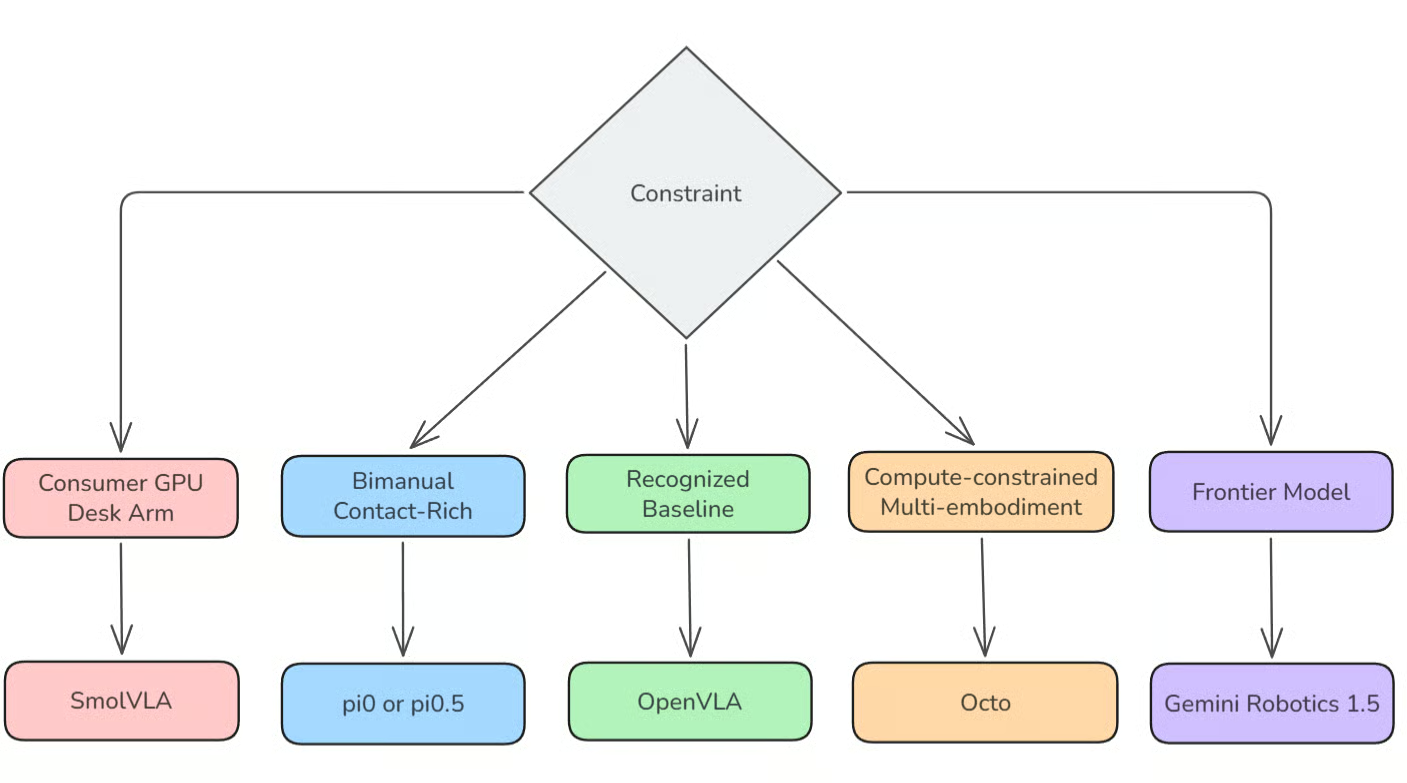
Cinco restrições, cinco modelos. Se for para lembrar um único diagrama deste artigo, que seja este. Imagem do autor.
Se você tem uma GPU de consumo ou um braço SO-101 na mesa, comece com o SmolVLA. Nada mais no ecossistema aberto entrega uma política funcional tão barato.
E um último ponto: cem demonstrações limpas no SmolVLA superam cinquenta bagunçadas no OpenVLA quase sempre.
Ou seja: gaste 60% a 70% do tempo do projeto na coleta e no controle de qualidade dos dados — e o resto no treinamento.
Os VLAs já saíram dos vídeos de demonstração e chegaram a algumas implantações reais — ainda que de forma desigual.
O padrão que vejo é: eles pousam primeiro onde o ambiente varia demais para ser programado por regras, mas ainda há um humano para intervir quando algo sai do trilho. Exemplos:
Este é o terreno principal: tarefas de pick-and-place, kitting, empacotamento, triagem, montagem etc.
São tarefas em que o robô precisa identificar, agarrar e reposicionar objetos cuja posição e orientação mudam entre tentativas — exatamente o tipo de cenário em que sistemas scriptados se saem mal.
Armazéns e fulfillment são hoje o caso comercial mais claro: um picker com script precisa do item sempre apresentado do mesmo jeito; um baseado em VLA trabalha um tote com quarenta SKUs misturados.
Empresas como Figure, 1X e Apptronik estão construindo sobre fundações VLA, e o motivo é simples: um bípede com duas mãos funcionais tem tarefas demais para serem roteirizadas uma a uma.
O resultado de Motion Transfer do Gemini Robotics — uma habilidade treinada no ALOHA 2 que roda direto no humanoide Apollo da Apptronik — é exatamente a propriedade que um programa de humanoide precisa para escalar.
A mesma habilidade, treinada uma vez no ALOHA 2, rodando no humanoide Apollo da Apptronik sem retreino. Fonte: Google DeepMind, “Gemini Robotics 1.5 brings AI agents into the physical world”.
Stacks de direção começam a adotar arquiteturas ao estilo VLA, conectando o que o carro vê ao que deve fazer em seguida dentro de um único loop de raciocínio — em vez de um repasse de percepção para o planejador.
O apelo é o mesmo da manipulação: situações raras, não previstas por regras, tratadas por um modelo que viu o suficiente do mundo para raciocinar — em vez de travar.
Este é o uso mais embrionário da lista.
A ideia: um sistema capaz de seguir a instrução falada de um cirurgião e se ajustar a variações do tecido supera um rigidamente programado; mas a aprovação regulatória é o gargalo aqui, não a capacidade do modelo.
Eu esperaria aplicações assistivas e de treinamento muito antes de algo próximo do autônomo.
Embora poderosos, os VLAs ainda têm fraquezas — especialmente em quatro pontos:
Os VLAs lidam razoavelmente bem com variações no início de uma tarefa, mas quando a pegada escapa no meio do caminho ou o objeto se move sob a garra, a recuperação é inconsistente.
A maioria dos dados de demonstração captura tentativas bem-sucedidas, então o modelo quase não vê exemplos de como se recuperar de erros.
Manipulação fina exige um loop de controle a 10–100 Hz, e fazer um modelo de 7B+ bater essa taxa no hardware do próprio robô ainda é objetivo — não engenharia resolvida.
Por isso, muitos sistemas em produção se conectam a um servidor de borda ou separam raciocínio de controle, como o Gemini Robotics 1.5.
Quantização, layer skipping e distilação ajudam, mas ainda são paliativos em evolução — não respostas definitivas.
Agora que há pesos abertos capazes para qualquer um baixar, os dados viraram o verdadeiro diferencial.
Coletar dados diversos e bem anotados via teleoperação é lento e caro de um jeito que “raspar a web” nunca foi — e o gap entre os resultados publicados do pi0 e o que foi reproduzido só com dados públicos é a melhor evidência do que uma vantagem privada de dados compra.
Os VLAs atuais generalizam bem dentro da distribuição de treino e degradam de forma notável fora dela.
Um modelo treinado em 22 corpos para manipulação em bancada ainda pode ir mal em um formato de tarefa realmente inédito para ele.
Como você viu, os VLAs unem percepção, entendimento de linguagem e geração de ação em uma única arquitetura — uma mudança estrutural, não incremental.
O que eles fazem, e o controle clássico não, é generalizar para condições que ninguém treinou explicitamente — porque os backbones de linguagem e visão já levam ao robô um “modelo de mundo” funcional antes mesmo da primeira demonstração.
O que mais me surpreende em 2026 é como a pergunta difícil mudou.
Três anos atrás, a pergunta difícil era a arquitetura.
Agora que OpenVLA, Octo, pi0 e SmolVLA estão no GitHub para qualquer um baixar, as perguntas difíceis são qualidade dos dados, comportamento de recuperação e se dá para rodar a 50 Hz no robô — e não num data center.
Se quiser continuar, o curso Introduction to AI Agents da DataCamp cobre o contexto agente mais amplo, e Large Language Models (LLMs) Concepts cobre o lado dos backbones.
Top DataCamp Courses
Curso
Curso
Curso
blog
Bhavishya Pandit
8 min
blog
Abid Ali Awan
8 min
blog
Nisha Arya Ahmed
12 min
blog
Stanislav Karzhev
9 min
Tutorial
Josep Ferrer
11 min
Tutorial
Zoumana Keita
8 min