
{count, plural, one {Corso} other {Corsi}}
Deep Learning intermedio con PyTorch
{hours} ore
30.1K
Immagina di dire a qualcuno: “Prendi la tazza e mettila sul ripiano”. Non ha bisogno di uno schema: guarda la tazza, capisce la frase e la sua mano va lì.
Qui succedono quasi in simultanea tre cose diverse. Vedere, capire e muoversi avvengono praticamente insieme per quella persona, non come tre passaggi separati consegnati a parti diverse del cervello.
Per gran parte della storia dell’IA in robotica, le macchine non funzionavano affatto così.
In passato abbiamo avuto modelli vision-language capaci di osservare un banco da lavoro in disordine e descrivere esattamente cosa c’era sopra, inclusi dettagli come la marca di un attrezzo.
I controllori robotici classici potevano afferrare quel cacciavite in modo affidabile, purché nessuno lo spostasse di due centimetri a sinistra. Le due metà del problema, vedere e capire da un lato e agire dall’altro, si sono sviluppate quasi del tutto separatamente.
Qui entrano in gioco i modelli Vision-language-action (VLA): sono un tentativo di colmare quel divario.
In questo articolo vedremo cosa sono i modelli VLA e come funziona la loro architettura a tre parti. Esploreremo in cosa differiscono dai modelli vision-language (VLM) e dal controllo robotico classico, quali modelli contano davvero nel 2026 e dove vengono usati. Infine, vedremo cosa i modelli CLA ancora sbagliano.
Partiamo con una definizione formale di cosa sono i VLA:
Un modello vision-language-action è un sistema di IA che elabora un flusso dalla camera, un’istruzione in linguaggio naturale e lo stato del robot, quindi produce comandi motori, con i moduli di visione, linguaggio e azione addestrati congiuntamente ed eseguiti in un’unica forward pass invece che in una pipeline classica percezione-poi-pianificazione-poi-controllo.
La cosa principale è che percezione, linguaggio e azione non sono sistemi separati cuciti insieme con codice scritto a mano.
Sono sottomoduli addestrati congiuntamente. Quindi un errore di visione o linguaggio che avrebbe fatto deragliare il passaggio di una pipeline classica viene corretto dalla discesa del gradiente invece che rilevato, o mancato, da un’interfaccia hard-coded.
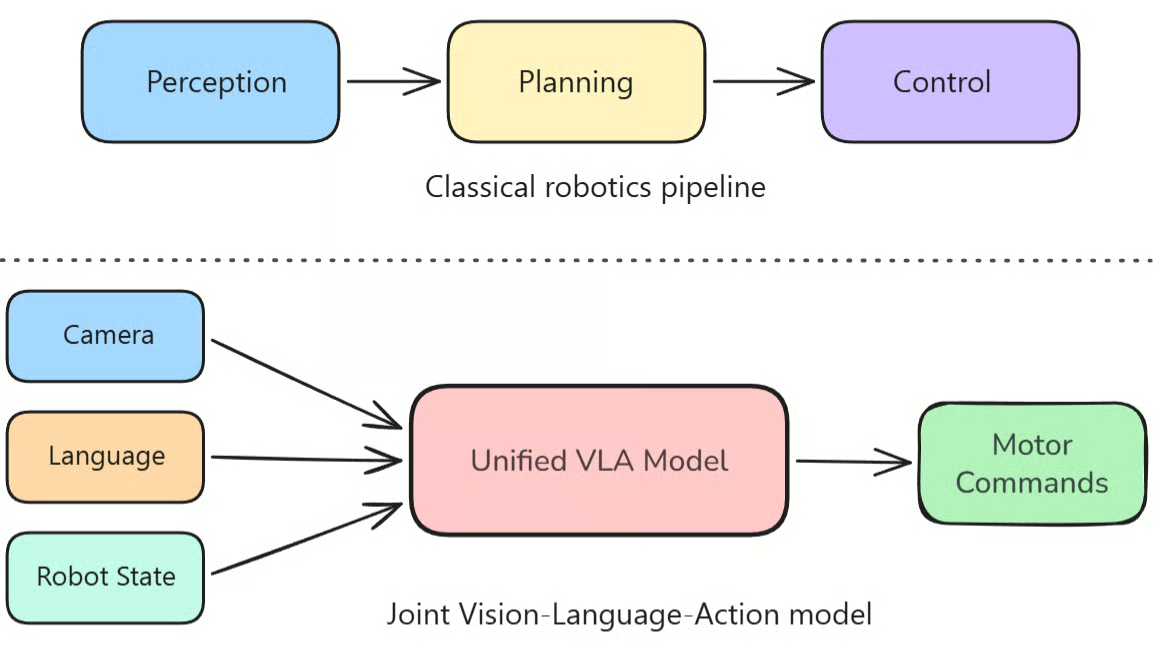
Tre riquadri e due passaggi fragili sopra, un modello fuso sotto. È questa la differenza strutturale di cui continuo a parlare. Immagine dell’autore.
Mi piace sintetizzare così la distinzione: un VLM è un cervello senza corpo, e un VLA glielo dà.
La percezione non è un servizio separato a cui il robot fa chiamate, ma è integrata nella pipeline addestrata congiuntamente che decide di quanto muovere il gripper.
Finora ho menzionato anche i VLM, quindi confrontiamo queste due architetture.
Un VLM (Vision-Language Model) riceve immagini e testo e produce testo o embedding.
Un VLA (Vision-Language-Action Model), invece, prende lo stesso tipo di input e produce un’azione.
Sembra un piccolo cambiamento, finché non vedi cosa comporta a valle:
|
Vision-language model (VLM) |
Vision-language-action model (VLA) |
|
|---|---|---|
|
Input |
Immagini, video, testo |
Immagini (spesso più camere), testo, stato propriocettivo del robot |
|
Output |
Testo, embedding |
Comandi motori continui o discretizzati |
|
Capacità primaria |
Descrivere e ragionare su una scena |
Agire su una scena |
|
Può agire nel mondo? |
No |
Sì |
|
Dati di training |
Coppie immagine-testo raccolte dal web |
Dati web più traiettorie di dimostrazioni robotiche |
|
Applicazione tipica |
Visual question answering, didascalie, parsing di documenti |
Manipolazione, navigazione, controllo di umanoidi |
Potresti aver già sentito parlare di modelli come GPT-4V, Gemini o LLaVA.
Un’idea molto diffusa è che un VLA sia solo uno di quelli con un braccio robotico attaccato.
In realtà non è così semplice.
Il modello deve imparare un intero nuovo spazio di output, in cui un token corrisponde a una quantità fisica reale, come lo spostamento dell’end-effector o l’apertura del gripper, e in cui sbagliare fa cadere una tazza dal tavolo invece di produrre una frase un po’ strana.
Se vuoi vedere come GPT-4V, Gemini e LLaVA si confrontano con il resto del campo, l’articolo di DataCamp Top 10 Vision Language Models in 2026 riassume i leader attuali.
C’è anche una conseguenza lato dati.
Un VLM può addestrarsi su miliardi di coppie immagine-testo perché Internet le fornisce gratuitamente.
Le traiettorie dei robot, invece, devono essere raccolte da un robot reale che svolge un compito reale, di solito in teleoperazione: è proprio per questo che il più grande dataset open di robotica, Open X-Embodiment, si ferma a circa 1 milione di traiettorie invece di 1 miliardo.
La raccolta manuale di tali traiettorie è anche molto costosa e lenta.
22 embodiment, un dataset, e comunque sotto 1 milione di traiettorie totali. Questo è ciò che intendo quando dico che i dati per i robot non scalano come il testo del web. Fonte: pagina del progetto Open X-Embodiment.
Ora, prima di parlare di come funziona l’architettura VLA, voglio esplorarla e confrontarla anche con il controllo robotico classico.
Il controllo robotico classico è costruito per un compito in un luogo, in condizioni che qualcuno ha fissato in anticipo.
Prendi, per esempio, il braccio di un distributore automatico.
Afferra sempre lo stesso snack dallo stesso ripiano nello stesso punto perché l’illuminazione, le posizioni degli oggetti e i movimenti richiesti non cambiano tra un prelievo e l’altro.
Questa configurazione ristretta e immutabile è esattamente ciò che permette al sistema di controllo di essere rigido e affidabile.
Ma ora cambiamo la configurazione interna del distributore, oppure l’illuminazione, o inseriamo un elemento nella scena che non era mai stato previsto.
A questo punto il controllore fallirà completamente perché non ha mai visto l’ambiente in quel modo.
Un VLA generalizza meglio a condizioni su cui non è stato esplicitamente addestrato, e il motivo è che il backbone VLM sottostante sa già come è fatto un mug, un asciugamano o un cassetto grazie al pretraining su scala web, prima ancora di vedere una dimostrazione robotica.
Affinarlo su un centinaio di esempi di piegatura di asciugamani gli permette di imparare come muoversi dato un oggetto che già riconosce.
È proprio quel trasferimento il vero passo avanti, non la precisione pura, e vorrei sottolineare che un controllore classico ben tarato può ancora battere un VLA in precisione in un contesto fisso e controllato.
Addentriamoci nell’architettura.
Per questo articolo ho scelto l’architettura di OpenVLA perché è facile da capire.
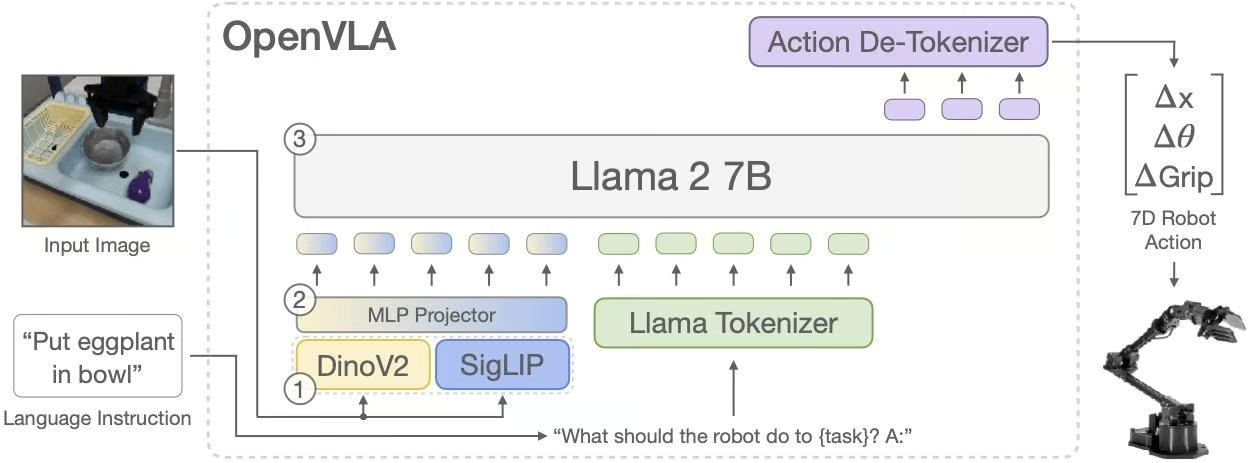
Questa è la pipeline che descrivo sotto: DINOv2 e SigLIP che alimentano un backbone Llama 2, con il decoder di azione che predice token discretizzati all’estremità opposta. Fonte: pagina del progetto OpenVLA.
Un VLA ha tre moduli separati:
Questi vengono addestrati end-to-end insieme.
Le rappresentazioni di visione e linguaggio vengono fuse, e questa rappresentazione combinata è ciò che il decoder di azione trasforma in comandi motori.
Importante, le tre parti sono strettamente accoppiate e non in pipeline, e questa è la scelta progettuale che separa un VLA da un VLM imbullonato a un controllore.
Se aiuta, pensalo come ho descritto la divisione tra visione, memoria e controller nel paper originale sui World Models: vede, capisce, agisce.
La differenza qui è che un VLA impara tutti e tre i compiti insieme, end-to-end, a partire da dimostrazioni, invece di addestrare ogni pezzo separatamente e poi cucirli insieme dopo.
Esploriamoli ora uno per uno.
L’encoder di visione trasforma un frame grezzo della camera in una rappresentazione densa che il resto della rete può davvero usare.
I VLA moderni usano vision transformer preaddestrati come DINOv2 o SigLIP, e molto spesso entrambi insieme.
OpenVLA è un buon esempio di uso di entrambi.
Fonde DINOv2, forte sul dettaglio spaziale e geometrico, con SigLIP, più forte sulle caratteristiche semantiche che si allineano bene con il linguaggio.
I due set di feature vengono concatenati per patch d’immagine e proiettati nello spazio di embedding del modello linguistico (in questo caso LLama 2 7B).
Vale la pena ricordare che usare più di una camera è lo standard nelle implementazioni reali.
Per esempio, una camera da polso dà dettaglio a corto raggio durante l’avvicinamento finale a un oggetto, una camera dall’alto fornisce il layout della scena e una vista laterale aiuta con la profondità che una singola camera non può ricostruire da sola.
pi0 (di cui sotto) prende viste da più camere più lo stato propriocettivo del robot.
Nota che l’input di stato conta più di quanto sembri: una foto di un braccio non ti dice quale coppia è attualmente nei giunti.
Il lato linguistico codifica un’istruzione, qualcosa come “raccogli il blocco rosso e mettilo nel cestino blu”, in una rappresentazione che si allinea con le feature visive nello stesso spazio.
Quasi ogni VLA riusa un large language model (LLM) preaddestrato invece di addestrare da zero un encoder testuale.
Nel nostro caso, OpenVLA usa Llama 2 7B. pi0 e pi0.5 si basano su PaliGemma, un VLM da 3 miliardi di parametri. SmolVLA usa uno stack SmolVLM2 modificato.
Riutilizzare un LLM in questo modo è questione di eredità.
Ottieni il follow-the-instructions e la comprensione composizionale, motivo per cui un VLA spesso sa gestire “metti la frutta nella ciotola” anche se non ha mai visto quella frase esatta durante l’addestramento robotico.
Il decoder di azione è dove la rappresentazione fusa diventa effettivamente un comando motorio, ed è anche il punto in cui i design VLA divergono di più tra loro. Al momento si usano tre approcci generali.
Si suddivide ogni dimensione dell’azione in bin discreti e li si predice uno dopo l’altro, con lo stesso setup di next-token che un LLM sa già addestrare.
OpenVLA usa 256 bin per dimensione e una normale loss di next-token, così puoi mantenere la consueta strumentazione da LLM.
Quello che perdi è risoluzione e velocità, perché il binning lascia un movimento seghettato e il campionamento token per token è troppo lento per tutto ciò che è rapido o ricco di contatto.
Invece di predire un token alla volta, il modello tratta la generazione di azioni come un processo di denoising e produce in una volta un intero blocco di azioni continue.
pi0 è stato il primo VLA costruito attorno a una testa di azione con flow matching, dove eseguono il denoising in circa 10 step per produrre un blocco fino a 50 azioni future.
Questo ha reso il movimento risultante visibilmente più fluido rispetto a qualsiasi approccio basato su token.
Un modello più grande gestisce il ragionamento di alto livello e suddivide il compito in step, mentre un controllore più piccolo e veloce gestisce l’esecuzione precisa e ad alta frequenza.
Un ottimo esempio è Gemini Robotics 1.5, dove hanno affiancato un modello di ragionamento a un modello di azione.
Secondo me, però, dopo aver letto diversi paper, le persone dedicano molta più energia a discutere della dimensione del backbone che della testa di azione, e credo che sia il contrario di ciò che servirebbe.
Se il tuo decoder schiaccia un’azione continua a 7 dimensioni in 256 bin discreti, nessuna qualità del backbone potrà ridarti quella fluidità!
Ora presento una tabella con alcuni modelli VLA davvero importanti che è probabile tu incontri:
|
Modello |
Sviluppatore |
Parametri |
Testa d’azione |
Licenza |
Hardware |
Ideale per |
|---|---|---|---|---|---|---|
|
OpenVLA |
Stanford, Berkeley e collaboratori |
7B |
Token autoregressivi |
MIT |
A100 o H100, o 24GB con quantizzazione a 4 bit |
Baseline per ricerca open |
|
Octo |
UC Berkeley |
27M o 93M |
Diffusion policy |
MIT |
Singola RTX 4090 |
Lavori con compute limitato |
|
pi0 / pi0.5 / pi0.6 |
Physical Intelligence |
3,3B (backbone 3B più 300M action expert) |
Flow matching |
Checkpoint open (openpi) |
Multi-GPU o una singola A100 |
Compiti destrorsi e di lungo orizzonte |
|
Gemini Robotics 1.5 |
Google DeepMind |
Non divulgati |
Ibrida, cloud più edge |
Closed |
Cloud-tethered |
Baseline proprietaria di frontiera |
|
SmolVLA |
Hugging Face |
450M |
Flow matching |
Apache 2.0 |
RTX 3060, GPU laptop o Jetson |
Robotica hobbistica ed edge |
Ora percorriamoli uno per uno qui sotto, partendo dal baseline di ricerca con cui la maggior parte ancora si confronta.
OpenVLA è un modello da 7 miliardi di parametri addestrato su 970.000 dimostrazioni robotiche nel mondo reale estratte da Open X-Embodiment.
Combina un backbone Llama 2 7B con l’encoder di visione fuso DINOv2 e SigLIP, descritto in precedenza, e l’intero modello è open source.
Il risultato sorprendente è stato che ha battuto il modello chiuso RT-2-X di 16,5 punti percentuali di successo sui task su 29 compiti, mentre RT-2-X girava con 55 miliardi di parametri contro i 7 miliardi di OpenVLA!
L’addestramento totale ha richiesto 64 GPU A100 per 15 giorni.
Resta popolare perché il fine-tuning con LoRA e la quantizzazione a 4 bit funzionano entrambe molto bene.
Questo significa che una RTX 4090 da 24GB può eseguire una versione quantizzata e la maggior parte dei lavori pubblicati su attacchi, difese e pruning dei VLA usa OpenVLA come target semplicemente perché è così accessibile.
Un seguito - OpenVLA-OFT ha migliorato la ricetta di fine-tuning sia in velocità che in tasso di successo.
Octo è un VLA piccolo, e arriva in due taglie - 27 milioni e 93 milioni di parametri su backbone ViT-S e ViT-B, rispettivamente, e può girare su una singola RTX 4090 a 20–30 Hz.
È stato addestrato su circa 800.000 traiettorie da Open X-Embodiment su 22 embodiment robotici, e la sua architettura transformer è davvero modulare.
Puoi aggiungere un nuovo input di osservazione o sostituire la testa di azione durante il fine-tuning senza ricostruire il modello da zero, e supporta token discreti e azioni continue basate su diffusion a seconda di ciò che serve.
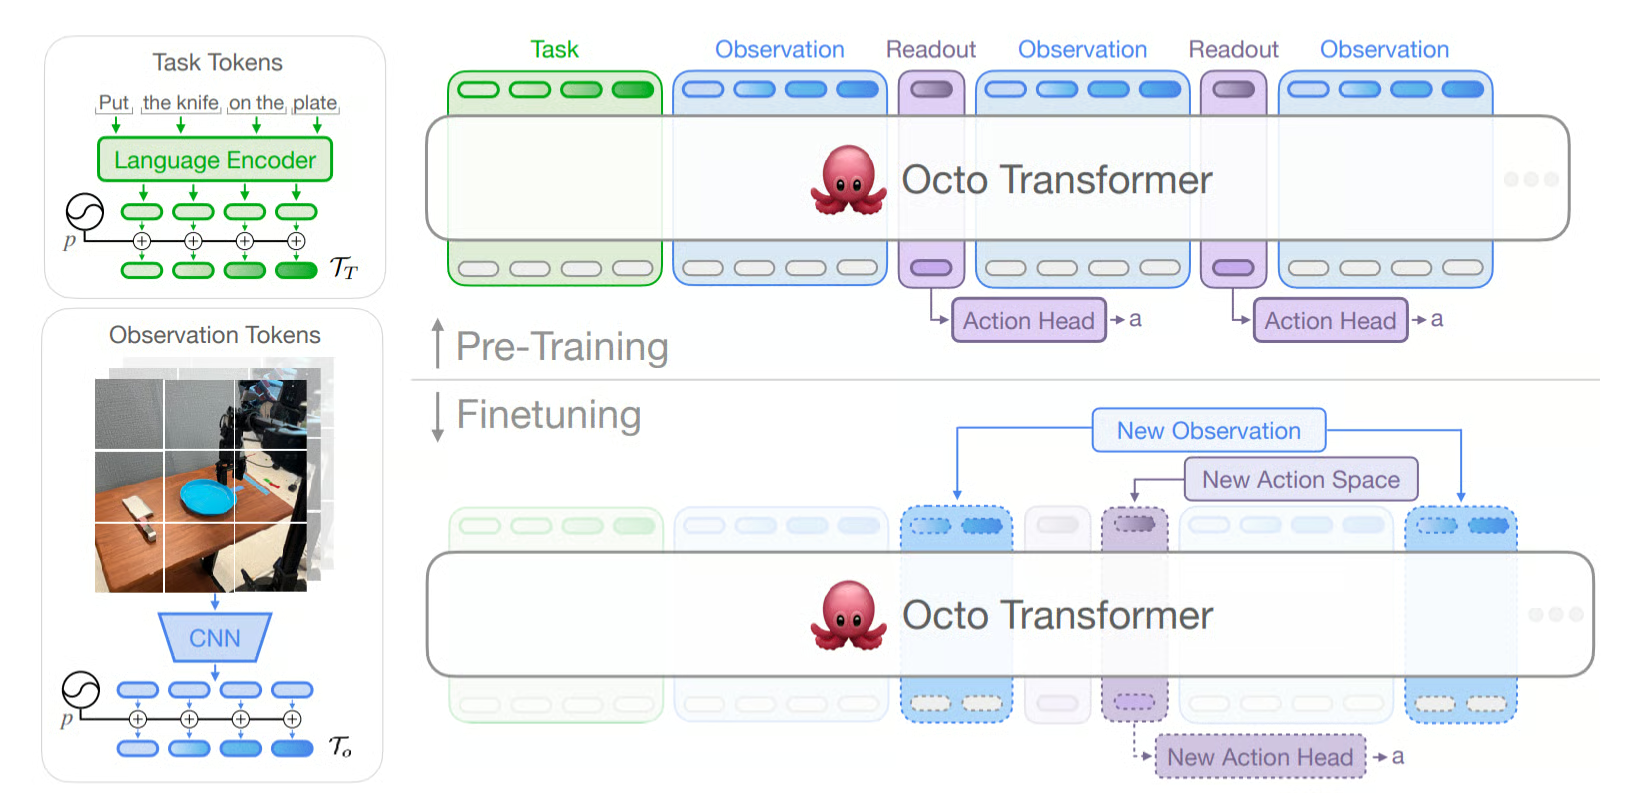
Il transformer di Octo: task e observation token in ingresso, readout token in uscita verso la testa d’azione, con spazio per aggiungere nuovi sensori o spazi d’azione in fase di fine-tuning. Fonte: paper Octo.
Personalmente uso Octo quando il fattore limitante è il compute più che la difficoltà del compito.
Supporta anche il conditioning con immagine-obiettivo, opzione utile quando descrivere a parole lo stato target è più scomodo che mostrare una foto di ciò che vuoi.
pi0 di Physical Intelligence è davvero bravo nella destrezza. Parte da PaliGemma, un VLM open da 3 miliardi di parametri, e aggiunge un action expert da 300 milioni di parametri addestrato da zero, per un totale di 3,3 miliardi di parametri.
Usa il flow matching per produrre in una volta un blocco fino a 50 azioni future invece di un passo alla volta.
Il risultato chiave sono stati i compiti bimanuali come piegare il bucato, imballare la spesa e assemblare scatole, gestiti con un livello di destrezza inedito fino ad allora.
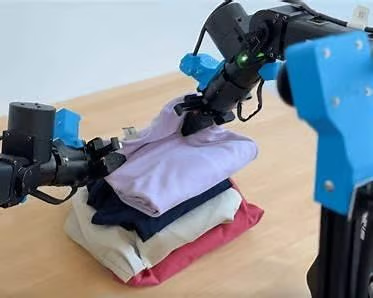
Il robot pi0 che piega il bucato con due braccia. Questo è uno dei compiti bimanuali menzionati; vale la pena guardarlo più che solo leggerne. Fonte: Physical Intelligence, “pi0: Our First Generalist Policy”.
Qui il flow matching fa il vero lavoro, perché coordinare due braccia insieme richiede un output fluido e continuo a 16 dimensioni, e né token discreti né sampling diffusion lento possono darcelo a una velocità utilizzabile.
La famiglia pi0 ha continuato a evolversi:
Una caveat che voglio evidenziare è che i risultati più forti di pi0 dipendono da dati proprietari raccolti sulla loro flotta di robot.
Nessuno al di fuori dell’azienda ha riprodotto esattamente quei numeri usando solo dati pubblici, quindi quanto della performance derivi dall’architettura rispetto al vantaggio sui dati è ancora davvero aperto.
Gemini Robotics 1.5 di Google DeepMind va inteso come due modelli che lavorano insieme più che come uno solo.
Gemini Robotics-ER 1.5 è un modello di ragionamento incarnato che pianifica, chiama strumenti come Google Search e può stimare i propri progressi su un compito.
Gemini Robotics 1.5 è il VLA che esegue ciò che decide il modello di ragionamento.
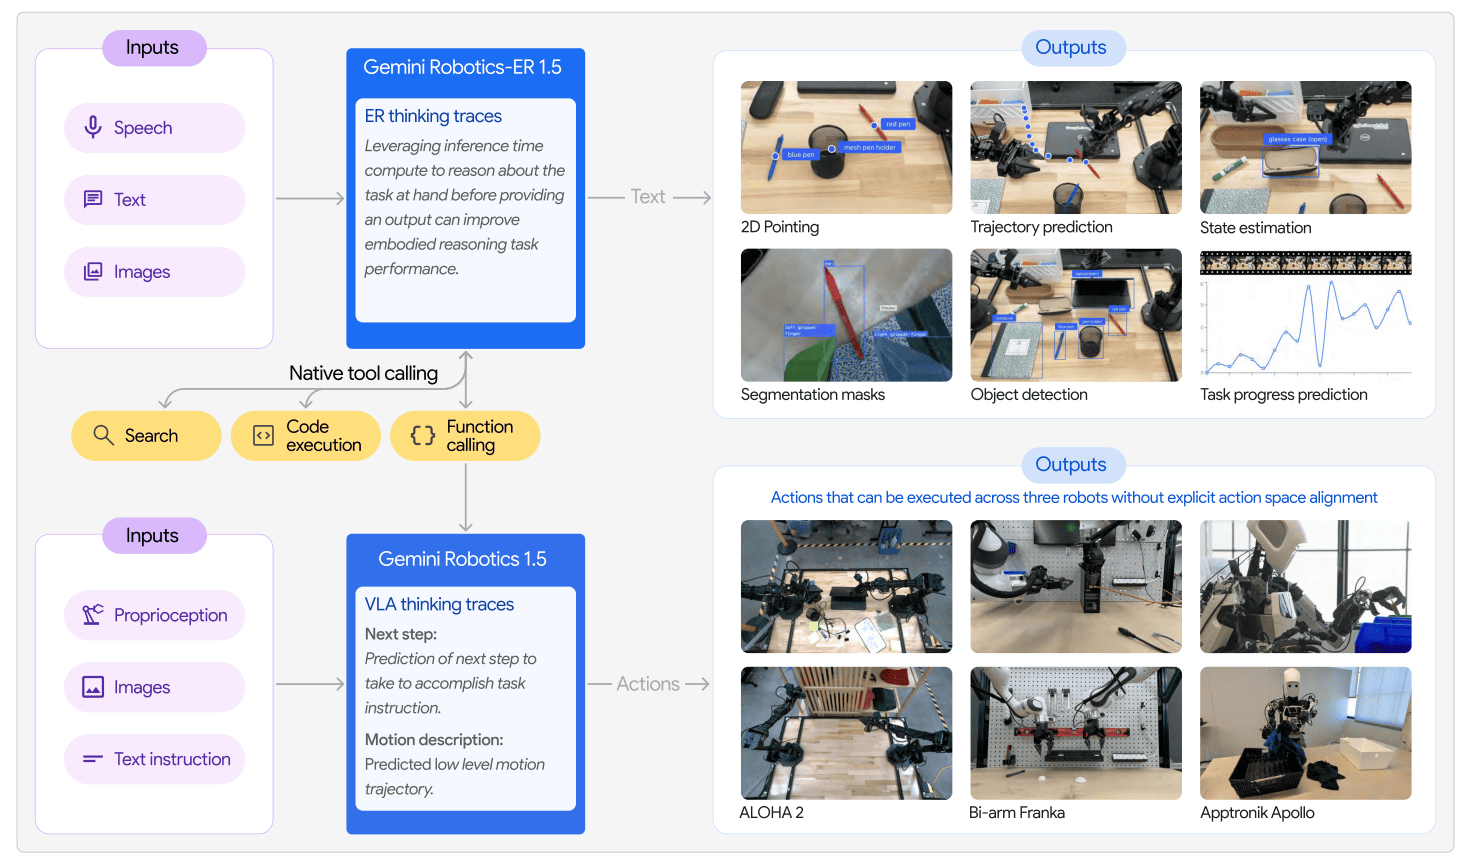
Gemini Robotics-ER 1.5 sopra per il ragionamento incarnato, Gemini Robotics 1.5 sotto come VLA, tool calling condiviso al centro e azioni in esecuzione su ALOHA 2, Franka e Apollo senza allineamento dell’action space. Fonte: paper Gemini Robotics 1.5.
La parte utile è che mescola le azioni con un processo di ragionamento interno scritto in linguaggio naturale, quindi il robot pensa prima di agire e può spiegare in seguito cosa ha deciso.
Dato un comando come “ordina il bucato per colore”, prima stabilisce che i bianchi vanno in un contenitore e il resto in un altro, poi pianifica le singole prese.
DeepMind riporta circa 250 millisecondi dall’osservazione all’azione, una frequenza di controllo effettiva di 50 Hz, ottenuta mettendo il ragionamento pesante nel cloud e mantenendo un decoder di azione leggero in locale sul robot.
L’altro risultato che voglio citare è il Motion Transfer, ossia un compito appreso sulla piattaforma bi-braccio ALOHA 2 trasferito direttamente a un setup bi-braccio Franka e all’umanoide Apollo di Apptronik, senza riaddestramento su nessuno dei due.
I pesi sono chiusi, quindi direi di considerarlo la baseline proprietaria di frontiera più che qualcosa che puoi scaricare e fine-tunare da solo.
SmolVLA di Hugging Face ha 450 milioni di parametri (licenza Apache 2.0). Abbina un backbone SmolVLM2 modificato a un action expert con flow matching, usando layer skipping e un numero ridotto di token visivi per mantenere l’inferenza economica su hardware piccolo.
Gira su una singola GPU consumer, inclusa una RTX 3060, sulla CPU di un MacBook (anche se lentamente), e si distribuisce su Jetson Orin per inferenza a bordo.
Il fine-tuning per 20.000 step richiede circa 4–5 ore su una singola GPU A100.
Nonostante l’addestramento su meno di 30.000 episodi, eguaglia o supera modelli considerevolmente più grandi su LIBERO, Meta-World e su bracci reali SO-100 e SO-101.
La parte migliore è che l’intero modello è preaddestrato su dataset contribuiti dalla community tramite il framework LeRobot.
Ora che ho presentato alcuni modelli VLA, parliamo di quale scegliere per il tuo progetto specifico.
La scelta tra questi cinque riguarda soprattutto l’allineamento tra frequenza di controllo e hardware e il tuo setup reale, non inseguire chi era in cima alla leaderboard il mese scorso.
Ecco, a grandi linee, come ci penserei:
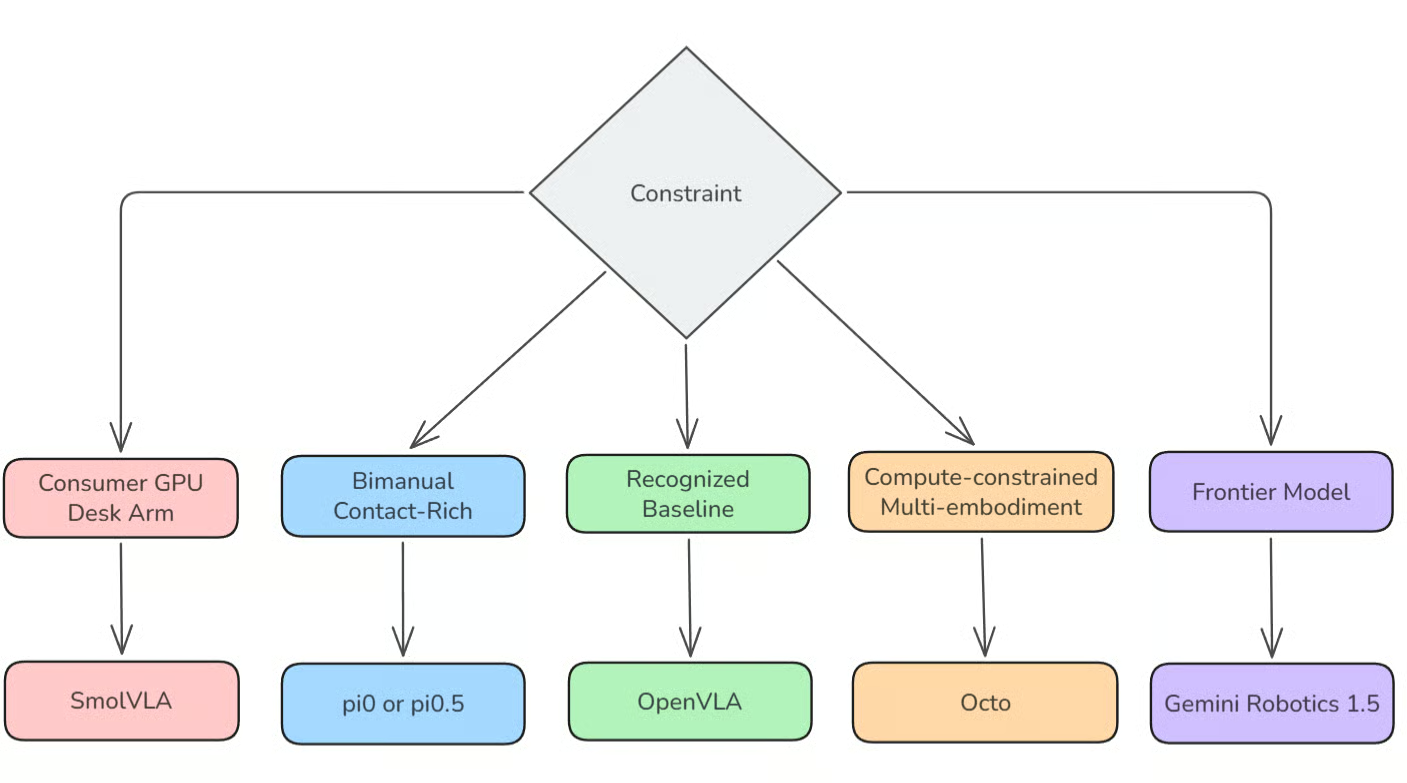
Cinque vincoli, cinque modelli. Se devi ricordare un solo diagramma di questo articolo, che sia questo. Immagine dell’autore.
Se hai una GPU consumer o un braccio SO-101 sulla scrivania, parti da SmolVLA. Niente altro nell’ecosistema open ti dà una policy funzionante a un costo così basso.
E l’ultimo punto importante che voglio fare è che cento dimostrazioni pulite su SmolVLA batteranno quasi sempre cinquanta dimostrazioni caotiche su OpenVLA.
Per questo, dedica il 60–70% del tempo del progetto alla raccolta e al controllo qualità dei dati, e il resto all’addestramento.
I VLA sono usciti dai video dimostrativi ed entrati in alcune implementazioni reali, anche se in modo disomogeneo.
Il pattern che noto è che arrivano prima dove l’ambiente ha troppa variabilità per essere scriptato, ma un umano può comunque intervenire quando qualcosa va storto. Ecco alcuni esempi:
Questo è il terreno principale, con compiti come pick-and-place, kitting, imballaggio, smistamento, assemblaggio, ecc.
Sono compiti in cui il robot deve identificare, afferrare e riposizionare oggetti la cui posizione e orientazione cambiano tra i tentativi, che è proprio la condizione che i sistemi scriptati gestiscono male.
Il lavoro di magazzino ed evasione ordini è il caso commerciale più chiaro adesso. Uno picker scriptato ha bisogno che l’articolo sia presentato sempre allo stesso modo, mentre uno basato su VLA può lavorare su una cassa con quaranta SKU diversi mescolati insieme.
Aziende come Figure, 1X e Apptronik costruiscono su fondamenta VLA, e il motivo è semplice: un robot bipede con due mani funzionanti ha troppi compiti possibili per essere scriptati uno a uno.
Il risultato di Motion Transfer di Gemini Robotics, dove una skill addestrata su ALOHA 2 è stata trasferita direttamente sull’umanoide Apollo di Apptronik, è esattamente la proprietà che serve a un programma su umanoidi se vuole scalare.
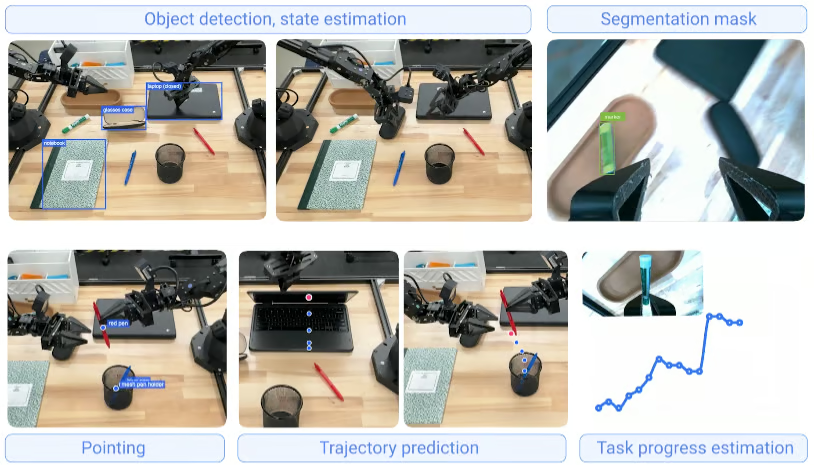
La stessa skill, addestrata una volta su ALOHA 2, eseguita sull’umanoide Apollo di Apptronik senza riaddestramento. Fonte: Google DeepMind, “Gemini Robotics 1.5 porta gli agenti di IA nel mondo fisico”.
Gli stack di guida stanno iniziando ad adottare architetture in stile VLA per collegare ciò che l’auto vede a ciò che dovrebbe fare dopo, all’interno di un unico loop di ragionamento invece di un passaggio percezione→planner.
L’attrattiva è la stessa che nella manipolazione: situazioni rare che nessuna regola aveva previsto, gestite da un modello che ha visto abbastanza del mondo da ragionarci sopra invece di bloccarsi.
Vale la pena dire che questa è l’applicazione più agli inizi in elenco.
L’idea è che un sistema capace di seguire le istruzioni vocali di un chirurgo e adattarsi a condizioni tissutali variabili batta uno rigidamente programmato, ma l’approvazione regolatoria è il vincolo principale qui, non la capacità del modello.
Mi aspetterei applicazioni di assistenza e formazione molto prima di qualcosa di vicino all’autonomo.
Per quanto i VLA siano ottimi, hanno ancora punti deboli, in particolare in quattro aree specifiche:
I VLA gestiscono piuttosto bene la variabilità all’inizio di un compito, ma quando una presa scivola a metà o un oggetto si sposta sotto il gripper, il recupero è incostante.
La maggior parte dei dati di dimostrazione cattura i tentativi riusciti, quindi il modello ha visto pochissimi esempi di come si recupera da un errore.
La manipolazione fine ha bisogno di un loop di controllo a 10–100 Hz, e portare un modello da 7 miliardi di parametri o più a quel rate sull’hardware del robot è ancora un’aspirazione più che un problema ingegneristico risolto.
Per questo la maggior parte dei sistemi in produzione è agganciata a un server edge o separa ragionamento e controllo, come fa Gemini Robotics 1.5.
Quantizzazione, layer skipping e distillazione aiutano, ma sono workaround ancora in evoluzione, non soluzioni definitive.
Ora che esistono pesi open capaci scaricabili da chiunque, i dati sono diventati il vero fattore differenziante.
Raccogliere dati di teleoperazione vari e ben annotati è lento e costoso in un modo che il web scraping non è mai stato, e il divario tra i risultati pubblicati di pi0 e ciò che è stato riprodotto da chiunque solo con dati pubblici è l’evidenza più chiara di cosa compri un vantaggio di dati privati.
I VLA attuali generalizzano bene all’interno della loro distribuzione di training e degradano in modo evidente al di fuori.
Un modello addestrato su 22 embodiment per la manipolazione da tavolo può comunque andare male su una forma di compito che non ha davvero mai visto.
Come vedi, i modelli VLA uniscono percezione, comprensione del linguaggio e generazione dell’azione in un’unica architettura, e questo è un cambiamento strutturale, non incrementale.
Quello che sanno fare e che il controllo classico non ha mai gestito è generalizzare a condizioni per cui nessuno li ha addestrati esplicitamente, perché i backbone di linguaggio e visione portano già nel robot un modello funzionante del mondo fisico prima ancora di vedere una dimostrazione.
La cosa che mi sorprende di più di dove siamo nel 2026 è quanto la domanda difficile sia cambiata.
Tre anni fa, la domanda difficile era l’architettura.
Ora che OpenVLA, Octo, pi0 e SmolVLA sono tutti su GitHub, le domande difficili sono la qualità dei dati, il comportamento di recupero e se puoi davvero far girare tutto questo a 50 Hz sul robot stesso invece che in un data center.
Se vuoi proseguire, il corso di DataCamp Introduzione agli agenti di IA copre il contesto agentico più ampio, e Large Language Models (LLMs) Concepts copre il lato dei backbone.
I migliori corsi DataCamp
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
15 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min
{count, plural, one {blog} other {blogs}}
Tim Lu
12 min



