
Last chance! 50% off DataCamp Premium
Sale ends in
कल्पना कीजिए, आप किसी से कहते हैं, “मग उठाइए और उसे शेल्फ पर रख दीजिए।” उन्हें किसी आरेख की ज़रूरत नहीं पड़ती; वे मग को देखते हैं, वाक्य समझते हैं, और उनका हाथ वहीं चला जाता है।
यहां लगभग एक ही समय पर तीन चीज़ें हुईं। देखने, समझने और चलने की क्रिया उस व्यक्ति के लिए लगभग साथ-साथ होती है—ऐसा नहीं कि मस्तिष्क के अलग-अलग हिस्सों के बीच तीन अलग-अलग चरणों का आदान-प्रदान हो रहा हो।
रोबोटिक AI के ज़्यादातर इतिहास में, मशीनें ऐसा बिल्कुल नहीं करती थीं।
पहले हमारे पास विज़न-लैंग्वेज मॉडल रहे हैं जो किसी बिखरे हुए वर्कबेंच को देखकर उस पर रखी चीज़ों को बारीकियों सहित—किसी औज़ार के ब्रांड नाम तक—ठीक-ठीक बता सकते थे।
क्लासिकल रोबोट कंट्रोलर उस स्क्रूड्राइवर को भरोसेमंद तरीके से उठा सकते थे—बशर्ते किसी ने उसे दो सेंटीमीटर बाईं ओर न खिसकाया हो। समस्या के ये दो हिस्से—एक तरफ देखना और समझना, दूसरी तरफ क्रिया करना—लगभग पूरी तरह अलग-अलग विकसित हुए।
यहीं पर विज़न-लैंग्वेज-एक्शन (VLA) मॉडल आते हैं—ये उसी अंतर को पाटने की कोशिश हैं।
इस लेख में, हम देखेंगे कि VLA मॉडल क्या हैं और उनकी त्रि-भागीय संरचना कैसे काम करती है। हम यह भी समझेंगे कि वे विज़न-लैंग्वेज मॉडल (VLMs) और क्लासिकल रोबोट कंट्रोल से कैसे अलग हैं, 2026 में कौन-से मॉडल वाकई मायने रखते हैं और उनका उपयोग कहाँ होता है। अंत में, हम देखेंगे कि CLA मोड अब भी कहाँ चूकते हैं।
आइए, पहले औपचारिक रूप से VLA मॉडल की परिभाषा समझते हैं:
विज़न-लैंग्वेज-एक्शन मॉडल एक ऐसा AI तंत्र है जो कैमरा फ़ीड, प्राकृतिक भाषा में निर्देश, और रोबोट की अपनी स्थिति को प्रोसेस करता है, और फिर मोटर कमांड देता है—जहाँ विज़न, भाषा, और एक्शन मॉड्यूल संयुक्त रूप से प्रशिक्षित होते हैं और क्लासिकल धारणा→योजना→नियंत्रण पाइपलाइन के बजाय एक ही फ़ॉरवर्ड पास में चलते हैं।
मुख्य बात यह है कि परसेप्शन, भाषा और एक्शन, हाथ से लिखे ग्लू कोड से जोड़े गए अलग-अलग सिस्टम नहीं हैं।
ये उप-मॉड्यूल संयुक्त रूप से प्रशिक्षित होते हैं। इसलिए, वह विज़न या भाषा त्रुटि जो क्लासिकल पाइपलाइन के हैंडऑफ़ को पटरी से उतार देती, वह अब हार्ड-कोडेड इंटरफ़ेस पर पकड़ी जाने (या छूट जाने) के बजाय ग्रेडिएंट डिसेंट से सुधर जाती है।
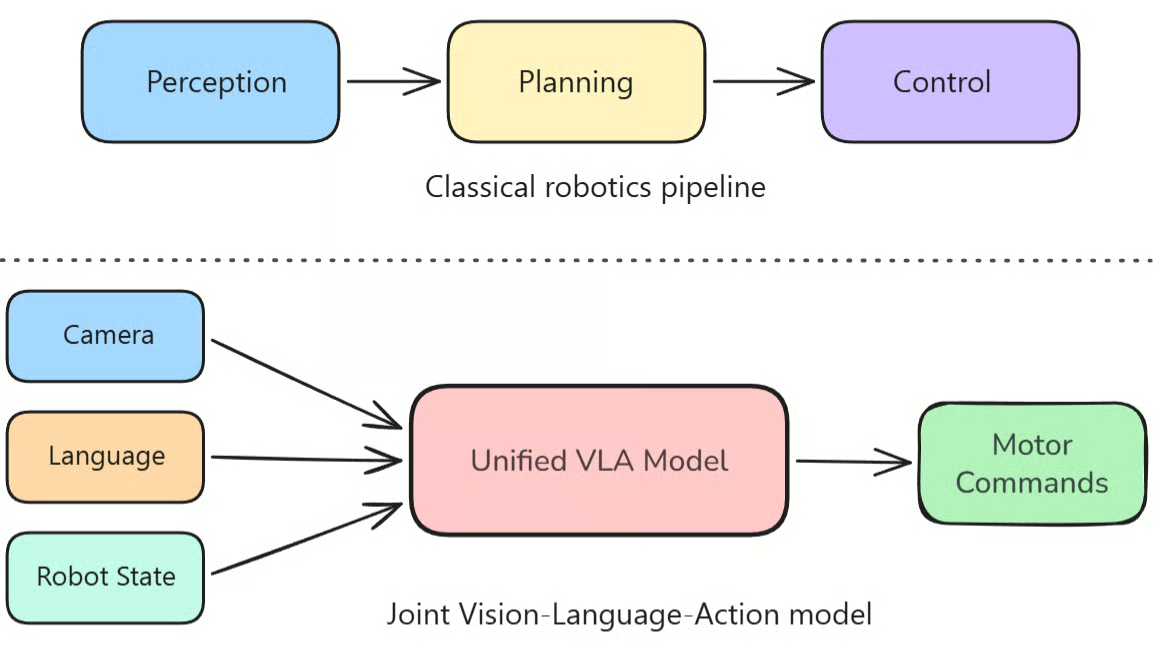
ऊपर तीन बॉक्स और दो नाज़ुक हैंडऑफ़, नीचे एक फ्यूज़्ड मॉडल। यही वह वास्तविक संरचनात्मक अंतर है जिसकी मैं बात करता रहता हूँ। चित्र: लेखक द्वारा।
मैं इसे यूँ कहता हूँ: VLM एक ऐसा मस्तिष्क है जिसका शरीर नहीं, और VLA उसे शरीर दे देता है।
परसेप्शन कोई अलग सेवा नहीं है जिसे रोबोट कॉल करता हो, बल्कि यह उसी संयुक्त रूप से प्रशिक्षित पाइपलाइन में जुड़ा होता है जो तय करती है कि ग्रिपर को कितनी दूर बढ़ना है।
अब तक मैंने VLM का भी ज़िक्र किया है, तो आइए इन 2 आर्किटेक्चर की तुलना करते हैं।
VLM (Vision-Language Model) छवियाँ और पाठ लेता है और पाठ या एम्बेडिंग्स आउटपुट करता है।
वहीं, VLA (Vision-Language-Action Model) वही इनपुट लेकर उसकी जगह कोई क्रिया उत्पन्न करता है।
यह बदलाव छोटा लगता है, जब तक आप नहीं देखते कि डाउनस्ट्रीम इसके क्या मायने हैं:
|
विज़न-लैंग्वेज मॉडल (VLM) |
विज़न-लैंग्वेज-एक्शन मॉडल (VLA) |
|
|---|---|---|
|
इनपुट |
छवियाँ, वीडियो, पाठ |
छवियाँ (अक्सर कई कैमरों से), पाठ, रोबोट की प्रोप्रीओसेप्टिव अवस्था |
|
आउटपुट |
पाठ, एम्बेडिंग्स |
सतत या डिस्क्रीट मोटर कमांड |
|
मुख्य क्षमता |
किसी दृश्य का वर्णन और तर्क करना |
दृश्य पर क्रिया करना |
|
क्या यह वास्तविक दुनिया में क्रिया कर सकता है? |
नहीं |
हाँ |
|
प्रशिक्षण डेटा |
वेब से स्क्रैप किए गए इमेज-टेक्स्ट जोड़े |
वेब डेटा के साथ रोबोट डेमो ट्राजेक्टरीज़ |
|
टिपिकल एप्लीकेशन |
विज़ुअल प्रश्नोत्तर, कैप्शनिंग, डॉक्यूमेंट पार्सिंग |
मैनीपुलेशन, नेविगेशन, ह्यूमनॉइड कंट्रोल |
हो सकता है आपने GPT-4V, Gemini या LLaVA के बारे में सुना हो।
एक आम धारणा यह है कि VLA बस इन्हीं में से किसी मॉडल के साथ एक रोबोट आर्म जोड़ देने जैसा है।
लेकिन बात इतनी सीधी नहीं है।
मॉडल को एक बिल्कुल नए आउटपुट स्पेस को सीखना पड़ता है—जहाँ कोई टोकन किसी वास्तविक भौतिक मात्रा से मेल खाता हो, जैसे एंड-इफ़ेक्टर का विस्थापन या ग्रिपर की चौड़ाई—और जहाँ गलती होने पर परिणाम एक अटपटा वाक्य नहीं, बल्कि कप का मेज़ से गिरना हो सकता है।
यदि आप देखना चाहते हैं कि GPT-4V, Gemini और LLaVA बाकी क्षेत्र के मुकाबले कैसे हैं, तो DataCamp का Top 10 Vision Language Models in 2026 मौजूदा लीडर्स का संक्षेप देता है।
डेटा पक्ष पर भी असर पड़ता है।
VLM अरबों इमेज-टेक्स्ट जोड़ों पर ट्रेन हो सकते हैं क्योंकि इंटरनेट वे मुफ्त में उपलब्ध कराता है।
लेकिन रोबोट ट्राजेक्टरीज़ तो किसी वास्तविक रोबोट द्वारा वास्तविक कार्य करते हुए—अकसर टेलिऑपरेशन के तहत—इकट्ठी करनी पड़ती हैं, यही कारण है कि सबसे बड़ा ओपन रोबोटिक्स डेटासेट Open X-Embodiment, 1 अरब नहीं बल्कि लगभग 10 लाख ट्राजेक्टरीज़ पर रुक जाता है।
ऐसी ट्राजेक्टरीज़ को मैन्युअल रूप से इकट्ठा करना भी बहुत महँगा और धीमा है।
22 एम्बॉडिमेंट, एक डेटासेट, और कुल मिलाकर अब भी 10 लाख से कम ट्राजेक्टरीज़। मेरा मतलब यही है जब मैं कहता हूँ कि रोबोट डेटा वेब टेक्स्ट की तरह स्केल नहीं करता। स्रोत: Open X-Embodiment प्रोजेक्ट पेज।
अब, VLA आर्किटेक्चर कैसे काम करता है उस पर बात करने से पहले, मैं इसे क्लासिकल रोबोट कंट्रोल से भी तुलना करना चाहता हूँ।
क्लासिकल रोबोट कंट्रोल एक कार्य के लिए, एक जगह के लिए, पहले से तय की गई शर्तों में बनाया जाता है।
उदाहरण के लिए वेंडिंग मशीन का हाथ ले लीजिए।
वह हर बार उसी शेल्फ से, उसी स्थान से, वही स्नैक उठाता है क्योंकि रोशनी, वस्तुओं की स्थिति और आवश्यक गतियाँ पिक के बीच बदलती नहीं हैं।
यही संकीर्ण, अपरिवर्तित सेटअप कंट्रोल सिस्टम को कठोर और भरोसेमंद रहने देता है।
पर अब वेंडिंग मशीन की आंतरिक कॉन्फ़िगरेशन बदल दें, या रोशनी बदल दें, या दृश्य में कोई ऐसा आइटम डाल दें जो योजना का हिस्सा ही न था।
अब कंट्रोलर पूरी तरह विफल हो जाएगा क्योंकि उसने ऐसा पर्यावरण कभी देखा ही नहीं है।
VLA उन परिस्थितियों में बेहतर सामान्यीकरण करता है जिन पर उसे स्पष्ट रूप से प्रशिक्षित नहीं किया गया, और इसका कारण यह है कि आधारभूत VLM बैकबोन ने रोबोट डेमोंस्ट्रेशन देखने से पहले ही वेब-स्केल प्रीट्रेनिंग से मग, तौलिया या दराज़ जैसी चीज़ों का दृश्य रूप सीख रखा होता है।
इसे तौलिये मोड़ने के सौ उदाहरणों पर फ़ाइन-ट्यून करना, पहले से पहचानी गई चीज़ के हिसाब से चलना सिखा देता है।
यह ट्रांसफ़र ही असली सफलता है, न कि कच्ची प्रिसिशन, और मैं जोड़ना चाहूँगा कि एक अच्छे से ट्यून किया हुआ क्लासिकल कंट्रोलर अब भी किसी स्थिर, नियंत्रित सेटिंग में प्रिसिशन पर VLA को पछाड़ सकता है।
आइए, आर्किटेक्चर में गहराई से उतरते हैं।
इस लेख के लिए, मैंने OpenVLA आर्किटेक्चर चुना है क्योंकि इसे समझना आसान है।
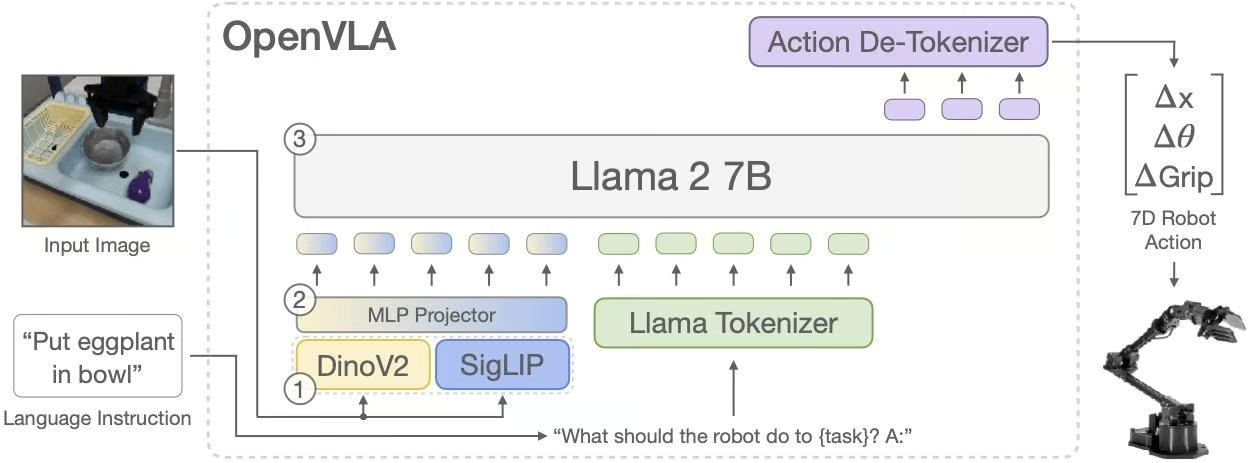
नीचे वही पाइपलाइन है जिसका मैं आगे वर्णन करता हूँ: DINOv2 और SigLIP, Llama 2 बैकबोन को फ़ीड करते हुए, और दूसरी ओर एक्शन डिकोडर डिस्क्रीटाइज़्ड टोकन की भविष्यवाणी करता हुआ। स्रोत: OpenVLA प्रोजेक्ट पेज।
एक VLA के तीन अलग-अलग मॉड्यूल होते हैं:
ये सब एंड-टू-एंड साथ में प्रशिक्षित किए जाते हैं।
विज़न और भाषा के प्रतिरूप आपस में फ्यूज़ होते हैं, और यही संयुक्त प्रतिरूप एक्शन डिकोडर मोटर कमांड में बदलता है।
महत्वपूर्ण रूप से, ये तीनों हिस्से कसकर जुड़े होते हैं, पाइपलाइन नहीं बनाते, और यही वह डिज़ाइन निर्णय है जो VLA को किसी कंट्रोलर से जोड़े गए VLM से अलग करता है।
अगर इससे मदद मिले, तो इसे उसी तरह सोचिए जैसा मैंने मूल World Models पेपर में विज़न, मेमोरी और कंट्रोलर के विभाजन के रूप में बताया था: यह देखता है, समझता है, क्रिया करता है।
अंतर बस इतना है कि VLA ये तीनों काम डेमोंस्ट्रेशन से एंड-टू-एंड साथ में सीखता है, न कि हर हिस्से को अलग-अलग ट्रेन करके बाद में जोड़ता है।
अब इन्हें अलग-अलग देखते हैं।
विज़न एन्कोडर किसी रॉ कैमरा फ़्रेम को एक ऐसे डेंस प्रतिरूप में बदलता है जिसका बाकी नेटवर्क इस्तेमाल कर सके।
आधुनिक VLA प्रीट्रेंड विज़न ट्रांसफ़ॉर्मर्स जैसे DINOv2 या SigLIP—और अक्सर दोनों—का उपयोग करते हैं।
OpenVLA दोनों का उपयोग करने का अच्छा उदाहरण है।
यह DINOv2—जो स्थानिक और ज्यामितीय विवरण में मज़बूत है—को SigLIP के साथ फ्यूज़ करता है—जो भाषा से मेल खाती सैमान्टिक विशेषताओं में मज़बूत है।
इन दोनों सेटों की विशेषताएँ प्रति इमेज पैच कंकैटनेट होती हैं और भाषा मॉडल के एम्बेडिंग स्पेस (यहाँ LLama 2 7B) में प्रोजेक्ट होती हैं।
मैं जोड़ दूँ कि वास्तविक डिप्लॉयमेंट में एक से अधिक कैमरा इस्तेमाल करना मानक है।
उदाहरण के लिए, कलाई पर लगा कैमरा किसी वस्तु के पास अंतिम पहुँच के दौरान क्लोज़-रेंज विवरण देता है, ओवरहेड कैमरा दृश्य का लेआउट देता है, और साइड व्यू, डेप्थ में मदद करता है जिसे अकेला कैमरा नहीं निकाल सकता।
pi0 (इसके बारे में नीचे) कई कैमरा व्यूज़ के साथ रोबोट की प्रोप्रीओसेप्टिव स्थिति भी लेता है।
ध्यान दें कि स्टेट इनपुट उतना महत्वपूर्ण है जितना सुनने में नहीं लगता, क्योंकि किसी हाथ की तस्वीर आपको यह नहीं बताती कि जोड़ों पर इस समय कितना टॉर्क है।
भाषा पक्ष निर्देशों—जैसे “लाल ब्लॉक उठाइए और उसे नीले बिन में रखिए”—को ऐसे प्रतिरूप में एन्कोड करता है जो उसी स्पेस में विज़ुअल फीचरों से मेल खाता हो।
लगभग हर VLA प्रीट्रेंड लार्ज लैंग्वेज मॉडल (LLM) बैकबोन का पुन: उपयोग करता है, न कि कोई टेक्स्ट एन्कोडर शून्य से प्रशिक्षित करता है।
हमारे मामले में, OpenVLA ने Llama 2 7B लिया। pi0 और pi0.5 ने 3-बिलियन-पैरामीटर VLM PaliGemma पर निर्माण किया। SmolVLA ने परिवर्तित SmolVLM2 स्टैक का उपयोग किया।
LLM का यह पुन: उपयोग वास्तव में इनहेरिटेंस के बारे में है।
आपको निर्देश पालन और संयोजित समझ मिलती है, यही कारण है कि VLA अक्सर “फल को कटोरे में रखो” जैसे निर्देश को संभाल सकता है, भले ही रोबोट ट्रेनिंग के दौरान उसने वही वाक्यांश कभी न देखा हो।
एक्शन डिकोडर वहीं है जहाँ फ्यूज़्ड प्रतिरूप वास्तव में मोटर कमांड बनता है—और यही वह जगह भी है जहाँ VLA डिज़ाइन सबसे ज़्यादा अलग होते हैं। फिलहाल तीन व्यापक तरीके प्रचलन में हैं।
आप हर एक्शन डायमेंशन को डिस्क्रीट बिन में काटते हैं और एक के बाद एक भविष्यवाणी करते हैं—वही नेक्स्ट-टोकन सेटअप जिसे LLM पहले से ट्रेन करना जानता है।
OpenVLA प्रति डायमेंशन 256 बिन और साधारण नेक्स्ट-टोकन लॉस का उपयोग करता है, तो आप सामान्य LLM टूलिंग बनाए रखते हैं।
जो आप खोते हैं वह है रेज़ोल्यूशन और स्पीड—बिनिंग से गति खुरदुरी पड़ती है, और टोकन-बाय-टोकन सैंपलिंग तेज़ या संपर्क-समृद्ध कार्यों के लिए बहुत धीमी है।
एक-एक टोकन की भविष्यवाणी करने के बजाय, मॉडल एक्शन जनरेशन को डिनॉइज़िंग प्रक्रिया की तरह मानता है और एक बार में सतत कार्रवाइयों का पूरा खंड उत्पन्न करता है।
pi0 वह पहला VLA था जिसने फ़्लो-मैचिंग एक्शन हेड पर निर्माण किया—जहाँ वे लगभग 10 चरणों में डिनॉइज़ करके अधिकतम 50 भविष्य की कार्रवाइयों का खंड बनाते थे।
इससे बनने वाली गति किसी भी टोकन-आधारित पद्धति से ज़ाहिर तौर पर अधिक स्मूद हुई।
एक बड़ा मॉडल उच्च-स्तरीय तर्क संभालता है और कार्य को चरणों में तोड़ता है, जबकि छोटा, तेज़ कंट्रोलर सटीक, उच्च-आवृत्ति निष्पादन संभालता है।
इसका एक बहुत अच्छा उदाहरण Gemini Robotics 1.5 है, जहाँ उन्होंने एक रीजनिंग मॉडल को एक एक्शन मॉडल के साथ जोड़ा।
मेरी सच्ची राय में, कई पेपर पढ़ने के बाद, लोग एक्शन हेड की तुलना में बैकबोन साइज पर कहीं ज़्यादा ऊर्जा खर्च करते हैं—और यह उल्टा है।
अगर आपका डिकोडर 7-डायमेंशनल सतत एक्शन को 256 डिस्क्रीट बिन में दबोच रहा है, तो कोई भी बैकबोन गुणवत्ता वह स्मूदनेस वापस नहीं ला सकती!
अब मैं एक तालिका प्रस्तुत करना चाहूँगा जो कुछ बहुत महत्वपूर्ण VLA मॉडल दिखाती है जिनसे आपका सामना होने की संभावना है:
|
मॉडल |
डेवलपर |
पैरामीटर |
एक्शन हेड |
लाइसेंस |
हार्डवेयर |
बेहतर किसके लिए |
|---|---|---|---|---|---|---|
|
OpenVLA |
स्टैनफोर्ड, बर्कले और सहयोगी |
7B |
ऑटोरिग्रेसिव टोकन |
MIT |
A100 या H100, या 4-बिट क्वांटाइज़ेशन के साथ 24GB |
ओपन रिसर्च बेसलाइन |
|
Octo |
यूसी बर्कले |
27M या 93M |
डिफ्यूज़न पॉलिसी |
MIT |
सिंगल RTX 4090 |
कम्प्यूट-सीमित काम |
|
pi0 / pi0.5 / pi0.6 |
फिजिकल इंटेलिजेंस |
3.3B (3B बैकबोन + 300M एक्शन एक्सपर्ट) |
फ़्लो मैचिंग |
ओपन चेकपॉइंट (openpi) |
मल्टी-GPU या सिंगल A100 |
कुशल, लंबी-अवधि के कार्य |
|
Gemini Robotics 1.5 |
गूगल डीपमाइंड |
प्रकटीकरण नहीं |
हाइब्रिड, क्लाउड + एज |
क्लोज़्ड |
क्लाउड-टेदर्ड |
फ़्रंटियर प्रोपाइटरी बेसलाइन |
|
SmolVLA |
हगिंग फ़ेस |
450M |
फ़्लो मैचिंग |
Apache 2.0 |
RTX 3060, लैपटॉप GPU, या जेटसन |
हॉबीस्ट और एज रोबोटिक्स |
अब आइए नीचे हर एक पर चलते हैं, शुरुआत उस रिसर्च बेसलाइन से जिसे अब भी अधिकतर लोग तुलना के लिए लेते हैं।
OpenVLA 7-बिलियन-पैरामीटर का मॉडल है जिसे Open X-Embodiment से ली गई 9,70,000 वास्तविक दुनिया की रोबोट डेमोंस्ट्रेशंस पर प्रशिक्षित किया गया है।
यह Llama 2 7B बैकबोन को पहले बताए गए फ्यूज़्ड DINOv2 और SigLIP विज़न एन्कोडर के साथ जोड़ता है, और पूरा मॉडल ओपन सोर्स है।
चकित करने वाला नतीजा यह था कि इसने क्लोज़्ड RT-2-X मॉडल को 29 कार्यों में टास्क सक्सेस पर 16.5 प्रतिशत अंक से पछाड़ दिया—जबकि RT-2-X 55 बिलियन पैरामीटर चला रहा था और OpenVLA सिर्फ 7 बिलियन!
कुल प्रशिक्षण 64 A100 GPUs पर 15 दिन चला।
यह अब भी लोकप्रिय इसलिए है क्योंकि LoRA फाइन-ट्यूनिंग और 4-बिट क्वांटाइज़ेशन इस पर अच्छी तरह काम करते हैं।
इसका मतलब है कि 24GB RTX 4090 एक क्वांटाइज़्ड वर्ज़न चला सकता है, और VLA पर हुए अधिकांश प्रकाशित काम—अटैक्स, डिफेंसेज़ और प्रूनिंग—OpenVLA को लक्ष्य बनाते हैं क्योंकि यह बहुत सुलभ है।
फ़ॉलो-अप—OpenVLA-OFT ने फाइन-ट्यूनिंग रेसिपी को स्पीड और सक्सेस रेट दोनों पर बेहतर बनाया।
Octo एक छोटा VLA है, यह दो आकारों में आता है—27 मिलियन और 93 मिलियन पैरामीटर—क्रमशः ViT-S और ViT-B बैकबोन पर—और सिंगल RTX 4090 पर 20 से 30 Hz पर चल सकता है।
इसे Open X-Embodiment की लगभग 8,00,000 ट्राजेक्टरीज़ पर 22 रोबोट एम्बॉडिमेंट्स में प्रशिक्षित किया गया, और इसकी ट्रांसफ़ॉर्मर आर्किटेक्चर सचमुच मॉड्यूलर है।
आप फाइन-ट्यूनिंग के दौरान कोई नया ऑब्ज़र्वेशन इनपुट जोड़ सकते हैं या एक्शन हेड बदल सकते हैं, बिना मॉडल को शून्य से फिर बनाने के, और यह आपकी ज़रूरत के अनुसार डिस्क्रीट टोकन और डिफ्यूज़न-आधारित सतत एक्शन दोनों को सपोर्ट करता है।
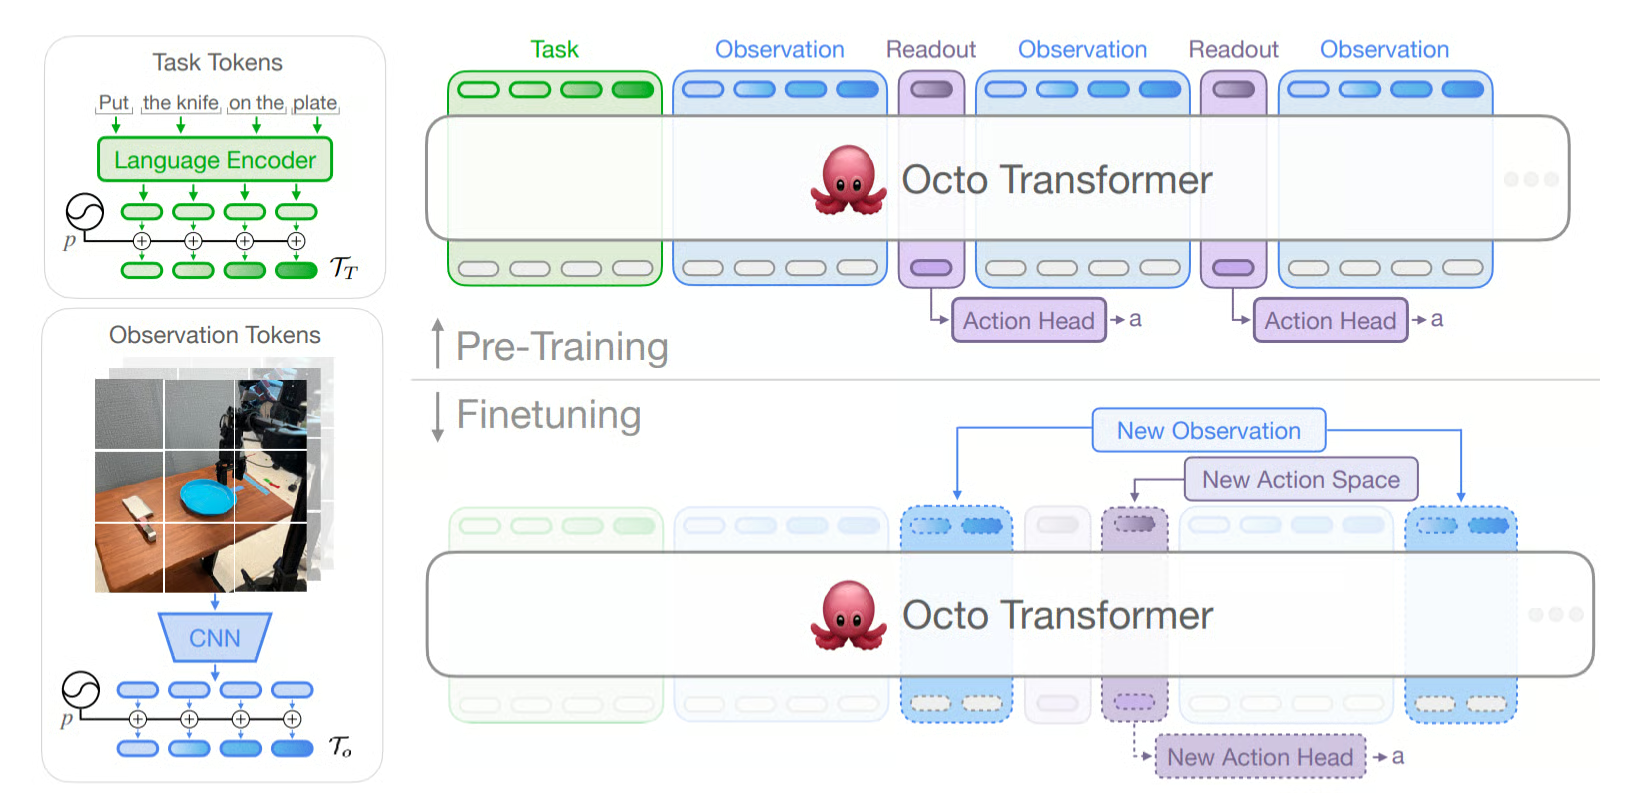
Octo का ट्रांसफ़ॉर्मर: टास्क और ऑब्ज़र्वेशन टोकन इन, रीडआउट टोकन एक्शन हेड की ओर आउट—फाइन-ट्यूनिंग पर नए सेंसर या एक्शन स्पेस जोड़ने की गुंजाइश के साथ। स्रोत: Octo पेपर।
मैं व्यक्तिगत रूप से Octo का उपयोग तब करता हूँ जब सीमा कम्प्यूट हो, न कि कार्य की कठिनाई।
यह गोल-इमेज कंडीशनिंग भी सपोर्ट करता है, जो तब अच्छा विकल्प है जब अपने लक्ष्य अवस्था का वर्णन शब्दों में करना एक फोटो दिखाने से अधिक पेचीदा हो।
pi0 फ़िजिकल इंटेलिजेंस का मॉडल दक्षता में बहुत अच्छा है। यह PaliGemma—3-बिलियन-पैरामीटर ओपन VLM—से शुरू करता है और शून्य से प्रशिक्षित 300-मिलियन-पैरामीटर का एक्शन एक्सपर्ट जोड़ता है, कुल मिलाकर 3.3 बिलियन पैरामीटर।
यह फ़्लो-मैचिंग का उपयोग करता है ताकि एक समय में एक कदम की बजाय एक साथ अधिकतम 50 भविष्य की कार्रवाइयों का खंड बना सके।
मुख्य परिणाम द्वि-हस्त (बाइमैनुअल) कार्य थे—जैसे कपड़े तह करना, किराना पैक करना, और बक्से असेंबल करना—जो पहले किसी भी मॉडल ने इस स्तर की कुशलता से नहीं दिखाए थे।
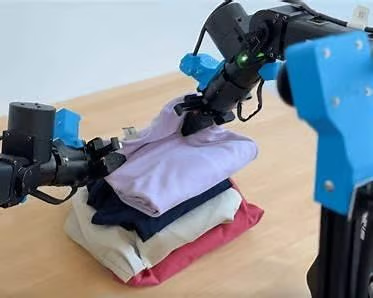
pi0 रोबोट दो भुजाओं से कपड़े तह करते हुए। यह उन्हीं बाइमैनुअल कार्यों में से एक है—लॉन्ड्री फोल्डिंग—और इसे पढ़ने की बजाय देखना बेहतर है। स्रोत: Physical Intelligence, “pi0: Our First Generalist Policy”।
यहाँ असली काम फ़्लो-मैचिंग कर रहा है, क्योंकि दो भुजाओं का साथ-साथ समन्वय 16-डायमेंशनल सतत आउटपुट मांगता है, और न तो डिस्क्रीट टोकन और न ही धीमी डिफ्यूज़न सैंपलिंग वह गति उपयोगी स्पीड पर दे सकती है।
pi0 परिवार विकसित होता रहा है:
एक सावधानी यह है कि pi0 के सबसे मज़बूत नतीजे उनके अपने रोबोट फ़्लीट पर इकट्ठे किए गए प्रोपाइटरी डेटा पर निर्भर हैं।
कंपनी के बाहर किसी ने केवल सार्वजनिक डेटा से उन सटीक संख्याओं को पुन: प्रस्तुत नहीं किया है, इसलिए प्रदर्शन में आर्किटेक्चर बनाम डेटा एडवांटेज का योगदान अब भी सचमुच अनसुलझा है।
Gemini Robotics 1.5 गूगल डीपमाइंड का मॉडल है, जिसे एक के बजाय दो मॉडलों के साथ मिलकर काम करने के रूप में सबसे बेहतर समझा जा सकता है।
Gemini Robotics-ER 1.5 एक एम्बॉडिड रीजनिंग मॉडल है जो योजना बनाता है, Google Search जैसे टूल कॉल करता है, और किसी कार्य पर अपनी प्रगति का अनुमान लगा सकता है।
Gemini Robotics 1.5 वह VLA है जो रीजनिंग मॉडल के निर्णयों को क्रियान्वित करता है।
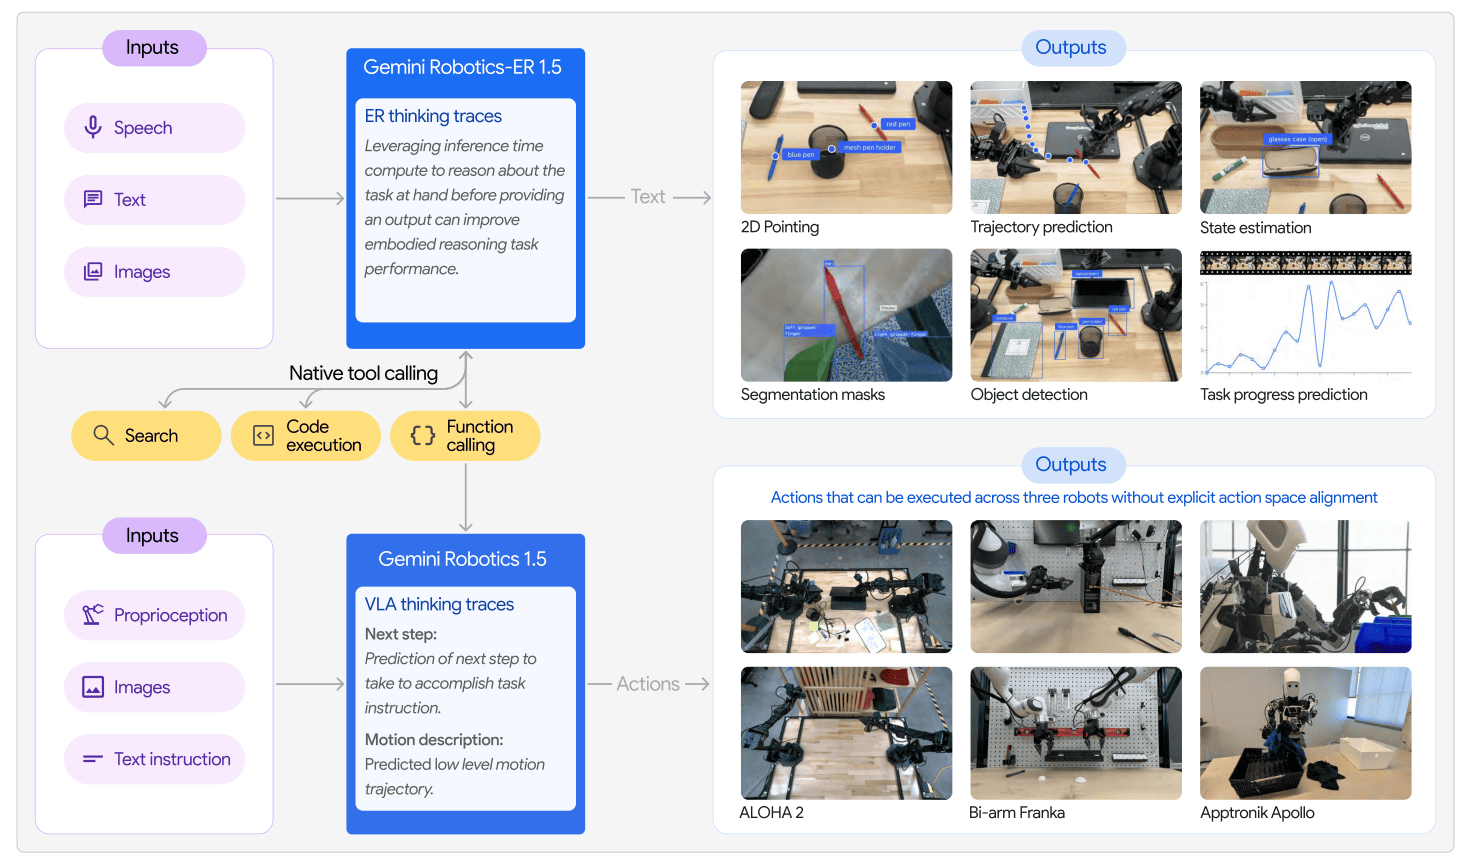
ऊपर एम्बॉडिड रीजनिंग के लिए Gemini Robotics-ER 1.5, नीचे VLA के रूप में Gemini Robotics 1.5, बीच में साझा टूल कॉलिंग, और ALOHA 2, Franka, तथा Apollo पर बिना एक्शन-स्पेस एलाइनमेंट के एक्शन। स्रोत: Gemini Robotics 1.5 पेपर।
कथनीय भाग यह है कि यह कार्रवाइयों को आंतरिक प्राकृतिक-भाषाई रीजनिंग के साथ मिलाता है—यानी रोबोट, क्रिया से पहले सोचता है और बाद में बता सकता है कि उसने क्या तय किया।
जैसे “मेरी लॉन्ड्री को रंग के अनुसार छाँटो” जैसा निर्देश मिलने पर, वह पहले तय करता है कि सफ़ेद एक बिन में जाएँगे और बाकी दूसरे में, फिर व्यक्तिगत पिक्स की योजना बनाता है।
DeepMind बताता है कि ऑब्ज़र्वेशन से एक्शन तक लगभग 250 मिलीसेकंड लगते हैं—प्रभावी कंट्रोल फ़्रीक्वेंसी 50Hz—जो भारी रीजनिंग को क्लाउड में रखकर और हल्के एक्शन डिकोडर को रोबोट के पास रखकर हासिल की गई।
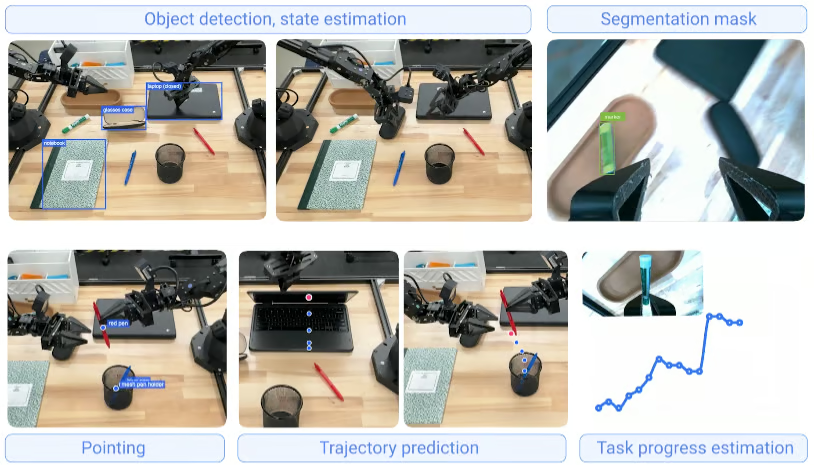
दूसरा नतीजा जिसे मैं नोट करना चाहूँगा वह है मोशन ट्रांसफ़र—जहाँ ALOHA 2 डुअल-आर्म प्लेटफ़ॉर्म पर सीखा गया कार्य बिना किसी रिट्रेनिंग के सीधे Franka बाई-आर्म सेटअप और Apptronik के Apollo ह्यूमनॉइड पर चला गया।
वज़न क्लोज़्ड हैं, इसलिए मैं कहूँगा कि इसे प्रोपाइटरी फ़्रंटियर बेसलाइन की तरह देखें—न कि कुछ ऐसा जिसे आप डाउनलोड करके खुद फाइन-ट्यून कर सकें।
SmolVLA हगिंग फ़ेस का 450 मिलियन पैरामीटर वाला मॉडल है (Apache 2.0 लाइसेंस के अंतर्गत)। यह परिवर्तित SmolVLM2 बैकबोन को फ़्लो-मैचिंग एक्शन एक्सपर्ट के साथ जोड़ता है, और इन्फ़्रेंस को सस्ता रखने के लिए लेयर स्किपिंग और कम विज़ुअल टोकन का उपयोग करता है।
यह एक सिंगल कंज्यूमर GPU—RTX 3060 सहित—पर, मैकबुक के CPU (हालाँकि धीमा) पर, और जेटसन ओरिन पर ऑनबोर्ड इन्फ़्रेंस के लिए चलता है।
20,000 स्टेप्स की फाइन-ट्यूनिंग सिंगल A100 GPU पर लगभग 4 से 5 घंटे लेती है।
30,000 से कम एपिसोड पर ट्रेन होने के बावजूद, यह LIBERO, Meta-World, और वास्तविक SO-100 तथा SO-101 भुजाओं पर कहीं बड़े मॉडलों के बराबर या उनसे बेहतर प्रदर्शन करता है।
सबसे अच्छी बात यह है कि पूरा मॉडल समुदाय-योगदान किए गए डेटासेट पर LeRobot फ़्रेमवर्क के ज़रिए प्रीट्रेंड है।
अब जब मैंने कुछ VLA मॉडल पेश कर दिए हैं, तो बात करते हैं कि अपने विशेष प्रोजेक्ट के लिए किसे चुनें।
इन पाँच के बीच चयन ज़्यादातर आपके वास्तविक सेटअप की कंट्रोल फ़्रीक्वेंसी और हार्डवेयर को मिलाने के बारे में है—न कि उस मॉडल के पीछे भागने के जो पिछले महीने लीडरबोर्ड पर शीर्ष पर था।
मैं इसे मोटे तौर पर ऐसे सोचूँगा:
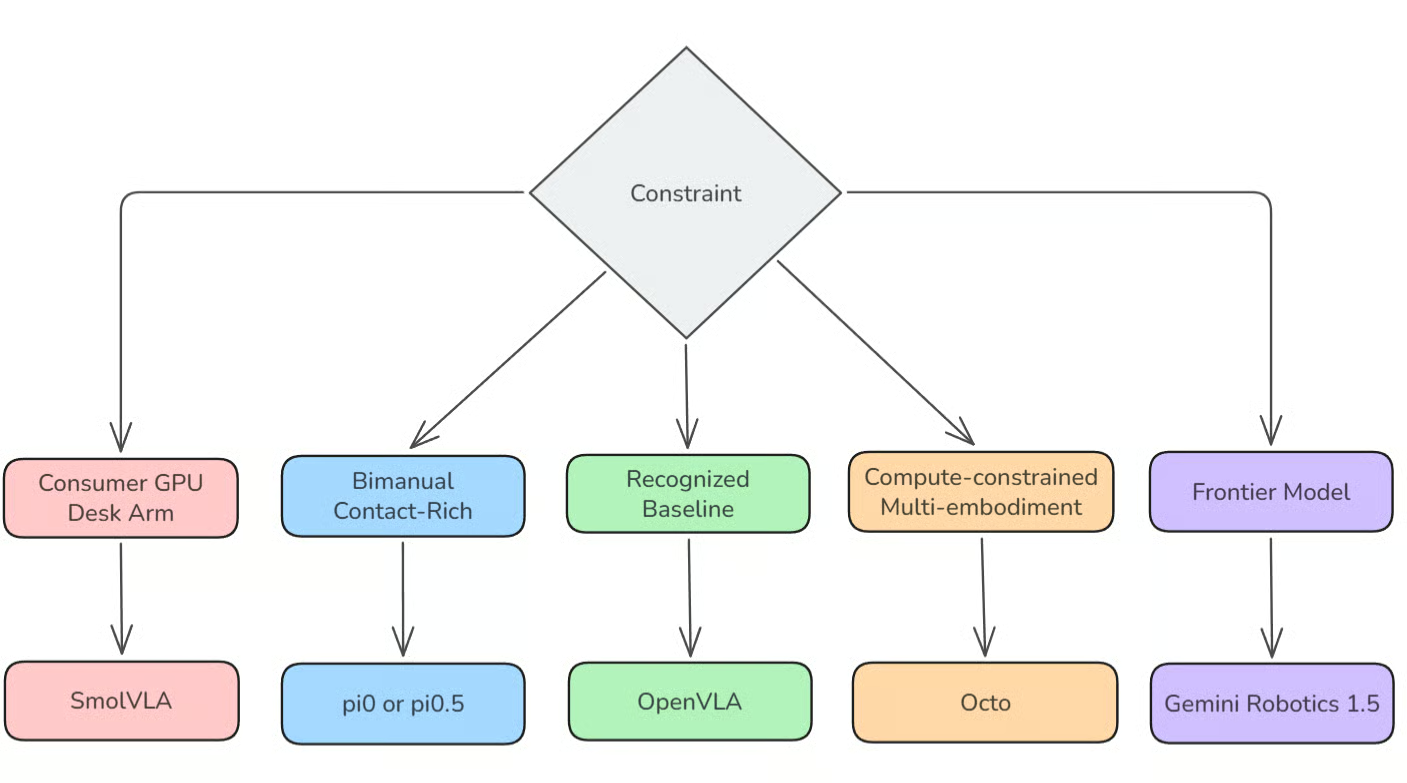
पाँच बाधाएँ, पाँच मॉडल। यदि आप इस लेख से केवल एक आरेख याद रखें, तो वही यह हो। चित्र: लेखक द्वारा।
यदि आपके पास कंज्यूमर GPU या आपके डेस्क पर कोई SO-101 भुजा है, तो SmolVLA से शुरू करें। ओपन इकोसिस्टम में कुछ और इतना सस्ता काम करने वाली पॉलिसी नहीं देता।
और आख़िरी बड़ी बात जो मैं कहना चाहूँगा, वह यह है कि SmolVLA पर सौ साफ-सुथरी डेमोंस्ट्रेशनें, OpenVLA पर पचास बिखरी हुई डेमोंस्ट्रेशन से लगभग हर बार बेहतर होंगी।
मेरा मतलब है—अपने प्रोजेक्ट समय का 60 से 70 प्रतिशत डेटा कलेक्शन और गुणवत्ता नियंत्रण पर खर्च करें, और शेष ट्रेनिंग पर।
VLA डेमो वीडियो से निकलकर कुछ वास्तविक डिप्लॉयमेंट तक पहुँच चुके हैं—भले ही असमान रूप से।
पैटर्न यह दिखता है कि वे पहले वहाँ उतरते हैं जहाँ पर्यावरण में स्क्रिप्टिंग के लिए बहुत विविधता हो, पर आवश्यकता पड़ने पर इंसान अब भी दखल दे सके। कुछ उदाहरण:
यह प्राथमिक क्षेत्र है—पिक-एंड-प्लेस, किटिंग, पैकिंग, सॉर्टिंग, असेंबली, आदि जैसे कार्य।
ये वे कार्य हैं जहाँ रोबोट को उन वस्तुओं की पहचान, पकड़ और पुनर्स्थापना करनी पड़ती है जिनकी स्थिति और अभिविन्यास हर प्रयास के बीच बदलते रहते हैं—और यही वह स्थिति है जिसे स्क्रिप्टेड सिस्टम बुरी तरह संभालते हैं।
वेयरहाउस और फ़ुलफ़िलमेंट फिलहाल सबसे स्पष्ट वाणिज्यिक मामला है। स्क्रिप्टेड पिकर को हर बार आइटम एक ही तरह से प्रस्तुत चाहिए, जबकि VLA-आधारित पिकर चालीस अलग-अलग SKU से भरे एक टोट में उलझे सामान के साथ काम कर सकता है।
Figure, 1X, और Apptronik जैसी कंपनियाँ VLA नींव पर निर्माण कर रही हैं, और कारण सरल है: दो कामकाजी हाथों वाला द्विपाद रोबोट इतने संभावित कार्य कर सकता है कि उन्हें एक-एक करके स्क्रिप्ट करना संभव नहीं।
Gemini Robotics का मोशन ट्रांसफ़र नतीजा—जहाँ ALOHA 2 पर सीखा कौशल सीधे Apptronik के Apollo ह्यूमनॉइड पर चला—वह ठीक वही गुण है जिसकी किसी ह्यूमनॉइड प्रोग्राम को स्केल करने के लिए ज़रूरत है।
वही कौशल, जो एक बार ALOHA 2 पर प्रशिक्षित हुआ, Apptronik के Apollo ह्यूमनॉइड पर बिना रिट्रेनिंग के चल रहा है। स्रोत: Google DeepMind, “Gemini Robotics 1.5 brings AI agents into the physical world”।
ड्राइविंग स्टैक अब VLA-शैली की आर्किटेक्चर अपनाने लगे हैं ताकि कार जो देखती है उसे अगले कदम में क्या करना चाहिए से एक ही रीजनिंग लूप के भीतर जोड़ा जा सके—परसेप्शन-टू-प्लैनर हैंडऑफ़ के बजाय।
अपील वही है जो मैनीपुलेशन में है: दुर्लभ स्थितियाँ जिनका कोई नियम पहले से अनुमान नहीं कर पाया—ऐसे मॉडल द्वारा संभाली जाएँ जो दुनिया को इतना देख चुका है कि उनके बारे में तर्क कर सके, ठिठक न जाए।
यह सूची का सबसे शुरुआती चरण का अनुप्रयोग है, मैं यह बताना चाहूँगा।
विचार यह है कि ऐसा सिस्टम जो सर्जन के बोले हुए निर्देशों का पालन कर सके और बदलती ऊतक-परिस्थितियों के अनुसार ढल सके, किसी कठोरता से प्रोग्राम्ड सिस्टम से बेहतर होगा—पर यहाँ मुख्य बाधा मॉडल की क्षमता नहीं बल्कि रेगुलेटरी अप्रूवल है।
मैं उम्मीद करता हूँ कि सहायक और प्रशिक्षण संबंधी उपयोग, किसी भी प्रकार की स्वायत्तता के बहुत पहले दिखेंगे।
अब, जबकि VLA बहुत अच्छे हैं, फिर भी चार खास जगहों पर उनकी कमज़ोरियाँ बनी हुई हैं:
VLA किसी कार्य की शुरुआत में विविधता को ठीक-ठाक संभालते हैं, लेकिन जब पकड़ आधे रास्ते में फिसल जाती है या वस्तु ग्रिपर के नीचे खिसक जाती है, तो रिकवरी असंगत रहती है।
अधिकांश डेमोंस्ट्रेशन डेटा सफल प्रयासों को कैप्चर करता है, इसलिए मॉडल ने गलती से उबरने के बहुत कम उदाहरण देखे होते हैं।
सूक्ष्म मैनीपुलेशन के लिए 10 से 100Hz तक की कंट्रोल लूप चाहिए, और 7 बिलियन या उससे बड़े मॉडल को खुद रोबोट के हार्डवेयर पर उस दर तक पहुँचाना अब भी लक्ष्य है—सुलझा हुआ इंजीनियरिंग नहीं।
इसीलिए अधिकांश डिप्लॉयड सिस्टम या तो किसी एज सर्वर से बंधे रहते हैं या रीजनिंग और कंट्रोल को अलग करते हैं—जैसे Gemini Robotics 1.5।
क्वांटाइज़ेशन, लेयर स्किपिंग और डिस्टिलेशन मदद करते हैं, पर ये अब भी स्थिर उत्तर नहीं—बल्कि चल रहा काम हैं।
अब जब सक्षम ओपन वेट्स किसी के लिए भी डाउनलोड करने को उपलब्ध हैं, अंतर पैदा करने वाली चीज़ डेटा हो गई है।
विविध, अच्छे से एनोटेटेड टेलिऑपरेशन डेटा एकत्र करना धीमा और महँगा है—वैसा नहीं जैसा वेब को स्क्रैप करना था—और pi0 के प्रकाशित परिणामों तथा केवल सार्वजनिक डेटा से किसी के पुनरुत्पादन के बीच का अंतर स्पष्ट करता है कि प्राइवेट डेटा एडवांटेज क्या दिलाता है।
वर्तमान VLA अपने ट्रेनिंग वितरण के अंदर तो अच्छा जनरलाइज़ करते हैं, बाहर आते ही प्रदर्शन उल्लेखनीय रूप से घटता है।
टेबलटॉप मैनीपुलेशन पर 22 एम्बॉडिमेंट्स में प्रशिक्षित मॉडल भी किसी ऐसे टास्क-शेप पर कमजोर पड़ सकता है जो उसने सचमुच कभी न देखा हो।
जैसा कि आप देख सकते हैं, VLA मॉडल परसेप्शन, भाषा समझ और एक्शन जनरेशन को एक ही आर्किटेक्चर में लाते हैं—और यह संरचनात्मक बदलाव है, क्रमिक नहीं।
जो वे कर सकते हैं—और क्लासिकल कंट्रोल नहीं कर पाया—वह है उन परिस्थितियों पर सामान्यीकरण करना जिन पर किसी ने स्पष्ट रूप से ट्रेनिंग नहीं दी, क्योंकि भाषा और विज़न बैकबोन, डेमोंस्ट्रेशन देखने से पहले ही, रोबोट में दुनिया का एक कार्यशील मॉडल ले आते हैं।
2026 में मुझे सबसे अधिक यह बात चौंकाती है कि कठिन सवाल कितना बदल गया है।
तीन साल पहले कठिन सवाल आर्किटेक्चर था।
अब जब OpenVLA, Octo, pi0, और SmolVLA—ये सब GitHub पर किसी के लिए भी डाउनलोड करने को रखे हैं—कठिन सवाल हैं डेटा गुणवत्ता, रिकवरी व्यवहार, और क्या आप यह सब 50Hz पर रोबोट पर ही चला सकते हैं—न कि किसी डेटा सेंटर में।
यदि आप आगे बढ़ना चाहते हैं, तो DataCamp का Introduction to AI Agents कोर्स व्यापक एजेंटिक संदर्भ कवर करता है, और Large Language Models (LLMs) Concepts बैकबोन पक्ष को कवर करता है।
शीर्ष DataCamp कोर्स
कोर्स
कोर्स
कोर्स
