50 % de descuento en DataCamp Premium. Más de 700 cursos a mitad de precio. Empieza a aprender hoy.
Imagina que le dices a alguien: «Coge la taza y ponla en la estantería». No necesita un diagrama; mira la taza, entiende la frase y su mano va directa a por ella.
Aquí suceden casi a la vez tres cosas distintas. Ver, comprender y moverse ocurren prácticamente en paralelo para esa persona, no como tres pasos separados que se pasan entre partes distintas del cerebro.
Durante gran parte de la historia de la IA robótica, las máquinas no funcionaban así en absoluto.
Hasta ahora, teníamos modelos de visión‑lenguaje capaces de mirar un banco de trabajo desordenado y describir con precisión lo que hay, incluidos detalles finos como la marca de una herramienta.
Los controladores robóticos clásicos podían coger ese destornillador con fiabilidad, siempre que nadie lo moviese dos centímetros a la izquierda. Las dos mitades del problema —ver y comprender por un lado, y actuar por otro— evolucionaron casi por completo por separado.
Aquí es donde entran los modelos de visión‑lenguaje‑acción (VLA): buscan cerrar esa brecha.
En este artículo, veremos qué son los modelos VLA y cómo funciona su arquitectura de tres partes. Exploraremos en qué se diferencian de los modelos de visión‑lenguaje (VLM) y del control robótico clásico, qué modelos importan de verdad en 2026 y dónde se usan. Por último, veremos qué cosas siguen fallando en los VLA.
Empecemos definiendo formalmente qué son los modelos VLA:
Un modelo de visión‑lenguaje‑acción es un sistema de IA que procesa una señal de cámara, una instrucción en lenguaje natural y el estado propio del robot, y produce comandos motores. Sus módulos de visión, lenguaje y acción se entrenan conjuntamente y se ejecutan en una sola pasada hacia delante, en lugar de seguir la canalización clásica de percepción→planificación→control.
La clave es que percepción, lenguaje y acción no son sistemas separados pegados con código artesanal.
Son submódulos entrenados conjuntamente. Así, un error de visión o lenguaje que descarrilaría el traspaso en una canalización clásica se corrige con descenso por gradiente, en lugar de depender de una interfaz rígida que lo detecte —o lo deje pasar.
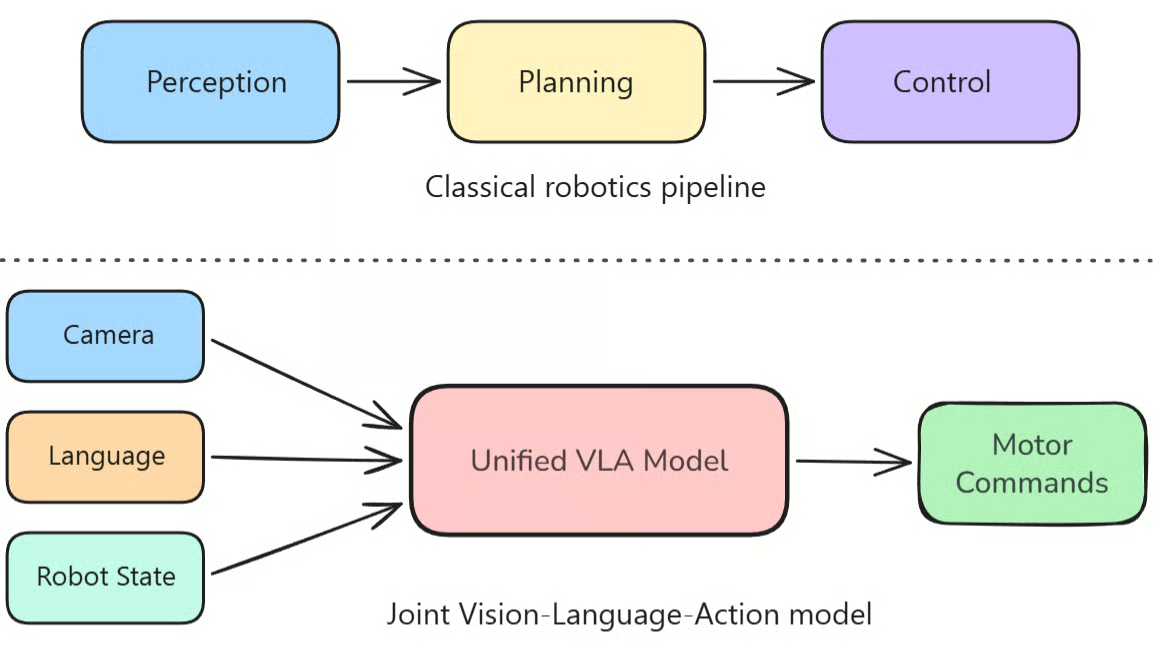
Arriba, tres cajas y dos traspasos frágiles; abajo, un único modelo fusionado. Esta es la diferencia estructural de la que hablo. Imagen del autor.
Me gusta resumirlo así: un VLM es un cerebro sin cuerpo y un VLA se lo da.
La percepción no es un servicio aparte al que llama el robot, sino que está integrada en la canalización entrenada de forma conjunta que decide cuánto debe moverse la garra.
Ya que he mencionado los VLM, comparemos estas dos arquitecturas.
Un VLM (Vision‑Language Model) recibe imágenes y texto, y produce texto o embeddings.
Un VLA (Vision‑Language‑Action Model), en cambio, toma el mismo tipo de entrada y produce una acción.
Suena a cambio menor hasta que ves lo que implica después:
|
Modelo de visión‑lenguaje (VLM) |
Modelo de visión‑lenguaje‑acción (VLA) |
|
|---|---|---|
|
Entrada |
Imágenes, vídeo, texto |
Imágenes (a menudo de varias cámaras), texto, estado propio del robot |
|
Salida |
Texto, embeddings |
Comandos motores continuos o discretizados |
|
Capacidad principal |
Describir y razonar sobre una escena |
Actuar sobre una escena |
|
¿Puede actuar en el mundo? |
No |
Sí |
|
Datos de entrenamiento |
Pares imagen‑texto extraídos de la web |
Datos web más trayectorias de demostración robótica |
|
Aplicación típica |
Visual question answering, subtitulado, análisis de documentos |
Manipulación, navegación, control de humanoides |
Puede que te suenen modelos como GPT‑4V, Gemini o LLaVA.
Es habitual pensar que un VLA es uno de esos modelos con un brazo robótico conectado.
Pero no es tan simple.
El modelo tiene que aprender un espacio de salida completamente nuevo, donde un token corresponde a una magnitud física real, como el desplazamiento del efector final o la apertura de la pinza; y equivocarse no genera una frase rara, sino que tira una taza de la mesa.
Si quieres ver cómo se comparan GPT‑4V, Gemini y LLaVA con el resto, el resumen de DataCamp Top 10 Vision Language Models in 2026 recoge a los líderes actuales.
También hay una consecuencia del lado de los datos.
Un VLM puede entrenarse con miles de millones de pares imagen‑texto porque Internet los suministra gratis.
Las trayectorias robóticas, en cambio, hay que recogerlas con un robot real haciendo una tarea real, normalmente bajo teleoperación. Por eso el mayor conjunto de datos robóticos abierto, Open X‑Embodiment, se queda en alrededor de 1 millón de trayectorias y no en 1.000 millones.
Recoger estas trayectorias a mano también es muy caro y lento.
22 morfologías, un dataset, y aun así por debajo de 1 millón de trayectorias en total. A esto me refiero cuando digo que los datos robóticos no escalan como el texto web. Fuente: página del proyecto Open X‑Embodiment.
Antes de entrar en cómo funciona la arquitectura VLA, compáremola con el control robótico clásico.
El control clásico está diseñado para una tarea en un lugar, bajo condiciones fijadas de antemano.
Piensa en el brazo de una máquina expendedora.
Coge siempre el mismo snack de la misma balda en el mismo punto, porque la iluminación, la posición de los objetos y los movimientos necesarios no cambian entre recogidas.
Esa configuración estrecha e inmutable es justo lo que permite que el control sea rígido y fiable.
Pero si cambiamos la configuración interna de la máquina, o la iluminación, o añadimos un objeto no previsto a la escena,
el controlador fallará por completo porque nunca ha visto ese entorno.
Un VLA generaliza mejor a condiciones para las que no se entrenó explícitamente, y la razón es que la columna vertebral VLM ya sabe cómo son una taza, una toalla o un cajón gracias al preentrenamiento a escala web, antes de ver siquiera una demostración robótica.
Ajustarlo con un centenar de ejemplos de doblar toallas le permite aprender cómo moverse ante algo que ya reconoce.
Ese trasvase es el verdadero avance aquí, no la precisión bruta, y conviene recordar que un controlador clásico bien afinado aún puede superar a un VLA en precisión en un entorno fijo y controlado.
Vamos a profundizar en la arquitectura.
Para este artículo, me baso en la arquitectura de OpenVLA porque es sencilla de entender.
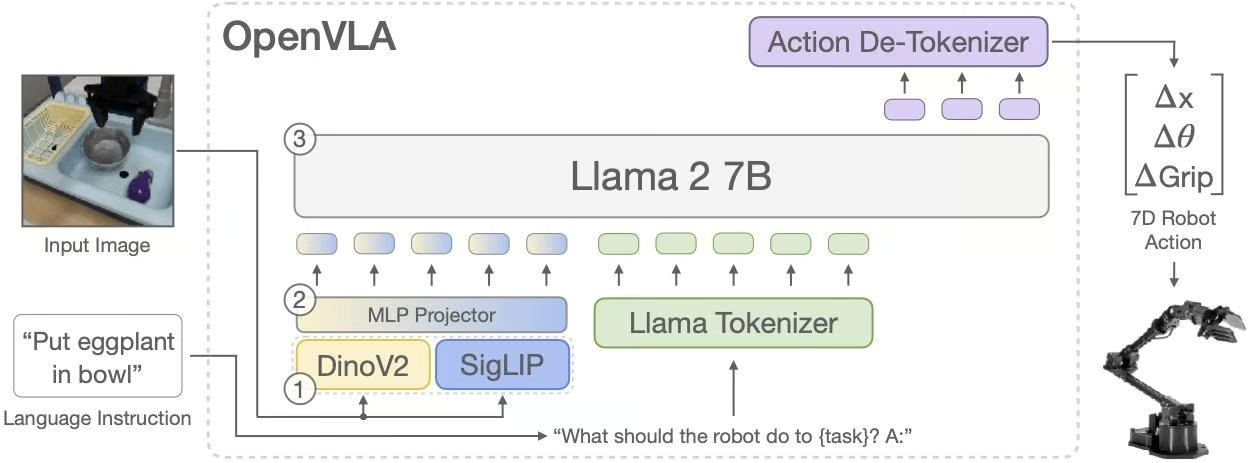
Esta es la canalización que describo a continuación: DINOv2 y SigLIP alimentan una columna Llama 2, con el decodificador de acción que predice tokens discretizados al otro extremo. Fuente: página del proyecto OpenVLA.
Un VLA tiene tres módulos:
Se entrenan de extremo a extremo, juntos.
Las representaciones de visión y lenguaje se fusionan, y esta representación combinada es la que el decodificador de acción convierte en comandos motores.
Importante: las tres partes están estrechamente acopladas, no encadenadas en una canalización. Esa es la decisión de diseño que separa a un VLA de un VLM atornillado a un controlador.
Si te ayuda, piensa en la división visión, memoria y controlador del paper original de World Models: ve, entiende, actúa.
La diferencia es que un VLA aprende los tres trabajos a la vez, de extremo a extremo, a partir de demostraciones, en lugar de entrenar cada pieza por separado y pegarlas después.
Veamos cada componente por separado.
El codificador de visión convierte un fotograma bruto de la cámara en una representación densa que el resto de la red puede utilizar.
Los VLA modernos usan transformers de visión preentrenados como DINOv2 o SigLIP, y a menudo ambos a la vez.
OpenVLA es un buen ejemplo de uso combinado.
Fusiona DINOv2, fuerte en detalle espacial y geométrico, con SigLIP, más potente en rasgos semánticos que se alinean bien con el lenguaje.
Ambos conjuntos de rasgos se concatenan por parche de imagen y se proyectan al espacio de embeddings del modelo de lenguaje (en este caso, LLama 2 7B).
Usar más de una cámara es lo habitual en despliegues reales.
Por ejemplo, una cámara en la muñeca da detalle de cerca en la aproximación final, una cámara cenital ofrece el plano de la escena y una vista lateral ayuda con la profundidad que una sola cámara no puede recuperar.
pi0 (más abajo) integra múltiples vistas de cámara más el estado propio del robot.
El estado importa más de lo que parece: una foto del brazo no te dice el par actual de las articulaciones.
La parte lingüística codifica una instrucción —por ejemplo «coge el bloque rojo y ponlo en el contenedor azul»— en una representación que se alinea con las características visuales en el mismo espacio.
Casi todos los VLA reutilizan una gran modelo de lenguaje (LLM) preentrenado en lugar de crear un codificador de texto desde cero.
En nuestro caso, OpenVLA usó Llama 2 7B. pi0 y pi0.5 partieron de PaliGemma, un VLM de 3.000 millones de parámetros. SmolVLA empleó una pila SmolVLM2 modificada.
Reutilizar un LLM va de heredar capacidades.
Obtienes seguimiento de instrucciones y comprensión composicional, por lo que un VLA puede manejar a menudo «pon la fruta en el cuenco» aunque no haya visto esa frase exacta durante el entrenamiento robótico.
El decodificador de acción es donde la representación fusionada se convierte en un comando motor, y también donde más difieren los diseños VLA. Hoy se usan tres enfoques generales.
Se trocea cada dimensión de la acción en bins discretos y se predicen uno tras otro, igual que el esquema de siguiente token que ya domina un LLM.
OpenVLA usa 256 bins por dimensión y una pérdida estándar de siguiente token, así que puedes conservar el tooling habitual de LLM.
Lo que pierdes es resolución y velocidad: el binning deja movimientos dentados y muestrear token a token es demasiado lento para tareas rápidas o con contacto intenso.
En lugar de predecir un token cada vez, el modelo trata la generación de acciones como un proceso de eliminación de ruido y produce de golpe un bloque de acciones continuas.
pi0 fue el primer VLA construido en torno a una cabeza de acción de flow matching, donde des‑ruidan en unas 10 etapas para producir un bloque de hasta 50 acciones futuras.
El movimiento resultante es notablemente más suave que con tokens discretos.
Un modelo grande se encarga del razonamiento de alto nivel y divide la tarea en pasos, mientras que un controlador más pequeño y rápido gestiona la ejecución precisa y de alta frecuencia.
Un buen ejemplo es Gemini Robotics 1.5, donde emparejan un modelo de razonamiento con un modelo de acción.
En mi opinión, tras leer varios papers, se dedica mucha más energía a discutir el tamaño de la columna que la cabeza de acción, y creo que es al revés.
Si tu decodificador aplasta una acción continua de 7 dimensiones en 256 bins discretos, ¡ninguna calidad de columna te devolverá esa suavidad!
A continuación, una tabla con modelos VLA importantes con los que probablemente te cruces:
|
Modelo |
Desarrollador |
Parámetros |
Cabeza de acción |
Licencia |
Hardware |
Ideal para |
|---|---|---|---|---|---|---|
|
OpenVLA |
Stanford, Berkeley y colaboradores |
7B |
Tokens autoregresivos |
MIT |
A100 o H100, o 24GB con cuantización a 4 bits |
Referencia abierta para investigación |
|
Octo |
UC Berkeley |
27M o 93M |
Política de difusión |
MIT |
Una sola RTX 4090 |
Trabajos con cómputo limitado |
|
pi0 / pi0.5 / pi0.6 |
Physical Intelligence |
3,3B (columna de 3B + experto de acción de 300M) |
Flow matching |
Checkpoints abiertos (openpi) |
Multi‑GPU o una sola A100 |
Tareas diestros y de largo horizonte |
|
Gemini Robotics 1.5 |
Google DeepMind |
No divulgado |
Híbrido, nube + borde |
Cerrado |
Conexión a la nube |
Referencia propietaria de frontera |
|
SmolVLA |
Hugging Face |
450M |
Flow matching |
Apache 2.0 |
RTX 3060, GPU de portátil o Jetson |
Robótica hobby y en el borde |
Ahora repasemos cada uno, empezando por la referencia de investigación con la que aún se compara casi todo.
OpenVLA es un modelo de 7.000 millones de parámetros entrenado con 970.000 demostraciones robóticas del mundo real extraídas de Open X‑Embodiment.
Combina una columna Llama 2 7B con los codificadores de visión fusionados DINOv2 y SigLIP que describí antes, y todo el modelo es open source.
El resultado sorprendente fue que superó al modelo cerrado RT‑2‑X en 16,5 puntos porcentuales de éxito a lo largo de 29 tareas, ¡mientras RT‑2‑X ejecutaba 55.000 millones de parámetros frente a los 7.000 millones de OpenVLA!
El entrenamiento total requirió 64 GPUs A100 durante 15 días.
Sigue siendo popular porque la afinación con LoRA y la cuantización a 4 bits funcionan bien.
Esto significa que una RTX 4090 de 24GB puede ejecutar una versión cuantizada y la mayoría de trabajos publicados sobre ataques, defensas y poda en VLA usan OpenVLA como objetivo por su accesibilidad.
OpenVLA‑OFT, una continuación, mejoró la receta de fine‑tuning en velocidad y tasa de éxito.
Octo es un VLA pequeño, en dos tamaños —27 y 93 millones de parámetros— sobre columnas ViT‑S y ViT‑B, respectivamente, y puede ejecutarse en una única RTX 4090 a 20–30 Hz.
Se entrenó con unas 800.000 trayectorias de Open X‑Embodiment en 22 morfologías robóticas y su arquitectura transformer es genuinamente modular.
Puedes añadir una nueva entrada de observación o cambiar la cabeza de acción durante el fine‑tuning sin reconstruir el modelo desde cero, y admite tokens discretos y acciones continuas basadas en difusión según lo que necesites.
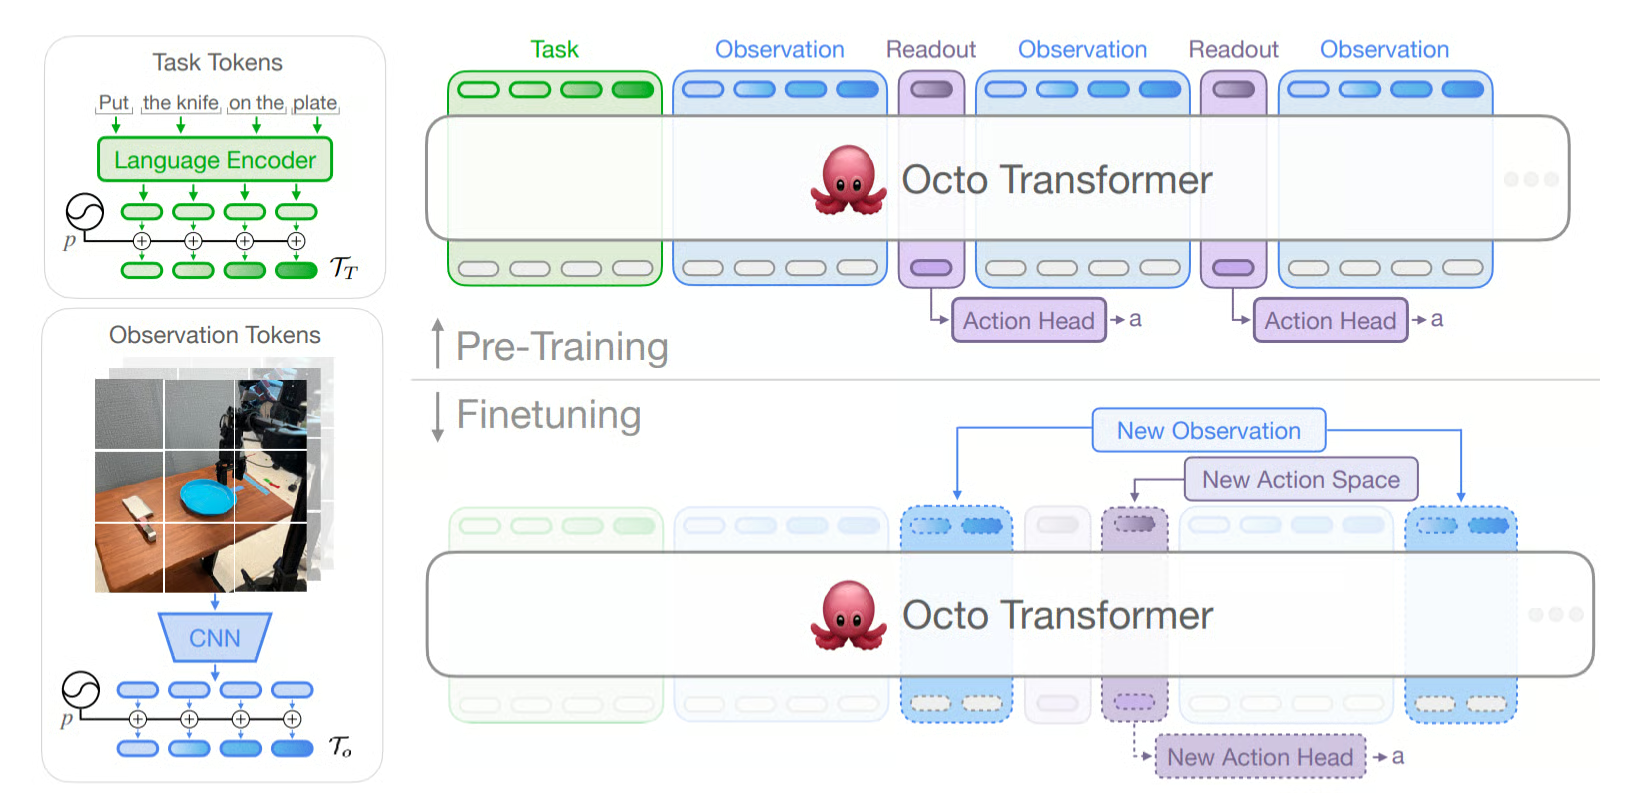
El transformer de Octo: tokens de tarea y observación de entrada, tokens de lectura de salida hacia la cabeza de acción, con margen para añadir sensores o espacios de acción nuevos en el ajuste fino. Fuente: paper de Octo.
Personalmente uso Octo cuando la limitación es el cómputo y no la dificultad de la tarea.
Además, admite condicionamiento por imagen objetivo, útil cuando describir el estado final en palabras es más engorroso que mostrar una foto.
pi0 de Physical Intelligence destaca en destreza. Parte de PaliGemma, un VLM abierto de 3.000 millones de parámetros, y añade un experto de acción de 300 millones entrenado desde cero, sumando 3.300 millones.
Usa flow matching para producir de una vez un bloque de hasta 50 acciones futuras, en lugar de un paso cada vez.
El resultado clave: tareas bimanuales como doblar ropa, empaquetar compras y montar cajas, con un nivel de destreza sin precedentes.
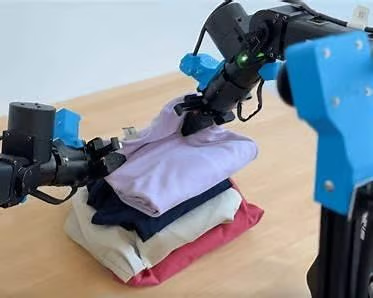
pi0 doblando ropa con dos brazos. Es una de las tareas bimanuales mencionadas; merece la pena verlo en vídeo. Fuente: Physical Intelligence, «pi0: Our First Generalist Policy».
El flow matching es la clave aquí, porque coordinar dos brazos a la vez requiere una salida continua y suave de 16 dimensiones, y ni los tokens discretos ni una difusión lenta dan esa fluidez a velocidad útil.
La familia pi0 ha seguido avanzando:
Un matiz: los mejores resultados de pi0 dependen de datos propietarios recogidos en su propia flota de robots.
Nadie fuera de la empresa ha replicado exactamente esas cifras usando solo datos públicos, así que cuánto se debe a la arquitectura y cuánto a la ventaja en datos sigue sin resolverse.
Gemini Robotics 1.5, de Google DeepMind, se entiende mejor como dos modelos que trabajan juntos.
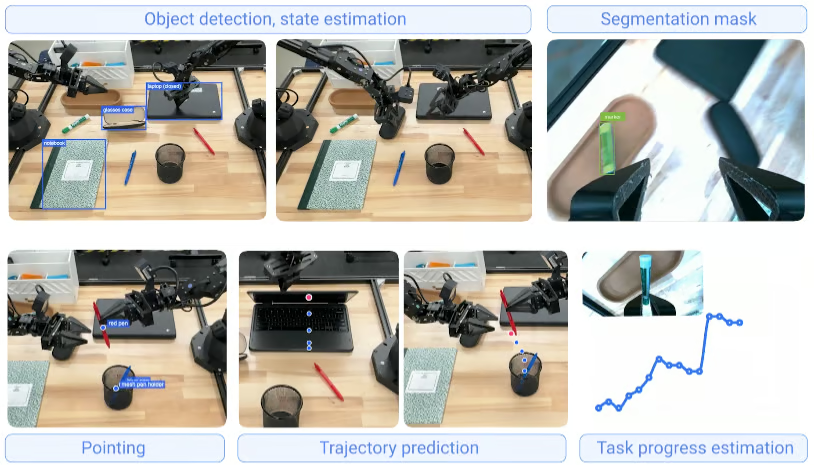
Gemini Robotics‑ER 1.5 es un modelo de razonamiento encarnado que planifica, llama a herramientas como Google Search y puede estimar su propio progreso en una tarea.
Gemini Robotics 1.5 es el VLA que ejecuta lo que decide el modelo de razonamiento.
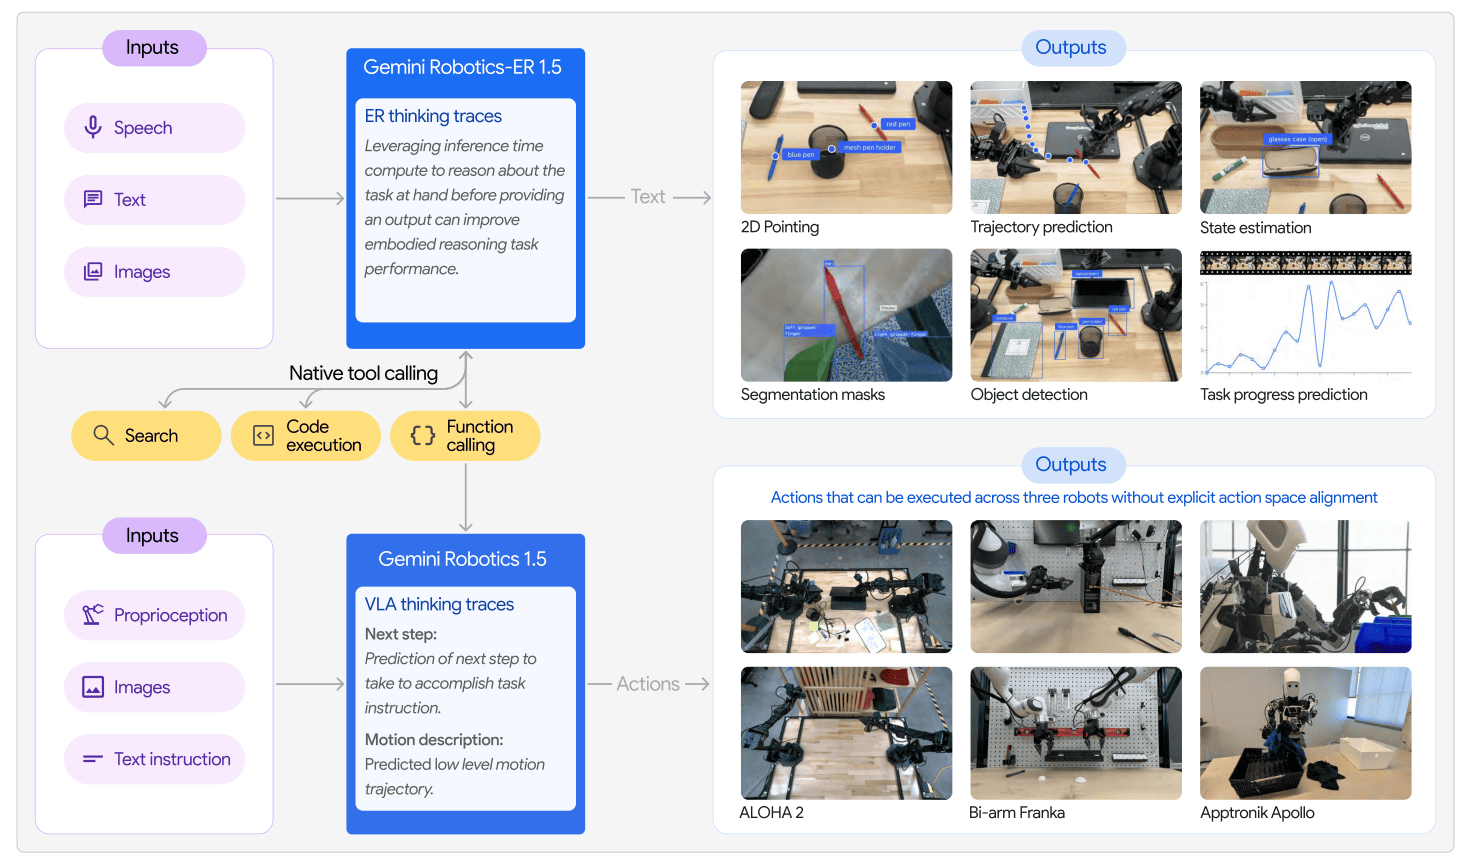
Gemini Robotics‑ER 1.5 arriba para el razonamiento encarnado, Gemini Robotics 1.5 abajo como VLA, llamadas a herramientas compartidas en medio, y acciones corriendo en ALOHA 2, Franka y Apollo sin alinear espacios de acción. Fuente: paper de Gemini Robotics 1.5.
Lo útil es que mezcla acciones con un proceso interno de razonamiento escrito en lenguaje natural, así que el robot piensa antes de actuar y puede explicar después lo que decidió.
Ante una instrucción como «clasifica mi ropa por color», primero deduce que los blancos van a un cubo y el resto a otro, y después planifica las recogidas individuales.
DeepMind reporta unos 250 ms desde la observación a la acción (50 Hz efectivos), logrados poniendo el razonamiento pesado en la nube y manteniendo un decodificador de acción ligero en el robot.
Otro resultado destacable es el Motion Transfer: una tarea aprendida en la plataforma bimanual ALOHA 2 se trasladó directamente a un montaje bi‑brazo Franka y al humanoide Apollo de Apptronik, sin reentrenamiento.
Los pesos son cerrados, así que trátalo como la referencia propietaria de frontera, no como algo que puedas descargar y afinar tú mismo.
SmolVLA de Hugging Face tiene 450 millones de parámetros (licencia Apache 2.0). Combina una columna SmolVLM2 modificada con un experto de acción de flow matching, usando salto de capas y menos tokens visuales para abaratar la inferencia en hardware pequeño.
Funciona en una sola GPU de consumo —incluida una RTX 3060—, en la CPU de un MacBook (más lento) y se despliega en un Jetson Orin para inferencia a bordo.
Afinarlo durante 20.000 pasos lleva unas 4–5 horas en una sola A100.
Pese a entrenarse con menos de 30.000 episodios, iguala o supera a modelos mucho mayores en LIBERO, Meta‑World y brazos reales SO‑100 y SO‑101.
Lo mejor es que todo está preentrenado con datasets aportados por la comunidad a través de LeRobot.
Ahora que hemos visto varios modelos VLA, hablemos de cómo elegir el adecuado para tu proyecto.
La elección entre estos cinco va más de casar frecuencia de control y hardware con tu montaje real que de perseguir al que lideró el ranking el mes pasado.
Así lo pensaría yo, a grandes rasgos:
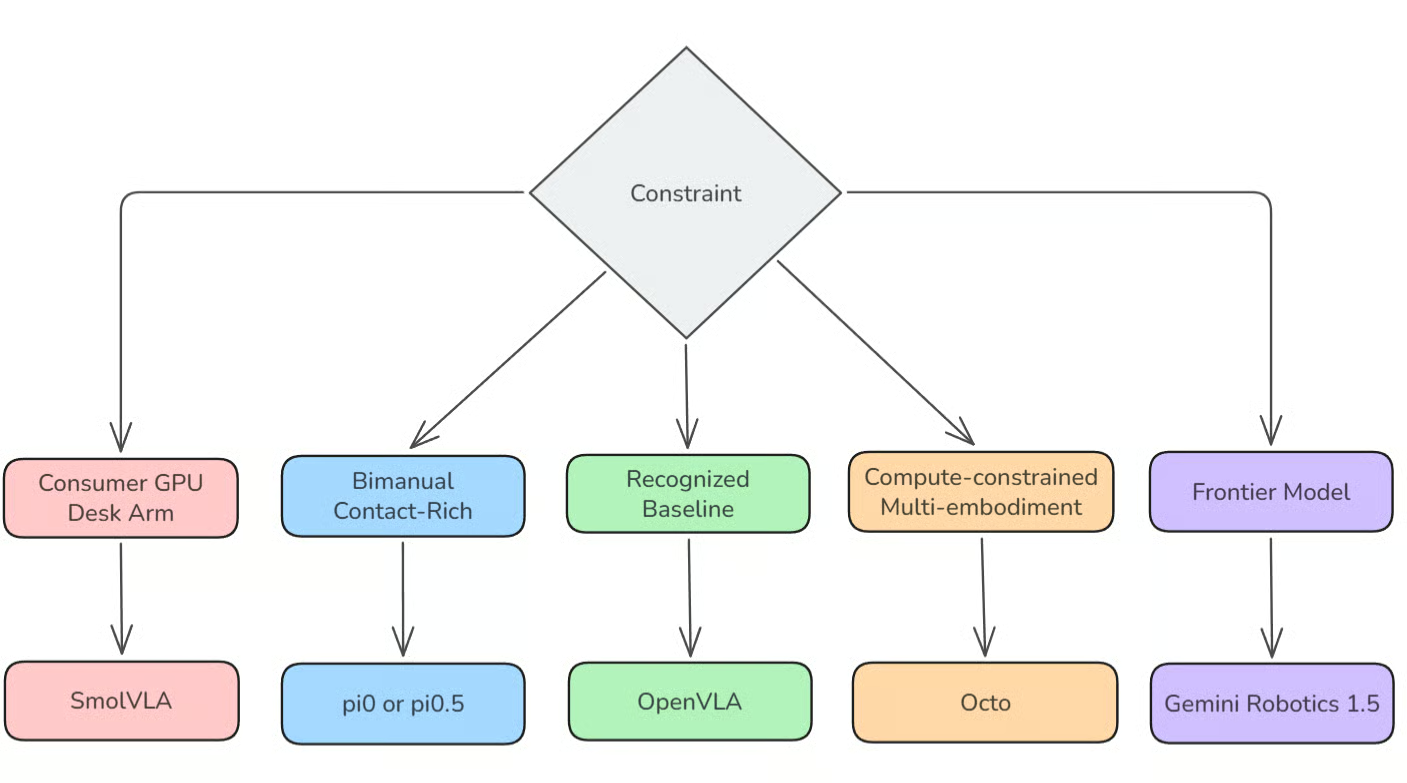
Cinco restricciones, cinco modelos. Si solo recuerdas un diagrama, que sea este. Imagen del autor.
Si tienes una GPU de consumo o un brazo SO‑101 en tu mesa, empieza con SmolVLA. Nada en el ecosistema abierto te da una política funcional tan barato.
Y un último punto importante: cien demostraciones limpias en SmolVLA superarán a cincuenta desordenadas en OpenVLA casi siempre.
Dedica entre el 60 y el 70% del tiempo del proyecto a recoger datos y control de calidad, y el resto al entrenamiento.
Los VLA han salido de los vídeos de demo y han llegado a algunos despliegues reales, aunque de forma desigual.
El patrón que veo es que aterrizan primero donde hay demasiada variación para programar a base de reglas, pero una persona puede intervenir si algo falla. Algunos ejemplos:
El terreno principal: tareas de pick‑and‑place, kitting, empaquetado, clasificación, ensamblaje, etc.
Son tareas donde el robot debe identificar, agarrar y recolocar objetos cuya posición y orientación cambian entre intentos: justo lo que los sistemas guionizados llevan mal.
La logística y la preparación de pedidos son el caso comercial más claro hoy. Un picker programado necesita que el ítem se presente igual siempre, mientras que uno basado en VLA puede trabajar con una caja con cuarenta referencias mezcladas.
Empresas como Figure, 1X y Apptronik se apoyan en cimientos VLA, por una razón simple: un bípedo con dos manos funcionales tiene demasiadas tareas posibles para programarlas una a una.
El resultado de Motion Transfer de Gemini Robotics —una habilidad entrenada en ALOHA 2 que se ejecuta en el humanoide Apollo sin reentrenamiento— es justo lo que un programa de humanoides necesita para escalar.
La misma habilidad, entrenada una vez en ALOHA 2, ejecutándose en el humanoide Apollo de Apptronik sin reentrenamiento. Fuente: Google DeepMind, «Gemini Robotics 1.5 brings AI agents into the physical world».
Las pilas de conducción empiezan a adoptar arquitecturas tipo VLA para conectar lo que ve el coche con lo que debe hacer a continuación, en un solo bucle de razonamiento y no con un traspaso de percepción al planificador.
El atractivo es el mismo que en manipulación: situaciones raras que ninguna regla anticipó, resueltas por un modelo que ha visto suficiente mundo como para razonar en vez de bloquearse.
Este es el campo más incipiente de la lista.
La idea: un sistema capaz de seguir instrucciones habladas del cirujano y ajustarse a variaciones del tejido supera a uno rígidamente programado, pero la aprobación regulatoria es el gran freno aquí, no la capacidad del modelo.
Antes veremos aplicaciones asistivas y de formación que algo cercano a lo autónomo.
Aunque los VLA son potentes, todavía flojean en cuatro áreas concretas:
Manejan razonablemente bien la variación al inicio, pero cuando un agarre resbala a mitad o un objeto se desplaza bajo la pinza, la recuperación es irregular.
La mayoría de datos de demostración capturan intentos exitosos, así que el modelo ha visto pocos ejemplos de cómo recuperarse de un error.
La manipulación fina requiere un bucle de control de 10 a 100 Hz, y hacer que un modelo de 7.000 millones o más alcance esa tasa en el hardware del robot todavía es aspiracional.
Por eso la mayoría de despliegues se conectan a un servidor de borde o separan razonamiento y control, como Gemini Robotics 1.5.
Cuantización, salto de capas y destilación ayudan, pero aún son apaños en evolución, no soluciones cerradas.
Ahora que hay pesos abiertos capaces al alcance de cualquiera, los datos son el verdadero factor diferencial.
Recoger datos diversos y bien anotados por teleoperación es lento y caro como no lo fue raspar la web, y la brecha entre los resultados publicados de pi0 y lo que se ha replicado solo con datos públicos lo evidencia.
Los VLA actuales generalizan bien dentro de su distribución de entrenamiento y se degradan fuera de ella.
Un modelo entrenado en 22 morfologías para manipulación de sobremesa puede rendir mal ante una forma de tarea que nunca haya visto.
Como ves, los modelos VLA integran percepción, comprensión del lenguaje y generación de acciones en una sola arquitectura, y eso es un cambio estructural, no incremental.
Lo que consiguen y el control clásico no es generalizar a condiciones para las que nadie los entrenó explícitamente, porque las columnas de lenguaje y visión ya aportan al robot un modelo funcional del mundo físico antes de ver una demostración.
Lo que más me sorprende de 2026 es cómo ha cambiado la gran pregunta.
Hace tres años la pregunta difícil era la arquitectura.
Ahora que OpenVLA, Octo, pi0 y SmolVLA están en GitHub para descargar, las preguntas difíciles son la calidad de los datos, la recuperación ante fallos y si puedes ejecutar todo esto a 50 Hz en el propio robot y no en un data center.
Si quieres seguir, el curso Introduction to AI Agents de DataCamp cubre el contexto agente y Large Language Models (LLMs) Concepts cubre la parte de la columna.
Top DataCamp Courses
{count, plural, one {Curso} other {Cursos}}
{count, plural, one {Curso} other {Cursos}}
{count, plural, one {Curso} other {Cursos}}
{count, plural, one {blog} other {blogs}}
Bhavishya Pandit
8 min
{count, plural, one {blog} other {blogs}}
Stanislav Karzhev
9 min
{count, plural, one {blog} other {blogs}}
Natassha Selvaraj
15 min
{count, plural, one {Tutorial} other {Tutoriales}}
Josep Ferrer
11 min
{count, plural, one {Tutorial} other {Tutoriales}}
Arunn Thevapalan
12 min
{count, plural, one {Tutorial} other {Tutoriales}}
Zoumana Keita
12 min