Stell dir vor, du sagst jemandem: “Nimm die Tasse und stell sie ins Regal.” Die Person braucht keinen Plan: Sie schaut auf die Tasse, versteht den Satz und greift hin.
Gleichzeitig passieren hier drei Dinge. Sehen, Verstehen und Bewegen laufen fast parallel ab, nicht als drei getrennte Schritte, die zwischen Hirnarealen hin- und hergereicht werden.
Über weite Strecken der robotischen KI war das bei Maschinen ganz anders.
Früher gab es Vision-Language-Modelle, die eine unordentliche Werkbank betrachten und exakt beschreiben konnten, was darauf liegt – bis hin zur Markenaufschrift auf einem Werkzeug.
Klassische Robotersteuerungen konnten diesen Schraubendreher zuverlässig greifen – solange ihn niemand zwei Zentimeter nach links verschob. Sehen und Verstehen auf der einen Seite und Handeln auf der anderen entwickelten sich nahezu vollständig getrennt.
Genau hier setzen Vision-Language-Action-Modelle (VLA) an – sie schließen diese Lücke.
In diesem Artikel schauen wir uns an, was VLA-Modelle sind und wie ihre dreiteilige Architektur funktioniert. Wir vergleichen sie mit Vision-Language-Modellen (VLMs) und klassischer Robotersteuerung, betrachten die Modelle, die 2026 wirklich zählen, und wo sie zum Einsatz kommen. Zum Schluss sehen wir uns an, wo VLAs noch danebenliegen.
Was sind Vision-Language-Action (VLA) Modelle?
Starten wir mit einer formalen Definition:
Ein Vision-Language-Action-Modell ist ein KI-System, das einen Kamerafeed, eine Anweisung in natürlicher Sprache und den Eigenzustand des Roboters verarbeitet und daraus Motorbefehle erzeugt – mit gemeinsam trainierten Vision-, Sprach- und Aktionsmodulen in einem einzigen Forward Pass statt in einer klassischen Wahrnehmung-→Planung-→Regelung-Pipeline.
Entscheidend ist, dass Wahrnehmung, Sprache und Aktion nicht als getrennte Systeme über handgeschriebenen Glue-Code zusammengeflickt sind.
Sie sind als Untermodule gemeinsam trainiert. Ein Sicht- oder Sprachfehler, der eine klassische Pipeline beim Handover aus dem Tritt bringen würde, wird durch Gradientenabstieg korrigiert – nicht (vielleicht) von einer hart codierten Schnittstelle abgefangen.
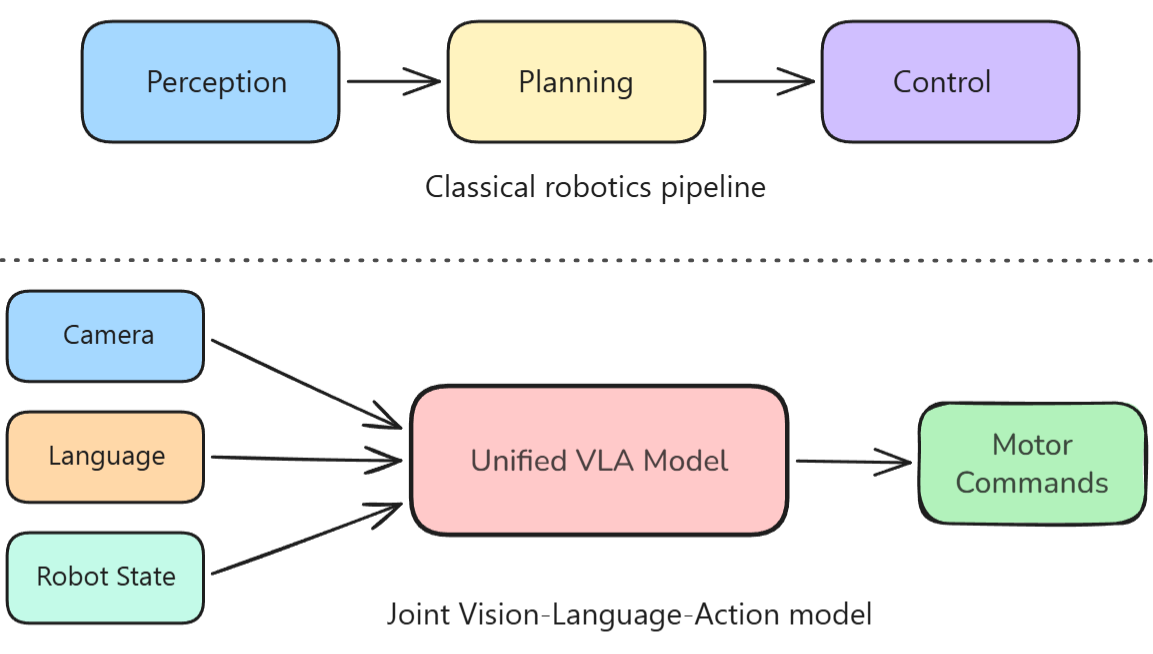
Oben drei Kästen und zwei fragile Übergaben, unten ein verschmolzenes Modell. Das ist genau der strukturelle Unterschied, von dem ich spreche. Bild: Autor.
Ich formuliere es gern so: Ein VLM ist ein Gehirn ohne Körper – ein VLA gibt ihm einen.
Die Wahrnehmung ist kein externer Dienst, den der Roboter aufruft, sondern fest in die gemeinsam trainierte Pipeline verdrahtet, die entscheidet, wie weit der Greifer fährt.
Ich habe bereits VLMs erwähnt – also vergleichen wir die beiden Architekturen.
VLA vs. Vision-Language-Model (VLM)
Ein VLM (Vision-Language Model) nimmt Bilder und Text auf und erzeugt Text oder Embeddings.
Ein VLA (Vision-Language-Action-Model) nimmt die gleichen Eingaben – erzeugt aber stattdessen eine Aktion.
Das klingt nach einem kleinen Unterschied – bis du siehst, was das downstream bedeutet:
| |
Vision-Language-Model (VLM)
|
Vision-Language-Action-Model (VLA)
|
|---|
|
Input
|
Bilder, Video, Text
|
Bilder (oft mehrere Kameras), Text, propriozeptiver Roboterzustand
|
|
Output
|
Text, Embeddings
|
Kontinuierliche oder diskretisierte Motorbefehle
|
|
Primäre Fähigkeit
|
Szenen beschreiben und darüber schlussfolgern
|
In einer Szene handeln
|
|
Kann es in der Welt agieren?
|
Nein
|
Ja
|
|
Trainingsdaten
|
Bild-Text-Paare aus dem Web
|
Webdaten plus Roboter-Demonstrationstrajektorien
|
|
Typische Anwendung
|
Visuelles Question Answering, Captioning, Dokumentenparsing
|
Manipulation, Navigation, humanoide Steuerung
|
Du hast sicher schon von Modellen wie GPT-4V, Gemini oder LLaVA gehört.
Oft wird angenommen, ein VLA sei einfach eines davon mit einem Roboterarm daran.
So einfach ist es nicht.
Das Modell muss einen völlig neuen Outputraum lernen, in dem ein Token einer realen physikalischen Größe entspricht – etwa einer Endeffektor-Verschiebung oder der Greiferöffnung – und ein Fehler nicht nur einen schrägen Satz erzeugt, sondern eine Tasse vom Tisch stößt.
Wenn du sehen willst, wie GPT-4V, Gemini und LLaVA im Feld abschneiden, bietet DataCamps Top 10 Vision Language Models 2026 eine gute Übersicht der führenden Modelle.
Das hat auch Folgen auf der Datenseite.
Ein VLM kann auf Milliarden Bild-Text-Paaren trainieren, weil das Internet sie praktisch gratis liefert.
Robotertrajektorien dagegen müssen von einem echten Roboter bei echten Aufgaben gesammelt werden – meist per Teleoperation. Darum kommt das größte offene Robotik-Dataset, Open X-Embodiment, auf rund 1 Million Trajektorien statt auf 1 Milliarde.
Die manuelle Erfassung solcher Trajektorien ist zudem teuer und langsam.
22 Embodiments, ein Dataset und trotzdem unter 1 Million Trajektorien insgesamt. So skalieren Roboterdaten eben nicht wie Webtext. Quelle: Open X-Embodiment Projektseite.
VLA vs. klassische Robotersteuerung
Bevor wir in die VLA-Architektur einsteigen, vergleichen wir sie kurz mit klassischer Robotersteuerung.
Klassische Steuerung ist für eine Aufgabe an einem Ort gebaut – unter Bedingungen, die vorher fixiert wurden.
Nimm zum Beispiel den Greifarm eines Snackautomaten.
Er greift jedes Mal denselben Snack am selben Platz im selben Regal, weil Beleuchtung, Objektpositionen und Bewegungen sich zwischen den Picks nicht ändern.
Diese enge, konstante Umgebung erlaubt ein starres, aber zuverlässiges Regelungssystem.
Verändern wir jetzt das Innenleben des Automaten, die Beleuchtung oder fügen ein unbekanntes Objekt hinzu,
scheitert der Controller komplett – er hat diese Situation nie gesehen.
Ein VLA generalisiert besser auf Bedingungen, auf die er nie explizit trainiert wurde. Grund: Das zugrunde liegende VLM-Backbone weiß durch Pretraining im Web bereits, wie eine Tasse, ein Handtuch oder eine Schublade aussieht – noch bevor es je eine Roboter-Demo sah.
Feintuning auf hundert Beispielen fürs Handtuchfalten reicht, damit es lernt, wie es sich bewegen muss – ein Objekt erkennt es ja schon.
Dieser Transfer ist der eigentliche Durchbruch – nicht die Rohpräzision, und ein gut getunter klassischer Controller schlägt ein VLA in einer festen, kontrollierten Umgebung weiterhin in Sachen Präzision.
Wie funktionieren VLA-Modelle?
Schauen wir tief in die Architektur.
Wir nehmen hier die OpenVLA-Architektur, weil sie gut nachvollziehbar ist.
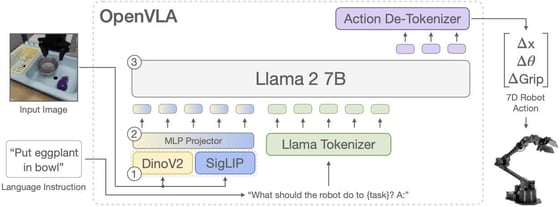
Die Pipeline, die ich unten beschreibe: DINOv2 und SigLIP speisen ein Llama-2-Backbone, der Aktionsdecoder sagt diskrete Tokens vorher. Quelle: OpenVLA Projektseite.
Ein VLA hat drei Module:
- Einen Vision-Encoder
- Ein Sprach-Backbone
- Einen Aktionsdecoder
Diese werden End-to-End gemeinsam trainiert.
Vision- und Sprachrepräsentationen werden fusioniert; diese kombinierte Repräsentation übersetzt der Aktionsdecoder in Motorbefehle.
Wichtig: Die drei Teile sind eng gekoppelt statt gepipelined – das unterscheidet ein VLA grundsätzlich von einem VLM, das nur auf eine Steuerung aufgesetzt wurde.
Wenn es hilft: Denk an die Aufteilung Sehen, Gedächtnis, Controller aus dem World-Models-Paper: Es sieht, versteht, handelt.
Der Unterschied: Ein VLA lernt alle drei Aufgaben gemeinsam, End-to-End, aus Demonstrationen – anstatt jedes Teil separat zu trainieren und dann zusammenzuflicken.
Schauen wir sie uns einzeln an.
Vision-Encoder: Was das Modell sieht
Der Vision-Encoder verwandelt rohe Kamerabilder in eine dichte Repräsentation, mit der das Netzwerk arbeiten kann.
Moderne VLAs nutzen vortrainierte Vision-Transformer wie DINOv2 oder SigLIP – oft beide zugleich.
OpenVLA ist ein gutes Beispiel für diese Kombination.
Es fusioniert DINOv2, stark bei räumlich-geometrischen Details, mit SigLIP, das semantische, sprachnahe Merkmale besser erfasst.
Die beiden Feature-Sätze werden patchweise konkateniert und in den Embedding-Raum des Sprachmodells projiziert (hier: Llama 2 7B).
Mehr als eine Kamera zu nutzen, ist im Einsatz Standard.
Eine Handgelenk-Kamera liefert Nahdetails beim Endanflug, eine Overhead-Kamera den Szenenaufbau, die Seitenansicht hilft bei der Tiefe, die eine einzelne Kamera nicht sicher rekonstruiert.
pi0 (unten mehr dazu) verarbeitet mehrere Kameraansichten plus den propriozeptiven Zustand des Roboters.
Wichtig: Zustandsinput ist relevanter, als es klingt – ein Bild des Arms verrät nicht, welche Drehmomente aktuell in den Gelenken anliegen.
Sprach-Encoder: Was dem Modell gesagt wird
Die Sprachseite kodiert eine Anweisung wie “Heb den roten Block auf und leg ihn in die blaue Kiste” in eine Repräsentation, die sich mit visuellen Features im selben Raum deckt.
Nahezu jedes VLA nutzt ein vortrainiertes Large Language Model (LLM) als Backbone, statt einen Textencoder bei Null zu starten.
Im Fall OpenVLA kam Llama 2 7B zum Einsatz. pi0 und pi0.5 bauten auf PaliGemma (3 Milliarden Parameter), SmolVLA auf einem modifizierten SmolVLM2-Stack.
Der Nutzen liegt in der Vererbung.
Man bekommt Befolgung von Anweisungen und kompositionelles Verständnis quasi gratis – daher kann ein VLA oft “Leg das Obst in die Schüssel” ausführen, ohne genau diesen Satz je im Robotik-Training gesehen zu haben.
Aktionsdecoder: Was das Modell tut
Im Aktionsdecoder wird die fusionierte Repräsentation zu Motorbefehlen. Hier unterscheiden sich VLA-Designs am stärksten. Derzeit gibt es drei gängige Ansätze.
Autoregressive Token-Vorhersage
Du zerlegst jede Aktionsdimension in diskrete Bins und sagst sie nacheinander voraus – wie bei der Next-Token-Vorhersage von LLMs.
OpenVLA nutzt 256 Bins pro Dimension und einen normalen Next-Token-Loss – gängige LLM-Tooling bleibt nutzbar.
Man verliert jedoch Auflösung und Geschwindigkeit: Die Binning-Quantisierung macht Bewegungen kantig, und Token-für-Token-Sampling ist zu langsam für schnelle oder kontaktintensive Aufgaben.
Diffusion und Flow-Matching-Decoding
Statt ein Token nach dem anderen vorherzusagen, behandelt das Modell die Aktionsgenerierung als Denoising-Prozess und erzeugt einen ganzen Block kontinuierlicher Aktionen auf einmal.
pi0 war das erste VLA mit einem Flow-Matching-Action-Head: In rund 10 Schritten werden bis zu 50 zukünftige Aktionen erzeugt.
Das macht die resultierenden Bewegungen deutlich flüssiger als bei Token-basierten Ansätzen.
Hybride Zwei-Ebenen-Architekturen
Ein größeres Modell übernimmt High-Level-Reasoning und zerlegt die Aufgabe in Schritte, ein kleiner, schneller Controller führt präzise mit hoher Frequenz aus.
Ein gutes Beispiel ist Gemini Robotics 1.5 – ein Reasoning-Modell plus Aktionsmodell.
Meiner Meinung nach steckt in vielen Papers zu viel Energie in die Backbone-Größe und zu wenig in den Aktionskopf – das ist die falsche Stelle zu sparen.
Wenn dein Decoder einen 7-dimensionalen kontinuierlichen Aktionsraum auf 256 Bins quetscht, holt die beste Backbone-Qualität die Glätte nicht zurück!
Wichtige VLA-Modelle 2026
Hier eine Tabelle mit zentralen VLA-Modellen, denen du 2026 wahrscheinlich begegnest:
|
Modell
|
Entwickler
|
Parameter
|
Aktionskopf
|
Lizenz
|
Hardware
|
Am besten für
|
|---|
|
OpenVLA
|
Stanford, Berkeley und Partner
|
7B
|
Autoregressive Tokens
|
MIT
|
A100 oder H100, oder 24GB mit 4-Bit-Quantisierung
|
Offener Forschungs-Baseline
|
|
Octo
|
UC Berkeley
|
27M oder 93M
|
Diffusions-Policy
|
MIT
|
Eine einzelne RTX 4090
|
Compute-limitierte Szenarien
|
|
pi0 / pi0.5 / pi0.6
|
Physical Intelligence
|
3,3B (3B Backbone plus 300M Action-Expert)
|
Flow Matching
|
Offene Checkpoints (openpi)
|
Multi-GPU oder eine einzelne A100
|
Geschickte, langschrittige Aufgaben
|
|
Gemini Robotics 1.5
|
Google DeepMind
|
Nicht offengelegt
|
Hybrid, Cloud plus Edge
|
Geschlossen
|
Cloud-gebunden
|
Proprietärer Frontier-Baseline
|
|
SmolVLA
|
Hugging Face
|
450M
|
Flow Matching
|
Apache 2.0
|
RTX 3060, Laptop-GPU oder Jetson
|
Hobby- und Edge-Robotik
|
Gehen wir sie im Detail durch – beginnend mit dem Forschungsbaseline, an dem noch viele messen.
OpenVLA
OpenVLA ist ein 7-Milliarden-Parameter-Modell, trainiert auf 970.000 realen Roboter-Demonstrationen aus Open X-Embodiment.
Es kombiniert ein Llama 2 7B-Backbone mit dem fusionierten DINOv2- und SigLIP-Vision-Encoder und ist komplett Open Source.
Überraschend war, dass es das geschlossene RT-2-X-Modell um 16,5 Prozentpunkte Task-Erfolg über 29 Aufgaben schlug – obwohl RT-2-X mit 55 Milliarden Parametern gegen die 7 Milliarden von OpenVLA antrat!
Das Training lief 15 Tage auf 64 A100-GPUs.
Beliebt bleibt es, weil LoRA-Feintuning und 4-Bit-Quantisierung sehr gut funktionieren.
Eine 24GB RTX 4090 kann eine quantisierte Version ausführen. Daher nutzen viele veröffentlichte Arbeiten zu Angriffen, Absicherungen und Pruning in VLAs OpenVLA als Ziel – es ist einfach extrem zugänglich.
Ein Follow-up – OpenVLA-OFT – verbesserte das Feintuning-Rezept in Tempo und Erfolgsrate.
Octo
Octo ist ein kleines VLA in zwei Größen: 27 Mio. und 93 Mio. Parameter auf ViT-S bzw. ViT-B Backbones und läuft mit 20–30 Hz auf einer einzelnen RTX 4090.
Trainiert wurde es auf rund 800.000 Trajektorien aus Open X-Embodiment über 22 Roboterausführungen hinweg; die Transformer-Architektur ist wirklich modular.
Du kannst beim Feintuning neue Sensor-Inputs hinzufügen oder den Aktionskopf tauschen, ohne das Modell neu aufzubauen – es unterstützt je nach Bedarf diskrete Tokens und Diffusions-basierte kontinuierliche Aktionen.
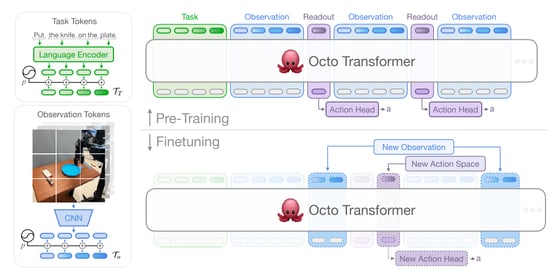
Der Octo-Transformer: Task- und Beobachtungstokens rein, Readout-Tokens raus zum Aktionskopf – mit Platz für neue Sensoren oder Aktionsräume beim Feintuning. Quelle: Octo-Paper.
Ich greife zu Octo, wenn der limitierende Faktor Rechenleistung ist – nicht die Aufgabenkomplexität.
Es unterstützt zudem Zielbild-Conditioning – praktisch, wenn ein Foto des Sollzustands klarer ist als eine textliche Beschreibung.
pi0 und die Physical-Intelligence-Familie
pi0 von Physical Intelligence ist äußerst geschickt. Es startet von PaliGemma (3 Mrd. Parameter, offenes VLM) und ergänzt einen 300-Mio.-Parameter Aktions-Experten, insgesamt 3,3 Mrd. Parameter.
Per Flow Matching erzeugt es bis zu 50 zukünftige Aktionen in einem Block statt schrittweise.
Schlüsselresultate waren bimanuale Aufgaben wie Wäschefalten, Lebensmitteltaschen packen und Kartons falten – mit einer Fingerfertigkeit, die es so zuvor nicht gab.
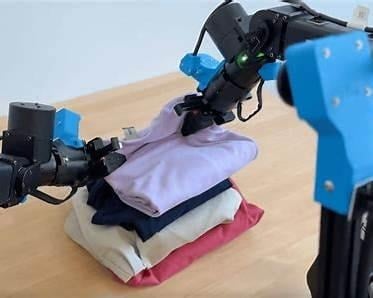
pi0 faltet Wäsche mit zwei Armen. Eine der erwähnten Bimanual-Aufgaben – ansehen lohnt mehr als lesen. Quelle: Physical Intelligence, “pi0: Our First Generalist Policy”.
Flow Matching ist hier der Gamechanger, denn zwei Arme zu koordinieren verlangt glatte, kontinuierliche 16-dimensionale Outputs – weder diskrete Tokens noch langsames Diffusions-Sampling liefern das in nutzbarer Geschwindigkeit.
Die pi0-Familie entwickelt sich weiter:
- pi0.5 (April 2025): führte Open-World-Generalisation ein: erst wird ein High-Level-Teilschritt in Worten vorhergesagt, dann die Low-Level-Aktion
- pi0.6 (November 2025): lernt aus eigener Roboterefahrung statt nur aus Demonstrationen
- openpi: Checkpoints und eine angenäherte Trainingspipeline im openpi-Repository, vortrainiert auf über 10.000 Stunden Roboterdaten
Ein Vorbehalt: Die stärksten Zahlen von pi0 basieren auf proprietären Daten aus der eigenen Roboterflotte.
Außerhalb des Unternehmens hat das noch niemand mit rein öffentlichen Daten reproduziert – wie viel Performance also von der Architektur und wie viel vom Datenvorsprung kommt, ist weiterhin offen.
Gemini Robotics 1.5
Gemini Robotics 1.5 von Google DeepMind ist am besten als Zusammenarbeit zweier Modelle zu verstehen.
Gemini Robotics-ER 1.5 ist ein embodied Reasoning-Modell, das plant, Tools wie die Google-Suche aufruft und seinen Fortschritt einschätzt.
Gemini Robotics 1.5 ist das VLA, das die geplanten Schritte ausführt.
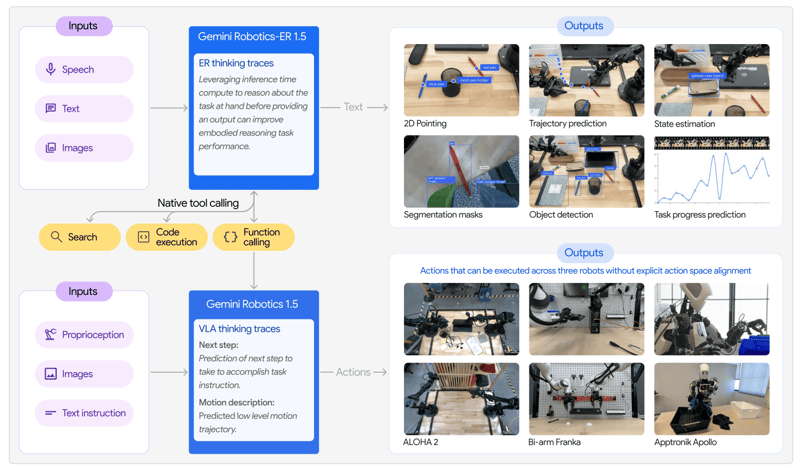
Oben Gemini Robotics-ER 1.5 fürs embodied Reasoning, unten Gemini Robotics 1.5 als VLA, dazwischen gemeinsames Tool-Calling, Aktionen laufen auf ALOHA 2, Franka und Apollo ohne Alignment des Aktionsraums. Quelle: Gemini Robotics 1.5 Paper.
Nützlich ist, dass Aktionen mit einem internen, natürlichsprachlichen Denkprozess verknüpft sind – der Roboter denkt vor dem Handeln und kann Entscheidungen im Nachhinein erklären.
Bei einer Anweisung wie “Sortiere meine Wäsche nach Farben” leitet er zunächst ab, dass Weißes in einen Behälter kommt und der Rest in einen anderen, und plant dann die einzelnen Griffe.
DeepMind berichtet rund 250 Millisekunden von Beobachtung bis Aktion (effektiv 50 Hz) – erreicht, indem das schwere Reasoning in der Cloud läuft und ein schlanker Aktionsdecoder lokal auf dem Roboter.
Bemerkenswert ist außerdem der Motion Transfer: Eine auf ALOHA 2 gelernte Aufgabe lief ohne Retraining auf einer Franka-Biarm-Konfiguration und auf Apptroniks humanoidem Apollo.
Die Gewichte sind geschlossen – betrachte es als proprietären Frontier-Baseline, nicht als etwas zum Selbst-Hosten.
SmolVLA
SmolVLA von Hugging Face umfasst 450 Mio. Parameter (Apache 2.0). Es kombiniert ein modifiziertes SmolVLM2-Backbone mit einem Flow-Matching-Aktions-Experten, nutzt Layer-Skipping und weniger visuelle Tokens, um Inferenz auf kleiner Hardware günstig zu halten.
Es läuft auf einer einzelnen Consumer-GPU (inkl. RTX 3060), auf der CPU eines MacBooks (langsam) und auf einem Jetson Orin direkt an Bord.
Feintuning über 20.000 Schritte dauert ca. 4–5 Stunden auf einer einzelnen A100.
Trotz weniger als 30.000 Episoden erreicht oder übertrifft es deutlich größere Modelle auf LIBERO, Meta-World sowie realen SO-100- und SO-101-Armen.
Das Beste: Das Pretraining basiert auf Community-Datasets über das LeRobot-Framework.
So wählst du ein VLA für dein Projekt
Nach den Modellen nun zur Auswahl für deinen Einsatzzweck.
Die Entscheidung hängt vor allem von Regelungsfrequenz und Hardware ab – nicht davon, wer letzten Monat auf einem Leaderboard vorne lag.
So würde ich vorgehen:
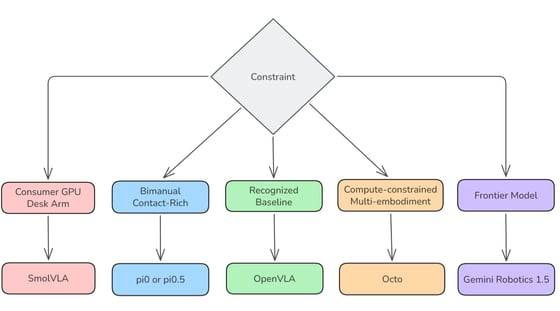
Fünf Constraints, fünf Modelle. Wenn du dir eine Grafik merken willst, dann diese. Bild: Autor.
Hast du eine Consumer-GPU oder einen SO-101-Arm auf dem Schreibtisch, starte mit SmolVLA. Nichts anderes im offenen Ökosystem liefert so günstig eine funktionierende Policy.
- Für kontaktreiche oder bimanuale Manipulation: direkt zu pi0 oder pi0.5. Der Flow-Matching-Kopf ist dafür ideal.
- Schreibst du ein Paper und brauchst einen Baseline, den Reviewer kennen, nimm OpenVLA – es liegt allen vor.
- Ist Compute der Engpass, du brauchst aber Multi-Embodiment-Support, ist Octo die sinnvolle Wahl.
- Willst du sehen, was an der Spitze möglich ist, schau dir Gemini Robotics 1.5 an – mit dem Verständnis, dass du es nicht selbst hosten kannst.
Und zuletzt: Hundert saubere Demos auf SmolVLA schlagen fünfzig chaotische auf OpenVLA fast immer.
Heißt: Investiere 60–70 Prozent der Projektzeit in Datenerfassung und Qualitätssicherung – der Rest geht ins Training.
Einsatzgebiete von VLA-Modellen
VLAs sind aus Demos heraus und in einige reale Deployments hineingewachsen – wenn auch ungleichmäßig.
Mein Muster: Sie landen zuerst dort, wo die Umgebung zu variabel für Scripting ist, aber Menschen bei Bedarf eingreifen können. Beispiele:
Robotische Manipulation
Das Hauptfeld: Pick-and-Place, Kitting, Verpacken, Sortieren, Montage etc.
Hier muss der Roboter Objekte erkennen, greifen und neu positionieren – bei wechselnden Lagen und Orientierungen –, genau das, was Skripte schlecht abdecken.
Lager- und Fulfillment-Aufgaben sind aktuell der klarste Business-Case. Ein geskripteter Picker braucht immer dieselbe Präsentation, ein VLA-basierter arbeitet eine Kiste mit vierzig gemischten SKUs ab.
Humanoide Roboter
Figure, 1X und Apptronik bauen auf VLA-Grundlagen – logisch: Ein zweibeiniger Roboter mit zwei Händen hat zu viele mögliche Aufgaben fürs Durchskripten.
Der Motion-Transfer von Gemini Robotics – eine auf ALOHA 2 gelernte Fähigkeit läuft direkt auf Apptroniks Apollo – ist genau die Eigenschaft, die ein skalierendes Humanoid-Programm braucht.
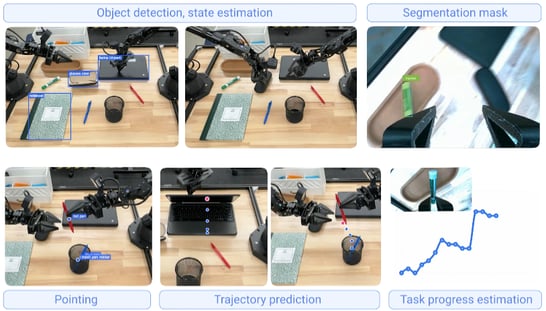
Dieselbe Fähigkeit, einmal auf ALOHA 2 trainiert, läuft auf Apptroniks humanoidem Apollo ohne Retraining. Quelle: Google DeepMind, “Gemini Robotics 1.5 brings AI agents into the physical world”.
Autonome Fahrzeuge
Fahr-Stacks übernehmen zunehmend VLA-ähnliche Architekturen: Was das Auto sieht und als Nächstes tun soll, läuft in einer Schleife – nicht per Handover vom Perzeptions- zum Planungsmodul.
Der Vorteil ist derselbe wie bei Manipulation: seltene, unvorhergesehene Situationen werden von einem Modell gehandhabt, das genug Welt gesehen hat, um darüber zu schlussfolgern – statt zu erstarren.
Chirurgische und medizinische Robotik
Das ist das früheste Stadium in dieser Liste.
Die Idee: Ein System, das verbale Anweisungen eines Chirurgen befolgt und sich an Gewebevariabilität anpasst, ist einem starr programmierten überlegen – aber die Zulassung ist hier der Engpass, nicht die Modellfähigkeit.
Erwarte Assistenz- und Trainingsanwendungen lange vor irgendetwas Autonomem.
Vision-Language-Action-Modelle: Herausforderungen und Grenzen
So gut VLAs auch sind – sie haben Schwächen, vor allem in vier Bereichen:
Erholung mitten in der Aufgabe
Variation zu Beginn einer Aufgabe meistern VLAs recht gut. Rutscht der Griff aber mittendrin ab oder verschiebt sich ein Objekt, ist die Erholung inkonsistent.
Die meisten Demos zeigen erfolgreiche Versuche – Beispiele für das Erholen nach Fehlern sind rar.
On-Device-Inferenz
Feinmanipulation braucht 10–100 Hz. Ein Modell mit 7+ Milliarden Parametern lokal auf dem Roboter auf diese Rate zu bringen, ist eher Zielbild als gelöste Ingenieursaufgabe.
Darum sind produktive Systeme meist per Edge-Server angebunden oder trennen Reasoning und Kontrolle – wie Gemini Robotics 1.5.
Quantisierung, Layer-Skipping und Distillation helfen, sind aber Workarounds in Arbeit – keine endgültigen Lösungen.
Der Daten-Flaschenhals
Da es inzwischen fähige offene Gewichte zum Download gibt, sind Daten der echte Differenzierer.
Diverse, gut annotierte Teleoperationsdaten zu sammeln ist langsam und teuer – ganz anders als Webscraping. Die Lücke zwischen pi0s veröffentlichten Ergebnissen und dem, was mit rein öffentlichen Daten reproduziert wurde, zeigt sehr deutlich, was ein privater Datenvorsprung bringt.
Generalisation außerhalb der Verteilung
Aktuelle VLAs generalisieren innerhalb ihrer Trainingsverteilung gut und bauen außerhalb spürbar ab.
Ein über 22 Embodiments auf Tischmanipulation trainiertes Modell kann bei einer wirklich neuen Aufgabenform dennoch schlecht abschneiden.
Fazit
VLA-Modelle vereinen Wahrnehmung, Sprachverständnis und Aktionsgenerierung in einer Architektur – das ist ein Strukturwandel, kein inkrementeller Schritt.
Sie können etwas, das klassische Regelung nie schaffte: auf Bedingungen generalisieren, auf die niemand sie explizit trainierte – weil Sprach- und Visions-Backbones dem Roboter schon vor der ersten Demo ein funktionierendes Weltmodell mitgeben.
Was mich 2026 am meisten überrascht: Die harte Frage hat sich verlagert.
Vor drei Jahren war es die Architektur.
Jetzt, wo OpenVLA, Octo, pi0 und SmolVLA auf GitHub für alle liegen, geht es um Datenqualität, Recovery-Verhalten und die Frage, ob du das alles wirklich mit 50 Hz auf dem Roboter selbst laufen lassen kannst – statt im Rechenzentrum.
Wenn du weitermachen willst: DataCamps Introduction to AI Agents deckt den weiteren agentischen Kontext ab, und Large Language Models (LLMs) Concepts behandelt die Backbone-Seite.




Stell dir vor, du sagst jemandem: “Nimm die Tasse und stell sie ins Regal.” Die Person braucht keinen Plan: Sie schaut auf die Tasse, versteht den Satz und greift hin.
Gleichzeitig passieren hier drei Dinge. Sehen, Verstehen und Bewegen laufen fast parallel ab, nicht als drei getrennte Schritte, die zwischen Hirnarealen hin- und hergereicht werden.
Über weite Strecken der robotischen KI war das bei Maschinen ganz anders.
Früher gab es Vision-Language-Modelle, die eine unordentliche Werkbank betrachten und exakt beschreiben konnten, was darauf liegt – bis hin zur Markenaufschrift auf einem Werkzeug.
Klassische Robotersteuerungen konnten diesen Schraubendreher zuverlässig greifen – solange ihn niemand zwei Zentimeter nach links verschob. Sehen und Verstehen auf der einen Seite und Handeln auf der anderen entwickelten sich nahezu vollständig getrennt.
Genau hier setzen Vision-Language-Action-Modelle (VLA) an – sie schließen diese Lücke.
In diesem Artikel schauen wir uns an, was VLA-Modelle sind und wie ihre dreiteilige Architektur funktioniert. Wir vergleichen sie mit Vision-Language-Modellen (VLMs) und klassischer Robotersteuerung, betrachten die Modelle, die 2026 wirklich zählen, und wo sie zum Einsatz kommen. Zum Schluss sehen wir uns an, wo VLAs noch danebenliegen.
Was sind Vision-Language-Action (VLA) Modelle?
Starten wir mit einer formalen Definition:
Ein Vision-Language-Action-Modell ist ein KI-System, das einen Kamerafeed, eine Anweisung in natürlicher Sprache und den Eigenzustand des Roboters verarbeitet und daraus Motorbefehle erzeugt – mit gemeinsam trainierten Vision-, Sprach- und Aktionsmodulen in einem einzigen Forward Pass statt in einer klassischen Wahrnehmung-→Planung-→Regelung-Pipeline.
Entscheidend ist, dass Wahrnehmung, Sprache und Aktion nicht als getrennte Systeme über handgeschriebenen Glue-Code zusammengeflickt sind.
Sie sind als Untermodule gemeinsam trainiert. Ein Sicht- oder Sprachfehler, der eine klassische Pipeline beim Handover aus dem Tritt bringen würde, wird durch Gradientenabstieg korrigiert – nicht (vielleicht) von einer hart codierten Schnittstelle abgefangen.
Oben drei Kästen und zwei fragile Übergaben, unten ein verschmolzenes Modell. Das ist genau der strukturelle Unterschied, von dem ich spreche. Bild: Autor.
Ich formuliere es gern so: Ein VLM ist ein Gehirn ohne Körper – ein VLA gibt ihm einen.
Die Wahrnehmung ist kein externer Dienst, den der Roboter aufruft, sondern fest in die gemeinsam trainierte Pipeline verdrahtet, die entscheidet, wie weit der Greifer fährt.
Ich habe bereits VLMs erwähnt – also vergleichen wir die beiden Architekturen.
VLA vs. Vision-Language-Model (VLM)
Ein VLM (Vision-Language Model) nimmt Bilder und Text auf und erzeugt Text oder Embeddings.
Ein VLA (Vision-Language-Action-Model) nimmt die gleichen Eingaben – erzeugt aber stattdessen eine Aktion.
Das klingt nach einem kleinen Unterschied – bis du siehst, was das downstream bedeutet:
Vision-Language-Model (VLM)
Vision-Language-Action-Model (VLA)
Input
Bilder, Video, Text
Bilder (oft mehrere Kameras), Text, propriozeptiver Roboterzustand
Output
Text, Embeddings
Kontinuierliche oder diskretisierte Motorbefehle
Primäre Fähigkeit
Szenen beschreiben und darüber schlussfolgern
In einer Szene handeln
Kann es in der Welt agieren?
Nein
Ja
Trainingsdaten
Bild-Text-Paare aus dem Web
Webdaten plus Roboter-Demonstrationstrajektorien
Typische Anwendung
Visuelles Question Answering, Captioning, Dokumentenparsing
Manipulation, Navigation, humanoide Steuerung
Du hast sicher schon von Modellen wie GPT-4V, Gemini oder LLaVA gehört.
Oft wird angenommen, ein VLA sei einfach eines davon mit einem Roboterarm daran.
So einfach ist es nicht.
Das Modell muss einen völlig neuen Outputraum lernen, in dem ein Token einer realen physikalischen Größe entspricht – etwa einer Endeffektor-Verschiebung oder der Greiferöffnung – und ein Fehler nicht nur einen schrägen Satz erzeugt, sondern eine Tasse vom Tisch stößt.
Wenn du sehen willst, wie GPT-4V, Gemini und LLaVA im Feld abschneiden, bietet DataCamps Top 10 Vision Language Models 2026 eine gute Übersicht der führenden Modelle.
Das hat auch Folgen auf der Datenseite.
Ein VLM kann auf Milliarden Bild-Text-Paaren trainieren, weil das Internet sie praktisch gratis liefert.
Robotertrajektorien dagegen müssen von einem echten Roboter bei echten Aufgaben gesammelt werden – meist per Teleoperation. Darum kommt das größte offene Robotik-Dataset, Open X-Embodiment, auf rund 1 Million Trajektorien statt auf 1 Milliarde.
Die manuelle Erfassung solcher Trajektorien ist zudem teuer und langsam.
22 Embodiments, ein Dataset und trotzdem unter 1 Million Trajektorien insgesamt. So skalieren Roboterdaten eben nicht wie Webtext. Quelle: Open X-Embodiment Projektseite.
VLA vs. klassische Robotersteuerung
Bevor wir in die VLA-Architektur einsteigen, vergleichen wir sie kurz mit klassischer Robotersteuerung.
Klassische Steuerung ist für eine Aufgabe an einem Ort gebaut – unter Bedingungen, die vorher fixiert wurden.
Nimm zum Beispiel den Greifarm eines Snackautomaten.
Er greift jedes Mal denselben Snack am selben Platz im selben Regal, weil Beleuchtung, Objektpositionen und Bewegungen sich zwischen den Picks nicht ändern.
Diese enge, konstante Umgebung erlaubt ein starres, aber zuverlässiges Regelungssystem.
Verändern wir jetzt das Innenleben des Automaten, die Beleuchtung oder fügen ein unbekanntes Objekt hinzu,
scheitert der Controller komplett – er hat diese Situation nie gesehen.
Ein VLA generalisiert besser auf Bedingungen, auf die er nie explizit trainiert wurde. Grund: Das zugrunde liegende VLM-Backbone weiß durch Pretraining im Web bereits, wie eine Tasse, ein Handtuch oder eine Schublade aussieht – noch bevor es je eine Roboter-Demo sah.
Feintuning auf hundert Beispielen fürs Handtuchfalten reicht, damit es lernt, wie es sich bewegen muss – ein Objekt erkennt es ja schon.
Dieser Transfer ist der eigentliche Durchbruch – nicht die Rohpräzision, und ein gut getunter klassischer Controller schlägt ein VLA in einer festen, kontrollierten Umgebung weiterhin in Sachen Präzision.
Wie funktionieren VLA-Modelle?
Schauen wir tief in die Architektur.
Wir nehmen hier die OpenVLA-Architektur, weil sie gut nachvollziehbar ist.
Die Pipeline, die ich unten beschreibe: DINOv2 und SigLIP speisen ein Llama-2-Backbone, der Aktionsdecoder sagt diskrete Tokens vorher. Quelle: OpenVLA Projektseite.
Ein VLA hat drei Module:
Diese werden End-to-End gemeinsam trainiert.
Vision- und Sprachrepräsentationen werden fusioniert; diese kombinierte Repräsentation übersetzt der Aktionsdecoder in Motorbefehle.
Wichtig: Die drei Teile sind eng gekoppelt statt gepipelined – das unterscheidet ein VLA grundsätzlich von einem VLM, das nur auf eine Steuerung aufgesetzt wurde.
Wenn es hilft: Denk an die Aufteilung Sehen, Gedächtnis, Controller aus dem World-Models-Paper: Es sieht, versteht, handelt.
Der Unterschied: Ein VLA lernt alle drei Aufgaben gemeinsam, End-to-End, aus Demonstrationen – anstatt jedes Teil separat zu trainieren und dann zusammenzuflicken.
Schauen wir sie uns einzeln an.
Vision-Encoder: Was das Modell sieht
Der Vision-Encoder verwandelt rohe Kamerabilder in eine dichte Repräsentation, mit der das Netzwerk arbeiten kann.
Moderne VLAs nutzen vortrainierte Vision-Transformer wie DINOv2 oder SigLIP – oft beide zugleich.
OpenVLA ist ein gutes Beispiel für diese Kombination.
Es fusioniert DINOv2, stark bei räumlich-geometrischen Details, mit SigLIP, das semantische, sprachnahe Merkmale besser erfasst.
Die beiden Feature-Sätze werden patchweise konkateniert und in den Embedding-Raum des Sprachmodells projiziert (hier: Llama 2 7B).
Mehr als eine Kamera zu nutzen, ist im Einsatz Standard.
Eine Handgelenk-Kamera liefert Nahdetails beim Endanflug, eine Overhead-Kamera den Szenenaufbau, die Seitenansicht hilft bei der Tiefe, die eine einzelne Kamera nicht sicher rekonstruiert.
pi0 (unten mehr dazu) verarbeitet mehrere Kameraansichten plus den propriozeptiven Zustand des Roboters.
Wichtig: Zustandsinput ist relevanter, als es klingt – ein Bild des Arms verrät nicht, welche Drehmomente aktuell in den Gelenken anliegen.
Sprach-Encoder: Was dem Modell gesagt wird
Die Sprachseite kodiert eine Anweisung wie “Heb den roten Block auf und leg ihn in die blaue Kiste” in eine Repräsentation, die sich mit visuellen Features im selben Raum deckt.
Nahezu jedes VLA nutzt ein vortrainiertes Large Language Model (LLM) als Backbone, statt einen Textencoder bei Null zu starten.
Im Fall OpenVLA kam Llama 2 7B zum Einsatz. pi0 und pi0.5 bauten auf PaliGemma (3 Milliarden Parameter), SmolVLA auf einem modifizierten SmolVLM2-Stack.
Der Nutzen liegt in der Vererbung.
Man bekommt Befolgung von Anweisungen und kompositionelles Verständnis quasi gratis – daher kann ein VLA oft “Leg das Obst in die Schüssel” ausführen, ohne genau diesen Satz je im Robotik-Training gesehen zu haben.
Aktionsdecoder: Was das Modell tut
Im Aktionsdecoder wird die fusionierte Repräsentation zu Motorbefehlen. Hier unterscheiden sich VLA-Designs am stärksten. Derzeit gibt es drei gängige Ansätze.
Autoregressive Token-Vorhersage
Du zerlegst jede Aktionsdimension in diskrete Bins und sagst sie nacheinander voraus – wie bei der Next-Token-Vorhersage von LLMs.
OpenVLA nutzt 256 Bins pro Dimension und einen normalen Next-Token-Loss – gängige LLM-Tooling bleibt nutzbar.
Man verliert jedoch Auflösung und Geschwindigkeit: Die Binning-Quantisierung macht Bewegungen kantig, und Token-für-Token-Sampling ist zu langsam für schnelle oder kontaktintensive Aufgaben.
Diffusion und Flow-Matching-Decoding
Statt ein Token nach dem anderen vorherzusagen, behandelt das Modell die Aktionsgenerierung als Denoising-Prozess und erzeugt einen ganzen Block kontinuierlicher Aktionen auf einmal.
pi0 war das erste VLA mit einem Flow-Matching-Action-Head: In rund 10 Schritten werden bis zu 50 zukünftige Aktionen erzeugt.
Das macht die resultierenden Bewegungen deutlich flüssiger als bei Token-basierten Ansätzen.
Hybride Zwei-Ebenen-Architekturen
Ein größeres Modell übernimmt High-Level-Reasoning und zerlegt die Aufgabe in Schritte, ein kleiner, schneller Controller führt präzise mit hoher Frequenz aus.
Ein gutes Beispiel ist Gemini Robotics 1.5 – ein Reasoning-Modell plus Aktionsmodell.
Meiner Meinung nach steckt in vielen Papers zu viel Energie in die Backbone-Größe und zu wenig in den Aktionskopf – das ist die falsche Stelle zu sparen.
Wenn dein Decoder einen 7-dimensionalen kontinuierlichen Aktionsraum auf 256 Bins quetscht, holt die beste Backbone-Qualität die Glätte nicht zurück!
Wichtige VLA-Modelle 2026
Hier eine Tabelle mit zentralen VLA-Modellen, denen du 2026 wahrscheinlich begegnest:
Modell
Entwickler
Parameter
Aktionskopf
Lizenz
Hardware
Am besten für
OpenVLA
Stanford, Berkeley und Partner
7B
Autoregressive Tokens
MIT
A100 oder H100, oder 24GB mit 4-Bit-Quantisierung
Offener Forschungs-Baseline
Octo
UC Berkeley
27M oder 93M
Diffusions-Policy
MIT
Eine einzelne RTX 4090
Compute-limitierte Szenarien
pi0 / pi0.5 / pi0.6
Physical Intelligence
3,3B (3B Backbone plus 300M Action-Expert)
Flow Matching
Offene Checkpoints (openpi)
Multi-GPU oder eine einzelne A100
Geschickte, langschrittige Aufgaben
Gemini Robotics 1.5
Google DeepMind
Nicht offengelegt
Hybrid, Cloud plus Edge
Geschlossen
Cloud-gebunden
Proprietärer Frontier-Baseline
SmolVLA
Hugging Face
450M
Flow Matching
Apache 2.0
RTX 3060, Laptop-GPU oder Jetson
Hobby- und Edge-Robotik
Gehen wir sie im Detail durch – beginnend mit dem Forschungsbaseline, an dem noch viele messen.
OpenVLA
OpenVLA ist ein 7-Milliarden-Parameter-Modell, trainiert auf 970.000 realen Roboter-Demonstrationen aus Open X-Embodiment.
Es kombiniert ein Llama 2 7B-Backbone mit dem fusionierten DINOv2- und SigLIP-Vision-Encoder und ist komplett Open Source.
Überraschend war, dass es das geschlossene RT-2-X-Modell um 16,5 Prozentpunkte Task-Erfolg über 29 Aufgaben schlug – obwohl RT-2-X mit 55 Milliarden Parametern gegen die 7 Milliarden von OpenVLA antrat!
Das Training lief 15 Tage auf 64 A100-GPUs.
Beliebt bleibt es, weil LoRA-Feintuning und 4-Bit-Quantisierung sehr gut funktionieren.
Eine 24GB RTX 4090 kann eine quantisierte Version ausführen. Daher nutzen viele veröffentlichte Arbeiten zu Angriffen, Absicherungen und Pruning in VLAs OpenVLA als Ziel – es ist einfach extrem zugänglich.
Ein Follow-up – OpenVLA-OFT – verbesserte das Feintuning-Rezept in Tempo und Erfolgsrate.
Octo
Octo ist ein kleines VLA in zwei Größen: 27 Mio. und 93 Mio. Parameter auf ViT-S bzw. ViT-B Backbones und läuft mit 20–30 Hz auf einer einzelnen RTX 4090.
Trainiert wurde es auf rund 800.000 Trajektorien aus Open X-Embodiment über 22 Roboterausführungen hinweg; die Transformer-Architektur ist wirklich modular.
Du kannst beim Feintuning neue Sensor-Inputs hinzufügen oder den Aktionskopf tauschen, ohne das Modell neu aufzubauen – es unterstützt je nach Bedarf diskrete Tokens und Diffusions-basierte kontinuierliche Aktionen.
Der Octo-Transformer: Task- und Beobachtungstokens rein, Readout-Tokens raus zum Aktionskopf – mit Platz für neue Sensoren oder Aktionsräume beim Feintuning. Quelle: Octo-Paper.
Ich greife zu Octo, wenn der limitierende Faktor Rechenleistung ist – nicht die Aufgabenkomplexität.
Es unterstützt zudem Zielbild-Conditioning – praktisch, wenn ein Foto des Sollzustands klarer ist als eine textliche Beschreibung.
pi0 und die Physical-Intelligence-Familie
pi0 von Physical Intelligence ist äußerst geschickt. Es startet von PaliGemma (3 Mrd. Parameter, offenes VLM) und ergänzt einen 300-Mio.-Parameter Aktions-Experten, insgesamt 3,3 Mrd. Parameter.
Per Flow Matching erzeugt es bis zu 50 zukünftige Aktionen in einem Block statt schrittweise.
Schlüsselresultate waren bimanuale Aufgaben wie Wäschefalten, Lebensmitteltaschen packen und Kartons falten – mit einer Fingerfertigkeit, die es so zuvor nicht gab.
pi0 faltet Wäsche mit zwei Armen. Eine der erwähnten Bimanual-Aufgaben – ansehen lohnt mehr als lesen. Quelle: Physical Intelligence, “pi0: Our First Generalist Policy”.
Flow Matching ist hier der Gamechanger, denn zwei Arme zu koordinieren verlangt glatte, kontinuierliche 16-dimensionale Outputs – weder diskrete Tokens noch langsames Diffusions-Sampling liefern das in nutzbarer Geschwindigkeit.
Die pi0-Familie entwickelt sich weiter:
Ein Vorbehalt: Die stärksten Zahlen von pi0 basieren auf proprietären Daten aus der eigenen Roboterflotte.
Außerhalb des Unternehmens hat das noch niemand mit rein öffentlichen Daten reproduziert – wie viel Performance also von der Architektur und wie viel vom Datenvorsprung kommt, ist weiterhin offen.
Gemini Robotics 1.5
Gemini Robotics 1.5 von Google DeepMind ist am besten als Zusammenarbeit zweier Modelle zu verstehen.
Gemini Robotics-ER 1.5 ist ein embodied Reasoning-Modell, das plant, Tools wie die Google-Suche aufruft und seinen Fortschritt einschätzt.
Gemini Robotics 1.5 ist das VLA, das die geplanten Schritte ausführt.
Oben Gemini Robotics-ER 1.5 fürs embodied Reasoning, unten Gemini Robotics 1.5 als VLA, dazwischen gemeinsames Tool-Calling, Aktionen laufen auf ALOHA 2, Franka und Apollo ohne Alignment des Aktionsraums. Quelle: Gemini Robotics 1.5 Paper.
Nützlich ist, dass Aktionen mit einem internen, natürlichsprachlichen Denkprozess verknüpft sind – der Roboter denkt vor dem Handeln und kann Entscheidungen im Nachhinein erklären.
Bei einer Anweisung wie “Sortiere meine Wäsche nach Farben” leitet er zunächst ab, dass Weißes in einen Behälter kommt und der Rest in einen anderen, und plant dann die einzelnen Griffe.
DeepMind berichtet rund 250 Millisekunden von Beobachtung bis Aktion (effektiv 50 Hz) – erreicht, indem das schwere Reasoning in der Cloud läuft und ein schlanker Aktionsdecoder lokal auf dem Roboter.
Bemerkenswert ist außerdem der Motion Transfer: Eine auf ALOHA 2 gelernte Aufgabe lief ohne Retraining auf einer Franka-Biarm-Konfiguration und auf Apptroniks humanoidem Apollo.
Die Gewichte sind geschlossen – betrachte es als proprietären Frontier-Baseline, nicht als etwas zum Selbst-Hosten.
SmolVLA
SmolVLA von Hugging Face umfasst 450 Mio. Parameter (Apache 2.0). Es kombiniert ein modifiziertes SmolVLM2-Backbone mit einem Flow-Matching-Aktions-Experten, nutzt Layer-Skipping und weniger visuelle Tokens, um Inferenz auf kleiner Hardware günstig zu halten.
Es läuft auf einer einzelnen Consumer-GPU (inkl. RTX 3060), auf der CPU eines MacBooks (langsam) und auf einem Jetson Orin direkt an Bord.
Feintuning über 20.000 Schritte dauert ca. 4–5 Stunden auf einer einzelnen A100.
Trotz weniger als 30.000 Episoden erreicht oder übertrifft es deutlich größere Modelle auf LIBERO, Meta-World sowie realen SO-100- und SO-101-Armen.
Das Beste: Das Pretraining basiert auf Community-Datasets über das LeRobot-Framework.
So wählst du ein VLA für dein Projekt
Nach den Modellen nun zur Auswahl für deinen Einsatzzweck.
Die Entscheidung hängt vor allem von Regelungsfrequenz und Hardware ab – nicht davon, wer letzten Monat auf einem Leaderboard vorne lag.
So würde ich vorgehen:
Fünf Constraints, fünf Modelle. Wenn du dir eine Grafik merken willst, dann diese. Bild: Autor.
Hast du eine Consumer-GPU oder einen SO-101-Arm auf dem Schreibtisch, starte mit SmolVLA. Nichts anderes im offenen Ökosystem liefert so günstig eine funktionierende Policy.
Und zuletzt: Hundert saubere Demos auf SmolVLA schlagen fünfzig chaotische auf OpenVLA fast immer.
Heißt: Investiere 60–70 Prozent der Projektzeit in Datenerfassung und Qualitätssicherung – der Rest geht ins Training.
Einsatzgebiete von VLA-Modellen
VLAs sind aus Demos heraus und in einige reale Deployments hineingewachsen – wenn auch ungleichmäßig.
Mein Muster: Sie landen zuerst dort, wo die Umgebung zu variabel für Scripting ist, aber Menschen bei Bedarf eingreifen können. Beispiele:
Robotische Manipulation
Das Hauptfeld: Pick-and-Place, Kitting, Verpacken, Sortieren, Montage etc.
Hier muss der Roboter Objekte erkennen, greifen und neu positionieren – bei wechselnden Lagen und Orientierungen –, genau das, was Skripte schlecht abdecken.
Lager- und Fulfillment-Aufgaben sind aktuell der klarste Business-Case. Ein geskripteter Picker braucht immer dieselbe Präsentation, ein VLA-basierter arbeitet eine Kiste mit vierzig gemischten SKUs ab.
Humanoide Roboter
Figure, 1X und Apptronik bauen auf VLA-Grundlagen – logisch: Ein zweibeiniger Roboter mit zwei Händen hat zu viele mögliche Aufgaben fürs Durchskripten.
Der Motion-Transfer von Gemini Robotics – eine auf ALOHA 2 gelernte Fähigkeit läuft direkt auf Apptroniks Apollo – ist genau die Eigenschaft, die ein skalierendes Humanoid-Programm braucht.
Dieselbe Fähigkeit, einmal auf ALOHA 2 trainiert, läuft auf Apptroniks humanoidem Apollo ohne Retraining. Quelle: Google DeepMind, “Gemini Robotics 1.5 brings AI agents into the physical world”.
Autonome Fahrzeuge
Fahr-Stacks übernehmen zunehmend VLA-ähnliche Architekturen: Was das Auto sieht und als Nächstes tun soll, läuft in einer Schleife – nicht per Handover vom Perzeptions- zum Planungsmodul.
Der Vorteil ist derselbe wie bei Manipulation: seltene, unvorhergesehene Situationen werden von einem Modell gehandhabt, das genug Welt gesehen hat, um darüber zu schlussfolgern – statt zu erstarren.
Chirurgische und medizinische Robotik
Das ist das früheste Stadium in dieser Liste.
Die Idee: Ein System, das verbale Anweisungen eines Chirurgen befolgt und sich an Gewebevariabilität anpasst, ist einem starr programmierten überlegen – aber die Zulassung ist hier der Engpass, nicht die Modellfähigkeit.
Erwarte Assistenz- und Trainingsanwendungen lange vor irgendetwas Autonomem.
Vision-Language-Action-Modelle: Herausforderungen und Grenzen
So gut VLAs auch sind – sie haben Schwächen, vor allem in vier Bereichen:
Erholung mitten in der Aufgabe
Variation zu Beginn einer Aufgabe meistern VLAs recht gut. Rutscht der Griff aber mittendrin ab oder verschiebt sich ein Objekt, ist die Erholung inkonsistent.
Die meisten Demos zeigen erfolgreiche Versuche – Beispiele für das Erholen nach Fehlern sind rar.
On-Device-Inferenz
Feinmanipulation braucht 10–100 Hz. Ein Modell mit 7+ Milliarden Parametern lokal auf dem Roboter auf diese Rate zu bringen, ist eher Zielbild als gelöste Ingenieursaufgabe.
Darum sind produktive Systeme meist per Edge-Server angebunden oder trennen Reasoning und Kontrolle – wie Gemini Robotics 1.5.
Quantisierung, Layer-Skipping und Distillation helfen, sind aber Workarounds in Arbeit – keine endgültigen Lösungen.
Der Daten-Flaschenhals
Da es inzwischen fähige offene Gewichte zum Download gibt, sind Daten der echte Differenzierer.
Diverse, gut annotierte Teleoperationsdaten zu sammeln ist langsam und teuer – ganz anders als Webscraping. Die Lücke zwischen pi0s veröffentlichten Ergebnissen und dem, was mit rein öffentlichen Daten reproduziert wurde, zeigt sehr deutlich, was ein privater Datenvorsprung bringt.
Generalisation außerhalb der Verteilung
Aktuelle VLAs generalisieren innerhalb ihrer Trainingsverteilung gut und bauen außerhalb spürbar ab.
Ein über 22 Embodiments auf Tischmanipulation trainiertes Modell kann bei einer wirklich neuen Aufgabenform dennoch schlecht abschneiden.
Fazit
VLA-Modelle vereinen Wahrnehmung, Sprachverständnis und Aktionsgenerierung in einer Architektur – das ist ein Strukturwandel, kein inkrementeller Schritt.
Sie können etwas, das klassische Regelung nie schaffte: auf Bedingungen generalisieren, auf die niemand sie explizit trainierte – weil Sprach- und Visions-Backbones dem Roboter schon vor der ersten Demo ein funktionierendes Weltmodell mitgeben.
Was mich 2026 am meisten überrascht: Die harte Frage hat sich verlagert.
Vor drei Jahren war es die Architektur.
Jetzt, wo OpenVLA, Octo, pi0 und SmolVLA auf GitHub für alle liegen, geht es um Datenqualität, Recovery-Verhalten und die Frage, ob du das alles wirklich mit 50 Hz auf dem Roboter selbst laufen lassen kannst – statt im Rechenzentrum.
Wenn du weitermachen willst: DataCamps Introduction to AI Agents deckt den weiteren agentischen Kontext ab, und Large Language Models (LLMs) Concepts behandelt die Backbone-Seite.