
Last chance! 50% off DataCamp Premium
Sale ends in
Birine “Kupayı al ve rafa koy.” dediğinizi hayal edin. Bir diyagrama ihtiyaç duymaz; sadece kupaya bakar, cümleyi anlar ve eli oraya gider.
Burada neredeyse aynı anda üç farklı şey oldu. Görme, anlama ve hareket etme o kişi için beynin farklı bölümleri arasında aktarılan üç ayrı adım olarak değil, neredeyse birlikte gerçekleşir.
Robotik yapay zekânın tarihinin büyük bölümü için, makineler hiç de böyle çalışmıyordu.
Geçmişte, görme-dil modelleri vardı; dağınık bir tezgâha bakıp üzerindeki şeyleri, hatta bir aletin marka adı gibi ince ayrıntılarıyla tarif edebiliyorlardı.
Klasik robot denetleyiciler, o tornavidayı güvenilir şekilde alabiliyordu; tabii kimse onu iki santimetre sola kaydırmadıkça. Sorunun iki yarısı—bir yanda görme ve anlama, diğer yanda eylem—neredeyse tamamen ayrı ayrı gelişti.
İşte görme-dil-eylem (VLA) modelleri bu noktada devreye giriyor—o aralığı kapatma girişimidirler.
Bu yazıda, VLA modellerinin ne olduğuna ve üç parçalı mimarilerinin nasıl çalıştığına bakacağız. VLM’lerden ve klasik robot kontrolden nasıl ayrıldıklarını, 2026’da gerçekten önem taşıyan modelleri ve nerelerde kullanıldıklarını inceleyeceğiz. Son olarak da VLA modlarının hâlâ neleri yanlış yaptığını ele alacağız.
VLA modellerini resmen tanımlayarak başlayalım:
Bir görme-dil-eylem modeli, bir kamera akışını, doğal dilde bir talimatı ve robotun kendi durumunu işler; ardından motor komutları üretir. Görme, dil ve eylem modülleri, klasik algıla-sonra-planla-sonra-kontrol et boru hattı yerine birlikte eğitilir ve tek bir ileri geçişte çalıştırılır.
Asıl önemli olan; algı, dil ve eylemin, el yazımı yapıştırma kodlarıyla birleştirilmiş ayrı sistemler olmamasıdır.
Birlikte eğitilen alt modüllerdirler. Dolayısıyla, klasik bir boru hattında el değiştirirken raydan çıkaracak bir görme veya dil hatası, sabit kodlanmış bir arayüz tarafından yakalanmak ya da kaçırılmak yerine, gradyan inişiyle düzeltilir.
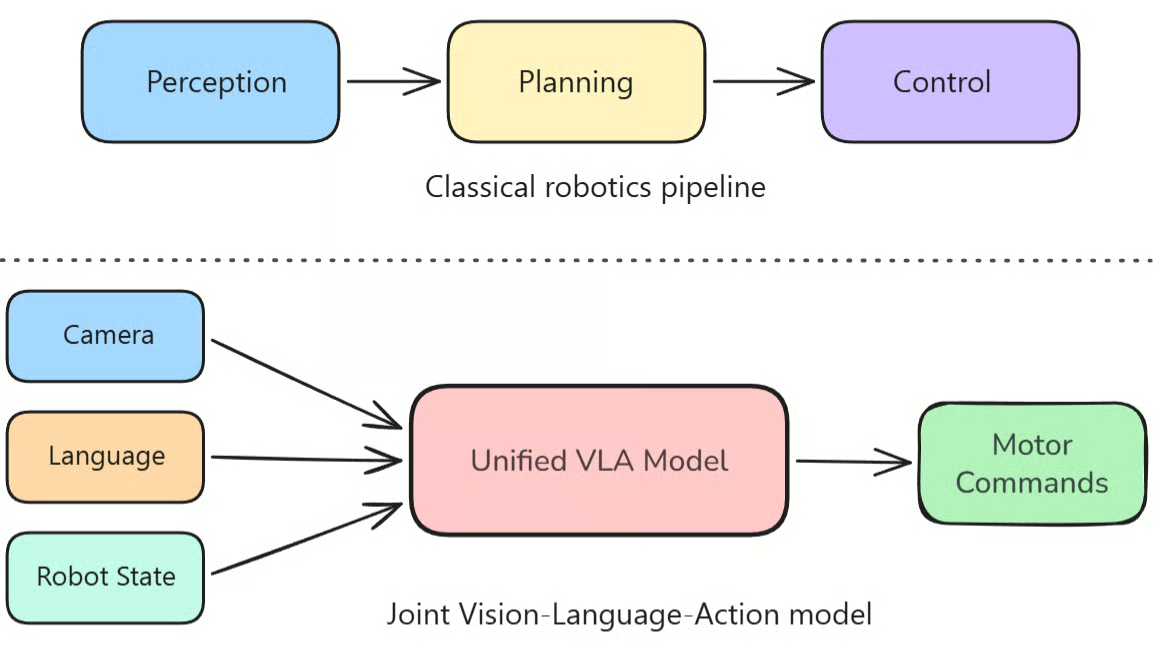
Üstte üç kutu ve iki kırılgan el değiştirme, altta tek bir kaynaşmış model. Sürekli sözünü ettiğim yapısal fark tam olarak bu. Görsel: Yazar.
Ayrımı şöyle ifade etmeyi seviyorum: Bir VLM bedensiz bir beyinse, VLA ona bir beden verir.
Algı, robotun çağırdığı ayrı bir hizmet değil; kavrayıcının ne kadar hareket edeceğine karar veren birlikte eğitilen boru hattına doğrudan bağlıdır.
Şimdiye dek VLM’lerden de söz ettim, o hâlde bu iki mimariyi karşılaştıralım.
Bir VLM (Görme-Dil Modeli) görüntü ve metni alır; çıktı olarak metin veya gömülemeler üretir.
Bir VLA (Görme-Dil-Eylem Modeli) ise aynı tür girdiyi alır ve bunun yerine bir eylem üretir.
Bu, aşağı yöndeki etkisini görene kadar küçük bir değişiklik gibi gelebilir:
|
Görme-dil modeli (VLM) |
Görme-dil-eylem modeli (VLA) |
|
|---|---|---|
|
Girdi |
Görüntüler, video, metin |
Görüntüler (çoğunlukla çoklu kamera), metin, robotun propriyoseptif durumu |
|
Çıktı |
Metin, gömülemeler |
Sürekli veya ayrıklaştırılmış motor komutları |
|
Birincil yetenek |
Bir sahneyi betimleme ve akıl yürütme |
Bir sahne üzerinde eyleme geçme |
|
Dünyada eyleme geçebilir mi? |
Hayır |
Evet |
|
Eğitim verisi |
Web’den kazınmış görüntü-metin çiftleri |
Web verisi artı robot gösterim yörüngeleri |
|
Tipik uygulama |
Görsel soru yanıtlama, altyazılama, belge ayrıştırma |
Manipülasyon, gezinme, insansı kontrol |
GPT-4V, Gemini ya da LLaVA gibi modelleri duymuş olabilirsiniz.
Yaygın bir varsayım, bir VLA’nın bunlardan birine robot kolu takılmış hali olduğudur.
Oysa iş bu kadar basit değil.
Modelin, bir belirtecin uç-effektör yer değiştirmesi veya kavrayıcı açıklığı gibi gerçek bir fiziksel niceliğe karşılık geldiği; yanlış yapıldığında biraz tuhaf bir cümle üretmek yerine bardağı masadan düşürdüğü büsbütün yeni bir çıktı uzayını öğrenmesi gerekir.
GPT-4V, Gemini ve LLaVA’nın alanın geri kalanına göre nerede durduğunu görmek isterseniz, DataCamp’in 2026’nın En İyi 10 Görme-Dil Modeli mevcut liderleri derliyor.
Veri tarafında da bir sonuç var.
Bir VLM, internetin bedelsiz sağladığı milyarlarca görüntü-metin çiftiyle eğitilebilir.
Robot yörüngeleri ise genellikle teleoperasyon altında, gerçek bir robotun gerçek bir görevi icra etmesiyle toplanmalıdır; bu yüzden en büyük açık robotik veri kümesi olan Open X-Embodiment, 1 milyar yerine yaklaşık 1 milyon yörüngede tıkanır.
Bu tür yörüngeleri elle toplamak ayrıca çok pahalı ve yavaştır.
22 bedenlenme, tek veri seti ve toplamda hâlâ 1 milyonun altında yörünge. “Robot verisi web metni gibi ölçeklenmiyor” derken kastettiğim bu. Kaynak: Open X-Embodiment proje sayfası.
Şimdi, VLA mimarisinin nasıl çalıştığını anlatmadan önce, onu klasik robot kontrolüyle de karşılaştırmak istiyorum.
Klasik robot kontrolü, birinin önceden kilitlediği koşullar altında, tek bir yerde tek bir görev için inşa edilir.
Örneğin bir otomat kolunu ele alalım.
Her seferinde aynı atıştırmalığı aynı raftaki aynı noktadan alır; çünkü aydınlatma, nesne konumları ve gereken hareketler alımlar arasında değişmez.
Bu dar ve değişmeyen kurgu, kontrol sisteminin katı ve güvenilir olmasını sağlayan şeydir.
Ama şimdi otomatın iç düzenini değiştirelim, aydınlatmayı değiştirelim ya da plana hiç dahil olmayan bir nesneyi sahneye bırakalım.
Denetleyici, ortamı hiç böyle görmediği için tümden başarısız olacaktır.
Bir VLA, açıkça eğitilmediği koşullara daha iyi geneller; çünkü alttaki VLM omurgası, robot gösterimi görmeden önce web ölçeğinde ön eğitim sayesinde bir kupanın, bir havlunun ya da bir çekmecenin nasıl göründüğünü zaten bilir.
Onu yüz kadar havlu katlama örneğiyle ince ayar yapmak, zaten tanıdığı bir nesne verildiğinde nasıl hareket edeceğini öğrenmesini sağlar.
Atılım aslında bu aktarım, ham hassasiyet değil, ve şunu da belirtmek isterim ki, iyi ayarlanmış bir klasik denetleyici, sabit ve kontrollü bir düzende hassasiyet açısından hâlâ bir VLA’yı geride bırakabilir.
Mimariye derinlemesine dalalım.
Bu yazı için, anlaşılması kolay olduğu için OpenVLA mimarisini seçtim.
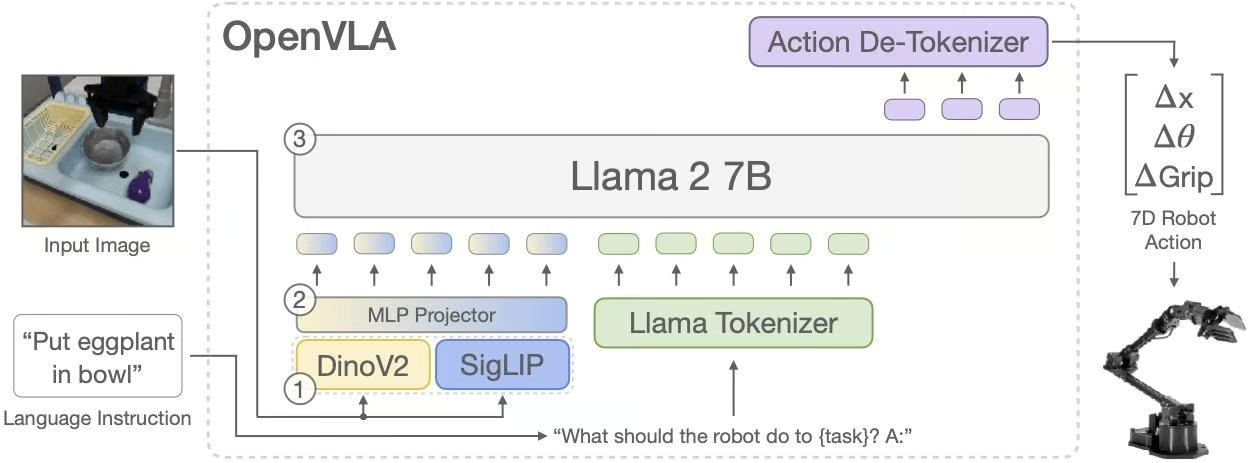
Aşağıda anlattığım boru hattı: DINOv2 ve SigLIP, Llama 2 omurgasını besliyor; öte uçta eylem kodçözücü ayrıklaştırılmış belirteçleri öngörüyor. Kaynak: OpenVLA proje sayfası.
Bir VLA’nın üç ayrı modülü vardır:
Bunlar uçtan uca birlikte eğitilir.
Görsel ve dil temsilleri birleştirilir ve eylem kodçözücü, motor komutlarına dönüştürdüğü birleşik temsil üzerinde çalışır.
Önemli olan, bu üç parçanın boru hattı şeklinde değil, sıkı sıkıya bağlanmış olmasıdır; VLA’yı, bir denetleyiciye yamalanmış bir VLM’den ayıran tasarım kararı budur.
İşe yarıyorsa, orijinal World Models makalesindeki görme, bellek ve denetleyici ayrımını düşündüğüm şekilde düşünün: görür, anlar, eyleme geçer.
Buradaki fark, bir VLA’nın üç işi de gösterimlerden, uçtan uca, birlikte öğrenmesi; her parçayı ayrı ayrı eğitip sonra birleştirmemesi.
Şimdi her birini ayrı ayrı inceleyelim.
Görme kodlayıcı, ham kamera karesini ağın geri kalanının gerçekten kullanabileceği yoğun bir temsile çevirir.
Modern VLA’lar, DINOv2 veya SigLIP gibi önceden eğitilmiş görsel dönüştürücüleri kullanır ve çoğu zaman ikisini birden kullanır.
OpenVLA, ikisini birden kullanmaya iyi bir örnektir.
Mekânsal ve geometrik ayrıntıda güçlü olan DINOv2’yi, dil ile iyi hizalanan semantik özelliklerde daha güçlü olan SigLIP ile birleştirir.
İki özellik kümesi, görüntü yamaları başına birleştirilir ve dil modelinin gömme uzayına (bu durumda LLama 2 7B) yansıtılır.
Birden fazla kamera kullanmanın gerçek konuşlandırmalarda standart olduğunu da belirtmek isterim.
Örneğin, bileğe takılı bir kamera, bir nesneye son yaklaşım sırasında yakın mesafe ayrıntılarını verir; bir üstten kamera, sahne düzenini sunar; yandan bir görünüm ise tek bir kameranın kendi başına kurtaramayacağı derinliğe yardımcı olur.
pi0 (aşağıda daha fazlası) birden fazla kamera görüşünü ve robotun propriyoseptif durumunu alır.
Durum girdisinin, göründüğünden daha fazla önem taşıdığını unutmayın; çünkü bir kolun fotoğrafı, eklemlerde hâlihazırda hangi torkun bulunduğunu söylemez.
Dil tarafı, “kırmızı bloğu al ve mavi kutuya koy” gibi bir talimatı, aynı uzaydaki görsel özelliklerle hizalanan bir temsile dönüştürür.
Neredeyse her VLA, sıfırdan bir metin kodlayıcı eğitmek yerine, önceden eğitilmiş bir büyük dil modeli (LLM) omurgasını yeniden kullanır.
Bizim durumumuzda OpenVLA, Llama 2 7B kullandı. pi0 ve pi0.5, 3 milyar parametreli bir VLM olan PaliGemma üzerine inşa edildi. SmolVLA, değiştirilmiş bir SmolVLM2 yığını kullandı.
Bu şekilde bir LLM’i yeniden kullanmak esasen mirasla ilgilidir.
Talimat izleme ve birleşimsel anlama kabiliyeti elde edersiniz; bu yüzden bir VLA, robot eğitimi sırasında o ifadeyi hiç görmemiş olsa bile, “meyveyi kaseye koy” talimatını çoğu zaman yerine getirebilir.
Eylem kodçözücü, birleşik temsilin gerçekten bir motor komutuna dönüştüğü yerdir ve VLA tasarımlarının en çok ayrıştığı yer de burasıdır. Şu anda üç geniş yaklaşım kullanılıyor.
her eylem boyutunu ayrık kutulara bölüp, bir dil modelinin zaten nasıl eğiteceğini bildiği şekilde, sıradaki-belirteç kurulumunda birbiri ardına tahmin edersiniz.
OpenVLA, boyut başına 256 kutu ve normal bir sıradaki-belirteç kaybı kullanır; böylece alışıldık LLM araçlarını korursunuz.
Verdiğiniz taviz ise, ayrıklaştırmanın hareketi pürüzlü bırakması nedeniyle çözünürlük ve hızdır; belirteç belirteç örneklemek, hızlı veya temasa dayalı işlerde fazla yavaştır.
Model, tek seferde bir belirteç öngörmek yerine eylem üretimini bir gürültü giderme süreci olarak ele alır ve bir grup sürekli eylemi bir defada üretir.
pi0, akış-eşleme eylem başı etrafında inşa edilen ilk VLA’ydı; yaklaşık 10 adımda gürültü gidererek, 50’ye kadar gelecekteki eylemi kapsayan bir parça üretti.
Bu, ortaya çıkan hareketi belirteç tabanlı olan her şeyden belirgin biçimde daha pürüzsüz yaptı.
Daha büyük bir model üst düzey akıl yürütmeyi ele alır ve görevi adımlara böler; daha küçük ve hızlı bir denetleyici ise hassas, yüksek frekanslı icrayı yürütür.
Buna iyi bir örnek olarak Gemini Robotics 1.5’ı vermeyi seviyorum; orada bir akıl yürütme modeli bir eylem modeliyle eşleştirildi.
Dürüst görüşüm şu ki, bu makalelerin birçoğunu okuduktan sonra, insanların eylem başından çok omurga boyutu üzerine enerji harcadığını görüyorum ve bunun tersinden olması gerektiğini düşünüyorum.
Kodçözücünüz 7 boyutlu sürekli bir eylemi 256 ayrık kutuya sıkıştırıyorsa, omurga kalitesi ne kadar iyi olursa olsun o akıcılık geri gelmez!
Şimdi, muhtemelen karşınıza çıkacak gerçekten önemli bazı VLA modellerini gösteren bir tablo sunmak istiyorum:
|
Model |
Geliştirici |
Parametreler |
Eylem başı |
Lisans |
Donanım |
En uygun alan |
|---|---|---|---|---|---|---|
|
OpenVLA |
Stanford, Berkeley ve işbirlikçileri |
7B |
Oto-regresif belirteçler |
MIT |
A100 veya H100, ya da 4 bit ayrıklaştırmayla 24GB |
Açık araştırma kıyas çizgisi |
|
Octo |
UC Berkeley |
27M veya 93M |
Difüzyon politikası |
MIT |
Tek RTX 4090 |
Hesaplama kısıtlı çalışmalar |
|
pi0 / pi0.5 / pi0.6 |
Physical Intelligence |
3,3B (3B omurga artı 300M eylem uzmanı) |
Akış eşleme |
Açık kontrol noktaları (openpi) |
Çoklu GPU veya tek A100 |
Maharetli, uzun ufuklu görevler |
|
Gemini Robotics 1.5 |
Google DeepMind |
Açıklanmadı |
Hibrit, bulut artı uç |
Kapalı |
Buluta bağlı |
Sınır düzeyi tescilli kıyas çizgisi |
|
SmolVLA |
Hugging Face |
450M |
Akış eşleme |
Apache 2.0 |
RTX 3060, dizüstü GPU’su veya Jetson |
Hobi ve uç robotikler |
Şimdi, çoğu kişinin hâlâ karşılaştırma yaptığı araştırma kıyas çizgisinden başlayarak, her birini aşağıda ele alalım.
OpenVLA, Open X-Embodiment’tan çekilen 970.000 gerçek dünya robot gösterimiyle eğitilmiş, 7 milyar parametreli bir modeldir.
Önceden anlattığım, birleştirilmiş DINOv2 ve SigLIP görme kodlayıcısını, Llama 2 7B omurgasıyla birleştirir ve modelin tamamı açık kaynaktır.
Sürpriz olan sonuç, kapalı RT-2-X modelini 29 görev boyunca görev başarısında 16,5 yüzde puanı farkla geride bırakmasıydı; üstelik RT-2-X, OpenVLA’nın 7 milyarına karşı 55 milyar parametreyle çalışıyordu!
Toplam eğitim, 64 A100 GPU’da 15 gün sürdü.
Hâlâ popüler olmasının nedeni, LoRA ince ayarı ve 4 bit ayrıklaştırmanın üzerinde iyi çalışmasıdır.
Bu da 24GB RTX 4090’ın ayrıklaştırılmış bir sürümü çalıştırabileceği ve VLA saldırıları, savunmaları ve budamaları üzerine yayımlanmış çalışmaların çoğunda hedef olarak OpenVLA’nın seçilmesi demektir; yalnızca bu kadar erişilebilir olduğu için.
Bir takip çalışması—OpenVLA-OFT, ince ayar tarifini hem hız hem de başarı oranı açısından geliştirdi.
Octo küçük bir VLA’dır ve iki boyutta gelir—sırasıyla ViT-S ve ViT-B omurgalarda 27 milyon ve 93 milyon parametre; 20 ila 30 Hz’de tek bir RTX 4090 üzerinde çalıştırılabilir.
22 robot bedenlenmesi boyunca Open X-Embodiment’tan yaklaşık 800.000 yörünge ile eğitildi ve dönüştürücü mimarisi gerçekten modülerdir.
İnce ayar sırasında yeni bir gözlem girdisi ekleyebilir veya eylem başını değiştirebilirsiniz; modeli baştan inşa etmeden. İhtiyacınıza bağlı olarak ayrık belirteçleri ve difüzyon tabanlı sürekli eylemleri destekler.
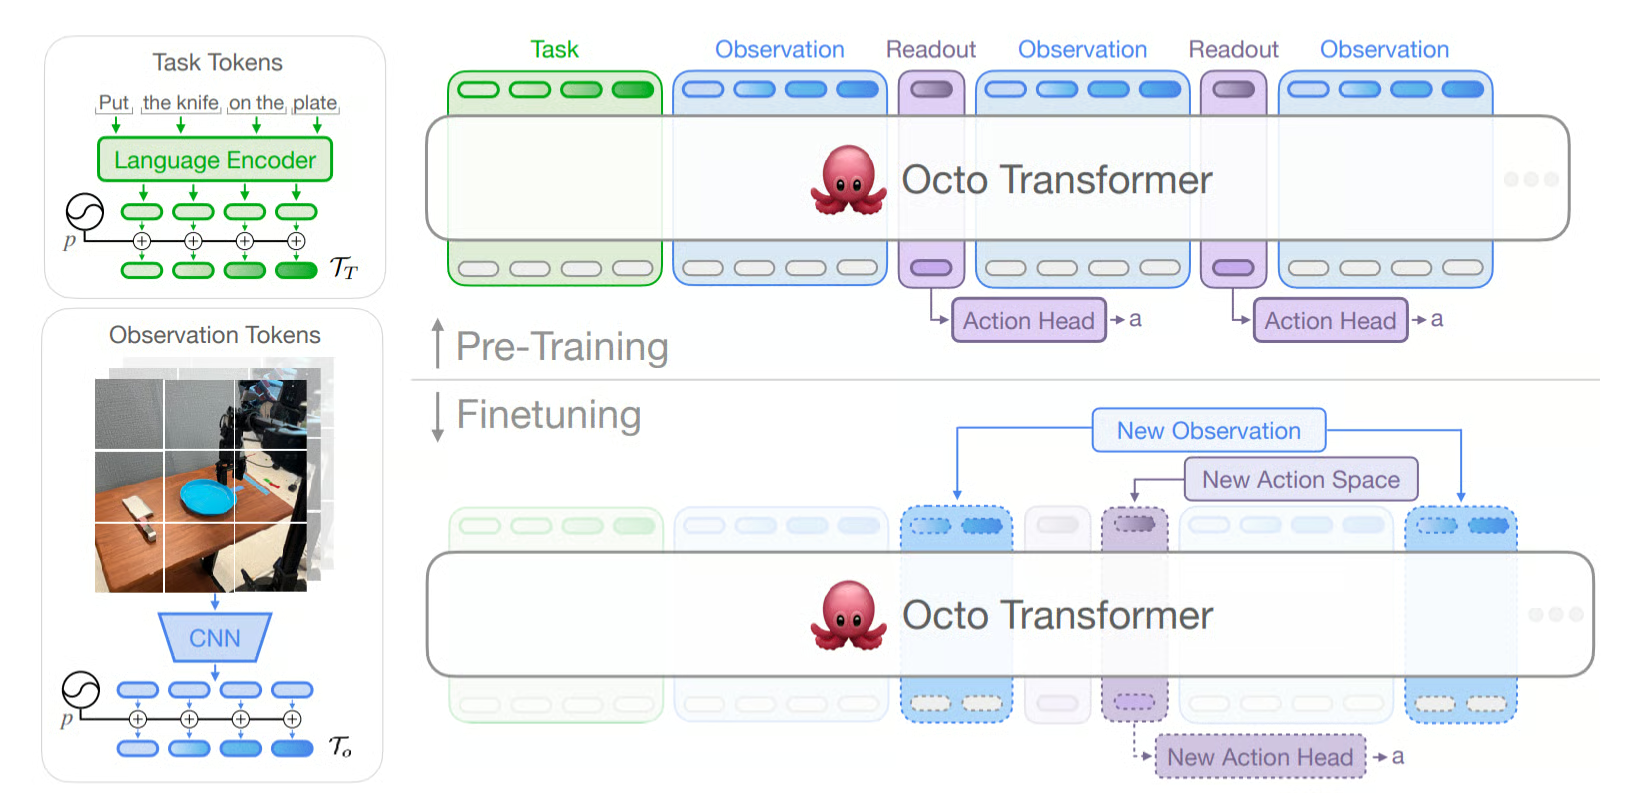
Octo’nun dönüştürücüsü: içeri görev ve gözlem belirteçleri, dışarı eylem başına giden okuma belirteçleri; ince ayarda yeni sensörler veya eylem uzayları eklemeye yer var. Kaynak: Octo makalesi.
Sınırlayıcı etken hesaplama gücü olduğunda, görev zorluğu değilse, ben şahsen Octo’yu kullanıyorum.
Ayrıca hedef-görüntü koşullandırmayı destekler; hedef durumunuzu kelimelerle tarif etmektense ne istediğinizi gösteren bir fotoğraf kullanmanın daha rahat olduğu durumlar için hoş bir seçenektir.
pi0, Physical Intelligence’tan, maharette gerçekten iyidir. PaliGemma, 3 milyar parametreli açık bir VLM, ile başlar ve sıfırdan eğitilmiş 300 milyon parametreli bir eylem uzmanı ekler; toplamda 3,3 milyar parametre eder.
Tek tek adımlar halinde değil, tek seferde 50’ye kadar gelecekteki eylemi kapsayan bir parça üretmek için akış eşleme kullanır.
Ana sonuç; çamaşır katlama, market poşetleme ve kutu montajı gibi iki elli görevlerdi—daha önce hiçbir şeyin göstermediği bir maharet düzeyiyle ele alındılar.
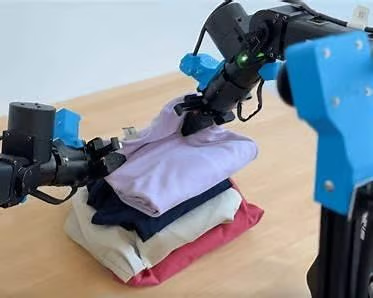
pi0 robotu iki kolla çamaşır katlıyor. Sözünü ettiğim iki elli görevlerden biri bu; okumakla yetinmeyip izlemeye değer. Kaynak: Physical Intelligence, “pi0: Our First Generalist Policy”.
Asıl işi burada akış eşleme yapıyor; çünkü iki kolu aynı anda koordine etmek, pürüzsüz, sürekli 16 boyutlu çıktı ister ve ne ayrık belirteçler ne de yavaş difüzyon örneklemesi bunu kullanılabilir hızda sağlar.
pi0 ailesi evrimleşmeye devam etti:
Belirtmek istediğim bir çekince, pi0’ın en güçlü sonuçlarının, kendi robot filolarından toplanan tescilli verilere dayanmasıdır.
Şirket dışındaki hiç kimse, yalnızca kamu verileriyle bu sayıları tam olarak yeniden üretmedi; dolayısıyla başarının ne kadarının mimariden, ne kadarının veri avantajından geldiği hâlâ gerçekten çözümlenmemiş durumda.
Gemini Robotics 1.5, Google DeepMind’dan; tek bir modelden ziyade birlikte çalışan iki model olarak anlaşılmalıdır.
Gemini Robotics-ER 1.5, plan yapan, Google Arama gibi araçları çağıran ve bir görevdeki kendi ilerlemesini tahmin edebilen bedenlenmiş bir akıl yürütme modelidir.
Gemini Robotics 1.5 ise akıl yürütme modelinin karar verdiğini uygulayan VLA’dır.
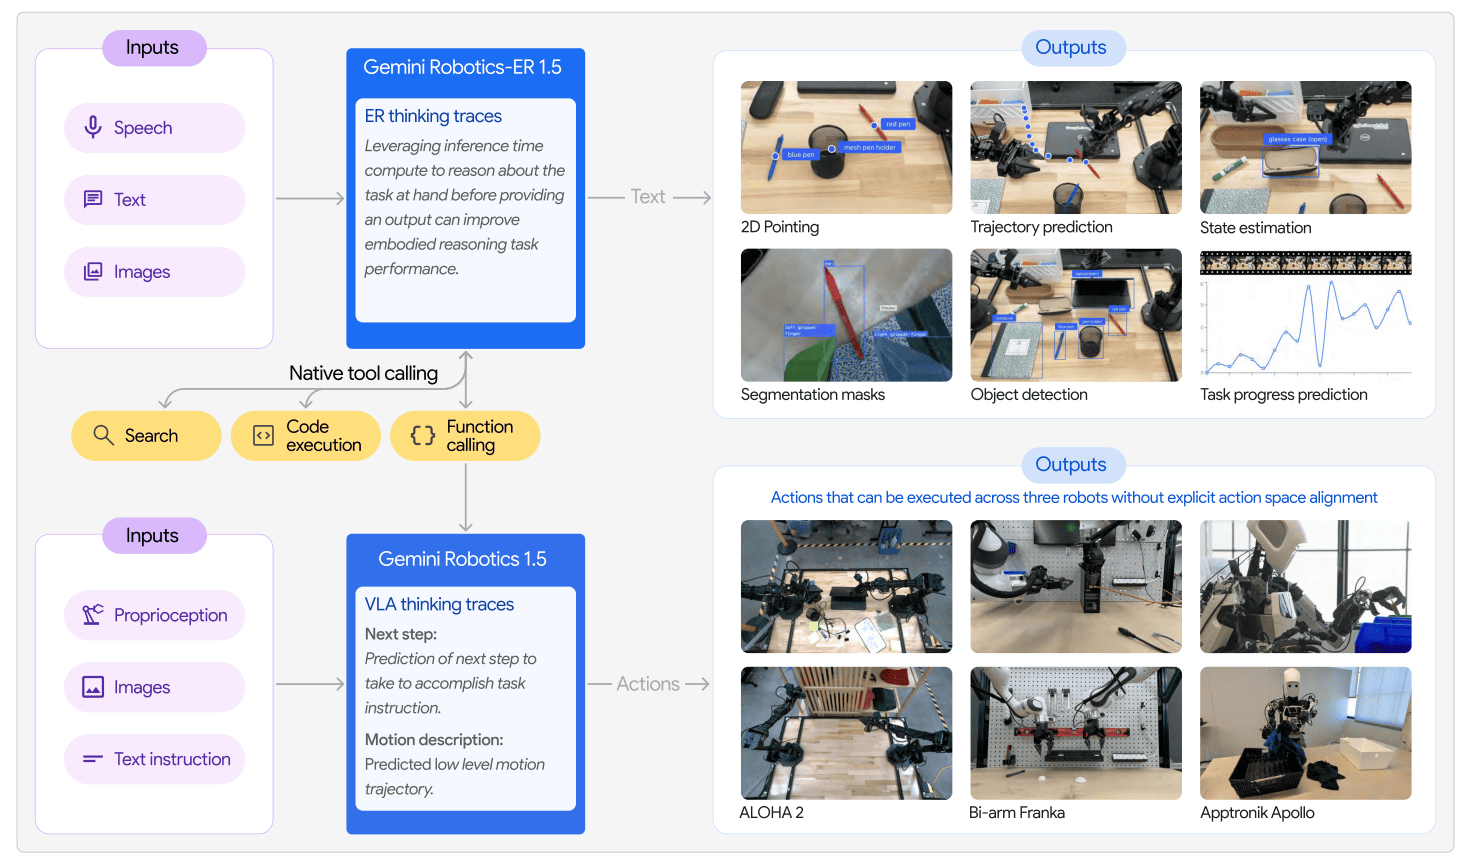
Üstte bedenlenmiş akıl yürütme için Gemini Robotics-ER 1.5, altta VLA olarak Gemini Robotics 1.5; ortada paylaşılan araç çağırma; ALOHA 2, Franka ve Apollo’da eylemler, eylem-uzayı hizalaması olmadan çalışıyor. Kaynak: Gemini Robotics 1.5 makalesi.
Faydalı olan, eylemleri doğal dilde yazılmış bir içsel akıl yürütme süreciyle harmanlaması; böylece robot, eyleme geçmeden önce düşünüyor ve sonrasında neye karar verdiğini açıklayabiliyor.
“Çamaşırlarımı renge göre ayır” gibi bir talimat verildiğinde, önce beyazların bir kutuya, diğerlerinin başka bir kutuya gittiğini çıkarımlıyor; sonra tek tek alımları planlıyor.
DeepMind, gözlemden eyleme yaklaşık 250 milisaniye rapor ediyor; bu, ağır akıl yürütmeyi bulutta tutup, hafif bir eylem kodçözücüyü robota yerelleştirerek elde edilen 50 Hz’lik etkili bir kontrol frekansıdır.
Belirtmek istediğim diğer sonuç ise Hareket Transferi; ALOHA 2 çift kollu platformda öğrenilen bir görev, Franka çift kol kurulumuna ve Apptronik’in Apollo insansısına, ikisinden herhangi biri üzerinde yeniden eğitim olmadan doğrudan taşındı.
Ağırlıklar kapalıdır; bu yüzden bunu, indirip kendinizin ince ayar yapabileceğiniz bir şey değil, tescilli sınır düzeyi kıyas çizgisi olarak ele alın.
SmolVLA, Hugging Face’ten; 450 milyon parametre (Apache 2.0 lisansı altında). Değiştirilmiş bir SmolVLM2 omurgayı akış-eşleme eylem uzmanıyla eşleştirir; küçük donanımlar için çıkarımı yeterince ucuz tutmak üzere katman atlama ve azaltılmış sayıda görsel belirteç kullanır.
Tek bir tüketici GPU’sunda—RTX 3060 dahil—, bir MacBook’un CPU’sunda (yavaş olsa da) çalışır ve gömülü çıkarım için Jetson Orin’e dağıtılır.
20.000 adımlık ince ayar, tek bir A100 GPU üzerinde yaklaşık 4 ila 5 saat sürer.
30.000’den az bölümle eğitilmesine rağmen, LIBERO, Meta-World ve gerçek SO-100 ve SO-101 kollarda kayda değer ölçüde daha büyük modellerle başa baş ya da daha iyi sonuçlar verir.
En güzel yanı, tamamının LeRobot çerçevesi aracılığıyla topluluk katkılı veri kümeleri üzerinde önceden eğitilmiş olmasıdır.
Artık bazı VLA modellerini sunduğuma göre, özel projeniz için hangisini seçeceğinizden bahsedelim.
Bu beş model arasında seçim yapmak, çoğunlukla kontrol frekansını ve donanımı gerçek kurulumunuzla eşleştirmekle ilgilidir; geçen ay hangi modelin liderlik tablosunun tepesine çıktığını kovalamakla değil.
Kabaca şöyle düşünürdüm:
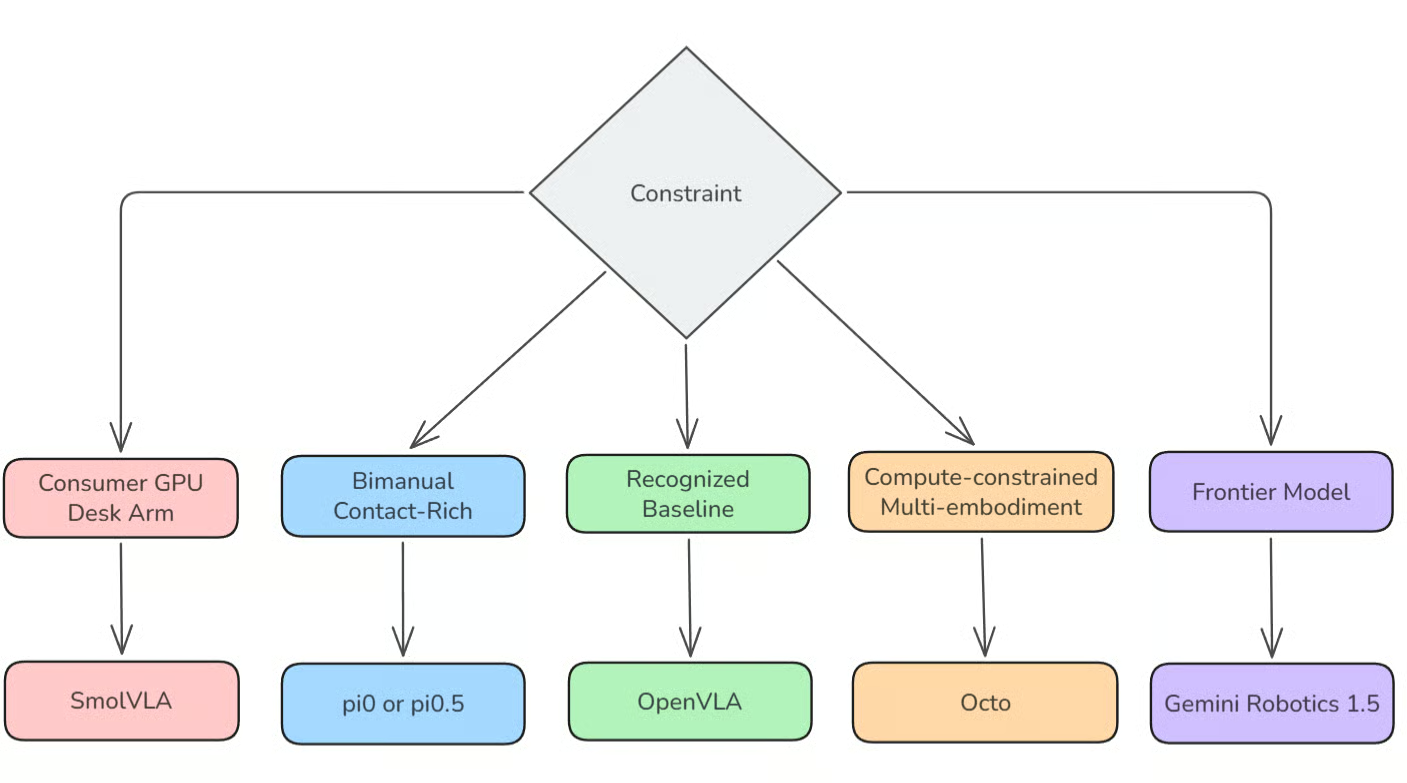
Beş kısıt, beş model. Bu yazıdan yalnızca bir diyagramı hatırlayacaksanız, bu olsun. Görsel: Yazar.
Masa başınızda bir tüketici GPU’su veya bir SO-101 kolu varsa, SmolVLA ile başlayın. Açık ekosistemde çalışan bir politikayı bu kadar ucuza sağlayan başka bir şey yok.
Ve son olarak vurgulamak istediğim ana nokta şu: SmolVLA üzerinde yüz temiz gösterim, OpenVLA üzerinde elli dağınık gösterimi neredeyse her zaman geride bırakır.
Bununla demek istediğim, proje sürenizin yüzde 60 ila 70’ini veri toplama ve kalite kontrole, kalanını ise eğitime ayırmanızdır.
VLA’lar, düzensiz de olsa, tanıtım videolarının ötesine geçip bir avuç gerçek konuşlandırmaya taşındı.
Dikkat ettiğim örüntü şu: Betik yazılamayacak kadar çok çeşitliliğe sahip ortamlara önce iniş yapıyorlar; ama bir şeyler ters gittiğinde hâlâ bir insan devreye girebiliyor. İşte bazı örnekler:
Burası ana zemin; alma-bırakma, malzeme hazırlama, paketleme, ayıklama, montaj vb. gibi görevlerle.
Bunlar, robotun, denemeler arasında konumu ve yönelimi değişen nesneleri tanımlaması, kavraması ve yeniden konumlandırması gereken görevlerdir; bu da tam olarak betik tabanlı sistemlerin kötü idare ettiği koşuldur.
Depo ve sipariş karşılama işleri şu anda en net ticari vakadır. Betik tabanlı bir toplayıcı, öğenin her seferinde aynı şekilde sunulmasını isterken, VLA tabanlı bir toplayıcı, kırk farklı SKU’nun birbirine karıştığı bir kutuda çalışabilir.
Figure, 1X ve Apptronik gibi şirketler VLA temelleri üzerine inşa ediyor ve nedeni basit: İki işlevsel ele sahip iki ayaklı bir robotun, tek tek betiklenemeyecek kadar çok olası görevi vardır.
ALOHA 2’de eğitilmiş bir becerinin, Apptronik’in Apollo insansısına doğrudan taşındığı Gemini Robotics Hareket Transferi sonucu, bir insansı programının ölçeklenmek istiyorsa ihtiyaç duyduğu özelliğin ta kendisidir.
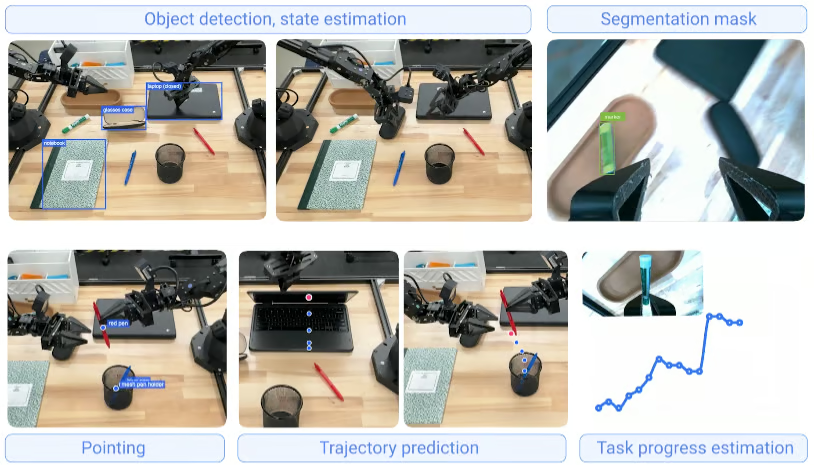
Aynı beceri, ALOHA 2’de bir kez eğitildi; Apptronik’in Apollo insansısında yeniden eğitim olmadan çalışıyor. Kaynak: Google DeepMind, “Gemini Robotics 1.5 yapay zekâ ajanlarını fiziksel dünyaya getiriyor”.
Sürüş yığınları, aracın gördüğüyle bir sonraki ne yapması gerektiğini, algılayıcıdan planlayıcıya el değiştirme yerine tek bir akıl yürütme döngüsü içinde bağlamak için VLA tarzı mimarileri benimsemeye başlıyor.
Cazibe, manipülasyondakiyle aynıdır: Hiçbir kuralın öngörmediği nadir durumlar, donup kalmak yerine dünya hakkında akıl yürütecek kadar çok şey görmüş bir model tarafından idare edilir.
Bunun listedeki en erken-aşama uygulama olduğunu belirtmek isterim.
Fikir, bir cerrahın sözlü talimatını izleyebilen ve değişken doku koşullarına uyum sağlayabilen bir sistemin, katı şekilde programlanmış bir sistemi geride bırakacağıdır; fakat burada ana kısıt modelin yeteneği değil, düzenleyici onaydır.
Otonomiye yakın bir şeyden çok önce, yardımcı ve eğitim amaçlı uygulamalar beklerim.
VLA’lar harika olsa da hâlâ zayıf yönleri var; özellikle dört noktada:
VLA’lar, bir görevin başlangıcındaki değişkenliği makul derecede iyi idare eder; ancak bir kavrayış yarıda kayarsa ya da bir nesne kavrayıcının altında kayarsa, toparlanma tutarsızdır.
Çoğu gösterim verisi başarılı denemeleri yakalar; bu yüzden model, bir hatadan toparlanmanın gerçekte nasıl göründüğüne dair çok az örnek görmüştür.
İnce manipülasyon, 10 ila 100 Hz’de çalışan bir kontrol döngüsü gerektirir ve 7 milyar veya daha fazla parametreli bir modeli robotun kendi donanımında bu hıza çıkarmak, çözümlenmiş mühendislikten çok bir hedeftir.
Bu yüzden çoğu konuşlandırılmış sistem ya bir uç sunucuya bağlıdır ya da Gemini Robotics 1.5’ta olduğu gibi akıl yürütmeyi kontrolden ayırır.
Ayrıklaştırma, katman atlama ve damıtma yardımcı olur; fakat bunlar, yerleşmiş yanıtlar olmaktan ziyade insanların üzerinde yineleme yaptığı ara çözümlerdir.
Artık herkesin indirebileceği yetkin açık ağırlıklar var; asıl ayrıştırıcı unsur veri oldu.
Çeşitli, iyi açıklamalı teleoperasyon verisi toplamak; web’i kazımak gibi hızlı ve ucuz değildir ve pi0’ın yayımlanan sonuçlarıyla, yalnızca kamu verileriyle yeniden üretilenler arasındaki uçurum, özel veri avantajının gerçekte neler sağladığının en net kanıtıdır.
Mevcut VLA’lar, eğitim dağılımları içinde iyi geneller ve bunun dışında gözle görülür şekilde bozulur.
Masaüstü manipülasyon üzerinde 22 bedenlenim boyunca eğitilmiş bir model, gerçekten hiç görmediği bir görev biçiminde yine de zayıf performans gösterebilir.
Gördüğünüz gibi, VLA modelleri, algıyı, dil anlayışını ve eylem üretimini tek bir mimaride bir araya getiriyor; bu, artımsal değil, yapısal bir dönüşümdür.
Klasik kontrolün başaramadığını yapabiliyorlar: Kimsenin açıkça eğitmediği koşullara genellemek; çünkü dil ve görme omurgaları, robot bir gösterim görmeden önce bile fiziksel dünyanın çalışan bir modelini robota taşır.
2026 itibarıyla beni en çok şaşırtan şey, zor sorunun ne kadar yer değiştirdiği.
Üç yıl önce zor soru mimariydi.
Şimdi OpenVLA, Octo, pi0 ve SmolVLA GitHub’da herkesin indirmesi için durduğuna göre, zor sorular veri kalitesi, toparlanma davranışı ve bunların herhangi birini veri merkezinde değil de bizzat robotun üzerinde 50 Hz’de gerçekten çalıştırıp çalıştıramayacağınızdır.
Devam etmek isterseniz, DataCamp’in Yapay Zekâ Ajanlarına Giriş kursu daha geniş ajan bağlamını, Büyük Dil Modelleri (LLM’ler) Kavramları ise işin omurga tarafını kapsar.
Öne Çıkan DataCamp Kursları
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme




