Stel, je zegt tegen iemand: “Pak de mok en zet hem op de plank.” Daar is geen schema voor nodig; diegene kijkt naar de mok, begrijpt de zin en steekt zijn hand uit.
Drie dingen vonden hier bijna tegelijk plaats. Zien, begrijpen en bewegen gebeuren voor die persoon vrijwel tegelijkertijd, niet als drie losse stappen die tussen verschillende hersendelen worden doorgegeven.
Het grootste deel van de geschiedenis van robotische AI werkte dat bij machines totaal niet zo.
We hadden vroeger vision-language-modellen die naar een rommelige werkbank konden kijken en precies konden beschrijven wat erop lag, inclusief details zoals het merk van een stuk gereedschap.
Klassieke robotcontrollers konden die schroevendraaier betrouwbaar oppakken, zolang niemand hem twee centimeter naar links verschoof. De twee helften van het probleem, zien en begrijpen aan de ene kant en handelen aan de andere, ontwikkelden zich vrijwel volledig los van elkaar.
Hier komen vision-language-action- (VLA-)modellen in beeld – een poging om dat gat te dichten.
In dit artikel bekijken we wat VLA-modellen zijn en hoe hun driedelige architectuur werkt. We vergelijken ze met vision-language-modellen (VLM’s) en met klassieke robotbesturing, bespreken de modellen die er in 2026 echt toe doen en waar ze worden gebruikt. Tot slot kijken we naar wat CLA-modi nog steeds verkeerd doen.
Wat zijn vision-language-action- (VLA-)modellen?
Laten we beginnen met een formele definitie van VLA-modellen:
Een vision-language-action-model is een AI-systeem dat een camerafeed, een instructie in natuurlijke taal en de eigen toestand van de robot verwerkt en vervolgens motorcommando’s uitstuurt, waarbij de visie-, taal- en actie-modules gezamenlijk zijn getraind en in één forward pass draaien in plaats van in een klassieke pijplijn van waarnemen-plannen-regelen.
Het belangrijkste is dat perceptie, taal en actie geen aparte systemen zijn die met handgeschreven glue code aan elkaar zijn genaaid.
Het zijn submodules die gezamenlijk worden getraind. Dus een visuele of taalfout die in een klassieke pijplijn de overdracht zou doen ontsporen, wordt hier gecorrigeerd via gradient descent in plaats van opgevangen, of gemist, door een hardgecodeerde interface.
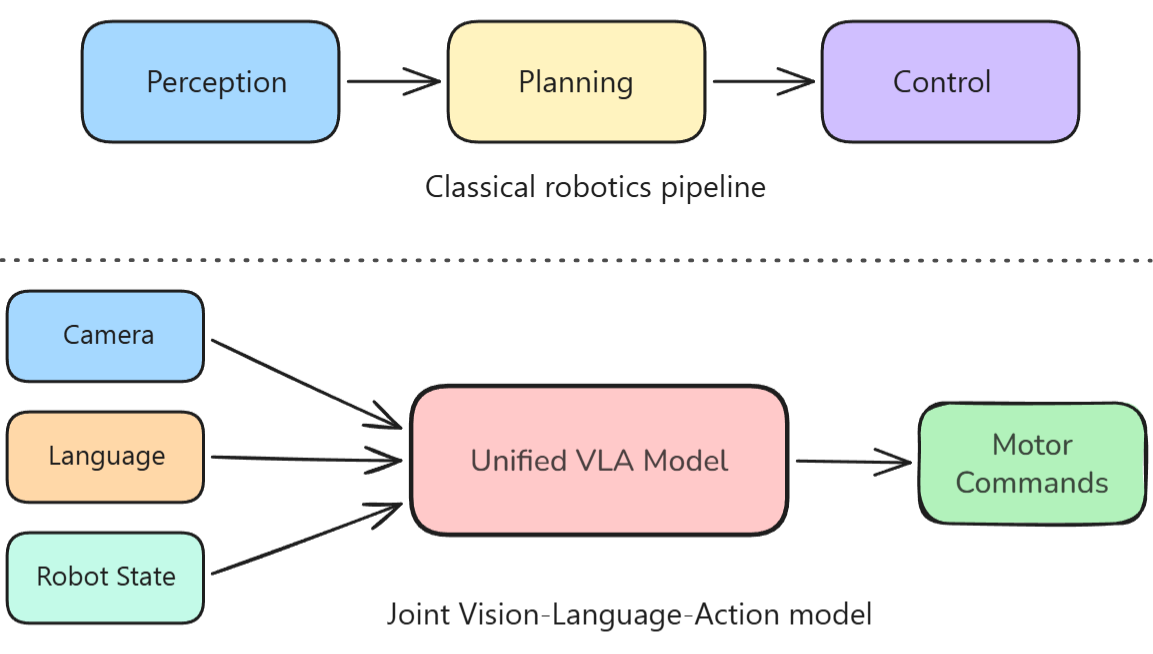
Boven: drie blokken met twee breekbare overdrachtsmomenten; onder: één gefuseerd model. Dit is het daadwerkelijke structurele verschil waar ik het steeds over heb. Afbeelding door de auteur.
Ik vat het verschil graag zo samen: een VLM is een brein zonder lichaam, en een VLA geeft het een lichaam.
De perceptie is geen aparte service waar de robot een call naar doet, maar zit juist ingebakken in de gezamenlijk getrainde pijplijn die beslist hoe ver de grijper moet bewegen.
Ik heb het ook al over VLM gehad, dus laten we deze twee architecturen vergelijken.
VLA vs. Vision-Language Model (VLM)
Een VLM (Vision-Language Model) neemt beelden en tekst als input en produceert tekst of embeddings.
Een VLA (Vision-Language-Action Model) daarentegen neemt dezelfde soort input en produceert juist een actie.
Dat klinkt als een kleine wijziging totdat je ziet wat het stroomafwaarts doet:
| |
Vision-language-model (VLM)
|
Vision-language-action-model (VLA)
|
|---|
|
Input
|
Afbeeldingen, video, tekst
|
Afbeeldingen (vaak meerdere camera’s), tekst, proprioceptieve staat van de robot
|
|
Output
|
Tekst, embeddings
|
Continue of gediscretiseerde motorcommando’s
|
|
Primaire capaciteit
|
Een scène beschrijven en erover redeneren
|
Handelen in een scène
|
|
Kan het in de wereld handelen?
|
Nee
|
Ja
|
|
Trainingsdata
|
Afbeelding-tekstparen van het web
|
Webdata plus robotdemonstratietrajecten
|
|
Typische toepassing
|
Visual question answering, bijschriften genereren, documentparsing
|
Manipulatie, navigatie, controle van humanoïden
|
Je hebt vast wel eens gehoord van modellen als GPT-4V, Gemini of LLaVA.
Een veelgemaakte aanname is dat een VLA gewoon zo’n model is met een robotarm eraan vast.
Maar zo simpel is het niet.
Het model moet een volledig nieuwe outputruimte leren, waarin een token overeenkomt met een echte fysieke grootheid, zoals verplaatsing van het end-effector of de opening van de grijper, en waar een fout een kopje van tafel stoot in plaats van een wat vreemd klinkende zin op te leveren.
Wil je zien hoe GPT-4V, Gemini en LLaVA zich verhouden tot de rest van het veld, bekijk dan DataCamp’s Top 10 Vision Language Models in 2026 met de huidige koplopers.
Er is ook een gevolg aan de datastructuurkant.
Een VLM kan trainen op miljarden afbeelding-tekstparen omdat het internet die gratis levert.
Robottrajecten daarentegen moeten worden verzameld door een echte robot die een echte taak uitvoert, meestal onder teleoperatie. Daarom komt de grootste open robotics-dataset, Open X-Embodiment, uit op ongeveer 1 miljoen trajecten in plaats van 1 miljard.
Het handmatig verzamelen van zulke trajecten is bovendien erg duur en traag.
22 belichamingen, één dataset, en nog steeds onder 1 miljoen trajecten in totaal. Dit bedoel ik als ik zeg dat robotdata niet schaalt zoals webtekst dat doet. Bron: Open X-Embodiment projectpagina.
VLA vs klassieke robotbesturing
Voordat we bespreken hoe de VLA-architectuur werkt, wil ik die ook vergelijken met klassieke robotbesturing.
Klassieke robotbesturing is gebouwd voor één taak op één plek, onder omstandigheden die vooraf strak zijn vastgelegd.
Neem bijvoorbeeld de arm van een automaat.
Die pakt elke keer hetzelfde snackje van dezelfde plank op exact dezelfde plek, omdat verlichting, objectposities en vereiste bewegingen tussen de picks niet veranderen.
Die smalle, onveranderlijke opstelling is precies wat het regelsysteem stug maar betrouwbaar maakt.
Maar verander nu de interne configuratie van de automaat, of de verlichting, of laat een object vallen dat nooit in het plan zat.
Dan faalt de controller volledig, omdat hij de omgeving nog nooit zo heeft gezien.
Een VLA generaliseert beter naar omstandigheden waarop niet expliciet is getraind, en de reden is dat de onderliggende VLM-backbone al weet hoe een mok, een handdoek of een lade eruitziet dankzij pretraining op web-schaal, nog vóór de eerste robotdemonstratie.
Fijn-afstemmen op honderd voorbeelden van handdoeken vouwen leert het model hoe te bewegen bij een object dat het al herkent.
Dát transfervermogen is de echte doorbraak, niet pure precisie, en ik wil erbij zeggen dat een goed afgestelde klassieke controller in een vaste, gecontroleerde setting nog steeds kan winnen op precisie van een VLA.
Hoe werken VLA-modellen?
Laten we de architectuur induiken.
Voor dit artikel kies ik de OpenVLA-architectuur, omdat die makkelijk te begrijpen is.
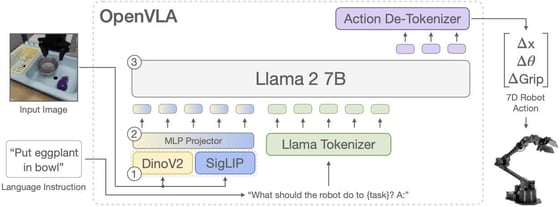
Dit is de pijplijn die ik hieronder beschrijf: DINOv2 en SigLIP voeden een Llama 2-backbone, met de action-decoder die gediscretiseerde tokens voorspelt aan het andere uiteinde. Bron: OpenVLA projectpagina.
Een VLA heeft drie afzonderlijke modules:
- Een vision-encoder
- Een language-backbone
- Een action-decoder
Deze worden end-to-end samen getraind.
De visuele en talige representaties worden gefuseerd, en deze gecombineerde representatie zet de action-decoder om in motorcommando’s.
Belangrijk: de drie delen zijn nauw gekoppeld in plaats van gepipelined. Dat is precies de ontwerpkeuze die een VLA onderscheidt van een VLM die op een controller is geschroefd.
Als het helpt, denk er dan aan zoals ik de splitsing tussen visie, geheugen en controller in het oorspronkelijke World Models-paper beschreef: het ziet, het begrijpt, het handelt.
Het verschil hier is dat een VLA alle drie de taken samen, end-to-end, leert op basis van demonstraties, in plaats van elk onderdeel apart te trainen en ze achteraf aan elkaar te knopen.
Laten we ze nu afzonderlijk bekijken.
Vision-encoder: wat het model ziet
De vision-encoder zet een ruwe cameraframe om in een dichte representatie waar de rest van het netwerk echt iets mee kan.
Moderne VLA’s gebruiken voorgetrainde vision transformers zoals DINOv2 of SigLIP, en vaak allebei tegelijk.
OpenVLA is een goed voorbeeld van het gebruik van beide.
Het fuseert DINOv2, sterk in ruimtelijke en geometrische details, met SigLIP, sterker in semantische kenmerken die goed aansluiten op taal.
De twee sets features worden per image patch geconcateneerd en geprojecteerd naar de embeddingruimte van het taalmodel (in dit geval LLama 2 7B).
Ik wil benadrukken dat het gebruik van meer dan één camera standaard is in echte deployments.
Een polsgemonteerde camera kan bijvoorbeeld dichtbijdetails geven tijdens de eindnadering van een object, een overheadcamera geeft de scène-indeling, en een zijaanzicht helpt met diepte die één enkele camera niet kan terugwinnen.
pi0 (daarover hieronder meer) neemt meerdere camerastandpunten plus de proprioceptieve staat van de robot.
Let op: toestand-input is belangrijker dan het klinkt, want een foto van een arm vertelt je niet welk koppel er op dat moment in de gewrichten staat.
Language-encoder: wat het model wordt verteld
De talige kant encodeert een instructie, iets als “pak het rode blok en leg het in de blauwe bak”, in een representatie die in dezelfde ruimte aansluit op de visuele features.
Vrijwel elke VLA hergebruikt een voorgetrainde large language model (LLM) als backbone in plaats van een tekstencoder vanaf nul te trainen.
In ons geval gebruikte OpenVLA Llama 2 7B. pi0 en pi0.5 bouwden op PaliGemma, een VLM met 3 miljard parameters. SmolVLA gebruikte een aangepaste SmolVLM2-stack.
Zo’n LLM hergebruiken draait echt om erfenis.
Je krijgt instructievolging en compositorisch begrip erbij, en daarom kan een VLA vaak “leg het fruit in de kom” aan, zelfs als die exacte zin nooit voorkwam tijdens de robottraining.
Action-decoder: wat het model doet
De action-decoder is waar de gefuseerde representatie daadwerkelijk een motorcommando wordt, en ook waar VLA-ontwerpen het meest van elkaar verschillen. Er zijn op dit moment grofweg drie benaderingen in gebruik.
Autoregressieve tokenvoorspelling
Je hakt elke actiedimensie in discrete bins en voorspelt ze één voor één, dezelfde next-token-opzet waar een LLM al op traint.
OpenVLA gebruikt 256 bins per dimensie en een normale next-token-loss, zodat je de gebruikelijke LLM-tooling kunt behouden.
Wat je inlevert is resolutie en snelheid: de binning laat hoekige bewegingen achter en token-voor-token samplen is te traag voor iets snels of contactintensiefs.
Diffusie- en flow-matching-decoding
In plaats van één token per keer te voorspellen, behandelt het model actiegeneratie als een denoiseproces en produceert het in één keer een hele brok continue acties.
pi0 was de eerste VLA rond een flow-matching-actiehead, waarbij in ongeveer 10 stappen werd gedenoised om een brok van tot 50 toekomstige acties te produceren.
Dit maakte de resulterende beweging merkbaar vloeiender dan alles op basis van tokens.
Hybride architecturen op twee niveaus
Een groter model handelt het hoog-niveau redeneren af en splitst de taak in stappen, terwijl een kleinere, snellere controller de precieze, hoogfrequente uitvoering verzorgt.
Een goed voorbeeld vind ik Gemini Robotics 1.5, waar een redeneermodel is gekoppeld aan een actiemodel.
Eerlijk gezegd, na het lezen van een aantal van deze papers, besteden mensen veel meer energie aan discussies over de backbone-grootte dan over de actiehead, en dat vind ik de verkeerde volgorde.
Als je decoder een 7-dimensionale continue actie in 256 discrete bins perst, krijg je die soepelheid met geen enkele backbonekwaliteit meer terug!
Belangrijke VLA-modellen in 2026
Hieronder een tabel met een paar echt belangrijke VLA-modellen waar je waarschijnlijk mee te maken krijgt:
|
Model
|
Ontwikkelaar
|
Parameters
|
Actiehead
|
Licentie
|
Hardware
|
Beste voor
|
|---|
|
OpenVLA
|
Stanford, Berkeley en samenwerkende partijen
|
7B
|
Autoregressieve tokens
|
MIT
|
A100 of H100, of 24GB met 4-bit kwantisatie
|
Open onderzoeksbaseline
|
|
Octo
|
UC Berkeley
|
27M of 93M
|
Diffusion policy
|
MIT
|
Eén RTX 4090
|
Werk met beperkte compute
|
|
pi0 / pi0.5 / pi0.6
|
Physical Intelligence
|
3,3B (3B backbone plus 300M actie-expert)
|
Flow matching
|
Open checkpoints (openpi)
|
Multi-GPU of één A100
|
Behendige, langetermijntaken
|
|
Gemini Robotics 1.5
|
Google DeepMind
|
Niet bekendgemaakt
|
Hybride, cloud plus edge
|
Gesloten
|
Cloud-gekoppeld
|
Propriëtaire frontier-baseline
|
|
SmolVLA
|
Hugging Face
|
450M
|
Flow matching
|
Apache 2.0
|
RTX 3060, laptop-GPU of Jetson
|
Hobby- en edge-robotica
|
Laten we ze nu één voor één doornemen, te beginnen met de onderzoeksbaseline waarmee de meesten nog steeds vergelijken.
OpenVLA
OpenVLA is een model met 7 miljard parameters, getraind op 970.000 echte robotdemonstraties uit Open X-Embodiment.
Het combineert een Llama 2 7B-backbone met de gefuseerde DINOv2- en SigLIP-vision-encoder, die ik eerder beschreef, en het hele model is open source.
De verrassende uitkomst was dat het het gesloten RT-2-X-model versloeg met 16,5 procentpunt meer taaksucces over 29 taken, terwijl RT-2-X 55 miljard parameters draaide tegenover de 7 miljard van OpenVLA!
Het totale trainen duurde 15 dagen op 64 A100-GPU’s.
De reden dat het nog steeds populair is, is dat LoRA-fine-tuning en 4-bit kwantisatie er goed op werken.
Dit betekent dat een 24GB RTX 4090 een gekwantiseerde versie kan draaien, en het meeste gepubliceerde werk over VLA-aanvallen, -verdedigingen en -pruning gebruikt OpenVLA als doelwit simpelweg omdat het zo toegankelijk is.
Een vervolg – OpenVLA-OFT verbeterde het fine-tuningrecept voor zowel snelheid als succesratio.
Octo
Octo is een kleine VLA en komt in twee maten – 27 miljoen en 93 miljoen parameters op respectievelijk ViT-S- en ViT-B-backbones, en draait op een enkele RTX 4090 met 20 tot 30 Hz.
Het is getraind op circa 800.000 trajecten uit Open X-Embodiment over 22 robotbelichamingen, en de transformer-architectuur is echt modulair.
Je kunt tijdens fine-tuning een nieuwe observatie-input toevoegen of de actiehead wisselen zonder het model vanaf nul opnieuw te bouwen, en het ondersteunt discrete tokens en diffusiegebaseerde continue acties, afhankelijk van wat je nodig hebt.
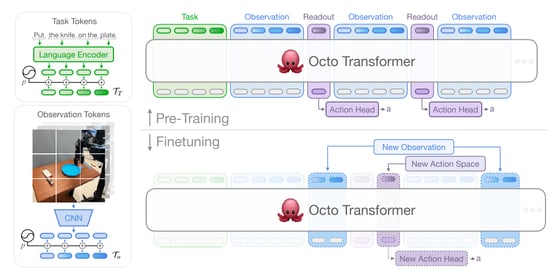
De transformer van Octo: taak- en observatietokens erin, readout-tokens eruit naar de actiehead, met ruimte om bij fine-tuning nieuwe sensoren of actieruimten toe te voegen. Bron: Octo-paper.
Ik gebruik Octo persoonlijk wanneer de beperkende factor compute is in plaats van taakmoeilijkheid.
Het ondersteunt ook doelafbeeldingsconditionering, wat handig is wanneer het omschrijven van je doelsituatie in woorden lastiger is dan gewoon een foto laten zien van wat je wilt.
pi0 en de Physical Intelligence-familie
pi0 van Physical Intelligence is erg goed in behendigheid. Het start vanaf PaliGemma, een open VLM met 3 miljard parameters, en voegt een actie-expert van 300 miljoen parameters toe die vanaf nul is getraind, samen goed voor 3,3 miljard parameters.
Het gebruikt flow matching om in één keer een brok van tot 50 toekomstige acties te produceren in plaats van stap voor stap.
Het belangrijkste resultaat waren bimanuële taken zoals was vouwen, boodschappen inpakken en dozen monteren, allemaal met een behendigheid die niets eerder had laten zien.
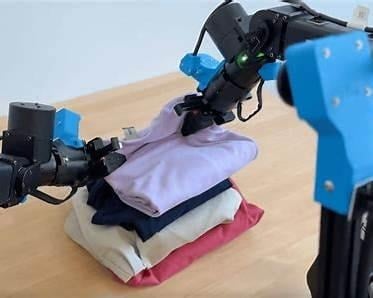
pi0-robot die met twee armen was vouwt. Dit is een van de bimanuële taken die ik noemde, was vouwen; dit moet je eigenlijk zien in plaats van alleen lezen. Bron: Physical Intelligence, “pi0: Our First Generalist Policy”.
Flow matching doet hier het echte werk, omdat het coördineren van twee armen tegelijk vloeiende, continue 16-dimensionale output vereist, en noch discrete tokens noch trage diffusiesampling leveren dat op bruikbare snelheid.
De pi0-familie is blijven evolueren:
- pi0.5 (april 2025): voegde open-wereld-generalizatie toe met een tweefasenproces dat eerst een hoog-niveau subtaak in woorden voorspelt en daarna de laag-niveau actie
- pi0.6 (november 2025): leert van de eigen ervaring van de robot in plaats van alleen van demonstraties
- openpi: checkpoints en een benaderende trainingspijplijn staan in de openpi-repository, voorgetraind op meer dan 10.000 uur robotdata
Eén kanttekening die ik wil noemen is dat de sterkste resultaten van pi0 afhangen van propriëtaire data, verzameld over hun eigen robotvloot.
Niemand buiten het bedrijf heeft die exacte cijfers gerepliceerd met alleen publieke data, dus hoeveel van de performance uit de architectuur komt versus uit het data-voordeel is nog echt onduidelijk.
Gemini Robotics 1.5
Gemini Robotics 1.5 van Google DeepMind moet je zien als twee samenwerkende modellen in plaats van één.
Gemini Robotics-ER 1.5 is een belichaamd redeneermodel dat plant, tools kan aanroepen zoals Google Zoeken en zijn eigen voortgang kan inschatten bij een taak.
Gemini Robotics 1.5 is de VLA die uitvoert wat het redeneermodel beslist.
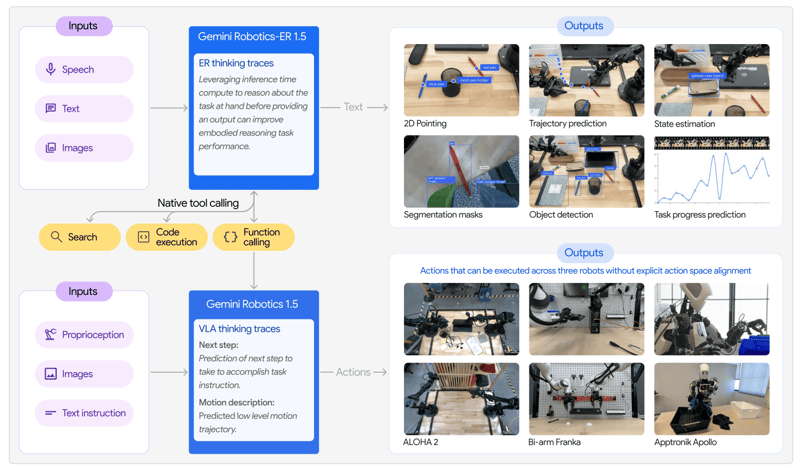
Boven: Gemini Robotics-ER 1.5 voor belichaamd redeneren; eronder Gemini Robotics 1.5 als VLA; gedeelde tool-calls in het midden; acties draaien op ALOHA 2, Franka en Apollo zonder afstemming van de actieruimte. Bron: Gemini Robotics 1.5-paper.
Het nuttige hier is dat het acties mengt met een intern redeneerproces in natuurlijke taal, zodat de robot nadenkt vóór hij handelt en achteraf kan uitleggen wat hij heeft besloten.
Bij een instructie als “sorteer mijn was op kleur” werkt het eerst uit dat wit in één bak gaat en de rest in een andere, en plant dan de individuele picks.
DeepMind meldt ongeveer 250 milliseconden van observatie tot actie, een effectieve control frequentie van 50 Hz, bereikt door het zware redeneren in de cloud te doen en een lichte action-decoder lokaal op de robot te houden.
Een ander resultaat dat ik wil noemen is Motion Transfer: een taak, geleerd op het dual-arm ALOHA 2-platform, werd direct overgezet naar een Franka bi-arm-opstelling en naar de Apollo-humanoid van Apptronik, zonder hertraining op beide.
De gewichten zijn gesloten, dus beschouw dit als de propriëtaire frontier-baseline in plaats van iets dat je zelf kunt downloaden en fine-tunen.
SmolVLA
SmolVLA van Hugging Face heeft 450 miljoen parameters (onder een Apache 2.0-licentie). Het koppelt een aangepaste SmolVLM2-backbone aan een flow-matching-actie-expert, met layer skipping en een gereduceerd aantal visuele tokens om inferentie goedkoop genoeg te houden voor kleine hardware.
Het draait op een enkele consumenten-GPU, waaronder een RTX 3060, op de CPU van een MacBook (wel traag), en het wordt uitgerold op een Jetson Orin voor onboard-inferentie.
Fine-tuning gedurende 20.000 stappen duurt ongeveer 4 tot 5 uur op één A100-GPU.
Ondanks training op minder dan 30.000 episodes, evenaart of verslaat het aanzienlijk grotere modellen op LIBERO, Meta-World en echte SO-100- en SO-101-armen.
Het mooiste is dat het geheel is voorgetraind op door de community bijgedragen datasets via het LeRobot-framework.
Hoe kies je een VLA voor je project
Nu ik een aantal VLA-modellen heb gepresenteerd, laten we het hebben over welke je voor jouw project kiest.
Kiezen tussen deze vijf draait vooral om het matchen van controlfrequentie en hardware aan je eigen setup, niet om achter het model aan te lopen dat vorige maand bovenaan een leaderboard stond.
Zo zou ik er ongeveer over nadenken:
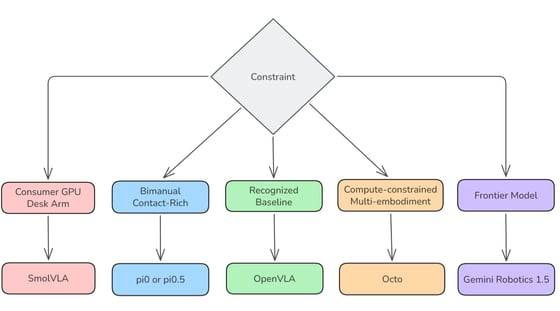
Vijf beperkingen, vijf modellen. Als je maar één diagram uit dit artikel onthoudt, laat het dan deze zijn. Afbeelding door de auteur.
Heb je een consumenten-GPU of een SO-101-arm op je bureau staan, begin dan met SmolVLA. Niets anders in het open ecosysteem levert je zo goedkoop een werkend beleid op.
- Als de taak rijk is aan contact of bimanuële manipulatie vereist, ga dan direct naar pi0 of pi0.5. De flow-matching-head is perfect voor zulke behendigheidstaken.
- Schrijf je een paper en heb je een baseline nodig die reviewers herkennen, gebruik dan OpenVLA, simpelweg omdat iedereen het al heeft.
- Als compute de beperking is, maar je toch multi-belichaming wilt, is Octo de verstandige keuze.
- Wil je zien wat er mogelijk is aan de frontier, kijk dan naar Gemini Robotics 1.5, met het besef dat je het niet zelf kunt hosten.
En de laatste hoofdboodschap die ik wil meegeven is dat honderd schone demonstraties op SmolVLA bijna altijd winnen van vijftig rommelige op OpenVLA.
Daarmee bedoel ik: besteed 60 tot 70 procent van je projecttijd aan dataverzameling en kwaliteitscontrole, en de rest aan training.
Toepassingen van VLA-modellen
VLA’s zijn uit demovideo’s gestapt en in een handvol echte deployments beland, zij het ongelijkmatig.
Het patroon dat ik zie: ze landen het eerst waar de omgeving te veel variatie heeft om te scripten, maar waar een mens nog kan ingrijpen als er iets misgaat. Enkele voorbeelden:
Robotische manipulatie
Dit is het primaire domein, met taken als pick-and-place, kitting, inpakken, sorteren, assemblage, enz.
Dit zijn taken waarbij de robot objecten moet identificeren, vastgrijpen en verplaatsen waarvan positie en oriëntatie tussen pogingen wisselen, precies de situatie waar gescripte systemen slecht mee omgaan.
Magazijn- en fulfilmentwerk is nu de duidelijkste commerciële case. Een gescripte picker heeft het item elke keer op dezelfde manier gepresenteerd nodig, terwijl een VLA-gebaseerde picker een bak met veertig verschillende SKU’s door elkaar aankan.
Humanoïde robots
Bedrijven als Figure, 1X en Apptronik bouwen op VLA-fundamenten, en de reden is simpel: een bipede robot met twee werkende handen heeft te veel mogelijke taken om stuk voor stuk te scripten.
Het Motion Transfer-resultaat van Gemini Robotics, waarbij een vaardigheid getraind op ALOHA 2 direct werd overgezet naar de Apollo-humanoid van Apptronik, is precies de eigenschap die een humanoïdenprogramma nodig heeft om op te schalen.
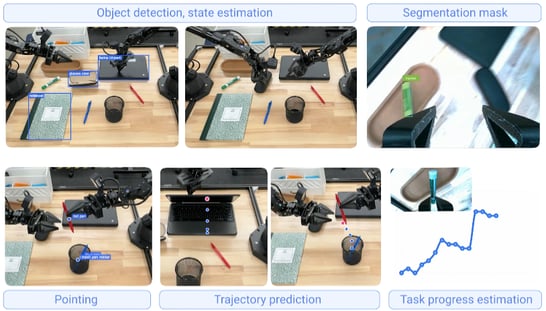
Dezelfde vaardigheid, één keer getraind op ALOHA 2, draait op de Apollo-humanoid van Apptronik zonder hertraining. Bron: Google DeepMind, “Gemini Robotics 1.5 brings AI agents into the physical world”.
Autonome voertuigen
Rijstacks beginnen VLA-achtige architecturen te adopteren om te verbinden wat de auto ziet met wat hij daarna moet doen, binnen één redeneerloop in plaats van een overdracht van perceptie naar planner.
De aantrekkingskracht is dezelfde als bij manipulatie: zeldzame situaties die geen enkele regel ooit voorzag, afgehandeld door een model dat genoeg van de wereld heeft gezien om erover te redeneren in plaats van vast te lopen.
Chirurgische en medische robotica
Dit is de toepassing in de vroegste fase op deze lijst.
Het idee is dat een systeem dat een mondelinge instructie van een chirurg kan volgen en zich kan aanpassen aan variabele weefselcondities beter is dan een rigide geprogrammeerd systeem, maar regulatorische goedkeuring is hier de belangrijkste beperking, niet de modelcapaciteit.
Ik verwacht hier eerst assistieve en trainingsapplicaties, lang voordat er iets komt dat in de buurt van autonoom is.
Vision Language Action-modellen: uitdagingen en beperkingen
Hoewel VLA’s geweldig zijn, hebben ze nog zwaktes, vooral op vier specifieke punten:
Herstel midden in een taak
VLA’s gaan redelijk om met variatie aan het begin van een taak, maar als een greep halverwege wegglijdt of een object onder de grijper verschuift, is herstel inconsistent.
De meeste demonstratiedata leggen geslaagde pogingen vast, dus het model heeft weinig voorbeelden gezien van hoe herstel uit een fout er daadwerkelijk uitziet.
Inferentie op het apparaat
Fijnmanipulatie vereist een control loop van 10 tot 100 Hz, en een model met 7 miljard of meer parameters dat tempo laten halen op de eigen hardware van de robot is nog een streven, geen opgelost engineeringprobleem.
Daarom zijn de meeste ingezette systemen ofwel gekoppeld aan een edge-server, ofwel splitsen ze redeneren en controle, zoals Gemini Robotics 1.5 doet.
Kwantisatie, layer skipping en distillatie helpen allemaal, maar het zijn workaround’s waar nog aan wordt gesleuteld, geen definitieve antwoorden.
De databottleneck
Nu er capabele open gewichten bestaan die iedereen kan downloaden, is data de echte onderscheidende factor geworden.
Het verzamelen van diverse, goed geannoteerde teleoperatiedata is traag en duur op een manier die webscraping nooit was, en de kloof tussen de gepubliceerde resultaten van pi0 en wat iemand met alleen publieke data heeft gereproduceerd is het duidelijkste bewijs van wat een privé data-voordeel je oplevert.
Grenzen aan generalisatie
Huidige VLA’s generaliseren goed binnen hun trainingsdistributie en gaan merkbaar achteruit daarbuiten.
Een model dat over 22 belichamingen op tafelmanipulatie is getraind, kan nog steeds slecht presteren op een taakvorm die het echt nooit heeft gezien.
Slotgedachten
Zoals je ziet, brengen VLA-modellen waarneming, taalbegrip en actiegeneratie samen in één architectuur, en dat is een structurele verschuiving, geen incrementele.
Wat ze wél kunnen en klassieke besturing nooit lukte, is generaliseren naar omstandigheden waarop niemand ze expliciet heeft getraind, omdat de taal- en visie-backbones al een werkend model van de fysieke wereld meebrengen in de robot voordat die ooit een demonstratie ziet.
Wat me in 2026 misschien nog het meest verbaast, is hoezeer de moeilijke vraag is verschoven.
Drie jaar geleden ging het moeilijke vraagstuk over architectuur.
Nu OpenVLA, Octo, pi0 en SmolVLA allemaal op GitHub staan om te downloaden, gaan de moeilijke vragen over datakwaliteit, herstelgedrag en of je dit überhaupt op 50 Hz op de robot zelf kunt draaien in plaats van in een datacenter.
Wil je verder, dan behandelt DataCamp’s Introduction to AI Agents-cursus de bredere agentic-context, en Large Language Models (LLMs) Concepts de backbone-kant.




Stel, je zegt tegen iemand: “Pak de mok en zet hem op de plank.” Daar is geen schema voor nodig; diegene kijkt naar de mok, begrijpt de zin en steekt zijn hand uit.
Drie dingen vonden hier bijna tegelijk plaats. Zien, begrijpen en bewegen gebeuren voor die persoon vrijwel tegelijkertijd, niet als drie losse stappen die tussen verschillende hersendelen worden doorgegeven.
Het grootste deel van de geschiedenis van robotische AI werkte dat bij machines totaal niet zo.
We hadden vroeger vision-language-modellen die naar een rommelige werkbank konden kijken en precies konden beschrijven wat erop lag, inclusief details zoals het merk van een stuk gereedschap.
Klassieke robotcontrollers konden die schroevendraaier betrouwbaar oppakken, zolang niemand hem twee centimeter naar links verschoof. De twee helften van het probleem, zien en begrijpen aan de ene kant en handelen aan de andere, ontwikkelden zich vrijwel volledig los van elkaar.
Hier komen vision-language-action- (VLA-)modellen in beeld – een poging om dat gat te dichten.
In dit artikel bekijken we wat VLA-modellen zijn en hoe hun driedelige architectuur werkt. We vergelijken ze met vision-language-modellen (VLM’s) en met klassieke robotbesturing, bespreken de modellen die er in 2026 echt toe doen en waar ze worden gebruikt. Tot slot kijken we naar wat CLA-modi nog steeds verkeerd doen.
Wat zijn vision-language-action- (VLA-)modellen?
Laten we beginnen met een formele definitie van VLA-modellen:
Een vision-language-action-model is een AI-systeem dat een camerafeed, een instructie in natuurlijke taal en de eigen toestand van de robot verwerkt en vervolgens motorcommando’s uitstuurt, waarbij de visie-, taal- en actie-modules gezamenlijk zijn getraind en in één forward pass draaien in plaats van in een klassieke pijplijn van waarnemen-plannen-regelen.
Het belangrijkste is dat perceptie, taal en actie geen aparte systemen zijn die met handgeschreven glue code aan elkaar zijn genaaid.
Het zijn submodules die gezamenlijk worden getraind. Dus een visuele of taalfout die in een klassieke pijplijn de overdracht zou doen ontsporen, wordt hier gecorrigeerd via gradient descent in plaats van opgevangen, of gemist, door een hardgecodeerde interface.
Boven: drie blokken met twee breekbare overdrachtsmomenten; onder: één gefuseerd model. Dit is het daadwerkelijke structurele verschil waar ik het steeds over heb. Afbeelding door de auteur.
Ik vat het verschil graag zo samen: een VLM is een brein zonder lichaam, en een VLA geeft het een lichaam.
De perceptie is geen aparte service waar de robot een call naar doet, maar zit juist ingebakken in de gezamenlijk getrainde pijplijn die beslist hoe ver de grijper moet bewegen.
Ik heb het ook al over VLM gehad, dus laten we deze twee architecturen vergelijken.
VLA vs. Vision-Language Model (VLM)
Een VLM (Vision-Language Model) neemt beelden en tekst als input en produceert tekst of embeddings.
Een VLA (Vision-Language-Action Model) daarentegen neemt dezelfde soort input en produceert juist een actie.
Dat klinkt als een kleine wijziging totdat je ziet wat het stroomafwaarts doet:
Vision-language-model (VLM)
Vision-language-action-model (VLA)
Input
Afbeeldingen, video, tekst
Afbeeldingen (vaak meerdere camera’s), tekst, proprioceptieve staat van de robot
Output
Tekst, embeddings
Continue of gediscretiseerde motorcommando’s
Primaire capaciteit
Een scène beschrijven en erover redeneren
Handelen in een scène
Kan het in de wereld handelen?
Nee
Ja
Trainingsdata
Afbeelding-tekstparen van het web
Webdata plus robotdemonstratietrajecten
Typische toepassing
Visual question answering, bijschriften genereren, documentparsing
Manipulatie, navigatie, controle van humanoïden
Je hebt vast wel eens gehoord van modellen als GPT-4V, Gemini of LLaVA.
Een veelgemaakte aanname is dat een VLA gewoon zo’n model is met een robotarm eraan vast.
Maar zo simpel is het niet.
Het model moet een volledig nieuwe outputruimte leren, waarin een token overeenkomt met een echte fysieke grootheid, zoals verplaatsing van het end-effector of de opening van de grijper, en waar een fout een kopje van tafel stoot in plaats van een wat vreemd klinkende zin op te leveren.
Wil je zien hoe GPT-4V, Gemini en LLaVA zich verhouden tot de rest van het veld, bekijk dan DataCamp’s Top 10 Vision Language Models in 2026 met de huidige koplopers.
Er is ook een gevolg aan de datastructuurkant.
Een VLM kan trainen op miljarden afbeelding-tekstparen omdat het internet die gratis levert.
Robottrajecten daarentegen moeten worden verzameld door een echte robot die een echte taak uitvoert, meestal onder teleoperatie. Daarom komt de grootste open robotics-dataset, Open X-Embodiment, uit op ongeveer 1 miljoen trajecten in plaats van 1 miljard.
Het handmatig verzamelen van zulke trajecten is bovendien erg duur en traag.
22 belichamingen, één dataset, en nog steeds onder 1 miljoen trajecten in totaal. Dit bedoel ik als ik zeg dat robotdata niet schaalt zoals webtekst dat doet. Bron: Open X-Embodiment projectpagina.
VLA vs klassieke robotbesturing
Voordat we bespreken hoe de VLA-architectuur werkt, wil ik die ook vergelijken met klassieke robotbesturing.
Klassieke robotbesturing is gebouwd voor één taak op één plek, onder omstandigheden die vooraf strak zijn vastgelegd.
Neem bijvoorbeeld de arm van een automaat.
Die pakt elke keer hetzelfde snackje van dezelfde plank op exact dezelfde plek, omdat verlichting, objectposities en vereiste bewegingen tussen de picks niet veranderen.
Die smalle, onveranderlijke opstelling is precies wat het regelsysteem stug maar betrouwbaar maakt.
Maar verander nu de interne configuratie van de automaat, of de verlichting, of laat een object vallen dat nooit in het plan zat.
Dan faalt de controller volledig, omdat hij de omgeving nog nooit zo heeft gezien.
Een VLA generaliseert beter naar omstandigheden waarop niet expliciet is getraind, en de reden is dat de onderliggende VLM-backbone al weet hoe een mok, een handdoek of een lade eruitziet dankzij pretraining op web-schaal, nog vóór de eerste robotdemonstratie.
Fijn-afstemmen op honderd voorbeelden van handdoeken vouwen leert het model hoe te bewegen bij een object dat het al herkent.
Dát transfervermogen is de echte doorbraak, niet pure precisie, en ik wil erbij zeggen dat een goed afgestelde klassieke controller in een vaste, gecontroleerde setting nog steeds kan winnen op precisie van een VLA.
Hoe werken VLA-modellen?
Laten we de architectuur induiken.
Voor dit artikel kies ik de OpenVLA-architectuur, omdat die makkelijk te begrijpen is.
Dit is de pijplijn die ik hieronder beschrijf: DINOv2 en SigLIP voeden een Llama 2-backbone, met de action-decoder die gediscretiseerde tokens voorspelt aan het andere uiteinde. Bron: OpenVLA projectpagina.
Een VLA heeft drie afzonderlijke modules:
Deze worden end-to-end samen getraind.
De visuele en talige representaties worden gefuseerd, en deze gecombineerde representatie zet de action-decoder om in motorcommando’s.
Belangrijk: de drie delen zijn nauw gekoppeld in plaats van gepipelined. Dat is precies de ontwerpkeuze die een VLA onderscheidt van een VLM die op een controller is geschroefd.
Als het helpt, denk er dan aan zoals ik de splitsing tussen visie, geheugen en controller in het oorspronkelijke World Models-paper beschreef: het ziet, het begrijpt, het handelt.
Het verschil hier is dat een VLA alle drie de taken samen, end-to-end, leert op basis van demonstraties, in plaats van elk onderdeel apart te trainen en ze achteraf aan elkaar te knopen.
Laten we ze nu afzonderlijk bekijken.
Vision-encoder: wat het model ziet
De vision-encoder zet een ruwe cameraframe om in een dichte representatie waar de rest van het netwerk echt iets mee kan.
Moderne VLA’s gebruiken voorgetrainde vision transformers zoals DINOv2 of SigLIP, en vaak allebei tegelijk.
OpenVLA is een goed voorbeeld van het gebruik van beide.
Het fuseert DINOv2, sterk in ruimtelijke en geometrische details, met SigLIP, sterker in semantische kenmerken die goed aansluiten op taal.
De twee sets features worden per image patch geconcateneerd en geprojecteerd naar de embeddingruimte van het taalmodel (in dit geval LLama 2 7B).
Ik wil benadrukken dat het gebruik van meer dan één camera standaard is in echte deployments.
Een polsgemonteerde camera kan bijvoorbeeld dichtbijdetails geven tijdens de eindnadering van een object, een overheadcamera geeft de scène-indeling, en een zijaanzicht helpt met diepte die één enkele camera niet kan terugwinnen.
pi0 (daarover hieronder meer) neemt meerdere camerastandpunten plus de proprioceptieve staat van de robot.
Let op: toestand-input is belangrijker dan het klinkt, want een foto van een arm vertelt je niet welk koppel er op dat moment in de gewrichten staat.
Language-encoder: wat het model wordt verteld
De talige kant encodeert een instructie, iets als “pak het rode blok en leg het in de blauwe bak”, in een representatie die in dezelfde ruimte aansluit op de visuele features.
Vrijwel elke VLA hergebruikt een voorgetrainde large language model (LLM) als backbone in plaats van een tekstencoder vanaf nul te trainen.
In ons geval gebruikte OpenVLA Llama 2 7B. pi0 en pi0.5 bouwden op PaliGemma, een VLM met 3 miljard parameters. SmolVLA gebruikte een aangepaste SmolVLM2-stack.
Zo’n LLM hergebruiken draait echt om erfenis.
Je krijgt instructievolging en compositorisch begrip erbij, en daarom kan een VLA vaak “leg het fruit in de kom” aan, zelfs als die exacte zin nooit voorkwam tijdens de robottraining.
Action-decoder: wat het model doet
De action-decoder is waar de gefuseerde representatie daadwerkelijk een motorcommando wordt, en ook waar VLA-ontwerpen het meest van elkaar verschillen. Er zijn op dit moment grofweg drie benaderingen in gebruik.
Autoregressieve tokenvoorspelling
Je hakt elke actiedimensie in discrete bins en voorspelt ze één voor één, dezelfde next-token-opzet waar een LLM al op traint.
OpenVLA gebruikt 256 bins per dimensie en een normale next-token-loss, zodat je de gebruikelijke LLM-tooling kunt behouden.
Wat je inlevert is resolutie en snelheid: de binning laat hoekige bewegingen achter en token-voor-token samplen is te traag voor iets snels of contactintensiefs.
Diffusie- en flow-matching-decoding
In plaats van één token per keer te voorspellen, behandelt het model actiegeneratie als een denoiseproces en produceert het in één keer een hele brok continue acties.
pi0 was de eerste VLA rond een flow-matching-actiehead, waarbij in ongeveer 10 stappen werd gedenoised om een brok van tot 50 toekomstige acties te produceren.
Dit maakte de resulterende beweging merkbaar vloeiender dan alles op basis van tokens.
Hybride architecturen op twee niveaus
Een groter model handelt het hoog-niveau redeneren af en splitst de taak in stappen, terwijl een kleinere, snellere controller de precieze, hoogfrequente uitvoering verzorgt.
Een goed voorbeeld vind ik Gemini Robotics 1.5, waar een redeneermodel is gekoppeld aan een actiemodel.
Eerlijk gezegd, na het lezen van een aantal van deze papers, besteden mensen veel meer energie aan discussies over de backbone-grootte dan over de actiehead, en dat vind ik de verkeerde volgorde.
Als je decoder een 7-dimensionale continue actie in 256 discrete bins perst, krijg je die soepelheid met geen enkele backbonekwaliteit meer terug!
Belangrijke VLA-modellen in 2026
Hieronder een tabel met een paar echt belangrijke VLA-modellen waar je waarschijnlijk mee te maken krijgt:
Model
Ontwikkelaar
Parameters
Actiehead
Licentie
Hardware
Beste voor
OpenVLA
Stanford, Berkeley en samenwerkende partijen
7B
Autoregressieve tokens
MIT
A100 of H100, of 24GB met 4-bit kwantisatie
Open onderzoeksbaseline
Octo
UC Berkeley
27M of 93M
Diffusion policy
MIT
Eén RTX 4090
Werk met beperkte compute
pi0 / pi0.5 / pi0.6
Physical Intelligence
3,3B (3B backbone plus 300M actie-expert)
Flow matching
Open checkpoints (openpi)
Multi-GPU of één A100
Behendige, langetermijntaken
Gemini Robotics 1.5
Google DeepMind
Niet bekendgemaakt
Hybride, cloud plus edge
Gesloten
Cloud-gekoppeld
Propriëtaire frontier-baseline
SmolVLA
Hugging Face
450M
Flow matching
Apache 2.0
RTX 3060, laptop-GPU of Jetson
Hobby- en edge-robotica
Laten we ze nu één voor één doornemen, te beginnen met de onderzoeksbaseline waarmee de meesten nog steeds vergelijken.
OpenVLA
OpenVLA is een model met 7 miljard parameters, getraind op 970.000 echte robotdemonstraties uit Open X-Embodiment.
Het combineert een Llama 2 7B-backbone met de gefuseerde DINOv2- en SigLIP-vision-encoder, die ik eerder beschreef, en het hele model is open source.
De verrassende uitkomst was dat het het gesloten RT-2-X-model versloeg met 16,5 procentpunt meer taaksucces over 29 taken, terwijl RT-2-X 55 miljard parameters draaide tegenover de 7 miljard van OpenVLA!
Het totale trainen duurde 15 dagen op 64 A100-GPU’s.
De reden dat het nog steeds populair is, is dat LoRA-fine-tuning en 4-bit kwantisatie er goed op werken.
Dit betekent dat een 24GB RTX 4090 een gekwantiseerde versie kan draaien, en het meeste gepubliceerde werk over VLA-aanvallen, -verdedigingen en -pruning gebruikt OpenVLA als doelwit simpelweg omdat het zo toegankelijk is.
Een vervolg – OpenVLA-OFT verbeterde het fine-tuningrecept voor zowel snelheid als succesratio.
Octo
Octo is een kleine VLA en komt in twee maten – 27 miljoen en 93 miljoen parameters op respectievelijk ViT-S- en ViT-B-backbones, en draait op een enkele RTX 4090 met 20 tot 30 Hz.
Het is getraind op circa 800.000 trajecten uit Open X-Embodiment over 22 robotbelichamingen, en de transformer-architectuur is echt modulair.
Je kunt tijdens fine-tuning een nieuwe observatie-input toevoegen of de actiehead wisselen zonder het model vanaf nul opnieuw te bouwen, en het ondersteunt discrete tokens en diffusiegebaseerde continue acties, afhankelijk van wat je nodig hebt.
De transformer van Octo: taak- en observatietokens erin, readout-tokens eruit naar de actiehead, met ruimte om bij fine-tuning nieuwe sensoren of actieruimten toe te voegen. Bron: Octo-paper.
Ik gebruik Octo persoonlijk wanneer de beperkende factor compute is in plaats van taakmoeilijkheid.
Het ondersteunt ook doelafbeeldingsconditionering, wat handig is wanneer het omschrijven van je doelsituatie in woorden lastiger is dan gewoon een foto laten zien van wat je wilt.
pi0 en de Physical Intelligence-familie
pi0 van Physical Intelligence is erg goed in behendigheid. Het start vanaf PaliGemma, een open VLM met 3 miljard parameters, en voegt een actie-expert van 300 miljoen parameters toe die vanaf nul is getraind, samen goed voor 3,3 miljard parameters.
Het gebruikt flow matching om in één keer een brok van tot 50 toekomstige acties te produceren in plaats van stap voor stap.
Het belangrijkste resultaat waren bimanuële taken zoals was vouwen, boodschappen inpakken en dozen monteren, allemaal met een behendigheid die niets eerder had laten zien.
pi0-robot die met twee armen was vouwt. Dit is een van de bimanuële taken die ik noemde, was vouwen; dit moet je eigenlijk zien in plaats van alleen lezen. Bron: Physical Intelligence, “pi0: Our First Generalist Policy”.
Flow matching doet hier het echte werk, omdat het coördineren van twee armen tegelijk vloeiende, continue 16-dimensionale output vereist, en noch discrete tokens noch trage diffusiesampling leveren dat op bruikbare snelheid.
De pi0-familie is blijven evolueren:
Eén kanttekening die ik wil noemen is dat de sterkste resultaten van pi0 afhangen van propriëtaire data, verzameld over hun eigen robotvloot.
Niemand buiten het bedrijf heeft die exacte cijfers gerepliceerd met alleen publieke data, dus hoeveel van de performance uit de architectuur komt versus uit het data-voordeel is nog echt onduidelijk.
Gemini Robotics 1.5
Gemini Robotics 1.5 van Google DeepMind moet je zien als twee samenwerkende modellen in plaats van één.
Gemini Robotics-ER 1.5 is een belichaamd redeneermodel dat plant, tools kan aanroepen zoals Google Zoeken en zijn eigen voortgang kan inschatten bij een taak.
Gemini Robotics 1.5 is de VLA die uitvoert wat het redeneermodel beslist.
Boven: Gemini Robotics-ER 1.5 voor belichaamd redeneren; eronder Gemini Robotics 1.5 als VLA; gedeelde tool-calls in het midden; acties draaien op ALOHA 2, Franka en Apollo zonder afstemming van de actieruimte. Bron: Gemini Robotics 1.5-paper.
Het nuttige hier is dat het acties mengt met een intern redeneerproces in natuurlijke taal, zodat de robot nadenkt vóór hij handelt en achteraf kan uitleggen wat hij heeft besloten.
Bij een instructie als “sorteer mijn was op kleur” werkt het eerst uit dat wit in één bak gaat en de rest in een andere, en plant dan de individuele picks.
DeepMind meldt ongeveer 250 milliseconden van observatie tot actie, een effectieve control frequentie van 50 Hz, bereikt door het zware redeneren in de cloud te doen en een lichte action-decoder lokaal op de robot te houden.
Een ander resultaat dat ik wil noemen is Motion Transfer: een taak, geleerd op het dual-arm ALOHA 2-platform, werd direct overgezet naar een Franka bi-arm-opstelling en naar de Apollo-humanoid van Apptronik, zonder hertraining op beide.
De gewichten zijn gesloten, dus beschouw dit als de propriëtaire frontier-baseline in plaats van iets dat je zelf kunt downloaden en fine-tunen.
SmolVLA
SmolVLA van Hugging Face heeft 450 miljoen parameters (onder een Apache 2.0-licentie). Het koppelt een aangepaste SmolVLM2-backbone aan een flow-matching-actie-expert, met layer skipping en een gereduceerd aantal visuele tokens om inferentie goedkoop genoeg te houden voor kleine hardware.
Het draait op een enkele consumenten-GPU, waaronder een RTX 3060, op de CPU van een MacBook (wel traag), en het wordt uitgerold op een Jetson Orin voor onboard-inferentie.
Fine-tuning gedurende 20.000 stappen duurt ongeveer 4 tot 5 uur op één A100-GPU.
Ondanks training op minder dan 30.000 episodes, evenaart of verslaat het aanzienlijk grotere modellen op LIBERO, Meta-World en echte SO-100- en SO-101-armen.
Het mooiste is dat het geheel is voorgetraind op door de community bijgedragen datasets via het LeRobot-framework.
Hoe kies je een VLA voor je project
Nu ik een aantal VLA-modellen heb gepresenteerd, laten we het hebben over welke je voor jouw project kiest.
Kiezen tussen deze vijf draait vooral om het matchen van controlfrequentie en hardware aan je eigen setup, niet om achter het model aan te lopen dat vorige maand bovenaan een leaderboard stond.
Zo zou ik er ongeveer over nadenken:
Vijf beperkingen, vijf modellen. Als je maar één diagram uit dit artikel onthoudt, laat het dan deze zijn. Afbeelding door de auteur.
Heb je een consumenten-GPU of een SO-101-arm op je bureau staan, begin dan met SmolVLA. Niets anders in het open ecosysteem levert je zo goedkoop een werkend beleid op.
En de laatste hoofdboodschap die ik wil meegeven is dat honderd schone demonstraties op SmolVLA bijna altijd winnen van vijftig rommelige op OpenVLA.
Daarmee bedoel ik: besteed 60 tot 70 procent van je projecttijd aan dataverzameling en kwaliteitscontrole, en de rest aan training.
Toepassingen van VLA-modellen
VLA’s zijn uit demovideo’s gestapt en in een handvol echte deployments beland, zij het ongelijkmatig.
Het patroon dat ik zie: ze landen het eerst waar de omgeving te veel variatie heeft om te scripten, maar waar een mens nog kan ingrijpen als er iets misgaat. Enkele voorbeelden:
Robotische manipulatie
Dit is het primaire domein, met taken als pick-and-place, kitting, inpakken, sorteren, assemblage, enz.
Dit zijn taken waarbij de robot objecten moet identificeren, vastgrijpen en verplaatsen waarvan positie en oriëntatie tussen pogingen wisselen, precies de situatie waar gescripte systemen slecht mee omgaan.
Magazijn- en fulfilmentwerk is nu de duidelijkste commerciële case. Een gescripte picker heeft het item elke keer op dezelfde manier gepresenteerd nodig, terwijl een VLA-gebaseerde picker een bak met veertig verschillende SKU’s door elkaar aankan.
Humanoïde robots
Bedrijven als Figure, 1X en Apptronik bouwen op VLA-fundamenten, en de reden is simpel: een bipede robot met twee werkende handen heeft te veel mogelijke taken om stuk voor stuk te scripten.
Het Motion Transfer-resultaat van Gemini Robotics, waarbij een vaardigheid getraind op ALOHA 2 direct werd overgezet naar de Apollo-humanoid van Apptronik, is precies de eigenschap die een humanoïdenprogramma nodig heeft om op te schalen.
Dezelfde vaardigheid, één keer getraind op ALOHA 2, draait op de Apollo-humanoid van Apptronik zonder hertraining. Bron: Google DeepMind, “Gemini Robotics 1.5 brings AI agents into the physical world”.
Autonome voertuigen
Rijstacks beginnen VLA-achtige architecturen te adopteren om te verbinden wat de auto ziet met wat hij daarna moet doen, binnen één redeneerloop in plaats van een overdracht van perceptie naar planner.
De aantrekkingskracht is dezelfde als bij manipulatie: zeldzame situaties die geen enkele regel ooit voorzag, afgehandeld door een model dat genoeg van de wereld heeft gezien om erover te redeneren in plaats van vast te lopen.
Chirurgische en medische robotica
Dit is de toepassing in de vroegste fase op deze lijst.
Het idee is dat een systeem dat een mondelinge instructie van een chirurg kan volgen en zich kan aanpassen aan variabele weefselcondities beter is dan een rigide geprogrammeerd systeem, maar regulatorische goedkeuring is hier de belangrijkste beperking, niet de modelcapaciteit.
Ik verwacht hier eerst assistieve en trainingsapplicaties, lang voordat er iets komt dat in de buurt van autonoom is.
Vision Language Action-modellen: uitdagingen en beperkingen
Hoewel VLA’s geweldig zijn, hebben ze nog zwaktes, vooral op vier specifieke punten:
Herstel midden in een taak
VLA’s gaan redelijk om met variatie aan het begin van een taak, maar als een greep halverwege wegglijdt of een object onder de grijper verschuift, is herstel inconsistent.
De meeste demonstratiedata leggen geslaagde pogingen vast, dus het model heeft weinig voorbeelden gezien van hoe herstel uit een fout er daadwerkelijk uitziet.
Inferentie op het apparaat
Fijnmanipulatie vereist een control loop van 10 tot 100 Hz, en een model met 7 miljard of meer parameters dat tempo laten halen op de eigen hardware van de robot is nog een streven, geen opgelost engineeringprobleem.
Daarom zijn de meeste ingezette systemen ofwel gekoppeld aan een edge-server, ofwel splitsen ze redeneren en controle, zoals Gemini Robotics 1.5 doet.
Kwantisatie, layer skipping en distillatie helpen allemaal, maar het zijn workaround’s waar nog aan wordt gesleuteld, geen definitieve antwoorden.
De databottleneck
Nu er capabele open gewichten bestaan die iedereen kan downloaden, is data de echte onderscheidende factor geworden.
Het verzamelen van diverse, goed geannoteerde teleoperatiedata is traag en duur op een manier die webscraping nooit was, en de kloof tussen de gepubliceerde resultaten van pi0 en wat iemand met alleen publieke data heeft gereproduceerd is het duidelijkste bewijs van wat een privé data-voordeel je oplevert.
Grenzen aan generalisatie
Huidige VLA’s generaliseren goed binnen hun trainingsdistributie en gaan merkbaar achteruit daarbuiten.
Een model dat over 22 belichamingen op tafelmanipulatie is getraind, kan nog steeds slecht presteren op een taakvorm die het echt nooit heeft gezien.
Slotgedachten
Zoals je ziet, brengen VLA-modellen waarneming, taalbegrip en actiegeneratie samen in één architectuur, en dat is een structurele verschuiving, geen incrementele.
Wat ze wél kunnen en klassieke besturing nooit lukte, is generaliseren naar omstandigheden waarop niemand ze expliciet heeft getraind, omdat de taal- en visie-backbones al een werkend model van de fysieke wereld meebrengen in de robot voordat die ooit een demonstratie ziet.
Wat me in 2026 misschien nog het meest verbaast, is hoezeer de moeilijke vraag is verschoven.
Drie jaar geleden ging het moeilijke vraagstuk over architectuur.
Nu OpenVLA, Octo, pi0 en SmolVLA allemaal op GitHub staan om te downloaden, gaan de moeilijke vragen over datakwaliteit, herstelgedrag en of je dit überhaupt op 50 Hz op de robot zelf kunt draaien in plaats van in een datacenter.
Wil je verder, dan behandelt DataCamp’s Introduction to AI Agents-cursus de bredere agentic-context, en Large Language Models (LLMs) Concepts de backbone-kant.