

Corso
Introduzione alla statistica
4 ore
163.9K
Pratica and corso your progress.
Continua Con GooglePadroneggiare gli strumenti di data analytics senza comprendere i concetti alla base è come avere una cassetta degli attrezzi piena di cacciaviti ma non sapere quando e come usare ciascun cacciavite. La statistica è importante da imparare perché l’ascesa di strumenti di analisi generati e assistiti dall’IA renderà le competenze tecniche meno un vantaggio competitivo a favore della comprensione e del pensiero critico.
Ti invito a non lasciarti intimidire dalla complessità della statistica. Questo articolo vuole offrire una guida completa ai concetti statistici più rilevanti per data analyst e data scientist attraverso 35 domande e risposte di colloquio sulla statistica. Che tu stia preparando un colloquio o meno, sono certo che troverai queste domande informative.
Infine, prima di iniziare, valuta di seguire il nostro corso Introduction to Statistics in R per imparare le basi, incluso come eseguire analisi statistiche e interpretare i risultati. Inoltre, se stai preparando attivamente un colloquio che richiede conoscenze statistiche, i due corsi DataCamp seguenti coprono tutti gli argomenti statistici più frequentemente trattati: Practicing Statistics Interview Questions in Python e Practicing Statistics Interview Questions in R.
La maggior parte dei lavori in data analytics richiede una comprensione di base della statistica, incluse statistica descrittiva, statistica inferenziale e probabilità. Se vuoi ripassare la statistica descrittiva prima di un colloquio, scarica la nostra Descriptive Statistics Cheat Sheet per una consultazione rapida. Inoltre, se vuoi cimentarti con alcuni calcoli e metodi, dai un’occhiata ai seguenti tutorial di DataCamp per approfondire i concetti rilevanti:
Varianza e deviazione standard misurano entrambe la dispersione o la variabilità di un dataset. La varianza è la media delle differenze quadrate dalla media. Fornisce un’idea di quanto i valori in un dataset si discostino dalla media. Tuttavia, poiché usa differenze al quadrato, anche le unità sono al quadrato, il che può risultare meno intuitivo rispetto alla deviazione standard. La deviazione standard è la radice quadrata della varianza, riportando le unità a quelle dei dati originali. Offre una misura della dispersione più interpretabile. Per esempio, se la varianza di un dataset è 25, la deviazione standard è √25 = 5.
L’asimmetria misura la non simmetria di un dataset attorno alla sua media e può essere positiva, negativa o nulla. Dati con asimmetria positiva, o asimmetrici a destra, hanno una coda destra più lunga, il che significa che la media è maggiore della mediana. Dati con asimmetria negativa, o asimmetrici a sinistra, hanno una coda sinistra più lunga, quindi la media è minore della mediana. Un’asimmetria zero indica una distribuzione simmetrica, come quella normale, in cui media, mediana e moda coincidono.
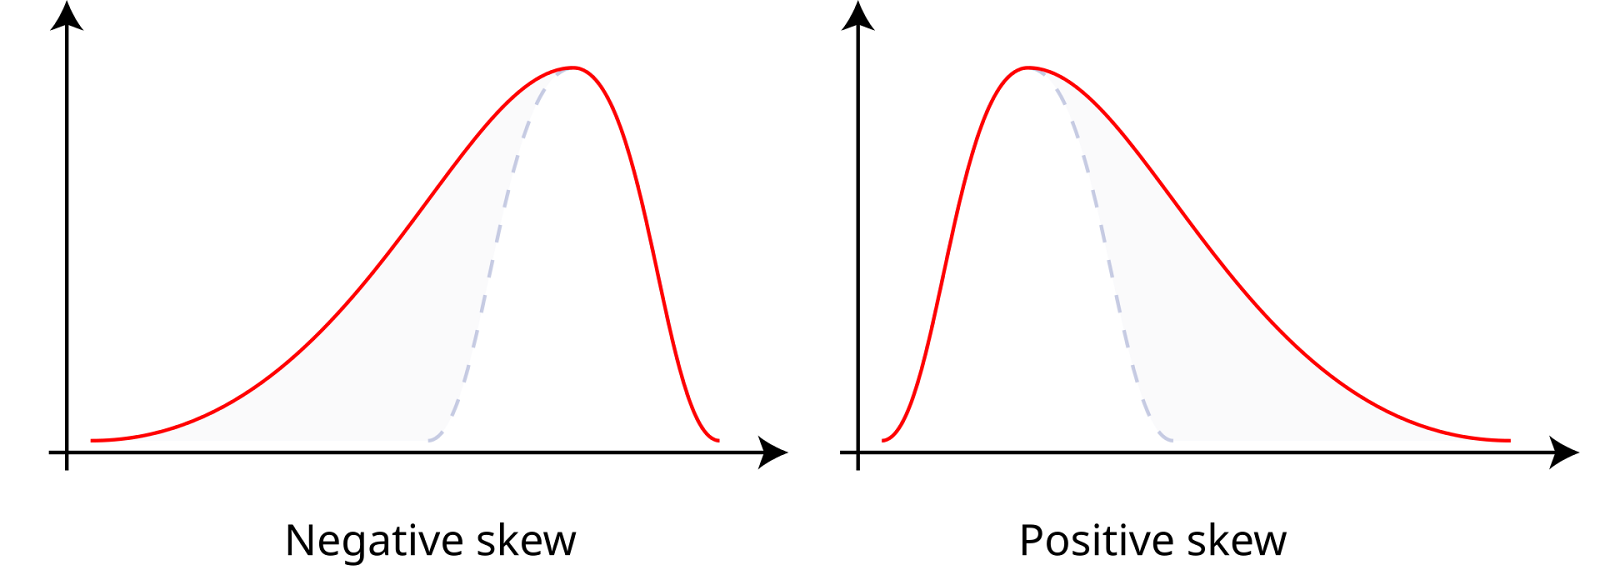
Asimmetria positiva e negativa. Fonte: Wikiversity.
Un istogramma è una rappresentazione grafica della distribuzione di un dataset. Divide i dati in intervalli (bin) e mostra la frequenza (o il conteggio) dei punti dati in ciascun intervallo. Gli istogrammi servono a comprendere la distribuzione di frequenza sottostante (la forma) di un insieme di dati continui. Aiutano a identificare schemi come l’asimmetria, la modalità (numero di picchi) e la presenza di outlier.
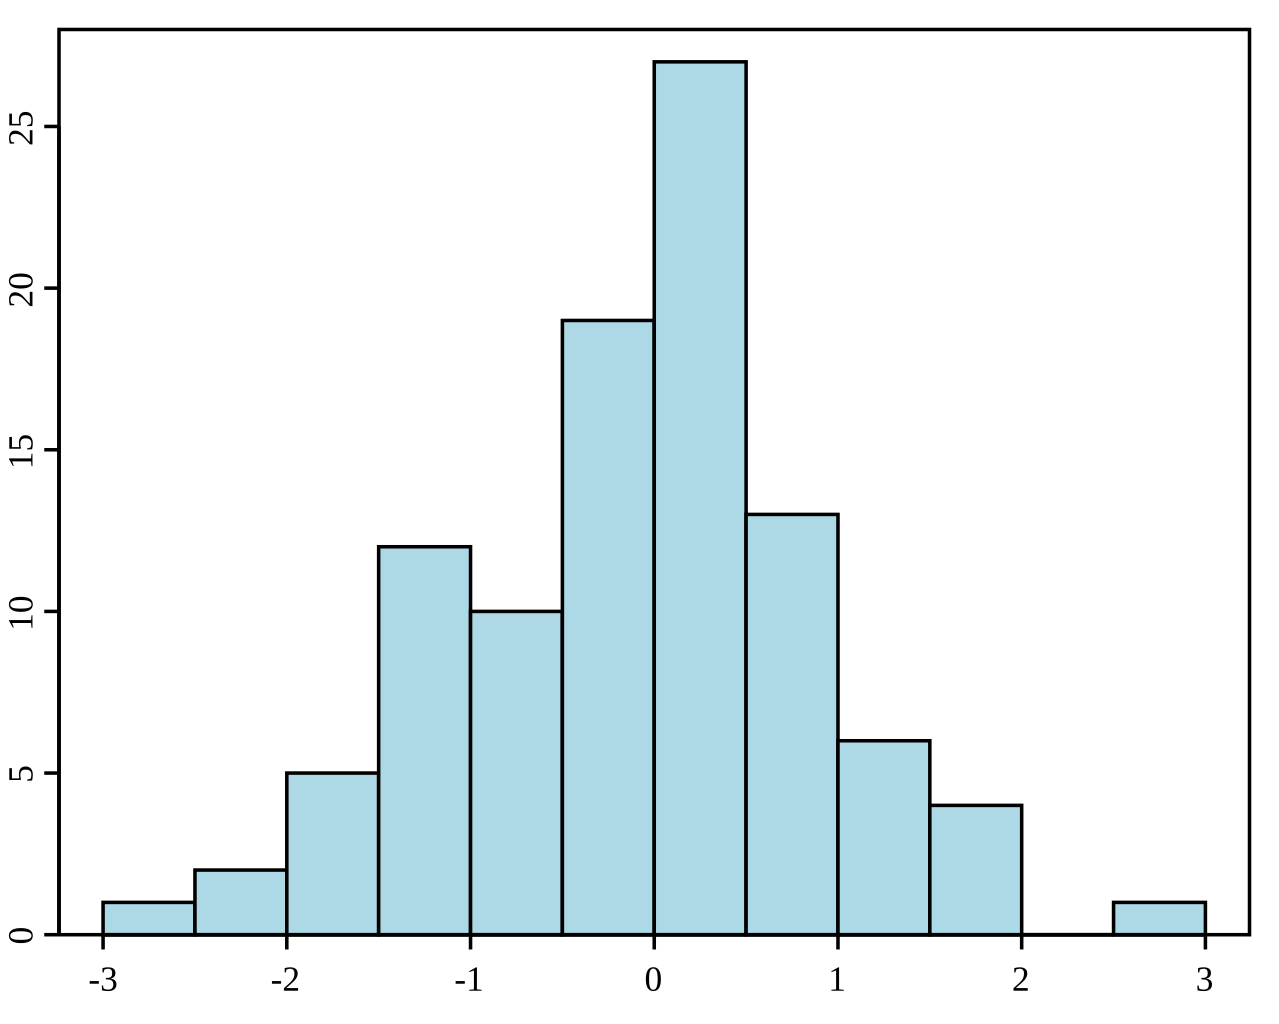
Esempio di istogramma. Fonte: Wikipedia.
La statistica inferenziale consiste nel formulare previsioni o inferenze su una popolazione a partire da un campione casuale di dati prelevato da quella popolazione. Utilizza vari metodi per stimare parametri della popolazione, testare ipotesi e fare previsioni. Mentre la statistica descrittiva riassume e descrive le caratteristiche di un dataset, la statistica inferenziale usa i dati per generalizzare e trarre conclusioni su una popolazione più ampia.
Diversi metodi di campionamento vengono utilizzati per garantire che i campioni siano rappresentativi e casuali. Nel campionamento casuale semplice ogni membro della popolazione ha pari probabilità di essere selezionato. Il campionamento sistematico prevede la selezione di ogni k-esimo membro della popolazione a partire da un punto scelto casualmente. Il campionamento stratificato divide la popolazione in strati o sottogruppi, estraendo campioni casuali da ciascuno strato. Il campionamento a grappoli divide la popolazione in cluster, selezionandone alcuni in modo casuale e campionando tutti i membri all’interno di essi.
Il teorema del limite centrale afferma che la distribuzione campionaria della media del campione si avvicina a una distribuzione normale all’aumentare della dimensione del campione, indipendentemente dalla distribuzione della popolazione, a patto che i campioni siano indipendenti e identicamente distribuiti.
La probabilità marginale si riferisce alla probabilità che si verifichi un singolo evento, indipendentemente dagli altri, indicata come P(A) per l’evento A. La probabilità congiunta è la probabilità che due eventi si verifichino insieme, rappresentata come P(A∩B) per gli eventi A e B. La probabilità condizionata è la probabilità che un evento si verifichi dato che un altro evento è già avvenuto, espressa come P(A|B) per gli eventi A e B.
Una distribuzione di probabilità descrive come sono distribuiti i valori di una variabile aleatoria. Fornisce una funzione che associa gli esiti della variabile aleatoria alle relative probabilità. Esistono due tipi principali di distribuzioni di probabilità. Una è la distribuzione discreta per variabili aleatorie discrete, come la distribuzione binomiale o di Poisson. L’altra è la distribuzione continua per variabili aleatorie continue, come la distribuzione normale o esponenziale.
La distribuzione normale, o di Gauss, è una distribuzione di probabilità continua caratterizzata dalla sua curva a campana, simmetrica rispetto alla media. Nelle distribuzioni normali, la media è quindi uguale alla mediana. Inoltre, si sa che circa il 68% dei dati ricade entro una deviazione standard dalla media, il 95% entro due deviazioni standard e il 99,7% entro tre deviazioni standard. Questo è noto come regola 68-95-99,7.
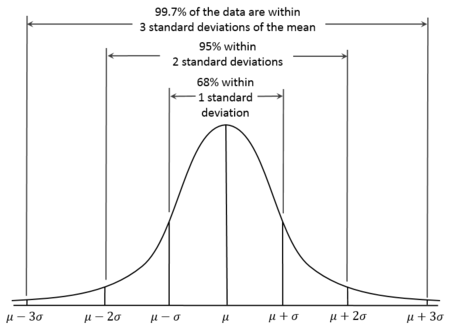
Curva di distribuzione normale. Fonte: Wikiversity.
La distribuzione binomiale è una distribuzione di probabilità discreta che modella il numero di successi in un numero fisso di prove di Bernoulli indipendenti, ciascuna con la stessa probabilità di successo. Si usa quando ci sono esattamente due possibili esiti (successo e fallimento) per ogni prova. Ad esempio, può essere usata per modellare il numero di teste in una serie di lanci di moneta.
La distribuzione di Poisson è una distribuzione di probabilità discreta che modella il numero di eventi che si verificano in un intervallo fisso di tempo o spazio, dove gli eventi avvengono in modo indipendente e a un tasso medio costante. È appropriata quando vuoi modellare il conteggio di eventi rari, come il numero di email ricevute in un’ora o il numero di terremoti in un anno.
Per ruoli di statistica intermedia, concentrati su test d’ipotesi, stima per intervalli e modelli di regressione. Se, leggendo queste domande, ti senti poco sicuro su alcuni concetti, puoi affidarti alle risorse DataCamp. Puoi imparare i test d’ipotesi con i corsi Hypothesis Testing in Python e Hypothesis Testing in R. Puoi anche padroneggiare le tecniche di regressione con i seguenti corsi e tutorial:
Un p-value è la probabilità di ottenere una statistica test almeno tanto estrema quanto quella osservata, assumendo vera l’ipotesi nulla. Si usa nei test d’ipotesi per determinare la significatività del risultato. Se il p-value è minore o uguale al livello di significatività scelto (α), rifiutiamo l’ipotesi nulla. Se il p-value è maggiore di α, non rifiutiamo l’ipotesi nulla.
Gli errori di Tipo I nei test d’ipotesi si verificano quando l’ipotesi nulla è vera ma la rifiutiamo erroneamente, producendo un falso positivo. La probabilità di commettere un errore di Tipo I coincide con il livello di significatività. Gli errori di Tipo II si verificano quando l’ipotesi nulla è falsa ma non la rifiutiamo, portando a un falso negativo.
I test parametrici assumono che i dati seguano una specifica distribuzione, come la normale, e richiedono determinati parametri di popolazione, risultando ideali quando tali assunzioni sono soddisfatte. Alcuni esempi di test parametrici che uso comunemente sono t-test, Z-test e ANOVA. I test non parametrici non assumono una distribuzione specifica e si usano quando i dati non rispettano le assunzioni parametriche, soprattutto con campioni piccoli. Molte persone conoscono questi test, ma non sempre li identificano come non parametrici. Ho usato il test Chi-quadro, il test di Mann-Whitney U, il test dei ranghi con segno di Wilcoxon e il test di Kruskal-Wallis, per citarne alcuni.
La regressione è un metodo statistico usato per esaminare la relazione tra una variabile dipendente e una o più variabili indipendenti. Aiuta a capire come cambia la variabile dipendente quando una delle variabili indipendenti varia, mantenendo costanti le altre variabili indipendenti.
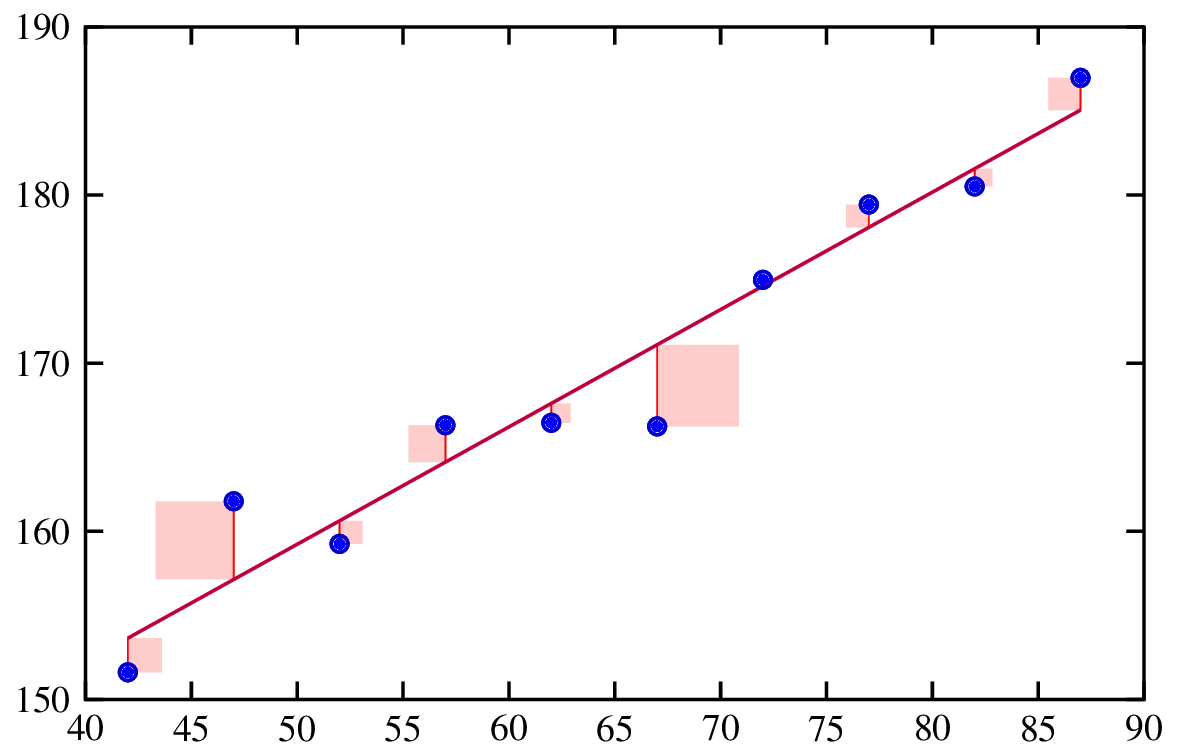
Stima di una retta di regressione. Fonte: Risk Engineering.
I residui sono le differenze tra i valori osservati e quelli predetti da un modello di regressione. Sono importanti perché analizzarli aiuta a verificare le assunzioni del modello, oltre che a valutare l’aderenza complessiva del modello.
In un modello di regressione lineare, ogni coefficiente rappresenta la variazione attesa nella variabile dipendente per un aumento di un’unità nella corrispondente variabile indipendente, mantenendo costanti le altre variabili. Per esempio, se il coefficiente di una variabile indipendente 𝑥𝑖 è 2, significa che per ogni aumento di un’unità in 𝑥𝑖 la variabile dipendente y è attesa aumentare di 2 unità, assumendo invariate le altre variabili.
Un intervallo di confidenza al 95% significa che, se prelevassimo molti campioni e calcolassimo un intervallo di confidenza per ciascuno, circa il 95% di questi intervalli conterrebbe il vero parametro di popolazione. Possiamo anche dire di essere fiduciosi al 95% che il valore del parametro ricada nell’intervallo stimato.
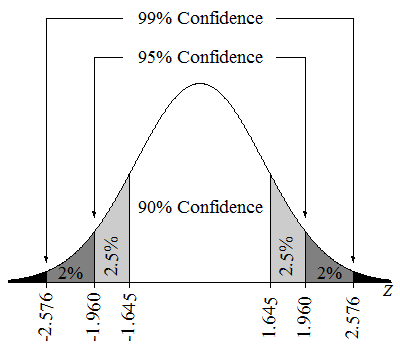
Intervalli di confidenza su una Z-distribution. Fonte: Lumen Learning.
La multicollinearità si verifica quando due o più variabili indipendenti in un modello di regressione multipla sono altamente correlate. È un problema perché può rendere instabili e difficili da interpretare le stime dei coefficienti. Un’elevata multicollinearità può anche aumentare gli errori standard dei coefficienti, portando a test statistici meno affidabili.
Le tecniche di regolarizzazione sono uno strumento potente per trattare la multicollinearità nei modelli di regressione. Si usano anche per prevenire l’overfitting aggiungendo al modello una penalizzazione per coefficienti di grande entità. Questo aiuta a creare un modello più generalizzabile. Tecniche comuni di regolarizzazione includono la Lasso e la Ridge Regression.
Se dovessi prepararmi per un colloquio che richiede una comprensione avanzata della statistica, mi assicurerei di studiare la statistica bayesiana e il machine learning.
Per la statistica bayesiana, esplora i nostri corsi: Bayesian Data Analysis in Python e Fundamentals of Bayesian Data Analysis in R. Per il machine learning, scopri i percorsi di carriera o i corsi su machine learning di DataCamp, tra cui il career track Machine Learning Scientist with Python e il corso Understanding Machine Learning.
La statistica bayesiana utilizza il teorema di Bayes per aggiornare la probabilità di un’ipotesi man mano che diventano disponibili nuove evidenze o informazioni. Combina convinzioni a priori con nuovi dati per formare una probabilità a posteriori.
Il Markov Chain Monte Carlo è una classe di algoritmi usati per campionare da una distribuzione di probabilità quando il campionamento diretto è difficile. È importante nella statistica bayesiana perché consente di stimare le distribuzioni a posteriori, soprattutto in modelli complessi in cui soluzioni analitiche non sono fattibili.
Il compromesso bias-varianza nel machine learning implica bilanciare due fonti di errore. Il bias è l’errore dovuto ad assunzioni di modello eccessivamente semplici, che causano underfitting e la mancata cattura dei pattern nei dati. La varianza è l’errore dovuto a un’eccessiva sensibilità alle fluttuazioni dei dati di training, che causa overfitting e la cattura del rumore invece dei veri pattern.
L’inferenza causale è un’idea importante che sta ricevendo molta attenzione. È il processo di determinare se e come una variabile (la causa) influisce direttamente su un’altra variabile (l’effetto), caratteristica che distingue l’inferenza causale dalla semplice correlazione. In realtà, l’inferenza causale è un insieme di metodi che mirano a stabilire una relazione causa-effetto per capire se qualcosa funziona, come un intervento o un trattamento. Se, per esempio, un ricercatore ha bisogno di capire se un farmaco funziona, l’inferenza causale può aiutare a rispondere alla domanda.
La Structural Equation Modeling è una tecnica per analizzare le relazioni tra quelle che vengono chiamate variabili osservate e latenti. È un po’ come un mix tra regressione multipla e analisi fattoriale. La SEM richiede più fasi, come la specificazione del modello, la stima e poi la valutazione. È nota per essere flessibile, ma richiede campioni di grandi dimensioni e, per usarla, serve una solida base teorica.
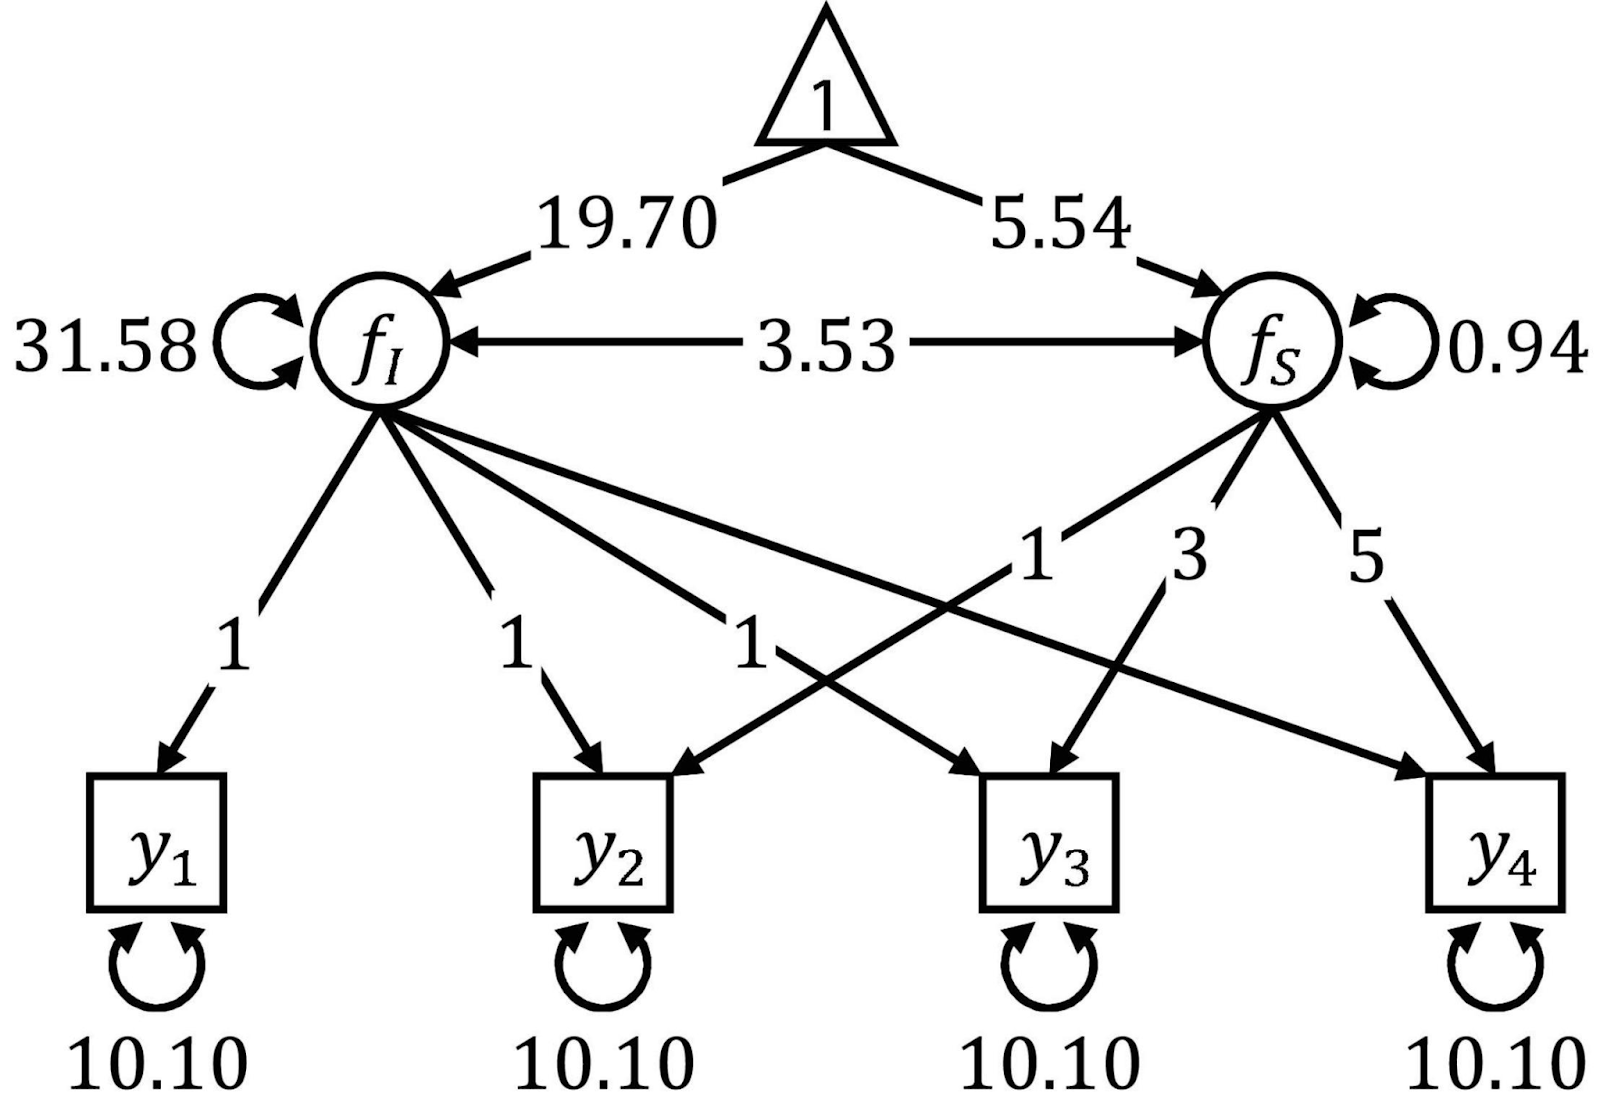
I path diagram vengono spesso usati per visualizzare la SEM. Fonte: Frontiers.
Troverai utili le seguenti domande se punti a un ruolo più focalizzato sull’intersezione tra data science e statistica. Gli argomenti includono preprocessing e pulizia dei dati, A/B testing e progettazione sperimentale, previsione di serie temporali e tecniche statistiche avanzate.
Se ti senti incerto su questi concetti e vuoi davvero migliorare le tue performance ai colloqui, utilizza queste risorse DataCamp sull’A/B testing: corso A/B Testing in Python o corso A/B Testing in R. Poi, per padroneggiare l’analisi delle serie temporali, scegli tra gli skill track Time Series with R o Time Series with Python per fare esperienza.
Separare i dati in set di training e di test ci aiuta a valutare le prestazioni del modello su dati non visti. Il set di training si usa per addestrare il modello, mentre il set di test serve a valutare quanto bene il modello generalizza a nuovi dati. Questa pratica aiuta a rilevare l’overfitting e garantisce che il modello possa performare bene su dati reali.
L’overfitting si verifica quando un modello impara sia i pattern sottostanti sia il rumore nei dati di training, portando a prestazioni eccellenti sul training ma scarse su dati nuovi e non visti. L’underfitting accade quando un modello è troppo semplice per catturare i pattern nei dati, risultando in prestazioni scarse sia sui dati di training sia su quelli nuovi.
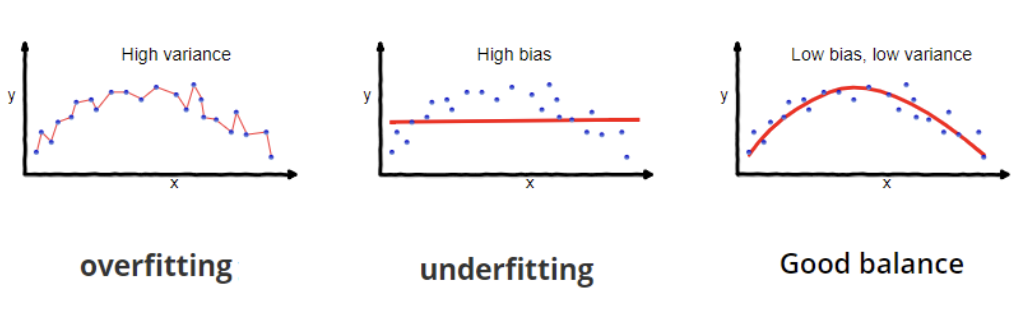
Overfitting e underfitting. Fonte: Wikipedia.
Capire il meccanismo di mancanza (MCAR, MAR, MNAR) è cruciale perché guida la scelta dei metodi appropriati per gestire i dati mancanti. Usare tecniche improprie può introdurre bias, ridurre la validità dei risultati e portare a conclusioni errate. Ad esempio, metodi semplici di imputazione possono andare bene per dati MCAR, mentre tecniche più sofisticate come l’imputazione multipla o metodi basati su modelli possono essere necessarie per dati MAR o MNAR per ottenere stime non distorte.
Rimuovere i valori mancanti può essere appropriato quando la proporzione di dati mancanti è molto piccola, tipicamente inferiore al 5%. Inoltre, è una buona idea quando i dati mancanti sono MCAR (Missing Completely at Random), cioè quando la mancanza non introduce bias. Infine, considererei di rimuovere i valori mancanti se il dataset è abbastanza grande da non risentire in modo significativo dell’eliminazione di un piccolo numero di righe.
Ogni metodo di imputazione ha pro e contro. Ad esempio, l’imputazione con media/mediana/moda è facile da implementare ma può introdurre bias e distorcere le relazioni tra variabili. L’imputazione con K-nearest neighbors (KNN) considera le relazioni tra variabili e può portare a risultati più accurati, ma può essere computazionalmente costosa.
L’A/B testing è un metodo usato nel disegno sperimentale per confrontare due versioni di una variabile, come una pagina web, una funzione di un’app o una campagna di marketing, per determinare quale performa meglio. È un argomento molto rilevante e compare nella sezione “richiesto” di molte job description.
La stagionalità è uno dei componenti delle serie temporali, oltre a trend e residui (rumore). Per rilevarla, possiamo prima ispezionare visivamente la serie tramite un line plot. Se si sospetta la presenza di stagionalità, possiamo procedere con una decomposizione della serie per stimare l’entità dell’effetto stagionale.
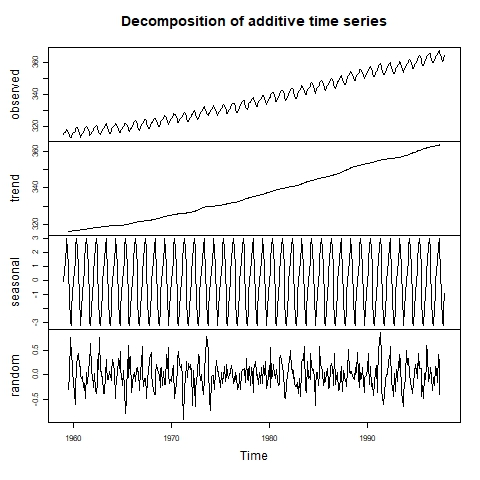
Serie temporale decomposta visivamente. Fonte: Lab of Environmental Informatics.
I modelli di smoothing esponenziale usano medie ponderate di osservazioni passate per previsioni semplici e di breve periodo. I modelli ARIMA combinano componenti autoregressive, differenziazione e medie mobili, risultando più complessi ma adatti sia a previsioni di breve che di lungo periodo, specialmente con pattern complessi e significativa autocorrelazione.
La cross-validation è una tecnica per valutare come un modello di machine learning generalizzerà su un dataset indipendente. Consiste nel dividere i dati in più fold ed effettuare diversi round di training e validazione.
Poiché perfezionare la statistica e i risultati dell’analisi non è completo senza comunicare l’esito agli stakeholder di business, le soft skill sono fondamentali per i datori di lavoro che assumono per ruoli data, soprattutto perché comunicare insight statistici non è mai semplice.
Per comunicare efficacemente con diversi stakeholder, adatto il mio stile in base ai loro background e interessi. Per esempio, con i dirigenti, do priorità all’impatto sul business, usando linguaggio aziendale e visual per facilitare decisioni rapide. Con gli sviluppatori, invece, fornisco dettagli tecnici. In entrambi i casi, mi assicuro che i concetti coinvolti siano chiaramente rilevanti e accessibili, e incoraggio domande e feedback. Questo approccio fa sì che ogni gruppo di stakeholder riceva le informazioni di cui ha bisogno in un formato che risuona con loro.
Imparare la statistica per ruoli di data analytics può essere impegnativo. Molte persone arrivano nel campo da percorsi diversi che non prevedono necessariamente molte o alcuna conoscenza statistica. La maggior parte delle risorse disponibili online incoraggia a concentrarsi solo sugli strumenti, trascurando l’importanza vitale della statistica.
Per approfondire ulteriormente la tua conoscenza e le opportunità di carriera, valuta di esplorare risorse e corsi aggiuntivi. Per una guida dettagliata su come diventare statistico, leggi il nostro post sul blog, How to Become a Statistician, che offre spunti preziosi. Puoi completarlo con il nostro career track Statistician with R. Prenditi del tempo per mettere alla prova la tua intuizione con il corso Probability Puzzles in R. Se preferisci Python, il nostro skill track Statistics Fundamentals with Python è un’ottima opzione.
In bocca al lupo per i tuoi prossimi colloqui!
Impara la statistica con DataCamp
Corso
Corso
Pratica and corso your progress.
Continua Con Googleblog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min



