

Accéder au contenu principal
Science des données
Analyse des données

Loi de Poisson : guide complet

La loi de Poisson modélise la probabilité d’un certain nombre d’événements dans un intervalle fixe. Découvrez ses applications concrètes en files d’attente et modélisation du trafic.
Vinod Chugani's photo
Vinod Chugani
Actualisé · 9 min lire

Explorez l'IA

ChatGPTClaudePerplexity

Créez votre compte gratuit

S'entraîner et cursus vos progrès.

Continuer Avec Google
En continuant, vous acceptez nos Conditions d'utilisation, notre Politique de confidentialité et le fait que vos données seront hébergées aux États-Unis.

En statistique et en data science, la loi de Poisson est un outil clé pour modéliser des événements discrets survenant dans un intervalle fixe. Baptisée d’après le mathématicien français Siméon Denis Poisson, cette loi de probabilité permet d’analyser et de prévoir des événements rares, ce qui en fait un atout pour les professionnels des données dans de nombreux domaines.

Si vous débutez en statistiques, notre cours Introduction to Statistics vous apportera des bases solides pour assimiler ces notions. Si vous souhaitez approfondir la théorie des probabilités, le cours Foundations of Probability in Python propose une exploration complète des concepts probabilistes, y compris la loi de Poisson. 

Qu’est-ce que la loi de Poisson ?

La loi de Poisson est une loi de probabilité discrète qui exprime la probabilité d’observer un nombre donné d’événements dans un intervalle de temps ou d’espace fixe. Elle suppose que ces événements se produisent à un taux moyen connu et indépendamment du temps écoulé depuis le dernier événement. Pour bien comprendre la loi de Poisson, il est utile de distinguer d’abord les lois discrètes des lois continues.
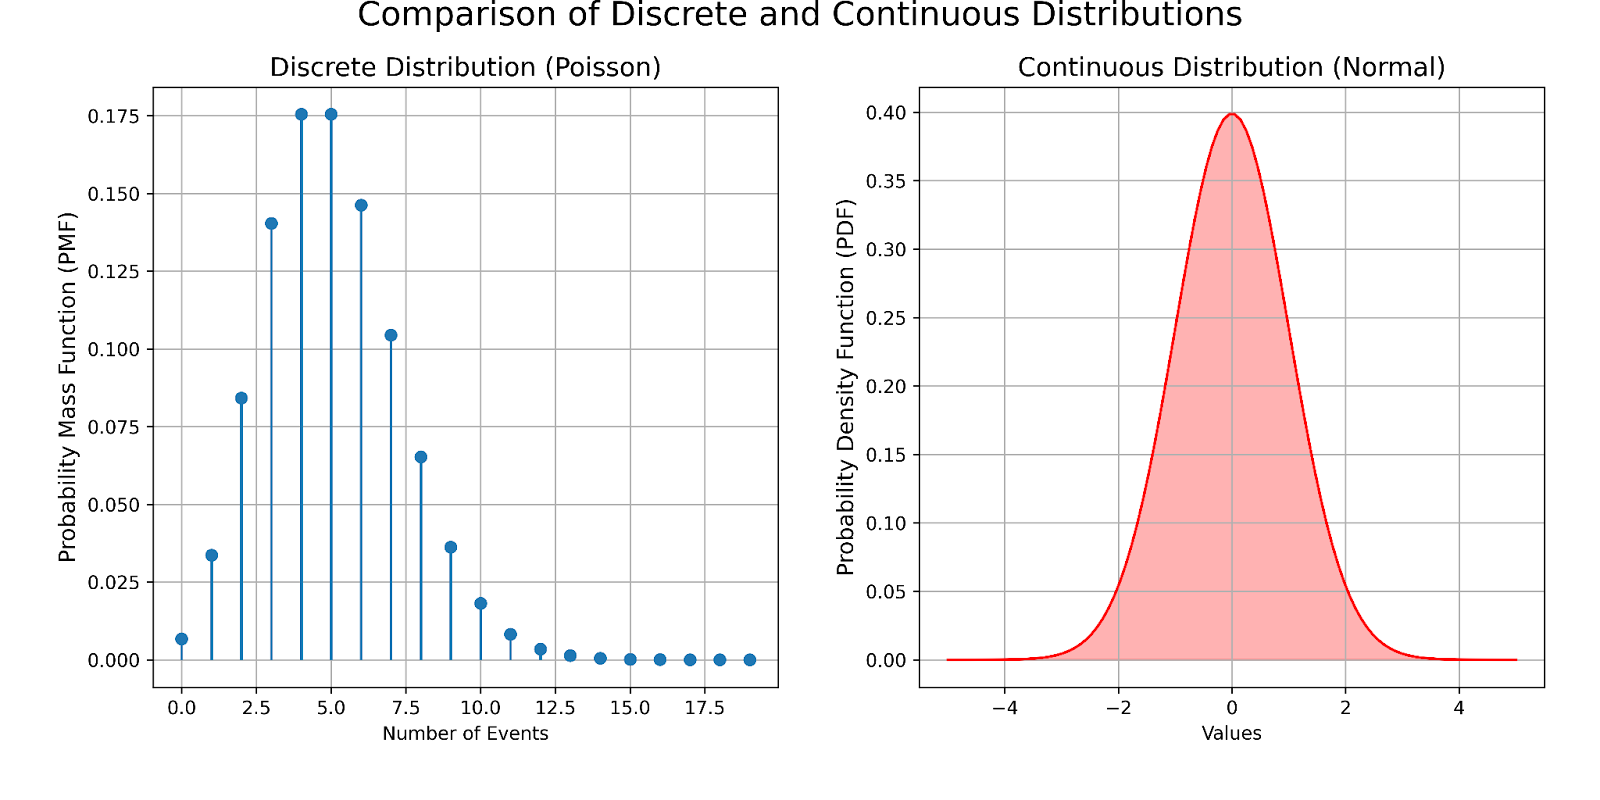
Loi de Poisson vs. loi continue

Loi de Poisson vs. loi continue. Image de l’auteur

Lois discrètes

  • Nature : les lois discrètes décrivent des phénomènes dont les issues se comptent en nombres entiers. Elles sont caractérisées par des fonctions de masse (PMF) qui attribuent une probabilité à chaque issue discrète possible.
  • Visualisation : dans le panneau de gauche, la loi de Poisson est représentée et chaque point indique la probabilité d’un nombre précis d’événements dans un intervalle donné. Cette loi est idéale pour modéliser des données de comptage, par exemple le nombre d’e-mails reçus par heure. Vous remarquerez aussi l’absence de valeurs négatives : par définition, une loi de Poisson ne peut pas prendre de valeurs négatives.

Parmi les lois de probabilité discrètes, on peut citer les lois de Bernoulli et binomiale. 

Lois continues

  • Nature : les lois continues s’appliquent à des données pouvant prendre n’importe quelle valeur dans un intervalle, y compris des décimales. Elles utilisent des fonctions de densité (PDF) pour décrire les probabilités d’appartenir à une plage donnée.
  • Visualisation : le panneau de droite illustre la loi normale. La courbe lisse indique la densité des valeurs autour de la moyenne ; l’aire sous la courbe entre deux points donne la probabilité d’appartenir à cette plage. Ce type de loi est utile pour mesurer des grandeurs comme la température ou le poids.

La loi normale, ou gaussienne, est l’exemple emblématique d’une loi continue.

Propriétés de la loi de Poisson

Passons en revue quelques caractéristiques essentielles de la loi de Poisson.

Événements dans un intervalle fixe

Une caractéristique clé de la loi de Poisson est sa capacité à modéliser des événements dans un intervalle fixe. Cet intervalle peut être temporel (p. ex. nombre de clients arrivant par heure) ou spatial (p. ex. nombre de défauts par mètre carré de tissu). Le modèle suppose :

  1. des événements indépendants ;
  2. un taux moyen d’occurrence (λ) constant sur l’intervalle ;
  3. l’impossibilité que deux événements surviennent exactement au même instant.

Moyenne et variance

L’une des propriétés les plus distinctives de la loi de Poisson est l’égalité entre sa moyenne (valeur attendue) et sa variance. Toutes deux sont représentées par le paramètre λ (lambda), qui désigne le nombre moyen d’événements dans l’intervalle. Cette propriété, utile pour vérifier si un jeu de données suit une loi de Poisson, s’écrit mathématiquement ainsi : 
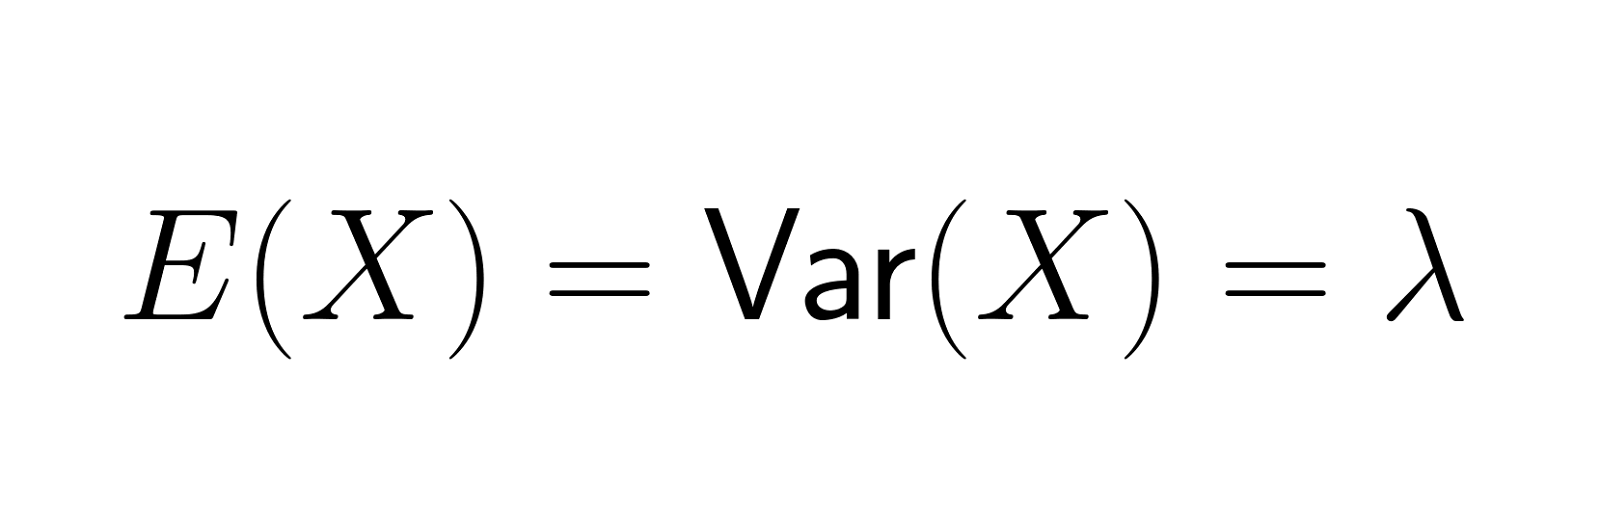
Moyenne et variance de la loi de Poisson

Cette égalité implique que, plus le nombre attendu d’événements augmente, plus la variabilité observée augmente également.

Asymétrie et forme

La forme de la loi de Poisson dépend de la valeur de λ. L’illustration suivante montre comment λ influe sur l’asymétrie et la symétrie de la distribution : 
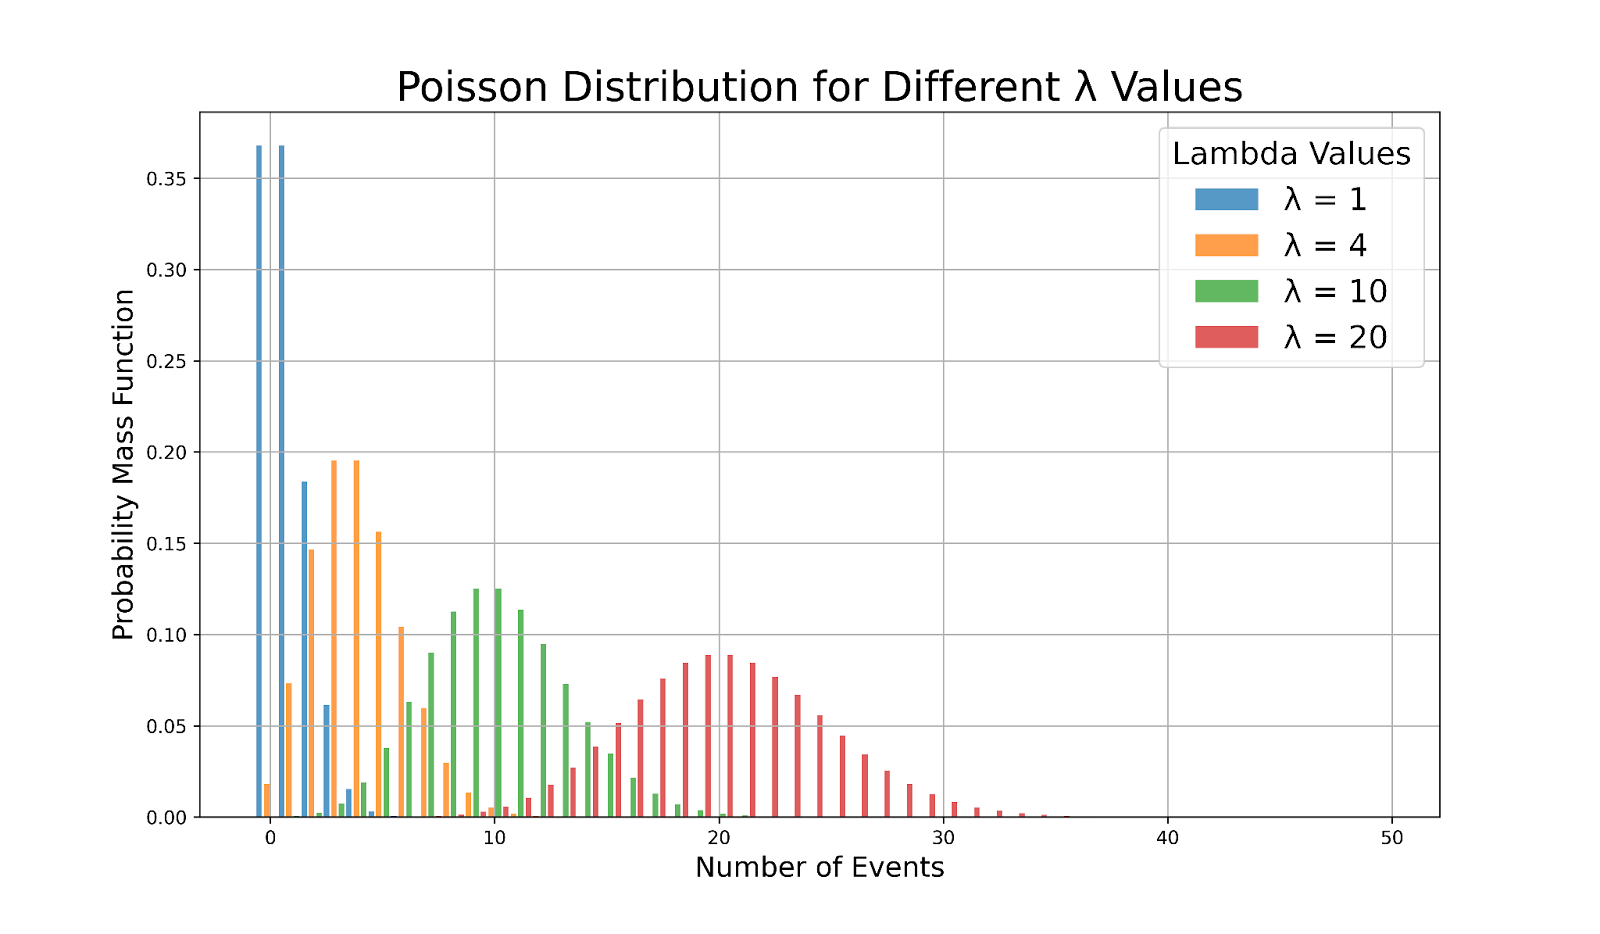
Lois de Poisson pour différentes valeurs de lambda

Lois de Poisson pour différentes valeurs de lambda. Image de l’auteur

  • Pour des petites valeurs de λ (λ < 10), la distribution est nettement asymétrique à droite : on observe plus fréquemment de faibles comptages et plus rarement de grands nombres d’événements.
  • Lorsque λ augmente (λ > 10), la distribution devient plus symétrique et tend à ressembler à une loi normale. Cette symétrie indique une répartition plus équilibrée des valeurs autour de la moyenne.

Cette évolution de la forme influe sur l’interprétation des probabilités et sur les inférences à partir de données suivant une loi de Poisson. Par exemple, une distribution plus symétrique facilite de nombreux types d’analyses, comme les tests d’hypothèse et l’estimation d’intervalles de confiance, car la répartition des données est plus prévisible et équilibrée.

Formule de la loi de Poisson

Voici la formule de la loi de Poisson. 
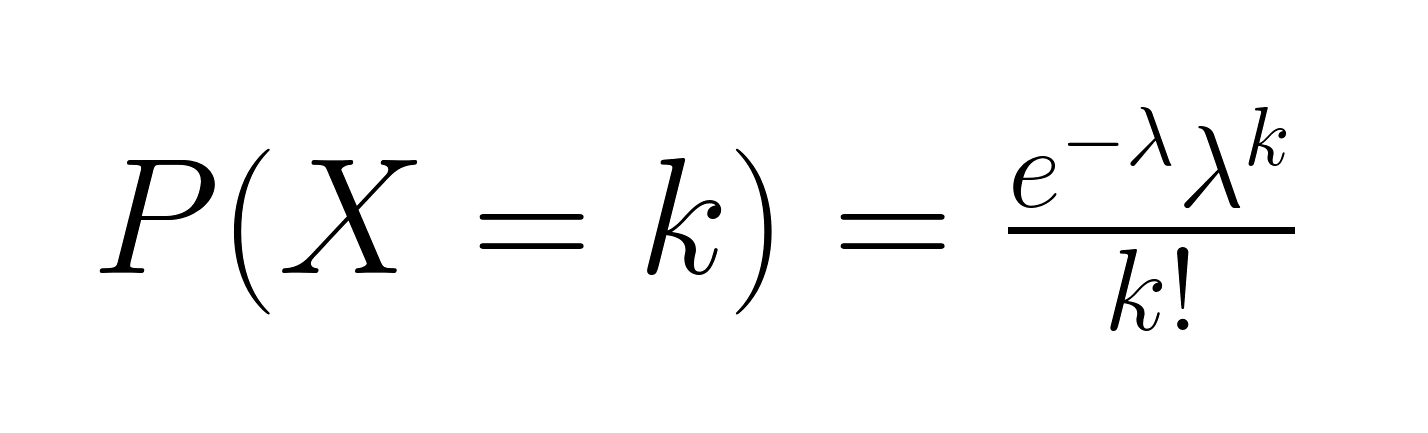
Formule de la loi de Poisson

  • Le membre de gauche (LHS) de la formule, P(X = k), représente la probabilité d’observer exactement k événements dans un intervalle donné. Ici, X est le nombre d’événements, et k est le nombre précis qui nous intéresse. En d’autres termes, le LHS indique quelle probabilité nous calculons.

  • Le numérateur du membre de droite (RHS), e-λλk, comporte deux parties. λk indique la vraisemblance d’observer k événements, compte tenu du taux moyen λ. Le terme e-λ reflète l’aléa des événements et garantit que la probabilité diminue à mesure que le nombre observé s’éloigne du taux attendu.

  • Le dénominateur du membre de droite (RHS), k!, tient compte du nombre de façons dont les x événements peuvent se produire. La factorielle comptabilise les arrangements possibles, de sorte que la probabilité ne dépende pas de l’ordre des événements.

Si vous voulez gagner en assurance avec Python pour le machine learning, commencez le parcours carrière Machine Learning Scientist with Python, qui vous permet de pratiquer des techniques avancées sur des jeux de données réels. 

Devenez un scientifique ML

Améliorez vos connaissances en Python pour devenir un scientifique spécialisé dans l'apprentissage automatique.
Commencez À Apprendre Gratuitement

Comment la loi de Poisson est utilisée

Voyons quelques usages concrets de la loi de Poisson. Si la planification capacitaire et l’optimisation des performances vous intéressent, notre cours Mixture Models in R couvre des applications avancées des lois de probabilité, y compris les mélanges de Poisson.

Théorie des files d’attente

En théorie des files d’attente, la loi de Poisson modélise les arrivées de clients aux points de service. Une banque, par exemple, peut l’utiliser pour prévoir le nombre de clients sur une heure, afin d’optimiser les effectifs et réduire les temps d’attente.

Épidémiologie et événements rares

Les épidémiologistes utilisent fréquemment la loi de Poisson pour modéliser l’occurrence de maladies rares. Cela permet d’estimer le nombre attendu de cas dans une population ou de détecter des flambées inhabituelles en comparant les cas observés à la distribution de Poisson attendue. Si l’épidémiologie vous intéresse, écoutez notre épisode de podcast Data Science, Epidemiology and Public Health avec Maëlle Salmon.

Trafic et modélisation des réseaux

Les ingénieurs du trafic et les analystes réseaux recourent à la loi de Poisson pour modéliser le nombre de véhicules passant un point de contrôle, l’arrivée de paquets de données sur un serveur ou les appels entrants d’un centre de contact.

Performances, idées reçues et alternatives

Lorsque vous travaillez avec la loi de Poisson, il est essentiel de tenir compte des aspects de performance, des idées reçues fréquentes et des modèles alternatifs pour garantir des résultats fiables. Plusieurs points méritent l’attention :

Défis de performance

Plusieurs facteurs influent sur l’efficacité de la modélisation par la loi de Poisson, en particulier dans les cas extrêmes :

  • Faibles taux d’événements : avec des taux très faibles (petit λ), la forte variabilité rend l’analyse difficile. Pour y faire face : allonger la période d’observation pour augmenter le comptage attendu, utiliser des approches bayésiennes pour intégrer des connaissances préalables, ou envisager des modèles « zéro-inflatés » en présence d’un excès de zéros.
  • Approximations par la loi normale : pour des valeurs de λ plus grandes (souvent au-delà de 30), la loi de Poisson peut être approchée par une loi normale, ce qui simplifie les calculs mais requiert de la prudence.

Lever les idées reçues

Une mauvaise compréhension de points clés peut mener à des modèles erronés :

  • Intervalles fixes : croire que l’intervalle d’un processus de Poisson peut varier est une erreur fréquente. En réalité, l’intervalle doit être fixe et bien défini. Le faire varier conduit à des modélisations et des prévisions inexactes.
  • Confusion avec la loi binomiale : bien que la loi de Poisson puisse être obtenue comme une limite de la loi binomiale sous certaines conditions, elles sont distinctes. La loi de Poisson sert à compter des événements rares dans un intervalle de temps ou d’espace fixé, tandis que la binomiale s’applique à un nombre fixe d’essais indépendants avec deux issues possibles.

Envisager des lois alternatives

Dans certains cas, d’autres distributions donnent de meilleurs résultats :

  • Loi binomiale négative : alternative pour des données de comptage sur-dispersées (variance supérieure à la moyenne). Plus flexible que la Poisson, elle modélise une variabilité accrue.
  • Loi exponentielle : alors que la loi de Poisson modélise le nombre d’événements dans un intervalle fixe, la loi exponentielle modélise le temps entre deux événements dans un processus de Poisson. Elle est continue (non discrète) et essentielle en analyse de survie et en fiabilité.

En résumé sur la loi de Poisson

Comprendre la loi de Poisson améliore considérablement l’analyse statistique et l’interprétation des données, notamment pour les événements rares ou les données de comptage. En maîtrisant ses propriétés, ses usages et ses limites, les praticiens des données affinent leurs décisions et bâtissent des modèles plus justes. 

Au fil de votre progression en data science, développez votre connaissance des concepts statistiques et de leurs applications. Pour celles et ceux qui travaillent avec R, le cours Introduction to Statistics in R et le parcours de compétences Statistics Fundamentals with R offrent une vue d’ensemble des principes clés, avec mise en pratique sur des lois comme Poisson. Si vous préférez Python, notre cours Introduction to Statistics in Python propose des exercices pratiques pour implémenter ces concepts, y compris des optimisations de performance. Continuer à renforcer vos compétences statistiques vous permettra d’aborder des problématiques complexes et d’en tirer des insights réellement exploitables.

Devenez un scientifique ML

Maîtriser Python pour devenir un scientifique de l'apprentissage automatique

Vinod Chugani's photo
Author
Vinod Chugani
LinkedIn

Vinod Chugani a débuté sa carrière à Tokyo comme plus jeune responsable du desk ventes hedge funds de JPMorgan, puis a signé un record de ventes individuel chez Lehman Brothers, avant de développer une activité de distribution d’électronique présente dans 30 pays, dépassant les 100 millions SG$ de chiffre d’affaires, puis de se tourner vers la data. Diplômé en économie de Duke et ancien élève de la NYC Data Science Academy, il a fait partie des trois lauréats de bourse sur plus de 100 candidatures pour le cours Building AI Applications de Hugo Bowne-Anderson sur Maven. Aujourd’hui, il écrit pour DataCamp, KDnuggets, Machine Learning Mastery et Statology, sur des sujets allant des statistiques à l’IA agentique, et accompagne des professionnels de la data à la NYC Data Science Academy, avec plus de 1 000 séances individuelles à son actif.


FAQ sur la loi de Poisson

Qu’est-ce que la loi de Poisson ?

La loi de Poisson est un modèle statistique qui prédit combien de fois un événement rare peut se produire sur une période ou une zone donnée. Elle est particulièrement utile pour des événements aléatoires mais à un taux moyen prévisible. Cette loi aide à mettre en lumière des schémas derrière des phénomènes en apparence aléatoires, du nombre de clients arrivant dans un magasin en une heure au nombre d’impacts de météorites sur une planète en un siècle.

Quand faut-il utiliser la loi de Poisson ?

Utilisez la loi de Poisson pour des situations où des événements surviennent de manière aléatoire et indépendante à un taux constant dans un intervalle donné, par exemple le nombre d’e-mails reçus en une heure ou les appels reçus pendant un shift dans un centre de contact.

En quoi la loi de Poisson diffère-t-elle de la loi normale ?

La loi de Poisson s’applique à des données de comptage discrètes, souvent avec de petits nombres d’événements, tandis que la loi normale modélise généralement des données continues et constitue une bonne approximation de Poisson lorsque le taux d’événements (λ) est élevé.

Quel est le lien entre les lois de Poisson et exponentielle ?

La loi de Poisson compte le nombre d’événements dans un intervalle fixe, tandis que la loi exponentielle mesure le temps entre deux événements successifs d’un processus de Poisson. Elles sont liées : connaissant le taux d’occurrence de la Poisson, on détermine l’échelle de l’exponentielle.

Peut-on utiliser la loi de Poisson pour tout type de données ?

Non. La loi de Poisson convient au comptage d’événements discrets, indépendants, au sein d’un intervalle ou d’une région fixes, avec un taux moyen constant. Elle n’est pas adaptée lorsque les événements s’influencent mutuellement ou lorsque le taux varie dans le temps.

Que signifie λ dans une loi de Poisson ?

Dans une loi de Poisson, λ (lambda) représente le nombre attendu d’événements dans l’intervalle. C’est à la fois la moyenne et la variance de la distribution.

Comment créer une loi de Poisson en Python ?

Pour générer une loi de Poisson en Python, on utilise principalement le module random de NumPy. La fonction np.random.poisson() génère des échantillons aléatoires selon une loi de Poisson ; vous spécifiez le taux moyen (lambda) et le nombre d’échantillons souhaités. Ces échantillons peuvent ensuite servir à tracer des histogrammes, calculer des probabilités ou mener des analyses statistiques. Pour des calculs de probabilité précis, le module stats de SciPy propose des fonctions comme stats.poisson.pmf() (fonction de masse) et stats.poisson.cdf() (fonction de répartition cumulée).

Comment créer une loi de Poisson dans R ?

Pour créer une loi de Poisson dans R, vous pouvez utiliser les fonctions natives du package statistique de base. Les principales fonctions sont rpois() pour générer des nombres aléatoires, dpois() pour la masse de probabilité, ppois() pour la probabilité cumulée et qpois() pour les quantiles. Combinez-les avec les outils de visualisation de R pour créer et tracer des lois de Poisson.

Quel est le lien entre la loi de Poisson et la régression de Poisson ?

La loi de Poisson décrit la probabilité d’un nombre d’événements sur un intervalle fixe ; la régression de Poisson est une méthode statistique pour modéliser des données de comptage et comprendre l’influence de variables explicatives sur ces comptages. On suppose que la variable réponse suit une loi de Poisson, et le logarithme de sa valeur attendue est modélisé comme une combinaison linéaire des prédicteurs, ce qui permet d’analyser comment différents facteurs affectent le taux d’occurrence des événements.

Sujets
Science des données
Analyse des données

Apprenez avec DataCamp

Cours

Comprendre le Machine Learning

2 h
313.2K
Une introduction au machine learning sans codage.
Voir les détailsCommencer Le Cours

Créez votre compte gratuit

S'entraîner et cursus vos progrès.

Continuer Avec Google
En continuant, vous acceptez nos Conditions d'utilisation, notre Politique de confidentialité et le fait que vos données seront hébergées aux États-Unis.
Voir plus
Contenus associés

Tutoriel

AVERAGE() dans Excel : une fonction essentielle expliquée

Apprenez à utiliser la fonction AVERAGE() d’Excel, y compris ses variantes conditionnelles et logiques.
Josef Waples's photo

Josef Waples

3 min

Tutoriel

Séquence de Fibonacci en Python : Apprenez et explorez les techniques de codage

Veuillez découvrir le fonctionnement de la suite de Fibonacci. Veuillez explorer ses propriétés mathématiques et ses applications concrètes.
Laiba Siddiqui's photo

Laiba Siddiqui

6 min

Tutoriel

Fonctions lambda Python : Guide pour débutants

Découvrez les fonctions lambda Python, leur utilité et quand les utiliser. Comprend des exemples pratiques et des bonnes pratiques pour une mise en œuvre efficace.
Mark Pedigo's photo

Mark Pedigo

10 min

Tutoriel

Régression MCO : Les idées clés expliquées

Gagnez en confiance dans la régression par les MCO en maîtrisant ses fondements théoriques. Découvrez comment réaliser des mises en œuvre simples dans Excel, R et Python.
Josef Waples's photo

Josef Waples

8 min

Tutoriel

Power Pivot Excel : guide pas à pas

Apprenez à relier des tables, écrire des formules DAX et construire des rapports interactifs dans Excel.
Laiba Siddiqui's photo

Laiba Siddiqui

14 min

Tutoriel

Python Switch Case Statement : Guide du débutant

Découvrez le match-case de Python : un guide sur sa syntaxe, ses applications en data science, ML, et une analyse comparative avec le switch-case traditionnel.
Matt Crabtree's photo

Matt Crabtree

5 min

Voir plus

