

कोर्स
Llama 3 के साथ फाइन-ट्यूनिंग
2 घंटा
4.1K
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखेंUnsloth Studio एक स्थानीय, ब्राउज़र-आधारित इंटरफ़ेस के माध्यम से LLM फाइन-ट्यूनिंग को सभी के लिए अधिक सुलभ बना रहा है, जो सेटअप और कोडिंग का अधिकांश ओवरहेड हटा देता है। यह एक नो-कोड वेब UI के रूप में डिज़ाइन किया गया है जो मॉडल लोडिंग, डेटासेट फ़ॉर्मैटिंग, हाइपरपैरामीटर सेटअप और लाइव ट्रेनिंग मॉनिटरिंग संभालता है।
इस ट्यूटोरियल में, हम Unsloth Studio के साथ एक LLM को फाइन-ट्यून करने के पूरे वर्कफ़्लो से गुजरेंगे। हम मॉडल और डेटा तैयार करने से शुरू करेंगे, फाइन-ट्यूनिंग जॉब चलाएँगे, चैट इंटरफ़ेस में लोकल रूप से फाइन-ट्यून किए गए मॉडल का परीक्षण करेंगे, और अंत में उसे बाद में उपयोग के लिए एक्सपोर्ट करेंगे।
Unsloth Studio Linux, Windows, macOS और WSL पर लोकल इंस्टॉलेशन सपोर्ट करता है, और इसके एक्सपोर्ट टूल GGUF, Safetensors और LoRA जैसे फ़ॉर्मैट्स सपोर्ट करते हैं ताकि उन्हें llama.cpp, Ollama और vLLM जैसे टूल्स में डाउनस्ट्रीम उपयोग किया जा सके।
कई छोटे से मध्यम फाइन-ट्यूनिंग वर्कफ़्लोज़ के लिए, वातावरण तैयार हो जाने के बाद यह प्रक्रिया आश्चर्यजनक रूप से जल्दी पूरी हो सकती है, जिससे Unsloth Studio शुरुआती लोगों के लिए एक व्यावहारिक विकल्प बन जाता है जो डेटा से एक काम करने वाले फाइन-ट्यून किए गए मॉडल तक सरल रास्ता चाहते हैं।
मैं अपने अन्य गाइड How to Run Unsloth Studio Locally भी देखने की सलाह देता/देती हूँ ताकि आप और जान सकें।
नीचे दिए गए चरणों में, मैं बताऊँगा/बताऊँगी कि आप LLM फाइन-ट्यूनिंग के लिए Unsloth Studio का उपयोग कैसे शुरू कर सकते हैं:
Unsloth Studio इंस्टॉल करने से पहले, सुनिश्चित करें कि आपकी मशीन ट्रेनिंग सपोर्ट करती है। Unsloth Studio Windows, Linux, WSL और macOS पर चल सकता है, लेकिन ट्रेनिंग सपोर्ट आपके हार्डवेयर पर निर्भर करता है।
इस समय, पूर्ण ट्रेनिंग NVIDIA GPUs और Intel GPUs पर समर्थित है। Mac और केवल CPU सिस्टम पर, आप अभी भी Chat और Data Recipes का उपयोग कर सकते हैं, जबकि MLX ट्रेनिंग सपोर्ट बाद में आने की उम्मीद है।
Linux ट्रेनिंग के लिए आवश्यकताएँ:
Unsloth Studio इंस्टॉल करने से पहले, How to Run Unsloth Studio Locally: Step-by-Step Guide ट्यूटोरियल पढ़ना उपयोगी है। यह Runpod सेटअप, Unsloth Studio इंस्टॉल करने और ब्राउज़र में खोलने का विस्तृत विवरण देता है।
इस ट्यूटोरियल के लिए, हमने एक छोटा बदलाव किया। A10 pod के बजाय, हमने RTX A6000 GPU pod का उपयोग किया। मुख्य कारण यह है कि A10 सेटअप में डिपेंडेंसीज़ इंस्टॉल करने और Unsloth Studio के लिए वातावरण तैयार करने में अधिक समय लग सकता है।
Unsloth Studio इंस्टॉल करने के लिए, आधिकारिक वन-लाइन इंस्टॉलर का उपयोग करें:
curl -fsSL https://unsloth.ai/install.sh | shइंस्टॉलर पहले आवश्यक Python डिपेंडेंसीज़ को uv का उपयोग करके सेटअप करता है।
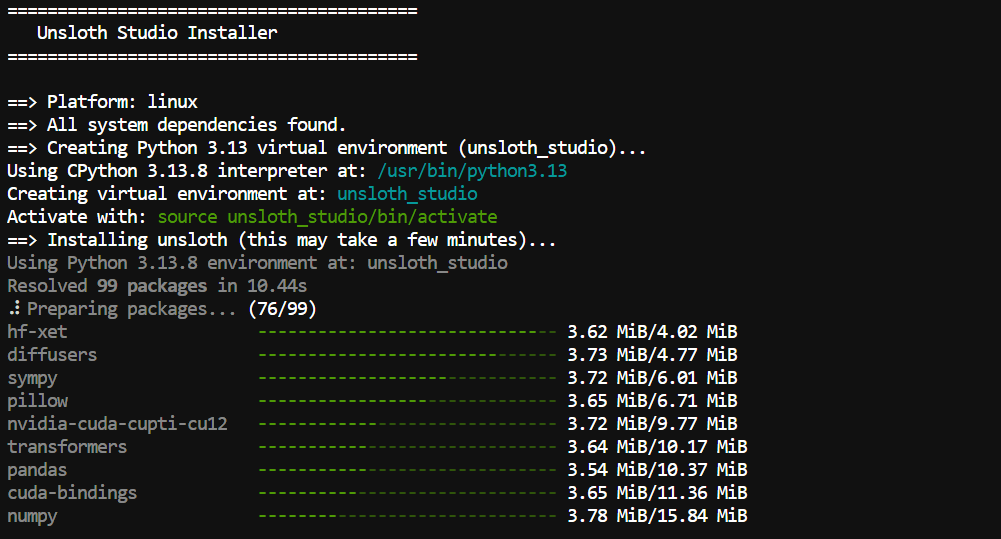
उसके बाद, यह Unsloth Studio सेटअप स्क्रिप्ट चलाता है, जो स्थानीय वेब इन्फरेंस के लिए आवश्यक फ़ाइलें इंस्टॉल करता है।
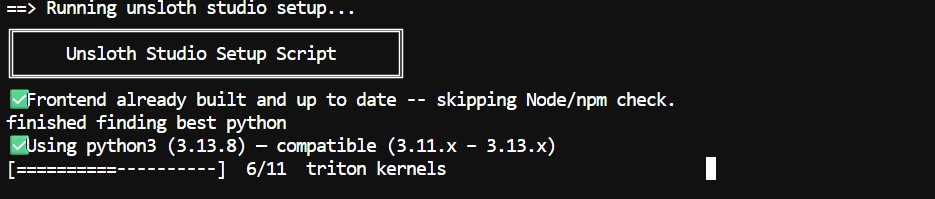
फ्रंटएंड फ़ाइलें और मॉडल कंपोनेंट्स सहित सब कुछ डाउनलोड और कॉन्फ़िगर हो जाने के बाद, Unsloth Studio आपको सर्वर शुरू करने और अपने ब्राउज़र में इंटरफ़ेस खोलने के अगले चरण दिखाएगा।
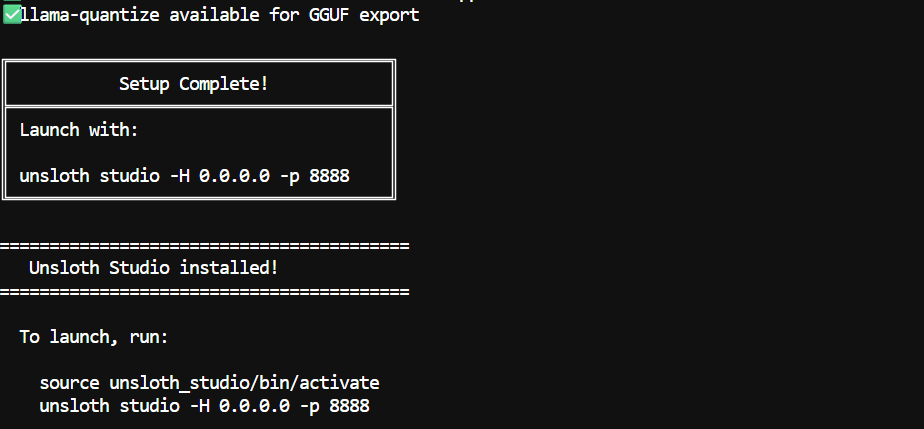
ध्यान दें: पहली इंस्टॉलेशन में 5 से 10 मिनट लग सकते हैं क्योंकि कुछ llama.cpp बाइनरीज़ को कंपाइल करने की आवश्यकता हो सकती है।
इंस्टॉलेशन पूरा होने के बाद, आप निम्नलिखित कमांड्स के साथ Unsloth Studio शुरू कर सकते हैं:
source unsloth_studio/bin/activateunsloth studio -H 0.0.0.0 -p 8910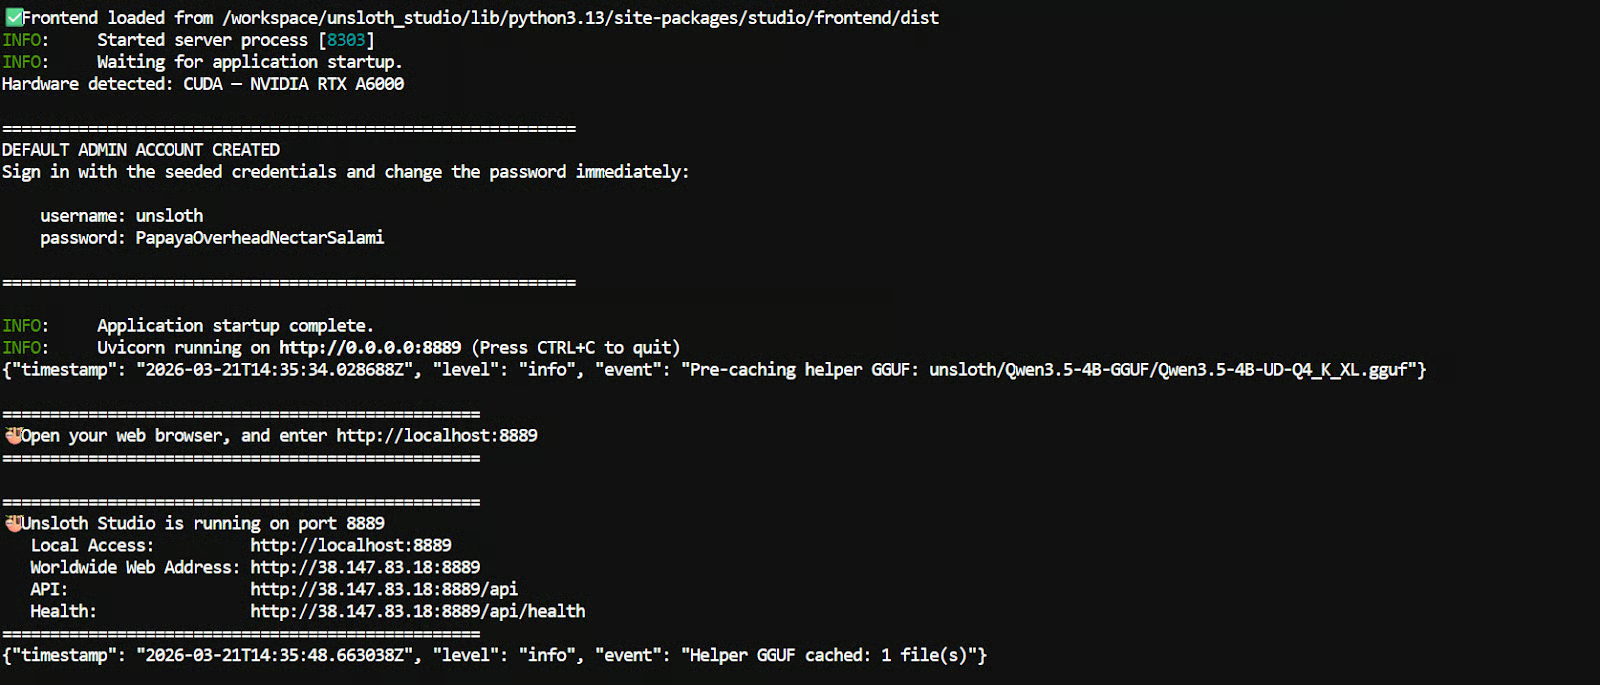
यदि आप इसे अपनी लोकल मशीन पर चला रहे हैं, तो अपने ब्राउज़र में यह लिंक खोलें:
http://localhost:8910यदि आप Runpod का उपयोग कर रहे हैं, तो अपने Runpod डैशबोर्ड पर जाएँ, Connect टैब खोलें, और पोर्ट 8910 के लिंक पर क्लिक करें।
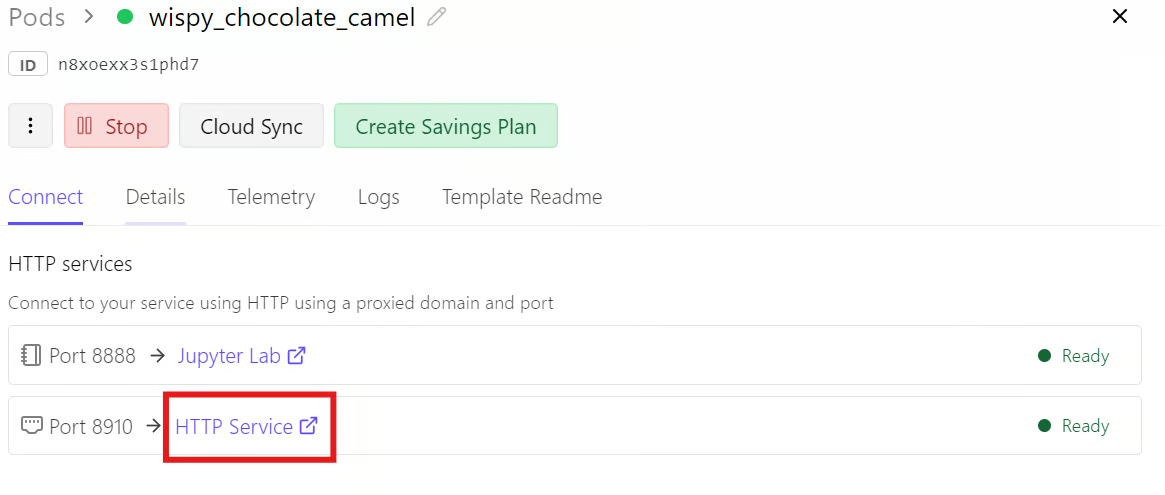
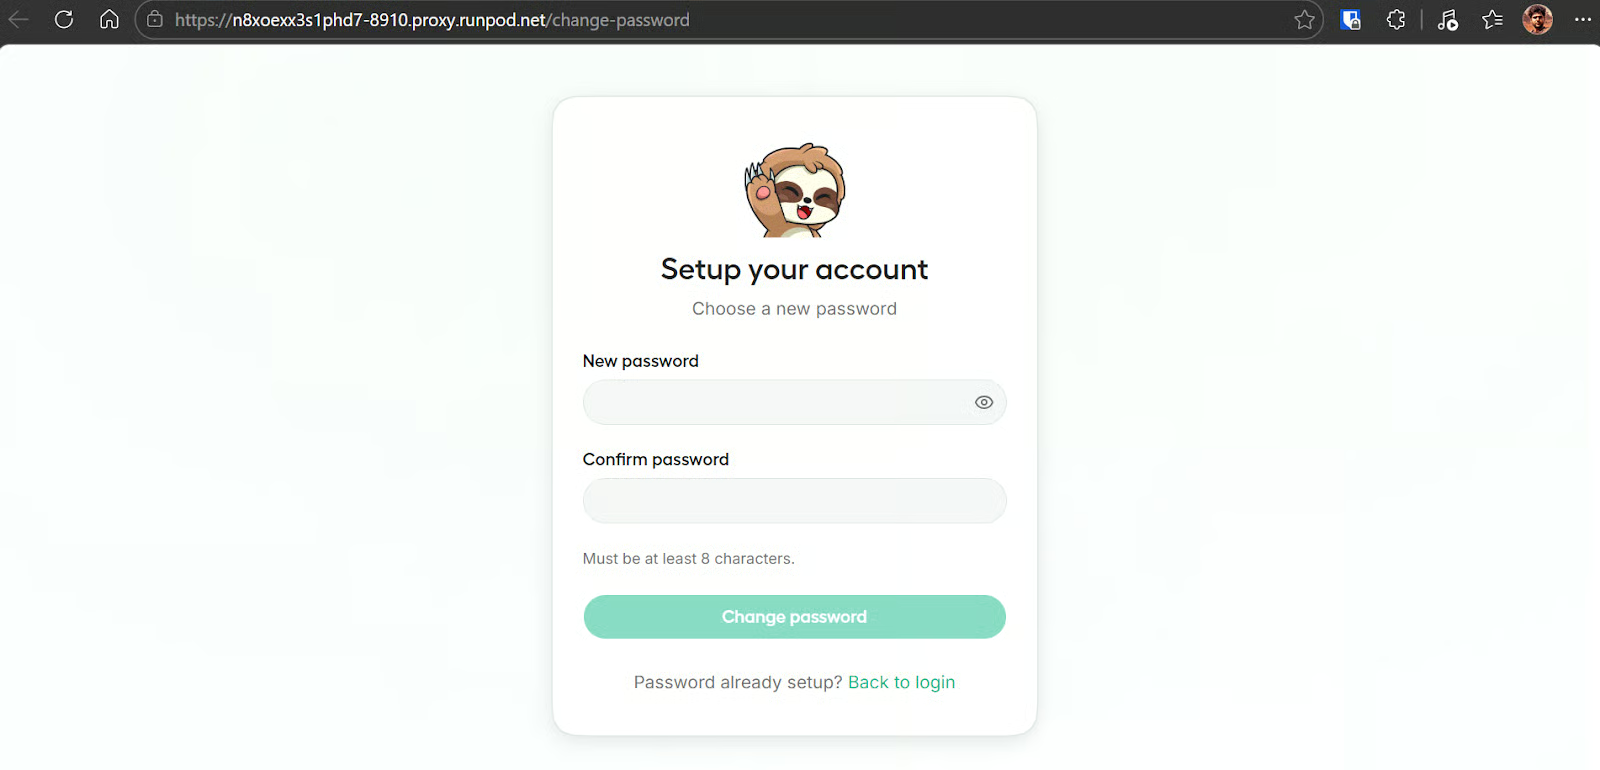
जब आप पहली बार Unsloth Studio खोलते हैं, तो यह आपसे अपनी इंस्टेंस के लिए पासवर्ड बनाने के लिए कहेगा। यह एक्सेस की सुरक्षा में मदद करता है, खासकर जब आप सार्वजनिक या बाहरी रूप से सुलभ लिंक का उपयोग कर रहे हों।
Unsloth Studio खुलने के बाद, मुख्य स्क्रीन चार प्रमुख अनुभागों में विभाजित होती है: Model, Dataset, Parameters, और Training/Config। साथ मिलकर, ये अनुभाग पूरे फाइन-ट्यूनिंग वर्कफ़्लो को कवर करते हैं—बेस मॉडल चुनने से लेकर ट्रेनिंग लॉन्च करने और प्रगति मॉनिटर करने तक।
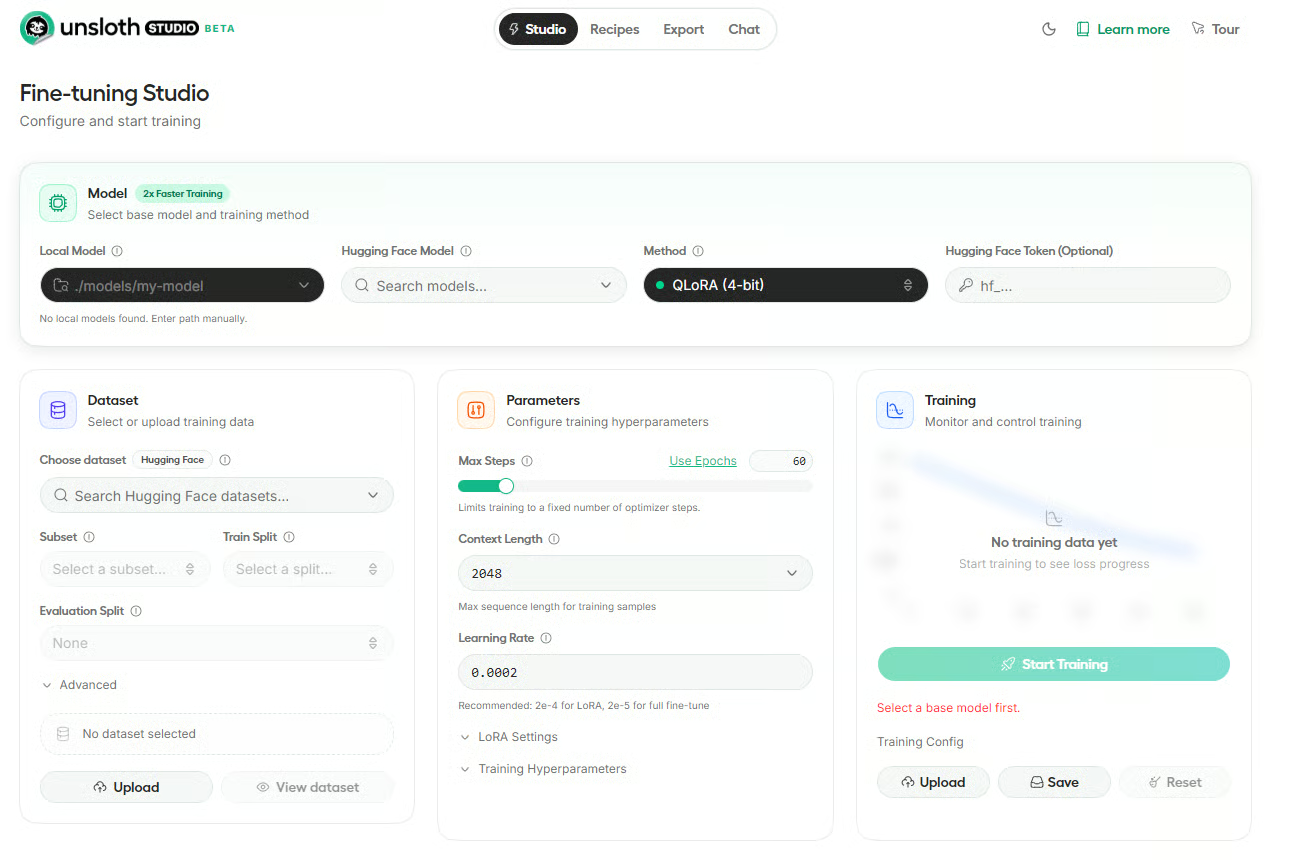
यहाँ आप बेस मॉडल और ट्रेनिंग विधि चुनते हैं। इस स्क्रीन में, आप लोकल मॉडल पाथ दर्ज कर सकते हैं, Hugging Face मॉडल खोज सकते हैं, QLoRA (4-bit) जैसी फाइन-ट्यूनिंग विधि चुन सकते हैं, और वैकल्पिक रूप से अपना Hugging Face टोकन जोड़ सकते हैं।
यह अनुभाग आपके ट्रेनिंग डेटा का चयन या अपलोड करने के लिए उपयोग किया जाता है। आप Hugging Face से डेटासेट चुन सकते हैं, सबसेट और स्प्लिट परिभाषित कर सकते हैं, और आवश्यकता होने पर अपनी फ़ाइलें अपलोड कर सकते हैं।
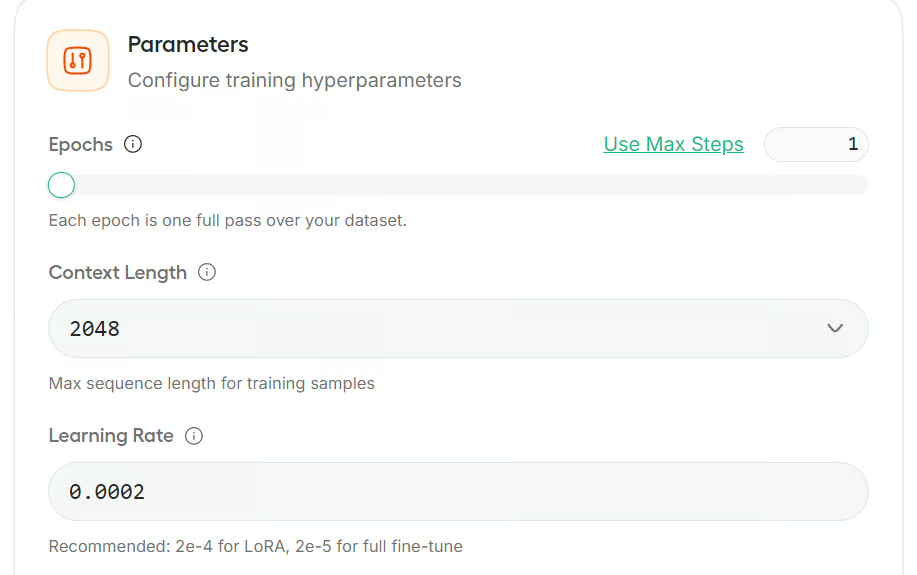
यहाँ आप मुख्य ट्रेनिंग सेटिंग्स कॉन्फ़िगर करते हैं, जैसे मैक्स स्टेप्स, कॉन्टेक्स्ट लेंथ और लर्निंग रेट। LoRA और अन्य ट्रेनिंग हाइपरपैरामीटर्स के लिए विस्तार योग्य सेटिंग्स भी उपलब्ध हैं।
यह अनुभाग वह जगह है जहाँ आप ट्रेनिंग शुरू और मॉनिटर करते हैं। जब मॉडल और डेटासेट तैयार हो जाते हैं, आप रन लॉन्च कर सकते हैं, प्रगति ट्रैक कर सकते हैं, और ट्रेनिंग कॉन्फ़िग अपलोड या सेव कर सकते हैं।
Model अनुभाग में, आप या तो Hugging Face से मॉडल खोज सकते हैं या अपनी मशीन पर पहले से उपलब्ध लोकल मॉडल चुन सकते हैं। Unsloth Studio डायरेक्ट Hub सर्च सपोर्ट करता है, और ~/.unsloth/studio/models में संग्रहीत लोकल मॉडल या आपके Hugging Face कैश में मौजूद मॉडल भी सूची में दिखाई दे सकते हैं।
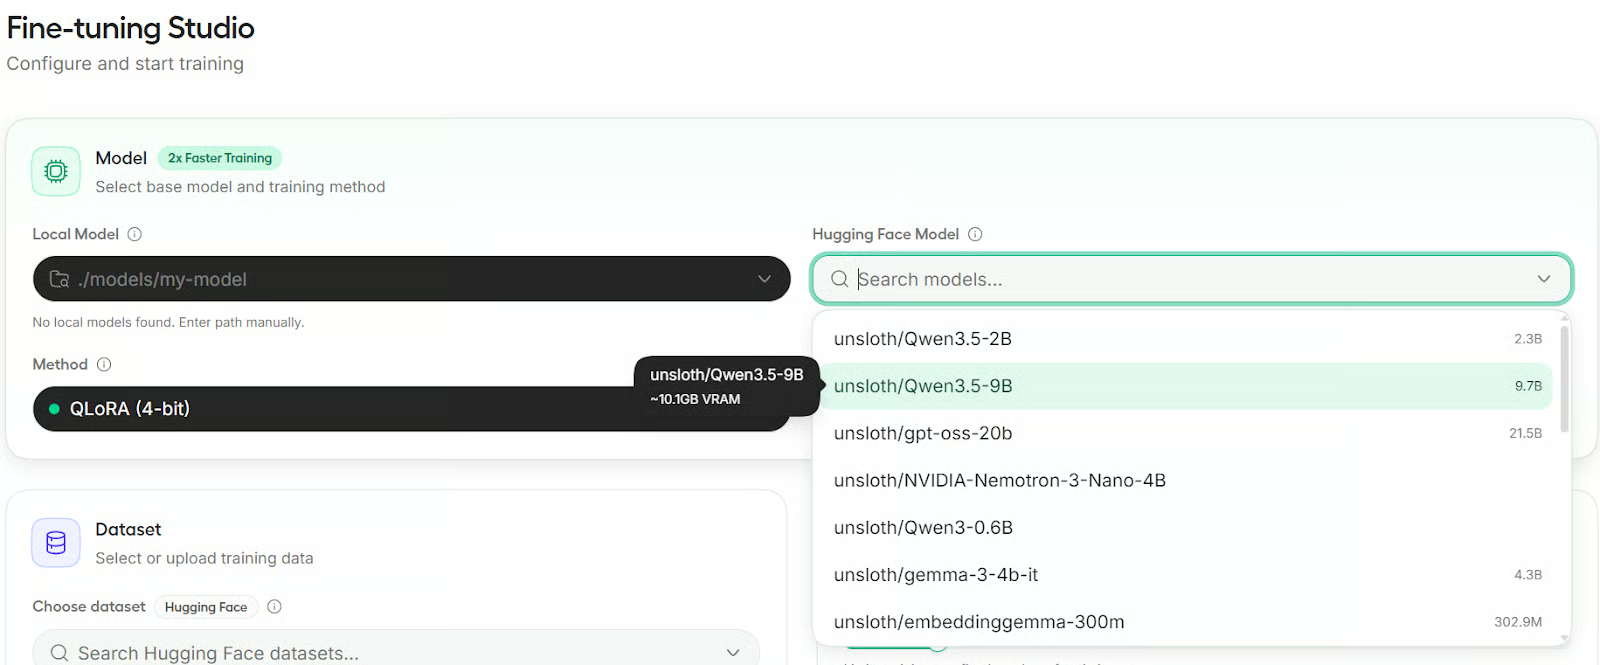
इस ट्यूटोरियल के लिए, हम Qwen3.5-9B को बेस मॉडल के रूप में उपयोग करेंगे। यह एक कॉम्पैक्ट लेकिन सक्षम मॉडल है जो छोटे पैमाने की फाइन-ट्यूनिंग और लोकल एक्सपेरिमेंटेशन के लिए अच्छा काम करता है।
Unsloth Studio तीन ट्रेनिंग विधियाँ प्रदान करता है: QLoRA, LoRA, और Full Fine-tuning। QLoRA 4-बिट क्वांटाइज़्ड बेस मॉडल के साथ एक LoRA एडेप्टर का उपयोग करता है और सबसे कम VRAM की ज़रूरत होती है।
LoRA बेस मॉडल को फुल प्रिसीजन में रखता है और LoRA एडेप्टर जोड़ता है, इसलिए यह अधिक मेमोरी उपयोग करता है। Full Fine-tuning सभी मॉडल वेट्स अपडेट करता है और सबसे अधिक VRAM की आवश्यकता होती है।
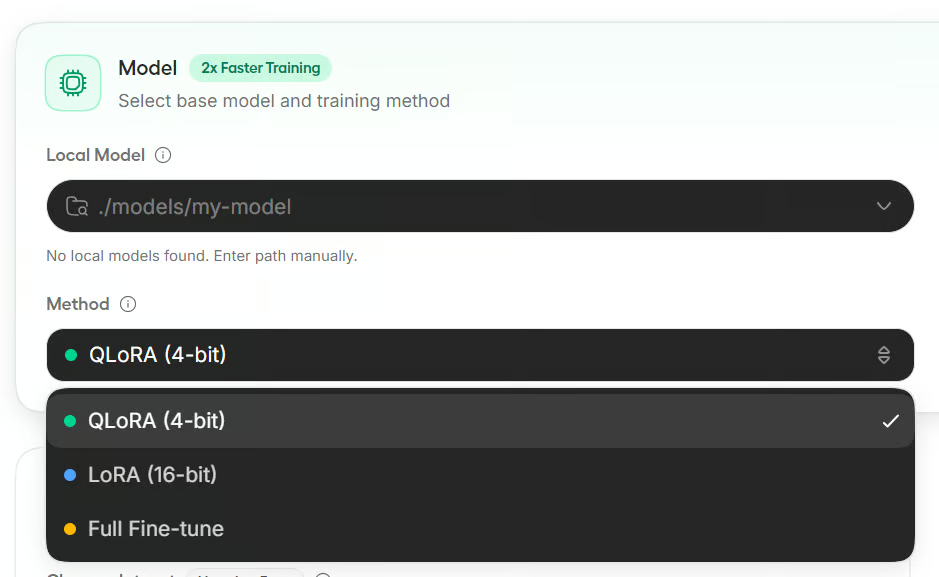
इस ट्यूटोरियल के लिए, हम QLoRA का उपयोग करेंगे क्योंकि यह सबसे मेमोरी-एफ़िशिएंट विकल्प है और आम तौर पर छोटे GPU सेटअप के लिए सबसे आसान पसंद होती है।
Dataset अनुभाग में, आप Hugging Face से डेटा लोड कर सकते हैं या लोकल फ़ाइलें अपलोड कर सकते हैं। Unsloth Studio ऑटोमैटिक डेटासेट फ़ॉर्मैटिंग सपोर्ट करता है और Alpaca, ChatML और ShareGPT जैसे सामान्य लेआउट्स के साथ काम करता है। इसमें स्प्लिट चयन, कॉलम मैपिंग और डेटासेट प्रीव्यू के टूल भी शामिल हैं।
यहाँ, Unsloth Latex OCR डेटासेट चुनें, train split चुनें, और ट्रेनिंग को तेज रखने के लिए evaluation split खाली छोड़ दें। हम फ़ॉर्मैट को Auto पर ही रखेंगे ताकि Studio हमारे लिए डेटासेट संरचना का पता लगा सके।
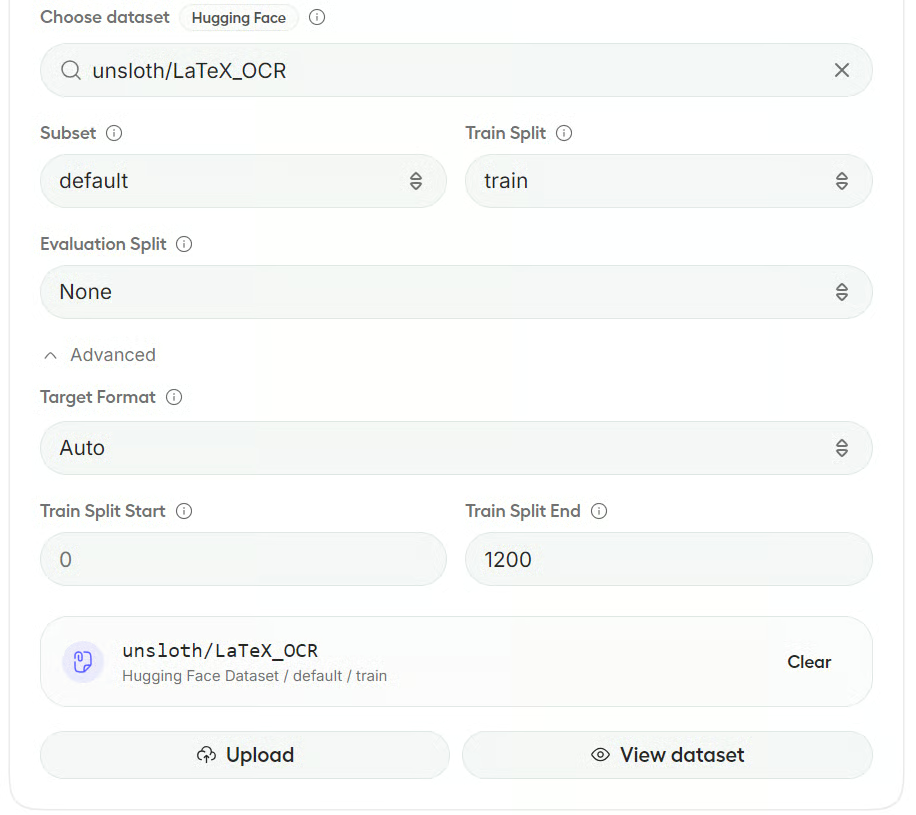
ध्यान दें: यदि Studio डेटासेट फ़ील्ड्स को पूरी तरह नहीं पहचान पाता, तो यह एक प्रीव्यू विंडो खोलता है जहाँ आप instruction, input, output या image जैसे कॉलम्स को मैप कर सकते हैं। सुझाए गए मैपिंग अक्सर स्वतः भरे रहते हैं।
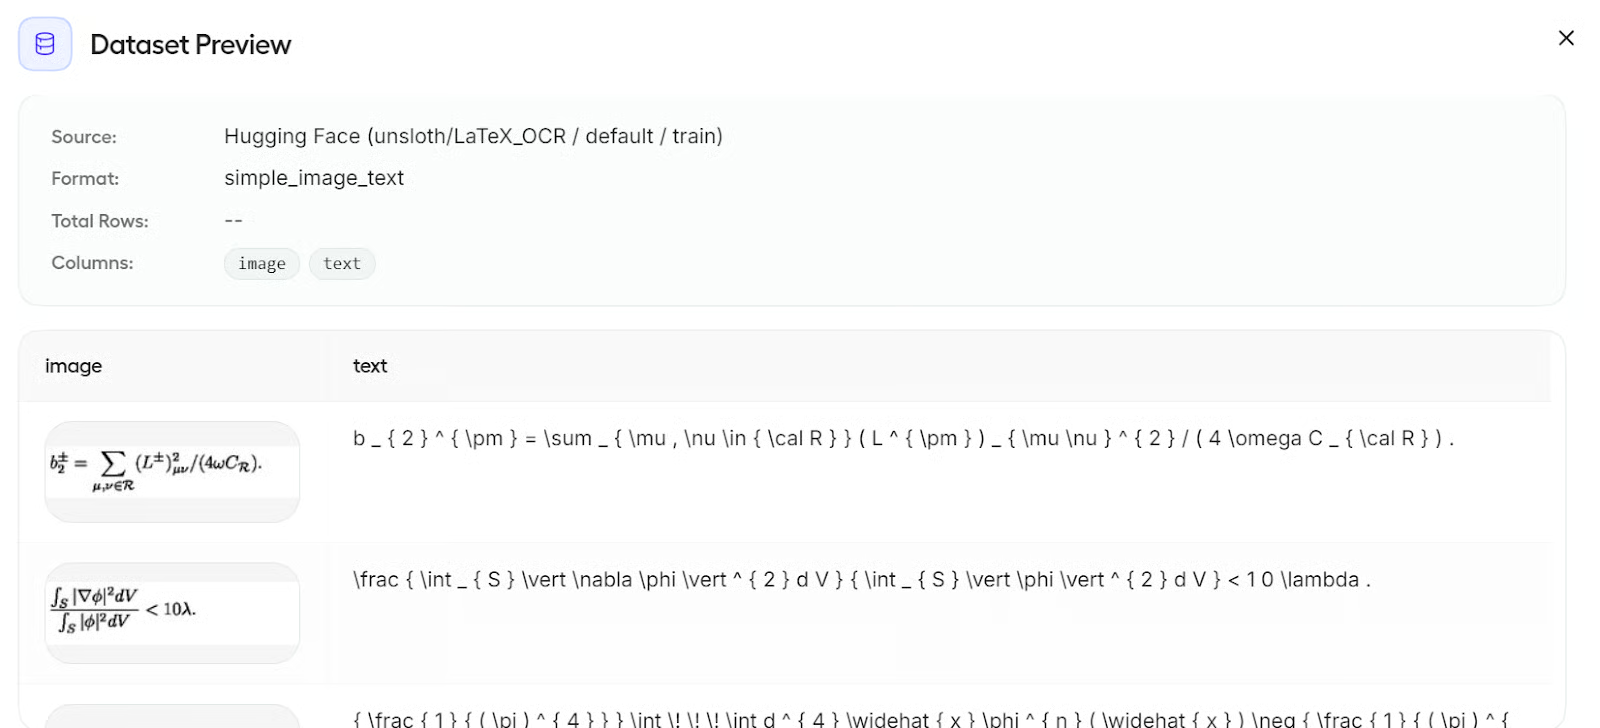
आप View dataset पर क्लिक कर के ट्रेनिंग से पहले अपने डेटा का निरीक्षण भी कर सकते हैं। इस मामले में, डेटासेट में image और text कॉलम शामिल हैं, जो इसे मल्टीमोडल फाइन-ट्यूनिंग के लिए तैयार बनाते हैं।
Parameters अनुभाग में, Unsloth Studio सेटिंग्स को कॉलेप्सिबल पैनल्स में समूहित करता है। इस ट्यूटोरियल के लिए, हम चीज़ों को सरल रखेंगे और केवल कुछ छोटे बदलाव करेंगे।
सबसे पहले, ट्रेनिंग लिमिट को steps से बदलकर epochs करें और इसे 1 epoch पर सेट करें। चूँकि यह एक छोटा उदाहरण रन है, डेटासेट पर एक पूरा पास ट्रेनिंग के लिए पर्याप्त है। बाकी मुख्य सेटिंग्स को हम डिफ़ॉल्ट पर ही छोड़ेंगे:
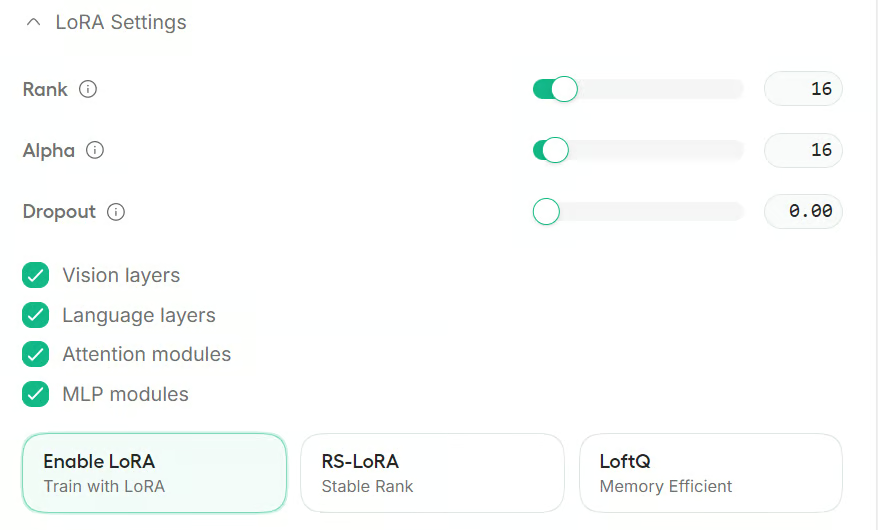
अगला, LoRA Settings अनुभाग खोलें। इस गाइड के लिए, हम यहाँ भी डिफ़ॉल्ट मान ही रखेंगे:
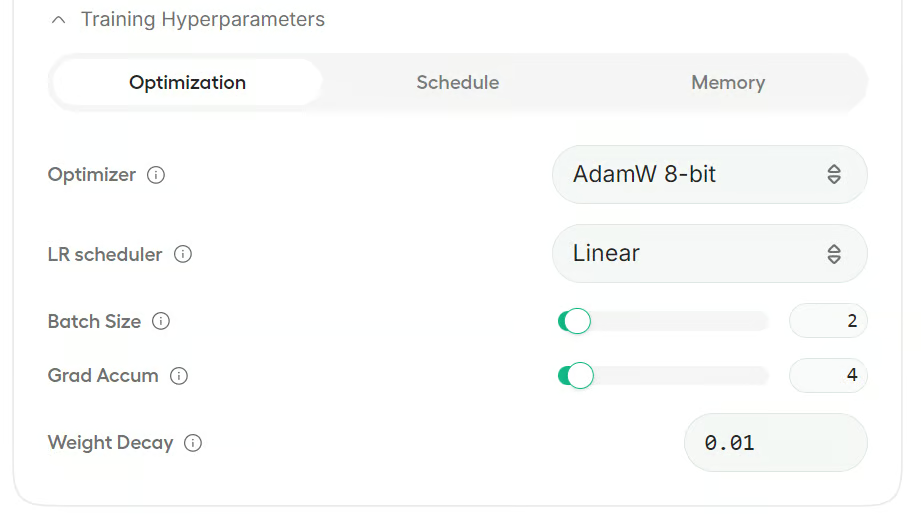
आप Training Hyperparameters अनुभाग का विस्तार कर के ऑप्टिमाइज़र, शेड्यूलर और मेमोरी-संबंधित सेटिंग्स जैसे विकल्पों को भी समायोजित कर सकते हैं।
इस उदाहरण के लिए, हम बाकी सब कुछ अपरिवर्तित छोड़ेंगे और डिफ़ॉल्ट कॉन्फ़िगरेशन का उपयोग करेंगे।
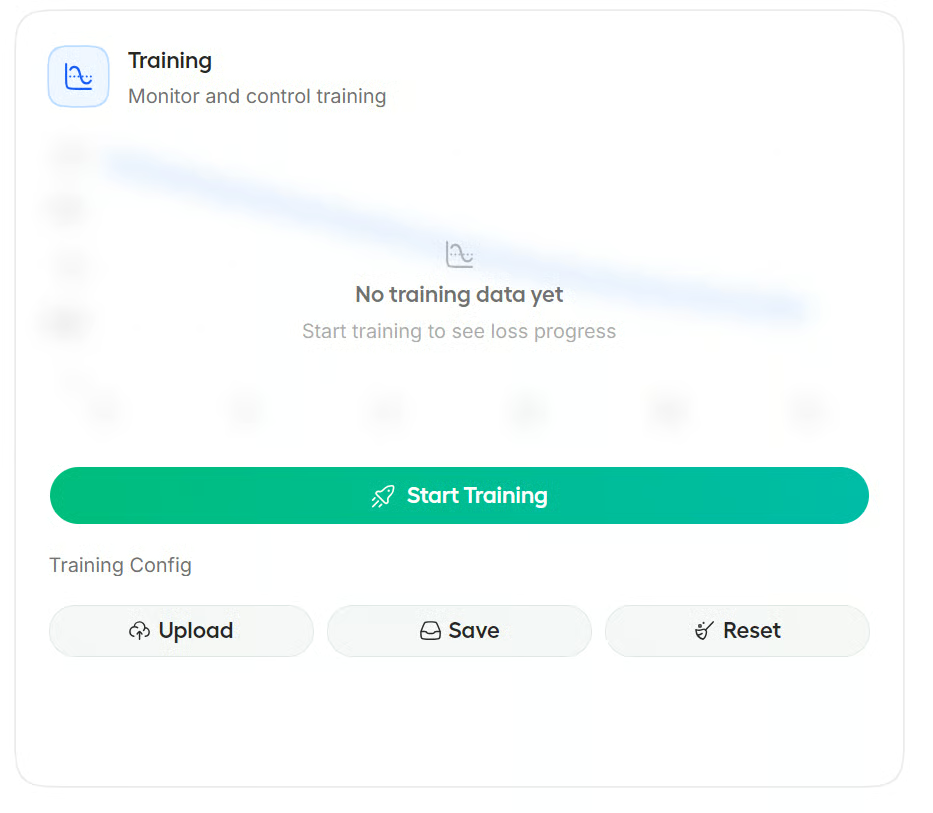
ट्रेनिंग शुरू करने से पहले, अपनी सेटिंग्स सेव करना एक अच्छा विचार है। इससे बाद में वही सेटअप फिर से लोड करना या अपनी टीम के साथ साझा करना आसान हो जाता है ताकि वे वही परिणाम दोहरा सकें।
सब कुछ तैयार हो जाने पर, Start Training पर क्लिक करें।
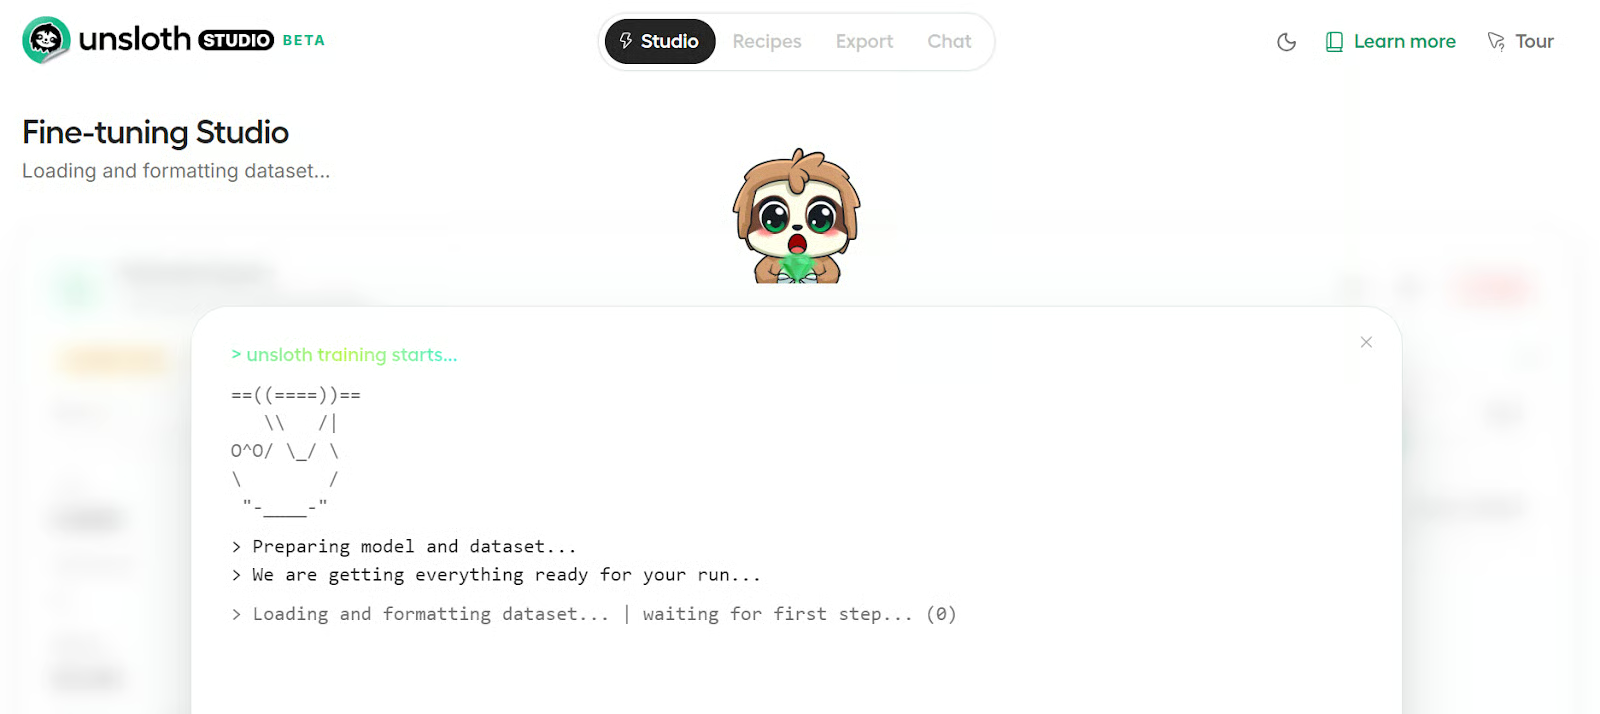
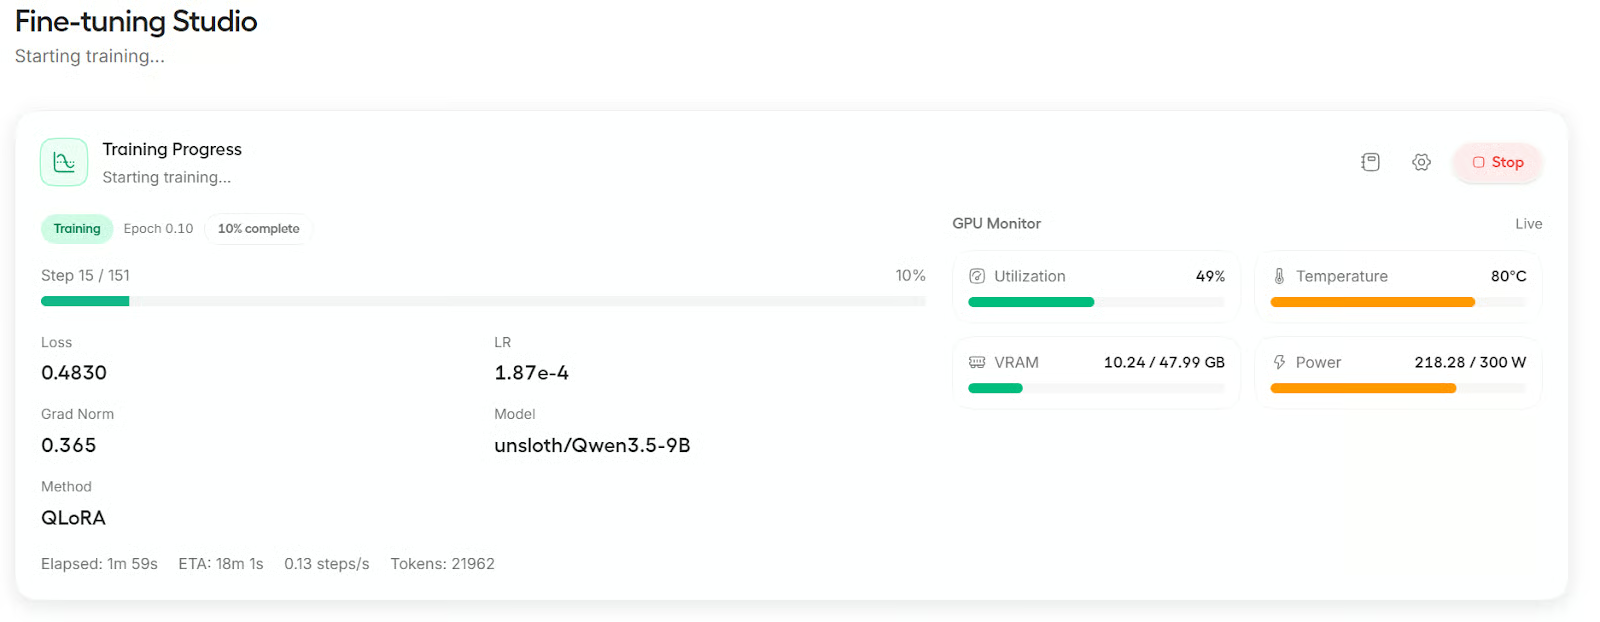
Studio ट्रेनिंग व्यू खोलेगा, जहाँ आप रन शुरू होते ही लॉग्स का अनुसरण कर सकते हैं। शुरुआत में, आप सामान्य सेटअप चरण देखेंगे जैसे Python लाइब्रेरियाँ लोड करना, डेटासेट तैयार करना और फाइन-ट्यूनिंग पाइपलाइन इनिशियलाइज़ करना।
ट्रेनिंग शुरू होने पर, स्क्रीन लाइव प्रगति दिखाने के लिए अपडेट होती है, जिसमें loss, steps और अन्य ट्रेनिंग विवरण शामिल होते हैं।
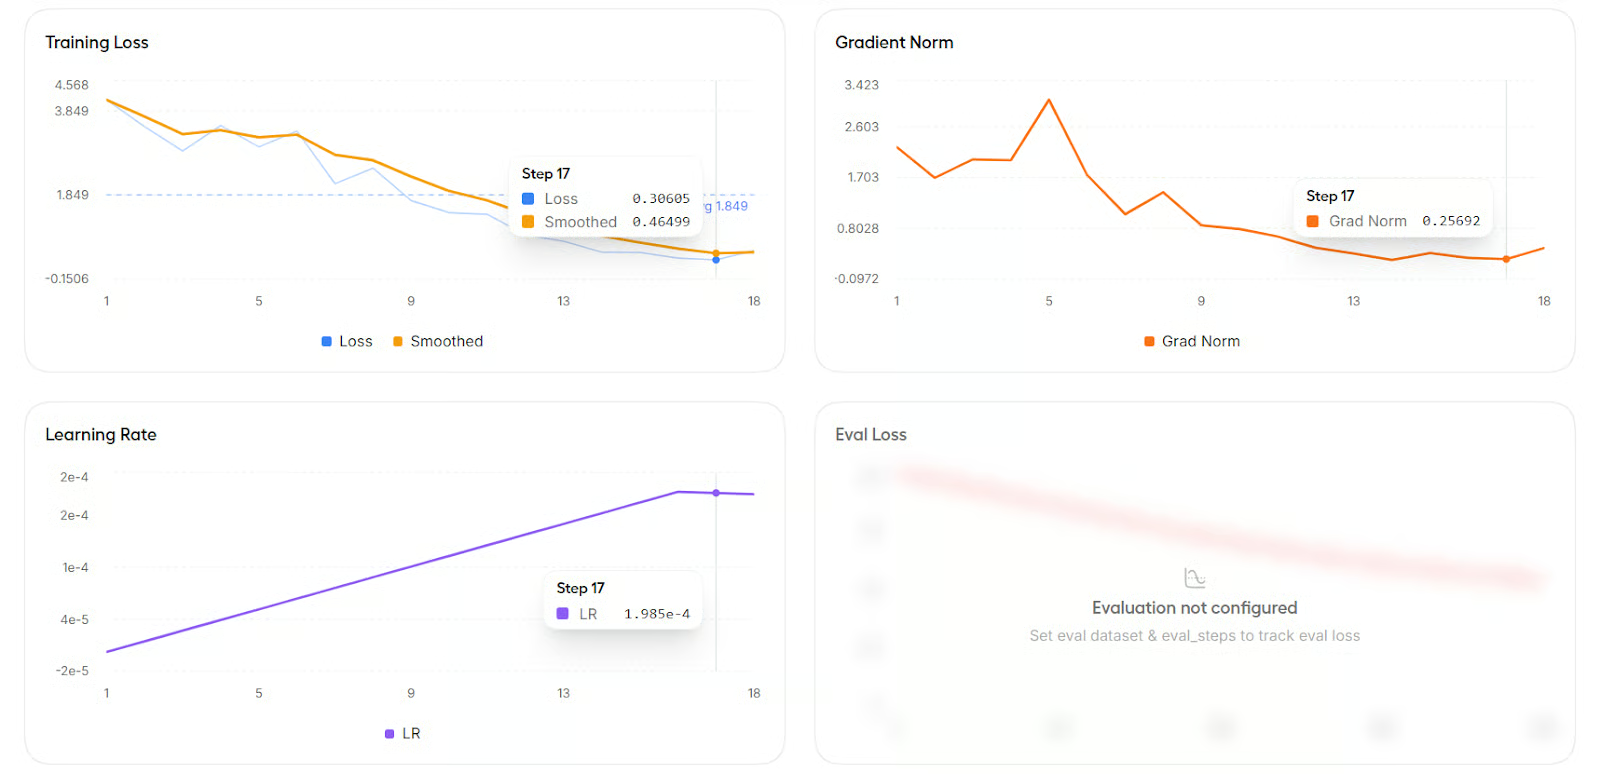
आप नीचे स्क्रॉल करके training loss, learning rate और gradient norm जैसे मैट्रिक्स के ग्राफ़ भी देख सकते हैं।
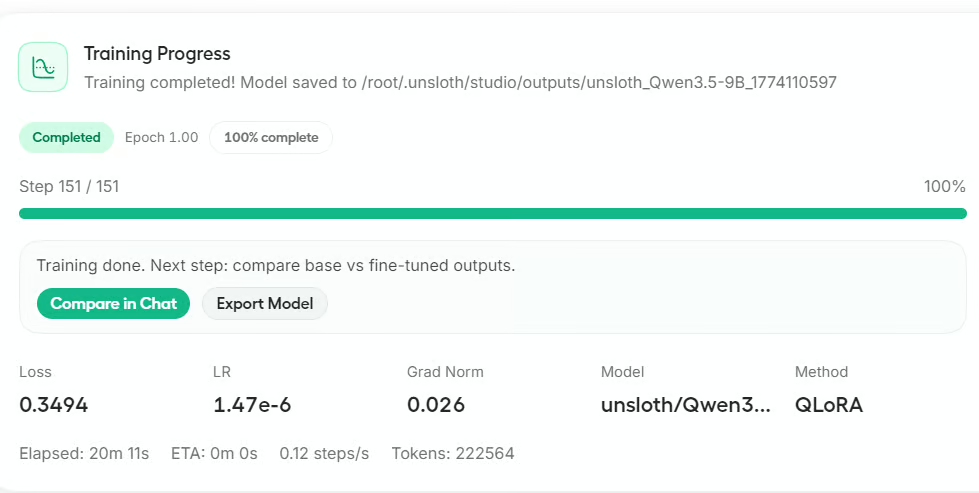
ट्रेनिंग पूरी होने के बाद, Studio आपको मॉडल एक्सपोर्ट करने या Chat में तुलना करने का विकल्प देता है। इस ट्यूटोरियल के लिए, फाइन-ट्यून किए गए मॉडल को टेस्ट करने के लिए Compare in Chat पर क्लिक करें।
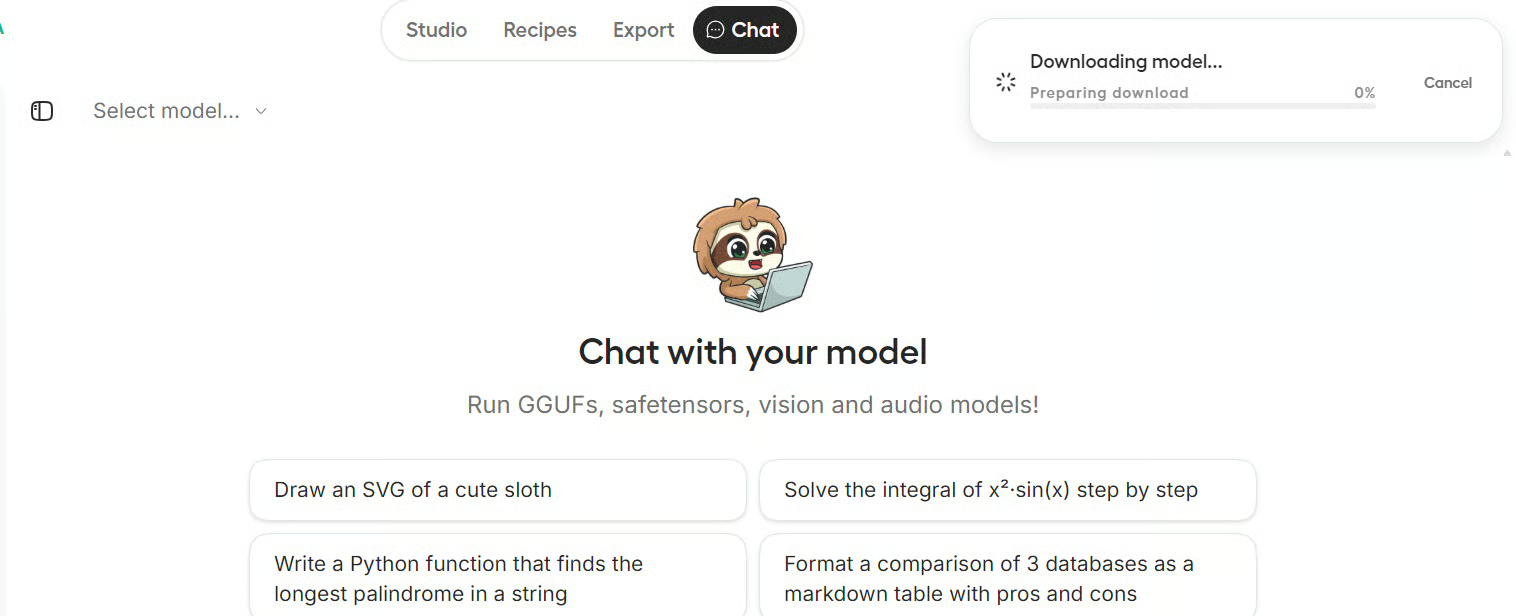
फाइन-ट्यून किया हुआ मॉडल चैट इंटरफ़ेस में लोड होने में कुछ सेकंड लग सकते हैं।
तैयार हो जाने पर, आपको Select Model अनुभाग में नया मॉडल नाम दिखाई देगा।
टेस्टिंग के लिए, हमने मॉडल को एक LaTeX समीकरण की छवि दी, और यह उसे सही ढंग से टेक्स्ट में ट्रांसक्राइब करने में सक्षम रहा।
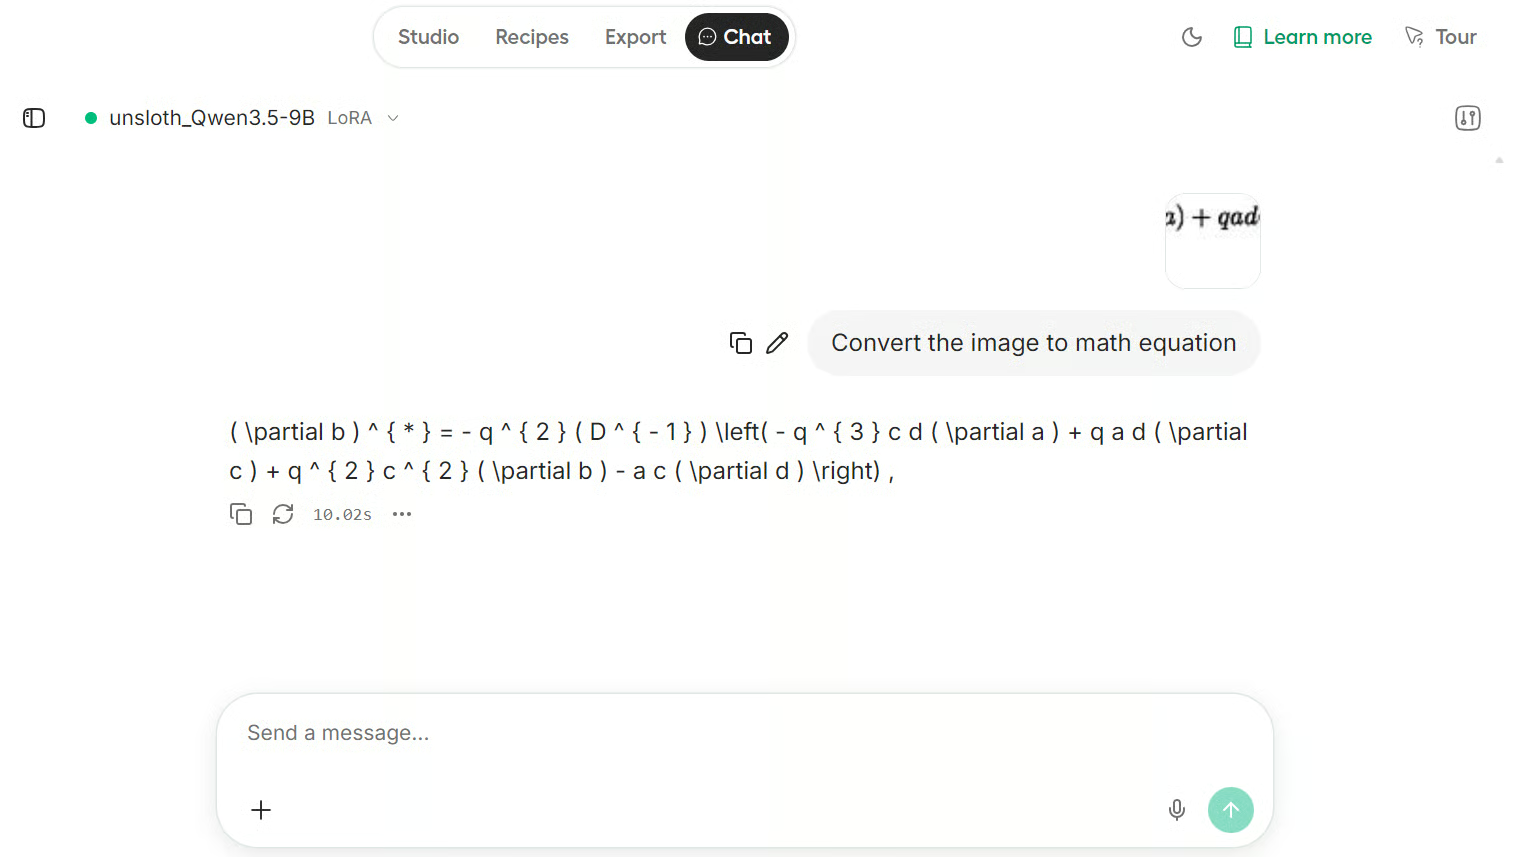
परिणाम प्रभावशाली है। यद्यपि यह केवल एक छोटा उदाहरण डेटासेट है, फाइन-ट्यून किए गए मॉडल ने समीकरण को अच्छी तरह संभाला और इस LaTeX OCR कार्य पर मज़बूत प्रदर्शन दिखाया।
फाइन-ट्यून किए मॉडल का परीक्षण करने के बाद, Export अनुभाग में जाएँ। यहाँ, अपना ट्रेनिंग रन चुनें, चेकपॉइंट चुनें, और फिर वह एक्सपोर्ट फ़ॉर्मैट चुनें जो आप चाहते हैं।
Unsloth को merged model, केवल LoRA, या GGUF के रूप में एक्सपोर्ट करने का समर्थन है, ताकि स्थानीय इन्फरेंस टूल्स में उपयोग किया जा सके।
इस ट्यूटोरियल के लिए, मॉडल को GGUF फ़ॉर्मैट में एक्सपोर्ट करें और Q4_K_M क्वांटाइज़ेशन चुनें।
यह स्थानीय उपयोग के लिए अच्छा विकल्प है क्योंकि यह मॉडल को छोटा रखता है जबकि Ollama, llama.cpp, LM Studio और Jan AI जैसे टूल्स में भी अच्छी तरह काम करता है।
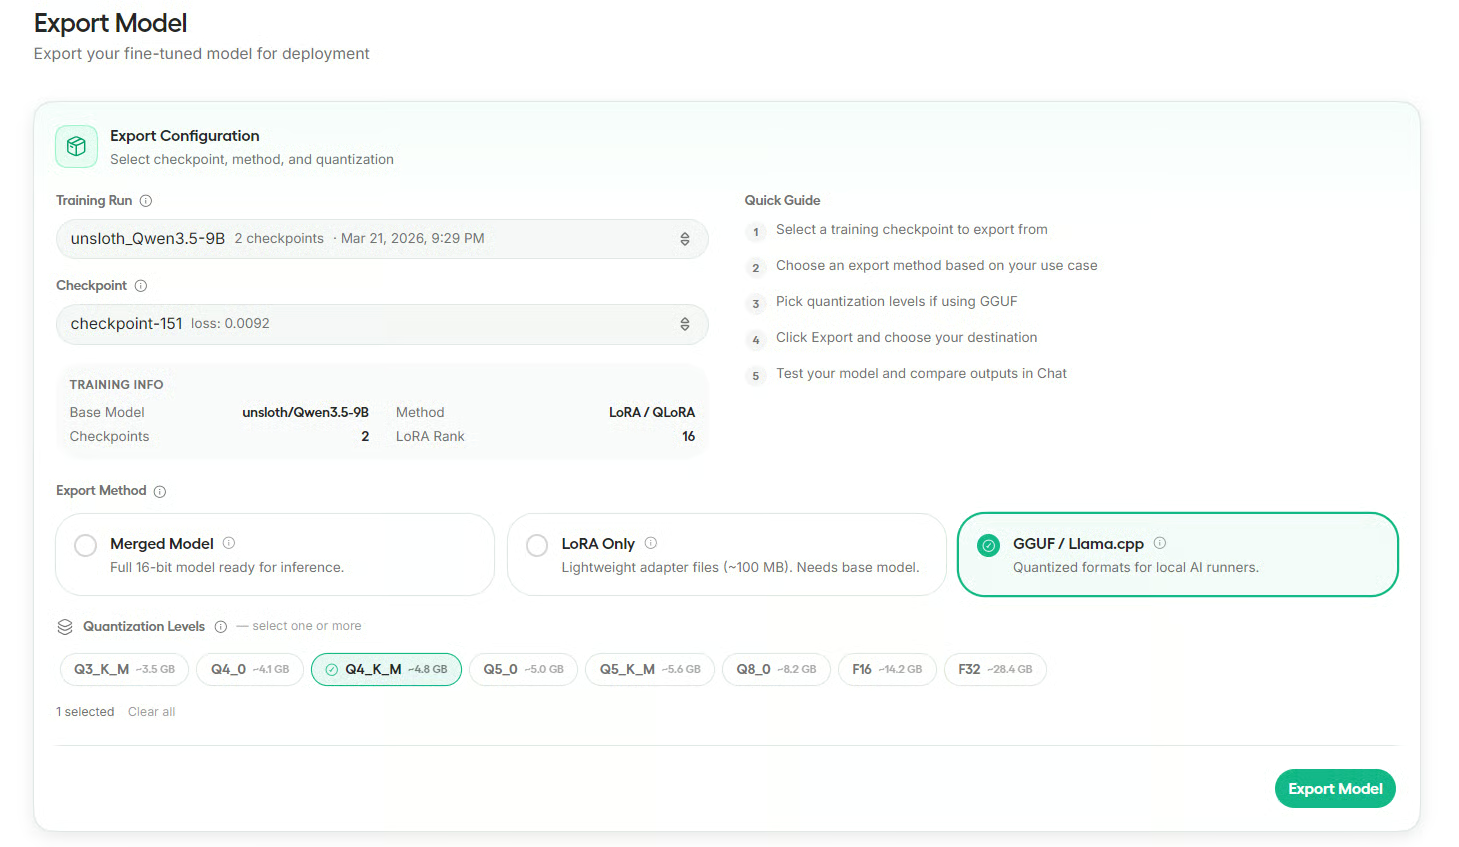
एक्सपोर्ट करने से पहले, Studio आपसे पूछेगा कि क्या आप मॉडल को लोकल रूप से सेव करना चाहते हैं या Hugging Face पर पुश करना चाहते हैं। इस गाइड में, हम इसे लोकल रूप से सेव करेंगे।
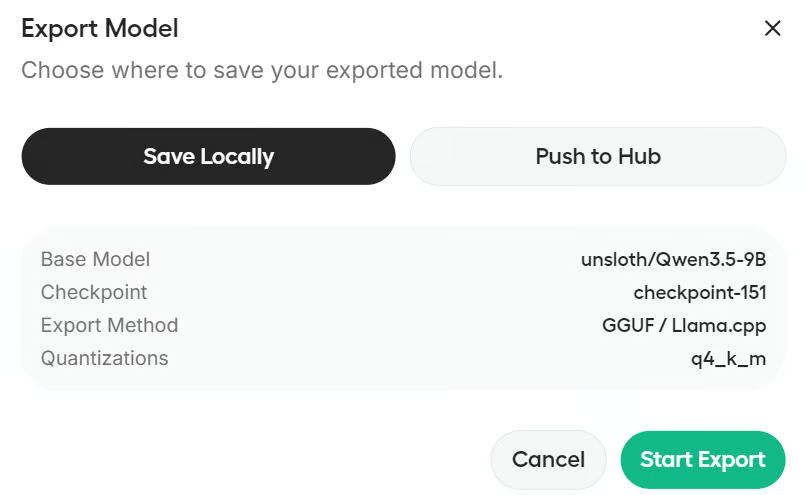
यदि आप Hugging Face पर पुश करना चाहते हैं, तो आपको सही ऑथेंटिकेशन सेटअप की आवश्यकता होगी, जैसे लिखने की अनुमति वाला Hugging Face लॉगिन या टोकन।
Unsloth Studio फाइन-ट्यूनिंग को अपनाना काफी आसान बना देता है, खासकर उनके लिए जो ओपन मॉडल्स के साथ काम करना चाहते हैं बिना जटिल ट्रेनिंग पाइपलाइन सेट करने में घंटों खर्च किए।
इंस्टॉलेशन से लेकर ट्रेनिंग, चैट टेस्टिंग और एक्सपोर्ट तक, पूरा वर्कफ़्लो ऐसे तरीके से संगठित है जो व्यावहारिक और शुरुआती-अनुकूल लगता है।
इस ट्यूटोरियल में, मैंने आपको Unsloth Studio में फाइन-ट्यूनिंग वर्कफ़्लो का पूरा मार्गदर्शन दिया। हमने GPU मशीन पर स्टूडियो इंस्टॉल किया, वेब इंटरफ़ेस लॉन्च किया, Qwen3.5-9B को बेस मॉडल के रूप में चुना, Latex OCR डेटासेट लोड किया, मुख्य ट्रेनिंग सेटिंग्स कॉन्फ़िगर कीं, QLoRA के साथ फाइन-ट्यूनिंग चलाई, चैट में फाइन-ट्यून किए मॉडल का परीक्षण किया, और अंत में उसे लोकल उपयोग के लिए एक्सपोर्ट किया।
यदि आप LLM फाइन-ट्यूनिंग में नए हैं, तो Unsloth Studio एक मज़बूत शुरुआती स्थान है। यह एंट्री बैरियर कम करता है, वर्कफ़्लो को स्पष्ट रखता है, और आपको लोकल रूप से मॉडल ट्रेन व रन करने का सरल रास्ता देता है। मैं Fine-Tuning With Llama 3 कोर्स भी देखने की सलाह देता/देती हूँ, जो फाइन-ट्यूनिंग प्रक्रिया के प्रैक्टिकल उदाहरण देता है।
शीर्ष DataCamp कोर्स
कोर्स
कोर्स
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखें