Kurs
Einführung in die Datenvisualisierung mit ggplot2
4 Std.
188.2K
Ich halte Datenvisualisierung für die beste Methode, um beschreibende Auswertungen und Analyse-Reports auf einen Blick verständlich zu machen. Ich liebe Visualisierungen, weil sie eine ganze Geschichte auf einem Screen erzählen können – je nach Datenkomplexität. Wenn du dieses Tutorial liest, kennst du wahrscheinlich das R-Paket Ggplot2, das großartige Analyse-Charts erzeugt, aber bei dynamischen Eigenschaften etwas zurückfällt.
Zurück zu Highcharter: Es ist ein R-Wrapper für die JavaScript-Bibliothek Highcharts inklusive ihrer Module.
Die wichtigsten Features dieses Pakets sind:
Legen wir los und bauen Visualisierungen mit Highcharter basierend auf den oben genannten Features:
hchart ist eine generische Funktion, die ein Objekt übernimmt und ein Highcharter-Objekt zurückgibt. Es gibt Funktionen mit ähnlichem Verhalten wie im ggplot2-Paket:
qplot.geom_S.aes.Wählen wir ein Dataset. Ich nehme das Pokemon-Dataset, das ebenfalls im Highcharter-Paket enthalten ist. Wirf einen Blick darauf.
glimpse(pokemon)## Observations: 718
## Variables: 20
## $ id <dbl> 1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14,...
## $ pokemon <chr> "bulbasaur", "ivysaur", "venusaur", "charmande...
## $ species_id <int> 1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14,...
## $ height <int> 7, 10, 20, 6, 11, 17, 5, 10, 16, 3, 7, 11, 3, ...
## $ weight <int> 69, 130, 1000, 85, 190, 905, 90, 225, 855, 29,...
## $ base_experience <int> 64, 142, 236, 62, 142, 240, 63, 142, 239, 39, ...
## $ type_1 <chr> "grass", "grass", "grass", "fire", "fire", "fi...
## $ type_2 <chr> "poison", "poison", "poison", NA, NA, "flying"...
## $ attack <int> 49, 62, 82, 52, 64, 84, 48, 63, 83, 30, 20, 45...
## $ defense <int> 49, 63, 83, 43, 58, 78, 65, 80, 100, 35, 55, 5...
## $ hp <int> 45, 60, 80, 39, 58, 78, 44, 59, 79, 45, 50, 60...
## $ special_attack <int> 65, 80, 100, 60, 80, 109, 50, 65, 85, 20, 25, ...
## $ special_defense <int> 65, 80, 100, 50, 65, 85, 64, 80, 105, 20, 25, ...
## $ speed <int> 45, 60, 80, 65, 80, 100, 43, 58, 78, 45, 30, 7...
## $ color_1 <chr> "#78C850", "#78C850", "#78C850", "#F08030", "#...
## $ color_2 <chr> "#A040A0", "#A040A0", "#A040A0", NA, NA, "#A89...
## $ color_f <chr> "#81A763", "#81A763", "#81A763", "#F08030", "#...
## $ egg_group_1 <chr> "monster", "monster", "monster", "monster", "m...
## $ egg_group_2 <chr> "plant", "plant", "plant", "dragon", "dragon",...
## $ url_image <chr> "1.png", "2.png", "3.png", "4.png", "5.png", "...Lass uns ein Balkendiagramm zeichnen.
pokemon%>%
  count(type_1)%>%
  arrange(n)%>%
  hchart(type = "bar", hcaes(x = type_1, y = n))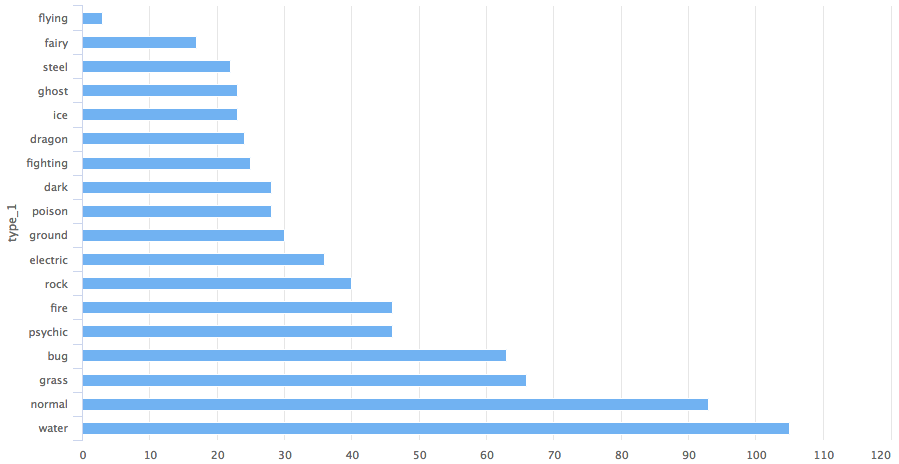
Du erhältst damit ein Balkendiagramm zur Kategorie type_1 der Pokemon.
Wenn du stattdessen ein Säulendiagramm möchtest, musst du nur den Typ auf column ändern.
pokemon%>%
  count(type_1)%>%
  arrange(n)%>%
  hchart(type = "column", hcaes(x = type_1, y = n))
pokemon%>%
  count(type_1)%>%
  arrange(n)%>%
  hchart(type = "treemap", hcaes(x = type_1, value = n, color = n))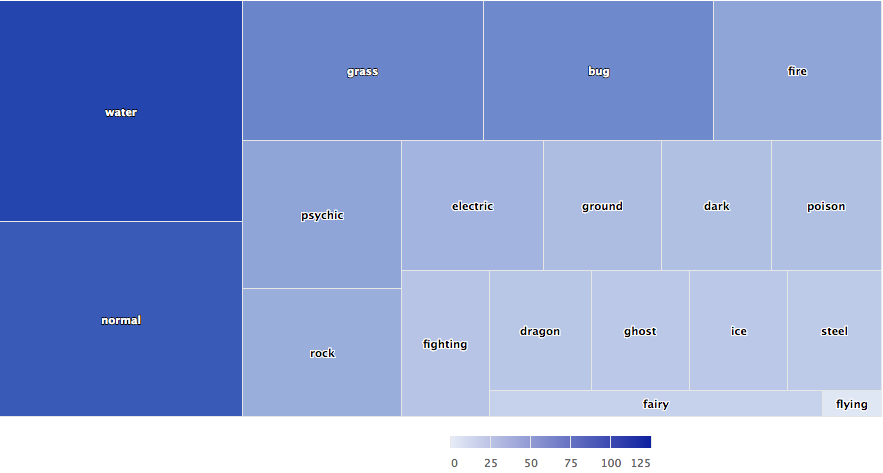
Wir können auch hc_add_series nutzen, um ein Diagramm zu zeichnen. Damit fügst du Reihen zu einem Highchart-Objekt hinzu oder entfernst sie.

highchart()%>%
  hc_add_series(pokemon, "scatter", hcaes(x = height, y = weight))
Der Hauptunterschied zwischen den geom_-Funktionen in ggplot2 und hc_add_series ist, dass wir bei Highcharter in jeder Funktion Daten und Ästhetik explizit angeben müssen. In ggplot2 kannst du Daten und Ästhetik einmal in einer Ebene setzen und weitere Geoms darauf aufbauen lassen.
Ein passendes Beispiel siehst du unten mit dem diamond-Dataset aus dem ggplot2-Paket.
data(diamonds, package = "ggplot2")

set.seed(123)
data <- sample_n(diamonds, 300)

modlss <- loess(price ~ carat, data = data)
fit <- arrange(augment(modlss), carat)

highchart() %>%
  hc_add_series(data, type = "scatter",
                hcaes(x = carat, y = price, size = depth, group = cut)) %>%
  hc_add_series(fit, type = "line", hcaes(x = carat, y = .fitted),
                name = "Fit", id = "fit") %>%
  hc_add_series(fit, type = "arearange",
                hcaes(x = carat, low = .fitted - 2*.se.fit,
                      high = .fitted + 2*.se.fit),
                linkedTo = "fit")
Wie im Beispiel zu sehen, besteht der Plot aus drei Reihen: Scatterplot, Linie und Bereichsband.
Replizieren wir nun eine Highcharts-JavaScript-Entwicklung in R mit hc_add_series.
highchart() %>%
  hc_chart(type = "area") %>%
  hc_title(text = "Historic and Estimated Worldwide Population Distribution by Region") %>%
  hc_subtitle(text = "Source: Wikipedia.org") %>%
  hc_xAxis(categories = c("1750", "1800", "1850", "1900", "1950", "1999", "2050"),
           tickmarkPlacement = "on",
           title = list(enabled = FALSE)) %>%
  hc_yAxis(title = list(text = "Percent")) %>%
  hc_tooltip(pointFormat = "<span style=\"color:{series.color}\">{series.name}</span>:
             <b>{point.percentage:.1f}%</b> ({point.y:,.0f} millions)<br/>",
             shared = TRUE) %>%
  hc_plotOptions(area = list(
     stacking = "percent",
     lineColor = "#ffffff",
     lineWidth = 1,
     marker = list(
       lineWidth = 1,
       lineColor = "#ffffff"
       ))
     ) %>%
  hc_add_series(name = "Asia", data = c(502, 635, 809, 947, 1402, 3634, 5268)) %>%
  hc_add_series(name = "Africa", data = c(106, 107, 111, 133, 221, 767, 1766)) %>%
  hc_add_series(name = "Europe", data = c(163, 203, 276, 408, 547, 729, 628)) %>%
  hc_add_series(name = "America", data = c(18, 31, 54, 156, 339, 818, 1201)) %>%
  hc_add_series(name = "Oceania", data = c(2, 2, 2, 6, 13, 30, 46))
Im Vergleich siehst du, wie sich jeder JavaScript-Block in verkettete R-Funktionen übersetzen lässt. Spannend ist etwa hctooltip mit pointFormat, das im gleichen Format wie im JavaScript-Code verwendet wird. Details findest du hier.
Highstocks sind Charts für Finanz- und Zeitreihenanalysen. Sie funktionieren gut mit der quamtmod-Bibliothek, und es ist leicht, Symbole zu plotten und per hc_add_series weitere Reihen hinzuzufügen.
x <- getSymbols("GOOG", auto.assign = FALSE)

hchart(x)
Wie im Chart zu sehen, müssen wir keinen zusätzlichen Code schreiben. hchart arbeitet sehr effizient mit dem xts-Objekt und liefert einen dynamischen Schnappschuss der Daten. Mit der Zoom-Funktion kannst du Daten für eine detailliertere Analyse in kleinere Abschnitte aufteilen.
Nutzen wir hc_add_series.
y <- getSymbols("AMZN", auto.assign = FALSE)

highchart(type = "stock") %>%
  hc_add_series(x) %>%
  hc_add_series(y, type = "ohlc")
Wie du siehst, passt sich die Visualisierung auch großen Datenmengen sehr effizient an.
Probier Stocks mit unterschiedlichen xts-Objekten aus.
Am einfachsten erstellst du eine Karte mit Highcharter über die Funktion hcmap. Wähle eine URL aus der Highmaps-Sammlung und nutze diese URL als Map in der hcmap-Funktion. Die Karte wird heruntergeladen und als Objekt im Argument mapdata verfügbar gemacht.
Zeichnen wir die Karte von Indien.
hcmap("https://code.highcharts.com/mapdata/countries/in/in-all.js")%>%
  hc_title(text = "India")
Das ist eine schlichte Karte. Wie machen wir daraus Choroplethen?
Jede Karte aus der Highcharts-Map-Sammlung enthält Schlüssel zum Joinen von Daten. Zwei Funktionen helfen dir, die Regionen und Join-Keys zu verstehen:
mapdata <- get_data_from_map(download_map_data("https://code.highcharts.com/mapdata/countries/in/in-all.js"))

glimpse(mapdata)
## Observations: 34
## Variables: 20
## $ `hc-group` <chr> "admin1", "admin1", "admin1", "admin1", "admin1"...
## $ `hc-middle-x` <dbl> 0.65, 0.59, 0.50, 0.56, 0.46, 0.46, 0.51, 0.59, ...
## $ `hc-middle-y` <dbl> 0.81, 0.63, 0.74, 0.38, 0.64, 0.51, 0.34, 0.41, ...
## $ `hc-key` <chr> "in-py", "in-ld", "in-wb", "in-or", "in-br", "in...
## $ `hc-a2` <chr> "PY", "LD", "WB", "OR", "BR", "SK", "CT", "TN", ...
## $ labelrank <chr> "2", "2", "2", "2", "2", "2", "2", "2", "2", "2"...
## $ hasc <chr> "IN.PY", "IN.LD", "IN.WB", "IN.OR", "IN.BR", "IN...
## $ `alt-name` <chr> "Pondicherry|Puduchcheri|Pondichéry", "Ã\u008dl...
## $ `woe-id` <chr> "20070459", "2345748", "2345761", "2345755", "23...
## $ fips <chr> "IN22", "IN14", "IN28", "IN21", "IN34", "IN29", ...
## $ `postal-code` <chr> "PY", "LD", "WB", "OR", "BR", "SK", "CT", "TN", ...
## $ name <chr> "Puducherry", "Lakshadweep", "West Bengal", "Ori...
## $ country <chr> "India", "India", "India", "India", "India", "In...
## $ `type-en` <chr> "Union Territory", "Union Territory", "State", "...
## $ region <chr> "South", "South", "East", "East", "East", "East"...
## $ longitude <chr> "79.7758", "72.7811", "87.7289", "84.4341", "85....
## $ `woe-name` <chr> "Puducherry", "Lakshadweep", "West Bengal", "Ori...
## $ latitude <chr> "10.9224", "11.2249", "23.0523", "20.625", "25.6...
## $ `woe-label` <chr> "Puducherry, IN, India", "Lakshadweep, IN, India...
## $ type <chr> "Union Territor", "Union Territor", "State", "St...#population state wise
pop = as.data.frame(c(84673556, 1382611, 31169272, 103804637, 1055450, 25540196, 342853, 242911, 18980000, 1457723, 60383628, 25353081, 6864602,
12548926, 32966238, 61130704, 33387677, 64429, 72597565, 112372972, 2721756, 2964007, 1091014, 1980602, 41947358, 1244464,
27704236, 68621012, 607688, 72138958, 3671032, 207281477, 10116752,91347736))
state= mapdata%>%
select(`hc-a2`)%>%
arrange(`hc-a2`)
State_pop = as.data.frame(c(state, pop))
names(State_pop)= c("State", "Population")
hcmap("https://code.highcharts.com/mapdata/countries/in/in-all.js", data = State_pop, value = "Population",
joinBy = c("hc-a2", "State"), name = "Fake data",
dataLabels = list(enabled = TRUE, format = '{point.name}'),
borderColor = "#FAFAFA", borderWidth = 0.1,
tooltip = list(valueDecimals = 0))
Probiere mit hc_add_series in Karten und Choroplethen eigene Varianten aus. Details und Beispiele findest du hier.
Jetzt testen wir ein paar Plug-ins von Highcharter wie Gruppierung, Drilldowns, Download/Export, Druck und ein paar starke Themes.
Gruppieren wir die Daten des mpg-Datasets. Für eine bessere Visualisierung erstellen wir eine Liste, die die Daten nach Hersteller gruppiert.
data(mpg, package = "ggplot2")

mpgg <- mpg %>%
  filter(class %in% c("suv", "compact", "midsize")) %>%
  group_by(class, manufacturer) %>%
  summarize(count = n())

categories_grouped <- mpgg %>%
  group_by(name = class) %>%
  do(categories = .$manufacturer) %>%
  list_parse()

highchart() %>%
  hc_xAxis(categories = categories_grouped) %>%
  hc_add_series(data = mpgg, type = "bar", hcaes(y = count, color = manufacturer),
                showInLegend = FALSE)
Erstellen wir ein Chart mit Drilldown in ein weiteres Chart für eine tiefere Analyse. Der Code ist leichter nachzuvollziehen, wenn du dich mit Listen in R auskennst.
df <- data_frame(
  name = c("Animals", "Fruits", "Cars"),
  y = c(5, 2, 4),
  drilldown = tolower(name)
)


ds <- list_parse(df)
names(ds) <- NULL


hc <- highchart() %>%
  hc_chart(type = "column") %>%
  hc_title(text = "Basic drilldown") %>%
  hc_xAxis(type = "category") %>%
  hc_legend(enabled = FALSE) %>%
  hc_plotOptions(
    series = list(
      boderWidth = 0,
      dataLabels = list(enabled = TRUE)
    )
  ) %>%
  hc_add_series(
    name = "Things",
    colorByPoint = TRUE,
    data = ds
  )

dfan <- data_frame(
  name = c("Cats", "Dogs", "Cows", "Sheep", "Pigs"),
  value = c(4, 3, 1, 2, 1)
)

dffru <- data_frame(
  name = c("Apple", "Organes"),
  value = c(4, 2)
)

dfcar <- data_frame(
  name = c("Toyota", "Opel", "Volkswage"),
  value = c(4, 2, 2)
)

second_el_to_numeric <- function(ls){

  map(ls, function(x){
    x[[2]] <- as.numeric(x[[2]])
    x
  })

}

dsan <- second_el_to_numeric(list_parse2(dfan))

dsfru <- second_el_to_numeric(list_parse2(dffru))

dscar <- second_el_to_numeric(list_parse2(dfcar))

hc %>%
  hc_drilldown(
    allowPointDrilldown = TRUE,
    series = list(
      list(
        id = "animals",
        data = dsan
      ),
      list(
        id = "fruits",
        data = dsfru
      ),
      list(
        id = "cars",
        data = dscar
      )
    )
  )
Wenden wir Drilldown auch auf andere Charts an.
tm <- pokemon %>%
  mutate(type_2 = ifelse(is.na(type_2), paste("only", type_1), type_2),
         type_1 = type_1) %>%
  group_by(type_1, type_2) %>%
  summarise(n = n()) %>%
  ungroup() %>%
  treemap::treemap(index = c("type_1", "type_2"),
                   vSize = "n", vColor = "type_1")
tm$tm <- tm$tm %>%
  tbl_df() %>%
  left_join(pokemon %>% select(type_1, type_2, color_f) %>% distinct(), by = c("type_1", "type_2")) %>%
  left_join(pokemon %>% select(type_1, color_1) %>% distinct(), by = c("type_1")) %>%
  mutate(type_1 = paste0("Main ", type_1),
         color = ifelse(is.na(color_f), color_1, color_f))

highchart() %>%
  hc_add_series_treemap(tm, allowDrillToNode = TRUE,
                        layoutAlgorithm = "squarified")
Fügen wir noch die Exportfunktion hinzu.
pokemon%>%
count(type_1)%>%
arrange(n)%>%
hchart(type = "bar", hcaes(x = type_1, y = n, color = type_1))%>%
hc_exporting(enabled = TRUE) Am Ende setzen wir noch ein Theme auf.
pokemon%>%
  count(type_1)%>%
  arrange(n)%>%
  hchart(type = "bar", hcaes(x = type_1, y = n, color = type_1))%>%
  hc_exporting(enabled = TRUE)%>%
hc_add_theme(hc_theme_chalk())
Du kannst viel aus dieser Quelle lernen. Es ist eine vollständige Bibliothek zu Highcharter. Außerdem teile ich einen meiner Lieblingsplots auf Basis eines Wetter-Datasets. Ein spannendes Argument ist hier polar: Wenn es auf TRUE gesetzt ist, verändert sich die gesamte Darstellung.
data("weather")

x <- c("Min", "Mean", "Max")
y <- sprintf("{point.%s}", c("min_temperaturec", "mean_temperaturec", "max_temperaturec"))
tltip <- tooltip_table(x, y)

hchart(weather, type = "columnrange",
       hcaes(x = date, low = min_temperaturec, high = max_temperaturec,
             color = mean_temperaturec)) %>%
  hc_chart(polar = TRUE) %>%
  hc_yAxis( max = 30, min = -10, labels = list(format = "{value} C"),
            showFirstLabel = FALSE) %>%
  hc_xAxis(
    title = list(text = ""), gridLineWidth = 0.5,
    labels = list(format = "{value: %b}")) %>%
  hc_tooltip(useHTML = TRUE, pointFormat = tltip,
             headerFormat = as.character(tags$small("{point.x:%d %B, %Y}")))
Wenn du mehr über Datenvisualisierung in R lernen möchtest, besuche DataCamps Kurs Data Visualization with ggplot2 (Part 1) und schau dir unser R Formula Tutorial an.
Erfahre mehr über R und Datenvisualisierung
Kurs
Kurs
Kurs