
{count, plural, one {Kurs} other {Kurse}}
Machine Learning verstehen
{hours} Std.
312.2K
Du hast ein Modell trainiert, das auf den Trainingsdaten fast perfekte Ergebnisse liefert, aber bei neuen Daten versagt? Das kennen wir alle.
Das ist die Kurzdefinition von Overfitting. Dein Modell hat nicht das eigentliche Muster gelernt, sondern die Trainingsdaten auswendig gelernt. In Produktion mit neuen, unbekannten Daten würdest du den Vorhersagen nicht trauen. Je stärker reale Daten von den Trainingsbeispielen abweichen, desto schlimmer wird es.
Regularisierung behebt das, indem sie der Verlustfunktion eine Strafkomponente hinzufügt. Diese Strafe hält komplexe Modelle in Schach. Anders gesagt: Regularisierung verhindert, dass dein Modell jeden einzelnen Datenpunkt perfekt anpasst, und zwingt es stattdessen zur Generalisierung.
In diesem Artikel führe ich dich durch die Intuition hinter der Regularisierung, die gängigsten Methoden – L1, L2 und Elastic Net – und wie du die richtige Wahl für deinen Anwendungsfall triffst.
Wenn du verstehen willst, warum und wie Machine-Learning-Modelle in Produktion scheitern, lies unseren Artikel zum Bias-Variance-Trade-off.
Regularisierung fügt der Verlustfunktion deines Modells einen Strafterm hinzu, um Komplexität zu begrenzen.
Ohne diesen Strafterm ist ein Modell so flexibel, wie es will, und passt sich den Trainingsdaten bis ins Detail an – inklusive Rauschen und Ausreißern. Regularisierung belegt diese Flexibilität mit Kosten. Je komplexer das Modell sein will, desto höher die Strafe.
Die Verlustfunktion deines Modells misst normalerweise den Unterschied zwischen vorhergesagten und tatsächlichen Werten. Regularisierung fügt dieser Gleichung einen zusätzlichen Term hinzu, der wächst, wenn die Koeffizienten des Modells wachsen. Das Modell muss nun zwei Ziele ausbalancieren: die Trainingsdaten gut anpassen und die Koeffizienten klein halten.
Dieses Gleichgewicht steuert die Modellflexibilität.
Ein sehr flexibles Modell kann sich in jede Form biegen, um die Trainingsdaten zu treffen. Regularisierung glättet es zurück zu einer einfacheren Form – einer, die auf unbekannten Daten eher Bestand hat.
Jedes Modell liegt irgendwo zwischen zwei unbrauchbaren Extremen: zu einfach und zu komplex.
Ein zu einfaches Modell erkennt die echten Muster in deinen Daten nicht. Es verfehlt das Signal. Das ist Underfitting – das Modell ist sowohl auf Trainingsdaten als auch auf neuen Daten schwach.
Ein zu komplexes Modell macht das Gegenteil. Es passt jedes Detail der Trainingsdaten, inklusive Rauschen. Das ist Overfitting – auf Trainingsdaten top, auf neuen Daten flop, weil es das Falsche auswendig gelernt hat.
Polynomregression ist ein greifbares Beispiel. Ein Polynom dritten Grades, das eine sanfte Kurve in den Daten beschreibt, trifft meist das richtige Muster. Ein Polynom 15. Grades durch dieselben Daten führt zum Overfitting – die Kurve geht durch jeden Punkt, macht dazwischen aber zufällige Vorhersagen.
Das Diagramm unten zeigt, wie das in der Praxis aussieht.
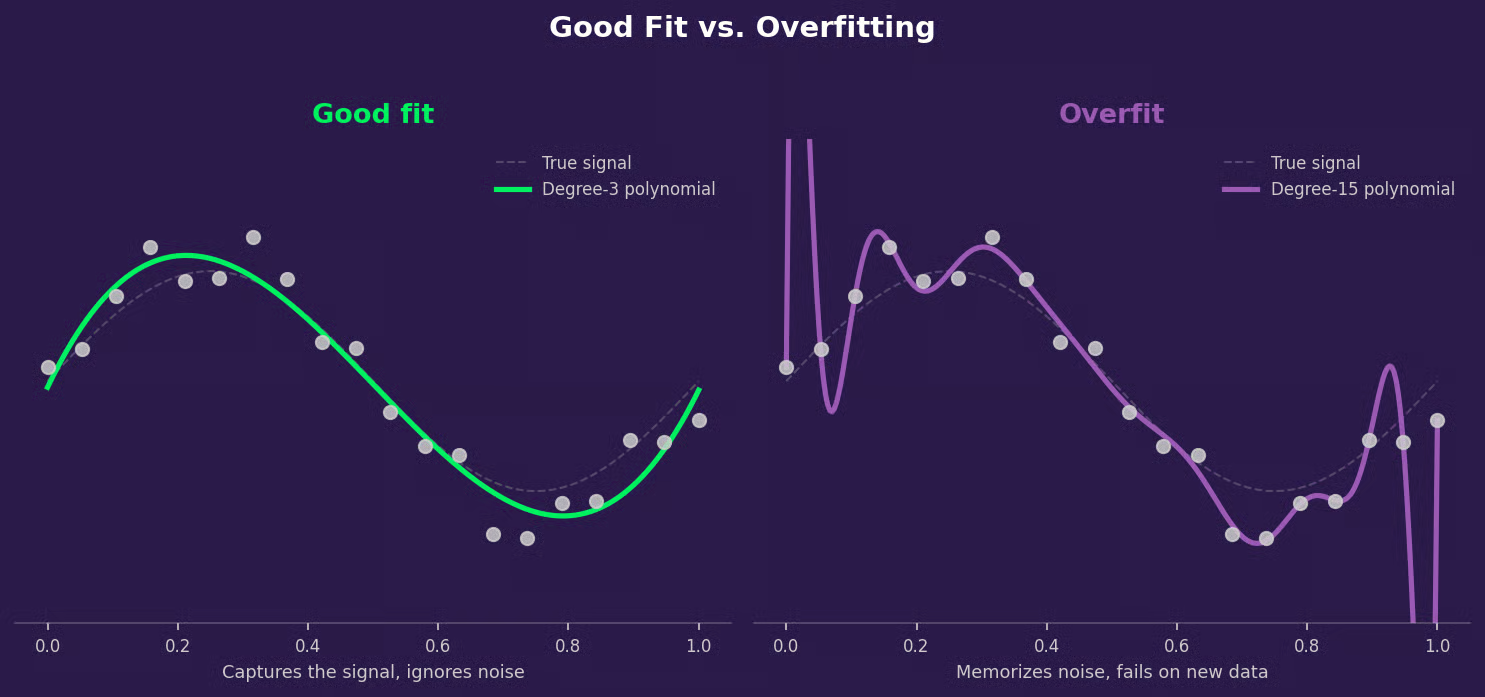
Genau richtig vs. zu komplexes Modell
Das ist der Bias-Variance-Trade-off.
Einfache Modelle haben hohen Bias – sie machen starke Annahmen und übersehen echte Muster. Komplexe Modelle haben hohe Varianz – sie reagieren zu empfindlich auf die konkreten Trainingsbeispiele, kleine Datenänderungen führen zu sehr unterschiedlichen Modellen.
Regularisierung hilft dir, das Beste aus beidem zu bekommen. Sie eliminiert Komplexität nicht, aber bestraft sie. So hat dein Modell bessere Chancen, das tatsächliche Signal zu lernen.
Jedes Modell lernt, indem es eine Verlustfunktion minimiert – also misst, wie falsch seine Vorhersagen sind. Ohne Regularisierung ist die einzige Aufgabe, diesen Fehler zu minimieren. Dafür nimmt es auch große Koeffizienten in Kauf, die die Trainingsdaten gut treffen, aber nicht verallgemeinern.
Regularisierung ändert das Ziel. Statt nur den Fehler zu minimieren, minimiert das Modell nun Folgendes:
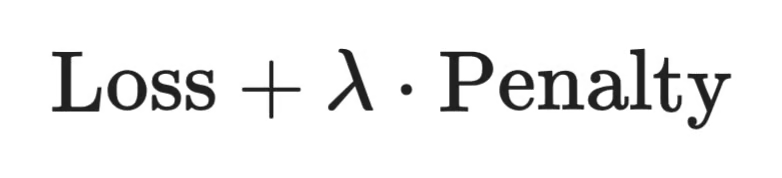
So funktioniert Regularisierung
Der Strafterm ist eine Funktion der Modellkoeffizienten. Große Koeffizienten erhöhen die Strafe. Um die Gesamtkosten niedrig zu halten, muss das Modell seine Koeffizienten klein halten – das führt zu einfacheren, besser generalisierbaren Lösungen.
Das λ (Lambda) steuert, wie stark die Strafe ins Gewicht fällt. Ein höheres λ erhöht den Druck, einfach zu bleiben. Ein niedrigeres λ erlaubt dem Modell, sich stärker auf das Fitten der Daten zu konzentrieren. Wie du das einstellst, siehst du unten im Abschnitt zur Wahl der Regularisierungsstärke.
Es gibt mehrere Wege, Modellkomplexität zu bestrafen. Jede Methode setzt die Koeffizienten anders unter Druck und eignet sich daher für unterschiedliche Situationen.
L2-Regularisierung bestraft das Quadrat jedes Koeffizienten. Je größer ein Koeffizient, desto stärker trägt er zur Strafe bei – und desto mehr versucht das Modell, ihn zu verkleinern.
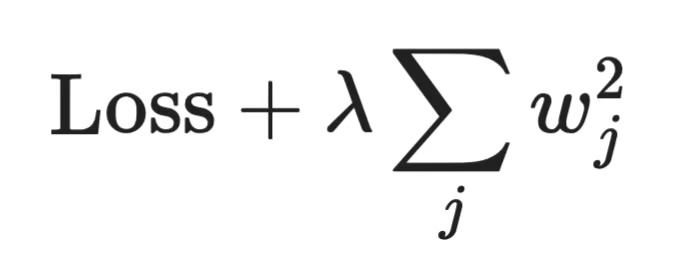
L2-Regularisierung
Das Stichwort ist verkleinern. L2 drückt alle Koeffizienten in Richtung Null, erreicht aber nie exakt Null. Jedes Feature bleibt im Modell, nur mit geringerem Gewicht. Deshalb ist Ridge ein guter Standard, wenn du glaubst, dass die meisten Features relevant sind und du ein stabiles, gutmütiges Modell willst.
L1-Regularisierung bestraft den Absolutwert jedes Koeffizienten statt seines Quadrats.
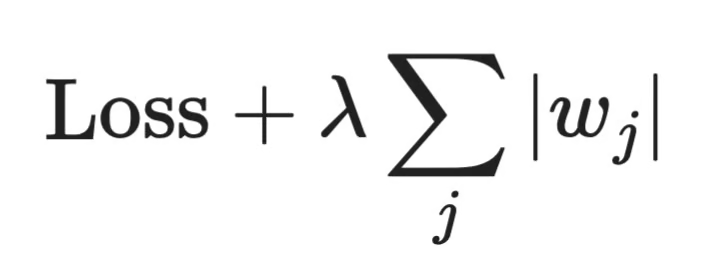
L1-Regularisierung
Dieser kleine Unterschied hat große Folgen. L1 kann Koeffizienten exakt auf Null setzen – Features fliegen damit aus dem Modell. Das ist im Grunde automatische Feature-Auswahl. Mit Lasso kannst du dein Modell also vereinfachen, indem du irrelevante Features entfernst.
Der zentrale Unterschied ist die Sparsität. L1 erzeugt sparsame Modelle – nur ein Teil der Features bleibt aktiv. L2 erzeugt dichte Modelle – alle Features bleiben drin, aber mit kleineren Gewichten.
Das beeinflusst auch die Interpretierbarkeit. Ein Lasso-Modell mit 5 aktiven Features ist leichter zu erklären als ein Ridge-Modell mit 50 Features, die alle ein bisschen beitragen. Ridge ist dafür stabiler, wenn Features miteinander korrelieren, weil es das Gewicht verteilt, statt willkürlich eines auszuwählen.
Hier ist eine schnelle Übersicht über die Unterschiede:
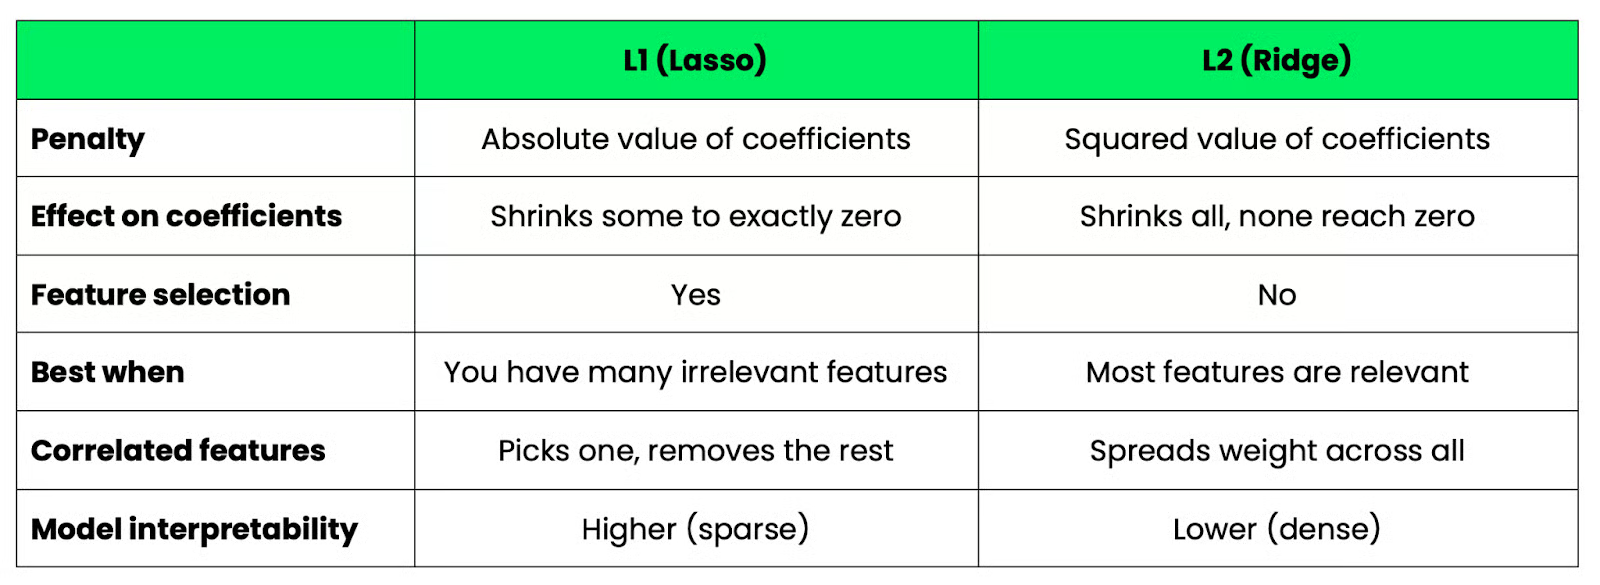
L1 versus L2-Regularisierung
Wenn du den Vergleich in Python sehen willst, hilft dir unser Tutorial zu Lasso- und Ridge-Regression in Python weiter.
Elastic Net kombiniert L1 und L2 in einem einzigen Strafterm.
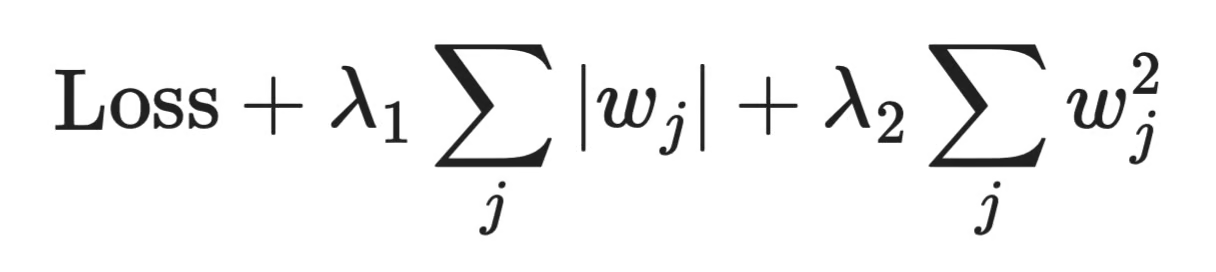
Elastic-Net-Regularisierung
Die Idee: das Beste aus beiden Welten – Feature-Auswahl von L1 und Stabilität von L2. Das ist nützlich, wenn du korrelierte Features hast und trotzdem einige davon aussortieren willst. Lasso allein wählt oft ein Feature aus einer korrelierten Gruppe und ignoriert den Rest. Elastic Net behält eher einige davon und entfernt trotzdem irrelevante.
Regularisierung taucht in vielen Machine-Learning-Modellen auf – aber in unterschiedlicher Form. Hier sind die wichtigsten.
Lineare Regression ist oft die erste Begegnung. Mit L2-Regularisierung wird daraus Ridge-Regression. Mit L1 entsprechend Lasso-Regression. Mathematisch wie oben: ein Strafterm zur kleinsten-Quadrate-Verlustfunktion.
Logistische Regression funktioniert genauso. Die Verlustfunktion ist eine andere – Kreuzentropie statt quadratischer Fehler – aber der Strafterm ist identisch. Viele ML-Bibliotheken wenden standardmäßig L2 auf logistische Regression an, daher der Parameter C in scikit-learn. Er ist der Kehrwert von λ; ein kleineres C bedeutet stärkere Regularisierung.
Neuronale Netze nutzen mehrere Ansätze:
Beides reduziert Overfitting, aber auf unterschiedlichen Wegen.
Baumbasierte Modelle arbeiten nicht mit Straftermen. Sie steuern Komplexität über Pruning – also über die maximale Tiefe oder indem sie Zweige entfernen, die den Nutzen nicht rechtfertigen. Hyperparameter wie max_depth und min_samples_split in scikit-learn sind Regularisierungsparameter, auch wenn sie nicht so heißen.
Regularisierung ist immer ein Kompromiss.
Wenn du einen Strafterm hinzufügst, schränkst du das Modell ein. Es kann die Trainingsdaten nicht mehr so eng fitten, wie es will. Diese Einschränkung führt zu Bias – das Modell macht bewusst leicht falsche Annahmen, weil du es auf Einfachheit trimmst.
Gleichzeitig sinkt die Varianz. Ein Modell, das nicht jeden Datenpunkt perfekt fitten kann, reagiert weniger empfindlich auf die konkreten Trainingsstichproben. Trainierst du es auf leicht anderen Daten, erhältst du ein ähnliches Ergebnis. Diese Stabilität willst du, damit dein Modell in Produktion nicht scheitert.
Ohne Regularisierung bekommst du ein sehr flexibles Modell mit niedrigem Bias (wenige Annahmen, gute Anpassung an Trainingsdaten) und hoher Varianz (kleine Änderungen in den Trainingsdaten erzeugen sehr unterschiedliche Modelle – auf neuen Daten unzuverlässig).
Regularisierung verschiebt das Gleichgewicht. Etwas mehr Bias gegen deutlich weniger Varianz führt meist zu besserer Leistung auf unbekannten Daten. Dieser Tausch lohnt sich fast immer.
Als Machine-Learning-Praktikerin oder -Praktiker legst du nach der Wahl der Methode die Stärke der Regularisierung fest.
Diese Stärke wird von einem Hyperparameter gesteuert – in der Mathematik meist Lambda (λ) genannt oder alpha in scikit-learn. Er multipliziert den Strafterm. Wenn du ihn änderst, änderst du, wie stark das Modell zur Einfachheit gedrängt wird.
Wenn du in die falsche Richtung übertreibst, bekommst du Probleme in Produktion:
Der richtige Wert liegt dazwischen, und es gibt keine Universallösung. Er hängt von deinen Daten, deinem Modell und dem Rauschanteil ab.
Der Standardweg ist Cross-Validation. Du teilst die Trainingsdaten in Folds, trainierst das Modell auf verschiedenen Fold-Kombinationen und misst die Validierungsleistung über einen Bereich von alpha-Werten. Den Wert mit dem besten durchschnittlichen Validierungsscore verwendest du.
In scikit-learn können RidgeCV und LassoCV das automatisch – sie führen Cross-Validation über ein Gitter von alpha-Werten durch und wählen den besten für dich aus.
from sklearn.linear_model import RidgeCV

model = RidgeCV(alphas=[0.01, 0.1, 1.0, 10.0], cv=5)
model.fit(X_train, y_train)

print(model.alpha_)
Das ausgegebene Alpha zeigt dir den per Cross-Validation besten Wert. Starte mit einem breiten Bereich und verfeinere ihn, sobald du die optimale Größenordnung kennst.
Regularisierung sorgt dafür, dass ein Modell nicht zu „clever“ für den Praxiseinsatz wird.
Sie bestraft Komplexität und zwingt das Modell, Lösungen zu finden, die generalisieren statt bloß Trainingsdaten auswendig zu lernen. L2 behält alle Features bei und senkt deren Einfluss. L1 entfernt irrelevante Features. Elastic Net kombiniert beides. Und über lineare Modelle, logistische Regression, neuronale Netze und Ensemble-Modelle hinweg begegnet dir dieselbe Idee in verschiedenen Formen – sie heißt nicht immer „Regularisierung“.
Am wichtigsten sind die gewählte Technik und die eingestellte Stärke. Also: Experimentiere. Probiere verschiedene Ansätze mit unterschiedlichen Parametern. Triff keine Einmalentscheidung.
Deine Daten zeigen dir, was funktioniert.
Wenn du mehr Regularisierungstechniken in Aktion sehen willst, melde dich für unseren Machine Learning Scientist in Python-Lernpfad an. Er bietet 85 Stunden Material und macht dich fit für den Job.
Lerne mit DataCamp
{count, plural, one {Kurs} other {Kurse}}
{count, plural, one {Kurs} other {Kurse}}
{count, plural, one {Kurs} other {Kurse}}