Kurs
Einführung in Python
4 Std.
7M
Als intensiver DataCamp-Nutzer seit zwei Jahren habe ich eine Menge gelernt. Mein Hauptgeschäft ist Online‑Marketing, und von meinen Data‑Science‑Kompetenzen profitiere ich enorm. Heute kann ich viel größere und komplexere Kampagnen steuern und effizient pflegen. Da ich mit den Inhalten, Themen und R‑Packages sowie Python inzwischen gut vertraut bin, habe ich mir als Übung überlegt, Suchkampagnen für DataCamp aufzusetzen.
In diesem Tutorial gehst du folgende Themen an:
SEM ist eine der wirksamsten Methoden, um in einem zunehmend wettbewerbsintensiven Markt zu wachsen. Dabei gewinnst du Website‑Traffic, indem du Anzeigen in Suchmaschinen buchst. Google AdWords ist eine der beliebtesten Formen von Online‑Werbung: Du bietest auf Anzeigenplätze in den gesponserten Links einer Suchmaschine für Keywords, die zu deinem Unternehmen passen, und zahlst der Suchmaschine eine Gebühr pro Klick.
Bezahlen pro Klick kann schnell ins Geld gehen. Umso wichtiger ist es, Keywords und Anzeigen so zu planen und zu clustern, dass du die Kosten im Griff behältst – und idealerweise profitabel wirst.
Wie genau der Klickpreis bestimmt wird, ist ein gut gehütetes Geheimnis und hängt von vielen Faktoren ab. Grundsätzlich gilt aber: Je relevanter deine Anzeigen, desto geringer die Kosten pro Klick.
Bevor du eine Kampagne aufsetzt, legst du in der Regel ein Budget fest, wählst Keywords und prüfst die Konkurrenz. Außerdem stellst du sicher, dass deine Landingpage stimmt. Danach kannst du die Kampagne konfigurieren: Du schreibst deine erste Anzeige, definierst die Details und richtest das Conversion‑Tracking ein. Dieses Tutorial konzentriert sich vor allem darauf, große Mengen an Keywords und Anzeigen basierend auf unseren verschiedenen Landingpages zu generieren.
Bevor es losgeht, schauen wir uns aber zuerst an, was Suchkampagnen genau sind.
Für eine Suchkampagne brauchst du zuerst einen Plan für deine Anzeigengruppen. Das ist die Basiseinheit, in der du Keywords, Anzeigen und Landingpages miteinander verknüpfst. Was genau sind diese drei Komponenten?
Diese drei Elemente sauber zuzuordnen, ist rund 70–80% der Arbeit. Wenn das sitzt, werden Pflege und Änderungen deutlich einfacher.
Heißt: Um für Nutzer spezifisch und relevant zu sein, musst du dein tatsächliches Produkt bewerben und vor allem die richtige Person mit der richtigen Botschaft auf die richtige Seite führen. Eine gute Kampagnenstruktur spiegelt die Struktur der Website wider – und damit letztlich die Geschäftsstrategie.
Hinweis: Jede Anzeigengruppe gehört zu einer Kampagne. Auf Kampagnenebene steuerst du Einstellungen für alle Anzeigengruppen, z. B. Sprache, Standort, Geräte, Tageszeit usw.
Vorhin hast du Suchkampagnen aus der Vogelperspektive betrachtet: Keywords, Anzeigen und Landingpages sind Teil einer Anzeigengruppe, und du brauchst einen Plan, wie diese drei Komponenten deine Geschäftsstrategie widerspiegeln. Jetzt tauchst du tiefer ein und fokussierst die Schritte, die du in diesem Tutorial durchläufst.
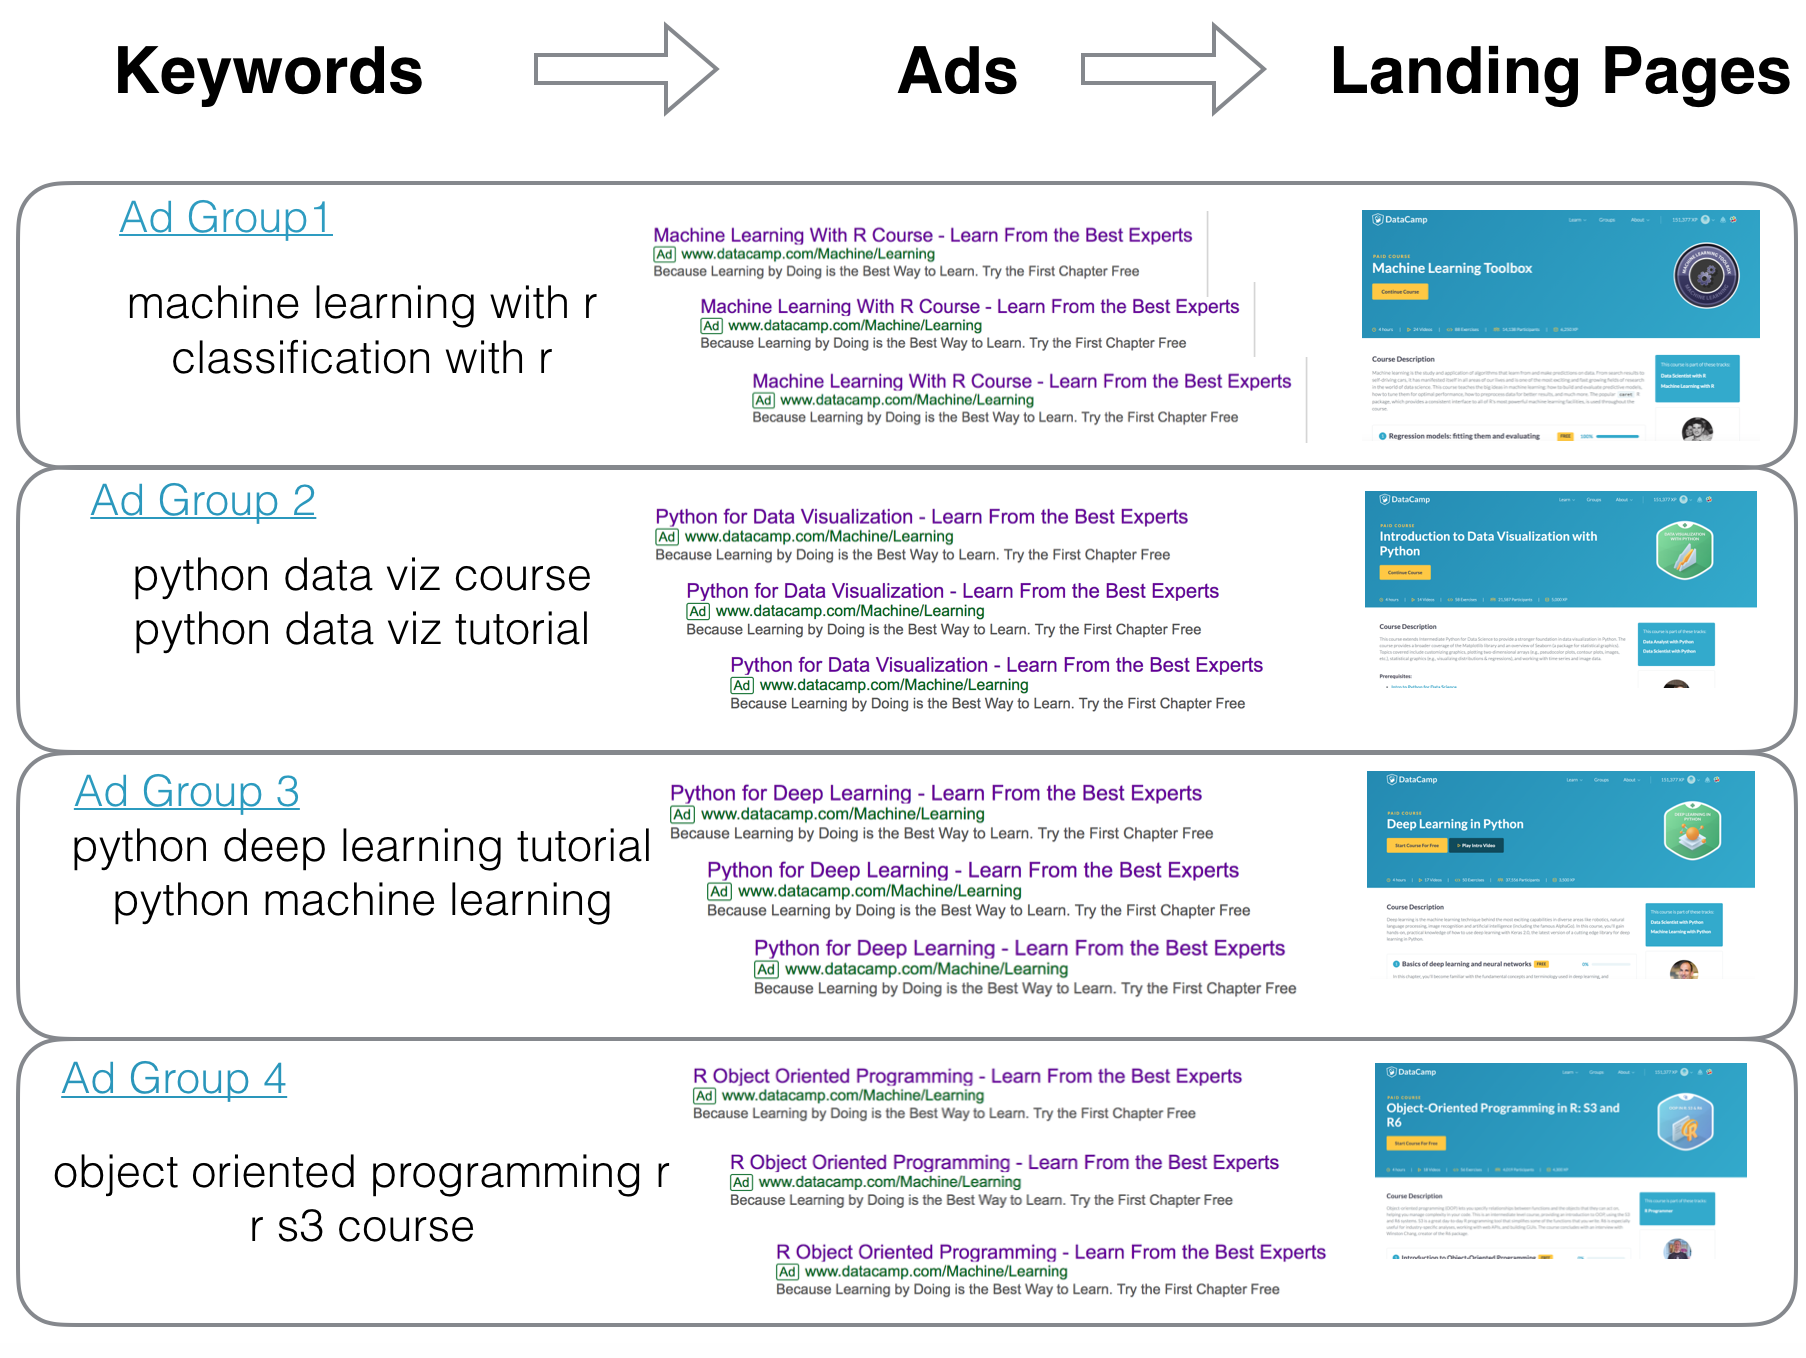
Wie oben gezeigt, ist das die Zuordnung, die du erreichen willst. Am Ende willst du zwei zentrale DataFrames haben: einen für Keywords und einen für Anzeigen. Unten siehst du, wie das aussehen kann.
| Campaign | Ad Group | Keyword |
|---|---|---|
| campaign 1 | adgroup 1 | keyword 1 |
| campaign 1 | adgroup 2 | keyword 2 |
| campaign 2 | adgroup 1 | keyword 3 |
| campaign 2 | adgroup 1 | keyword 4 |
| campaign 2 | adgroup 2 | keyword 5 |
| Campaign | Ad Group | Display URL | Final URL | Headline 1 | Headline 2 |
|---|---|---|---|---|---|
| campaign 1 | adgroup 1 | datacamp.com | datacamp.com/a | Headline 1 | Headline 1a |
| campaign 1 | adgroup 2 | datacamp.com | datacamp.com/b | Headline 1 | Headline 1a |
| campaign 2 | adgroup 1 | datacamp.com | datacamp.com/c | Headline 1 | Headline 1a |
| campaign 2 | adgroup 2 | datacamp.com | datacamp.com/d | Headline 2 | Headline 2a |
| campaign 2 | adgroup 3 | datacamp.com | datacamp.com/e | Headline 3 | Headline 1a |
Sind diese Tabellen fertig, kannst du sie als CSV‑Dateien (Comma‑separated Values) in Google AdWords oder andere, ähnlich funktionierende Plattformen hochladen. Google AdWords ist mit Abstand die beliebteste Paid‑Search‑Plattform – daneben gibt es Bing Ads, Yandex, Baidu und weitere.
Hinweis: Wenn du in andere Plattformen als Google AdWords oder Bing Ads importierst, sind meist kleine Anpassungen nötig.
Wie in der Einleitung beschrieben, willst du Suchkampagnen für DataCamp erstellen. Betrachtet man die unterschiedlichen Arten, wie jemand Interesse am Angebot – also an Data‑Science‑Weiterbildung – äußern kann, ergibt sich schnell eine erste Liste:
In diesem Tutorial überspringst du die klassische Keyword‑Recherchephase, denn du nutzt die Power der Programmiersprache, um alle möglichen Kombinationen zu generieren und direkt in passende Kampagnen und Anzeigengruppen zu clustern.
Dafür brauchst du vor allem zwei Dinge:
Starten wir mit der Generierung der Keywords.
Diese Kampagne zielt auf Personen, die nach Kursen bestimmter DataCamp‑Dozierender suchen.
Du kannst die Keywords auf „course by <instructor name>“ beschränken oder breiter nur auf den Namen des Instructors zielen. Zu Beginn ist es besser, die Namen in Kombination mit „course“ oder „courses“ zu targeten und die Wirkung zu testen.
Prüfe außerdem, ob einer der Namen auch eine andere berühmte Person bezeichnet oder sehr häufig ist. In solchen Fällen musst du die Keywords für diese Person stärker einschränken.
Du beginnst damit, die Namen der Dozierenden und die jeweiligen URLs zu erfassen:
import requests
from bs4 import BeautifulSoup


instructors_page = 'https://www.datacamp.com/instructors?all=true'
instructor_link_selector = '.instructor-block__description .instructor-block__link' # CSS class of the link
instructor_name_selector = '.mb-sm'  # CSS class of the name

instructor_resp = requests.get(instructors_page)
soup = BeautifulSoup(instructor_resp.text, 'lxml')

instructor_urls = [url['href'] for url in soup.select(instructor_link_selector)]
instructor_names = [name.text.strip() for name in soup.select(instructor_name_selector)]
instructor_urls = ['https://www.datacamp.com' + url for url in instructor_urls]
Packe alles in einen DataFrame für die spätere Verwendung. Die URLs brauchst du später für die Anzeigenerstellung.
instructor_df = pd.DataFrame({
    'name': instructor_names,
    'url': instructor_urls
})
print(instructor_df.shape)
instructor_df.head()
(72, 2)
| name | url | |
|---|---|---|
| 0 | Filip Schouwenaars | https://www.datacamp.com/instructors/filipsch |
| 1 | Jonathan Cornelissen | https://www.datacamp.com/instructors/jonathana... |
| 2 | Hugo Bowne-Anderson | https://www.datacamp.com/instructors/hugobowne |
| 3 | Greg Wilson | https://www.datacamp.com/instructors/greg48f64... |
| 4 | Nick Carchedi | https://www.datacamp.com/instructors/nickyc |
Nun kombinierst du jeden Namen mit einem Set themennaher Keywords – hier geht es vor allem um Kurse der jeweiligen Person.
Variablen im folgenden Code:
col_names: Headernamen der Tabelle, die du später zu Google AdWords hochlädst.words: Wörter, die du mit den Namen kombinierst, um vollständige Keywords/Phrasen zu erzeugen.match_types: Details findest du im AdWords‑Hilfecenter. Kurzfassung:
[data science course], "data science course" und data science course sind technisch drei unterschiedliche Keywords.
col_names = ['Campaign', 'Ad Group', 'Keyword', 'Criterion Type']
instructor_keywords = []

words = ['course', 'courses', 'learn', 'data science', 'data camp', 'datacamp']
match_types = ['Exact', 'Phrase', 'Broad']
for instructor in instructor_df['name']:
    for word in words:
        for match in match_types:
            if match == 'Broad':
                keyword = '+' + ' +'.join([instructor.replace(' ', ' +').lower(), word])  # modified broach match
            else:
                keyword = instructor.lower() + ' ' + word
            row = ['SEM_Instructors',  # campaign name
                   instructor,  # ad group name
                   keyword, # instructor <keyword>
                   match]  # keyword match type
            instructor_keywords.append(row)

# do the same by having the keywords come before the instructor name
for instructor in instructor_df['name']:
    for word in words:
        for match in match_types:
            if match == 'Broad':
                keyword = '+' + ' +'.join([word, instructor.replace(' ', ' +').lower()])
            else:
                keyword = word + ' ' + instructor.lower()
            row = ['SEM_Instructors',  # campaign name
                   instructor,  # ad group name
                   keyword, # <keyword> instructor
                   match]  # keyword match type
            instructor_keywords.append(row)


instructor_keywords_df = pd.DataFrame.from_records(instructor_keywords,
                                                   columns=col_names)
print('total keywords:', instructor_keywords_df.shape[0])
instructor_keywords_df.head()
total keywords: 2592
| Campaign | Ad Group | Keyword | Criterion Type | |
|---|---|---|---|---|
| 0 | SEM_Instructors | Filip Schouwenaars | filip schouwenaars course | Exact |
| 1 | SEM_Instructors | Filip Schouwenaars | filip schouwenaars course | Phrase |
| 2 | SEM_Instructors | Filip Schouwenaars | +filip +schouwenaars +course | Broad |
| 3 | SEM_Instructors | Filip Schouwenaars | filip schouwenaars courses | Exact |
| 4 | SEM_Instructors | Filip Schouwenaars | filip schouwenaars courses | Phrase |
Im Kern iterierst du über die Instruktornamen, alle Keywords und alle Match‑Typen, um sämtliche Kombinationen zu erzeugen. Das passiert zweimal: einmal im Muster „Instructor Name Keyword“ und einmal „Keyword Instructor Name“.
Jetzt wiederholst du das Prinzip für alle weiteren Segmente – mit kleinen Anpassungen bei Keywords und Datenerhebung.
Eine gute Faustregel aus R for Data Science: Wenn du etwas öfter als zweimal kopierst und einfügst, schreib eine Funktion.
def generate_keywords(topics, keywords, match_types=['Exact', 'Phrase', 'Broad'],
                     campaign='SEM_Campaign'):
    col_names = ['Campaign', 'Ad Group', 'Keyword', 'Criterion Type']
    campaign_keywords = []

    for topic in topics:
        for word in keywords:
            for match in match_types:
                if match == 'Broad':
                    keyword = '+' + ' +'.join([topic.lower().replace(' ', ' +'), word.replace(' ', ' +')])
                else:
                    keyword = topic.lower() + ' ' + word
                row = [campaign,  # campaign name
                       topic,  # ad group name
                       keyword, # instructor <keyword>
                       match]  # keyword match type
                campaign_keywords.append(row)

    # I said more than twice! :)
    for topic in topics:
        for word in keywords:
            for match in match_types:
                if match == 'Broad':
                    keyword = '+' + ' +'.join([word.replace(' ', ' +'), topic.lower().replace(' ', ' +')])
                else:
                    keyword = word + ' ' + topic.lower()
                row = [campaign,  # campaign name
                       topic,  # ad group name
                       keyword, # <keyword> instructor
                       match]  # keyword match type
                campaign_keywords.append(row)

    return pd.DataFrame.from_records(campaign_keywords, columns=col_names)
Probieren wir es aus:
topics = ['Data Science', 'Machine Learning']
keywords = ['course', 'tutorial']
generate_keywords(topics, keywords).head(10)
| Campaign | Ad Group | Keyword | Criterion Type | |
|---|---|---|---|---|
| 0 | SEM_Campaign | Data Science | data science course | Exact |
| 1 | SEM_Campaign | Data Science | data science course | Phrase |
| 2 | SEM_Campaign | Data Science | +data +science +course | Broad |
| 3 | SEM_Campaign | Data Science | data science tutorial | Exact |
| 4 | SEM_Campaign | Data Science | data science tutorial | Phrase |
| 5 | SEM_Campaign | Data Science | +data +science +tutorial | Broad |
| 6 | SEM_Campaign | Machine Learning | machine learning course | Exact |
| 7 | SEM_Campaign | Machine Learning | machine learning course | Phrase |
| 8 | SEM_Campaign | Machine Learning | +machine +learning +course | Broad |
| 9 | SEM_Campaign | Machine Learning | machine learning tutorial | Exact |
Sieht gut aus. Jetzt generieren wir passende Themen und Keywords für jedes Segment.
topics = ['R', 'Python', 'SQL', 'Git', 'Shell']  # listed on the /courses page
keywords = ['data science', 'programming', 'analytics', 'data analysis', 'machine learning',
            'deep learning', 'financial analysis', 'data viz', 'visualization', 'data visualization',
            'learn', 'course', 'courses', 'education', 'data import', 'data cleaning',
            'data manipulation', 'probability', 'stats', 'statistics', 'course', 'courses',
           'learn', 'education', 'tutorial']  # @marketing_team: this list can / should be refined or
                                              # expanded based on the strategy and how specific the
                                              # targeting needs to be
tech_keywords = generate_keywords(topics, keywords, campaign='SEM_Technologies')
print('total keywords:', tech_keywords.shape[0])
tech_keywords.head()
total keywords: 750
| Campaign | Ad Group | Keyword | Criterion Type | |
|---|---|---|---|---|
| 0 | SEM_Technologies | R | r data science | Exact |
| 1 | SEM_Technologies | R | r data science | Phrase |
| 2 | SEM_Technologies | R | +r +data +science | Broad |
| 3 | SEM_Technologies | R | r programming | Exact |
| 4 | SEM_Technologies | R | r programming | Phrase |
Das ist vermutlich das spezifischste – und damit relevanteste – Segment. Sucht jemand nach „data visualization with r“ und DataCamp hat genau diesen Kurs, ist die Anzeige extrem relevant, weil die Landingpage das Bedürfnis exakt erfüllt.
Es gibt nur ein kleines Problem: Manche Kursnamen entsprechen nicht dem typischen Suchverhalten, z. B. „Machine Learning with the Experts: School Budgets“, „Sentiment Analysis in R: The Tidy Way“. Das sind keine schlechten Titel, aber bei der Keyword‑Auswahl brauchst du Fingerspitzengefühl – oft fallweise.
Wie bei den Instructors kannst du Namen und URLs scrapen:
courses_page = 'https://www.datacamp.com/courses/all'
course_link_selector = '.courses__explore-list .course-block'

course_resp = requests.get(courses_page)
soup = BeautifulSoup(course_resp.text, 'lxml')

course_urls = [link.contents[1]['href'] for link in soup.select(course_link_selector)]
course_urls = ['https://www.datacamp.com' + url for url in course_urls]
course_names = [link.h4.text for link in soup.select(course_link_selector)]
course_df = pd.DataFrame({
    'name': course_names,
    'url': course_urls
})
course_df['name_clean'] = course_df.name.str.replace('\(.*\)', '').str.strip()  # remove (part x)
print('total keywords:', course_df.shape[0])
course_df.head()
total keywords: 104
| name | url | name_clean | |
|---|---|---|---|
| 0 | Intro to Python for Data Science | https://www.datacamp.com/courses/intro-to-python-for-data-science... | Intro to Python for Data Science |
| 1 | Introduction to R | https://www.datacamp.com/courses/free-introduction-to-r... | Introduction to R |
| 2 | Intermediate Python for Data Science | https://www.datacamp.com/courses/intermediate-python... | Intermediate Python for Data Science |
| 3 | Introduction to Git for Data Science | https://www.datacamp.com/courses/introduction-to-git... | Introduction to Git for Data Science |
| 4 | Intermediate R | https://www.datacamp.com/courses/intermediate-r | Intermediate R |
Für die Kurse nutzt du ebenfalls die Funktion generate_keywords(). Beachte jedoch: Die Ergebnisse sollten geprüft werden, denn wie erwähnt sind manche Namen nicht suchgetrieben formuliert. Für den Start ist Folgendes gut genug – danach entscheidest du datenbasiert.
Der leere String unten ist Absicht: Die Kursnamen sind lang und spezifisch genug, um allein als Keyword zu dienen – ohne Zusätze wie „learn“ oder „course“. Du nutzt also sowohl die reinen Kursnamen als auch Kombinationen mit Qualifiern.
keywords = ['', 'learn', 'course', 'courses', 'tutorial', 'education']
course_keywords = generate_keywords(course_df['name_clean'], keywords, campaign='SEM_Courses')
print('total keywords:', course_keywords.shape[0])
course_keywords.head(10)
total keywords: 3744
| Campaign | Ad Group | Keyword | Criterion Type | |
|---|---|---|---|---|
| 0 | SEM_Courses | Intro to Python for Data Science | intro to python for data science | Exact |
| 1 | SEM_Courses | Intro to Python for Data Science | intro to python for data science | Phrase |
| 2 | SEM_Courses | Intro to Python for Data Science | +intro +to +python +for +data +science + | Broad |
| 3 | SEM_Courses | Intro to Python for Data Science | intro to python for data science learn | Exact |
| 4 | SEM_Courses | Intro to Python for Data Science | intro to python for data science learn | Phrase |
| 5 | SEM_Courses | Intro to Python for Data Science | +intro +to +python +for +data +science +learn | Broad |
| 6 | SEM_Courses | Intro to Python for Data Science | intro to python for data science course | Exact |
| 7 | SEM_Courses | Intro to Python for Data Science | intro to python for data science course | Phrase |
| 8 | SEM_Courses | Intro to Python for Data Science | +intro +to +python +for +data +science +course | Broad |
| 9 | SEM_Courses | Intro to Python for Data Science | intro to python for data science courses | Exact |
Das sind generische Themen, nach denen Menschen suchen könnten. Sie sind im Bereich „Tracks“ abgebildet – mit Skills und Career als Unterkategorien. Für unser Ziel kannst du sie in einer Kampagne gruppieren. Der Prozess ist derselbe wie zuvor.
skills_page = 'https://www.datacamp.com/tracks/skill'
skills_link_selector = '#all .shim'

skills_resp = requests.get(skills_page)
skill_soup = BeautifulSoup(skills_resp.text, 'lxml')

skills_urls = [link['href'] for link in skill_soup.select(skills_link_selector)]
skills_names = [skill.replace('/tracks/', '').replace('-', ' ') for skill in skills_urls]
skills_urls = ['https://www.datacamp.com' + url for url in skills_urls]
career_page = 'https://www.datacamp.com/tracks/career'
career_link_selector = '#all .shim'

career_resp = requests.get(career_page)
career_soup = BeautifulSoup(career_resp.text, 'lxml')

career_urls = [link['href'] for link in career_soup.select(career_link_selector)]

career_names = [career.replace('/tracks/', '').replace('-', ' ') for career in career_urls]
career_urls = ['https://www.datacamp.com' + url for url in career_urls]
tracks_df = pd.DataFrame({
    'name': skills_names + career_names,
    'url': skills_urls + career_urls
})
tracks_df['name'] = [x.title() for x in tracks_df['name']]
tracks_df.head()
| name | url | |
|---|---|---|
| 0 | R Programming | https://www.datacamp.com/tracks/r-programming |
| 1 | Importing Cleaning Data With R | https://www.datacamp.com/tracks/importing-cleaning-data-with-r... |
| 2 | Data Manipulation With R | https://www.datacamp.com/tracks/data-manipulation-with-r... |
| 3 | Python Programming | https://www.datacamp.com/tracks/python-programming... |
| 4 | Importing Cleaning Data With Python | https://www.datacamp.com/tracks/importing-cleaning-data-with-python... |
tracks_keywords = generate_keywords(tracks_df['name'], keywords, campaign='SEM_Tracks')
print('total keywords:', tracks_keywords.shape[0])
tracks_keywords.head()
total keywords: 720
| Campaign | Ad Group | Keyword | Criterion Type | |
|---|---|---|---|---|
| 0 | SEM_Tracks | R Programming | r programming | Exact |
| 1 | SEM_Tracks | R Programming | r programming | Phrase |
| 2 | SEM_Tracks | R Programming | +r +programming + | Broad |
| 3 | SEM_Tracks | R Programming | r programming learn | Exact |
| 4 | SEM_Tracks | R Programming | r programming learn | Phrase |
Zum Schluss fasst du alle Keywords aus instructor_keywords, tech_keywords, course_keywords und tracks_keywords zu einem großen DataFrame zusammen:
full_keywords_df = pd.concat([instructor_keywords_df, tech_keywords, course_keywords, tracks_keywords])
print('total keywords:', full_keywords_df.shape[0])
print('total campaigns:', len(set(full_keywords_df['Campaign'])))
print('total ad groups:', len(set(full_keywords_df['Ad Group'])))
full_keywords_df.to_csv('keywords.csv', index=False)
full_keywords_df.head()
total keywords: 7806
total campaigns: 4
total ad groups: 191
| Campaign | Ad Group | Keyword | Criterion Type | |
|---|---|---|---|---|
| 0 | SEM_Instructors | Filip Schouwenaars | filip schouwenaars course | Exact |
| 1 | SEM_Instructors | Filip Schouwenaars | filip schouwenaars course | Phrase |
| 2 | SEM_Instructors | Filip Schouwenaars | +filip +schouwenaars +course | Broad |
| 3 | SEM_Instructors | Filip Schouwenaars | filip schouwenaars courses | Exact |
| 4 | SEM_Instructors | Filip Schouwenaars | filip schouwenaars courses | Phrase |
Damit sind deine Keywords startklar. Wenn du dir den kompletten Datensatz ansehen willst, findest du ihn hier. Als Nächstes generierst du Anzeigen für jede Anzeigengruppe.
Legen wir los mit den Anzeigen.
Aktuell hast du Folgendes:
full_keywords_df korrekt gemappt.Mit diesem Setup folgst du diesem Plan:
Campaign-Spalte an und füge sie zu den ('name', 'url')‑DataFrames hinzu.'name', 'url')‑DataFrames zu einem großen DataFrame zusammen.Generiere alle Anzeigen für alle Anzeigengruppen; pro Anzeige brauchst du diese Felder (neue Spalten im selben DataFrame):
Stelle Konsistenz mit dem keywords‑DataFrame sicher.
Anzeigen generieren heißt: Die Themenbegriffe (Kurs, Tech, Instructor etc.) an die richtige Stelle in der Vorlage setzen – und für jede Anzeigengruppe 2–3 Varianten erstellen.
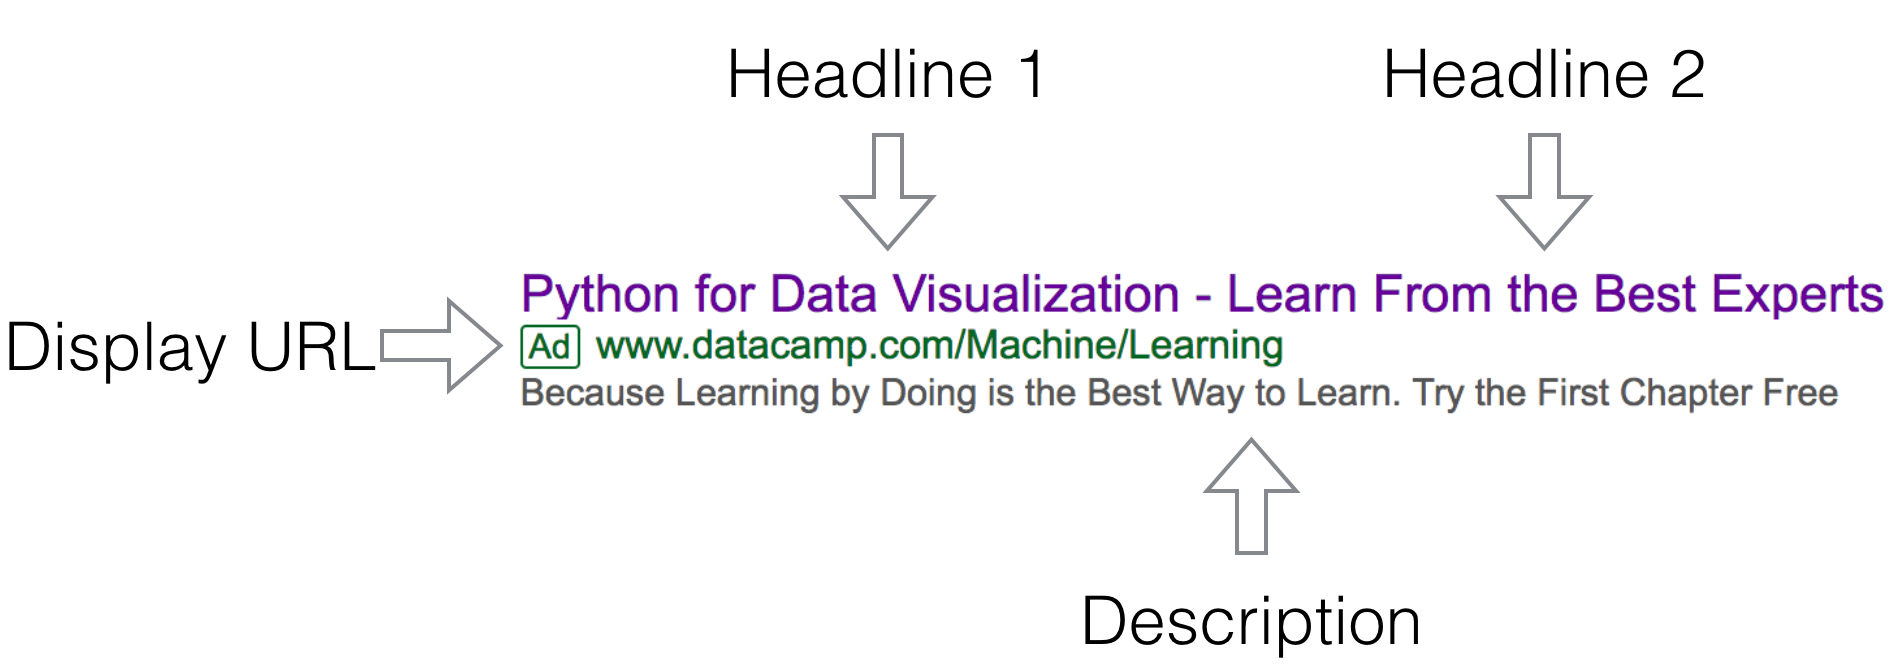
Wichtig: Auch wenn das Einsetzen der Anzeigengruppennamen einfach ist, müssen die Feldlängen innerhalb der Limits bleiben. Da Kurs- und Themennamen stark variieren, brauchst du eine Lösung dafür.
Schauen wir uns das Ausmaß des Problems an:
%matplotlib inline
import matplotlib.pyplot as plt
adgroup_lengths = pd.Series([len(adgrp) for adgrp in full_keywords_df['Ad Group'].unique()])
long_adgroups = sum(adgroup_lengths > 30)
plt.figure(figsize=(9,6))
plt.hist(adgroup_lengths, rwidth=0.9, bins=50)
plt.vlines(x=30, ymin=0, ymax=10, colors='red')
plt.title(str(long_adgroups) + ' ad group name lenghts > 30 (don\'t fit in a headline)',  fontsize=17)
plt.xlabel('Ad Group Name Lengths', fontsize=15)
plt.ylabel('Count', fontsize=15)
plt.yticks(range(11))
plt.xticks(range(0, 51, 5))
plt.grid(alpha=0.5)
plt.show()
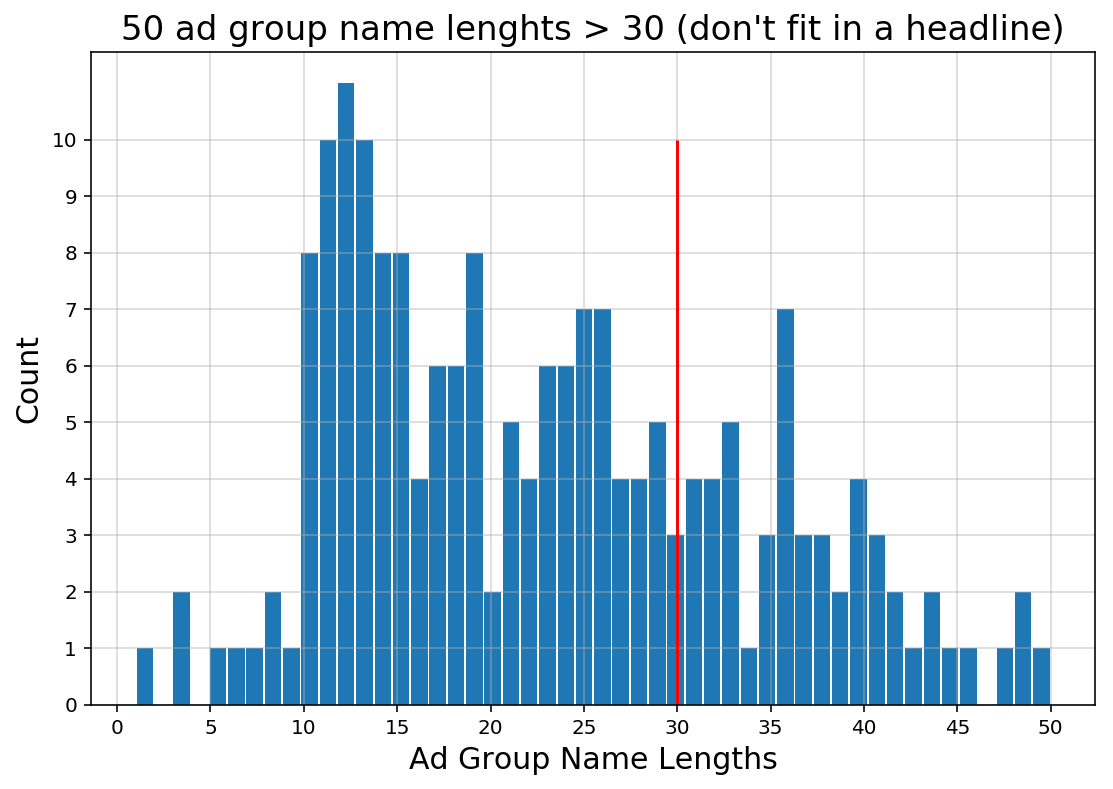
Das Problem ist nicht trivial und es gibt keinen einfachen Fix. Ideal wäre, wenn die beiden Headlines den vollen Kurstitel aufnehmen könnten.
Ich habe verschiedene Ansätze geprüft und mich für einen einfachen Algorithmus entschieden, der den Namen in zwei Phrasen mit jeweils maximal 30 Zeichen aufteilt.
Der Algorithmus ist nicht allgemeingültig und braucht für generische Nutzung Feinschliff, funktioniert für diesen Datensatz aber gut:
def split_string(string, splits=2, max_len=60):
    """Split `string` into `splits` words, each shorter than `max_len` / `splits`"""
    if len(string) < max_len / splits:
        return string, ''
    str_words = string.split(' ')
    result = ''
    for i, word in enumerate(str_words):
        if len(result + ' ' + word) <= max_len / splits:
            result += word + ' '
        else:
            break
    spaces = result.strip().count(' ')
    result2 = string[string[len(result):].index(word) + len(result):]
    return result.strip(), result2
print(split_string('this is a very long course name that needs splitting', 2, 60))
print(split_string('short course name', 2, 60))
('this is a very long course', 'name that needs splitting')
('short course name', '')
Das mache ich sonst selten, aber mir gefällt diese Technik – die werde ich künftig auch in anderen Kampagnen nutzen. Ein schöner Nebeneffekt beim Schreiben eines Tutorials.
Jetzt zu den Vorlagen, die du schreiben willst.
Die generelle Anzeigenvorlage besteht aus folgenden Elementen (typisch in dieser Reihenfolge):
Alles in einer „Tweet‑langen“ Anzeige unterzubringen, ist nicht leicht, und manches überschneidet sich. Versuch trotzdem, so viel wie möglich abzudecken.
Campaign Columnsfull_keywords_df.Campaign.unique() # just to make sure you have consistent naming conventions
array(['SEM_Instructors', 'SEM_Technologies', 'SEM_Courses', 'SEM_Tracks'], dtype=object)
course_df['Campaign'] = 'SEM_Courses'
course_df = course_df.rename(columns={'name_clean': 'name', 'name': 'old_name'})
course_df.head()
| old_name | url | name | Campaign | |
|---|---|---|---|---|
| 0 | Intro to Python for Data Science | https://www.datacamp.com/courses/intro-to-python-for-data-science... | Intro to Python for Data Science | SEM_Courses |
| 1 | Introduction to R | https://www.datacamp.com/courses/free-introduction-to-r... | Introduction to R | SEM_Courses |
| 2 | Intermediate Python for Data Science | https://www.datacamp.com/courses/intermediate-python... | Intermediate Python for Data Science | SEM_Courses |
| 3 | Introduction to Git for Data Science | https://www.datacamp.com/courses/introduction-to-git... | Introduction to Git for Data Science | SEM_Courses |
| 4 | Intermediate R | https://www.datacamp.com/courses/intermediate-r | Intermediate R | SEM_Courses |
instructor_df['Campaign'] = 'SEM_Instructors'
instructor_df.head()
| name | url | Campaign | |
|---|---|---|---|
| 0 | Filip Schouwenaars | https://www.datacamp.com/instructors/filipsch | SEM_Instructors |
| 1 | Jonathan Cornelissen | https://www.datacamp.com/instructors/jonathana... | SEM_Instructors |
| 2 | Hugo Bowne-Anderson | https://www.datacamp.com/instructors/hugobowne | SEM_Instructors |
| 3 | Greg Wilson | https://www.datacamp.com/instructors/greg48f64... | SEM_Instructors |
| 4 | Nick Carchedi | https://www.datacamp.com/instructors/nickyc | SEM_Instructors |
tracks_df['Campaign'] = 'SEM_Tracks'
tracks_df.head()
| name | url | Campaign | |
|---|---|---|---|
| 0 | R Programming | https://www.datacamp.com/tracks/r-programming | SEM_Tracks |
| 1 | Importing Cleaning Data With R | https://www.datacamp.com/tracks/importing-cleaning-data-with-r... | SEM_Tracks |
| 2 | Data Manipulation With R | https://www.datacamp.com/tracks/data-manipulation-with-r... | SEM_Tracks |
| 3 | Python Programming | https://www.datacamp.com/tracks/python-programming... | SEM_Tracks |
| 4 | Importing Cleaning Data With Python | https://www.datacamp.com/tracks/importing-cleaning-data-with-python... | SEM_Tracks |
tech_domain = 'https://www.datacamp.com/courses/tech:'
tech_domain_list = []
for tech in ['R', 'Python', 'SQL', 'Git', 'Shell']:
    tech_domain_list.append((tech, tech_domain + tech))
tech_df = pd.DataFrame.from_records(tech_domain_list, columns=['name', 'url'])
tech_df['Campaign'] = 'SEM_Technologies'
tech_df
| name | url | Campaign | |
|---|---|---|---|
| 0 | R | https://www.datacamp.com/category/r | SEM_Technologies |
| 1 | Python | https://www.datacamp.com/category/python | SEM_Technologies |
| 2 | SQL | https://www.datacamp.com/category/sql | SEM_Technologies |
| 3 | Git | https://www.datacamp.com/courses/tech:Git | SEM_Technologies |
| 4 | Shell | https://www.datacamp.com/category/shell | SEM_Technologies |
'name', 'url') DataFramesfull_ads_df = pd.concat([course_df[['Campaign', 'name', 'url']],
instructor_df,
tracks_df,
tech_df], ignore_index=True)
full_ads_df = full_ads_df.rename(columns={'name': 'Ad Group', 'url': 'Final URL'})
print('total rows:', full_ads_df.shape[0])
n_adgroups = full_ads_df.shape[0]
full_ads_df.head()
total rows: 201
| Campaign | Ad Group | Final URL | |
|---|---|---|---|
| 0 | SEM_Courses | Intro to Python for Data Science | https://www.datacamp.com/courses/intro-to-python-for-data-science... |
| 1 | SEM_Courses | Introduction to R | https://www.datacamp.com/courses/free-introduction-to-r... |
| 2 | SEM_Courses | Intermediate Python for Data Science | https://www.datacamp.com/courses/intermediate-python... |
| 3 | SEM_Courses | Introduction to Git for Data Science | https://www.datacamp.com/courses/introduction-to-git... |
| 4 | SEM_Courses | Intermediate R | https://www.datacamp.com/courses/intermediate-r |
Zur Orientierung: Dein Ads‑DataFrame enthält nun die Spalten Campaign, Ad Group und Final URL korrekt gemappt. Jetzt fehlen noch Headline 1, Headline 2 und Description.
Denk daran: Für jede Anzeigengruppe legst du drei Varianten an. Das ist Best Practice fürs Testing – Klickrate, Conversions usw. Der DataFrame sollte am Ende dreimal so viele Zeilen haben wie vorher.
Duplikiziere zunächst jede Zeile im full_ads_df dreimal:
full_ads_df = full_ads_df.iloc[[x  for x in range(n_adgroups) for i in range(3)], :]
print('total rows:', full_ads_df.shape[0])
full_ads_df.head(9)
total rows: 603
| Campaign | Ad Group | Final URL | |
|---|---|---|---|
| 0 | SEM_Courses | Intro to Python for Data Science | https://www.datacamp.com/courses/intro-to-python-for-data-science... |
| 0 | SEM_Courses | Intro to Python for Data Science | https://www.datacamp.com/courses/intro-to-python-for-data-science... |
| 0 | SEM_Courses | Intro to Python for Data Science | https://www.datacamp.com/courses/intro-to-python-for-data-science... |
| 1 | SEM_Courses | Introduction to R | https://www.datacamp.com/courses/free-introduction-to-r... |
| 1 | SEM_Courses | Introduction to R | https://www.datacamp.com/courses/free-introduction-to-r... |
| 1 | SEM_Courses | Introduction to R | https://www.datacamp.com/courses/free-introduction-to-r... |
| 2 | SEM_Courses | Intermediate Python for Data Science | https://www.datacamp.com/courses/intermediate-python... |
| 2 | SEM_Courses | Intermediate Python for Data Science | https://www.datacamp.com/courses/intermediate-python... |
| 2 | SEM_Courses | Intermediate Python for Data Science | https://www.datacamp.com/courses/intermediate-python... |
Jetzt fügst du die drei unterschiedlichen Beschreibungen ein, die du oben erstellt hast.
Description = [
    'Learn Directly From the Top Experts in the Field. 20% off Annual Subcriptions',
    'Be Ahead of the Curve, Master Data Science Skills. $29 / Month. Cancel Anytime',
    'Choose From a Wide Variety of Topics Tuaght by the Best in the World. Start Now'
]
Description = [x for i in range(n_adgroups) for x in Description ]
full_ads_df['Description'] = Description
full_ads_df.head()
| Campaign | Ad Group | Final URL | Description | |
|---|---|---|---|---|
| 0 | SEM_Courses | Intro to Python for Data Science | https://www.datacamp.com/courses/intro-to-python-for-data-science... | Learn Directly From the Top Experts in the Fie... |
| 0 | SEM_Courses | Intro to Python for Data Science | https://www.datacamp.com/courses/intro-to-python-for-data-science... | Be Ahead of the Curve, Master Data Science Ski... |
| 0 | SEM_Courses | Intro to Python for Data Science | https://www.datacamp.com/courses/intro-to-python-for-data-science... | Choose From a Wide Variety of Topics Tuaght by... |
| 1 | SEM_Courses | Introduction to R | https://www.datacamp.com/courses/free-introduction-to-r... | Learn Directly From the Top Experts in the Fie... |
| 1 | SEM_Courses | Introduction to R | https://www.datacamp.com/courses/free-introduction-to-r... | Be Ahead of the Curve, Master Data Science Ski... |
Als Nächstes ergänzt du Headline 1 und Headline 2 im DataFrame. Fast geschafft.
benefits = [
    'Boost Your Data Science Career',
    'Stand Out From the Crowd',
    'Tackle Complex Questions'
]
Die Benefits nutzt du als Headline 2, wenn die Länge der Anzeigengruppe 30 Zeichen oder weniger beträgt. In diesem Fall ist das zweite Feld leer, das du dann mit einem Benefit füllst.
benefits = [x for i in range(n_adgroups) for x in benefits]
headlines = [split_string(x) for x in full_ads_df['Ad Group']]
full_ads_df['Headline 1'] = [x[0] for x in headlines]
full_ads_df['Headline 2'] = [x[1] if x[1] else benefits[i] for i, x in enumerate(headlines)]
print('total ads:', full_ads_df.shape[0])
full_ads_df.head(9)
total ads: 603
| Campaign | Ad Group | Final URL | Description | Headline 1 | Headline 2 | |
|---|---|---|---|---|---|---|
| 0 | SEM_Courses | Intro to Python for Data Science | https://www.datacamp.com/courses/intro-to-python-for-data-science... | Learn Directly From the Top Experts in the Fie... | Intro to Python for Data | Science |
| 0 | SEM_Courses | Intro to Python for Data Science | https://www.datacamp.com/courses/intro-to-python-for-data-science... | Be Ahead of the Curve, Master Data Science Ski... | Intro to Python for Data | Science |
| 0 | SEM_Courses | Intro to Python for Data Science | https://www.datacamp.com/courses/intro-to-python-for-data-science... | Choose From a Wide Variety of Topics Tuaght by... | Intro to Python for Data | Science |
| 1 | SEM_Courses | Introduction to R | https://www.datacamp.com/courses/free-introduction-to-r... | Learn Directly From the Top Experts in the Fie... | Introduction to R | Boost Your Data Science Career |
| 1 | SEM_Courses | Introduction to R | https://www.datacamp.com/courses/free-introduction-to-r... | Be Ahead of the Curve, Master Data Science Ski... | Introduction to R | Stand Out From the Crowd |
| 1 | SEM_Courses | Introduction to R | https://www.datacamp.com/courses/free-introduction-to-r... | Choose From a Wide Variety of Topics Tuaght by... | Introduction to R | Tackle Complex Questions |
| 2 | SEM_Courses | Intermediate Python for Data Science | https://www.datacamp.com/courses/intermediate-python... | Learn Directly From the Top Experts in the Fie... | Intermediate Python for Data | Science |
| 2 | SEM_Courses | Intermediate Python for Data Science | https://www.datacamp.com/courses/intermediate-python... | Be Ahead of the Curve, Master Data Science Ski... | Intermediate Python for Data | Science |
| 2 | SEM_Courses | Intermediate Python for Data Science | https://www.datacamp.com/courses/intermediate-python... | Choose From a Wide Variety of Topics Tuaght by... | Intermediate Python for Data | Science |
Wie du siehst, war „Intro to Python for Data Science“ lang und wurde auf zwei Felder aufgeteilt – so bleibt es klar. „Introduction to R“ passt in Headline 1; daher fügst du in Headline 2 die drei verschiedenen Benefits ein.
Und damit bist du durch.
Zum Abschluss ein schneller Check, ob Kampagnen- und Anzeigengruppennamen in beiden DataFrames identisch sind.
ads_check = (full_ads_df[['Campaign', 'Ad Group']]
             .drop_duplicates()
             .sort_values(['Campaign', 'Ad Group'])
             .reset_index(drop=True))
keywords_check = (full_keywords_df[['Campaign', 'Ad Group']]
                  .drop_duplicates()
                  .sort_values(['Campaign', 'Ad Group'])
                  .reset_index(drop=True))

all(ads_check == keywords_check)
True
full_ads_df.to_csv('ads.csv', index=False)
Wie besprochen, deckt dieses Tutorial nur bestimmte Schritte innerhalb von SEM‑Kampagnen ab und setzt ein Grundverständnis von Suchmaschinenwerbung voraus. Wenn du mehr über Mechanik und Details zum Upload und Starten deiner Anzeigengruppen wissen willst, hilft dir der AdWords‑Leitfaden für den Einstieg. Vollständige Kurse in verschiedenen Bereichen findest du in der Google Academy for Ads.
Mit den beiden CSV‑Dateien kannst du hochladen und deine Kampagnen starten. Du musst noch Tagesbudgets, Geotargeting und ein paar andere Parameter setzen – ansonsten bist du startklar.
Die CSV‑Dateien findest du hier:
Ich hoffe, das Tutorial war hilfreich. Danke fürs Lesen! Wenn du Wachstumsprojekte teilen möchtest, die du mit Python umgesetzt hast, schreib mir gern auf Twitter @eliasdabbas.
Erfahre mehr über Python
Kurs
Kurs
Kurs