Kurs
Zeitreihenanalyse in Python
4 Std.
70.6K
In der Facebook-Live-Coding-Session am 4. Januar haben wir uns Google-Trends-Daten zu den Keywords "diet", "gym" und "finance" angeschaut, um zu sehen, wie sie sich über die Zeit verändern. Wir haben uns gefragt, ob es im Januar mehr Suchen nach diesen Begriffen gibt, wenn wir alle mit guten Vorsätzen ins neue Jahr starten.
In diesem Tutorial gehst du den während der Session geschriebenen Code Schritt für Schritt durch. Du wirst kaum Mathematik brauchen. Der Fokus liegt klar auf der visuellen Erkundung des Datensatzes.
Mehr zu pandas findest du im DataCamp-Lernpfad Data Manipulation with Python. Mehr zu Zeitreihen mit pandas gibt es im Kurs Manipulating Time Series Data in Python.
Also bleibt die Frage: Gibt es wirklich mehr Suchen nach diesen Begriffen im Januar, wenn wir alle ein neues Kapitel aufschlagen?
Finden wir es heraus, indem wir hier die Daten checken. Hinweis: Dieses Tutorial ist inspiriert von diesem FiveThirtyEight-Artikel.
Du kannst die Daten auch als .csv herunterladen, lokal speichern und in deine eigene Python-Umgebung importieren, um die Analyse selbst durchzuführen. Genau das machst du jetzt. Los geht’s!
Zu Beginn importierst du einige Pakete: Wir verwenden numpy, pandas, matplotlib und seaborn.
Wenn du die Grafiken direkt im Jupyter Notebook anzeigen willst, kannst du IPython-Magie mit %matplotlib inline nutzen. Alternativ stellst du mit sns.set() die Seaborn-Standards ein:
# Import packages
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
%matplotlib inline
sns.set()
Importiere die heruntergeladenen Daten mit .read_csv() und sieh dir mit .head() die ersten Zeilen an.
Hinweis: Mit dem Argument skiprows überspringst du die erste Zeile der Datei.
 df = pd.read_csv('data/multiTimeline.csv', skiprows=1)
df.head()| Month | diet: (Worldwide) | gym: (Worldwide) | finance: (Worldwide) | |
|---|---|---|---|---|
| 0 | 2004-01 | 100 | 31 | 48 |
| 1 | 2004-02 | 75 | 26 | 49 |
| 2 | 2004-03 | 67 | 24 | 47 |
| 3 | 2004-04 | 70 | 22 | 48 |
| 4 | 2004-05 | 72 | 22 | 43 |
Mit der Methode .info() prüfst du Datentypen, Zeilenanzahl und mehr:
df.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 168 entries, 0 to 167
Data columns (total 4 columns):
Month                   168 non-null object
diet: (Worldwide)       168 non-null int64
gym: (Worldwide)        168 non-null int64
finance: (Worldwide)    168 non-null int64
dtypes: int64(3), object(1)
memory usage: 5.3+ KB
Nachdem du die Google-Trends-Daten importiert und kurz gesichtet hast, bereitest du sie jetzt für die Analyse auf.
Als Erstes benennst du die Spalten deines DataFrames df so um, dass keine Leerzeichen mehr enthalten sind. Es gibt mehrere Wege, aber hier weist du df.columns einfach eine Liste mit den gewünschten Namen zu.
Prüfe das Ergebnis mit df.head():
df.columns = ['month', 'diet', 'gym', 'finance']
df.head()
| month | diet | gym | finance | |
|---|---|---|---|---|
| 0 | 2004-01 | 100 | 31 | 48 |
| 1 | 2004-02 | 75 | 26 | 49 |
| 2 | 2004-03 | 67 | 24 | 47 |
| 3 | 2004-04 | 70 | 22 | 48 |
| 4 | 2004-05 | 72 | 22 | 43 |
Als Nächstes wandelst du die Spalte 'month' in den Datentyp DateTime um und setzt sie als Index des DataFrames.
Hinweis: In .info() war 'Month' vom Typ object. Dieser generische Typ umfasst Strings, Integer usw. Für Zeitreihendaten ist das unpraktisch. Deshalb konvertierst du mit .to_datetime() die Spalte 'month' in DateTime.
Vorsicht: Nutze beim Setzen des Index das Argument inplace, damit der ursprüngliche Index wirklich durch 'month' ersetzt wird.
df.month = pd.to_datetime(df.month)
df.set_index('month', inplace=True)
df.head()
| diet | gym | finance | |
|---|---|---|---|
| month | |||
| 2004-01-01 | 100 | 31 | 48 |
| 2004-02-01 | 75 | 26 | 49 |
| 2004-03-01 | 67 | 24 | 47 |
| 2004-04-01 | 70 | 22 | 48 |
| 2004-05-01 | 72 | 22 | 43 |
Jetzt wird der DataFrame visuell erkundet.
Mit der eingebauten pandas-Methode .plot() kannst du die Daten als drei Liniendiagramme in einer Abbildung darstellen (je eine Linie für 'diet', 'gym' und 'finance').
Hinweis: Du kannst Argumente wie figsize, linewidth und fontsize angeben, um Größe, Linienstärke und Schriftgröße zu steuern.
Auf der x-Achse siehst du standardmäßig Jahre, nicht Monate. Damit die Beschriftung passt, setzt du das x-Label auf 'Year' und die Schriftgröße auf 20.
Tipp: Wenn du Matplotlib-Ausgaben unterdrücken möchtest, hänge einfach ein Semikolon ; an die letzte Codezeile!
df.plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
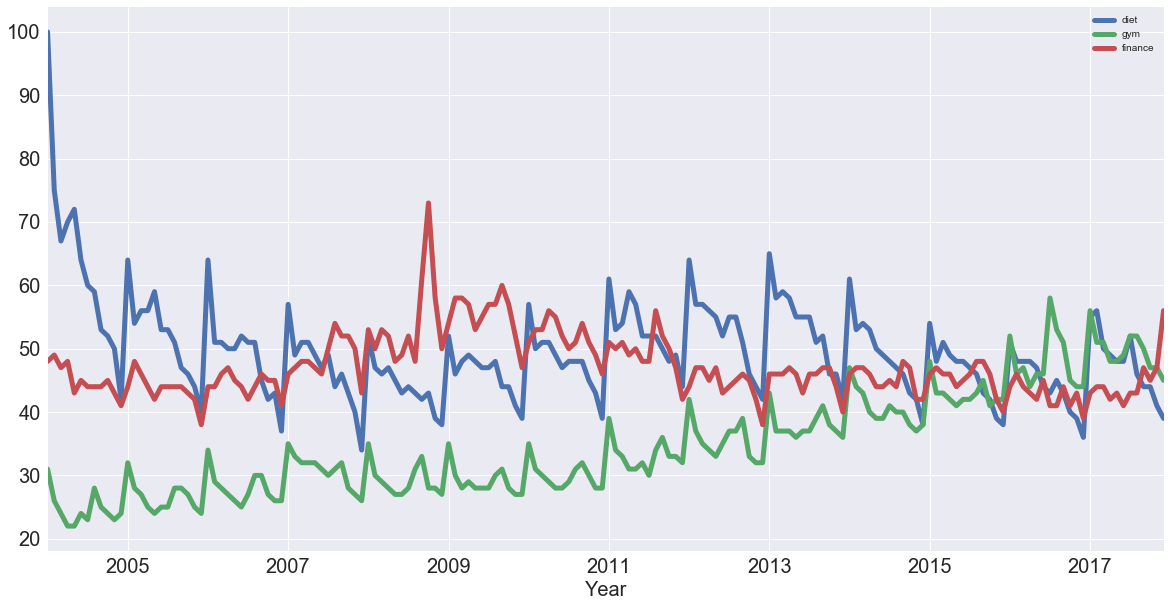
Hinweis: Diese Daten sind relativ. In Google Trends heißt es:
Zahlen repräsentieren das Suchinteresse relativ zum Höchstwert im Diagramm für die jeweilige Region und den Zeitraum. Ein Wert von 100 steht für die maximale Beliebtheit des Suchbegriffs. Ein Wert von 50 bedeutet, dass der Begriff halb so beliebt ist. Ein Wert von 0 bedeutet, dass der Begriff weniger als 1 % so beliebt war wie der Spitzenwert.
Du kannst auch die Spalte 'diet' allein als Zeitreihe plotten:
df[['diet']].plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
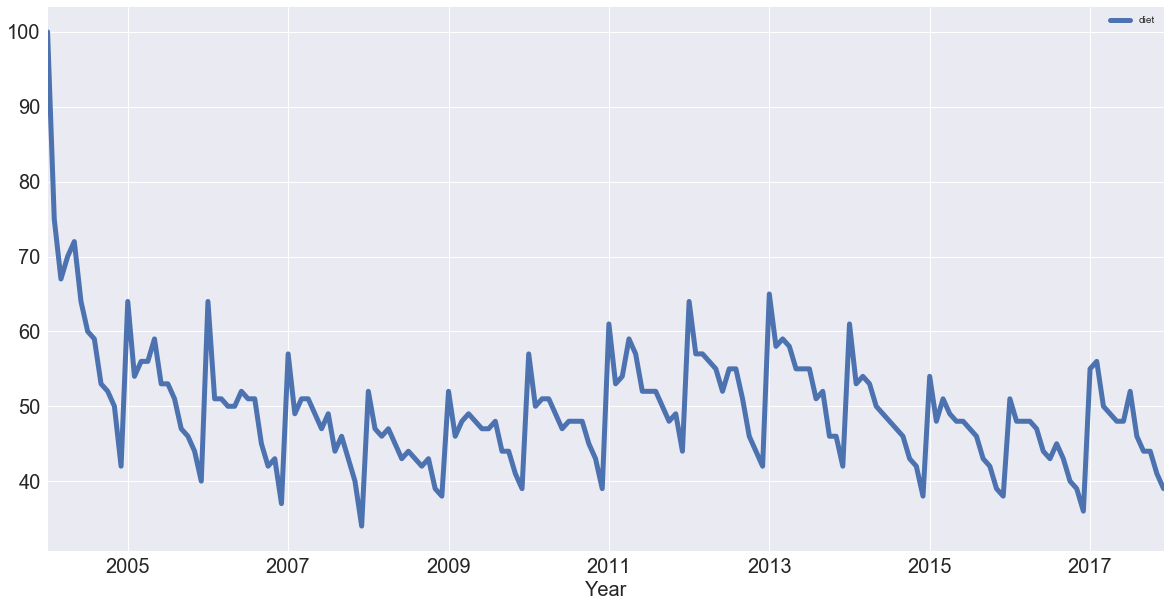
Beobachtung: Es gibt Saisonalität: Jeden Januar gibt es einen deutlichen Sprung. Außerdem scheint ein Trend vorhanden zu sein: erst leicht nach oben, dann nach unten, wieder nach oben und wieder nach unten. Mit anderen Worten: Die Zeitreihen haben Trend- und saisonale Komponenten.
Mit diesem Wissen lernst du jetzt, wie du Trends in deiner Zeitreihe identifizierst.
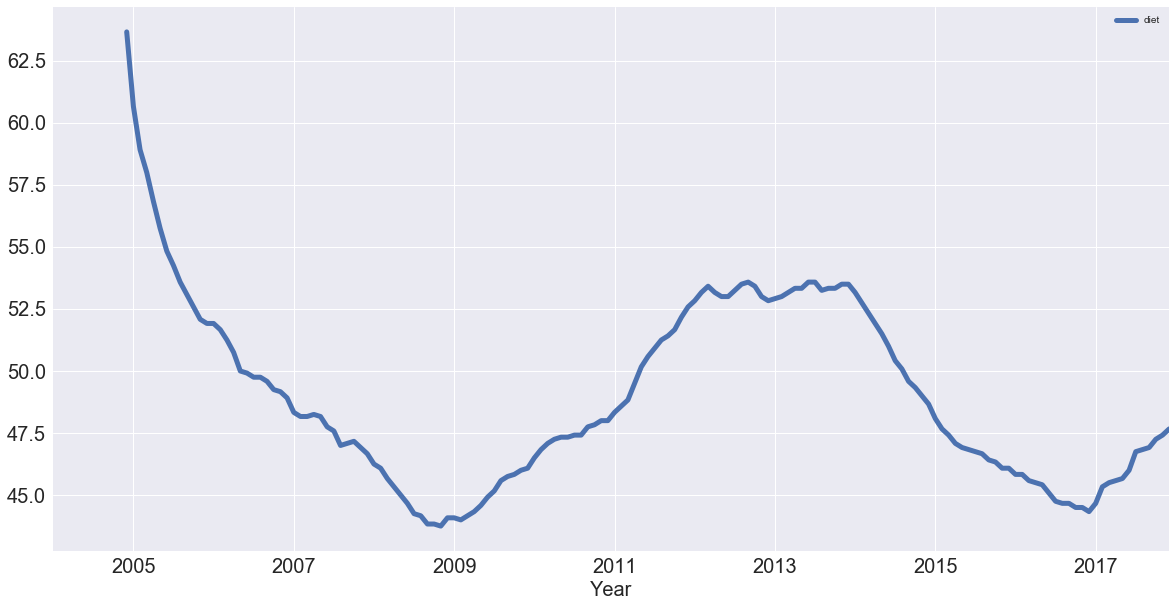
Es gibt mehrere Ansätze, Trends in Zeitreihen zu identifizieren. Beliebt ist der gleitende Durchschnitt (Rolling Average): Für jeden Zeitpunkt nimmst du den Mittelwert der Punkte um ihn herum. Die Anzahl der Punkte bestimmst du über die Fenstergröße.
Durch das Mitteln glättest du Rauschen und Saisonalität. Ein Beispiel siehst du jetzt. Betrachte den gleitenden Mittelwert von 'diet' mit den eingebauten pandas-Methoden.
Für die Fenstergröße bietet sich hier zwölf Monate an, weil wir über jährliche Saisonalität sprechen.
diet = df[['diet']]
diet.rolling(12).mean().plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
Hinweis: Oben haben wir doppelte eckige Klammern verwendet, um 'diet' als DataFrame zu extrahieren; Mit einfachen Klammern wie df['diet'] würdest du eine pandas Series erhalten.
Im Codebeispiel oben werden Methoden verkettet: Du rufst Methoden nacheinander auf demselben Objekt auf. Method Chaining ist sehr beliebt, und pandas unterstützt diesen Stil hervorragend.
Jetzt hast du den gesuchten Trend! Im Vergleich zum vorherigen Plot ist die Saisonalität weitgehend entfernt.
Auch für 'gym' kannst du den gleitenden Durchschnitt mit derselben Fenstergröße plotten:
gym = df[['gym']]
gym.rolling(12).mean().plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
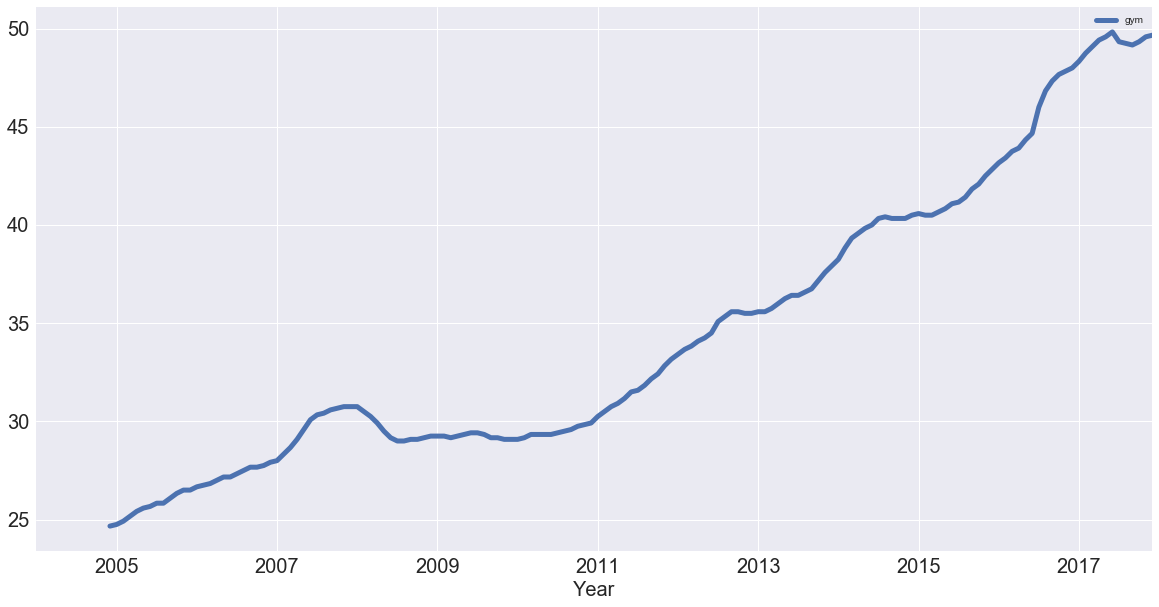
Die Saisonalität ist entfernt, und für "gym" siehst du einen Aufwärtstrend. Aber wie schneiden die beiden Suchbegriffe im Vergleich ab?
Das findest du heraus, indem du die Trends von 'gym' und 'diet' in einer Abbildung vergleichst:
df_rm = pd.concat([diet.rolling(12).mean(), gym.rolling(12).mean()], axis=1)
df_rm.plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
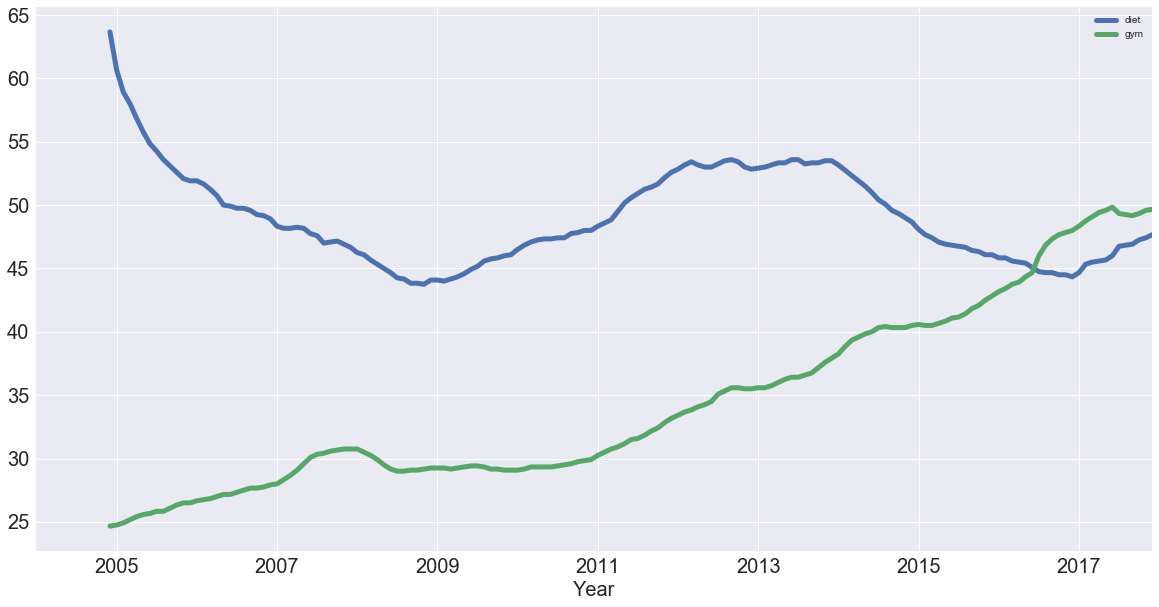
Du hast einen neuen DataFrame df_rm erstellt, der zwei Spalten mit den gleitenden Durchschnitten von 'diet' und 'gym' enthält. Dafür nutzt du pd.concat() mit einer Liste der Spalten als erstem Argument und setzt axis auf 1, um spaltenweise zu verbinden.
Anschließend plottest du den DataFrame wie zuvor mit plot(). Ohne Saisonalität zeigt sich: diet hat potenziell eine andere Dynamik, während gym tatsächlich steigt.
Nachdem die Trends identifiziert sind, kümmern wir uns um die Saisonalität, also die wiederkehrenden Muster der Zeitreihe. Wie zu Beginn gesehen, gibt es beides: Trend- und saisonale Komponenten.
Eine Möglichkeit, saisonale Komponenten zu untersuchen, ist das Entfernen des Trends. So lässt sich die Saisonalität leichter analysieren. Du kannst den zuvor berechneten Trend (gleitender Mittelwert) von der Originalreihe abziehen. Das Ergebnis hängt allerdings von der Fenstergröße ab.
Eine andere Methode ist das „Differenzieren“, bei dem du die Differenz aufeinander folgender Datenpunkte betrachtest ("Differenzieren erster Ordnung", da du jeweils den Unterschied zum direkt vorherigen Punkt nimmst).
Mit pandas sowie den Methoden diff() und plot() berechnest und plottest du die erste Differenz der Serie 'diet':
diet.diff().plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
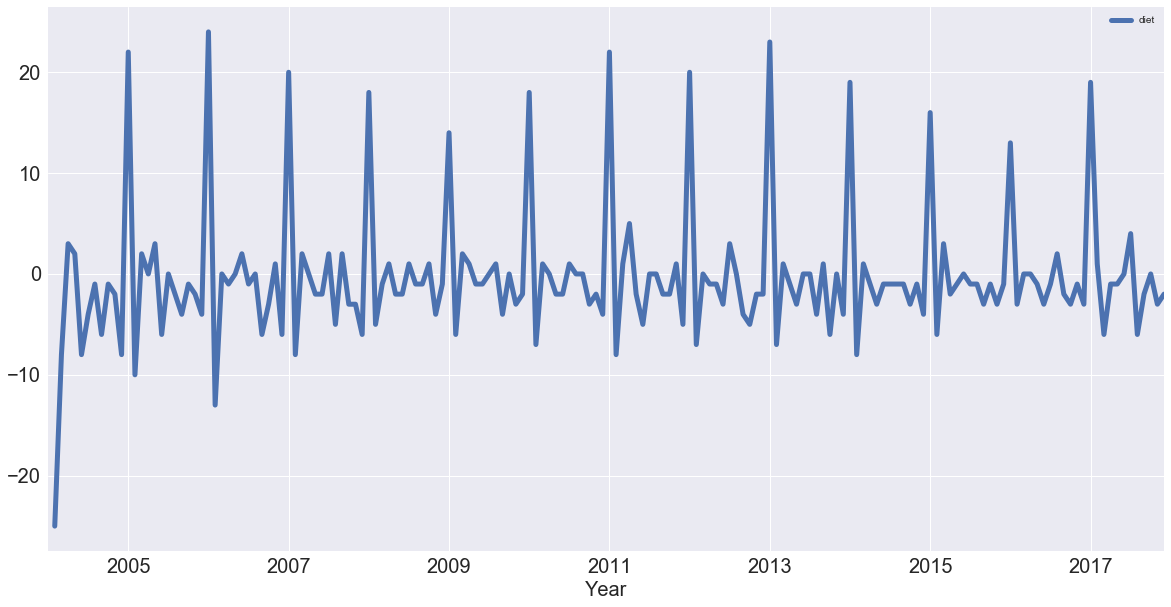
Du siehst, dass viel Trend entfernt wurde und die Januargipfel jedes Jahr deutlich sichtbar sind. Jeden Januar gibt es einen starken Ausschlag von 20 Prozentpunkten oder mehr beim höchsten Suchinteresse.
Hinweis: Du kannst auch Differenzieren 2. Ordnung durchführen, also den Unterschied zu den zwei vorherigen Punkten betrachten, falls der Trend noch nicht ausreichend entfernt ist. Mehr dazu hier.
Differenzieren hilft dabei, eine Zeitreihe stationär zu machen. Stationäre Reihen haben über die Zeit konstante statistische Eigenschaften (z. B. Mittelwert und Varianz). Das ist nützlich, weil viele Prognoseverfahren eine (annähernd) stationäre Zeitreihe voraussetzen.
Damit analysierst du jetzt die Periodizität deiner Zeitreihe über die Autokorrelationsfunktion. Zuvor aber ein kurzer Exkurs zur Korrelation.
Eine Zeitreihe ist periodisch, wenn sie sich in gleichen Abständen wiederholt, z. B. alle 12 Monate.
Anders gesagt: Hat die Reihe irgendwo einen Peak, folgt 12 Monate später wieder ein Peak; Gibt es ein Tal, folgt 12 Monate später erneut ein Tal.
Noch anders formuliert: Die Zeitreihe ist mit sich selbst korreliert, wenn man sie um 12 Monate verschiebt. Schiebst du sie um 12 Monate vor oder zurück, legt sie sich in gewisser Weise wieder auf sich selbst.
Diese Korrelation einer Zeitreihe mit einer verschobenen Version von sich selbst beschreibt die Autokorrelation.
Gleich geht’s los.
Erst erinnern wir uns an Korrelation und nähern uns dem Konzept intuitiv.
Der Korrelationskoeffizient zweier Variablen misst, wie stark sie linear zusammenhängen. Zur Veranschaulichung nutzen wir den iris-Datensatz mit Blumenmessungen.
Dafür importierst du den iris-Datensatz aus scikit-learn, wandelst ihn in einen DataFrame um und zeigst mit .head() die ersten Zeilen an:
from sklearn import datasets
iris = datasets.load_iris()
df_iris = pd.DataFrame(data= np.c_[iris['data'], iris['target']],
                     columns= iris['feature_names'] + ['target'])
df_iris.head()
| sepal length (cm) | sepal width (cm) | petal length (cm) | petal width (cm) | target | |
|---|---|---|---|---|---|
| 0 | 5.1 | 3.5 | 1.4 | 0.2 | 0.0 |
| 1 | 4.9 | 3.0 | 1.4 | 0.2 | 0.0 |
| 2 | 4.7 | 3.2 | 1.3 | 0.2 | 0.0 |
| 3 | 4.6 | 3.1 | 1.5 | 0.2 | 0.0 |
| 4 | 5.0 | 3.6 | 1.4 | 0.2 | 0.0 |
Zur Einordnung: Jede Blüte hat Kelchblätter (sepal) und Blütenblätter (petal). Die Kelchblätter umschließen die Blütenblätter und sind meist grün und laubartig, die Blütenblätter sind in der Regel farbig. Die Spalte 'target' ist die Zielvariable und steht für die Iris-Art: Versicolor, Virginica oder Setosa. In der Tabelle oben sind sie als 0, 1 und 2 kodiert.
Um Korrelation zu untersuchen, betrachtest du, wie Kelchblattlänge und -breite zusammenhängen. Dazu erstellst du mit pandas bzw. seaborn ein Streudiagramm von 'sepal length' gegen 'sepal width':
sns.lmplot(x='sepal length (cm)', y='sepal width (cm)', fit_reg=False, data=df_iris);
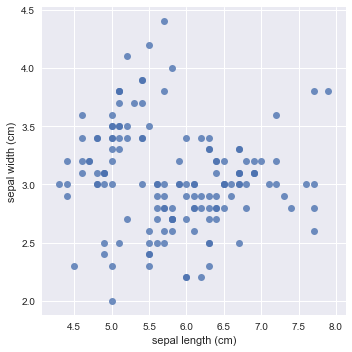
Hinweis: Die lineare Regression wurde mit fit_reg=False deaktiviert.
Sind Länge und Breite über alle Blumen hinweg positiv oder negativ korreliert? Und wie innerhalb jeder Art? Das ist ein wichtiger Unterschied.
Ersteres bedeutet: Steigt die Kelchblattlänge, steigt auch die -breite linear. Letzteres: Steigt die Länge, sinkt die Breite linear.
Auf den ersten Blick wirkt es oben negativ korreliert: Mit zunehmender Länge nimmt die Breite leicht ab.
Erstelle nun ein Streudiagramm von 'sepal length' gegen 'sepal width', eingefärbt nach species (target):
sns.lmplot(x='sepal length (cm)', y='sepal width (cm)', fit_reg=False, data=df_iris, hue='target');
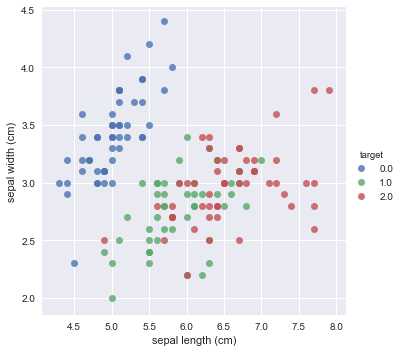
Hier scheint die Korrelation innerhalb der einzelnen Arten positiv zu sein: Steigt die Länge, steigt auch die Breite.
Visualisierungen geben eine gute Intuition, aber du kannst Korrelation auch quantifizieren, indem du den Korrelationskoeffizienten berechnest.
Die Korrelationskoeffizienten aller Messpaare berechnest du mit .corr():
df_iris.corr()
| sepal length (cm) | sepal width (cm) | petal length (cm) | petal width (cm) | target | |
|---|---|---|---|---|---|
| sepal length (cm) | 1.000000 | -0.109369 | 0.871754 | 0.817954 | 0.782561 |
| sepal width (cm) | -0.109369 | 1.000000 | -0.420516 | -0.356544 | -0.419446 |
| petal length (cm) | 0.871754 | -0.420516 | 1.000000 | 0.962757 | 0.949043 |
| petal width (cm) | 0.817954 | -0.356544 | 0.962757 | 1.000000 | 0.956464 |
| target | 0.782561 | -0.419446 | 0.949043 | 0.956464 | 1.000000 |
Hinweis: "sepal length (cm)" und "sepal width (cm)" sind über alle Blumen hinweg negativ korreliert (Korrelation -0,1). Innerhalb der Arten jedoch nicht, dort ist die Korrelation positiv (z. B. 0,78).
Für Interessierte: Das ist das Simpson-Paradoxon und wichtig bei kausalen Schlussfolgerungen. Mehr dazu hier.
Schauen wir genauer hin und berechnen die Korrelationskoeffizienten je Art. Dazu kettelst du .groupby() und .corr(), gruppierst nach Zielvariable und gibst die Korrelation aus:
df_iris.groupby(['target']).corr()
| petal length (cm) | petal width (cm) | sepal length (cm) | sepal width (cm) | ||
|---|---|---|---|---|---|
| target | |||||
| 0.0 | petal length (cm) | 1.000000 | 0.306308 | 0.263874 | 0.176695 |
| petal width (cm) | 0.306308 | 1.000000 | 0.279092 | 0.279973 | |
| sepal length (cm) | 0.263874 | 0.279092 | 1.000000 | 0.746780 | |
| sepal width (cm) | 0.176695 | 0.279973 | 0.746780 | 1.000000 | |
| 1.0 | petal length (cm) | 1.000000 | 0.786668 | 0.754049 | 0.560522 |
| petal width (cm) | 0.786668 | 1.000000 | 0.546461 | 0.663999 | |
| sepal length (cm) | 0.754049 | 0.546461 | 1.000000 | 0.525911 | |
| sepal width (cm) | 0.560522 | 0.663999 | 0.525911 | 1.000000 | |
| 2.0 | petal length (cm) | 1.000000 | 0.322108 | 0.864225 | 0.401045 |
| petal width (cm) | 0.322108 | 1.000000 | 0.281108 | 0.537728 | |
| sepal length (cm) | 0.864225 | 0.281108 | 1.000000 | 0.457228 | |
| sepal width (cm) | 0.401045 | 0.537728 | 0.457228 | 1.000000 |
In dieser Korrelationsmatrix siehst du:
Alles abnehmende, aber positive Korrelationen – und deutlich positiver als die ursprüngliche negative Korrelation über alle Blumen hinweg.
Das ist aufschlussreich und erinnert daran, Daten gründlich zu analysieren.
Jetzt bist du bereit, die Periodizität deiner Zeitreihen über die Autokorrelationsfunktion zu betrachten.
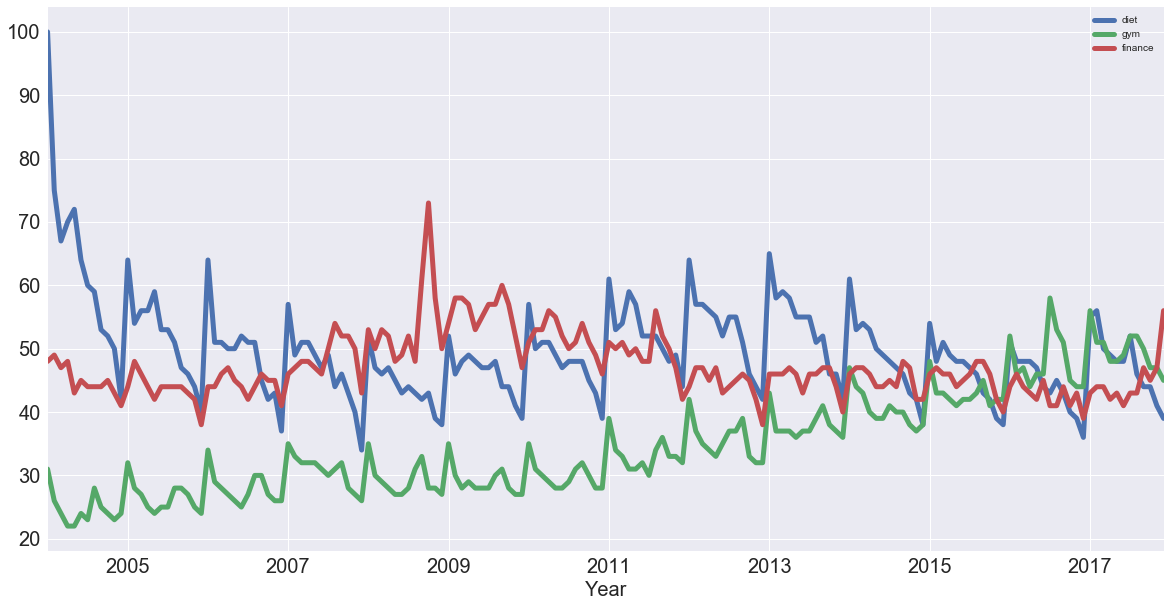
Zur Einstimmung plottest du noch einmal alle Zeitreihen:
df.plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
Dann berechnest du die Korrelationskoeffizienten aller Zeitreihen mit .corr():
df.corr()
| diet | gym | finance | |
|---|---|---|---|
| diet | 1.000000 | -0.100764 | -0.034639 |
| gym | -0.100764 | 1.000000 | -0.284279 |
| finance | -0.034639 | -0.284279 | 1.000000 |
Was sagen dir diese Werte?
Betrachten wir 'diet' und 'gym': Sie sind negativ korreliert. Spannend! Denk daran: Es gibt Trend- und saisonale Komponenten. Der Gesamtkorrelationskoeffizient erfasst beides. Visuell wirken die saisonalen Komponenten eher positiv korreliert, die Trends eher negativ.
Der Koeffizient fasst diese Effekte zusammen.
Als Nächstes plottest du die Differenzen erster Ordnung und berechnest deren Korrelation – das nähert die Korrelation der saisonalen Komponenten an. Das Entfernen des Trends kann verborgene saisonale Korrelationen sichtbar machen.
Starte mit dem Plot der ersten Differenzen über .diff() und .plot():
df.diff().plot(figsize=(20,10), linewidth=5, fontsize=20)
plt.xlabel('Year', fontsize=20);
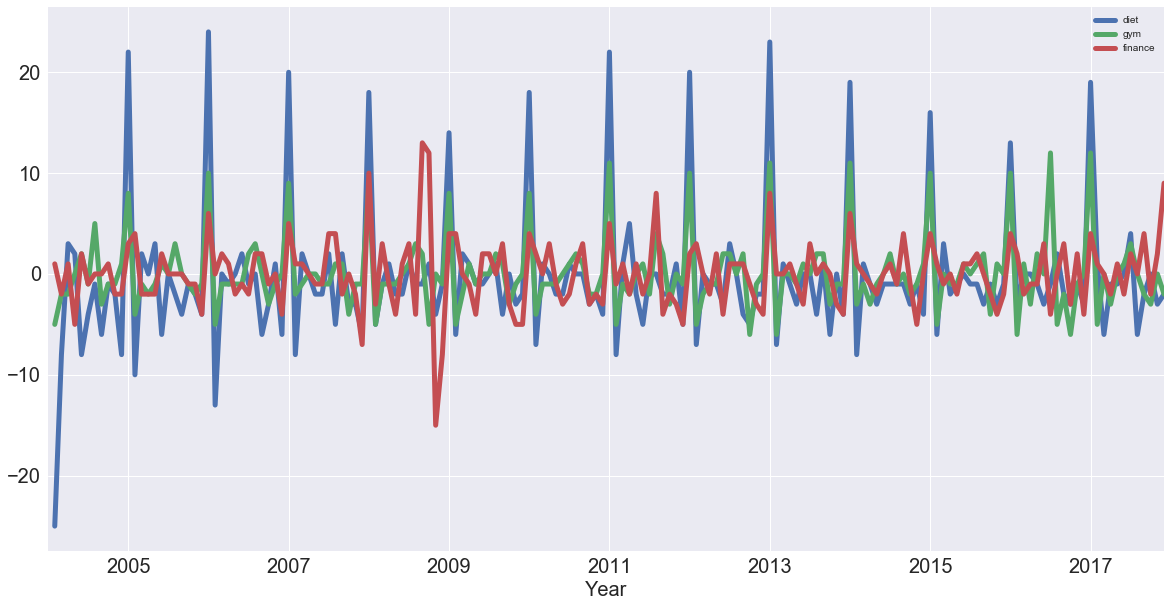
Du siehst, dass 'diet' und 'gym' nach Entfernen des Trends stark korreliert sind. Jetzt berechnest du die Korrelationskoeffizienten der ersten Differenzen:
df.diff().corr()
| diet | gym | finance | |
|---|---|---|---|
| diet | 1.000000 | 0.758707 | 0.373828 |
| gym | 0.758707 | 1.000000 | 0.301111 |
| finance | 0.373828 | 0.301111 | 1.000000 |
Hinweis: Vorher war die Korrelation leicht negativ, weil Trend und Saisonalität gemischt wurden. Jetzt – für die saisonale Komponente – sind 'diet' und 'gym' mit 0,76 hoch korreliert.
Nach Korrelation zwischen Variablen und Zeitreihen betrachtest du nun die Autokorrelation der Serie 'diet': Auf der x-Achse steht der Lag, auf der y-Achse, wie stark die Zeitreihe mit sich selbst bei diesem Lag korreliert.
Wiederholt sich die Reihe etwa alle zwei Tage, erwartest du einen Peak bei Lag 2.
Hier solltest du einen Peak bei 12 Monaten sehen: Die Zeitreihe ist mit sich selbst um zwölf Monate verschoben korreliert.
Nutze die plotting-Schnittstelle von pandas mit der Funktion autocorrelation_plot(), um 'diet' zu plotten:
pd.plotting.autocorrelation_plot(diet);
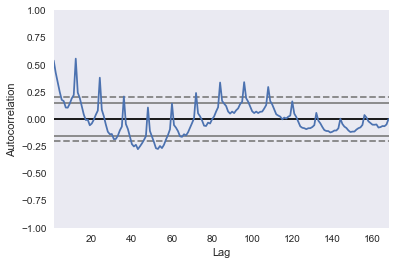
Mit mehr Lags auf der Achse würdest du sehen: Bei 12 Monaten gibt es einen großen Peak. Auch bei 24 Monaten (und 36) gibt es Peaks, aber je weiter weg, desto schwächer wird die Korrelation.
Klar: Bei Lag 0 ist die Korrelation mit sich selbst maximal.
Die gestrichelten Linien zeigen die statistische Signifikanz. Hier kannst du sagen, dass 'diet' mit einem Lag von zwölf Monaten tatsächlich autokorreliert ist.
Damit ist die Saisonalität mit 12-monatiger Wiederholung identifiziert.
In diesem Tutorial hast du viel abgedeckt: Du hast Google-Trends-Daten zu den Keywords "diet" und "gym" (sowie kurz "finance") untersucht und Konzepte wie Saisonalität, Trends, Korrelation und Autokorrelation bearbeitet.
Für alle, die direkt weitermachen wollen, hier zwei Ideen:
Erfahre mehr über Python
Kurs
Kurs
Kurs