
Cursus
Principes fondamentaux de l'apprentissage automatique en Python
16 h
Dans ce tutoriel, nous allons découvrir DeepChecks et apprendre à l'utiliser pour réaliser la validation des données et les tests de machine learning. Nous utiliserons également GitHub Actions pour automatiser les tests de modèle et enregistrer les résultats en tant qu'artifacts.
Au fil des étapes, nous aborderons les tests de machine learning et DeepChecks, exécuterons la suite d'intégrité des données DeepChecks et générerons un rapport complet. Nous produirons aussi des rapports de tests ML en lançant une suite d'évaluation de modèle, verrons comment exécuter un test unique au lieu d'une suite complète, automatiserons le flux de test avec GitHub Actions et enregistrerons le rapport de test ML comme Artifact GitHub.
Image de l'auteur
Le test de machine learning est un processus essentiel qui consiste à évaluer et valider les performances des modèles pour garantir leur équité, leur précision et leur robustesse. Il ne s'agit pas uniquement de précision et de performance. Il faut également examiner les biais du modèle, les faux positifs, les faux négatifs, différents indicateurs de performance, le débit d'inférence et la conformité du modèle avec l'éthique de l'IA.
Le processus de test comprend divers types d'évaluations : validation des données, validation croisée, F1-score, matrice de confusion, dérive de prédiction, dérive des données et tests de robustesse, chacun étant conçu pour vérifier un aspect différent de la performance et de la fiabilité du modèle.
Nous divisons également notre jeu de données en trois sous-ensembles afin d'évaluer le modèle pendant l'entraînement et après, sur des données jamais vues.
Les tests de machine learning sont une brique essentielle des applications d'IA, et les automatiser avec l'entraînement des modèles permet de déployer des systèmes d'IA fiables et utiles.
Si vous débutez en machine learning et souhaitez apprendre les bases, suivez le parcours de compétences Machine Learning Fundamentals avec Python. Ce cursus couvre les fondamentaux du machine learning avec Python, en commençant par l'apprentissage supervisé avec la bibliothèque scikit-learn.
DeepChecks est un package Python open source conçu pour faciliter les tests et la validation approfondis des modèles et des données de machine learning. Il propose un large éventail de contrôles intégrés pour détecter des problèmes liés aux performances des modèles, à la distribution et à l'intégrité des données, et bien plus. DeepChecks inclut des fonctionnalités de validation continue, garantissant que les modèles restent fiables et efficaces une fois déployés en conditions réelles.
Nous allons commencer par installer le package Python avec la commande pip.
%pip install deepchecks --upgrade -qPour ce tutoriel, nous utilisons les données de prêt issues des jeux de données DataCamp. Elles comportent 9¥78 lignes et des informations sur la structure du prêt, l'emprunteur et le remboursement intégral ou non du prêt.
Chargez le fichier CSV avec Pandas et affichez les 5 premières lignes.
import pandas as pd
loan_data = pd.read_csv("loan_data.csv")
loan_data.head()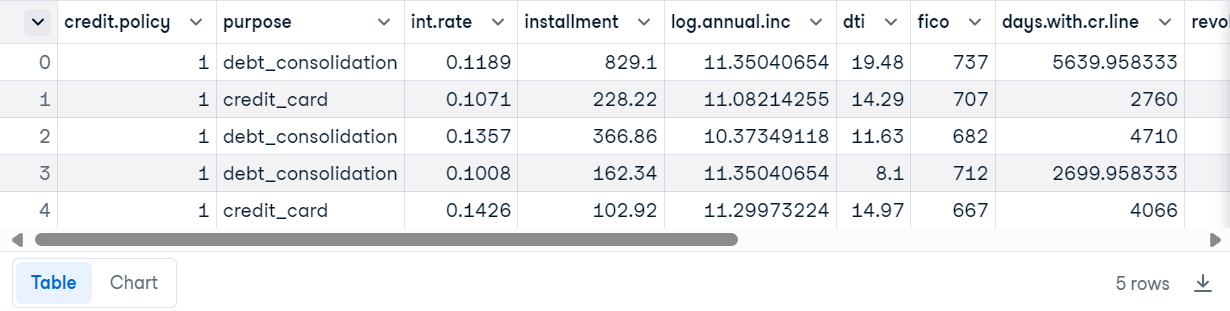
Créez le jeu de données DeepChecks à partir des données de prêt, du nom de la colonne de label et du nom de la caractéristique catégorielle.
from sklearn.model_selection import train_test_split
from deepchecks.tabular import Dataset

label_col = 'not.fully.paid'

deep_loan_data = Dataset(loan_data, label=label_col, cat_features=["purpose"])Nous allons utiliser une suite d'intégrité des données pour des données tabulaires. La suite exécutera tous les tests de manière autonome et générera un rapport interactif avec les résultats.
Pour cela, nous allons importer la suite d'intégrité des données, l'initialiser, puis l'exécuter en lui fournissant les données de prêt DeepChecks. Enfin, nous afficherons les résultats.
from deepchecks.tabular.suites import data_integrity

integ_suite = data_integrity()
suite_result = integ_suite.run(deep_loan_data)
suite_result.show()
Remarque : nous utilisons DataLab comme environnement de développement. L'usage d'ipywidgets est désactivé, ce qui empêche l'affichage des résultats. Nous utiliserons donc la fonction « show_in_iframe » pour afficher le résultat dans un iframe. Les résultats sont identiques quel que soit le mode d'affichage.
suite_result.show_in_iframe()Notre rapport d'intégrité des données inclut des résultats sur :
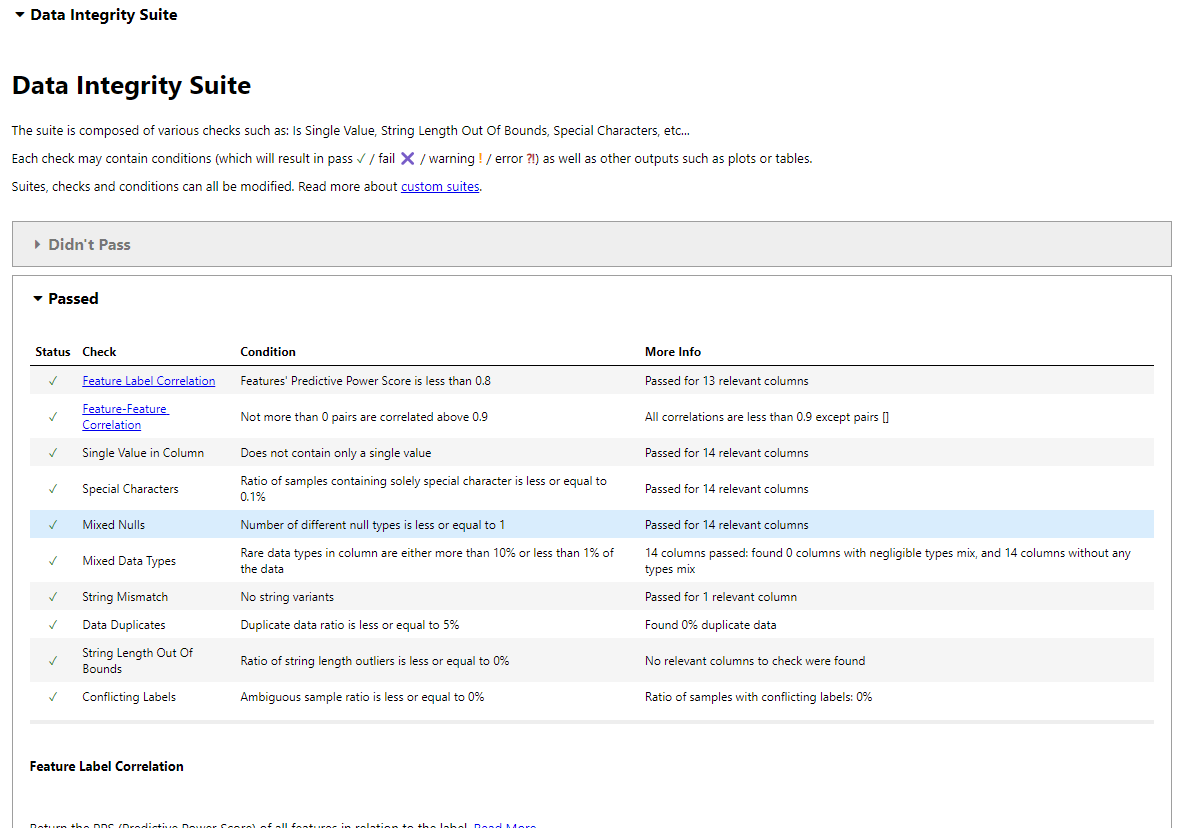
Résultats du test d'intégrité des données dans Jupyter Notebook.
Vous pouvez également enregistrer les résultats en HTML et les partager avec vos collègues.
suite_result.save_as_html()'output.html'Lancer la suite complète sur un grand jeu de données peut s'avérer inefficace, car la génération des résultats sera longue. Vous pouvez plutôt exécuter quelques tests individuels pertinents pour vos données et générer votre propre rapport.
Pour exécuter un test unique, importez les checks tabulaires, initialisez le check et lancez-le avec les données de prêt DeepChecks. Ensuite, affichez les valeurs au lieu de générer un rapport interactif via la fonction results.value.
from deepchecks.tabular.checks import IsSingleValue, DataDuplicates

result = IsSingleValue().run(deep_loan_data)
result.value
Comme on le voit, l'outil affiche le nombre de valeurs uniques présentes dans chaque colonne.
{'credit.policy': 2,
 'purpose': 7,
 'int.rate': 249,
 'installment': 4788,
 'log.annual.inc': 1987,
 'dti': 2529,
 'fico': 44,
 'days.with.cr.line': 2687,
 'revol.bal': 7869,
 'revol.util': 1035,
 'inq.last.6mths': 28,
 'delinq.2yrs': 11,
 'pub.rec': 6,
 'not.fully.paid': 2}
Vérifions maintenant la présence de doublons dans nos données.
result = DataDuplicates().run(deep_loan_data)
result.value
Nous n'avons aucun doublon dans le jeu de données.
0.0Dans cette section, nous allons combiner plusieurs modèles et les entraîner sur le jeu de données prétraité. Ensuite, pour générer un rapport de test de modèle, nous exécuterons une suite d'évaluation sur les jeux d'entraînement et de test.
from sklearn.linear_model import LogisticRegression
from sklearn.ensemble import RandomForestClassifier
from sklearn.ensemble import VotingClassifier
from sklearn.naive_bayes import GaussianNB
from sklearn.preprocessing import LabelEncoder

# Train test split
df_train, df_test = train_test_split(loan_data, stratify=loan_data[label_col], random_state=0)

# Encode the 'purpose' column
label_encoder = LabelEncoder()
df_train['purpose'] = label_encoder.fit_transform(df_train['purpose'])
df_test['purpose'] = label_encoder.fit_transform(df_test['purpose'])

# Define models
model_1 = LogisticRegression(random_state=1, max_iter=10000)
model_2 = RandomForestClassifier(n_estimators=50, random_state=1)
model_3 = GaussianNB()

# Create the VotingClassifier
clf_model = VotingClassifier(
    estimators=[('lr', model_1), ('rf', model_2), ('svc', model_3)],
    voting='soft'
)

# Train the model
clf_model.fit(df_train.drop(label_col, axis=1), df_train[label_col])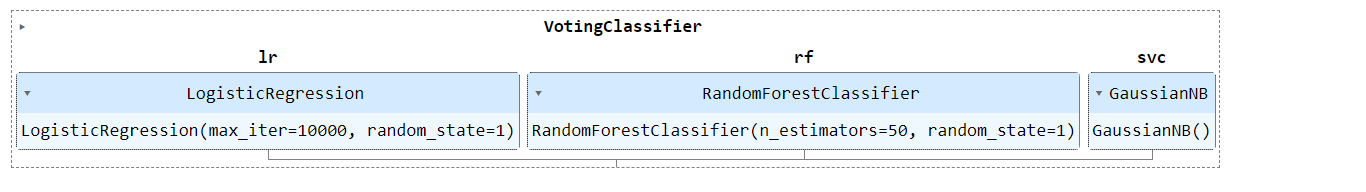
Nous allons exécuter la suite d'évaluation de modèle DeepChecks pour évaluer les performances.
from deepchecks.tabular.suites import model_evaluation

deep_train = Dataset(df_train, label=label_col, cat_features=[])
deep_test =  Dataset(df_test,  label=label_col, cat_features=[])

evaluation_suite = model_evaluation()
suite_result = evaluation_suite.run(deep_train, deep_test, clf_model)
suite_result.show_in_iframe()
Notre rapport d'évaluation de modèle inclut des résultats sur :
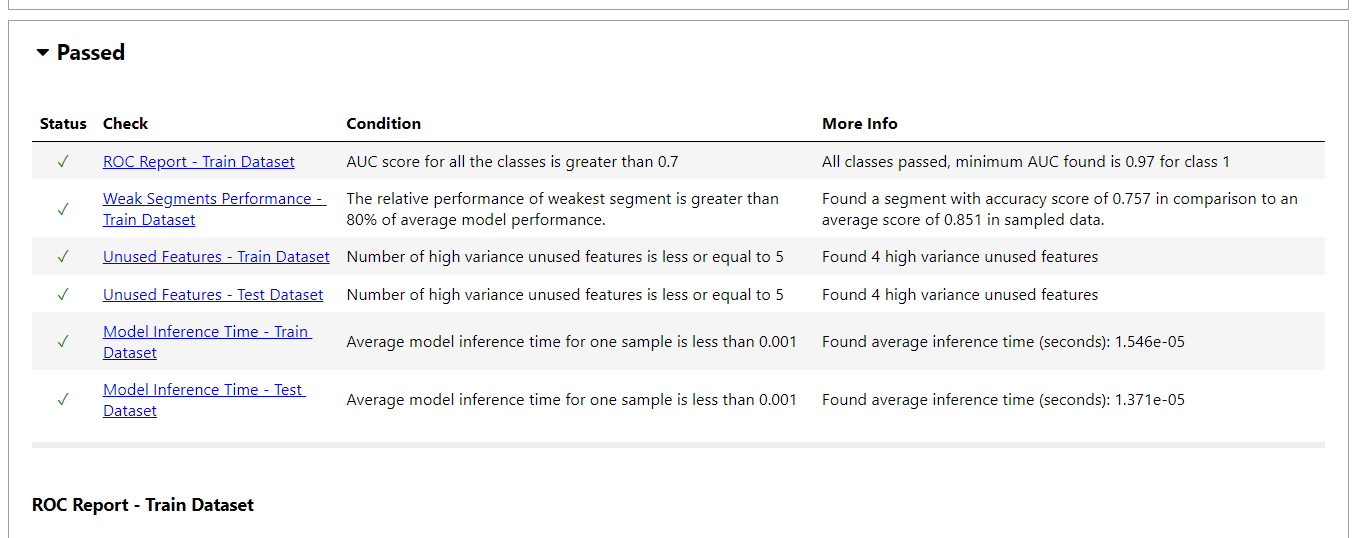
to_json().suite_result.to_json()Comme pour la validation des données, vous pouvez lancer un test de machine learning isolé. Ici, nous allons vérifier la dérive des labels entre l'entraînement et le test afin de détecter d'éventuels changements dans le temps.
from deepchecks.tabular.checks import LabelDrift
check = LabelDrift()
result = check.run(deep_train, deep_test)
result.value
Aucune dérive n'est détectée dans les données.
{'Drift score': 0.0, 'Method': "Cramer's V"}Si vous rencontrez des difficultés pour exécuter les suites de validation des données et d'évaluation des modèles, consultez l'espace de travail DataLab : Machine Learning Testing with DeepChecks.
Si vous préférez des tests de machine learning « manuels », suivez le tutoriel Machine Learning Experimentation pour apprendre à structurer, journaliser et analyser vos expériences de ML avec Weights & Biases.
Automatisons la validation des données, l'entraînement et l'évaluation du modèle avec GitHub Actions et enregistrons les résultats dans un fichier zip.
L'automatisation des tests de machine learning est une composante clé d'un pipeline MLOps. Pour en savoir plus, suivez le parcours de compétences MLOps Fundamentals. Vous y apprendrez les principes fondamentaux de la mise en production des modèles de ML et de leur supervision pour créer de la valeur métier.
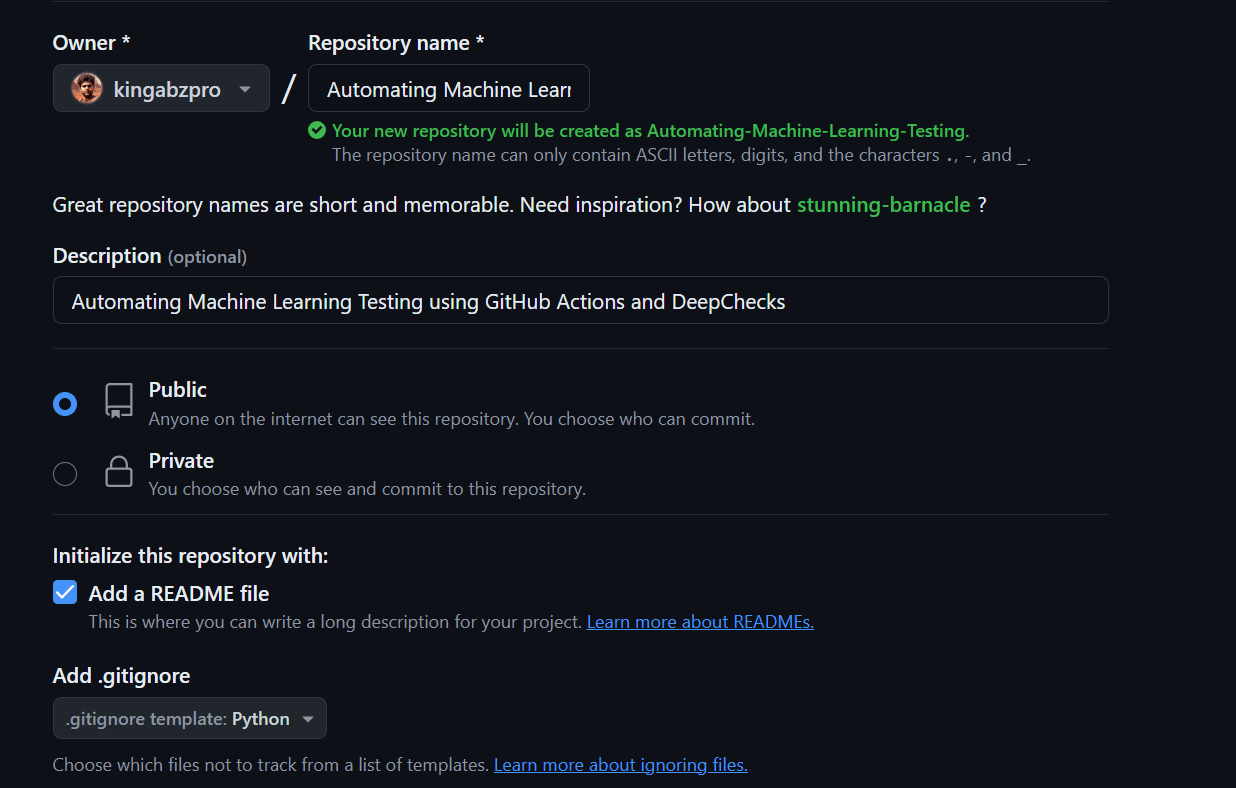
$ cd C:\Repository\GitHub\
$ git clone https://github.com/kingabzpro/Automating-Machine-Learning-Testing.git

$ cd .\Automating-Machine-Learning-Testing\
$ mkdir data
$ mv -v ".Downloads\loan_data.csv" ".\Automating-Machine-Learning-Testing\data"
$ code -r data_validation.pyimport pandas as pd
from deepchecks.tabular import Dataset
from deepchecks.tabular.suites import data_integrity
# Load the loan data from a CSV file
loan_data = pd.read_csv("data/loan_data.csv")
# Define the label column
label_col = "not.fully.paid"
# Create a Deepchecks Dataset object with the loan data
deep_loan_data = Dataset(loan_data, label=label_col, cat_features=["purpose"])
# Initialize the data integrity suite
integ_suite = data_integrity()
# Run the data integrity suite on the dataset
suite_result = integ_suite.run(deep_loan_data)
# Save the results of the data integrity suite as an HTML file
suite_result.save_as_html("results/data_validation.html")$ code -r train_validation.pyimport pandas as pd
from sklearn.ensemble import RandomForestClassifier, VotingClassifier
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split
from sklearn.naive_bayes import GaussianNB
from sklearn.preprocessing import LabelEncoder, StandardScaler
from deepchecks.tabular import Dataset
from deepchecks.tabular.suites import model_evaluation
# Load the loan data from a CSV file
loan_data = pd.read_csv("data/loan_data.csv")
# Define the label column
label_col = "not.fully.paid"
# Train test split
df_train, df_test = train_test_split(
loan_data, stratify=loan_data[label_col], random_state=0
)
# Encode the 'purpose' column
label_encoder = LabelEncoder()
df_train["purpose"] = label_encoder.fit_transform(df_train["purpose"])
df_test["purpose"] = label_encoder.transform(df_test["purpose"])
# Standardize the features
scaler = StandardScaler()
df_train[df_train.columns.difference([label_col])] = scaler.fit_transform(df_train[df_train.columns.difference([label_col])])
df_test[df_test.columns.difference([label_col])] = scaler.transform(df_test[df_test.columns.difference([label_col])])
# Define models
model_1 = LogisticRegression(random_state=1, max_iter=10000)
model_2 = RandomForestClassifier(n_estimators=50, random_state=1)
model_3 = GaussianNB()
# Create the VotingClassifier
clf_model = VotingClassifier(
estimators=[("lr", model_1), ("rf", model_2), ("gnb", model_3)], voting="soft"
)
# Train the model
clf_model.fit(df_train.drop(label_col, axis=1), df_train[label_col])
# Calculate the accuracy score using the .score function
accuracy = clf_model.score(df_test.drop(label_col, axis=1), df_test[label_col])
# Print the accuracy score
print(f"Accuracy: {accuracy:.2f}")
# Create Deepchecks datasets
deep_train = Dataset(df_train, label=label_col, cat_features=["purpose"])
deep_test = Dataset(df_test, label=label_col, cat_features=["purpose"])
# Run the evaluation suite
evaluation_suite = model_evaluation()
suite_result = evaluation_suite.run(deep_train, deep_test, clf_model)
# Save the results as HTML
suite_result.save_as_html("results/model_validation.html")Si vous découvrez GitHub Actions, commencez par le tutoriel « GitHub Actions and MakeFile : A Hands-on Introduction » avant de vous lancer. Il explique en détail le fonctionnement de GitHub Actions avec des exemples de code.
$ git add .
$ git commit -m "Data and Validation files"
$ git push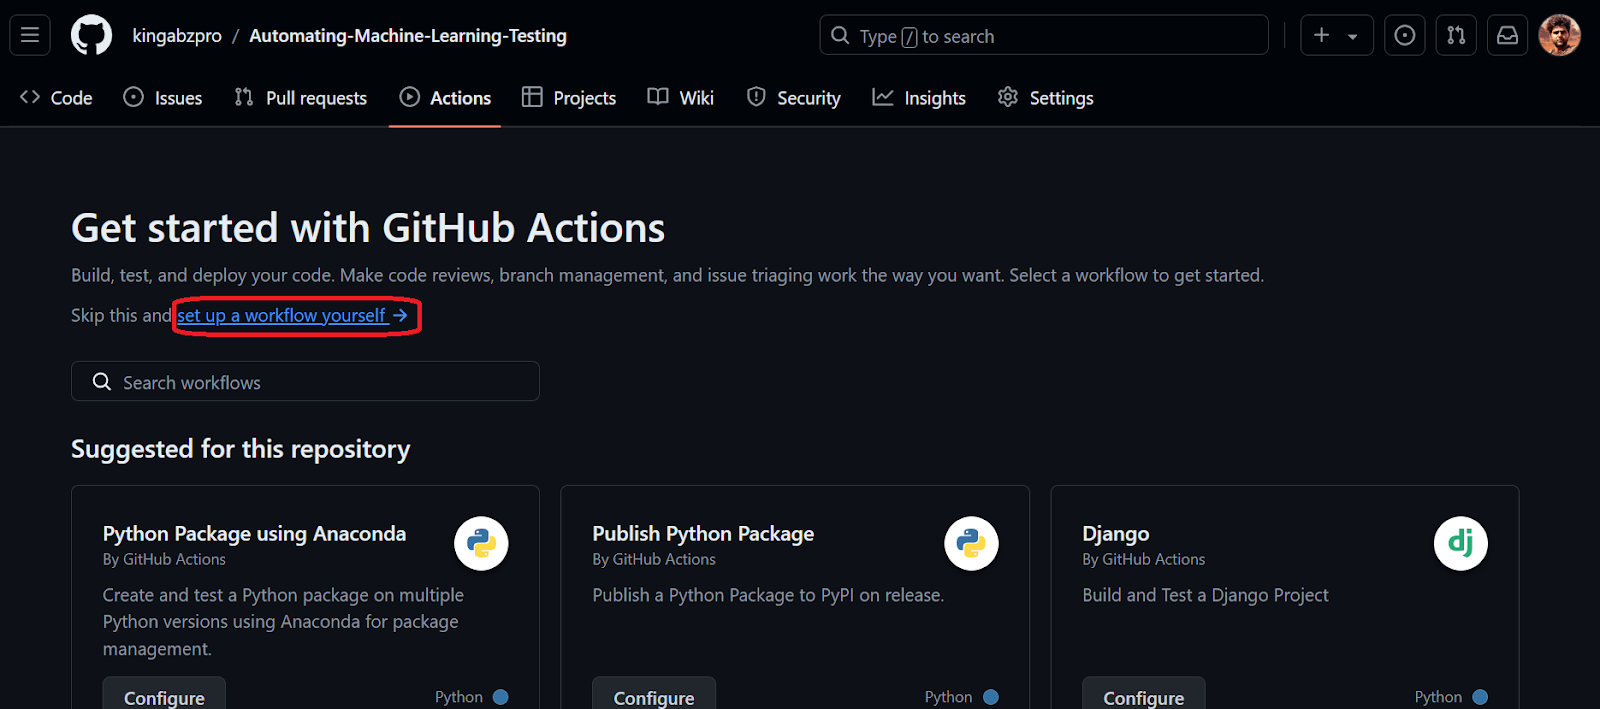
main.yml. Copiez-collez le code suivant. Ce workflow commence par configurer l'environnement et installer le package DeepChecks. Il crée ensuite le dossier, lance la validation des données et l'évaluation du modèle, puis enregistre les résultats comme Artifact GitHub.name: Model Training and Validation
on:
push:
branches: [ main ]
pull_request:
branches: [ main ]
jobs:
build:
runs-on: ubuntu-latest
steps:
- name: Checkout Repository
uses: actions/checkout@v4
- name: Set up Python 3.10
uses: actions/setup-python@v5
with:
python-version: '3.10'
- name: Install dependencies
run: |
python -m pip install --upgrade pip
pip install deepchecks
- name: Create a folder
run: |
mkdir -p results
- name: Validate Data
run: |
python data_validation.py
- name: Validate Model Performance
run: |
python train_validation.py
- name: Archive Deepchecks Results
uses: actions/upload-artifact@v4
if: always()
with:
name: deepchecks results
path: results/*_validation.html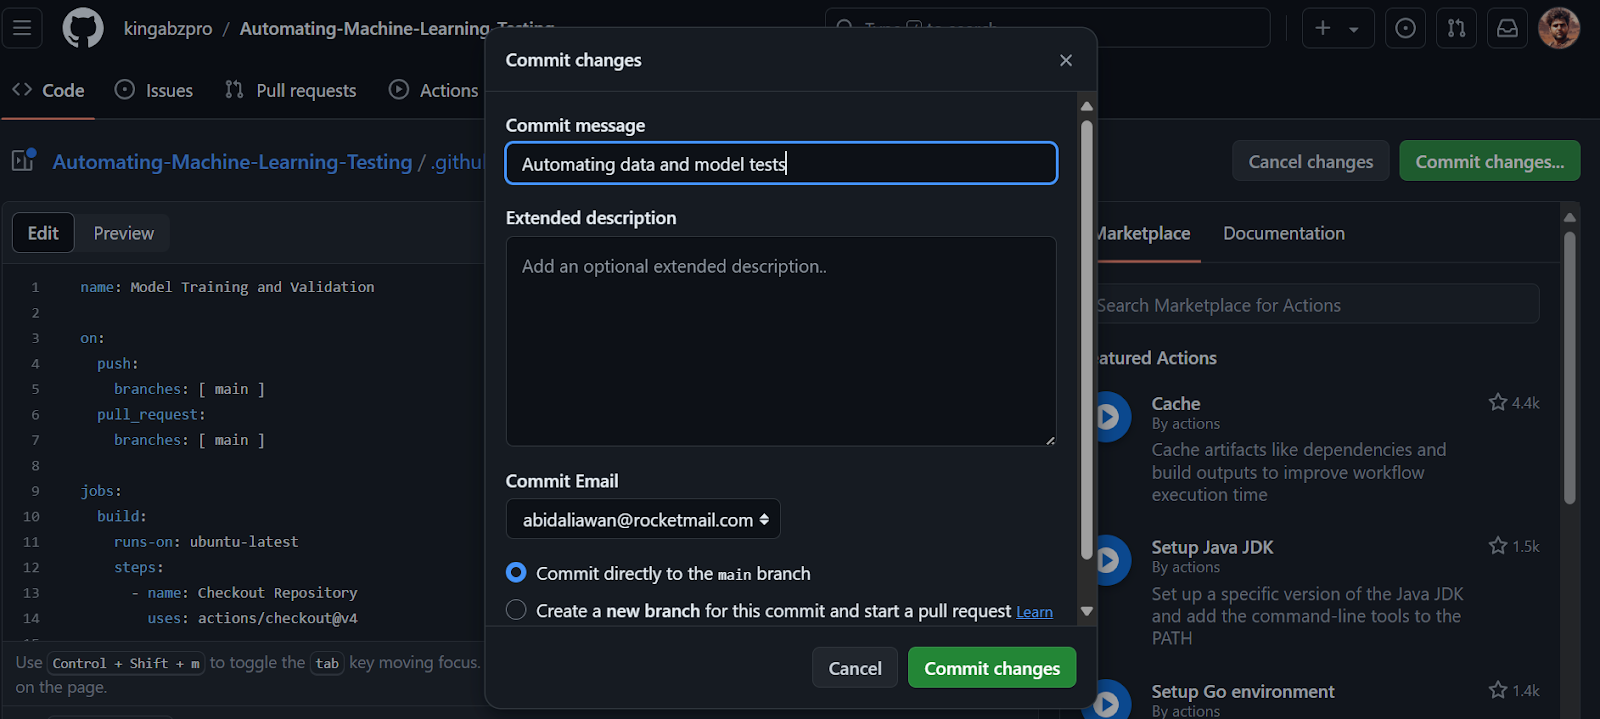
En validant sur la branche principale, l'exécution du workflow se démarre. Pour consulter les logs, allez dans l'onglet « Actions » et cliquez sur l'exécution liée au message de commit.
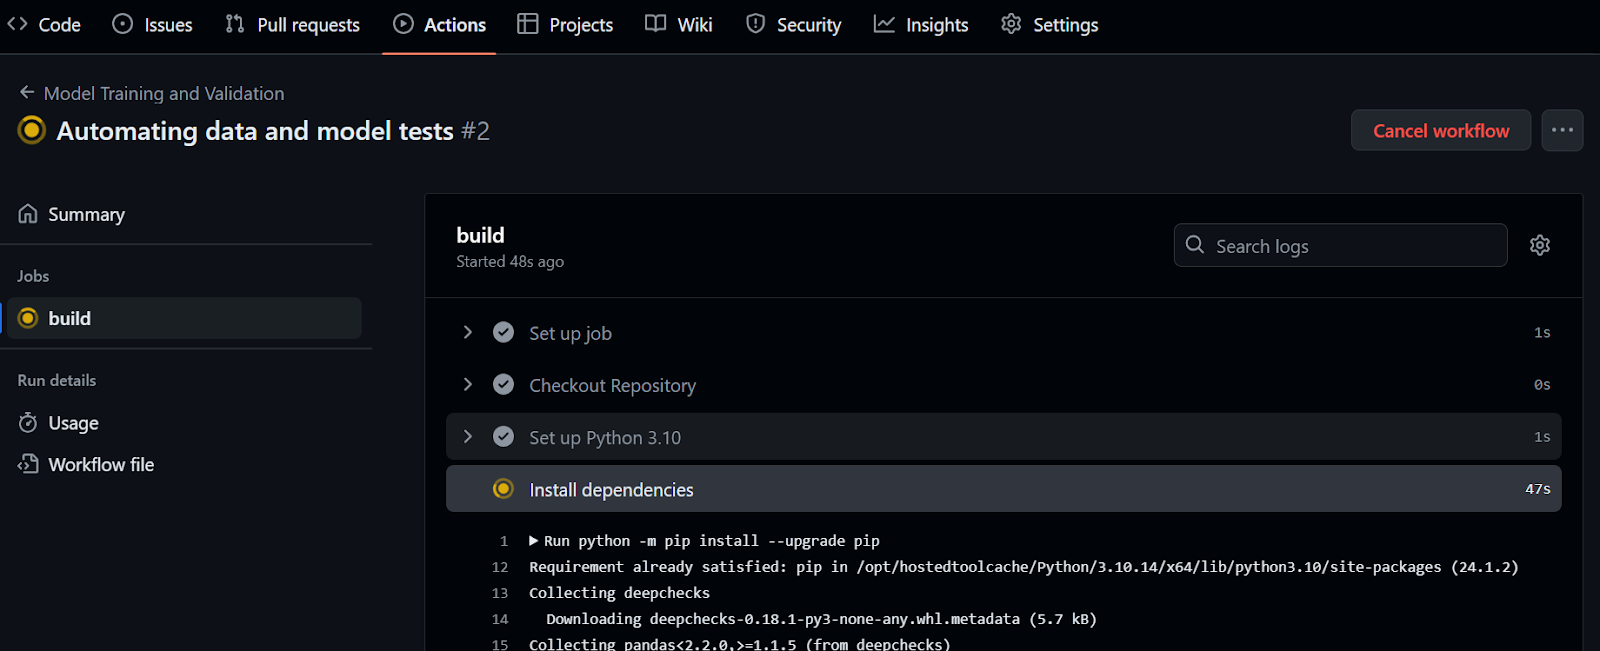
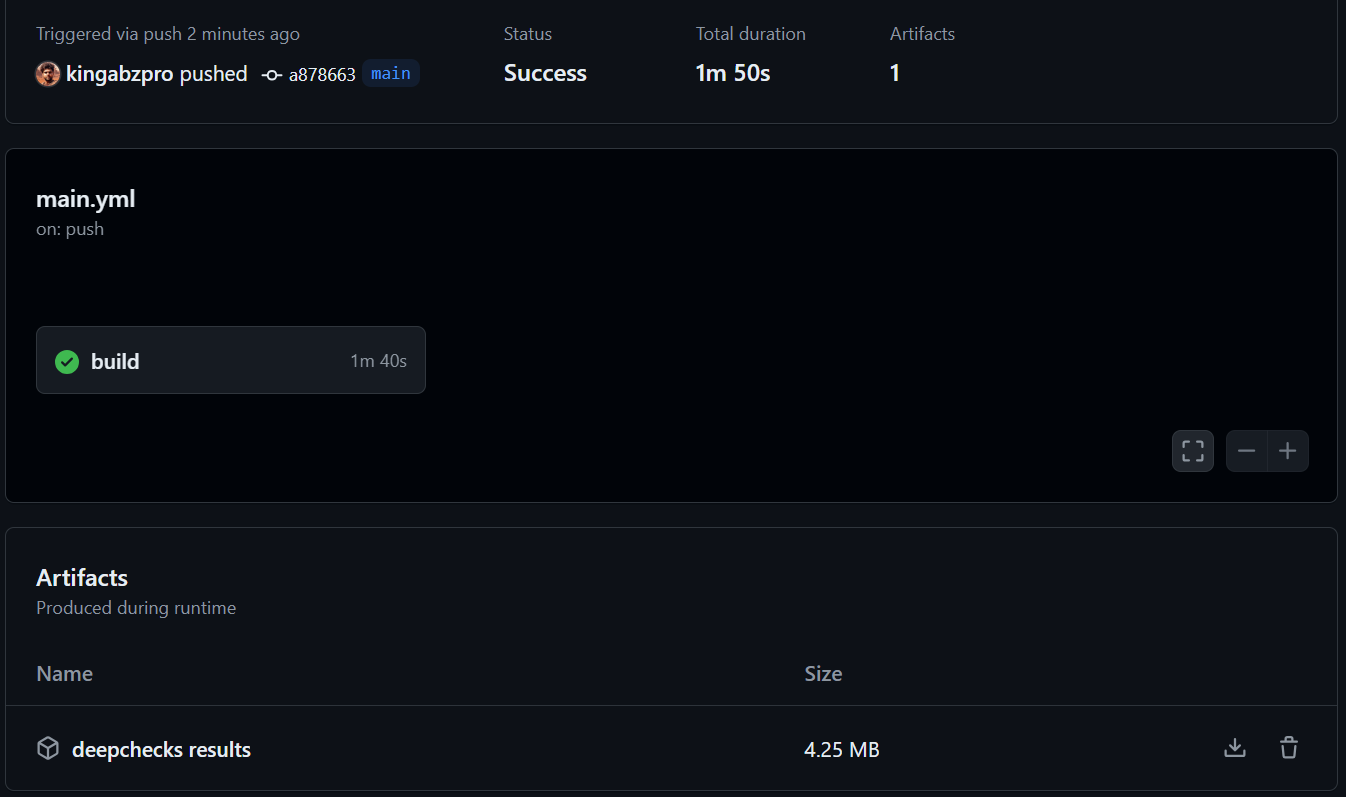
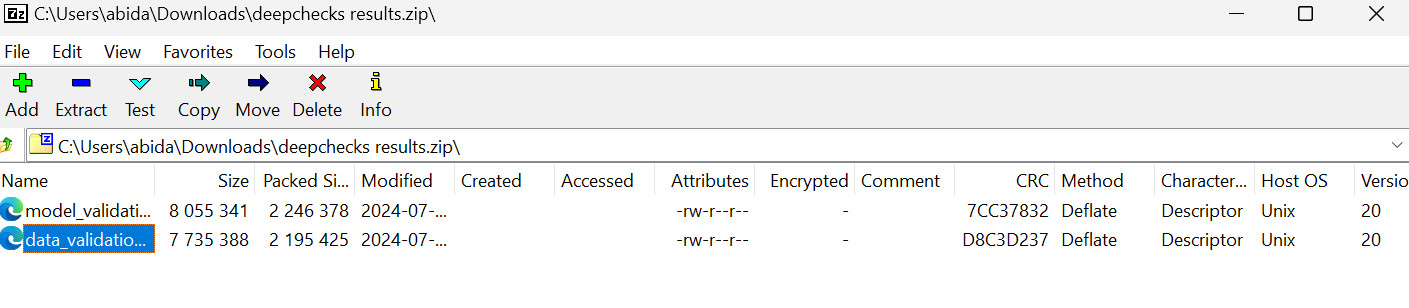
Consultez le dépôt GitHub kingabzpro/Automating-Machine-Learning-Testing comme guide. Il contient les données, le code Python, les fichiers de workflow et autres ressources pour exécuter des tests entièrement automatisés.
Automatiser toute la chaîne de machine learning suppose de maîtriser plusieurs processus et outils. Pour vous y former, suivez le cours MLOps Deployment and Lifecycle. Ce cours présente les frameworks MLOps modernes, en mettant l'accent sur le cycle de vie et le déploiement des modèles.
En automatisant le processus de test, les développeurs peuvent valider rapidement et efficacement la précision et la robustesse des modèles sur des jeux de données vastes et complexes. Les tests automatisés permettent d'identifier tôt des problèmes comme les incohérences, la dérive des données ou les biais du modèle, souvent difficiles à déceler manuellement. Cela fait gagner du temps et améliore la capacité du modèle à produire des prédictions justes et équitables.
Dans ce tutoriel, nous avons vu les tests de machine learning et l'utilisation de DeepChecks pour la validation des données et des modèles. Nous avons aussi automatisé les tests et enregistré les résultats en tant qu'artifacts avec GitHub Actions.
Si ce tutoriel vous a plu et que vous envisagez de démarrer une carrière en machine learning, inscrivez-vous au parcours de carrière Machine Learning Scientist with Python. Suivez tous les cours en 3 mois pour acquérir les compétences nécessaires au métier de data scientist spécialisé en machine learning.
Meilleures formations en machine learning
Cursus
Cours
Cursus