
Lernpfad
Grundlagen des maschinellen Lernens in Python
16 Std.
In diesem Tutorial lernst du DeepChecks kennen und erfährst, wie du damit Datenvalidierung und Machine-Learning-Tests durchführst. Außerdem nutzen wir GitHub Actions, um das Modell-Testing zu automatisieren und die Ergebnisse als Artefakte zu speichern.
Schritt für Schritt schauen wir uns Machine-Learning-Tests und DeepChecks an, führen die Data-Integrity-Suite aus und erstellen einen umfassenden Bericht. Wir generieren zudem Testberichte für ML-Modelle mit einer Model-Evaluation-Suite, führen einzelne Checks statt kompletter Suiten aus, automatisieren den Test-Workflow mit GitHub Actions und speichern den Testbericht als GitHub-Artifact.
Bild: Autor
Machine-Learning-Testing ist ein zentraler Prozess zur Bewertung und Validierung der Leistung von ML-Modellen, um Fairness, Genauigkeit und Robustheit sicherzustellen. Es geht nicht nur um Accuracy und reine Performance. Wir betrachten auch Modellverzerrungen, False Positives, False Negatives, verschiedene Performancemetriken, Durchsatz sowie die Ausrichtung des Modells an KI-Ethik.
Zum Testing gehören unterschiedliche Prüfungen wie Datenvalidierung, Cross-Validation, F1-Score, Confusion Matrix, Prediction Drift, Data Drift und Robustheitstests. Jede davon beleuchtet einen anderen Aspekt von Modellleistung und Zuverlässigkeit.
Außerdem teilen wir den Datensatz in drei Splits, um das Modell während und nach dem Training auf einem unbekannten Datensatz zu evaluieren.
Machine-Learning-Testing ist ein wesentlicher Bestandteil von KI-Anwendungen. In Kombination mit automatisiertem Training entstehen verlässliche KI-Systeme, die für Menschen funktionieren.
Wenn du neu im Machine Learning bist und die Grundlagen lernen möchtest, starte mit dem Machine Learning Fundamentals Skill Track mit Python. Dieser Track führt dich in die ML-Grundlagen mit Python ein, beginnend mit Supervised Learning in scikit-learn.
DeepChecks ist ein Open-Source-Python-Paket für umfassende Tests und Validierung von ML-Modellen und Daten. Es liefert zahlreiche eingebaute Checks, um Probleme bei Modellleistung, Datenverteilung, Datenintegrität und mehr zu erkennen. DeepChecks unterstützt kontinuierliche Validierung, damit Modelle auch im Produktionseinsatz verlässlich bleiben.
Wir starten mit der Installation des Python-Pakets per pip.
%pip install deepchecks --upgrade -qFür dieses Tutorial nutzen wir die Loan Data aus den DataCamp-Datasets. Sie umfasst 9.578 Zeilen mit Informationen zur Kreditstruktur, zum Kreditnehmenden und dazu, ob der Kredit vollständig zurückgezahlt wurde.
Lade die CSV-Datei mit Pandas und zeige die ersten 5 Zeilen an.
import pandas as pd
loan_data = pd.read_csv("loan_data.csv")
loan_data.head()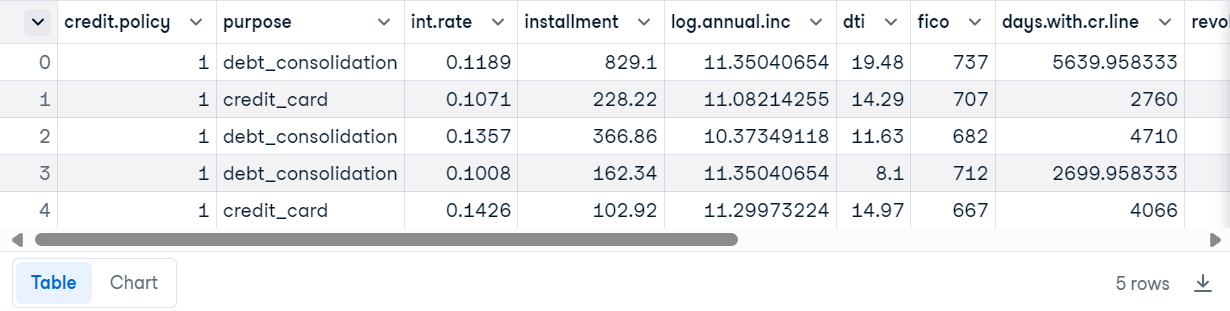
Erstelle das DeepChecks-Dataset anhand des Kreditdatensatzes, dem Labelspaltennamen und dem Namen des kategorialen Features.
from sklearn.model_selection import train_test_split
from deepchecks.tabular import Dataset

label_col = 'not.fully.paid'

deep_loan_data = Dataset(loan_data, label=label_col, cat_features=["purpose"])Wir nutzen die Data-Integrity-Suite für tabellarische Daten. Die Suite führt alle Checks automatisch aus und erzeugt einen interaktiven Bericht mit den Ergebnissen.
Dazu importieren wir die Suite, initialisieren sie, führen sie auf den DeepChecks-Kreditdaten aus und zeigen anschließend die Resultate an.
from deepchecks.tabular.suites import data_integrity

integ_suite = data_integrity()
suite_result = integ_suite.run(deep_loan_data)
suite_result.show()
Hinweis: Wir verwenden DataLab als Entwicklungsumgebung. ipywidgets sind deaktiviert und können die Ergebnisse nicht anzeigen. Stattdessen nutzen wir die Funktion "show_in_iframe", um die Resultate als Iframe darzustellen. Die Inhalte sind auf allen Ebenen identisch.
suite_result.show_in_iframe()Unser Data-Integrity-Report enthält Ergebnisse zu:
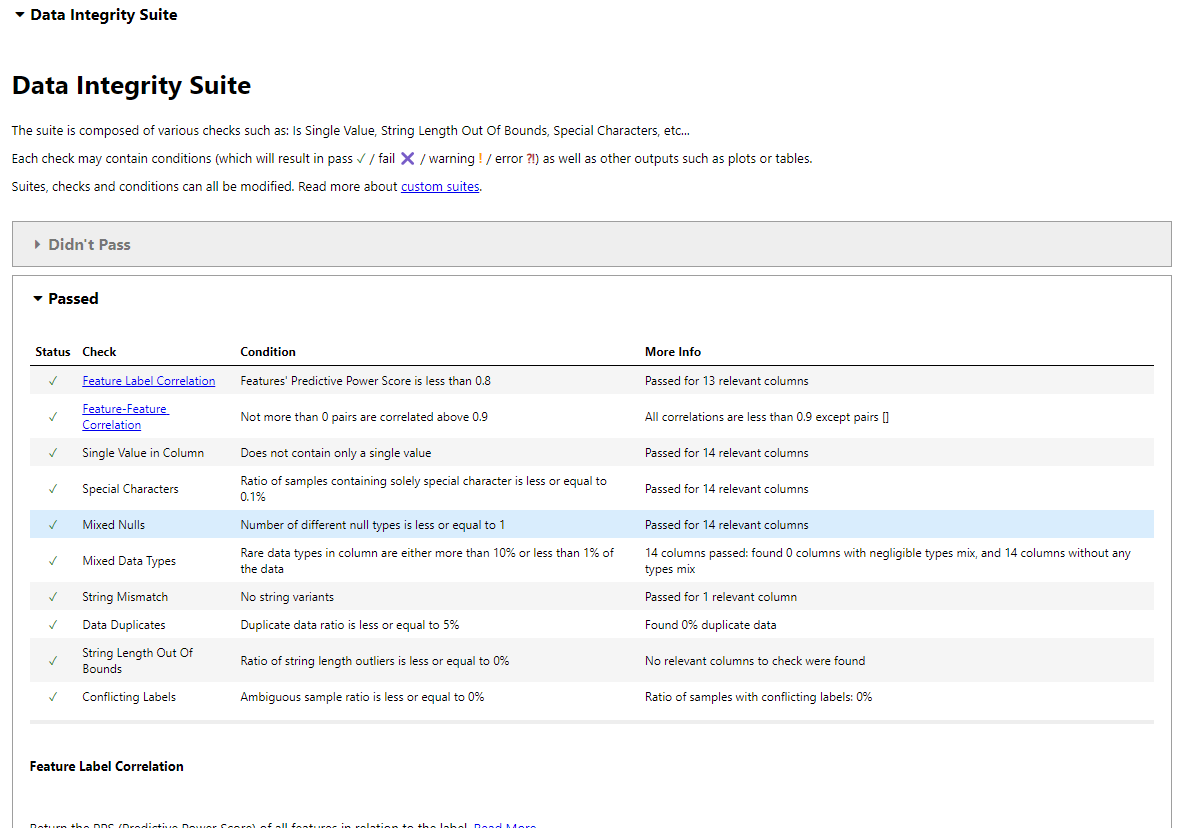
Ergebnisse des Data-Integrity-Tests im Jupyter Notebook.
Du kannst die Ergebnisse auch als HTML-Datei speichern und mit Kolleginnen und Kollegen teilen.
suite_result.save_as_html()'output.html'Bei großen Datensätzen ist es oft ineffizient, die komplette Suite laufen zu lassen. Stattdessen kannst du einige relevante Einzeltests für deine Daten ausführen und deinen eigenen Bericht erstellen.
Um einen einzelnen Test zu starten, importierst du die tabellarischen Checks, initialisierst den Check und führst ihn mit den DeepChecks-Kreditdaten aus. Danach gibst du die Werte direkt aus, statt einen interaktiven Bericht zu erzeugen, und zwar mit der Funktion results.value.
from deepchecks.tabular.checks import IsSingleValue, DataDuplicates

result = IsSingleValue().run(deep_loan_data)
result.value
Wie zu sehen ist, werden die Anzahlen der eindeutigen Werte je Spalte angezeigt.
{'credit.policy': 2,
 'purpose': 7,
 'int.rate': 249,
 'installment': 4788,
 'log.annual.inc': 1987,
 'dti': 2529,
 'fico': 44,
 'days.with.cr.line': 2687,
 'revol.bal': 7869,
 'revol.util': 1035,
 'inq.last.6mths': 28,
 'delinq.2yrs': 11,
 'pub.rec': 6,
 'not.fully.paid': 2}
Lass uns prüfen, ob es Duplikate in den Daten gibt.
result = DataDuplicates().run(deep_loan_data)
result.value
Unser Datensatz enthält keine Duplikate.
0.0In diesem Abschnitt ensemble wir mehrere Modelle und trainieren sie auf dem aufbereiteten Kreditsatz. Anschließend erstellen wir einen Testbericht, indem wir die Model-Evaluation-Suite auf Trainings- und Testdaten laufen lassen.
from sklearn.linear_model import LogisticRegression
from sklearn.ensemble import RandomForestClassifier
from sklearn.ensemble import VotingClassifier
from sklearn.naive_bayes import GaussianNB
from sklearn.preprocessing import LabelEncoder

# Train test split
df_train, df_test = train_test_split(loan_data, stratify=loan_data[label_col], random_state=0)

# Encode the 'purpose' column
label_encoder = LabelEncoder()
df_train['purpose'] = label_encoder.fit_transform(df_train['purpose'])
df_test['purpose'] = label_encoder.fit_transform(df_test['purpose'])

# Define models
model_1 = LogisticRegression(random_state=1, max_iter=10000)
model_2 = RandomForestClassifier(n_estimators=50, random_state=1)
model_3 = GaussianNB()

# Create the VotingClassifier
clf_model = VotingClassifier(
    estimators=[('lr', model_1), ('rf', model_2), ('svc', model_3)],
    voting='soft'
)

# Train the model
clf_model.fit(df_train.drop(label_col, axis=1), df_train[label_col])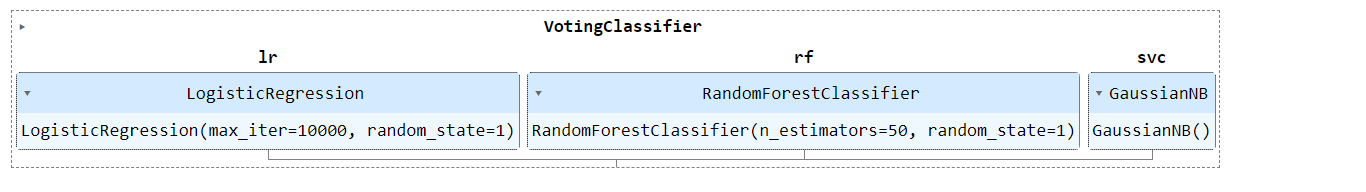
Wir führen die DeepChecks-Model-Evaluation-Suite aus, um die Modellleistung zu bewerten.
from deepchecks.tabular.suites import model_evaluation

deep_train = Dataset(df_train, label=label_col, cat_features=[])
deep_test =  Dataset(df_test,  label=label_col, cat_features=[])

evaluation_suite = model_evaluation()
suite_result = evaluation_suite.run(deep_train, deep_test, clf_model)
suite_result.show_in_iframe()
Unser Model-Evaluation-Report enthält Ergebnisse zu:
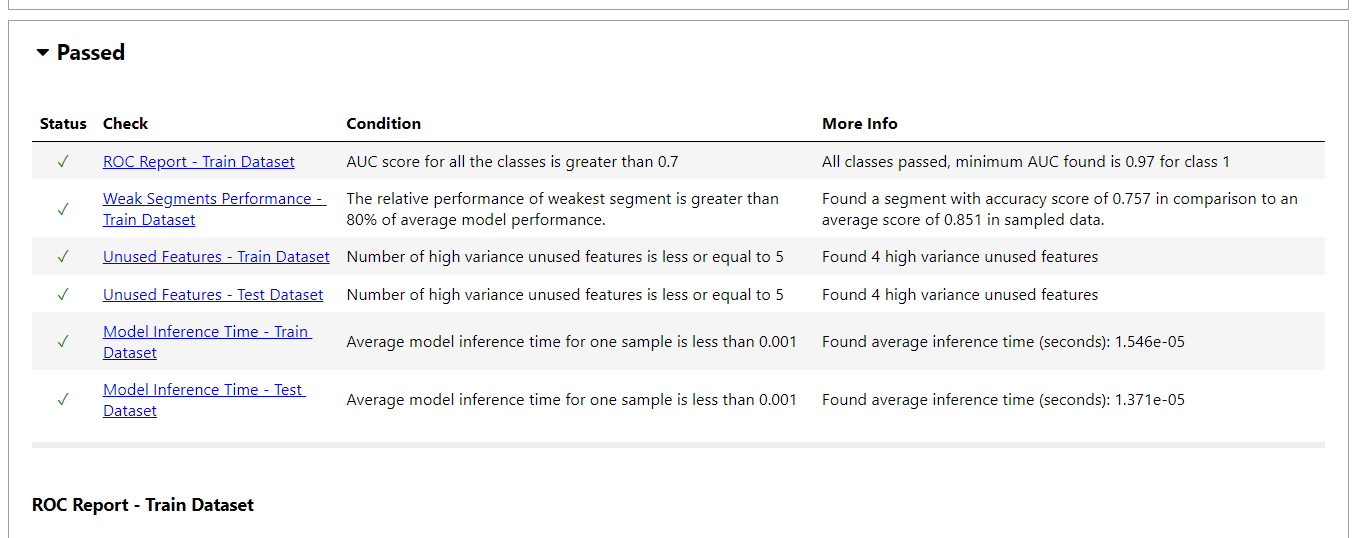
to_json(). suite_result.to_json()Wie bei der Datenvalidierung kannst du auch einzelne ML-Checks ausführen. In unserem Fall prüfen wir Label Drift auf Train-/Test-Split, um zu sehen, ob sich die Labels über die Zeit verändert haben.
from deepchecks.tabular.checks import LabelDrift
check = LabelDrift()
result = check.run(deep_train, deep_test)
result.value
Es wurde kein Drift in den Daten festgestellt.
{'Drift score': 0.0, 'Method': "Cramer's V"}Wenn du Schwierigkeiten beim Ausführen der Data-Validation- und Model-Evaluation-Suiten hast, wirf einen Blick in den DataLab-Workspace Machine Learning Testing with DeepChecks.
Wenn du dich für „manuelles“ ML-Testing interessierst, folge dem Tutorial Machine Learning Experimentation und lerne, wie du ML-Experimente mit Weights & Biases strukturierst, protokollierst und auswertest.
Lass uns Datenvalidierung, Modelltraining und -evaluation mit GitHub Actions automatisieren und die Ergebnisse als ZIP-Datei speichern.
Automatisiertes ML-Testing ist ein fester Bestandteil der MLOps-Pipeline. Mehr dazu lernst du im MLOps Fundamentals Skill Track. In dieser Kursreihe lernst du die Grundlagen, wie ML-Modelle in Produktion gebracht und überwacht werden, um Business-Mehrwert zu liefern.
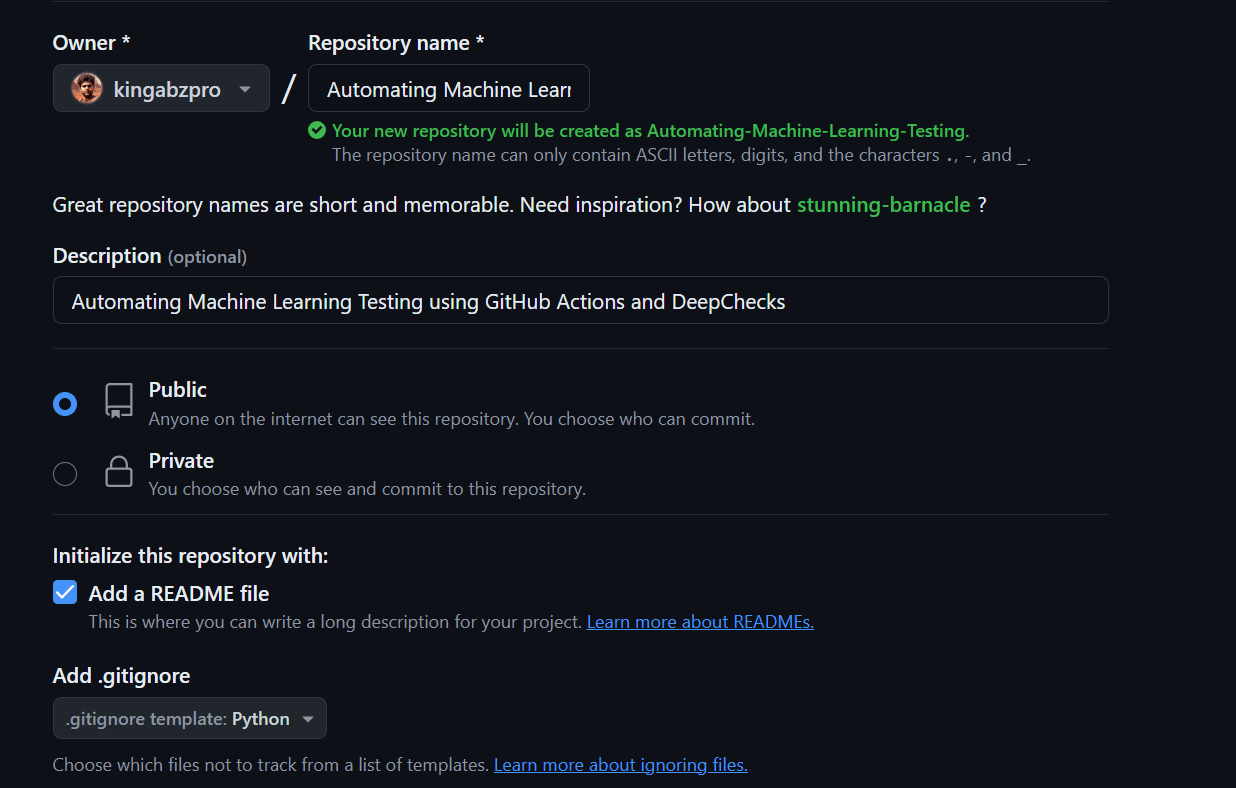
$ cd C:\Repository\GitHub\
$ git clone https://github.com/kingabzpro/Automating-Machine-Learning-Testing.git

$ cd .\Automating-Machine-Learning-Testing\
$ mkdir data
$ mv -v ".Downloads\loan_data.csv" ".\Automating-Machine-Learning-Testing\data"
$ code -r data_validation.pyimport pandas as pd
from deepchecks.tabular import Dataset
from deepchecks.tabular.suites import data_integrity
# Load the loan data from a CSV file
loan_data = pd.read_csv("data/loan_data.csv")
# Define the label column
label_col = "not.fully.paid"
# Create a Deepchecks Dataset object with the loan data
deep_loan_data = Dataset(loan_data, label=label_col, cat_features=["purpose"])
# Initialize the data integrity suite
integ_suite = data_integrity()
# Run the data integrity suite on the dataset
suite_result = integ_suite.run(deep_loan_data)
# Save the results of the data integrity suite as an HTML file
suite_result.save_as_html("results/data_validation.html")$ code -r train_validation.pyimport pandas as pd
from sklearn.ensemble import RandomForestClassifier, VotingClassifier
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split
from sklearn.naive_bayes import GaussianNB
from sklearn.preprocessing import LabelEncoder, StandardScaler
from deepchecks.tabular import Dataset
from deepchecks.tabular.suites import model_evaluation
# Load the loan data from a CSV file
loan_data = pd.read_csv("data/loan_data.csv")
# Define the label column
label_col = "not.fully.paid"
# Train test split
df_train, df_test = train_test_split(
loan_data, stratify=loan_data[label_col], random_state=0
)
# Encode the 'purpose' column
label_encoder = LabelEncoder()
df_train["purpose"] = label_encoder.fit_transform(df_train["purpose"])
df_test["purpose"] = label_encoder.transform(df_test["purpose"])
# Standardize the features
scaler = StandardScaler()
df_train[df_train.columns.difference([label_col])] = scaler.fit_transform(df_train[df_train.columns.difference([label_col])])
df_test[df_test.columns.difference([label_col])] = scaler.transform(df_test[df_test.columns.difference([label_col])])
# Define models
model_1 = LogisticRegression(random_state=1, max_iter=10000)
model_2 = RandomForestClassifier(n_estimators=50, random_state=1)
model_3 = GaussianNB()
# Create the VotingClassifier
clf_model = VotingClassifier(
estimators=[("lr", model_1), ("rf", model_2), ("gnb", model_3)], voting="soft"
)
# Train the model
clf_model.fit(df_train.drop(label_col, axis=1), df_train[label_col])
# Calculate the accuracy score using the .score function
accuracy = clf_model.score(df_test.drop(label_col, axis=1), df_test[label_col])
# Print the accuracy score
print(f"Accuracy: {accuracy:.2f}")
# Create Deepchecks datasets
deep_train = Dataset(df_train, label=label_col, cat_features=["purpose"])
deep_test = Dataset(df_test, label=label_col, cat_features=["purpose"])
# Run the evaluation suite
evaluation_suite = model_evaluation()
suite_result = evaluation_suite.run(deep_train, deep_test, clf_model)
# Save the results as HTML
suite_result.save_as_html("results/model_validation.html")Wenn du neu bei GitHub Actions bist, absolviere zuerst das Tutorial „GitHub Actions and MakeFile: A Hands-on Introduction“. Dort bekommst du einen fundierten Überblick mit Codebeispielen.
$ git add .
$ git commit -m "Data and Validation files"
$ git push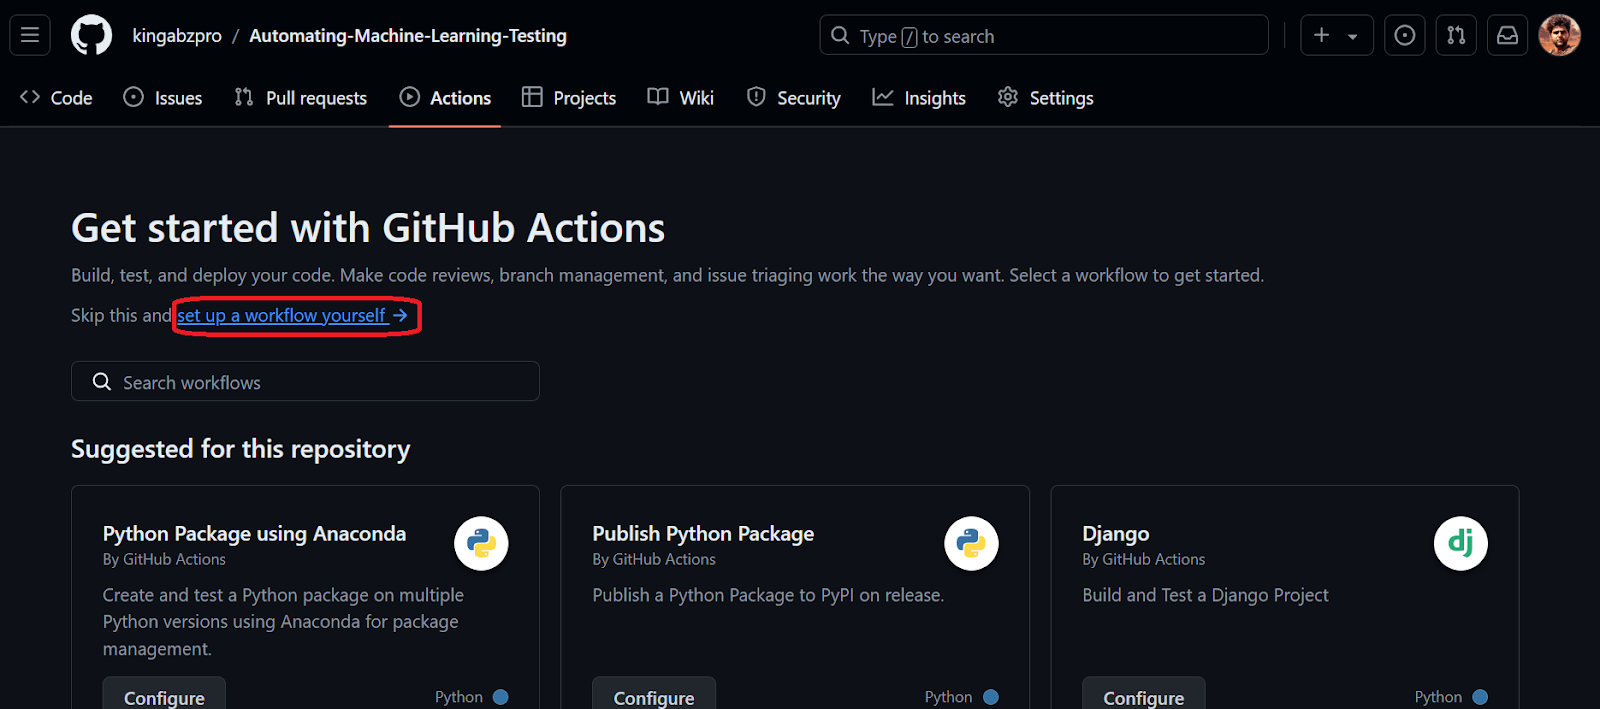
main.yml weitergeleitet. Kopiere den folgenden Code. Er richtet die Umgebung ein, installiert DeepChecks, erstellt den Ordner, führt Datenvalidierung und Modellauswertung aus und speichert die Ergebnisse als GitHub-Artifact.name: Model Training and Validation
on:
push:
branches: [ main ]
pull_request:
branches: [ main ]
jobs:
build:
runs-on: ubuntu-latest
steps:
- name: Checkout Repository
uses: actions/checkout@v4
- name: Set up Python 3.10
uses: actions/setup-python@v5
with:
python-version: '3.10'
- name: Install dependencies
run: |
python -m pip install --upgrade pip
pip install deepchecks
- name: Create a folder
run: |
mkdir -p results
- name: Validate Data
run: |
python data_validation.py
- name: Validate Model Performance
run: |
python train_validation.py
- name: Archive Deepchecks Results
uses: actions/upload-artifact@v4
if: always()
with:
name: deepchecks results
path: results/*_validation.html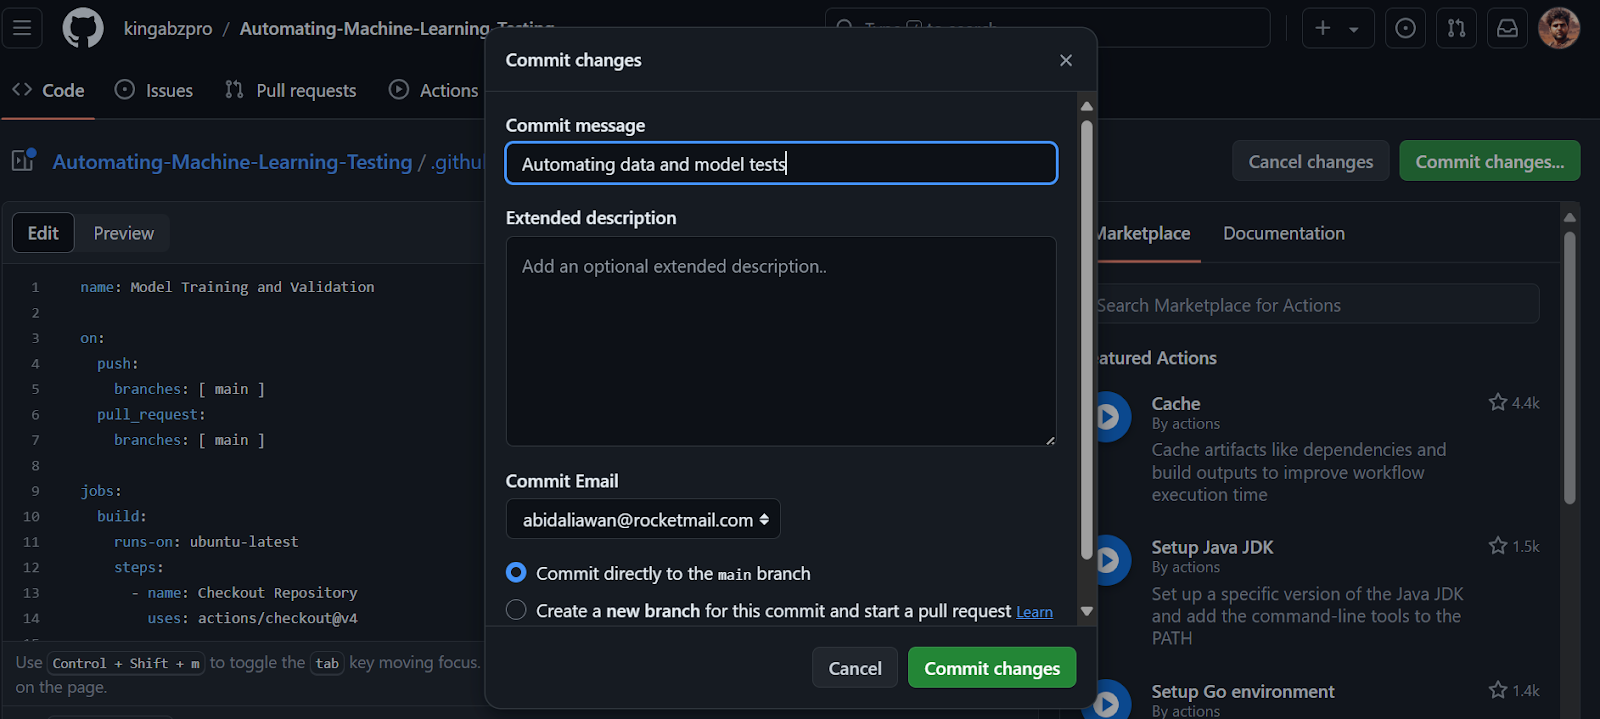
Durch den Commit in den Main-Branch startet der Workflow-Lauf. Um die Logs einzusehen, wechsle zum Tab „Actions“ und öffne den aktuellen Lauf zum zugehörigen Commit.
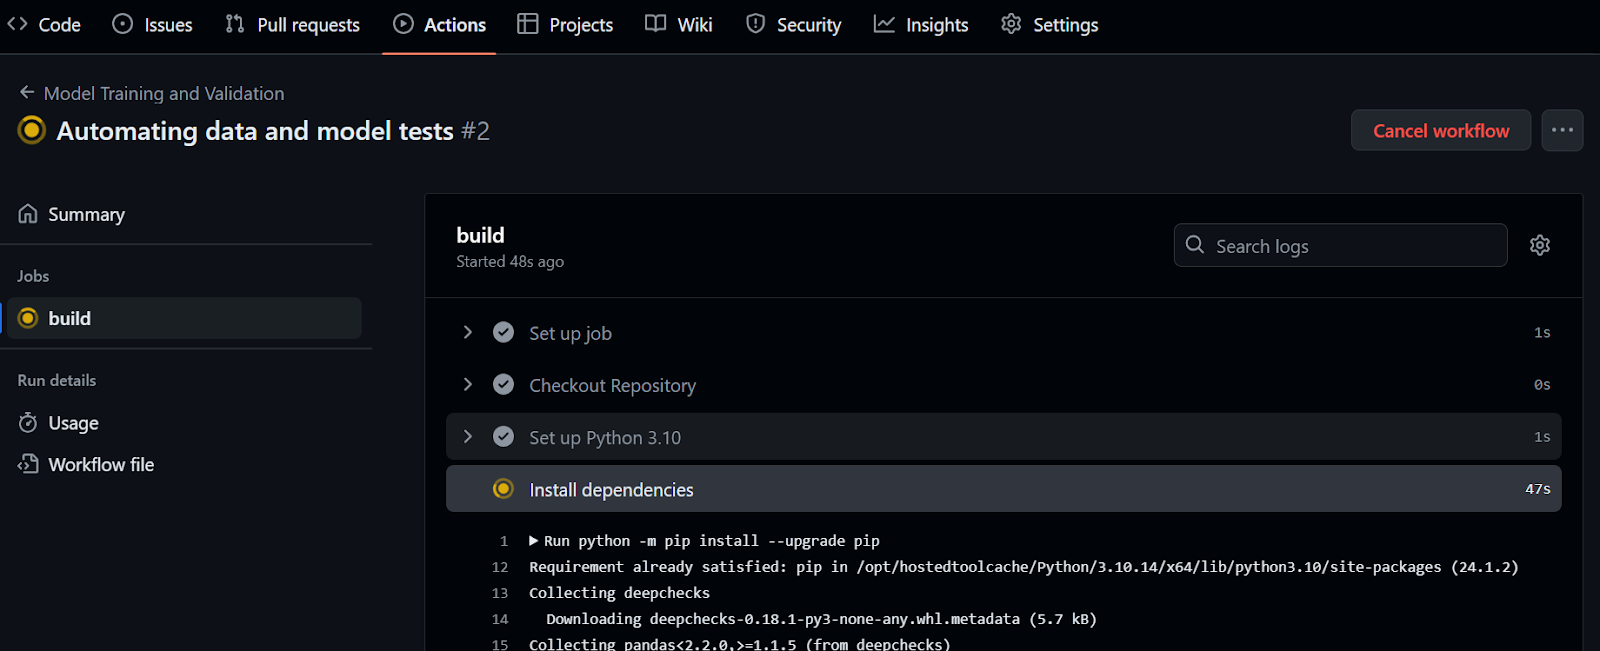
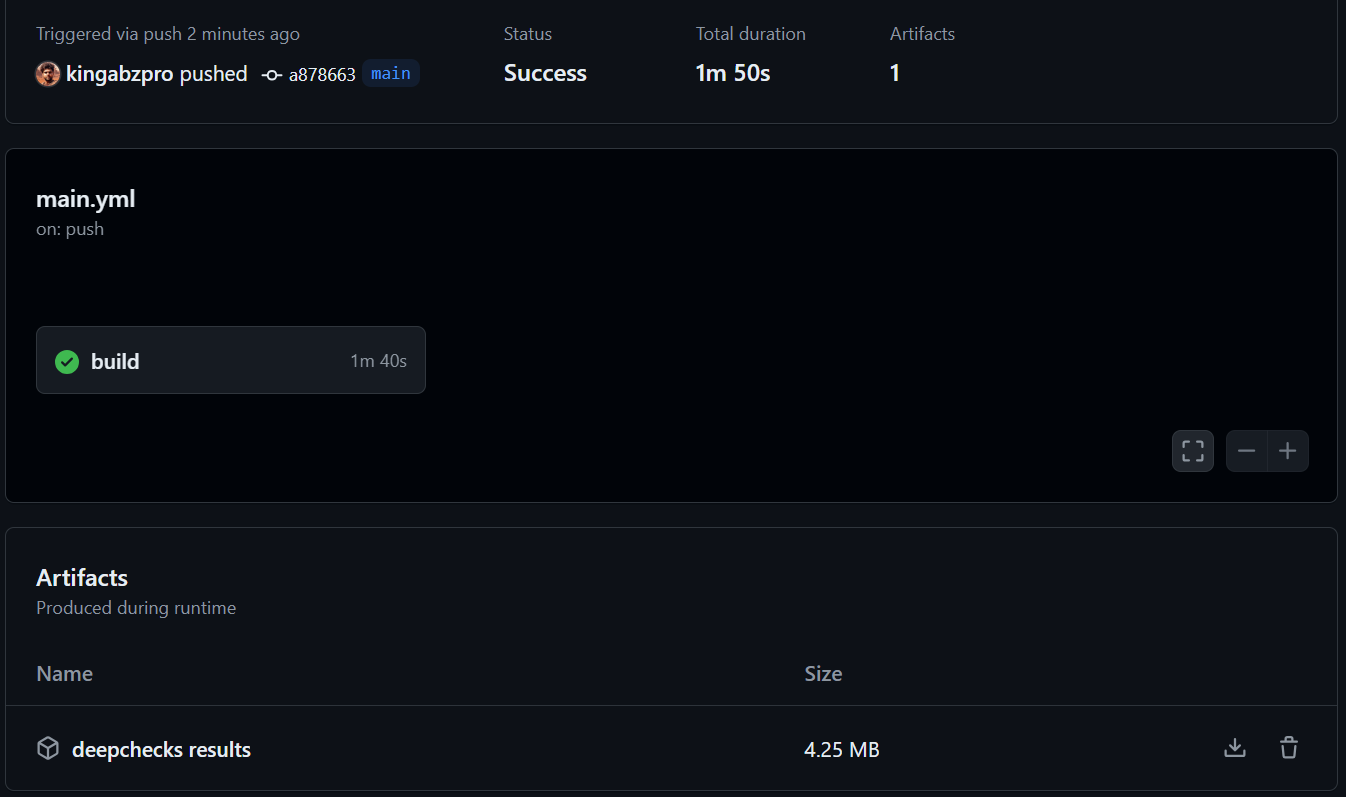
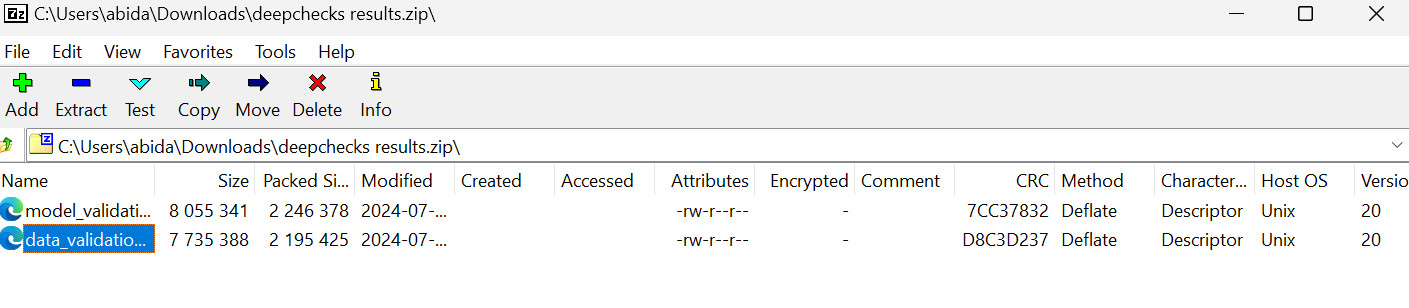
Nutze das Repository kingabzpro/Automating-Machine-Learning-Testing als Referenz. Es enthält Daten, Python-Code, Workflow-Dateien und alles Nötige für vollständig automatisierte Tests.
Die Automatisierung der gesamten ML-Pipeline erfordert Kenntnisse in verschiedenen Prozessen und Tools. Wenn du das vertiefen möchtest, sieh dir den Kurs MLOps Deployment and Lifecycle an. Er behandelt moderne MLOps-Frameworks mit Fokus auf Lifecycle und Deployment von ML-Modellen.
Durch automatisierte Tests können Entwicklerinnen und Entwickler die Genauigkeit und Robustheit von Modellen gegenüber großen, komplexen Datensätzen schnell und effizient validieren. Automatisiertes Testing deckt frühzeitig Probleme wie Dateninkonsistenzen, Data Drift und Modell-Bias auf, die manuell oft unentdeckt bleiben. Das spart Zeit und verbessert die Fähigkeit des Modells, faire und präzise Vorhersagen zu treffen.
In diesem Tutorial haben wir ML-Testing kennengelernt und gesehen, wie DeepChecks für Datenvalidierung und Modelltests eingesetzt wird. Außerdem haben wir Daten- und Modelltests automatisiert und die Ergebnisse mit GitHub Actions als Artefakte gespeichert.
Wenn dir das Tutorial gefallen hat und du eine Karriere im Machine Learning starten möchtest, melde dich für den Machine Learning Scientist with Python Career Track an. Schließe alle Kurse in 3 Monaten ab und erwirb die Kompetenzen für deinen Einstieg als Machine-Learning-Scientist.
Top Machine-Learning-Kurse
Lernpfad
Kurs
Lernpfad