Cours
L’optimisation est l’un des piliers du machine learning. C’est l’une des premières notions que j’ai apprises, et j’ai vite compris que ses applications dépassent largement le cadre de l’IA et du ML.
L’optimisation numérique joue un rôle central pour résoudre des problèmes complexes dans de nombreux domaines. Sans elle, data scientists, économistes et ingénieurs seraient condamnés à concevoir des outils inefficaces et coûteux et à prendre des décisions sous-optimales.
C’est pourquoi nous abordons dans cet article l’optimisation en Python, avec un panorama des packages les plus courants, des techniques et des bonnes pratiques.
Attachez votre ceinture, suivez le guide et ouvrez ce carnet DataLab pour reproduire les exemples.
Qu’est-ce que l’optimisation numérique ?
Pour de nombreux problèmes concrets, il est difficile de trouver directement la meilleure solution. Leur résolution nécessite une approche itérative : c’est précisément le rôle de l’optimisation numérique.
L’optimisation numérique consiste à rechercher le minimum ou le maximum d’une fonction à l’aide de méthodes de calcul itératives, par opposition aux solutions analytiques obtenues par manipulations algébriques.
Contrairement aux méthodes analytiques, qui peuvent fournir des solutions exactes sous forme fermée, l’optimisation numérique s’appuie sur des algorithmes qui approchent la solution optimale en améliorant progressivement des estimations au fil des itérations.
Cette approche est particulièrement utile pour des fonctions :
- complexes
- non linéaires
- de grande dimension
Obtenir une solution exacte de manière analytique est alors impossible ou peu pratique, d’où l’intérêt de l’itératif.
Problèmes d’optimisation courants
En optimisation numérique, on classe généralement les problèmes selon la nature de la fonction objectif et la présence ou non de contraintes.
On distingue ainsi les cas les plus fréquents :
Optimisation sans contrainte
Il s’agit de la forme la plus simple. Elle consiste à trouver le minimum ou le maximum d’une fonction objectif sans aucune restriction sur les variables.
L’objectif est de déterminer le point où la fonction atteint sa valeur optimale (minimum ou maximum) en s’appuyant uniquement sur sa structure mathématique.
Des techniques comme la descente de gradient ou la méthode de Newton sont couramment employées pour résoudre ces problèmes (nous y revenons plus loin). L’idée est d’améliorer la solution de manière itérative en évaluant les dérivées de la fonction.
Par exemple, minimiser une fonction de coût f(x) qui dépend d’une ou plusieurs variables x, sans limitation sur les valeurs que peut prendre x, constitue un problème typique sans contrainte.
Optimisation avec contraintes
À l’inverse, les problèmes d’optimisation avec contraintes consistent à trouver la valeur optimale d’une fonction objectif sous une ou plusieurs contraintes portant sur les variables. Ces contraintes peuvent être des égalités ou des inégalités.
Le défi est alors d’optimiser la fonction tout en garantissant que la solution respecte les contraintes imposées.
Par exemple, en ingénierie, on peut chercher à minimiser le coût des matériaux (fonction objectif) tout en respectant des limites physiques, comme la résistance ou le poids (contraintes).
Des méthodes comme les multiplicateurs de Lagrange, les fonctions de pénalité ou les méthodes de barrière permettent d’intégrer ces contraintes dans le processus d’optimisation.
Optimisation linéaire vs non linéaire
En optimisation linéaire, la fonction objectif et les contraintes sont — vous l’avez deviné — linéaires. Les relations entre variables sont donc modélisées par des équations ou inégalités linéaires.
L’espace des solutions est généralement plus simple et bien structuré, ce qui permet des résolutions efficaces via des méthodes comme le Simplex ou les méthodes de points intérieurs.
Un exemple classique est la programmation linéaire, où l’objectif peut être de maximiser un profit (fonction linéaire) sous des contraintes de ressources (inégalités linéaires).
À l’inverse, l’optimisation non linéaire fait intervenir une fonction objectif ou des contraintes non linéaires, ce qui complexifie fortement le problème.
On rencontre souvent ces problèmes dans le monde réel, où les relations entre variables ne sont pas triviales. Ils peuvent comporter de multiples optima locaux, rendant la résolution plus délicate que pour les problèmes linéaires.
Des techniques comme les méthodes à base de gradient, la méthode de Newton ou les algorithmes évolutionnaires sont fréquemment utilisées pour traiter l’optimisation non linéaire.
Un exemple serait la minimisation d’une fonction d’énergie avec des dépendances physiques complexes, comme l’optimisation de la forme d’une aile d’avion pour améliorer l’efficacité aérodynamique, qui implique des relations non linéaires entre variables de conception et indicateurs de performance.
Devenez un scientifique ML
Techniques d’optimisation en Python
Python propose un large éventail de techniques puissantes pour résoudre des problèmes d’optimisation, des méthodes simples à base de gradient aux algorithmes plus avancés. Elles permettent de trouver efficacement les minima ou maxima de fonctions, que ce soit en machine learning, en ingénierie ou en recherche opérationnelle.
Dans cette section, nous passons en revue les techniques d’optimisation couramment implémentées en Python : descente de gradient, méthode de Newton, méthode du gradient conjugué, méthodes quasi-Newton, méthode du Simplex et méthodes à région de confiance.
Remarque : consultez ce DataLab pour voir tout le code utilisé afin de générer les visualisations de cette section.
C’est parti !
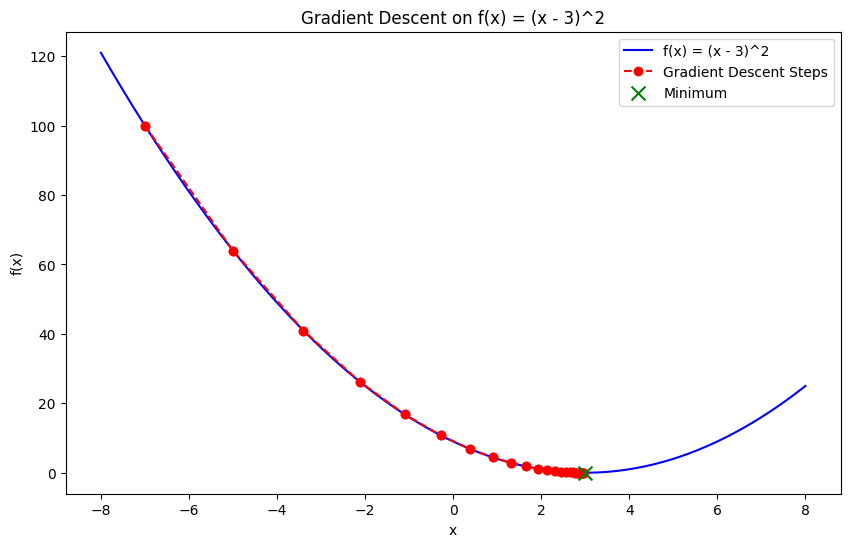
Descente de gradient
La descente de gradient est l’une des techniques fondamentales de l’optimisation numérique. Il s’agit d’une méthode itérative qui cherche le minimum d’une fonction en suivant l’opposé de son gradient (ou pente).
Le principe est de partir d’une estimation initiale et de la mettre à jour itérativement en se déplaçant selon la plus forte pente descendante jusqu’à convergence. C’est l’une des approches les plus utilisées pour entraîner des modèles de machine learning, où l’objectif est de minimiser la fonction de perte.
Méthode de Newton
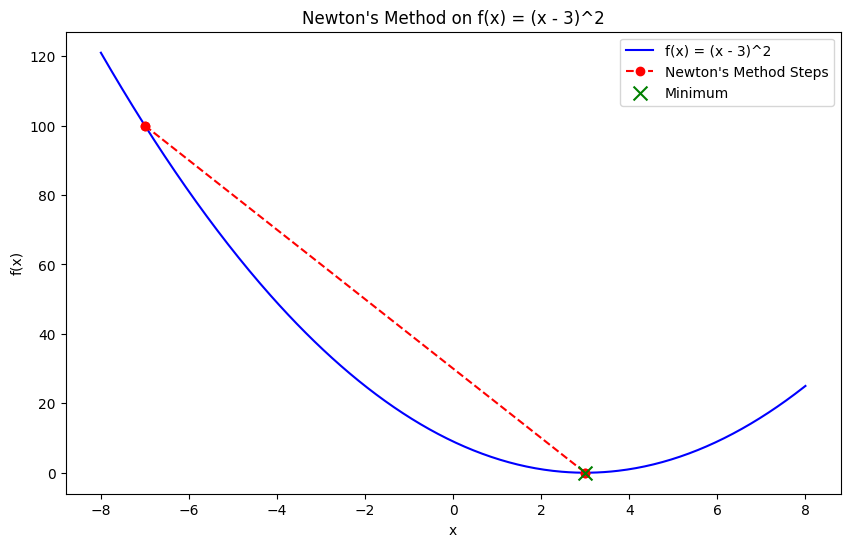
La méthode de Newton est une technique d’optimisation qui trouve un minimum en exploitant à la fois le gradient et la dérivée seconde (matrice hessienne) de la fonction objectif. Contrairement à la descente de gradient, qui ne s’appuie que sur les dérivées premières, elle utilise l’information de courbure, ce qui accélère la convergence, notamment pour les fonctions convexes.
Si la méthode de Newton converge rapidement, elle nécessite le calcul de la matrice hessienne, coûteux et parfois impraticable à grande échelle. Elle est en revanche très efficace pour des problèmes convexes, lisses et de petite taille.
Méthode du gradient conjugué
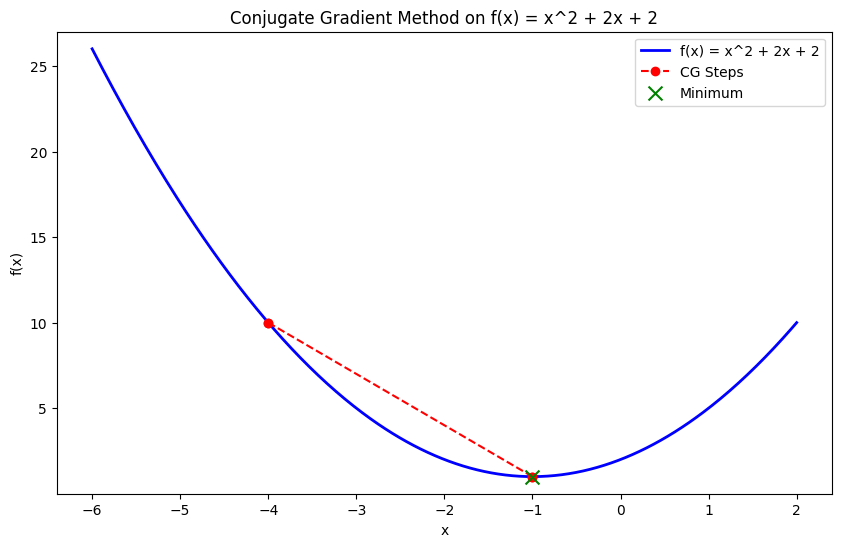
La méthode du gradient conjugué est une technique efficace pour des problèmes de grande taille, notamment lorsque stocker la hessienne est irréaliste. Elle construit itérativement des directions conjuguées et optimise le long de ces directions sans requérir la hessienne complète, ce qui la rend adaptée à la minimisation de grandes fonctions quadratiques.
On l’emploie par exemple en analyse par éléments finis ou pour des applications de machine learning à grande échelle, où les calculs matriciels deviennent lourds.
Méthodes quasi-Newton (BFGS)
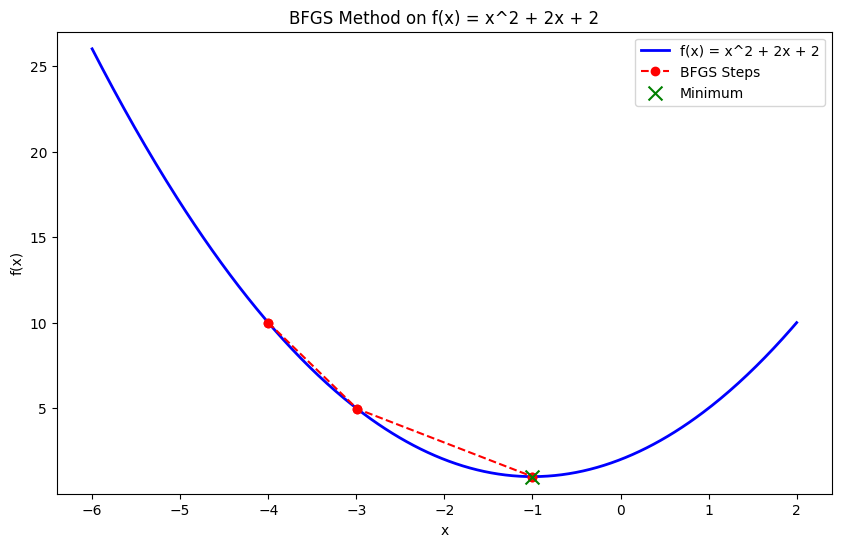
Les méthodes quasi-Newton, comme l’algorithme de Broyden–Fletcher–Goldfarb–Shanno (BFGS), approximent la hessienne au lieu de la calculer explicitement. Elles convergent plus vite que la descente de gradient en exploitant une information de second ordre, sans le coût de calcul d’une hessienne complète.
Méthode du Simplex
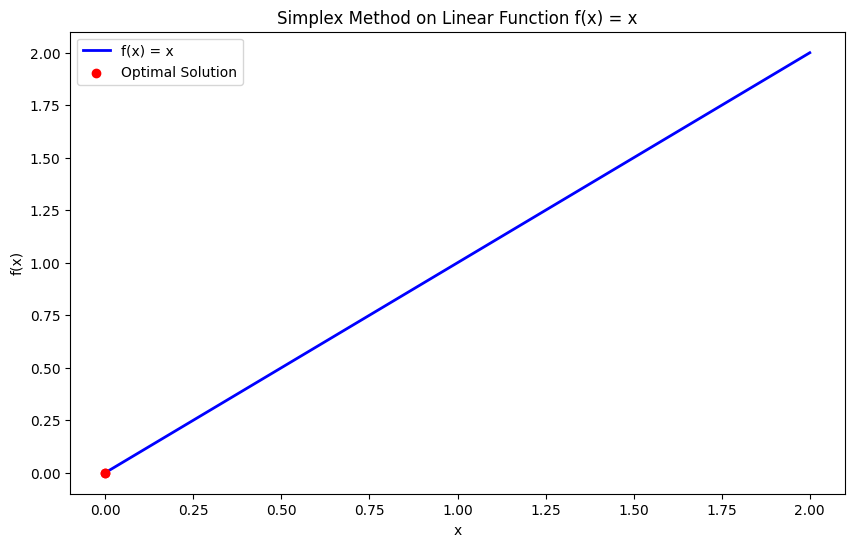
La méthode du Simplex est un algorithme largement utilisé pour résoudre des problèmes de programmation linéaire (PL), où la fonction objectif et les contraintes sont linéaires. Elle explore systématiquement les sommets de la région admissible (un polyèdre) et progresse vers le sommet optimal où la fonction objectif atteint sa valeur maximale ou minimale.
Méthodes à région de confiance
Les méthodes à région de confiance construisent un modèle local de la fonction objectif dans une « région de confiance » autour de la solution courante.
Plutôt que d’avancer selon une direction prédéfinie (comme en descente de gradient), l’algorithme résout un sous-problème simplifié à l’intérieur de cette région et affine la solution itérativement. Ces méthodes sont particulièrement efficaces pour des problèmes non linéaires complexes et offrent une meilleure stabilité que les approches purement basées sur le gradient.
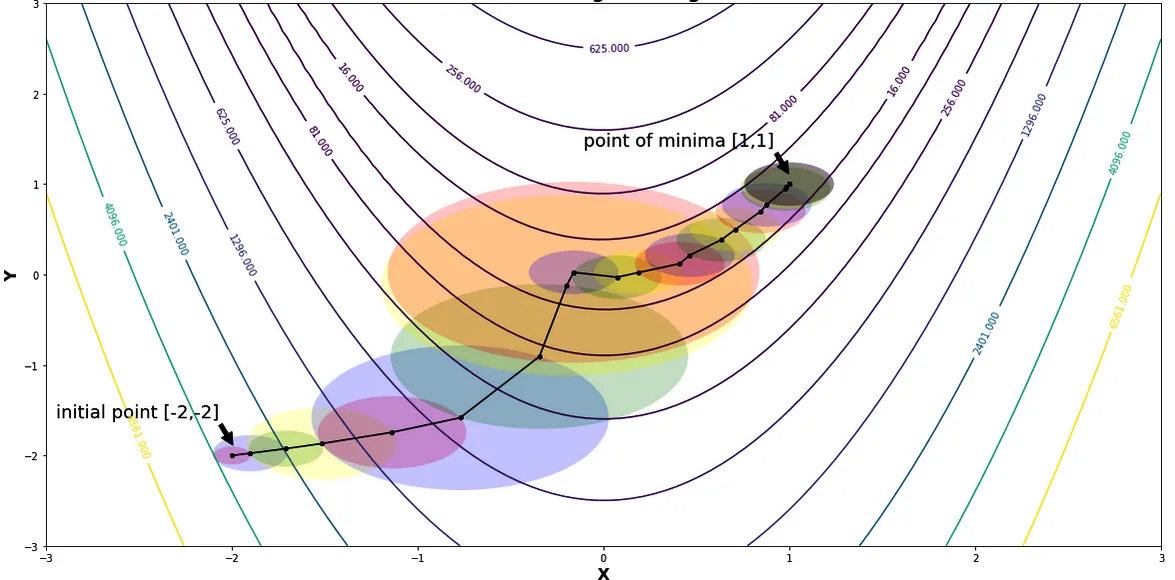
Régions de confiance et rayons lors de la minimisation de la fonction de Rosenbrock | Source : Trust Region Methods par Shivangi Khare
Packages Python courants pour l’optimisation
Il existe une large gamme de bibliothèques et de packages dédiés à l’optimisation numérique. Chacun a ses forces et ses cas d’usage, mais quel que soit votre problème, vous trouverez en Python un outil robuste pour l’aborder.
Voici quatre packages d’optimisation parmi les plus utilisés :
SciPy optimization (scipy.optimize)
Le module scipy.optimize est une bibliothèque polyvalente de l’écosystème SciPy qui propose un large éventail d’algorithmes pour des problèmes avec ou sans contraintes. Il inclut des fonctions pour minimiser des fonctions scalaires ou multivariées, résoudre des problèmes de recherche de racines et ajuster des courbes aux données.
Parmi ses fonctions :
minimize(): minimise une fonction scalaire d’une ou plusieurs variables.
from scipy.optimize import minimize
def objective_function(x):
return x[0]**2 + x[1]**2
result = minimize(objective_function, [1, 1], method='BFGS')
print(result.x) # Optimal solution
# >>> [-1.07505143e-08 -1.07505143e-08]
root(): trouve la racine d’une fonction vectorielle — très utile pour résoudre des systèmes d’équations non linéaires.
from scipy.optimize import root
def equations(vars):
x, y = vars
return [x + 2*y - 3, x - y - 1]
result = root(equations, [0, 0])
print(result.x)
# >>> [1.66666667 0.66666667]
curve_fit(): ajuste une courbe à un ensemble de points, utile pour la modélisation et l’estimation de paramètres.
from scipy.optimize import curve_fit
import numpy as np
def model(x, a, b):
return a * np.exp(b * x)
x_data = np.array([1, 2, 3])
y_data = np.array([2.7, 7.4, 20.1])
params, covariance = curve_fit(model, x_data, y_data)
print(params) # Fitted parameters
# >>> [0.9981286 1.00089935]
CVXPY
CVXPY est une bibliothèque Python dédiée aux problèmes d’optimisation convexe. Elle permet de définir et résoudre ces problèmes avec une syntaxe déclarative et de haut niveau. Elle simplifie la formulation en décrivant naturellement la fonction objectif et les contraintes.
CVXPY propose notamment :
- Syntaxe déclarative : modélisation intuitive des problèmes via des expressions mathématiques Python.
- Solveurs de pointe : interfaçage avec ECOS, SCS et OSQP pour traiter efficacement les problèmes convexes.
import cvxpy as cp
# Define variables
x = cp.Variable()
y = cp.Variable()
# Define constraints
constraints = [x + y == 1, x - y >= 2]
# Define the objective function
objective = cp.Minimize(x**2 + y**2)
# Formulate the problem
prob = cp.Problem(objective, constraints)
# Solve the problem
result = prob.solve()
print(f"Optimal value: {result}")
print(f"x: {x.value}, y: {y.value}")
# >>> Optimal value: 2.5
# x: 1.5, y: -0.5000000000000001
Pyomo
Pyomo est un package de modélisation d’optimisation souple et complet qui couvre la programmation linéaire, non linéaire et mixte en nombres entiers. Conçu pour des problèmes complexes, il s’intègre aux solveurs tels que GLPK, CBC et CPLEX.
Ses atouts :
- Flexibilité de modélisation : définition de problèmes avec contraintes et objectifs complexes.
- Intégration de solveurs : large choix de solveurs pour sélectionner l’outil le plus adapté.
Gurobi et CPLEX (via Pyomo ou API directe)
Gurobi et CPLEX sont des solveurs haute performance adaptés aux problèmes de grande taille. Ils sont couramment utilisés en entreprise pour l’optimisation de la chaîne d’approvisionnement, la gestion de portefeuille ou la logistique.
Ils offrent des algorithmes avancés pour traiter avec efficacité des problèmes complexes et volumineux.
- Gurobi : accessible via Pyomo ou en API directe, reconnu pour sa vitesse et sa fiabilité en programmation linéaire, entière et quadratique.
- CPLEX : propose des capacités d’optimisation puissantes, utilisées dans de nombreux secteurs pour des problématiques opérationnelles et stratégiques. Accès via Pyomo ou API directe.
Ces solveurs s’imposent lorsque l’efficacité de calcul et la robustesse sont critiques à l’échelle industrielle.
Applications réelles de l’optimisation numérique en Python
Comme mentionné en introduction, l’optimisation numérique est essentielle dans de nombreux domaines. Elle fournit des techniques clés pour résoudre des problèmes complexes et appuyer des décisions fondées sur les données.
Par exemple :
- Machine learning : les modèles sont entraînés par optimisation numérique pour trouver les paramètres qui minimisent la fonction de perte, indicateur de la qualité de prédiction.
- Recherche opérationnelle : les techniques d’optimisation aident à maximiser ou minimiser des indicateurs opérationnels. En optimisant une fonction objectif sous contraintes, on améliore l’efficacité de processus comme la supply chain, la planification des équipes ou la production.
- Finance : essentielle pour l’optimisation de portefeuille afin de déterminer l’allocation d’actifs qui maximise le rendement ou minimise le risque.
- Conception en ingénierie : utilisée pour concevoir des systèmes et structures répondant à des critères de performance tout en maîtrisant les coûts, des ponts et avions aux procédés industriels et systèmes énergétiques.
Bonnes pratiques pour l’optimisation numérique en Python
Pour obtenir les meilleurs résultats en Python, gardez à l’esprit les bonnes pratiques suivantes :
Choisir le bon algorithme
Le choix de l’algorithme est déterminant et dépend de la nature du problème :
- Linéaire vs non linéaire : pour les problèmes linéaires, privilégiez le Simplex ou les méthodes de points intérieurs. Pour les non linéaires, tournez-vous vers la descente de gradient, la méthode de Newton ou des méthodes quasi-Newton (p. ex. BFGS).
- Avec ou sans contraintes : pour des contraintes explicites, utilisez des approches comme la programmation quadratique séquentielle (SQP) ou des méthodes gérant nativement les contraintes (p. ex. points intérieurs). Sans contraintes, la descente de gradient ou Newton sont efficaces.
Adapter l’algorithme aux caractéristiques du problème favorise une convergence rapide et des solutions plus précises.
Gérer les contraintes
Les contraintes influencent fortement le choix d’algorithme et la stratégie de résolution. Plusieurs approches existent :
- Méthodes de pénalité : intégrer les contraintes dans la fonction objectif via un terme de pénalité en cas de violation, transformant ainsi le problème en un problème sans contrainte.
- Méthodes de barrière : ajouter un terme de barrière à l’objectif qui devient infini à l’approche des frontières des contraintes.
- Prise en charge native : utiliser des solveurs qui gèrent intrinsèquement les contraintes, comme ceux de
scipy.optimizeou CVXPY.
Choisir la bonne méthode de gestion des contraintes garantit des solutions faisables conformes aux exigences.
Mise à l’échelle et prétraitement
Une mise à l’échelle et un prétraitement adéquats améliorent nettement les performances des algorithmes :
- Mise à l’échelle : normalisez ou standardisez les entrées pour que chaque variable contribue de manière comparable à l’objectif. Cela améliore la stabilité numérique et la vitesse de convergence.
- Prétraitement : mettez en œuvre de l’ingénierie des variables ou de la réduction de dimension pour simplifier le problème et accélérer la résolution.
Interpréter les résultats
L’interprétation des résultats implique de considérer plusieurs aspects :
- Qualité de la solution : vérifiez le respect des conditions d’optimalité et des contraintes. Comparez à des références ou validez par des techniques de validation croisée.
- Critères de convergence : examinez les messages de convergence, le nombre d’itérations ou l’évolution de la valeur de l’objectif pour confirmer l’atteinte d’un optimum.
- Précision numérique : tenez compte des effets d’arrondis et erreurs numériques, surtout sur des problèmes de grande taille ou à tolérances serrées.
Conclusion
L’optimisation numérique est un fondement de la résolution moderne de problèmes. Elle offre des outils puissants pour s’attaquer à des défis complexes en machine learning, ingénierie, finance et recherche opérationnelle.
Grâce à l’écosystème Python — SciPy, CVXPY, Pyomo, entre autres — ces techniques avancées sont plus accessibles, permettant aux chercheurs, ingénieurs et data scientists de concevoir des systèmes efficaces, d’optimiser des modèles et de prendre de meilleures décisions basées sur les données.
Avec les bonnes techniques et bonnes pratiques, vous avez désormais toutes les cartes en main pour aborder et résoudre des problèmes d’optimisation exigeants en Python. Pour aller plus loin :
Renforcer les compétences en matière d'apprentissage automatique
FAQs
Qu’est-ce que l’optimisation ?
L’optimisation est le processus qui consiste à trouver le minimum ou le maximum d’une fonction via des méthodes de calcul itératives plutôt que par des solutions analytiques.
Pourquoi l’optimisation est-elle importante ?
Elle est essentielle car elle permet de résoudre des problèmes complexes et concrets en machine learning, ingénierie ou finance, où une solution directe est impraticable voire impossible.
Quels packages Python sont les mieux adaptés à l’optimisation numérique ?
Parmi les packages Python populaires : SciPy (optimisation généraliste), CVXPY (optimisation convexe), Pyomo (modélisation flexible), ainsi que des solveurs puissants comme Gurobi et CPLEX adaptés aux applications industrielles de grande taille.
Comment l’optimisation numérique est-elle utilisée en machine learning ?
En machine learning, l’optimisation numérique sert à minimiser la fonction de perte, qui mesure la capacité du modèle à prédire les variables cibles.
Quelle est la différence entre optimisation avec et sans contrainte ?
L’optimisation sans contrainte cherche la valeur optimale d’une fonction objectif sans restriction sur les variables. L’optimisation avec contraintes impose des restrictions (égalités ou inégalités) que la solution doit respecter tout en optimisant la fonction.
