Kurs
Optimierung gehört zu den zentralen Techniken im Machine Learning. Es war eines der ersten Themen, die ich gelernt habe – und schnell wurde klar: Die Anwendung geht weit über ML hinaus.
Numerische Optimierung spielt eine Schlüsselrolle beim Lösen komplexer Probleme in vielen Disziplinen. Ohne sie müssten Datenexpertinnen und -experten, Ökonominnen und Ökonomen sowie Ingenieurinnen und Ingenieure ineffiziente, teure Werkzeuge bauen und suboptimale Entscheidungen treffen.
Darum schauen wir uns in diesem Artikel die Optimierung in Python an – inklusive der gängigsten Packages, Techniken und Best Practices.
Schnall dich an, lehn dich zurück und arbeite parallel im DataLab Workbook mit.
Was ist numerische Optimierung?
Für viele reale Probleme ist die beste Lösung nicht direkt bestimmbar. Ihre Lösung erfordert iterative Verfahren – hier kommt die numerische Optimierung ins Spiel.
Numerische Optimierung ist der Prozess, mithilfe iterativer Rechenmethoden das Minimum oder Maximum einer Funktion zu finden – im Gegensatz zu analytischen Lösungen, die durch algebraische Umformungen hergeleitet werden.
Anders als analytische Methoden, die teils geschlossene, exakte Lösungen liefern, nähern sich numerische Optimierungsalgorithmen der optimalen Lösung Schritt für Schritt über aufeinanderfolgende Iterationen an.
Dieser Ansatz ist besonders nützlich für Funktionen, die:
- komplex
- nichtlinear
- hochdimensional
sind. In solchen Fällen ist eine exakte analytische Lösung unmöglich oder unpraktikabel – daher die iterative Vorgehensweise.
Typische Optimierungsprobleme
In der numerischen Optimierung werden Probleme meist anhand der Eigenschaften der Zielfunktion sowie der Anwesenheit von Nebenbedingungen kategorisiert.
Die häufigsten Problemklassen sind daher:
Unbeschränkte Optimierung
Das ist die einfachste Form: Es geht darum, das Minimum oder Maximum einer Zielfunktion zu finden, ohne die Variablen einzuschränken.
Ziel ist der Punkt, an dem die Funktion allein aufgrund ihrer mathematischen Struktur ihren optimalen Wert erreicht (Minimum oder Maximum).
Techniken wie Gradientenabstieg oder das Newton-Verfahren werden häufig für unbeschränkte Probleme eingesetzt (mehr dazu gleich). Im Fokus steht die iterative Verbesserung der Lösung über Ableitungen der Funktion.
Ein Beispiel ist das Minimieren einer Kostenfunktion f(x), die von einer oder mehreren Variablen x abhängt, ohne Einschränkungen hinsichtlich der Werte, die x annehmen darf.
Beschränkte Optimierung
Bei beschränkten Problemen wird das Optimum einer Zielfunktion unter Einhaltung von Nebenbedingungen für die Variablen gesucht. Diese können als Gleichungen oder Ungleichungen formuliert sein.
Die Herausforderung besteht darin, die Funktion zu optimieren und gleichzeitig sicherzustellen, dass die Lösung die vorgegebenen Nebenbedingungen erfüllt.
Ein typisches Beispiel aus dem Engineering ist das Minimieren von Materialkosten (Zielfunktion) unter Einhaltung physikalischer Grenzen wie Festigkeit oder Gewicht (Nebenbedingungen).
Methoden wie Lagrange-Multiplikatoren, Strafterm- und Barrierenmethoden binden solche Nebenbedingungen in den Optimierungsprozess ein.
Lineare vs. nichtlineare Optimierung
Bei linearer Optimierung sind sowohl Zielfunktion als auch Nebenbedingungen – genau – linear. Das heißt, Beziehungen zwischen Variablen werden durch lineare Gleichungen oder Ungleichungen beschrieben.
Der Lösungsraum ist hier oft einfacher und gut strukturiert, sodass effiziente Verfahren wie Simplex oder Interior-Point greifen.
Ein Klassiker ist das Lineare Programmieren, etwa um den Gewinn (lineare Funktion) unter Ressourcenbeschränkungen (lineare Ungleichungen) zu maximieren.
Nichtlineare Optimierung hingegen umfasst eine nichtlineare Zielfunktion oder Nebenbedingungen – das macht die Probleme deutlich komplexer.
In der Praxis sind viele Zusammenhänge zwischen Variablen nicht linear. Solche Probleme besitzen oft mehrere lokale Optima und sind schwerer zu lösen als lineare.
Gängige Verfahren sind gradientenbasierte Methoden, das Newton-Verfahren und evolutionäre Algorithmen.
Ein Beispiel ist das Minimieren einer Energiefunktion mit komplexen physikalischen Abhängigkeiten, etwa die aerodynamische Optimierung der Tragflächenform eines Flugzeugs – mit nichtlinearen Beziehungen zwischen Designvariablen und Leistungskennzahlen.
Werde ein ML-Wissenschaftler
Optimierungstechniken in Python
Python bietet eine Vielzahl leistungsfähiger Verfahren zur Lösung von Optimierungsproblemen – von einfachen gradientenbasierten Methoden bis hin zu komplexeren Algorithmen. Damit findest du effizient Minima oder Maxima von Funktionen, ob im Machine Learning, Engineering oder in der Operations Research.
In diesem Abschnitt behandeln wir in Python gängige Optimierungstechniken: Gradientenabstieg, das Newton-Verfahren, das konjugierte Gradientenverfahren, Quasi-Newton-Verfahren, die Simplex-Methode und Trust-Region-Verfahren.
Hinweis: Im DataLab findest du den gesamten Code, mit dem die Visualisierungen in diesem Abschnitt erzeugt wurden.
Los geht’s!
Gradientenabstieg
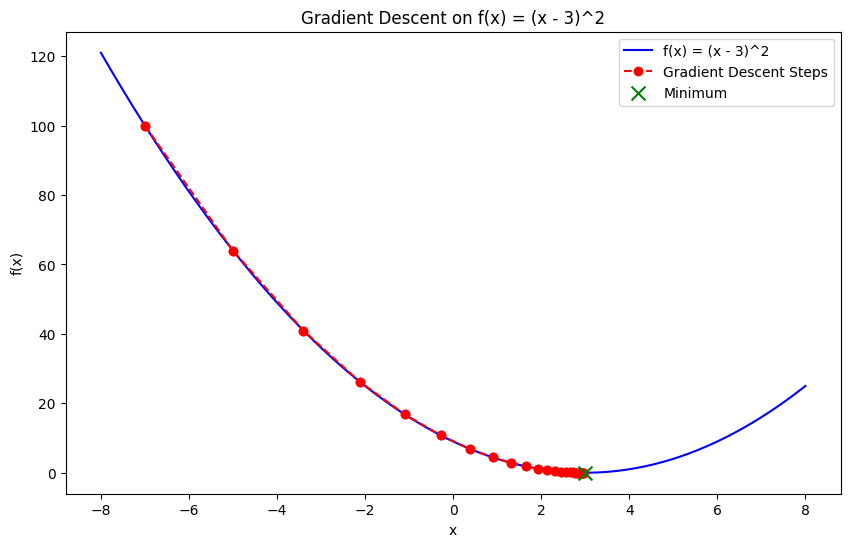
Der Gradientenabstieg ist eine der grundlegendsten Techniken der numerischen Optimierung. Das iterative Verfahren sucht das Minimum einer Funktion, indem es der negativen Richtung des Gradienten (der Steigung) folgt.
Die Idee: Man startet mit einem Anfangswert und aktualisiert ihn iterativ in Richtung des steilsten Abstiegs, bis Konvergenz erreicht ist. Beim Training von ML-Modellen ist das eine der am häufigsten genutzten Methoden, da hier die Verlustfunktion minimiert wird.
Newton-Verfahren
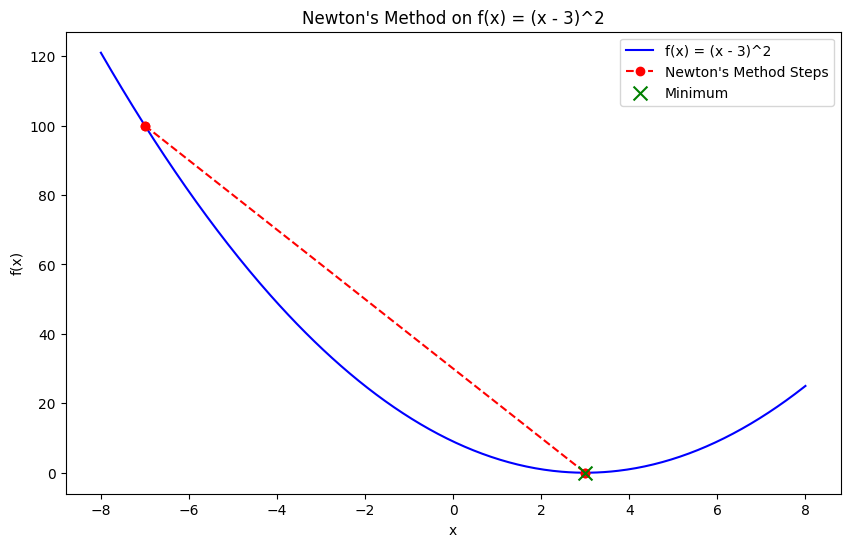
Das Newton-Verfahren nutzt für die Minimierung sowohl den Gradienten als auch die zweite Ableitung (Hesse-Matrix) der Zielfunktion. Im Unterschied zum Gradientenabstieg, der nur erste Ableitungen verwendet, nutzt Newton Krümmungsinformationen und konvergiert dadurch oft schneller, insbesondere bei konvexen Funktionen.
Obwohl das Newton-Verfahren schnell konvergiert, erfordert es die Berechnung der Hesse-Matrix – das kann rechenintensiv und für sehr große Probleme unpraktisch sein. Für kleine, glatte, konvexe Probleme ist es jedoch äußerst effektiv.
Konjugiertes Gradientenverfahren
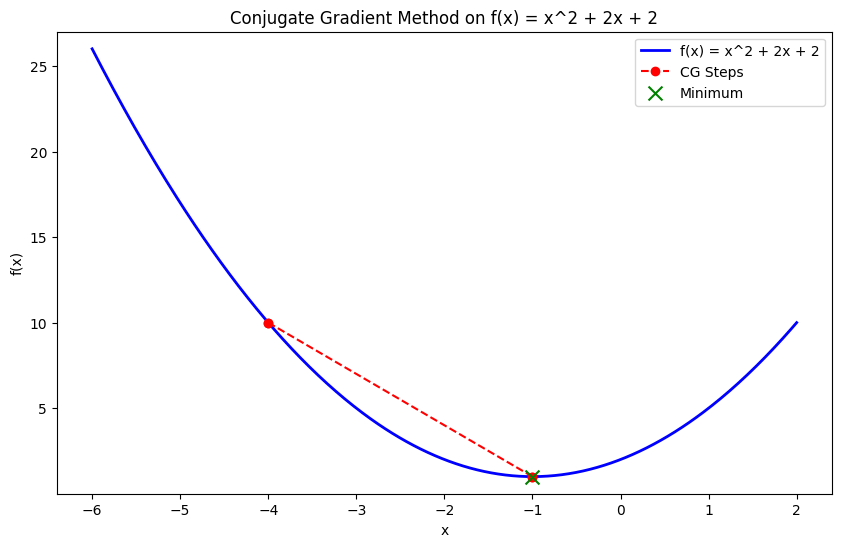
Das konjugierte Gradientenverfahren ist ein effizientes Verfahren für großskalige Probleme, insbesondere wenn die Hesse-Matrix nicht gespeichert werden kann. Es konstruiert iterativ konjugierte Richtungen und optimiert entlang dieser, ohne die vollständige Hesse-Matrix zu benötigen – ideal etwa für das Minimieren großer quadratischer Funktionen.
Es ist nützlich in der Finite-Elemente-Analyse oder in großskaligen ML-Anwendungen, in denen Matrixoperationen teuer werden.
Quasi-Newton-Verfahren (BFGS)
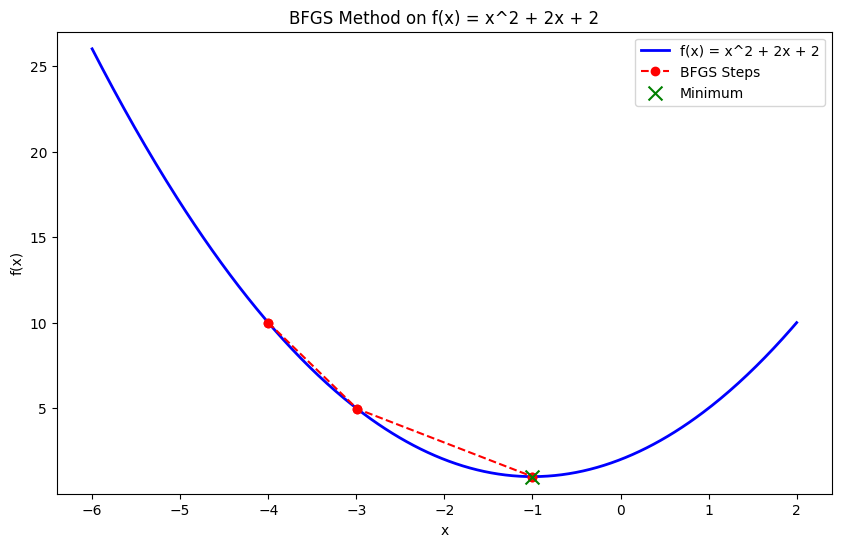
Quasi-Newton-Verfahren wie der Broyden–Fletcher–Goldfarb–Shanno-Algorithmus (BFGS) approximieren die Hesse-Matrix statt sie direkt zu berechnen. So erreichen sie schnellere Konvergenz als der Gradientenabstieg, nutzen zweite Ordnungsinformationen, ohne den vollen Rechenaufwand für die Hesse-Matrix zu verursachen.
Simplex-Methode
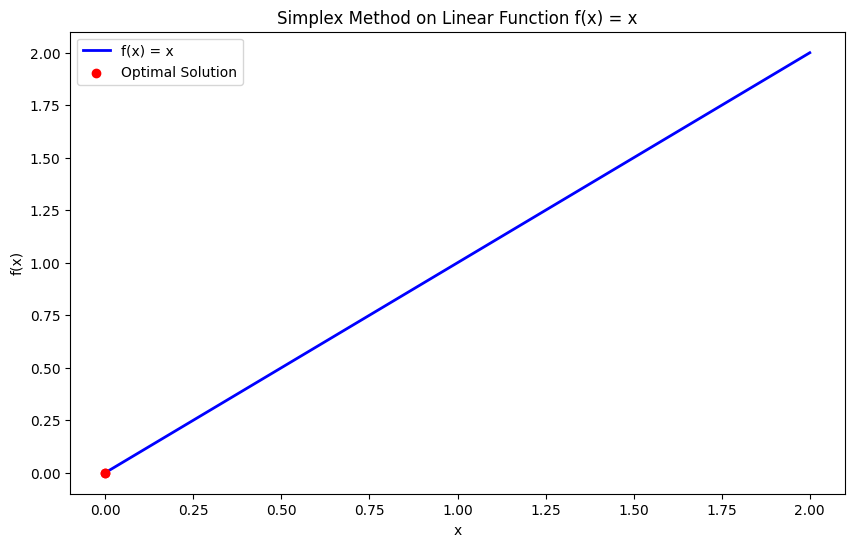
Die Simplex-Methode ist ein weit verbreiteter Algorithmus zur Lösung linearer Programme (LP), bei denen Zielfunktion und Nebenbedingungen linear sind. Sie untersucht systematisch die Ecken des zulässigen Bereichs (eines Polyeders) und bewegt sich zur optimalen Ecke, an der die Zielfunktion ihr Maximum oder Minimum erreicht.
Trust-Region-Verfahren
Trust-Region-Verfahren bauen ein lokales Modell der Zielfunktion in einer „Vertrauensregion“ um die aktuelle Lösung auf.
Anstatt Schritte in vorgegebener Richtung zu gehen (wie beim Gradientenabstieg), definiert der Algorithmus ein einfacheres Teilproblem innerhalb der Vertrauensregion und löst es iterativ zur Verfeinerung der Lösung. Diese Methoden sind besonders effektiv für komplexe, nichtlineare Probleme und oft stabiler als klassische gradientenbasierte Ansätze.
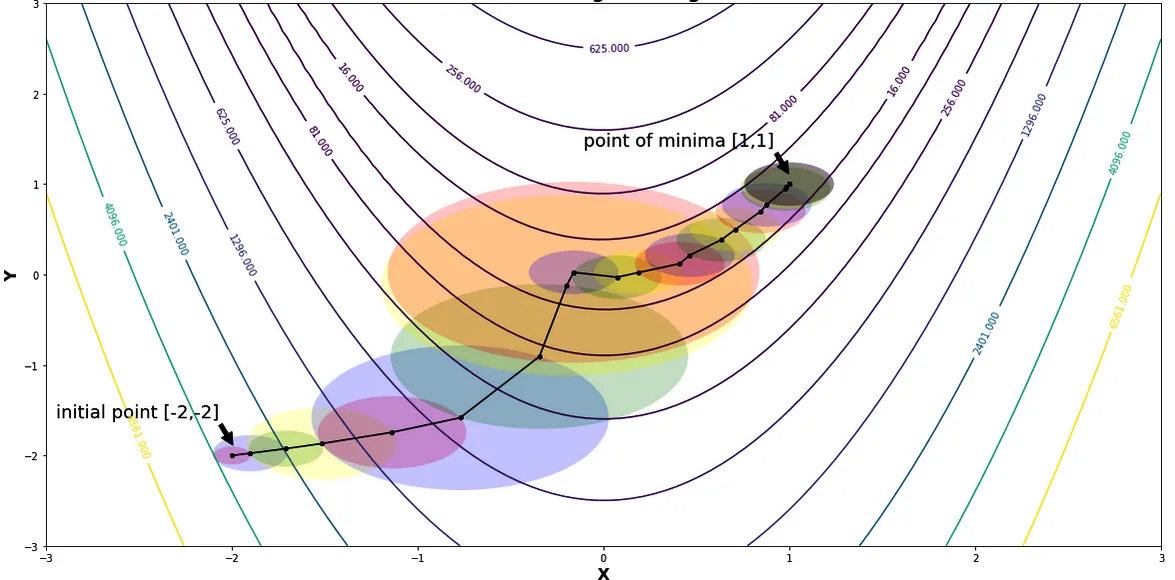
Trust-Regionen und -Radien bei der Minimierung der Rosenbrock-Funktion | Quelle: Trust Region Methods von Shivangi Khare
Gängige Python-Packages für Optimierung
Es gibt eine Reihe von Bibliotheken und Packages, die numerische Optimierung erleichtern. Jedes hat seine Stärken und Anwendungsfälle – doch egal, welches Optimierungsproblem du angehst, in Python findest du in der Regel ein robustes Werkzeug dafür.
Hier sind vier der gängigsten Optimierungspackages:
SciPy Optimization (scipy.optimize)
Das Modul scipy.optimize ist eine vielseitige Bibliothek im SciPy-Ökosystem und bietet eine breite Palette an Algorithmen für unbeschränkte und beschränkte Optimierungsprobleme. Enthalten sind Funktionen zum Minimieren skalarer und multivariater Funktionen, zum Lösen von Nullstellensuchen sowie zum Kurvenfitten.
Wichtige Funktionen sind unter anderem:
minimize(): Minimiert eine skalare Funktion mit einer oder mehreren Variablen.
from scipy.optimize import minimize
def objective_function(x):
return x[0]**2 + x[1]**2
result = minimize(objective_function, [1, 1], method='BFGS')
print(result.x) # Optimal solution
# >>> [-1.07505143e-08 -1.07505143e-08]
root(): Findet die Nullstelle einer Vektorfunktion – äußerst nützlich zum Lösen nichtlinearer Gleichungssysteme.
from scipy.optimize import root
def equations(vars):
x, y = vars
return [x + 2*y - 3, x - y - 1]
result = root(equations, [0, 0])
print(result.x)
# >>> [1.66666667 0.66666667]
curve_fit(): Passt eine Kurve an Datenpunkte an – hilfreich für Datenfit und Parameterschätzung.
from scipy.optimize import curve_fit
import numpy as np
def model(x, a, b):
return a * np.exp(b * x)
x_data = np.array([1, 2, 3])
y_data = np.array([2.7, 7.4, 20.1])
params, covariance = curve_fit(model, x_data, y_data)
print(params) # Fitted parameters
# >>> [0.9981286 1.00089935]
CVXPY
CVXPY ist eine Python-Bibliothek für konvexe Optimierungsprobleme. Sie erlaubt das Formulieren und Lösen solcher Probleme mit einer deklarativen, hochsprachlichen Syntax. So lassen sich komplexe Optimierungsaufgaben natürlich und lesbar mit Zielfunktion und Nebenbedingungen spezifizieren.
CVXPY bietet unter anderem:
- Deklarative Syntax: Intuitives Modellieren von Optimierungsproblemen mit mathematischen Ausdrücken in Python.
- State-of-the-Art-Solver: Anbindung an fortschrittliche Solver wie ECOS, SCS und OSQP, die konvexe Probleme effizient lösen.
import cvxpy as cp
# Define variables
x = cp.Variable()
y = cp.Variable()
# Define constraints
constraints = [x + y == 1, x - y >= 2]
# Define the objective function
objective = cp.Minimize(x**2 + y**2)
# Formulate the problem
prob = cp.Problem(objective, constraints)
# Solve the problem
result = prob.solve()
print(f"Optimal value: {result}")
print(f"x: {x.value}, y: {y.value}")
# >>> Optimal value: 2.5
# x: 1.5, y: -0.5000000000000001
Pyomo
Pyomo ist ein flexibles, umfassendes Modellierungspackage für Optimierung und unterstützt lineare, nichtlineare und gemischt-ganzzahlige Programme. Es ist für komplexe Optimierungsprobleme ausgelegt und integriert sich nahtlos mit Solvern wie GLPK, CBC und CPLEX.
Zu den Features von Pyomo zählen:
- Modellierungsfreiheit: Definition hochflexibler Optimierungsprobleme inklusive komplexer Nebenbedingungen und Ziele.
- Solver-Integration: Unterstützung vieler Solver – so wählst du das passende Werkzeug für das jeweilige Problem.
Gurobi und CPLEX (über Pyomo oder direkte API)
Gurobi und CPLEX sind Hochleistungs-Solver für großskalige Optimierungsprobleme. In der Industrie werden sie häufig für Lieferkettenoptimierung, Portfoliomanagement und Logistik eingesetzt.
Sie bieten fortgeschrittene Algorithmen, die komplexe, große Probleme effizient bewältigen.
- Gurobi: Über Pyomo oder die direkte API nutzbar. Gurobi ist für Geschwindigkeit und Zuverlässigkeit bei linearen, ganzzahligen und quadratischen Programmen bekannt.
- CPLEX: Ebenfalls ein leistungsfähiger Solver, der in vielen Branchen komplexe operative und strategische Probleme löst – via Pyomo oder direkt über die API.
Diese Solver kommen oft bei Industrieproblemen zum Einsatz, bei denen Recheneffizienz und Robustheit entscheidend sind.
Praxisanwendungen numerischer Optimierung in Python
Wie in der Einleitung erwähnt, ist numerische Optimierung in vielen Bereichen unverzichtbar. Sie liefert zentrale Techniken, um komplexe Probleme zu lösen und datenbasierte Entscheidungen zu treffen.
Beispiele sind:
- Machine Learning: Modelle werden im Kern mithilfe numerischer Optimierung trainiert. Dabei werden die Parameter so bestimmt, dass die Verlustfunktion minimiert wird und das Modell die Zielvariable möglichst gut vorhersagt.
- Operations Research: Optimierungstechniken unterstützen strategische Entscheidungen, um operative Kennzahlen zu maximieren oder zu minimieren. Durch das Optimieren von Zielfunktionen unter Nebenbedingungen lassen sich Prozesse wie Lieferketten, Schichtplanung und Produktion effizienter gestalten.
- Finanzen: In der Finanzwelt ist numerische Optimierung essenziell, z. B. für Portfoliooptimierung. Sie hilft, die beste Asset-Allokation zur Maximierung der Rendite oder Minimierung des Risikos zu bestimmen.
- Engineering-Design: Numerische Optimierung unterstützt das Entwickeln von Systemen und Strukturen, die bestimmte Leistungsziele erfüllen und dabei Kosten minimieren – von Brücken und Flugzeugen bis zu Fertigungsprozessen und Energiesystemen.
Best Practices für numerische Optimierung in Python
Damit deine Optimierung in Python bestmögliche Ergebnisse liefert, solltest du einige Punkte beachten. Folge diesen Best Practices:
Den passenden Algorithmus wählen
Die Wahl des richtigen Verfahrens ist entscheidend – sie hängt von der Problemstruktur ab:
- Linear vs. nichtlinear: Für lineare Probleme eignen sich Verfahren der linearen Programmierung wie Simplex oder Interior-Point. Für nichtlineare Probleme sind Gradientenabstieg, Newton oder Quasi-Newton (z. B. BFGS) oft besser.
- Beschränkt vs. unbeschränkt: Bei Nebenbedingungen kommen etwa Sequential Quadratic Programming (SQP) oder Verfahren mit nativer Constraint-Unterstützung (z. B. Interior-Point) zum Einsatz. Unbeschränkte Probleme lassen sich effizient mit Gradientenabstieg oder Newton lösen.
Die richtige Wahl beschleunigt die Konvergenz und erhöht die Genauigkeit der Lösung.
Nebenbedingungen behandeln
Nebenbedingungen beeinflussen die Verfahrens- und Strategiewahl deutlich. Übliche Ansätze sind:
- Strafterme (Penalty): Nebenbedingungen werden über Strafbegriffe in die Zielfunktion integriert. So wird ein beschränktes in ein unbeschränktes Problem überführt und unbeschränkte Verfahren sind anwendbar.
- Barrierenmethoden: Barrierefunktionen verhindern das Verletzen von Nebenbedingungen, indem sie gegen Unendlich gehen, je näher man an die Randbereiche kommt.
- Native Unterstützung: Nutze Solver mit integrierter Constraint-Unterstützung. Viele moderne Solver, etwa in
scipy.optimizeoder CVXPY, verarbeiten Nebenbedingungen direkt und effizient.
Mit dem passenden Ansatz bleiben Lösungen zulässig und erfüllen alle Anforderungen.
Skalierung und Vorverarbeitung
Saubere Skalierung und Vorverarbeitung können die Performance von Optimierern massiv verbessern:
- Skalierung: Normalisiere oder standardisiere Eingaben, damit Features gleichgewichtig zur Zielfunktion beitragen. Das verbessert numerische Stabilität und Konvergenzraten.
- Vorverarbeitung: Nutze Feature Engineering oder Dimensionalitätsreduktion, um das Problem zu vereinfachen. Das senkt die Komplexität und beschleunigt die Lösung.
Ergebnisse interpretieren
Bei der Interpretation von Optimierungsergebnissen sind mehrere Aspekte wichtig:
- Lösungsqualität: Prüfe, ob Optimalitätsbedingungen und Nebenbedingungen erfüllt sind. Vergleiche mit Benchmarks oder validiere per Cross-Validation.
- Konvergenzkriterien: Überprüfe Meldungen zur Konvergenz, die Anzahl Iterationen oder Änderungen des Zielfunktionswerts. Stelle sicher, dass ein Punkt nahe am wahren Optimum erreicht wurde.
- Numerische Präzision: Beachte den Einfluss numerischer Rundungsfehler. Kleine Fehler können sich aufaddieren – besonders bei großen Problemen oder engen Toleranzen.
Fazit
Numerische Optimierung ist ein Fundament moderner Problemlösung. Sie liefert mächtige Werkzeuge für Herausforderungen in Machine Learning, Engineering, Finanzen und Operations Research.
Das reichhaltige Python-Ökosystem – etwa SciPy, CVXPY und Pyomo – macht fortgeschrittene Techniken zugänglich und ermöglicht es Forschenden, Ingenieurinnen und Ingenieuren sowie Data Scientists, effiziente Systeme zu entwerfen, Modelle zu optimieren und smartere, datenbasierte Entscheidungen zu treffen.
Mit den richtigen Techniken und Best Practices bist du bestens gerüstet, auch anspruchsvolle Optimierungsprobleme in Python zu lösen. Für deinen nächsten Schritt empfehlen wir:
Fähigkeiten im Bereich Machine Learning aufbauen
FAQs
Was ist Optimierung?
Optimierung ist der Prozess, mithilfe iterativer Rechenmethoden statt analytischer Lösungen das Minimum oder Maximum einer Funktion zu finden.
Warum ist Optimierung wichtig?
Optimierung ist wichtig, weil sie hilft, komplexe, reale Probleme in Bereichen wie Machine Learning, Engineering und Finanzen zu lösen, für die direkte Lösungen unpraktisch oder unmöglich sind.
Welche Python-Packages eignen sich für numerische Optimierung?
Beliebte Python-Packages für numerische Optimierung sind SciPy (Allzweck-Optimierung), CVXPY (konvexe Optimierung), Pyomo (flexibles Modellieren) sowie leistungsstarke Solver wie Gurobi und CPLEX für großskalige Industrieanwendungen.
Wie wird numerische Optimierung im Machine Learning genutzt?
Im Machine Learning wird numerische Optimierung eingesetzt, um die Verlustfunktion zu minimieren – also zu messen, wie gut ein Modell seine Zielgrößen vorhersagt.
Was ist der Unterschied zwischen beschränkter und unbeschränkter Optimierung?
Unbeschränkte Optimierung sucht das Optimum einer Zielfunktion ohne Einschränkungen der Variablen. Beschränkte Optimierung legt hingegen Nebenbedingungen (Gleichungen/Ungleichungen) fest; die optimale Lösung muss diese erfüllen und gleichzeitig die Funktion optimieren.
