मुख्य सामग्री पर जाएं

2026 के लिए शीर्ष 30 RAG इंटरव्यू प्रश्न और उत्तर

बुनियादी से लेकर उन्नत अवधारणाओं तक को कवर करने वाले 30 प्रमुख RAG इंटरव्यू प्रश्नों के साथ अपने AI इंटरव्यू के लिए तैयार रहें।
अपडेट किया गया 25 सित॰ 2026  · 15 मि॰ पढ़ें

AI के साथ खोजें

ChatGPTClaudePerplexity

रीट्रीवल-अगमेंटेड जेनरेशन (RAG) टेक्स्ट जनरेशन प्रक्रिया के दौरान प्रासंगिक बाहरी जानकारी लाने के लिए लार्ज लैंग्वेज मॉडल्स (LLMs) को रीट्रीवल सिस्टम्स के साथ जोड़ता है।

पिछले कुछ वर्षों में, RAG ने काफी लोकप्रियता हासिल की है और AI इंजीनियर, मशीन लर्निंग इंजीनियर, प्रॉम्प्ट इंजीनियर, और डेटा वैज्ञानिक जैसी भूमिकाओं के लिए इंटरव्यू प्रश्नों में आम विषय बन गया है।

यह लेख बुनियादी अवधारणाओं से लेकर अधिक उन्नत विषयों तक 30 प्रमुख प्रश्नों का व्यापक अवलोकन प्रदान करके आपको RAG-संबंधित इंटरव्यू प्रश्नों के लिए तैयार करने का उद्देश्य रखता है।

भले ही आप जल्द इंटरव्यू की तैयारी न कर रहे हों, यह लेख आपके RAG ज्ञान को परखने का अच्छा अवसर हो सकता है।

बेसिक RAG इंटरव्यू प्रश्न

आइए RAG से जुड़े कुछ मूलभूत इंटरव्यू प्रश्नों से शुरुआत करें।

RAG सिस्टम के मुख्य हिस्सों को समझाइए और वे कैसे काम करते हैं।

एक RAG (रीट्रीवल-अगमेंटेड जेनरेशन) सिस्टम में दो मुख्य अवयव होते हैं: रीट्रीवर और जेनरेटर।

रीट्रीवर बाहरी स्रोतों, जैसे डेटाबेस, दस्तावेज़, या वेबसाइटों से प्रासंगिक जानकारी खोजता और एकत्र करता है।

जेनरेटर, जो आमतौर पर एक उन्नत भाषा मॉडल होता है, इस जानकारी का उपयोग करके स्पष्ट और सटीक टेक्स्ट बनाता है।

रीट्रीवर सुनिश्चित करता है कि सिस्टम को सबसे नवीन जानकारी मिले, जबकि जेनरेटर इसे अपनी स्वयं की जानकारी के साथ मिलाकर बेहतर उत्तर तैयार करता है।

मिलकर, वे अकेले जेनरेटर की तुलना में अधिक सटीक उत्तर देते हैं।

सिर्फ LLM की आंतरिक जानकारी पर निर्भर रहने की बजाय RAG का उपयोग करने के मुख्य लाभ क्या हैं?

यदि आप केवल LLM की बिल्ट-इन जानकारी पर निर्भर रहते हैं, तो सिस्टम उसी तक सीमित रहता है जिस पर उसे प्रशिक्षित किया गया था, जो पुराना या अपर्याप्त हो सकता है।

RAG सिस्टम बाहरी स्रोतों से नई जानकारी खींचकर एक बड़ा लाभ देते हैं, जिससे अधिक सटीक और समयानुकूल उत्तर मिलते हैं।

यह तरीका "हैलुसिनेशन"—जहाँ मॉडल तथ्य गढ़ देता है—को भी कम करता है, क्योंकि उत्तर वास्तविक डेटा पर आधारित होते हैं। RAG विशेष रूप से कानून, चिकित्सा, या टेक जैसी विशिष्ट क्षेत्रों में उपयोगी है, जहाँ नवीनतम और विशेषज्ञ-स्तरीय ज्ञान आवश्यक होता है।

RAG के कुछ सामान्य उपयोग क्या हैं?

RAG का उपयोग विभिन्न डोमेनों में वास्तविक-जीवन AI अनुप्रयोगों में किया जाता है:

  • प्रश्न-उत्तर और सपोर्ट सिस्टम: RAG ग्राहक सहायता चैटबॉट्स और नॉलेज-बेस असिस्टेंट्स को नवीनतम दस्तावेज़ीकरण या FAQs को रीट्रीव कर उपयोगकर्ताओं के लिए सटीक उत्तर जनरेट करने में सक्षम बनाता है। इससे ग्राहक प्रश्नों का समाधान ताज़ा जानकारी से होता है (जैसे, मौजूदा नीतियों या उत्पाद विवरण को खींचना)।

  • संवादी एजेंट: कई चैटबॉट्स और वर्चुअल असिस्टेंट्स तथ्यात्मक, संदर्भ-सचेत उत्तर देने के लिए RAG का उपयोग करते हैं। चलते-फिरते प्रासंगिक तथ्य लाकर, एक संवादात्मक एजेंट (जैसे हेल्थकेयर या फाइनेंस चैटबॉट) विश्वसनीय स्रोतों पर आधारित जानकारीपूर्ण उत्तर दे सकता है।

  • कंटेंट जनरेशन और सार-संक्षेप: RAG तथ्यात्मक शुद्धता के साथ सामग्री जनरेट या सार-संक्षेप करने में मदद करता है। उदाहरण के लिए, यह समाचार लेखों या शोध-पत्रों के अंश रीट्रीव कर सुसंगत और स्रोत डेटा से सत्यापित सारांश या रिपोर्ट तैयार कर सकता है।

  • डोमेन-विशिष्ट शोध: कानून या चिकित्सा जैसे विशिष्ट क्षेत्रों में, RAG सिस्टम केस लॉ, मेडिकल जर्नल्स आदि जैसे डोमेन-विशिष्ट डेटाबेस से जानकारी लेकर जटिल प्रश्नों का उत्तर देने में सहायक होते हैं। इस प्रकार, मॉडल का आउटपुट विश्वसनीय और अद्यतन डोमेन ज्ञान पर आधारित होता है, जो पेशेवर उपयोग मामलों के लिए महत्वपूर्ण है।

RAG किन प्रकार के बाहरी ज्ञान स्रोतों का उपयोग कर सकता है?

RAG सिस्टम संरचित और असंरचित, दोनों प्रकार के बाहरी स्रोतों से जानकारी जुटा सकते हैं:

  • संरचित स्रोत में डेटाबेस, APIs, या नॉलेज ग्राफ शामिल हैं, जहाँ डेटा व्यवस्थित और खोजने में आसान होता है।
  • असंरचित स्रोत बड़े टेक्स्ट संकलन होते हैं, जैसे दस्तावेज़, वेबसाइटें, या आर्काइव, जहाँ जानकारी को नैचुरल लैंग्वेज अंडरस्टैंडिंग का उपयोग करके प्रोसेस करना पड़ता है।

यह लचीलापन RAG सिस्टम्स को विभिन्न क्षेत्रों, जैसे कानूनी या चिकित्सा उपयोग, के अनुरूप ढालने देता है—केस लॉ डेटाबेस, शोध जर्नल्स, या क्लीनिकल ट्रायल डेटा से जानकारी खींचकर।

क्या RAG में प्रॉम्प्ट इंजीनियरिंग मायने रखती है?

प्रॉम्प्ट इंजीनियरिंग रीट्रीव की गई जानकारी का उपयोग करते हुए भाषा मॉडलों को उच्च-गुणवत्ता वाले उत्तर देने में मदद करती है। आप प्रॉम्प्ट कैसे डिज़ाइन करते हैं, यह आउटपुट की प्रासंगिकता और स्पष्टता को प्रभावित कर सकता है।

  • विशिष्ट सिस्टम प्रॉम्प्ट टेम्पलेट्स मॉडल को दिशा देने में मदद करते हैं। उदाहरण के लिए, साधारण "प्रश्न का उत्तर दें" की जगह आप कह सकते हैं, "केवल दिए गए संदर्भ के आधार पर प्रश्न का उत्तर दें।" यह मॉडल को स्पष्ट निर्देश देता है कि उत्तर देने के लिए सिर्फ दिए गए संदर्भ का ही उपयोग करें, जिससे हैलुसिनेशन की संभावना घटती है।
  • फ्यू-शॉट प्रॉम्प्टिंग में मॉडल को अपनी प्रतिक्रिया देने से पहले कुछ उदाहरण प्रतिक्रियाएँ दी जाती हैं, ताकि उसे पता रहे कि आप किस प्रकार का उत्तर चाहते हैं।
  • चेन-ऑफ-थॉट प्रॉम्प्टिंग जटिल प्रश्नों को तोड़कर चरण-दर-चरण तर्क समझाने के लिए मॉडल को प्रेरित करता है, फिर उत्तर देता है।

RAG सिस्टम में रीट्रीवर कैसे काम करता है? सामान्य रीट्रीवल विधियाँ क्या हैं?

RAG सिस्टम में रीट्रीवर जेनरेटर के उपयोग के लिए बाहरी स्रोतों से प्रासंगिक जानकारी एकत्र करता है। जानकारी रीट्रीव करने के अलग-अलग तरीके हैं।

एक तरीका है स्पार्स रीट्रीवल, जो कीवर्ड्स का मिलान करता है (जैसे, TF-IDF या BM25)। यह सरल है, लेकिन शब्दों के गहरे अर्थ को पकड़ नहीं सकता।

दूसरा तरीका है डेंस रीट्रीवल, जो डॉक्यूमेंट्स और क्वेरी के अर्थ को समझने के लिए न्यूरल एम्बेडिंग्स का उपयोग करता है। BERT या Dense Passage Retrieval (DPR) जैसी विधियाँ डॉक्यूमेंट्स को साझा स्पेस में वेक्टर के रूप में निरूपित करती हैं, जिससे रीट्रीवल अधिक सटीक होता है।

इन तरीकों के बीच चयन RAG सिस्टम के प्रदर्शन पर बड़ा प्रभाव डाल सकता है।

रीट्रीव की गई जानकारी को LLM जनरेशन के साथ जोड़ने की चुनौतियाँ क्या हैं?

रीट्रीव की गई जानकारी को LLM की जनरेशन के साथ जोड़ने में कुछ चुनौतियाँ आती हैं। उदाहरण के लिए, रीट्रीव किया गया डेटा क्वेरी के लिए अत्यधिक प्रासंगिक होना चाहिए, क्योंकि अप्रासंगिक डेटा मॉडल को भ्रमित कर सकता है और उत्तर की गुणवत्ता घटा सकता है।

साथ ही, यदि रीट्रीव की गई जानकारी मॉडल की आंतरिक जानकारी से टकराती है, तो यह उलझनपूर्ण या गलत उत्तर दे सकती है। इसलिए, इन टकरावों को उपयोगकर्ता को भ्रमित किए बिना सुलझाना महत्वपूर्ण है।

अंततः, रीट्रीव डेटा की शैली और फॉर्मेट हमेशा मॉडल की सामान्य लेखन शैली या फॉर्मेटिंग से मेल नहीं खाते, जिससे जानकारी का सहज एकीकरण कठिन हो सकता है।

RAG में वेक्टर डेटाबेस की क्या भूमिका है?

RAG सिस्टम में, वेक्टर डेटाबेस टेक्स्ट की डेंस एम्बेडिंग्स को प्रबंधित और संग्रहीत करने में मदद करता है। ये एम्बेडिंग्स शब्दों और वाक्यांशों के अर्थ को पकड़ने वाले संख्यात्मक निरूपण होते हैं, जिन्हें BERT या OpenAI जैसे मॉडलों द्वारा बनाया जाता है।

जब कोई क्वेरी भेजी जाती है, तो उसकी एम्बेडिंग को डेटाबेस में संग्रहीत एम्बेडिंग्स से मिलाकर समान डॉक्यूमेंट्स खोजे जाते हैं। इससे सही जानकारी को तेज़ी और अधिक सटीकता से रीट्रीव करना संभव होता है। यह प्रक्रिया सिस्टम को सबसे प्रासंगिक जानकारी जल्दी ढूंढने और प्रस्तुत करने में मदद करती है, जिससे गति और सटीकता दोनों में सुधार होता है।

RAG सिस्टम्स का मूल्यांकन करने के कुछ सामान्य तरीके क्या हैं?

किसी RAG सिस्टम का मूल्यांकन करने के लिए, आपको रीट्रीवल और जनरेशन, दोनों घटकों को देखना होता है।

  • रीट्रीवर के लिए, आप जाँचते हैं कि रीट्रीव किए गए डॉक्यूमेंट्स कितने सटीक और प्रासंगिक हैं। यहाँ प्रिसिजन (रीट्रीव डॉक्यूमेंट्स में से कितने प्रासंगिक हैं) और रीकॉल (कुल प्रासंगिक डॉक्यूमेंट्स में से कितने मिले) जैसे मेट्रिक्स का उपयोग किया जा सकता है।
  • जेनरेटर के लिए, BLEU और ROUGE जैसे मेट्रिक्स का उपयोग जनरेटेड टेक्स्ट की मानव-लिखित उदाहरणों से तुलना कर गुणवत्ता आँकने के लिए किया जा सकता है।

क्वेश्चन-आंस‍रिंग जैसे डाउनस्‍ट्रीम कार्यों के लिए, F1 स्कोर, प्रिसिजन, और रीकॉल जैसे मेट्रिक्स का उपयोग पूरे RAG सिस्टम का मूल्यांकन करने के लिए भी किया जा सकता है।

RAG सिस्टम में अस्पष्ट या अधूरी क्वेरीज़ को कैसे संभालते हैं ताकि प्रासंगिक परिणाम सुनिश्चित हों?

RAG सिस्टम में अस्पष्ट या अधूरी क्वेरीज़ को संभालने के लिए ऐसी रणनीतियाँ चाहिए जो उपयोगकर्ता के इनपुट में स्पष्टता की कमी के बावजूद प्रासंगिक और सटीक जानकारी रीट्रीव कर सकें।

एक तरीका क्वेरी रिफाइनमेंट तकनीकों को लागू करना है, जहाँ सिस्टम स्वचालित रूप से स्पष्टीकरण सुझाता है या अस्पष्ट क्वेरी को ज्ञात पैटर्न या पिछले इंटरेक्शंस के आधार पर अधिक सटीक रूप में पुनर्गठित करता है। इसमें फॉलो-अप प्रश्न पूछना या उपयोगकर्ता को अपनी मंशा सीमित करने के लिए कई विकल्प देना शामिल हो सकता है।

दूसरा तरीका क्वेरी की एकाधिक संभावित व्याख्याओं को कवर करने वाले विविध डॉक्यूमेंट्स का सेट रीट्रीव करना है। विभिन्न परिणामों को रीट्रीव करके, सिस्टम सुनिश्चित करता है कि भले ही क्वेरी अस्पष्ट हो, कुछ प्रासंगिक जानकारी शामिल होने की संभावना बनी रहे।

अंत में, हम नैचुरल लैंग्वेज अंडरस्टैंडिंग (NLU) मॉडल्स का उपयोग कर अधूरी क्वेरीज़ से उपयोगकर्ता की मंशा का अनुमान लगा सकते हैं और रीट्रीवल प्रक्रिया को परिष्कृत कर सकते हैं।

इंटरमीडिएट RAG इंटरव्यू प्रश्न

अब जब हमने कुछ बुनियादी प्रश्न कवर कर लिए हैं, तो इंटरमीडिएट RAG इंटरव्यू प्रश्नों की ओर बढ़ते हैं।

आप किसी RAG एप्लिकेशन के लिए सही रीट्रीवर कैसे चुनते हैं?

सही रीट्रीवर का चुनाव आपके डेटा के प्रकार, क्वेरी की प्रकृति, और उपलब्ध कंप्यूटिंग संसाधनों पर निर्भर करता है।

जटिल क्वेरीज़, जहाँ शब्दों के पीछे के अर्थ की गहरी समझ चाहिए, के लिए BERT या DPR जैसी डेंस रीट्रीवल विधियाँ बेहतर हैं। ये संदर्भ पकड़ती हैं और कस्टमर सपोर्ट या शोध जैसे कार्यों के लिए आदर्श हैं, जहाँ अंतर्निहित अर्थ समझना मायने रखता है।

यदि कार्य सरल है और कीवर्ड मिलान के इर्द-गिर्द घूमता है, या यदि आपके पास सीमित कंप्यूट संसाधन हैं, तो BM25 या TF-IDF जैसी स्पार्स रीट्रीवल विधियाँ अधिक उपयुक्त हो सकती हैं। ये तेज़ और सेटअप में आसान हैं, लेकिन संभव है कि वे ऐसे डॉक्यूमेंट्स न ढूँढें जिनमें सटीक कीवर्ड न हों।

डेंस और स्पार्स रीट्रीवल के बीच मुख्य संतुलन सटीकता बनाम कंप्यूटेशनल लागत का होता है। कई बार, दोनों तरीकों को मिलाकर एक हाइब्रिड रीट्रीवल सिस्टम बनाना कंप्यूटेशनल दक्षता के साथ सटीकता का संतुलन बना सकता है। इस तरह, आप अपनी जरूरतों के अनुसार डेंस और स्पार्स, दोनों के फायदे ले सकते हैं।

हाइब्रिड सर्च क्या है?

हाइब्रिड सर्च डेंस और स्पार्स, दोनों रीट्रीवल विधियों की ताकतों को जोड़ती है।

उदाहरण के लिए, आप पहले BM25 जैसी स्पार्स विधि से कीवर्ड्स के आधार पर डॉक्यूमेंट्स तेजी से ढूँढ सकते हैं। फिर, BERT जैसी डेंस विधि से उन डॉक्यूमेंट्स को उनके संदर्भ और अर्थ समझकर री-रैंक कर सकते हैं। इससे स्पार्स सर्च की गति के साथ डेंस विधियों की सटीकता मिलती है, जो जटिल क्वेरीज़ और बड़े डेटासेट्स के लिए उत्कृष्ट है।

क्या RAG लागू करने के लिए वेक्टर डेटाबेस आवश्यक है? यदि नहीं, तो विकल्प क्या हैं?

वेक्टर डेटाबेस डेंस एम्बेडिंग्स को प्रबंधित करने के लिए बढ़िया है, लेकिन यह हमेशा आवश्यक नहीं है। विकल्पों में शामिल हैं:

  • पारंपरिक डेटाबेस: यदि आप स्पार्स विधियाँ या संरचित डेटा उपयोग कर रहे हैं, तो सामान्य रिलेशनल या NoSQL डेटाबेस पर्याप्त हो सकते हैं। ये कीवर्ड सर्च के लिए अच्छे हैं। MongoDB या Elasticsearch जैसे डेटाबेस असंरचित डेटा और फुल-टेक्स्ट सर्च संभालने में अच्छे हैं, लेकिन गहरे सेमांटिक सर्च की कमी रहती है।
  • इनवर्टेड इंडेसेज़: ये तेज़ सर्च के लिए कीवर्ड्स को डॉक्यूमेंट्स से मैप करते हैं, लेकिन शब्दों के पीछे का अर्थ नहीं पकड़ते।
  • फाइल सिस्टम्स: छोटे सिस्टम्स के लिए, सुव्यवस्थित दस्तावेज़ों को फाइलों में संग्रहीत करना काम आ सकता है, लेकिन इनकी सर्च क्षमताएँ सीमित होती हैं।

सही विकल्प आपकी विशिष्ट जरूरतों पर निर्भर करता है, जैसे डेटा का पैमाना और क्या आपको गहरी सेमांटिक समझ की आवश्यकता है।

आप कैसे सुनिश्चित करते हैं कि रीट्रीव की गई जानकारी प्रासंगिक और सटीक है?

रीट्रीव जानकारी को प्रासंगिक और सटीक बनाने के लिए आप कई दृष्टिकोण अपना सकते हैं:

  • उच्च-गुणवत्ता नॉलेज बेस तैयार करें: सुनिश्चित करें कि आपके डेटाबेस की जानकारी विश्वसनीय है और आपके एप्लिकेशन की जरूरतों के अनुरूप है।
  • रीट्रीवर को फाइन-ट्यून करें: रीट्रीवर मॉडल को आपके विशिष्ट कार्यों और आवश्यकताओं के मुताबिक समायोजित करें। इससे परिणामों की प्रासंगिकता में सुधार होता है।
  • री-रैंकिंग का उपयोग करें: प्रारंभिक परिणाम रीट्रीव करने के बाद, उन्हें विस्तृत प्रासंगिकता के आधार पर क्रमबद्ध करें ताकि सबसे सटीक जानकारी मिले। इसमें यह जाँचना शामिल है कि परिणाम क्वेरी से कितनी गहराई से मेल खाते हैं।
  • फीडबैक लूप्स लागू करें: उपयोगकर्ताओं या मॉडलों से परिणामों की उपयोगिता पर इनपुट लें। यह फीडबैक समय के साथ रीट्रीवर को परिष्कृत करने में मदद करता है। इसका एक उदाहरण है Corrective RAG (CRAG)।
  • नियमित मूल्यांकन: प्रिसिजन, रीकॉल, या F1 स्कोर जैसे मेट्रिक्स के साथ सिस्टम के प्रदर्शन को लगातार मापें ताकि सटीकता और प्रासंगिकता में निरंतर सुधार होता रहे।

RAG में लंबे दस्तावेज़ों या बड़े नॉलेज बेस को संभालने की तकनीकें क्या हैं?

लंबे दस्तावेज़ों या बड़े नॉलेज बेस के साथ काम करते समय, ये तकनीकें उपयोगी हैं:

  1. चंकिंग: लंबे दस्तावेज़ों को छोटे, अधिक प्रबंधनीय हिस्सों में बाँटें। इससे पूरे दस्तावेज़ को प्रोसेस किए बिना प्रासंगिक भागों को खोजने और रीट्रीव करने में आसानी होती है।
  2. सार-संक्षेप (समरीकरण): लंबे दस्तावेज़ों के संक्षिप्त संस्करण बनाएँ। इससे सिस्टम पूरे टेक्स्ट के बजाय छोटे सारांशों के साथ काम कर पाता है, और रीट्रीवल तेज़ होता है।
  3. हाइरार्किकल रीट्रीवल: दो-चरणीय दृष्टिकोण अपनाएँ—पहले व्यापक श्रेणियों में खोजें और फिर विशिष्ट विवरणों तक सीमित करें। यह बड़े पैमाने पर डेटा को अधिक प्रभावी ढंग से प्रबंधित करने में मदद करता है।
  4. मेमोरी-इफिशिएंट एम्बेडिंग्स: कॉम्पैक्ट वेक्टर निरूपण का उपयोग करें ताकि मेमोरी और कंप्यूटिंग की जरूरत कम हो। एम्बेडिंग्स के आकार को अनुकूलित करने से बड़े डेटासेट्स को संभालना आसान होता है।
  5. इंडेक्सिंग और शार्डिंग: नॉलेज बेस को छोटे भागों में बाँटकर कई सिस्टम्स में संग्रहीत करें। इससे पैरेलल प्रोसेसिंग और तेज़ रीट्रीवल संभव होता है, खासकर बड़े सिस्टम्स में।

सटीकता और दक्षता, दोनों के लिहाज से RAG सिस्टम के प्रदर्शन को कैसे अनुकूलित करेंगे?

RAG सिस्टम से सटीकता और दक्षता, दोनों में सर्वश्रेष्ठ प्रदर्शन पाने के लिए आप कई रणनीतियाँ अपना सकते हैं:

  1. मॉडलों को फाइन-ट्यून करें: रीट्रीवर और जेनरेटर को आपके कार्य-विशिष्ट डेटा से समायोजित करें। इससे वे विशेष क्वेरीज़ पर बेहतर प्रदर्शन करते हैं।
  2. दक्ष इंडेक्सिंग: इनवर्टेड इंडेसेज़ या हैशिंग जैसी तेज़ डेटा स्ट्रक्चर्स के साथ नॉलेज बेस को व्यवस्थित करें। इससे प्रासंगिक जानकारी ढूँढना तेज़ होता है।
  3. कैशिंग का उपयोग: बार-बार एक्सेस होने वाले डेटा को स्टोर करें ताकि उसे बार-बार रीट्रीव न करना पड़े। इससे दक्षता और प्रतिक्रिया समय सुधरता है।
  4. रीट्रीवल चरण घटाएँ: खोज की बारंबारता कम करें। रीट्रीवर की प्रिसिजन बढ़ाएँ या री-रैंकिंग का उपयोग करें ताकि केवल श्रेष्ठ परिणाम ही जेनरेटर तक जाएँ और अनावश्यक प्रोसेसिंग घटे।
  5. हाइब्रिड सर्च: स्पार्स और डेंस रीट्रीवल को मिलाएँ। जैसे, स्पार्स रीट्रीवल से जल्दी व्यापक रूप से प्रासंगिक डॉक्यूमेंट्स खोजें, फिर डेंस रीट्रीवल से उन्हें अधिक सटीकता से परिष्कृत और रैंक करें।

एक मल्टी-टर्न बातचीत में RAG सिस्टम संदर्भ कैसे बनाए रखता है?

मल्टी-टर्न बातचीतों (जैसे, चैटबॉट संवाद) में, RAG सिस्टम को बाद के प्रश्नों का सही उत्तर देने के लिए पहले के टर्न्स के प्रासंगिक संदर्भ को साथ लेकर चलना होता है। इसे पाने के लिए, RAG प्रत्येक नई क्वेरी में वार्तालाप का इतिहास सम्मिलित कर सकता है:

  • क्वेरी रिफाइनमेंट: सिस्टम पिछले संवाद से मिली जानकारी का उपयोग कर उपयोगकर्ता के प्रश्न को स्वतः पुनर्लेखित या समृद्ध कर सकता है। पहले के टर्न्स से विवरण जोड़ने पर रीट्रीवर को अधिक सन्दर्भ-समृद्ध क्वेरी मिलती है, जिससे वह चल रही चर्चा से संबंधित डॉक्यूमेंट्स ला सके।

  • कन्वर्सेशन हिस्ट्री शामिल करना: दूसरा तरीका यह है कि मॉडल को इनपुट संदर्भ के हिस्से के रूप में पिछले संवाद टर्न्स का सारांश या सूची दी जाए। कई RAG आर्किटेक्चर्स नए प्रश्न के साथ संदेशों का क्रम (यूज़र और असिस्टेंट का इतिहास) पास करने देती हैं। इस तरह, जब रीट्रीवर जानकारी खोजता है, तो वह स्थापित संदर्भ को ध्यान में रखता है, और जेनरेटर उस संदर्भ का उपयोग कर सुसंगत वार्तालाप बनाए रखता है।

इन तरीकों से, RAG सिस्टम इस बात का हिसाब रखता है कि "किसने क्या कहा" और क्या पहले ही हल किया जा चुका है। यह विवरण भूलने या खुद को दोहराने से बचाता है।

एडवांस्ड RAG इंटरव्यू प्रश्न

अब तक हमने बेसिक और इंटरमीडिएट RAG इंटरव्यू प्रश्न कवर कर लिए हैं, और अब हम चंकिंग तकनीकें या कॉन्टेक्स्चुअलाइज़ेशन जैसे अधिक उन्नत कॉन्सेप्ट्स पर चर्चा करेंगे।

दस्तावेज़ों को तोड़ने (चंकिंग) की विभिन्न तकनीकें क्या हैं, और उनके फायदे-नुकसान क्या हैं?

रीट्रीवल और प्रोसेसिंग के लिए दस्तावेज़ों को तोड़ने के कई तरीके हैं:

  • फिक्स्ड-लेंथ: दस्तावेज़ों को नियत आकार के हिस्सों में बाँटना। करना आसान है, पर कभी-कभी हिस्से तार्किक ब्रेक्स से मेल नहीं खाते, जिससे महत्वपूर्ण जानकारी कट सकती है या अप्रासंगिक सामग्री शामिल हो सकती है।
  • वाक्य-आधारित: वाक्यों के आधार पर तोड़ना वाक्यों की अखंडता बनाए रखता है, जो सूक्ष्म विश्लेषण के लिए अच्छा है। हालांकि, इससे बहुत अधिक हिस्से बन सकते हैं या छोटे वाक्यों में पूर्ण विचार न समा पाने से संदर्भ खो सकता है।
  • पैराग्राफ-आधारित: पैराग्राफ के आधार पर विभाजन संदर्भ बनाए रखने में मदद करता है, पर पैराग्राफ बहुत लंबे हो सकते हैं, जिससे रीट्रीवल और प्रोसेसिंग कम दक्ष हो जाती है।
  • सेमांटिक चंकिंग: अर्थ (जैसे अनुभाग या विषय) के आधार पर हिस्से बनाना। यह संदर्भ स्पष्ट रखता है, पर इसे लागू करना कठिन है क्योंकि इसमें उन्नत टेक्स्ट विश्लेषण की जरूरत होती है।
  • स्लाइडिंग विंडो: ओवरलैपिंग हिस्से बनाते हुए टेक्स्ट पर स्लाइड करना। इससे महत्वपूर्ण जानकारी छूटती नहीं, पर कंप्यूटेशनल लागत बढ़ सकती है और दोहराव भी आ सकता है।

बड़े बनाम छोटे चंक्स में दस्तावेज़ों को बाँटने के बीच क्या समझौते (ट्रेड-ऑफ्स) हैं?

छोटे हिस्से, जैसे वाक्य या छोटे पैराग्राफ, एक ही वेक्टर में संपीड़ित करते समय महत्वपूर्ण संदर्भ जानकारी के पतला होने से बचाते हैं। हालांकि, इससे हिस्सों के पार फैली लंबी निर्भरताएँ खो सकती हैं, जिससे उन संदर्भों को समझना कठिन होता है जो कई हिस्सों में फैले हों।

बड़े हिस्से अधिक संदर्भ बनाए रखते हैं, जिससे समृद्ध सन्दर्भ सूचना मिलती है, लेकिन वे कम फोकस्ड हो सकते हैं और सारी जानकारी को एक ही वेक्टर में कोड करते समय कुछ बातें खो सकती हैं।

लेट चंकिंग क्या है और यह पारंपरिक चंकिंग विधियों से कैसे अलग है?

लेट चंकिंग दस्तावेज़ प्रोसेसिंग में पारंपरिक चंकिंग विधियों की सीमाओं को दूर करने के लिए बनाई गई एक प्रभावी पद्धति है।

पारंपरिक तरीकों में, पहले दस्तावेज़ों को वाक्य या पैराग्राफ जैसे हिस्सों में बाँटा जाता है, फिर एम्बेडिंग मॉडल लगाया जाता है। इन हिस्सों को फिर अलग-अलग वेक्टर में एन्कोड किया जाता है, और प्रायः प्रत्येक हिस्से के लिए एक एम्बेडिंग बनाने हेतु मीन पूलिंग का उपयोग होता है। यह तरीका लंबी दूरी की संदर्भ निर्भरताओं के खोने का कारण बन सकता है, क्योंकि एम्बेडिंग्स पूरे दस्तावेज़ के संदर्भ पर ध्यान दिए बिना स्वतंत्र रूप से जेनरेट होती हैं।

लेट चंकिंग अलग दृष्टिकोण अपनाता है। यह पहले एम्बेडिंग मॉडल की ट्रांसफॉर्मर लेयर को पूरे दस्तावेज़ (या जितना संभव हो सके) पर लागू करता है और प्रत्येक टोकन के लिए वेक्टर निरूपणों का अनुक्रम बनाता है। यह विधि इन टोकन-स्तरीय एम्बेडिंग्स में टेक्स्ट के पूरे संदर्भ को कैप्चर करती है।

इसके बाद, टोकन वेक्टरों के इस अनुक्रम के हिस्सों पर मीन पूलिंग लागू की जाती है, जिससे प्रत्येक हिस्से की एम्बेडिंग बनती है जो पूरे दस्तावेज़ के संदर्भ से सूचित होती है। पारंपरिक पद्धति के विपरीत, लेट चंकिंग परस्पर-शर्तित चंक एम्बेडिंग्स बनाता है, जिससे अधिक संदर्भ सूचना संरक्षित होती है और लंबी दूरी की निर्भरताएँ सुलझती हैं।

प्रक्रिया में बाद में चंकिंग लागू करके, यह सुनिश्चित करता है कि प्रत्येक चंक की एम्बेडिंग पूरे दस्तावेज़ द्वारा प्रदान किए गए समृद्ध संदर्भ से लाभान्वित हो, न कि अलग-थलग रहे। यह तरीका संदर्भ-हानि की समस्या दूर करता है और रीट्रीवल व जनरेशन कार्यों के लिए उपयोग की जाने वाली एम्बेडिंग्स की गुणवत्ता में सुधार करता है।
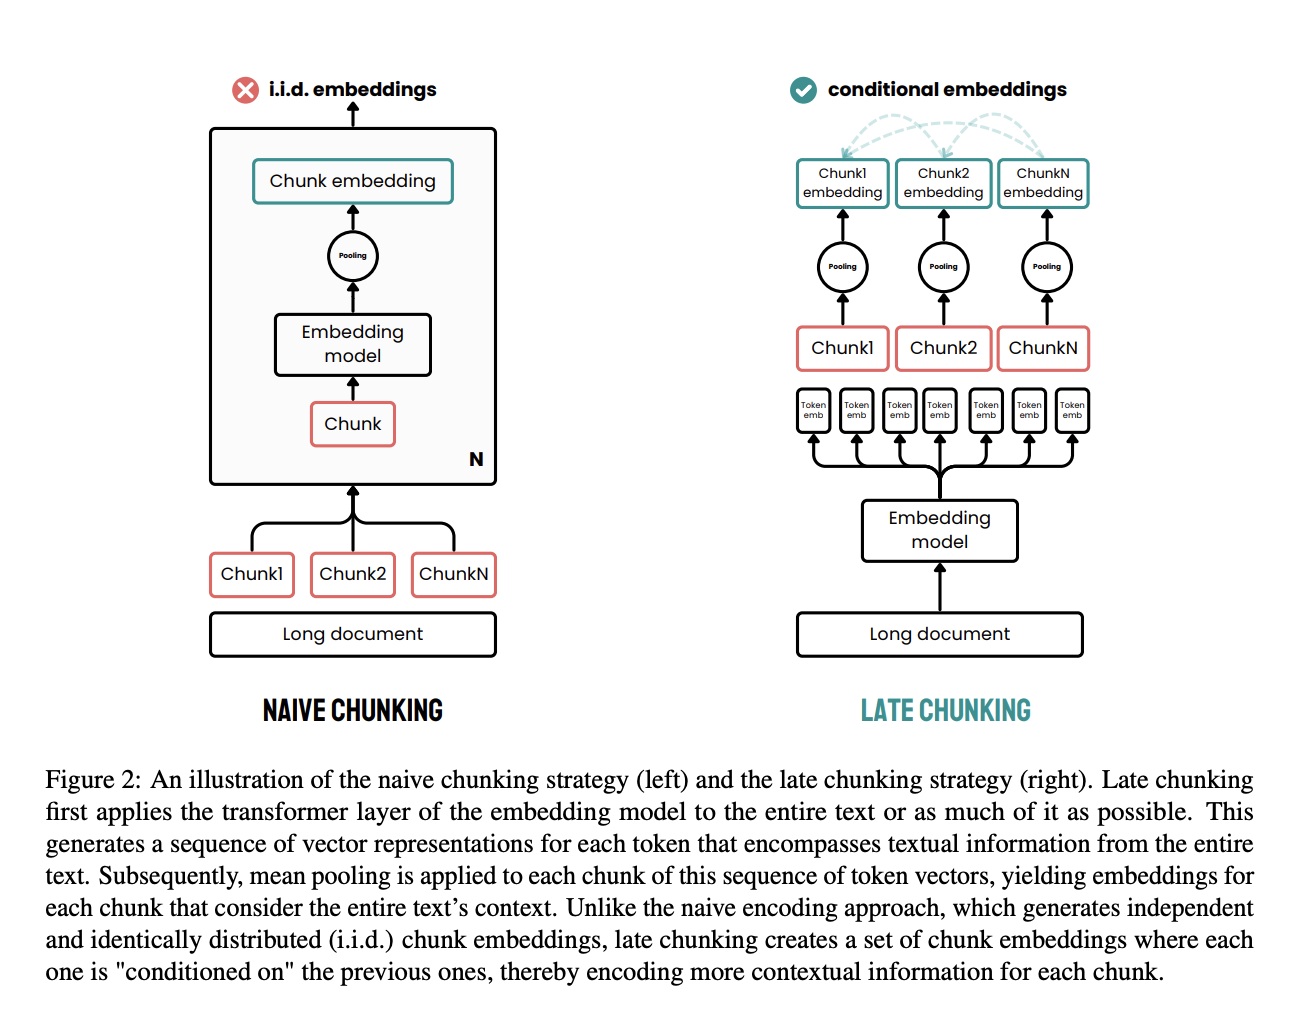
RAG सिस्टम्स में लेट चंकिंग

स्रोत: Günther et al., 2024

RAG में "कॉन्टेक्स्चुअलाइज़ेशन" की अवधारणा समझाइए और इसका प्रदर्शन पर क्या प्रभाव पड़ता है।

RAG में कॉन्टेक्स्चुअलाइज़ेशन का अर्थ है यह सुनिश्चित करना कि रीट्रीव की गई जानकारी क्वेरी के लिए प्रासंगिक हो। क्वेरी के साथ रीट्रीव डेटा को मिलाकर, सिस्टम बेहतर और अधिक प्रासंगिक उत्तर देता है।

इससे गलत या अप्रासंगिक परिणामों की संभावना कम होती है और आउटपुट उपयोगकर्ता की जरूरतों के अनुरूप रहता है। एक तरीका यह है कि जेनरेटर मॉडल को भेजने से पहले रीट्रीव डॉक्यूमेंट्स की प्रासंगिकता जाँचने के लिए किसी LLM का उपयोग करें, जैसा कि Corrective RAG (CRAG) में प्रदर्शित है।

रीट्रीव की गई जानकारी या LLM की जनरेशन में संभावित पक्षपात (बायस) को कैसे संबोधित करेंगे?

पहला कदम यह है कि नॉलेज बेस को इस तरह बनाएं कि पक्षपाती सामग्री फ़िल्टर हो जाए और जानकारी यथासंभव निष्पक्ष रहे। आप रीट्रीवल सिस्टम को भी पुन:प्रशिक्षित कर संतुलित, निष्पक्ष स्रोतों को प्राथमिकता दिला सकते हैं।

एक अन्य महत्वपूर्ण कदम संभावित पक्षपात की जाँच के लिए एक एजेंट अपनाना हो सकता है, ताकि मॉडल का आउटपुट निष्पक्ष बना रहे।

RAG में गतिशील या विकसित होते नॉलेज बेस को संभालने की चुनौतियों पर चर्चा करें।

एक बड़ा मुद्दा नवीनतम जानकारी के साथ इंडेक्स किए गए डेटा को अद्यतन रखना है, जिसके लिए विश्वसनीय अपडेटिंग तंत्र चाहिए। इस प्रकार, विभिन्न संस्करणों का प्रबंधन और स्थिरता सुनिश्चित करने के लिए वर्शन कंट्रोल महत्वपूर्ण हो जाता है।

इसके अलावा, मॉडल को बार-बार पुन:प्रशिक्षण के बिना, जो संसाधन-गहन हो सकता है, रियल-टाइम में नई जानकारी के अनुसार ढलने में सक्षम होना चाहिए। इन चुनौतियों के लिए परिष्कृत समाधान आवश्यक हैं ताकि नॉलेज बेस के विकसित होने के साथ-साथ सिस्टम सटीक और प्रासंगिक बना रहे।

CAG क्या है, और यह पारंपरिक RAG से कैसे अलग है? प्रोडक्शन में आप कब CAG को RAG पर प्राथमिकता देंगे?

CAG (कैश-अगमेंटेड जेनरेशन) RAG का एक उन्नत रूप है, जहाँ रीट्रीव किए गए डॉक्यूमेंट्स को LLM को भेजने से पहले संक्षेपित या संपीड़ित किया जाता है। इससे प्रासंगिकता बढ़ती है, टोकन उपयोग घटता है, और मॉडल के कॉन्टेक्स्ट विंडो में अधिक जानकारी समा पाती है।

मुख्य अंतर यह है कि CAG में, रीट्रीव की गई सामग्री जेनरेटर तक जाने से पहले एक मध्यवर्ती चरण (जैसे समरीज़र या संदर्भ परिष्कर्ता) से गुजरती है। जबकि पारंपरिक RAG में कच्चे डॉक्यूमेंट्स सीधे प्रॉम्प्ट में पास किए जाते हैं।

CAG विशेष रूप से तब उपयोगी है जब:

  • आप स्थिर डेटासेट्स (जैसे प्रोडक्ट कैटलॉग, शैक्षणिक पेपर्स) पर काम कर रहे हों जिन्हें पहले से संपीड़ित और कैश किया जा सकता है।

  • टोकन दक्षता महत्वपूर्ण हो (जैसे, लागत-संवेदनशील APIs या मोबाइल/ऑन-डिवाइस इन्फरेंस)।

  • रीट्रीव किए गए डॉक्यूमेंट्स लंबे या शोरयुक्त हों और उन्हें डिस्टिलेशन की आवश्यकता हो।

दूसरी ओर, RAG तब प्राथमिकता पाता है जब:

  • आधारभूत डेटा गतिशील या अक्सर अपडेट होता हो (जैसे, रियल-टाइम सपोर्ट टिकट्स, लाइव डॉक्यूमेंटेशन)।

  • आप पूरे नॉलेज बेस को पुन:प्रोसेस किए बिना, क्वेरी समय पर सबसे ताज़ा ज्ञान सम्मिलित करना चाहते हों।

संक्षेप में, स्थिर डोमेन्स के लिए CAG उपयोग करें जहाँ आप पहले से संदर्भ को अनुकूलित कर सकते हैं, और गतिशील परिदृश्यों के लिए RAG, जहाँ ताजगी और ऑन-डिमांड रीट्रीवल अधिक महत्वपूर्ण हैं।

इस विषय पर अधिक विस्तृत तुलना के लिए RAG बनाम CAG लेख देखें।

कुछ उन्नत RAG सिस्टम्स कौन-से हैं?

कई उन्नत RAG सिस्टम्स मौजूद हैं।

एक सिस्टम है एडैप्टिव RAG, जहाँ सिस्टम न केवल जानकारी रीट्रीव करता है बल्कि क्वेरी के आधार पर वास्तविक समय में अपने तरीके को समायोजित भी करता है। एडैप्टिव RAG यह तय कर सकता है कि कोई रीट्रीवल न किया जाए, सिंगल-शॉट RAG किया जाए, या इटरेटिव RAG। यह डायनेमिक व्यवहार सिस्टम को उपयोगकर्ता के अनुरोध के अनुरूप अधिक मज़बूत और प्रासंगिक बनाता है।

एक अन्य उन्नत सिस्टम है एजेंटिक RAG, जो रीट्रीवल एजेंट्स—ऐसे टूल्स—प्रस्तुत करता है जो तय करते हैं कि किसी स्रोत से जानकारी खींचनी है या नहीं। भाषा मॉडल को यह क्षमता देकर, वह स्वयं निर्णय कर सकता है कि उसे अतिरिक्त जानकारी चाहिए या नहीं, जिससे प्रक्रिया सुगम होती है।

Corrective RAG (CRAG) भी लोकप्रिय हो रहा है। इस पद्धति में, सिस्टम रीट्रीव किए गए डॉक्यूमेंट्स की समीक्षा करता है और प्रासंगिकता की जाँच करता है। केवल प्रासंगिक के रूप में वर्गीकृत डॉक्यूमेंट्स ही जेनरेटर तक भेजे जाते हैं। यह स्व-सुधार चरण सुनिश्चित करता है कि सटीक और प्रासंगिक जानकारी का उपयोग हो। अधिक जानने के लिए, यह ट्यूटोरियल पढ़ें: Corrective RAG (CRAG) Implementation With LangGraph।

Self-RAG इसे एक कदम आगे ले जाता है—यह केवल रीट्रीव डॉक्यूमेंट्स ही नहीं, बल्कि अंतिम जनरेटेड प्रतिक्रियाओं का भी मूल्यांकन करता है, ताकि दोनों उपयोगकर्ता की क्वेरी के अनुरूप हों। इससे अधिक विश्वसनीय और सुसंगत परिणाम मिलते हैं।

रियल-टाइम RAG सिस्टम में सटीकता से समझौता किए बिना लेटेंसी कैसे घटाएँगे?

एक प्रभावी तरीका है अक्सर माँगी जाने वाली प्रासंगिक जानकारी को पहले से प्री-फेच करना ताकि आवश्यकता पड़ने पर वह तुरंत उपलब्ध हो। साथ ही, अपनी इंडेक्सिंग और क्वेरी एल्गोरिद्म्स को परिष्कृत करना भी डेटा को तेज़ी से रीट्रीव और प्रोसेस करने में बड़ा अंतर ला सकता है।

RAG सिस्टम्स की कुछ सीमाएँ या चुनौतियाँ क्या हैं?

हालाँकि RAG शक्तिशाली है, इसकी कई सीमाएँ और चुनौतियाँ हैं:

  • रीट्रीव डेटा गुणवत्ता पर निर्भरता: RAG सिस्टम उतना ही अच्छा है जितनी अच्छी जानकारी वह रीट्रीव करता है। यदि रीट्रीवर अप्रासंगिक या गलत डॉक्यूमेंट्स लाता है, तो जेनरेटर का उत्तर प्रभावित होगा। उच्च-गुणवत्ता, विश्वसनीय स्रोतों को सुनिश्चित करना (और रीट्रीवर को फाइन-ट्यून करना) लगातार चुनौती है, ताकि गार्बेज-इन, गार्बेज-आउट से बचा जा सके।

  • जटिलता और लेटेंसी में वृद्धि: RAG जनरेशन के ऊपर एक अतिरिक्त रीट्रीवल चरण जोड़ता है, जिससे पूरा सिस्टम स्टैंडअलोन LLM की तुलना में अधिक जटिल और कम्प्यूटेशनली भारी हो जाता है। बड़े नॉलेज बेस में खोज करना लेटेंसी बढ़ा सकता है और उल्लेखनीय कंप्यूट संसाधन माँग सकता है, इसलिए RAG सिस्टम्स को सटीकता और दक्षता का संतुलन बनाना होता है।

  • नॉलेज बेस का रखरखाव: स्थिर LLMs के विपरीत, RAG बाहरी नॉलेज रिपॉजिटरी पर निर्भर करता है जिसे नियमित रूप से अपडेट और क्यूरेट करना पड़ता है। संगठनों को लगातार नया डेटा शामिल करना, पुरानी जानकारी हटाना, और इंडेसेज़ का प्रबंधन करना होता है। विश्वसनीय और अद्यतन स्रोतों के बिना, RAG जल्दी कम प्रभावी हो सकता है या पुराने उत्तर दे सकता है।

  • इंटेग्रेशन और ट्यूनिंग की कठिनाई: रीट्रीवल और जनरेशन को जोड़ना मतलब अधिक घटकों को ट्यून और मॉनिटर करना (वेक्टर डेटाबेस, रीट्रीवर मॉडल, और LLM)। त्रुटियों का निवारण कठिन हो सकता है क्योंकि समस्या रीट्रीवल या जनरेशन, किसी भी ओर से आ सकती है। यह जटिलता अकेले LLM उपयोग की तुलना में विकास और रखरखाव प्रयास बढ़ा सकती है।

यह भी ध्यान देने योग्य है कि यदि किसी डोमेन का डेटा अधिकांशतः स्थिर है और मॉडल के प्रशिक्षण में समा जाता है, तो फाइन-ट्यून किया गया LLM RAG के स्थान पर पर्याप्त हो सकता है। हालाँकि, फाइन-ट्यूनिंग में RAG की वह क्षमता नहीं होती कि वह तुरंत ताज़ी जानकारी शामिल कर सके, और प्रत्येक नॉलेज अपडेट पर पुन:प्रशिक्षण महँगा पड़ सकता है।

AI इंजीनियर्स के लिए RAG इंटरव्यू प्रश्न

अब, आइए AI इंजीनियर पदों के लिए इंटरव्यू देने वालों को लक्षित कुछ विशिष्ट प्रश्नों पर बात करें।

आप प्रोडक्शन वातावरण में RAG सिस्टम के प्रदर्शन का मूल्यांकन और सुधार कैसे करेंगे?

सबसे पहले, आपको उपयोगकर्ता फीडबैक को ट्रैक करना होगा ताकि आंका जा सके कि सिस्टम कितना अच्छा काम कर रहा है और कितना प्रासंगिक है।

आपको लेटेंसी भी मॉनिटर करनी होगी ताकि प्रतिक्रियाएँ समय पर मिलें, और रीट्रीव डॉक्यूमेंट्स व जनरेटेड आउटपुट्स—दोनों की गुणवत्ता का मूल्यांकन करना होगा। प्रमुख मेट्रिक्स जैसे प्रतिक्रिया सटीकता, उपयोगकर्ता संतुष्टि, और सिस्टम थ्रूपुट महत्वपूर्ण हैं।

प्रदर्शन बढ़ाने के लिए, आप सिस्टम के हिस्सों को अद्यतन डेटा के साथ पुन:प्रशिक्षित कर सकते हैं या पैरामीटर्स में बदलाव कर सकते हैं। आप प्रासंगिकता और दक्षता में सुधार के लिए रीट्रीवल एल्गोरिद्म्स को भी परिष्कृत कर सकते हैं, और नॉलेज स्रोतों को नियमित रूप से अद्यतन रख सकते हैं।

निरंतर परफॉर्मेंस रिव्यूज़ और A/B परीक्षण से लगातार सुधार के लिए अंतर्दृष्टियाँ मिलती हैं।

आप प्रोडक्शन में RAG सिस्टम की विश्वसनीयता और मजबूती कैसे सुनिश्चित करेंगे, खासकर संभावित विफलताओं या अप्रत्याशित इनपुट्स के सामने?

प्रोडक्शन-रेडी RAG सिस्टम बनाते समय विभिन्न चुनौतियों को संभालना पड़ता है। संभावित समाधान शामिल हो सकते हैं:

  • रेडंडेंसी और फेलओवर: विफलताओं की स्थिति में भी निरंतर संचालन सुनिश्चित करने के लिए बैकअप या अतिरिक्त घटकों को लागू करना।
  • एरर हैंडलिंग और लॉगिंग: त्रुटियों को पकड़ने और लॉग करने के लिए प्रणालियाँ लागू करना, जिससे त्वरित निदान और समस्या निवारण संभव हो।
  • इनपुट वैलिडेशन और सैनिटाइज़ेशन: संभावित कमजोरियों और प्रॉम्प्ट इंजेक्शंस जैसे हमलों को रोकने के लिए उपयोगकर्ता इनपुट की वैलिडेशन और सफाई करना।
  • मॉनिटरिंग और अलर्टिंग: मॉनिटरिंग और अलर्टिंग सिस्टम्स सेट करना ताकि प्रदर्शन समस्याओं या संभावित खतरों का पता चल सके और उन्हें संबोधित किया जा सके।

आप किसी विशिष्ट कार्य (जैसे, प्रश्न-उत्तर, सार-संक्षेप) के लिए RAG सिस्टम कैसे डिज़ाइन करेंगे?

क्वेश्चन-आंसरिंग सिस्टम के लिए, आप ऐसा रीट्रीवर चुनकर शुरुआत कर सकते हैं जो उपयोगकर्ता की क्वेरी के आधार पर प्रासंगिक डॉक्यूमेंट्स को कुशलतापूर्वक ढूँढ सके और ला सके। यह पारंपरिक, जैसे कीवर्ड सर्च, या अधिक उन्नत, जैसे बेहतर रीट्रीवल के लिए डेंस एम्बेडिंग्स का उपयोग, हो सकता है। अगला चरण ऐसा जेनरेटर चुनना या फाइन-ट्यून करना है जो रीट्रीव किए गए डॉक्यूमेंट्स का उपयोग कर सटीक और सुसंगत उत्तर तैयार कर सके।

समरीकरण के लिए, रीट्रीवर का काम संबंधित दस्तावेज़ या विषय से जुड़ी व्यापक सामग्री जुटाना है। दूसरी ओर, जेनरेटर को इस सामग्री को संक्षिप्त, सारगर्भित सारांशों में डिस्टिल करने में सक्षम होना चाहिए।

प्रॉम्प्ट इंजीनियरिंग यहाँ महत्वपूर्ण है। डाउनस्‍ट्रीम कार्य के अनुसार, हमें ऐसे प्रॉम्प्ट बनाने होंगे जो मॉडल को रीट्रीव जानकारी को शामिल कर प्रासंगिक आउटपुट तैयार करने के लिए प्रेरित करें।

आप तकनीकी रूप से समझा सकते हैं कि RAG कार्य के लिए आप किसी LLM को कैसे फाइन-ट्यून करेंगे?

यह कार्य-विशिष्ट डेटा को एकत्र और तैयार करने से शुरू होता है। यह प्रश्न-उत्तर युग्मों के एनोटेटेड उदाहरण या समरीकरण डेटासेट्स हो सकते हैं।

इसके बाद आप Retrieval-Augmented Language Modeling (REALM) जैसी तकनीकों का उपयोग कर सकते हैं, जो मॉडल को अपनी प्रतिक्रियाओं में रीट्रीव किए गए डॉक्यूमेंट्स को बेहतर ढंग से एकीकृत करने में मदद करती हैं। इसका अर्थ अक्सर मॉडल की आर्किटेक्चर या प्रशिक्षण तरीकों को इस प्रकार समायोजित करना होता है कि वह रीट्रीव संदर्भ को बेहतर संभाल सके।

आप Retrieval-Augmented Fine-Tuning (RAFT) का भी उपयोग कर सकते हैं, जो RAG और फाइन-ट्यूनिंग की ताकतों को जोड़ता है, जिससे मॉडल डोमेन-विशिष्ट ज्ञान के साथ-साथ बाहरी जानकारी को प्रभावी ढंग से रीट्रीव और उपयोग करना सीख सके।

तेज़ी से बदलते डोमेन्स में, RAG सिस्टम में पुरानी या अप्रासंगिक जानकारी को कैसे संभालेंगे?

एक तरीका है नॉलेज बेस या डॉक्यूमेंट इंडेक्स के नियमित अपडेट लागू करना, ताकि नई जानकारी उपलब्ध होते ही शामिल होती जाए। इसमें स्वचालित वर्कफ़्लोज़ सेट करना शामिल हो सकता है जो समय-समय पर अद्यतन सामग्री स्क्रैप या इन्जेस्ट करें, ताकि रीट्रीवर हमेशा नवीनतम डेटा के साथ काम करे।

इसके अलावा, मेटाडेटा टैगिंग का उपयोग कर पुरानी जानकारी को फ्लैग किया जा सकता है, जिससे रीट्रीवल के दौरान सिस्टम हालिया और अधिक प्रासंगिक डॉक्यूमेंट्स को प्राथमिकता दे सके।

तेज़ी से बदलते डोमेन्स में, यह भी महत्वपूर्ण है कि समय-संवेदनशीलता के आधार पर परिणामों को फ़िल्टर या री-रैंक करने के तंत्र जोड़े जाएँ। उदाहरण के लिए, रीट्रीवल के दौरान अधिक हालिया लेखों या डॉक्यूमेंट्स को अधिक वेट देना, यह सुनिश्चित करने में मदद करता है कि जनरेटेड प्रतिक्रियाएँ अद्यतन स्रोतों पर आधारित हों।

एक अन्य तकनीक फीडबैक लूप्स या ह्यूमन-इन-द-लूप सिस्टम्स का उपयोग करना है, जहाँ चिन्हित अशुद्धियों को जल्दी सुधारा जा सके, और रीट्रीवर को इस तरह समायोजित किया जा सके कि वह पुरानी जानकारी रीट्रीव करने से बचे।

व्यापक उत्तर सुनिश्चित करने के लिए RAG सिस्टम में रीट्रीवल की प्रासंगिकता और विविधता में कैसे संतुलन रखते हैं?

प्रासंगिकता और विविधता में संतुलन बनाना सटीक और समग्र उत्तर देने के लिए आवश्यक है। प्रासंगिकता सुनिश्चित करती है कि रीट्रीव डॉक्यूमेंट्स क्वेरी से निकटता से मेल खाएँ, जबकि विविधता यह सुनिश्चित करती है कि सिस्टम बहुत संकीर्ण रूप से किसी एक स्रोत या दृष्टिकोण पर केंद्रित न हो।

एक तरीका ऐसे री-रैंकिंग स्ट्रेटेजीज़ अपनाना है जो प्रासंगिकता और विविधता—दोनों को प्राथमिकता दें। आप विभिन्न स्रोतों या नॉलेज बेस के अलग-अलग सेक्शनों से डॉक्यूमेंट्स खींचकर भी विविधता बढ़ा सकते हैं।

समान परिणामों का क्लस्टरिंग कर अलग-अलग क्लस्टर्स से डॉक्यूमेंट्स चुनना भी सहायक होता है।

रीट्रीवर को इस प्रकार फाइन-ट्यून करना कि वह प्रासंगिकता और विविधता—दोनों पर ध्यान दे—यह भी सुनिश्चित करता है कि सिस्टम व्यापक डॉक्यूमेंट्स का सेट रीट्रीव करे।

आप कैसे सुनिश्चित करते हैं कि RAG सिस्टम का जनरेटेड आउटपुट रीट्रीव की गई जानकारी के अनुरूप रहे?

एक प्रमुख तरीका प्रॉम्प्ट इंजीनियरिंग के माध्यम से रीट्रीवल और जनरेशन के बीच सुदृढ़ कनेक्शन बनाना है। सावधानीपूर्वक डिज़ाइन किए गए प्रॉम्प्ट्स, जो भाषा मॉडल को स्पष्ट रूप से निर्देश दें कि अपना उत्तर रीट्रीव डॉक्यूमेंट्स पर आधारित रखें, जनरेशन को डेटा-ग्राउंडेड बनाए रखने में मदद करते हैं।

इसके अलावा, साइटेशन जनरेशन जैसी तकनीकें—जहाँ मॉडल से अपने उत्तरों को रीट्रीव स्रोतों से संदर्भित या उचित ठहराने के लिए कहा जाता है—संगतता बनाए रखने में मदद कर सकती हैं।

एक अन्य तरीका पोस्ट-जनरेशन जाँच या वैलिडेशन लागू करना है, जहाँ आउटपुट की तुलना रीट्रीव डॉक्यूमेंट्स से कर संरेखण सुनिश्चित किया जाता है। यह समानता मेट्रिक्स का उपयोग करके या छोटे वैरिफिकेशन मॉडलों को लगाकर किया जा सकता है जो रीट्रीव डेटा और जनरेटेड टेक्स्ट के तथ्यात्मक सामंजस्य की जाँच करें।

कुछ मामलों में, इटरेटिव रिफाइनमेंट विधियाँ उपयोगी होती हैं—जहाँ मॉडल पहले आउटपुट बनाता है, फिर अपने उत्तर की जाँच और परिष्करण के लिए रीट्रीव डॉक्यूमेंट्स पर लौटता है। फीडबैक लूप्स और उपयोगकर्ता सुधारों का भी लाभ उठाया जा सकता है ताकि समय के साथ स्थिरता सुधरे, क्योंकि सिस्टम पिछली असंगतियों से सीखता है और अपने रीट्रीवल व जनरेशन तंत्रों को तदनुसार समायोजित करता है।

संवेदनशील जानकारी से निपटते समय, आप RAG सिस्टम में डेटा गोपनीयता और सुरक्षा कैसे सुनिश्चित करते हैं?

जब रीट्रीव डेटा या उपयोगकर्ता क्वेरी में संवेदनशील या व्यक्तिगत जानकारी होती है, तो RAG सिस्टम्स में गोपनीयता और सुरक्षा सुनिश्चित करना महत्वपूर्ण है। प्रमुख रणनीतियाँ शामिल हैं:

  • डेटा रिडैक्शन और एनोनीमाइज़ेशन: डेटा के RAG पाइपलाइन में प्रवेश करने से पहले, व्यक्तिगत पहचान योग्य जानकारी (PII) और अन्य संवेदनशील विवरणों को हटा दें या मास्क करें। उदाहरण के लिए, दस्तावेज़ों को स्कैन कर इन्जेशन पर किसी भी PII को रिडैक्ट किया जा सकता है। यह जीरो-ट्रस्ट दृष्टिकोण सुनिश्चित करता है कि यदि डेटा रीट्रीव भी हो, तो भी वह गोपनीय जानकारी उजागर न करे क्योंकि उसे पहले ही सैनिटाइज़ किया गया है।

  • सुरक्षित डेटा स्टोरेज और ट्रांसफर: डेटा एट-रेस्ट (डेटाबेस या वेक्टर स्टोर्स में) और इन-ट्रांजिट (जब रीट्रीवर स्टोरेज से संवाद करता है) के लिए एन्क्रिप्शन का उपयोग करें। यह सुनिश्चित करना कि वेक्टर डेटाबेस और नॉलेज स्रोतों पर एक्सेस कंट्रोल्स (उचित ऑथेंटिकेशन और ऑथराइज़ेशन) हों, अनधिकृत पहुँच को रोकता है। केवल विश्वसनीय एप्लिकेशंस या सेवाएँ ही नॉलेज बेस से पढ़ सकें।

  • रोल-आधारित एक्सेस कंट्रोल्स: रीट्रीवल परिणामों पर कड़े एक्सेस फ़िल्टर्स लागू करें। आप नॉलेज के हिस्सों को इस मेटाडेटा के साथ टैग कर सकते हैं कि उन्हें कौन देख सकता है (जैसे, एडमिन बनाम यूज़र) और RAG सिस्टम से इन नियमों को रीट्रीवल के दौरान लागू करवाएँ। उदाहरण के लिए, एक हेल्थकेयर RAG असिस्टेंट डॉक्टरों को रोगी-पहचान योग्य जानकारी रीट्रीव करने दे सकता है लेकिन अन्य उपयोगकर्ताओं को कभी न दिखाए।

  • प्रॉम्प्ट फ़िल्टरिंग और आउटपुट मॉनिटरिंग: AI गार्डरेल्स शामिल करें ताकि LLM निजी डेटा आउटपुट न करे। प्रॉम्प्ट इंजेक्शन डिफेंस, आउटपुट स्कैनिंग, या नीतियाँ (जैसे LLMs के लिए OWASP गाइडलाइंस) जैसी तकनीकें प्रतिक्रियाओं से संवेदनशील सामग्री पकड़कर हटाने में मदद कर सकती हैं। उच्च-जोखिम डोमेन्स में ह्यूमन-इन-द-लूप समीक्षा भी उपयोगी है।

  • अनुपालन और ऑडिटिंग: सुनिश्चित करें कि RAG सिस्टम डेटा सुरक्षा नियमों (GDPR, HIPAA, आदि) का डिजाइन स्तर पर पालन करता हो। इसमें यह बनाए रखना शामिल है कि कब और कौन-सा डेटा रीट्रीव किया गया—इसके ऑडिट लॉग्स रखें, उपयोगकर्ता डेटा के उपयोग हेतु उचित सहमति लें, और संवेदनशील जानकारी के लिए नॉलेज स्रोतों का नियमित ऑडिट करें।

इन उपायों के संयोजन से, RAG सिस्टम संवेदनशील डेटा को सुरक्षित रूप से संभाल सकता है। इंटरव्यू में आपसे यह अपेक्षा की जाएगी कि आप बताएँ कि उपयोगकर्ता डेटा की सुरक्षा कोई बाद की बात नहीं है—यह इस बात में निहित है कि RAG पाइपलाइन जानकारी को कैसे इन्जेस्ट, स्टोर, रीट्रीव और जनरेट करती है।

निष्कर्ष

इस गाइड ने आपको RAG पर चर्चा की तैयारी के लिए 30 प्रमुख इंटरव्यू प्रश्न दिए—बुनियादी अवधारणाओं से लेकर उन्नत RAG सिस्टम्स तक।

यदि आप RAG सिस्टम्स के बारे में और सीखना चाहते हैं, तो मैं ये ब्लॉग सुझाता/सुझाती हूँ:


Ryan Ong's photo
Author
Ryan Ong
LinkedIn
Twitter

रायन एक लीड डेटा साइंटिस्ट हैं जो LLMs का उपयोग करके एआई अनुप्रयोग बनाने में विशेषज्ञता रखते/रखती हैं। वे इम्पीरियल कॉलेज लंदन में नैचुरल लैंग्वेज प्रोसेसिंग और नॉलेज ग्राफ्स में पीएचडी उम्मीदवार हैं, जहाँ से उन्होंने कंप्यूटर साइंस में अपना मास्टर’स भी पूरा किया है। डेटा साइंस के अलावा, वे साप्ताहिक Substack न्यूज़लेटर The Limitless Playbook लिखते हैं, जिसमें वे दुनिया के अग्रणी विचारकों से एक क्रियान्वयन योग्य विचार साझा करते हैं और समय-समय पर मूलभूत एआई अवधारणाओं पर भी लिखते हैं।

विषय
कृत्रिम बुद्धिमत्ता
बड़े भाषा मॉडल

इन कोर्सेज के साथ AI सीखें!

कोर्स

Pinecone के साथ AI Applications बनाना

3 घंटा
11.9K
जानें कि Pinecone वेक्टर डेटाबेस AI एप्लिकेशन डेवलपमेंट में कैसे क्रांति ला रहा है!
विवरण देखेंRight Arrow
पाठ्यक्रम शुरू करें

लर्निंग पाथ

डेवलपर्स के लिए एसोसिएट AI इंजीनियर

26 घंटा
एपीआई और ओपन-सोर्स लाइब्रेरी का उपयोग करके सॉफ़्टवेयर अनुप्रयोगों में AI को एकीकृत करना सीखें। आज ही AI इंजीनियर बनने की अपनी यात्रा शुरू करें!
और देखेंRight Arrow