

LlaMA-Factory WebUI के साथ शुरुआत
इस अनुभाग में, हम Google Colab और Microsoft Windows में LlaMA-Factory WebUI को इंस्टॉल और लॉन्च करना सीखेंगे।
Google Colab निःशुल्क GPU उपलब्ध कराता है, इसलिए यदि आपके लैपटॉप में GPU या CUDA इंस्टॉल नहीं है, तो मैं सलाह दूंगा कि आप Colab नोटबुक से शुरुआत करें।
- Google Colab नोटबुक को “T4 GPU” रनटाइम टाइप के साथ लॉन्च करें।
- कोड सेल में निम्न कमांड टाइप करें ताकि LLaMA-Factory GitHub रेपो क्लोन हो जाए और आवश्यक सभी Python पैकेज इंस्टॉल हो जाएँ।
%cd /content/
%rm -rf LLaMA-Factory
!git clone https://github.com/hiyouga/LLaMA-Factory.git
%cd LLaMA-Factory
%ls
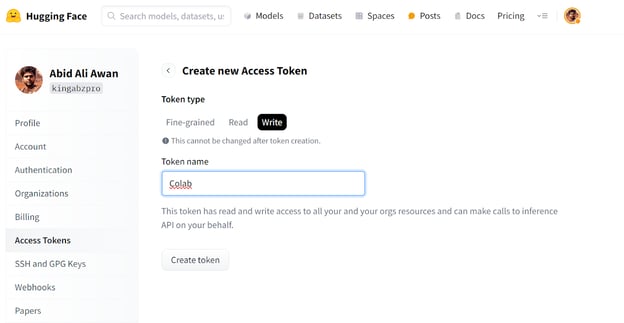
%pip install -e .[torch,bitsandbytes]- मॉडल और डेटासेट तक पहुँच के लिए, आपको Hugging Face के CLI में लॉगिन करना होगा। इसके लिए Hugging Face सेटिंग्स में जाकर "Access Tokens" पर क्लिक करें और Google Colab के लिए एक नया टोकन बनाएँ।
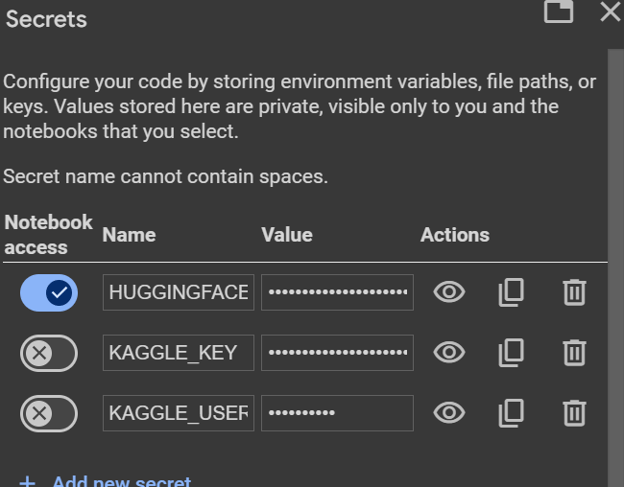
- Colab के "Secrets" फीचर का उपयोग करके Hugging Face पर्यावरण वेरिएबल बनाएँ, जो हमें नोटबुक के भीतर सुरक्षित रूप से एक्सेस किए जा सकने वाले एन्वायरनमेंट वेरिएबल बनाने देता है।
- Huggion Face एक्सेस टोकन का उपयोग करके Hugging Face Hub में लॉगिन करें।
from huggingface_hub import login
from google.colab import userdata
hf_token = userdata.get("HUGGINGFACE_TOKEN")
login(token = hf_token)llamafactory-cliका उपयोग करके LLaMA-Factor WebUI लॉन्च करें। हम GRADIO_SHARE=1 सेट कर रहे हैं ताकि वेब ऐप तक पहुँच के लिए पब्लिक लिंक जनरेट कर सकें।
%cd /content/LLaMA-Factory/
!GRADIO_SHARE=1 llamafactory-cli webui- WebUI को नए टैब में लॉन्च करने के लिए पब्लिक URL पर क्लिक करें।
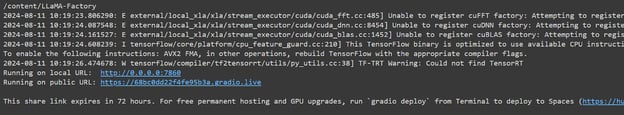
LLAMA-Factory WebUI दिखने में सरल है, लेकिन इसमें बहुत सारे विकल्प और टैब हैं। हम इन्हें अगले अनुभाग में देखेंगे।
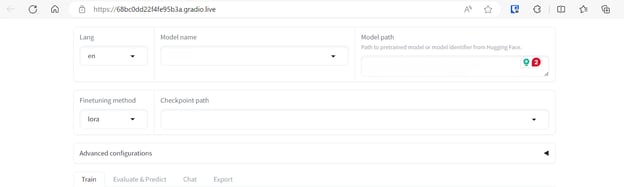
यदि आपको अपना LlaMA-Factory WebUI लॉन्च करने में समस्या आ रही है, तो कृपया Google Colab नोटबुक देखें।
Windows पर LlaMA-Factory WebUI चलाना
यदि आप Windows पर लोकली LlaMA-Factory WebUI चलाना चाहते हैं, तो आपको bitsandbytes लाइब्रेरी का प्री-बिल्ट संस्करण इंस्टॉल करना होगा। यह CUDA 11.1 से 12.2 तक सपोर्ट करता है, इसलिए कृपया अपनी CUDA संस्करण के आधार पर उपयुक्त रिलीज़ संस्करण चुनें।
- अपने Windows टर्मिनल पर जाएँ और LLaMA-Factory GitHub रेपो क्लोन करने के लिए Git कमांड टाइप करें।
- सभी आवश्यक Python पैकेज इंस्टॉल करें।
- Windows के लिए bitsandbytes लाइब्रेरी इंस्टॉल करें।
$ git clone https://github.com/hiyouga/LLaMA-Factory.git
$ cd LLaMA-Factory
$ pip install -e .[torch,bitsandbytes]
$ pip install https://github.com/jllllll/bitsandbytes-windows-webui/releases/download/wheels/bitsandbytes-0.41.2.post2-py3-none-win_amd64.whl- LLaMA-Factory WebUI लॉन्च करें।
$ llamafactory-cli webui- CLI का उपयोग करते हुए एक्सेस टोकन प्रदान करके Hugging Face में लॉगिन करना न भूलें।
$ huggingface-cli loginLlaMA-3 8B Chat को LlaMA-Factory WebUI से फाइन‑ट्यून करना
इस अनुभाग में कोई कोडिंग नहीं होगी। हम फाइन-ट्यूनिंग के लिए मॉडल और डेटासेट चुनेंगे, कुछ पैरामीटर्स बदलेंगे, और तेज़ प्रशिक्षण के लिए कुछ बटन दबाएँगे।
बड़े भाषा मॉडलों के फाइन-ट्यूनिंग के पीछे के सिद्धांत को समझने के लिए, यह व्यापक गाइड देखें: Large Language Models का फाइन‑ट्यूनिंग.
डेटासेट और मॉडल चुनना
हम unsloth/llama-3-8b-bnb-4bit मॉडल को Microsoft/wiki_qa डेटासेट पर फाइन-ट्यून करेंगे। डेटासेट में कई कॉलम हैं, जैसा कि नीचे दिखाया गया है, लेकिन हम मॉडल फाइन-ट्यूनिंग के लिए “question” और “answer” कॉलम का उपयोग करेंगे।
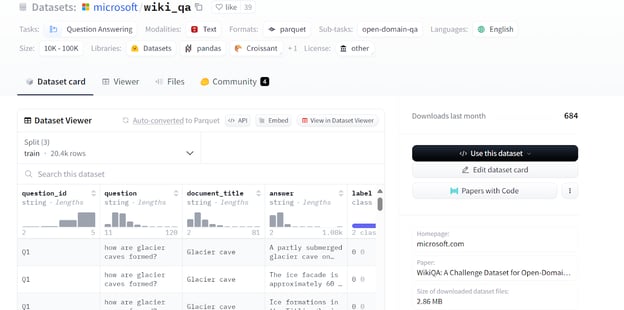
स्रोत: microsoft/wiki_qa | Microsoft का Wiki Question Answering कॉर्पस
हम Google Colab के फ्री संस्करण में पूरा LLaMA-3-8B instruction मॉडल लोड नहीं कर सकते। इसके बजाय, हम Unsloth द्वारा उपलब्ध कराए गए इसी 모델 के 4‑बिट क्वांटाइज़्ड संस्करण को लोड करेंगे।
ऐसा करने के लिए, मॉडल नाम में "Custom" चुनें और मॉडल पाथ में "unsloth/llama-3-8b-bnb-4bit" रेपो लिंक पेस्ट करें।
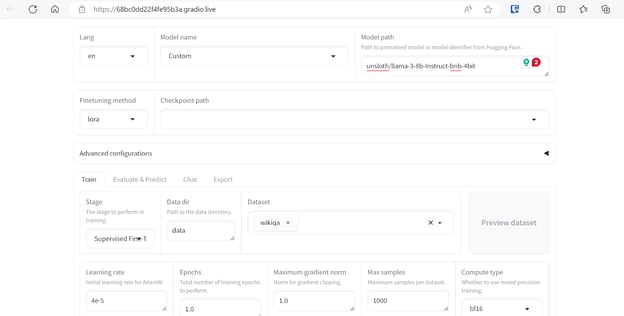
हम अपने मॉडल को फाइन-ट्यून करने के लिए कई डेटासेट चुन सकते हैं। हालाँकि, इस ट्यूटोरियल के लिए हम केवल “Wikiqa” डेटासेट का उपयोग करेंगे, जिसे आप ऊपर दिखाए अनुसार प्री-डिफाइंड डेटासेट सूची से आसानी से चुन सकते हैं।
प्रशिक्षण पैरामीटर्स समायोजित करना
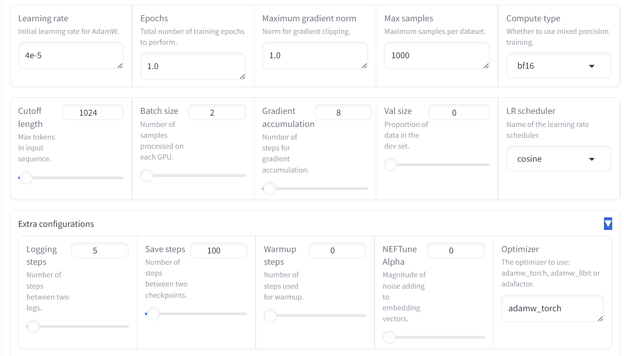
पेज को नीचे स्क्रॉल करके मॉडल प्रशिक्षण आर्गुमेंट्स समायोजित करें। हम निम्न पैरामीटर्स सेट करेंगे:
- लर्निंग रेट: 4e-5
- एपॉक्स: 1.0
- मैक्स सैंपल्स: 1000 ताकि मॉडल प्रशिक्षण तेज़ हो
बाकी आर्गुमेंट्स को डिफ़ॉल्ट मानों पर ही रहने दिया जाएगा। इन मानों को बदलकर फाइन-ट्यून मॉडल के व्यवहार को संशोधित किया जा सकता है।
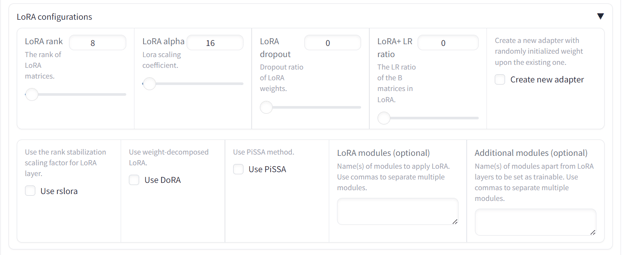
हमारे पास LoRa रैंक और अन्य LoRa-संबंधित कॉन्फ़िगरेशन बदलने का विकल्प भी है। इस ट्यूटोरियल के लिए, हम बाकी सभी सेटिंग्स को उनके डिफ़ॉल्ट मानों पर ही रख रहे हैं।
प्रशिक्षण प्रक्रिया शुरू करना
पेज को और नीचे स्क्रॉल करें ताकि प्रशिक्षण कॉन्फ़िगरेशन दिखाई दे। कृपया आउटपुट डायरेक्ट्री और कॉन्फ़िगरेशन पाथ प्रदान करें और “Start” बटन दबाएँ। लॉस ग्राफ़ को दिखने में कुछ समय लगेगा क्योंकि LlaMA-Factor पहले मॉडल और डेटासेट डाउनलोड करेगा और फिर दोनों को लोड करेगा, जिसमें कम से कम 5 मिनट लग सकते हैं।
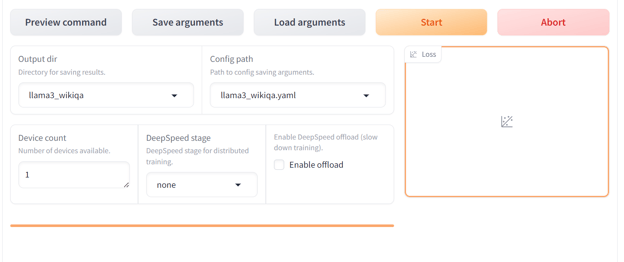
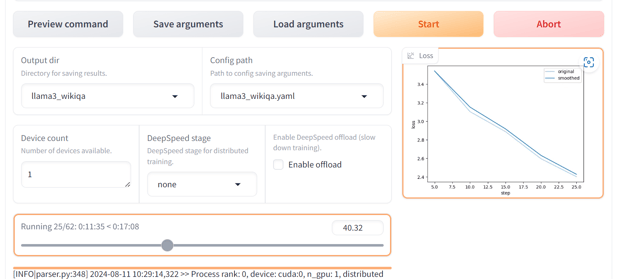
जब मॉडल पूरी तरह लोड हो जाए और प्रशिक्षण शुरू हो जाए, तो आप लॉस ग्राफ़ पर विज़ुअलाइज़ेशन देखना शुरू करेंगे। जैसा कि हम देख सकते हैं, स्टेप्स की संख्या के साथ लॉस धीरे-धीरे घट रहा है, जो अच्छा संकेत है।
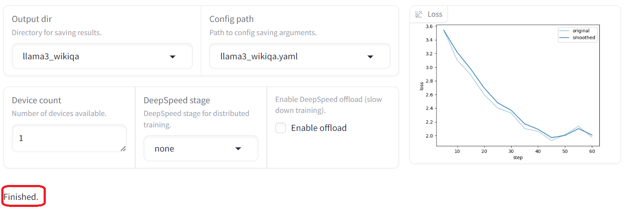
प्रशिक्षण पूरा होने पर, आपको नीचे बाएँ फिनिश संदेश दिखाई देगा। जैसा कि हम देख सकते हैं, 45 स्टेप्स के बाद लॉस धीरे-धीरे घटकर स्थिर हो गया है।
यदि आप एक डेटा वैज्ञानिक या डेवलपर हैं, तो आपको Python भाषा का उपयोग करके अपना मॉडल फाइन-ट्यून करना आसान लगेगा।
हमारे पास तकनीकी व्यक्तियों के लिए LlaMA‑3 को ट्रेन करने की एक विस्तृत गाइड है: Llama 3 का फाइन‑ट्यूनिंग और लोकली उपयोग: चरण-दर-चरण गाइड.
फाइन‑ट्यून मॉडल का मूल्यांकन
फाइन‑ट्यून मॉडल का मूल्यांकन करने के लिए, हमें मेन्यू को “Train” से “Chat” में स्विच करना होगा। फिर, “Checkpoint path” पर जाएँ और सेव किए गए फाइन‑ट्यून एडॉप्टर को लोड करें।
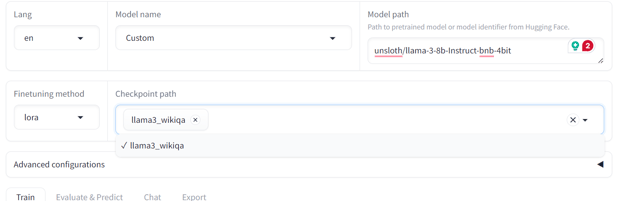
उसके बाद, “Load model” बटन पर क्लिक करें और मॉडल के सफलतापूर्वक लोड होने तक कुछ सेकंड प्रतीक्षा करें।
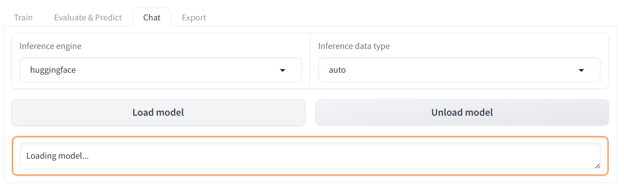
चैट इनपुट बॉक्स देखने के लिए नीचे स्क्रॉल करें और पर्वत श्रृंखला पर एक सामान्य प्रश्न लिखें।
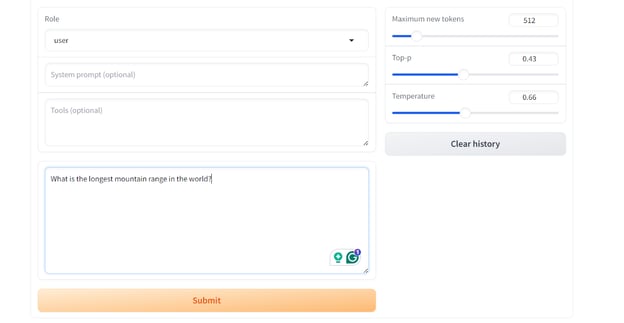
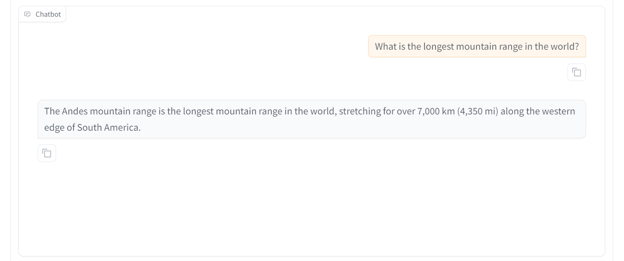
परिणामस्वरूप, आपको “wiki_qa” डेटासेट जैसा सरल और सीधा उत्तर मिलेगा।
आइए एक और प्रश्न पूछकर देखें। हम देख सकते हैं कि मॉडल असाधारण रूप से अच्छा प्रदर्शन कर रहा है। 30 मिनट के भीतर, हमने मॉडल को फाइन‑ट्यून कर लिया, जो Transformer लाइब्रेरी का उपयोग करने पर 4 घंटे से अधिक ले सकता था। यह कमाल है।
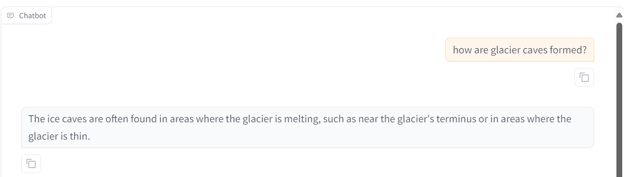
कभी‑कभी, फाइन‑ट्यूनिंग LLM की सभी समस्याओं का समाधान नहीं होती। इसलिए आपको RAG बनाम फाइन‑ट्यूनिंग: व्यावहारिक उदाहरणों के साथ एक व्यापक ट्यूटोरियल पढ़ना चाहिए और जानना चाहिए कि आपके लिए क्या सबसे बेहतर काम करता है।
LlaMA-Factory WebUI की अतिरिक्त विशेषताएँ
फाइन‑ट्यूनिंग और परीक्षण से आगे, LLaMA-Factory इकोसिस्टम कई प्रमुख सुविधाएँ प्रदान करता है, जिनमें कस्टम डेटा से फाइन‑ट्यूनिंग, मॉडलों का मर्ज और एक्सपोर्ट, और VLLM के जरिए फाइन‑ट्यून मॉडलों की डिप्लॉयमेंट शामिल है।
कस्टम डेटासेट
कस्टम डेटासेट जोड़ने के लिए, बस data/dataset_info.json फ़ाइल संशोधित करें, और यह LLaMA-Factory WebUI में सुलभ हो जाएगा।
डेटासेट फ़ाइलों के आवश्यक फॉर्मेट और dataset_info.json फ़ाइल को कैसे संशोधित करें, इस पर विस्तृत जानकारी के लिए कृपया data/README.md दस्तावेज़ देखें।
आप Hugging Face या ModelScope हब्स से डेटासेट का उपयोग कर सकते हैं, या अपने लोकल डिस्क से डेटासेट लोड कर सकते हैं।
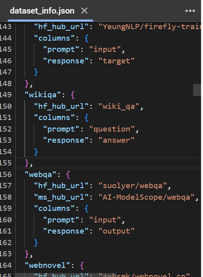
data/dataset_info.json फ़ाइल का प्रीव्यू
मॉडल को मर्ज और एक्सपोर्ट करना
हम “Export” टैब पर क्लिक करके फाइन‑ट्यून LoRA एडॉप्टर को फुल मॉडल के साथ आसानी से मर्ज कर सकते हैं और इसे Hugging Face Hub पर एक्सपोर्ट कर सकते हैं।
मैक्सिमम शार्ड साइज समायोजित करें, एक्सपोर्ट डायरेक्ट्री पाथ सेट करें, और Hugging Face Hub रिपॉज़िटरी ID व एक्सपोर्ट डिवाइस निर्दिष्ट करें। मॉडल को मर्ज करने और सभी फ़ाइलें Hugging Face Hub पर अपलोड करने में कुछ मिनट लगेंगे।
नोट: Colab का फ्री संस्करण केवल 12GB RAM देता है, जबकि 8 बिलियन पैरामीटर वाले मॉडल के LoRA को मर्ज करने के लिए कम से कम 16GB RAM की आवश्यकता होती है। इसलिए, यह कार्य Colab के फ्री संस्करण में नहीं किया जा सकता।
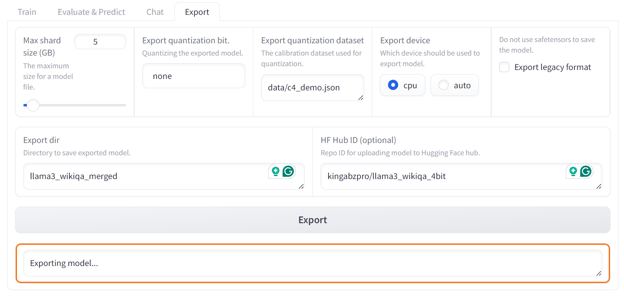
फाइन‑ट्यून मॉडल को Hugging Face Hub पर मर्ज और एक्सपोर्ट करना
OpenAI‑स्टाइल API और vLLM के साथ डिप्लॉय करें
LlaMA-Factory मॉडल सर्विंग और डिप्लॉयमेंट के लिए vLLM फ्रेमवर्क के साथ आता है। निम्न कमांड टाइप करके, हम Llama-3-8B-Instruct मॉडल सर्व कर सकते हैं और उसे OpenAI Python API या RestAPI के जरिए एक्सेस कर सकते हैं।
$ API_PORT=8000 llamafactory-cli api examples/inference/llama3_vllm.yamlआप फ़ाइल को संशोधित भी कर सकते हैं या अपना .yaml फ़ाइल बना सकते हैं ताकि अपने फाइन‑ट्यून मॉडल को प्रोडक्शन में सर्व कर सकें। आपको बस मॉडल फ़ोल्डर का पाथ लोकली या Huggin Face Hub पर प्रदान करना है।
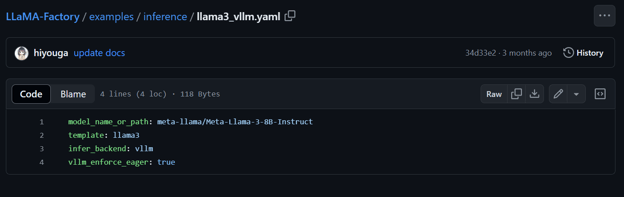
स्रोत: hiyouga/LLaMA-Factory (github.com)
यदि आप इसी तरह का लो‑कोड समाधान ढूँढ रहे हैं जो आपको विशेष रूप से स्वामित्व वाले GPT‑4o मॉडल को फाइन‑ट्यून करने देता है, तो हमारे पास आपके लिए एक व्यापक गाइड है। हमारा चरण‑दर‑चरण ट्यूटोरियल यहाँ देखें: OpenAI के GPT‑4 का फाइन‑ट्यूनिंग: चरण‑दर‑चरण गाइड.
निष्कर्ष
LLaMA-Factory WebUI शुरुआती और विशेषज्ञ दोनों के लिए प्रक्रिया को सरल बनाता है। आपको बस कुछ पैरामीटर्स समायोजित करने हैं और कस्टम डेटासेट पर मॉडल को फाइन‑ट्यून करना है। उसी यूज़र इंटरफेस का उपयोग करके आप मॉडल का परीक्षण कर सकते हैं और उसे Hugging Face पर एक्सपोर्ट या लोकली सेव कर सकते हैं। इससे आप बाद में LLaMA-Factory CLI के api कमांड का उपयोग करके मॉडल को प्रोडक्शन में डिप्लॉय कर सकते हैं। यह उतना ही सीधा है।
सैकड़ों लाइनों का कोड लिखने और फाइन‑ट्यूनिंग समस्याओं को सुलझाने के बजाय, आप कुछ ही क्लिक में समान परिणाम प्राप्त कर सकते हैं।
इस ट्यूटोरियल में, हमने LLaMA-Factory WebUI के बारे में सीखा, और इस फ्रेमवर्क का उपयोग करते हुए Wikipedia Q&A डेटासेट पर LLaMA‑3‑8B‑Instruct मॉडल को कैसे फाइन‑ट्यून करें यह जाना। इसके अलावा, हमने बिल्ट‑इन चैटबॉट मेन्यू का उपयोग करके फाइन‑ट्यून मॉडल का परीक्षण किया और LLaMA-Factory द्वारा दी गई अतिरिक्त सुविधाओं का अन्वेषण किया।
Python का उपयोग करके LLMs को फाइन‑ट्यून करना सीखें—फ्री में पंजीकरण करें हमारे आगामी वेबिनार Fine‑Tuning Your Own Llama 3 Model के लिए।

एक प्रमाणित डेटा साइंटिस्ट के रूप में, मैं अत्याधुनिक तकनीक का उपयोग करके नवाचारी मशीन लर्निंग अनुप्रयोग बनाने के लिए उत्साहित रहता/रहती हूँ। स्पीच रिकॉग्निशन, डेटा विश्लेषण और रिपोर्टिंग, MLOps, संवादात्मक AI और NLP में मजबूत पृष्ठभूमि के साथ, मैंने ऐसे बुद्धिमान सिस्टम विकसित करने में अपनी विशेषज्ञता निखारी है जो वास्तविक प्रभाव डाल सकें। तकनीकी दक्षता के अलावा, मैं जटिल अवधारणाओं को स्पष्ट और संक्षिप्त भाषा में प्रस्तुत करने में भी निपुण हूँ। परिणामस्वरूप, मैं डेटा साइंस पर एक मांग में रहने वाला/वाली ब्लॉगर बन गया/गई हूँ, और डेटा प्रोफेशनलों के बढ़ते समुदाय के साथ अपने अनुभव और विचार साझा करता/करती हूँ। वर्तमान में, मैं कंटेंट निर्माण और संपादन पर केंद्रित हूँ, बड़े भाषा मॉडलों के साथ काम करते हुए ऐसा प्रभावशाली और आकर्षक कंटेंट विकसित कर रहा/रही हूँ जो व्यवसायों और व्यक्तियों दोनों को अपने डेटा का अधिकतम लाभ उठाने में मदद कर सके।
इस ट्यूटोरियल में, हम Wikipedia Q&A डेटासेट पर LlaMA-Factory WebUI का उपयोग करते हुए Llama 3 8B मॉडल को फाइन-ट्यून करना सीखेंगे। हम LlaMA-Factory WebUI का परिचय देकर शुरू करेंगे, फिर इसे Google Colab वातावरण में सेट अप करेंगे। कॉन्फ़िगरेशन पूरा होने पर, हम डेटासेट पर Llama 3 8B मॉडल के फाइन-ट्यूनिंग की प्रक्रिया से गुज़रेंगे और फिर चैट इंटरफेस के जरिए मॉडल के प्रदर्शन का मूल्यांकन करेंगे।
आगे बढ़ते हुए, आप यह भी सीखेंगे कि कस्टम डेटासेट कैसे लोड करें, मॉडलों को मर्ज करें, और उन्हें Hugging Face पर एक्सपोर्ट करें। अंत में, हम फाइन-ट्यून मॉडल को डिप्लॉय करने के तरीके को कवर करेंगे, जिससे वह OpenAI API के माध्यम से सुलभ हो सके।
आप AI Fundamentals स्किल ट्रैक लेकर ChatGPT, बड़े भाषा मॉडल, जनरेटिव AI, और अन्य लोकप्रिय AI विषयों पर क्रियाशील ज्ञान प्राप्त कर सकते हैं।
छवि: लेखक | Canva
LlaMA-Factory क्या है?
hiyouga/LLaMA-Factory एक ओपन-सोर्स प्रोजेक्ट है जो आपको WebUI इंटरफेस के माध्यम से 100 से अधिक बड़े भाषा मॉडलों (LLMs) को फाइन-ट्यून करने देता है। यह फाइन-ट्यूनिंग, चैटबॉट, सर्विंग, और बेंचमार्किंग के लिए एक व्यापक टूलकिट और स्क्रिप्ट्स प्रदान करता है।
LLaMA-Factory खासकर शुरुआती और गैर-तकनीकी पेशेवरों के लिए बनाया गया है जो ओपन-सोर्स LLMs को अपने कस्टम डेटासेट पर बिना जटिल AI अवधारणाएँ सीखे फाइन-ट्यून करना चाहते हैं। उपयोगकर्ताओं को सिर्फ एक मॉडल चुनना है, अपना डेटासेट जोड़ना है, और कुछ पैरामीटर समायोजित कर प्रशिक्षण प्रक्रिया शुरू करनी है।
प्रशिक्षण पूरा होने पर, उसी वेब एप्लिकेशन का उपयोग मॉडल का परीक्षण करने के लिए किया जा सकता है, जिसके बाद इसे Hugging Face पर एक्सपोर्ट किया जा सकता है या लोकली सेव किया जा सकता है। यह LLMs को लोकल रूप से फाइन-ट्यून करने का तेज़ और कुशल तरीका प्रदान करता है।