
Cours
Développement d'applications LLM avec LangChain
3 h
50.6K
Dans ce tutoriel, nous allons affiner le modèle Llama 3 8B avec LLaMA-Factory WebUI sur le jeu de données Wikipedia Q&A. Nous commencerons par présenter LLaMA-Factory WebUI, puis nous verrons comment le configurer dans l'environnement Google Colab. Une fois la configuration effectuée, nous parcourrons l'ensemble du processus d'affinage du modèle Llama 3 8B sur le jeu de données, puis nous évaluerons ses performances via l'interface de chat.
Au fil des étapes, vous apprendrez également à charger des jeux de données personnalisés, à fusionner des modèles et à les exporter vers Hugging Face. Enfin, nous verrons comment déployer le modèle affiné et le rendre accessible via l'API OpenAI.
Pour aller plus loin sur des sujets IA incontournables comme ChatGPT, les grands modèles de langage, l'IA générative et bien plus, suivez le parcours AI Fundamentals.
Image par l’auteur | Canva
hiyouga/LLaMA-Factory est un projet open source qui permet d’affiner plus de 100 grands modèles de langage (LLM) via une interface WebUI. Il fournit un ensemble complet d’outils et de scripts pour l’affinage, le chatbot, le serving et le benchmarking des LLM.
LLaMA-Factory est conçu pour les débutants et les professionnels non techniques qui souhaitent affiner des LLM open source sur leurs propres jeux de données sans maîtriser des concepts d’IA complexes. Il suffit de choisir un modèle, d’ajouter son jeu de données et d’ajuster quelques paramètres pour lancer l’entraînement.
Une fois l’entraînement terminé, la même application web permet de tester le modèle, puis de l’exporter vers Hugging Face ou de le sauvegarder en local. C’est un moyen rapide et efficace d’affiner des LLM en local.
Dans cette section, nous allons voir comment installer et lancer LLaMA-Factory WebUI dans Google Colab et sous Microsoft Windows.
Google Colab met à disposition des GPU gratuits. Si votre ordinateur portable n’en a pas ou n’a pas CUDA installé, nous vous recommandons de démarrer avec un notebook Colab.
%cd /content/
%rm -rf LLaMA-Factory
!git clone https://github.com/hiyouga/LLaMA-Factory.git
%cd LLaMA-Factory
%ls
%pip install -e .[torch,bitsandbytes]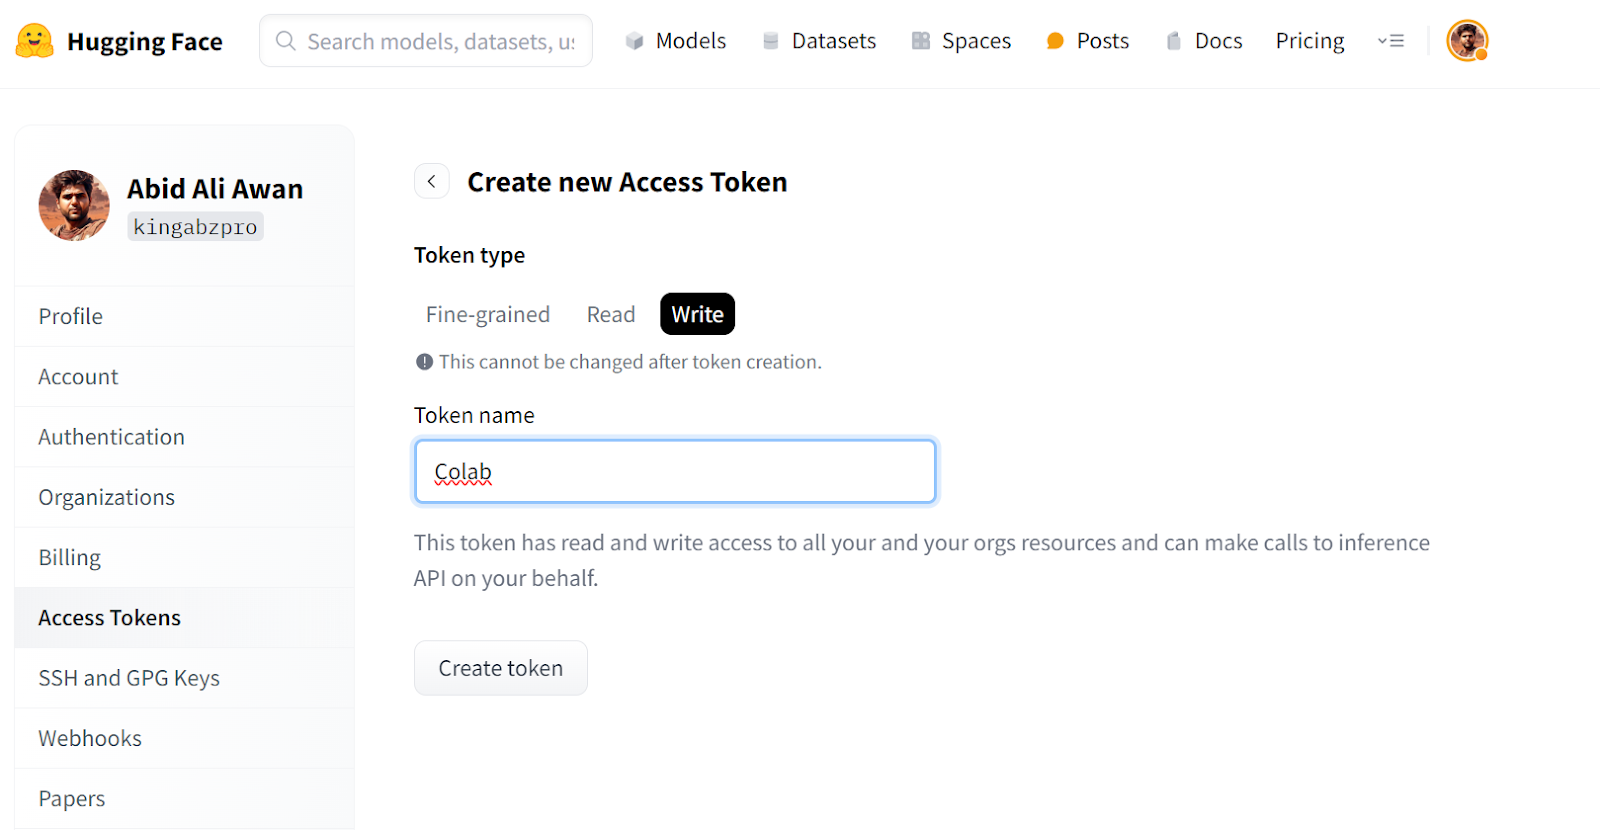
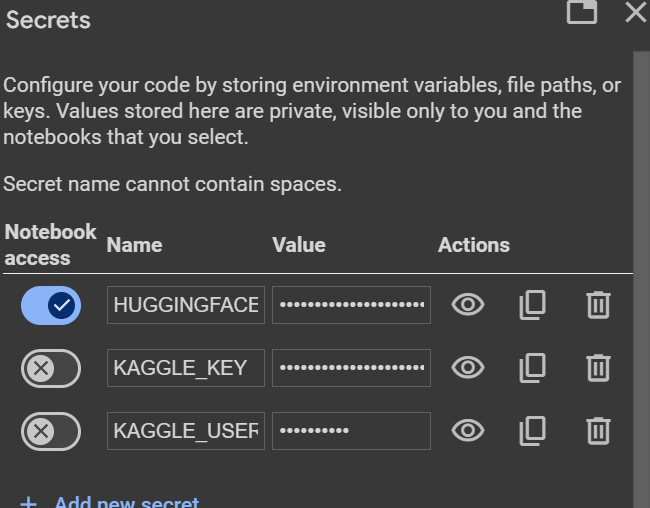
from huggingface_hub import login
from google.colab import userdata
hf_token = userdata.get("HUGGINGFACE_TOKEN")
login(token = hf_token)llamafactory-cli. Nous définissons GRADIO_SHARE=1 afin de générer un lien public pour accéder à l’application web. %cd /content/LLaMA-Factory/
!GRADIO_SHARE=1 llamafactory-cli webui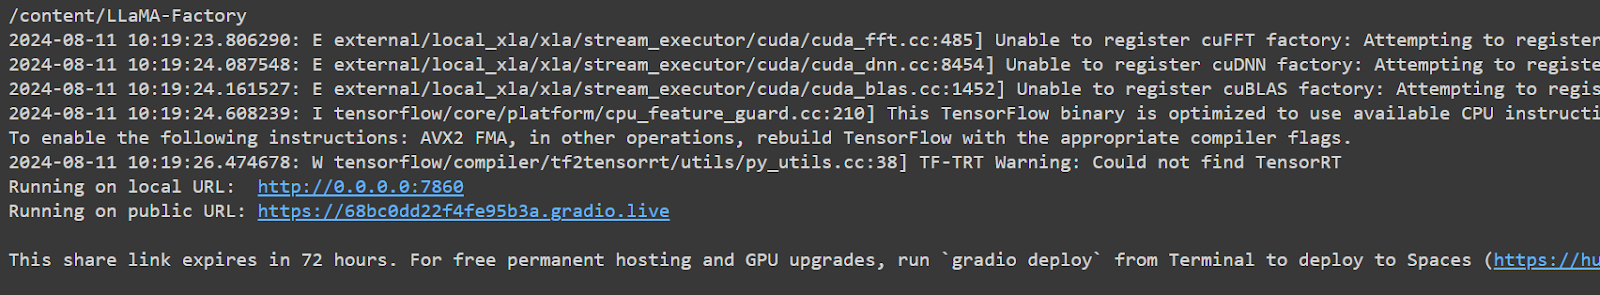
L’interface LLaMA-Factory WebUI est simple mais propose de nombreuses options et onglets. Nous les explorerons dans la section suivante.
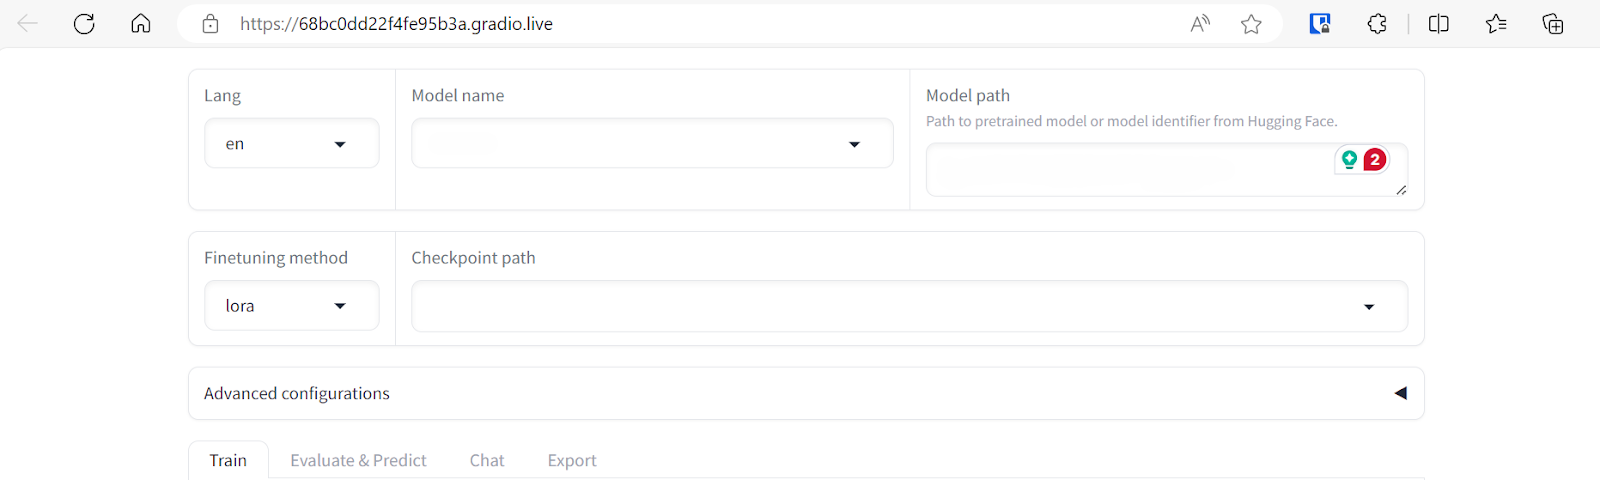
Si vous rencontrez des difficultés pour lancer votre propre LLaMA-Factory WebUI, consultez le notebook Google Colab.
Pour exécuter LLaMA-Factory WebUI en local sous Windows, vous devez installer une version précompilée de la bibliothèque bitsandbytes. Elle prend en charge CUDA 11.1 à 12.2 : choisissez donc la bonne version en fonction de votre version de CUDA.
$ git clone https://github.com/hiyouga/LLaMA-Factory.git

$ cd LLaMA-Factory

$ pip install -e .[torch,bitsandbytes]

$ pip install https://github.com/jllllll/bitsandbytes-windows-webui/releases/download/wheels/bitsandbytes-0.41.2.post2-py3-none-win_amd64.whl$ llamafactory-cli webui$ huggingface-cli loginAucun code dans cette section. Nous allons sélectionner le modèle et le jeu de données à affiner, modifier quelques paramètres, puis cliquer sur quelques boutons pour un entraînement rapide.
Pour comprendre la théorie de l’affinage des grands modèles de langage, consultez ce guide complet : Fine-Tuning Large Language Models.
Nous allons affiner le modèle unsloth/llama-3-8b-bnb-4bit sur le jeu de données Microsoft/wiki_qa. Ce jeu de données contient plusieurs colonnes (voir ci-dessous), mais nous utiliserons uniquement les colonnes « question » et « answer » pour l’affinage.
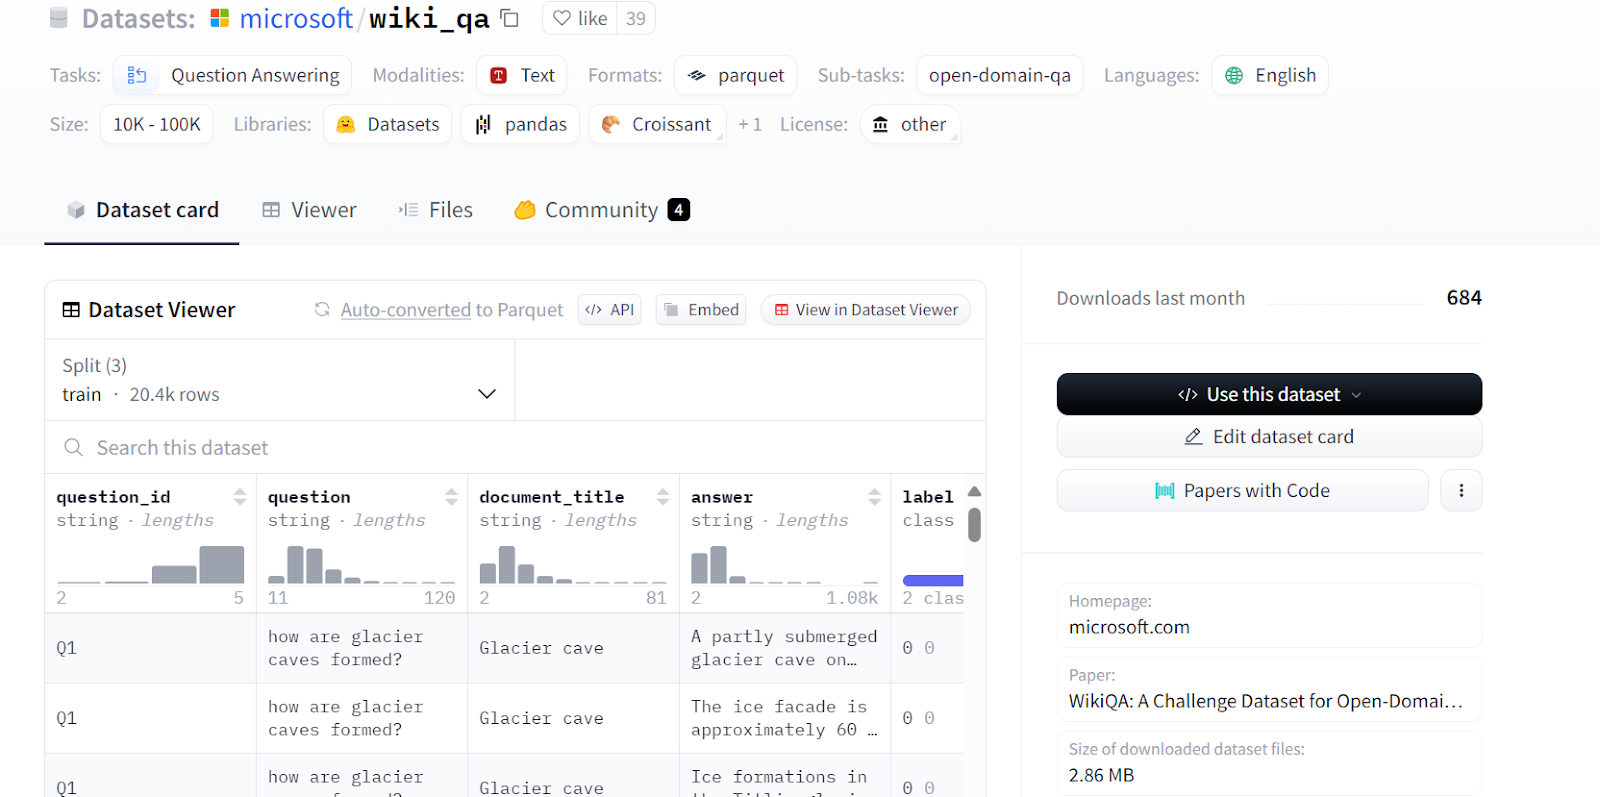
Source : microsoft/wiki_qa | Corpus Wiki Question Answering de Microsoft
Nous ne pouvons pas charger le modèle d’instruction LLaMA-3-8B complet dans la version gratuite de Google Colab. À la place, nous chargerons la version quantifiée en 4 bits du même modèle proposée par Unsloth.
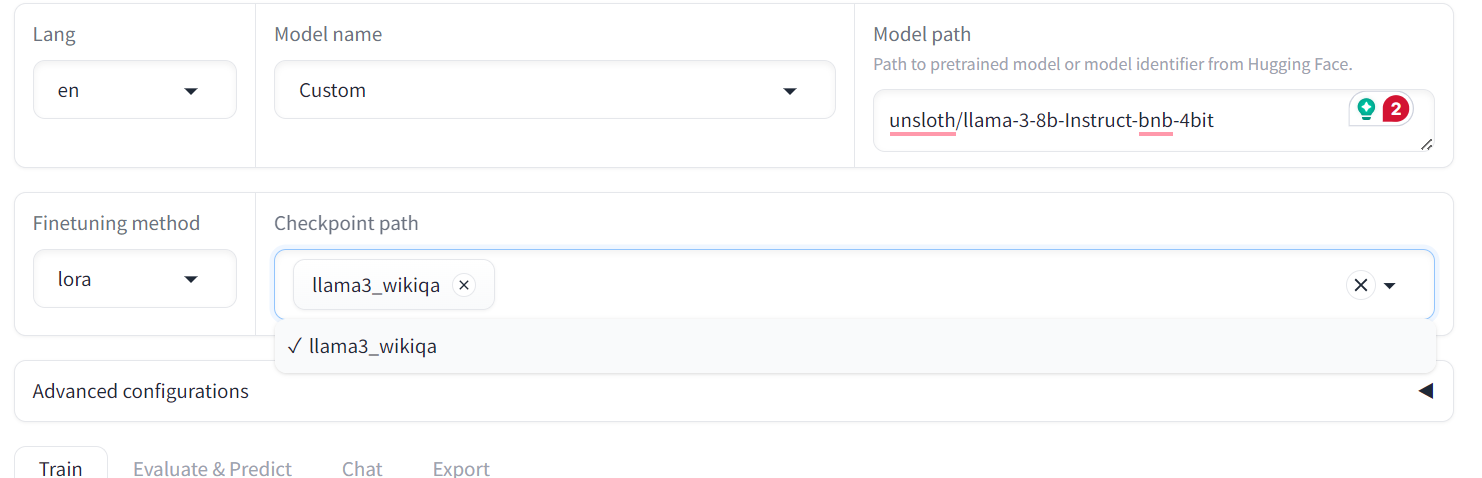
Pour ce faire, sélectionnez « Custom » comme nom de modèle et collez le lien du dépôt « unsloth/llama-3-8b-bnb-4bit » dans le chemin du modèle.
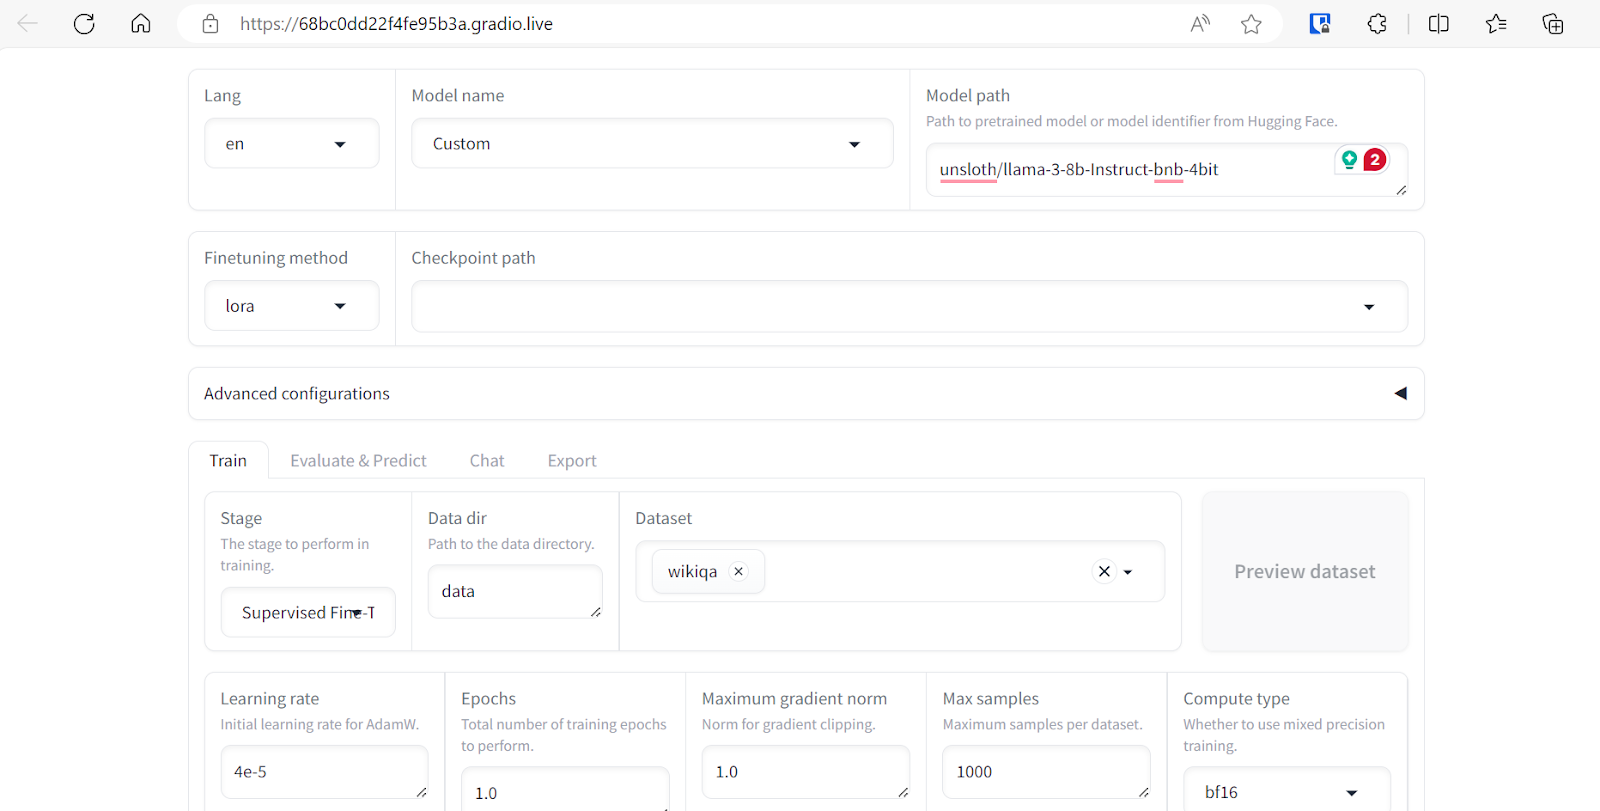
Vous pouvez sélectionner plusieurs jeux de données pour affiner votre modèle. Toutefois, pour ce tutoriel, nous n’utiliserons que le jeu de données « Wikiqa », que vous pouvez facilement choisir parmi les jeux prédéfinis comme ci-dessus.
Ajustez les paramètres d’entraînement en faisant défiler la page. Nous allons définir :
Nous laissons les autres paramètres à leurs valeurs par défaut. Vous pourrez les modifier pour ajuster le comportement du modèle affiné.
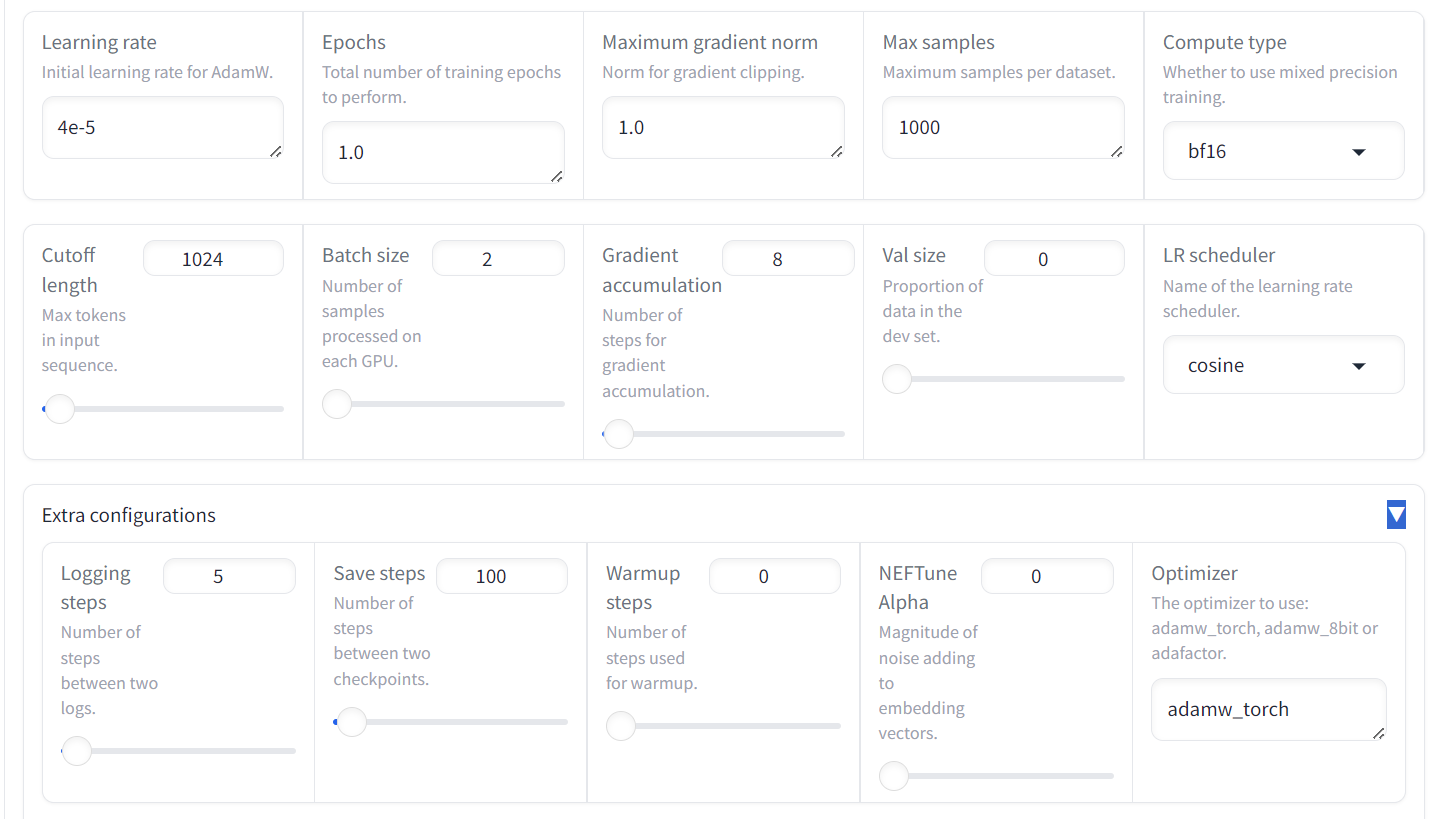
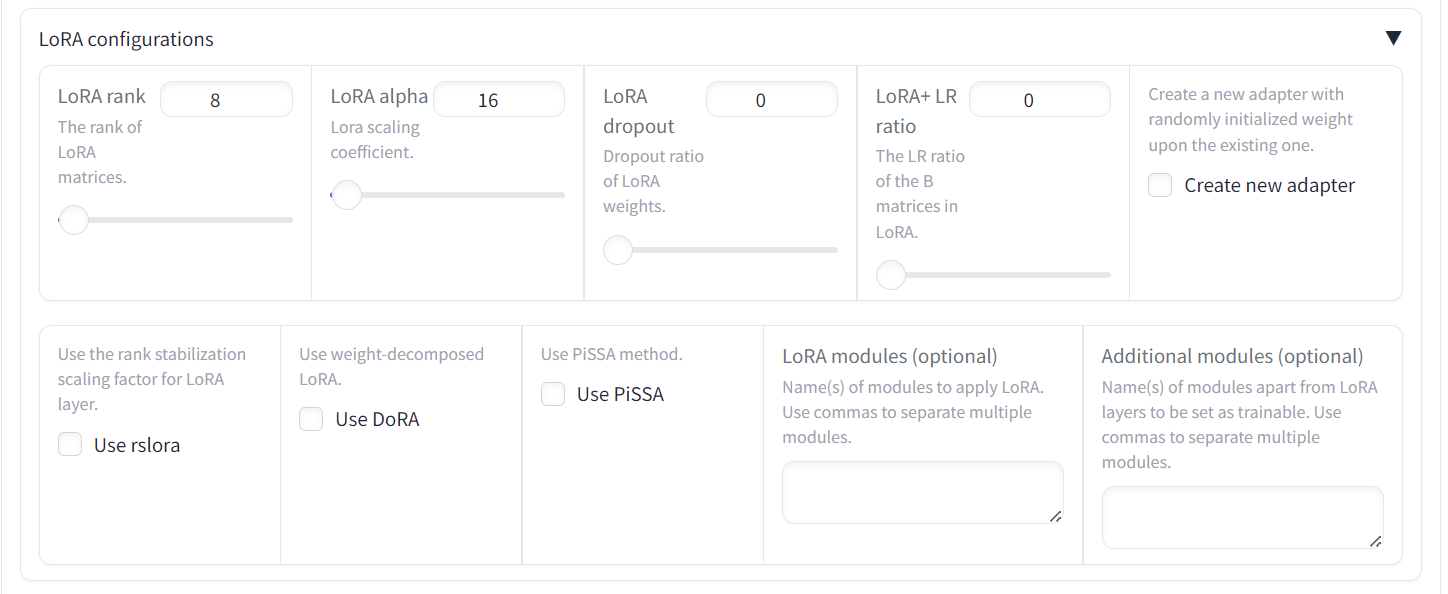
Vous pouvez aussi modifier le rang LoRA et d’autres configurations associées. Pour ce tutoriel, nous gardons toutes les autres options par défaut.
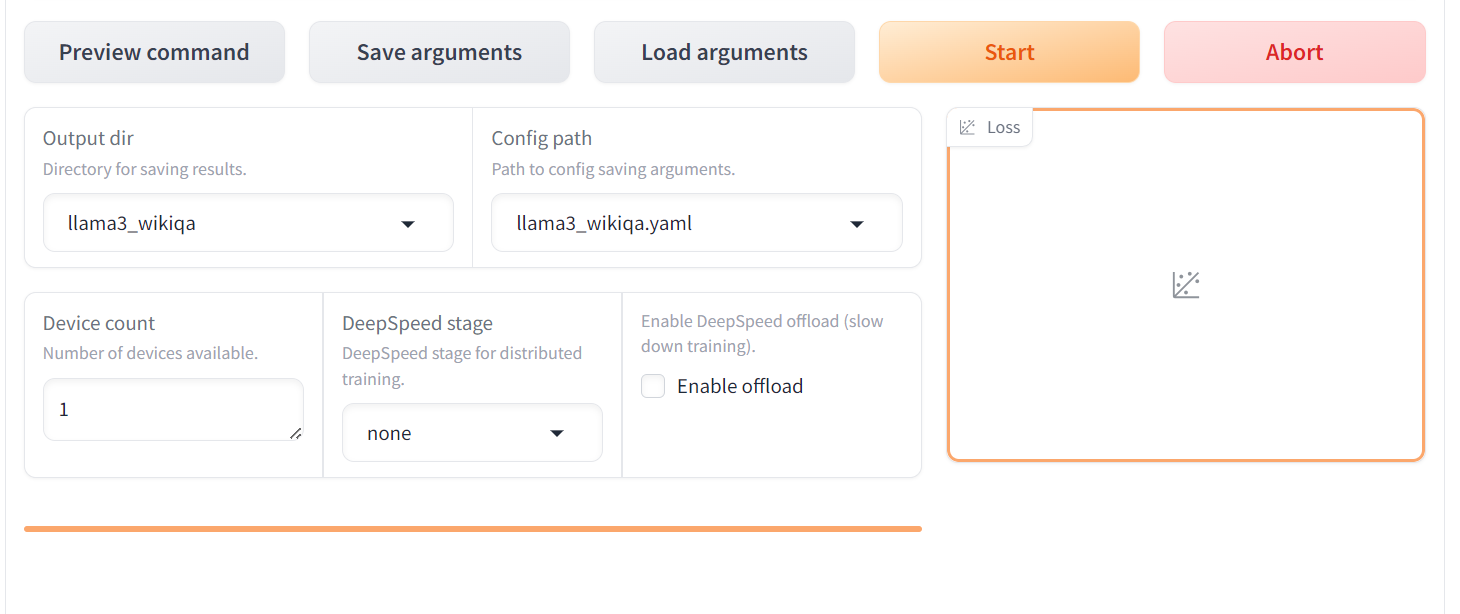
Faites défiler plus bas pour accéder à la configuration d’entraînement. Renseignez le répertoire de sortie et le chemin de configuration, puis cliquez sur le bouton « Start ». Le graphique de loss mettra un moment à s’afficher, car LLaMA-Factory commence par télécharger le modèle et le jeu de données, puis à les charger, ce qui peut prendre au moins 5 minutes.
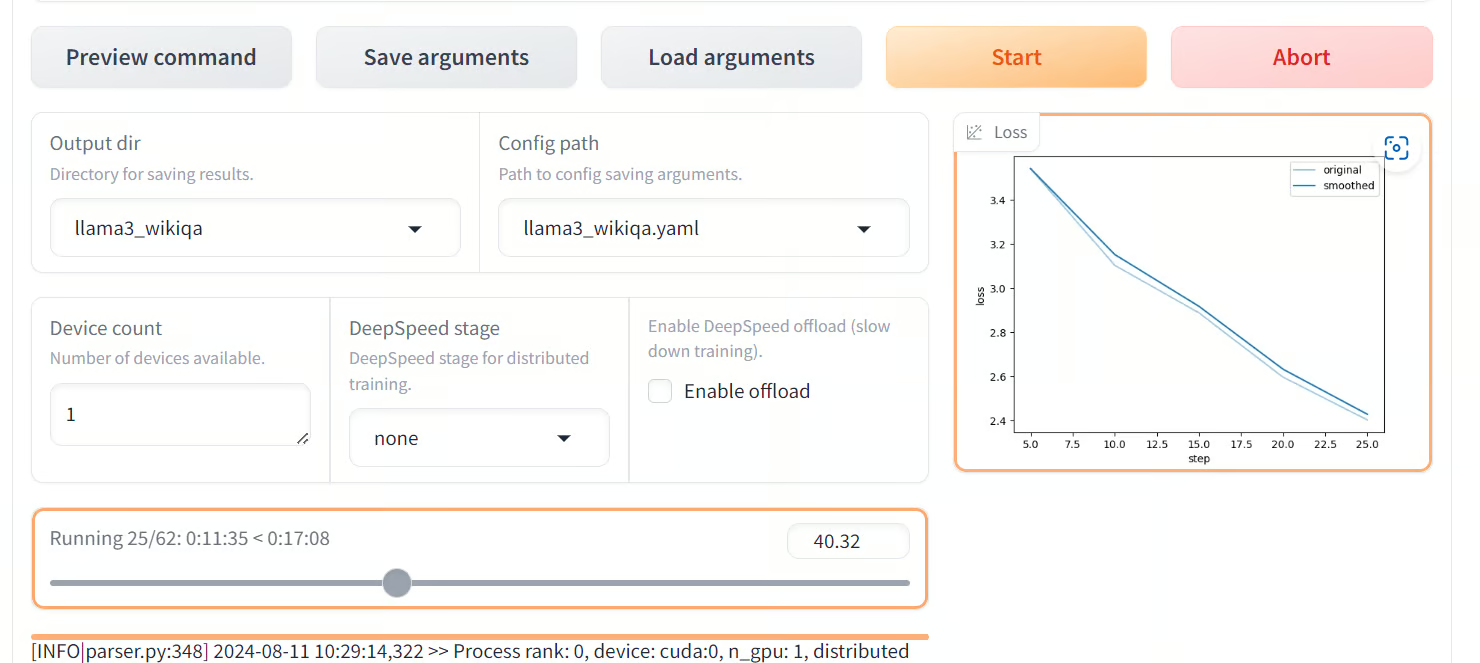
Une fois le modèle chargé et l’entraînement démarré, vous verrez les visualisations apparaître sur le graphique de loss. Comme on l’observe, la loss décroît progressivement au fil des étapes, ce qui est bon signe.
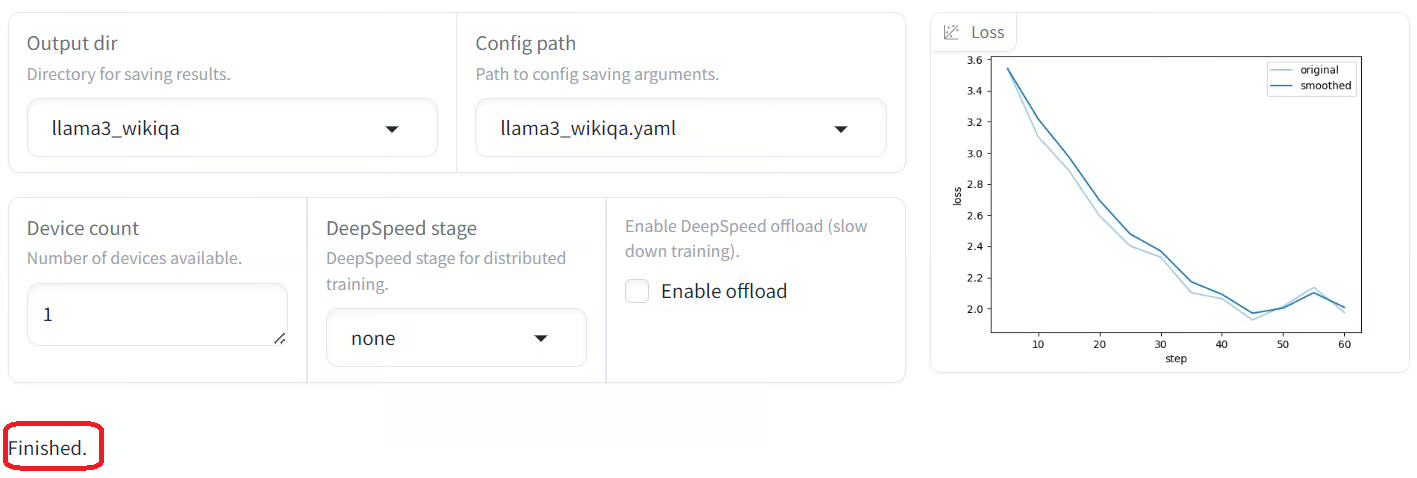
À la fin de l’entraînement, un message « finish » apparaît en bas à gauche. Comme on le voit, la loss a diminué progressivement puis s’est stabilisée après 45 étapes.
Si vous êtes data scientist ou développeur, vous trouverez facile d’affiner votre modèle en Python.
Nous proposons un guide détaillé pour les profils techniques souhaitant entraîner LLaMA‑3 ici : Fine-Tuning Llama 3 and Using It Locally: A Step-by-Step Guide.
Pour évaluer le modèle affiné, passez du menu « Train » à « Chat ». Puis, dans « Checkpoint path », chargez l’adapter affiné enregistré.
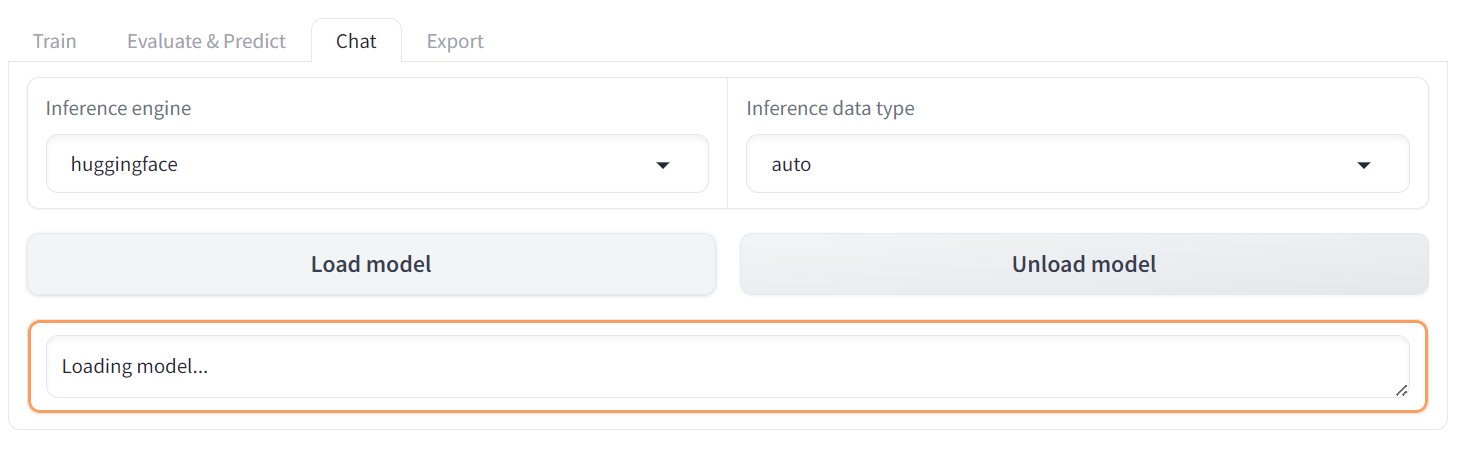
Cliquez ensuite sur « Load model » et patientez quelques secondes jusqu’au chargement complet du modèle.
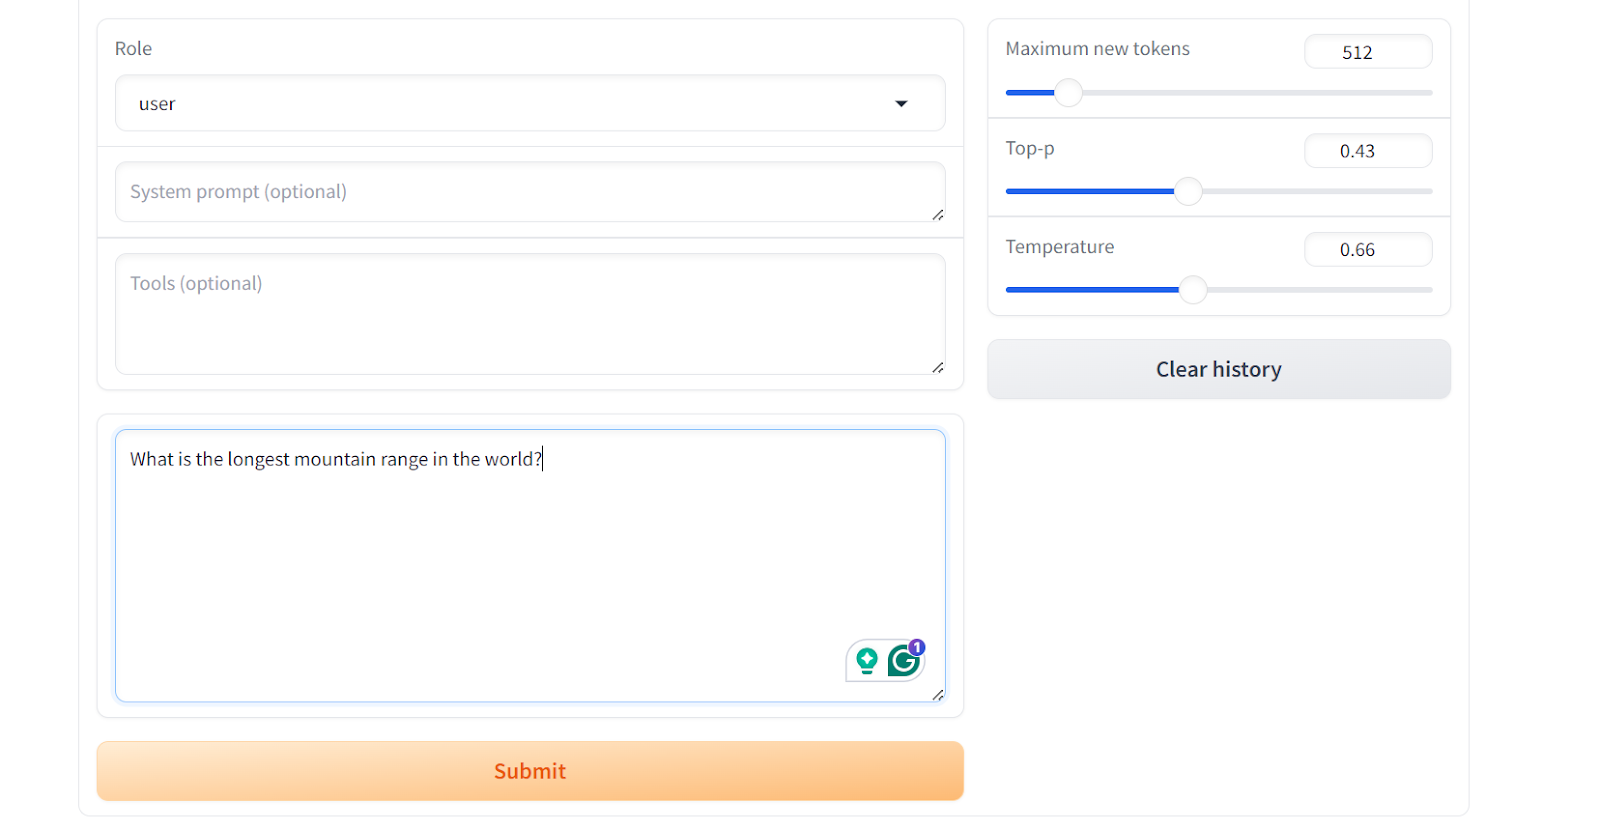
Faites défiler pour afficher le champ de saisie du chat et posez une question générale sur une chaîne de montagnes.
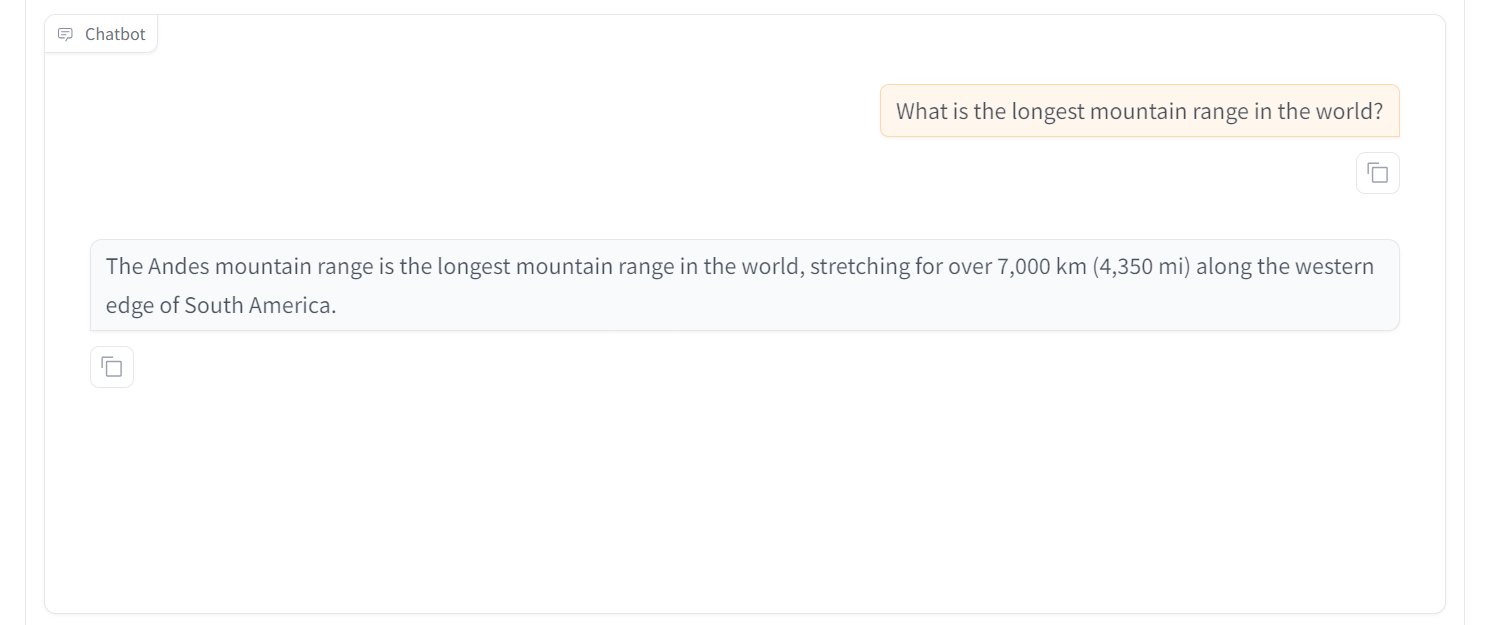
Vous obtiendrez une réponse simple et directe, proche de ce que propose le jeu de données « wiki_qa ».
Posons une autre question. On constate que le modèle s’en sort très bien. En 30 minutes, nous avons affiné le modèle, ce qui aurait pris plus de 4 heures avec la bibliothèque Transformers. Impressionnant.
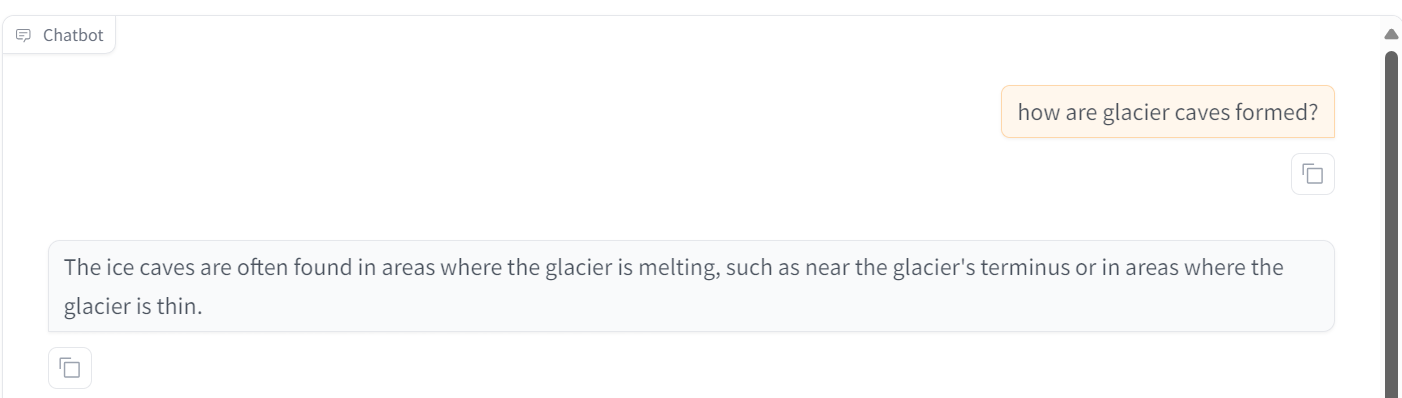
Parfois, l’affinage ne résout pas tous les problèmes d’un LLM. C’est pourquoi nous vous recommandons de lire RAG vs Fine-Tuning : un tutoriel complet avec des exemples pratiques pour identifier la meilleure approche selon vos besoins.
Au-delà de l’affinage et des tests, l’écosystème LLaMA-Factory propose des fonctionnalités clés : utilisation de données personnalisées pour l’affinage, fusion et export de modèles, et déploiement des modèles affinés avec VLLM.
Pour ajouter un jeu de données personnalisé, modifiez simplement le fichier data/dataset_info.json. Il sera alors accessible dans LLaMA-Factory WebUI.
Pour plus de détails sur le format attendu des fichiers de jeu de données et la manière de modifier le fichier dataset_info.json, reportez-vous à la documentation data/README.md.
Vous pouvez utiliser des jeux de données issus des hubs Hugging Face ou ModelScope, ou charger un jeu de données depuis votre disque local.
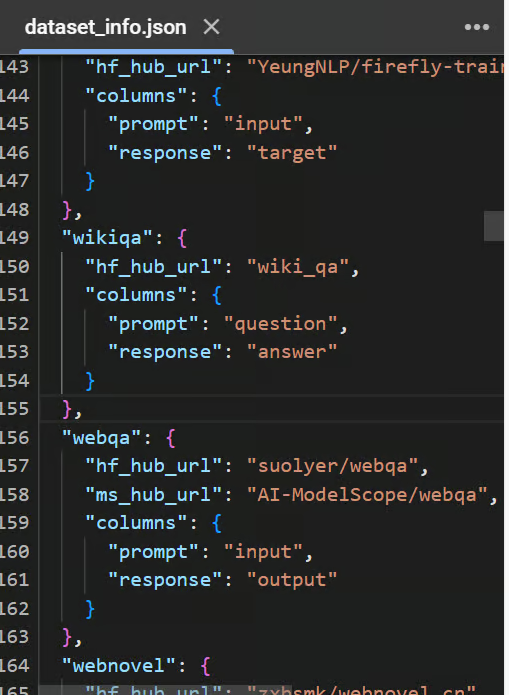
Aperçu du fichier data/dataset_info.json
Vous pouvez facilement fusionner l’adapter LoRA affiné avec le modèle complet et l’exporter vers Hugging Face Hub en cliquant sur l’onglet « Export ».
Ajustez la taille maximale des shards, définissez le chemin du répertoire d’export, puis indiquez l’ID du dépôt sur Hugging Face Hub et l’appareil d’export. La fusion et le téléversement de tous les fichiers sur Hugging Face Hub prennent quelques minutes.
Remarque : la version gratuite de Colab offre 12 Go de RAM, alors que la fusion du LoRA d’un modèle de 8 milliards de paramètres nécessite au moins 16 Go. Cette opération n’est donc pas possible dans la version gratuite.
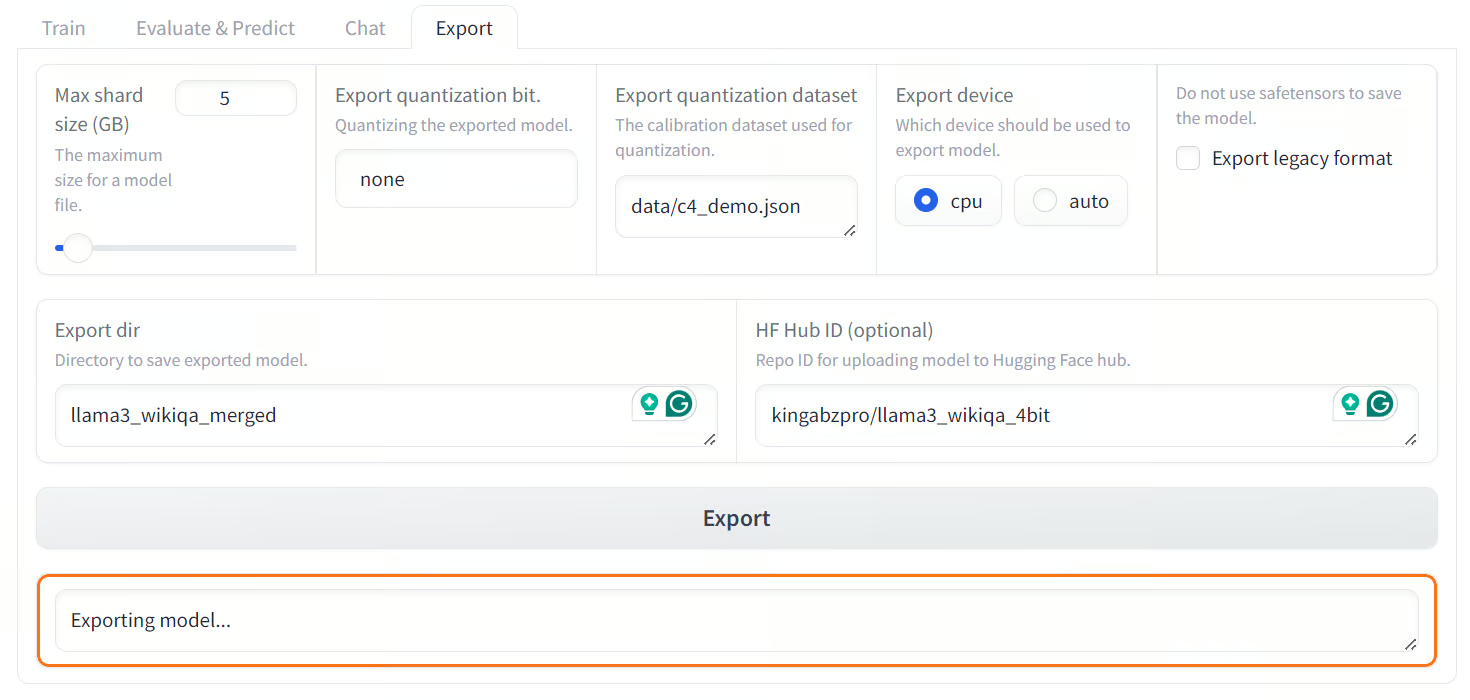
Fusion et export du modèle affiné vers Hugging Face Hub
LLaMA-Factory intègre le framework vLLM pour le serving et le déploiement. Avec la commande suivante, nous pouvons servir le modèle Llama-3-8B-Instruct et y accéder via l’API Python OpenAI ou en RestAPI.
$ API_PORT=8000 llamafactory-cli api examples/inference/llama3_vllm.yamlVous pouvez modifier ce fichier ou créer votre propre fichier .yaml pour servir votre modèle affiné en production. Il suffit d’indiquer le chemin vers le dossier du modèle en local ou sur Hugging Face Hub.
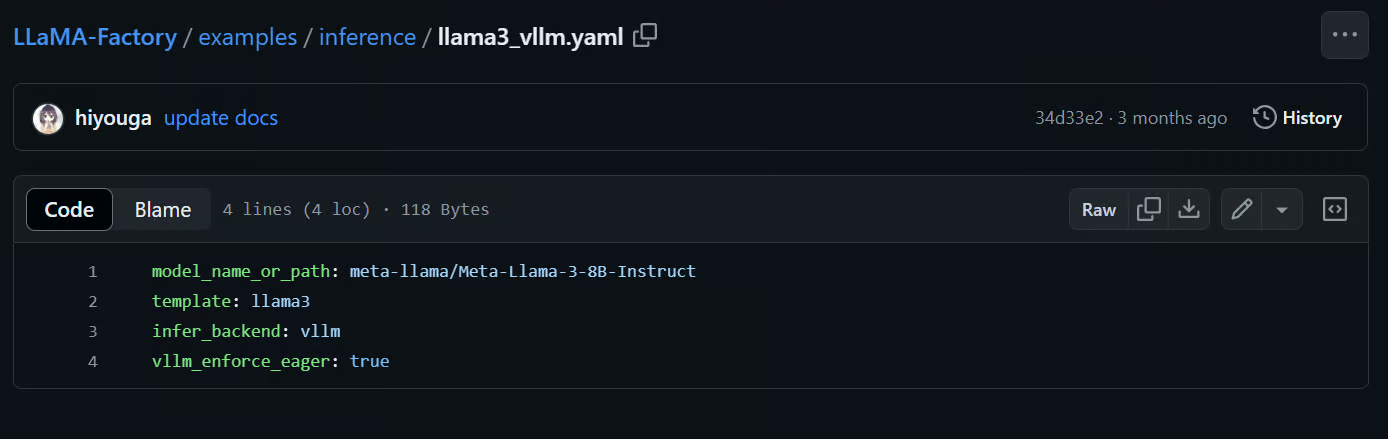
Source : hiyouga/LLaMA-Factory (github.com)
Si vous cherchez une solution low-code similaire pour affiner des LLM, notamment le modèle propriétaire GPT-4o, nous avons un guide complet à votre disposition. Suivez notre tutoriel pas à pas ici : Fine-Tuning OpenAI's GPT-4: A Step-by-Step Guide.
LLaMA-Factory WebUI simplifie la vie des débutants comme des experts. Il suffit d’ajuster quelques paramètres pour affiner un modèle sur un jeu de données personnalisé. Avec la même interface, vous pouvez tester le modèle, l’exporter vers Hugging Face ou le sauvegarder en local. Vous pourrez ensuite le déployer en production avec la commande api du CLI LLaMA-Factory. C’est aussi simple que cela.
Plutôt que d’écrire des centaines de lignes de code et de déboguer des problèmes d’affinage, vous obtenez des résultats similaires en quelques clics.
Dans ce tutoriel, nous avons découvert LLaMA-Factory WebUI et appris à affiner le modèle LLaMA‑3‑8B‑Instruct sur un jeu de données Wikipedia Q&A à l’aide de ce framework. Nous avons également testé le modèle affiné via le menu chatbot intégré et exploré les fonctionnalités supplémentaires proposées par LLaMA-Factory.
Apprenez à affiner des LLM en Python en vous inscrivant gratuitement au prochain webinar Fine-Tuning Your Own Llama 3 Model.
Les meilleurs cours DataCamp sur les LLM
Cours
Cours
Cursus