कोर्स
Python में DeepSeek के साथ काम करना
3 घंटा
1.3K
Mistral ने अपना पहला रीजनिंग मॉडल जारी किया है, Magistral, जो दो वेरिएंट में उपलब्ध है: Magistral Small (ओपन-वेट) और Magistral Medium (क्लोज़्ड मॉडल)।
इस ब्लॉग में मेरा ध्यान Magistral Small पर रहेगा—यह एक ओपन-वेट रीजनिंग मॉडल है, जिसे स्ट्रक्चर्ड लॉजिक, बहुभाषी समझ, और ट्रेस करने योग्य व्याख्याएँ देने की क्षमता वाले कार्यों के लिए डिज़ाइन किया गया है। जब इसे vLLM जैसे हाई-थ्रूपुट इंफरेंस इंजन या Ollama जैसे आसान टूल्स के साथ जोड़ा जाता है, तो यह त्रुटिपूर्ण तर्क को डिबग करने और रीजनिंग टास्क के लिए एक बेहतरीन टूल बन जाता है।
इस ट्यूटोरियल में, मैं चरण-दर-चरण समझाऊँगा कि कैसे:
हम अपने पाठकों को AI की ताज़ा खबरों से अपडेट रखते हैं The Median के ज़रिए—यह हमारा मुफ़्त शुक्रवार का न्यूज़लेटर है जो हफ्ते की प्रमुख कहानियों को सरलता से समझाता है। सब्सक्राइब करें और हर हफ्ते चंद मिनटों में अपडेट रहें:
Magistral, Mistral AI का पहला समर्पित रीजनिंग मॉडल है, जिसे चरण-दर-चरण लॉजिक, बहुभाषी सटीकता, और ट्रेस करने योग्य आउटपुट के लिए बनाया गया है। यह दो वेरिएंट में ड्यूल-रिलीज़ मॉडल है:
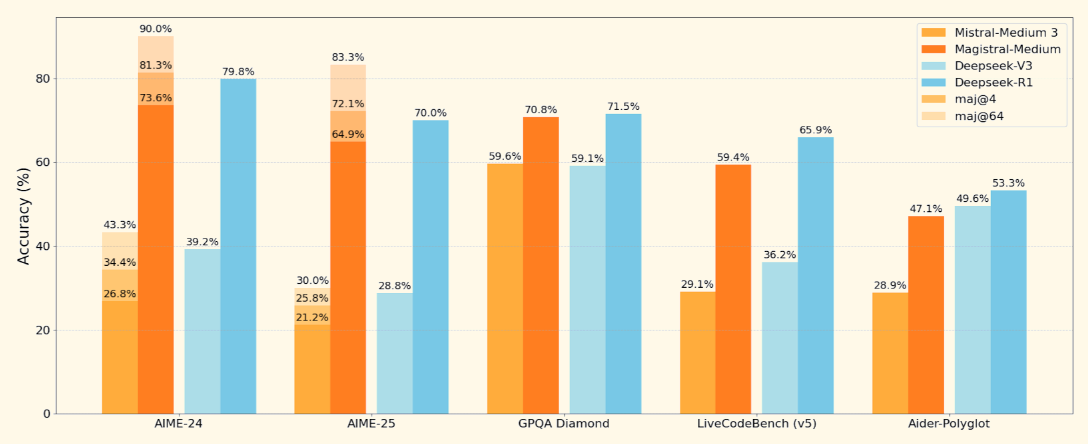
स्रोत: Mistral
Magistral Small, जिस ओपन मॉडल पर हम ध्यान देंगे, 128K कॉन्टेक्स्ट विंडो को सपोर्ट करता है (स्थिर प्रदर्शन के लिए 40K अनुशंसित)। इसे सुपरवाइज़्ड फाइन-ट्यूनिंग (Magistral Medium के ट्रेसेज़ पर) और रीइन्फोर्समेंट लर्निंग से प्रशिक्षित किया गया है।
इस सेक्शन में, हम Ollama का उपयोग करके लोकल रूप से Mistral के Magistral मॉडल पर इंफरेंस करेंगे। ध्यान दें कि इस मॉडल को लगभग 14GB स्पेस की आवश्यकता है और क्वांटाइज़ करने के बाद इसे एकल RTX 4090 या 32GB RAM वाले MacBook में चलाया जा सकता है। मैंने यह डेमो M3 MacBook Pro पर चलाया।
macOS, Windows, या Linux के लिए Ollama यहाँ से डाउनलोड करें: https://ollama.com/download.
इंस्टॉलर के निर्देशों का पालन करें, और इंस्टॉलेशन के बाद, टर्मिनल में यह चलाकर सत्यापित करें:
ollama --versionअगला कदम, निम्न कोड चलाकर Magistral मॉडल पुल करें:
ollama pull magistral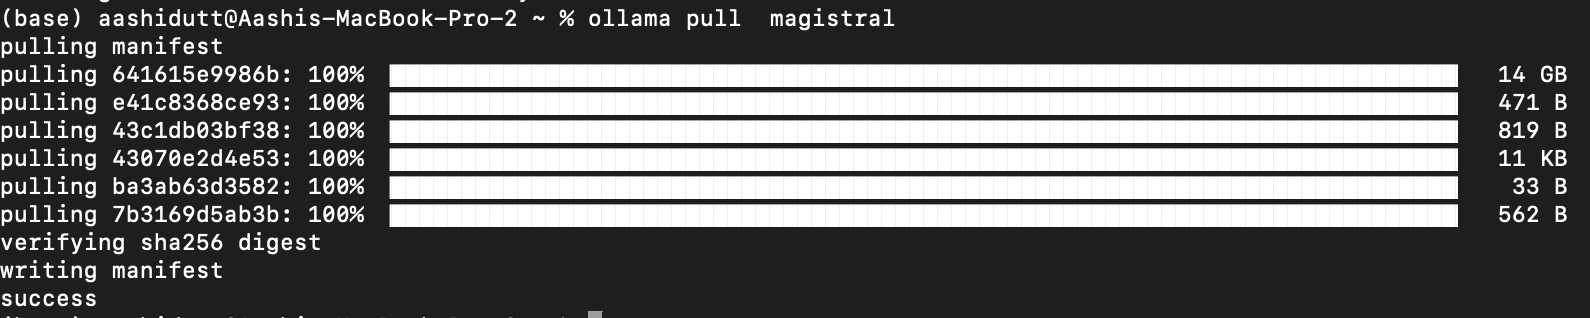
यह Magistral मॉडल को आपकी लोकल मशीन पर पुल कर देगा। नोट: मॉडल लगभग 14 GB का है, इसलिए समय लगेगा।
आइए सभी आवश्यक निर्भरताएँ इंस्टॉल करके शुरुआत करें।
pip install ollama
pip install requests
निर्भरताएँ इंस्टॉल होने के बाद, हम इंफरेंस चलाने के लिए तैयार हैं।
अब, हम एक प्रॉम्प्ट टेम्पलेट संरचना सेट करते हैं (जैसा कि मूल Magistral पेपर में बताया गया है) जो मॉडल की सोचने की प्रक्रिया को निर्देशित करती है।
import gradio as gr
import requests
import json
def build_prompt(flawed_logic):
    return f"""<s>[SYSTEM_PROMPT]
A user will ask you to solve a task. You should first draft your thinking process (inner monologue) until you have derived the final answer. Afterwards, write a self-contained summary of your thoughts.
Your thinking process must follow the template below:
<think>
Your thoughts or/and draft, like working through an exercise on scratch paper. Be as casual and detailed as needed until you're confident.
</think>
Do not mention that you're debugging — just present your thought process and conclusion naturally.
[/SYSTEM_PROMPT][INST]
Here is a flawed solution. Can you debug it and correct it step by step?
\"\"\"{flawed_logic}\"\"\"
[/INST]
"""
उपरोक्त फ़ंक्शन एक फॉर्मैटेड प्रॉम्प्ट लौटाता है जो Magistral को यह करने के लिए निर्देशित करता है:
यह संरचना उन मॉडलों के लिए महत्वपूर्ण है जैसे Magistral, जिन्हें टूल-ऑगमेंटेड प्रॉम्प्ट्स के साथ प्रशिक्षित किया गया है। यही सिस्टम प्रॉम्प्ट संरचना गणितीय और कोडिंग दोनों समस्याओं के लिए प्रयोग की जा सकती है।
इस चरण में, हम Ollama के लोकल API का उपयोग करके Magistral मॉडल का आउटपुट रियल-टाइम में स्ट्रीम करेंगे। चूँकि हमारा फोकस ट्रेस करने योग्य, चरणबद्ध तर्क के साथ त्रुटिपूर्ण लॉजिक को डिबग करना है, इसलिए यह ज़रूरी है कि उपयोगकर्ता देख सके कि मॉडल अपने निष्कर्ष तक कैसे पहुँचता है। अंत में, हम व्याख्या को एक साफ-सुथरे Gradio इंटरफेस के माध्यम से दिखाते हैं।
def call_ollama_stream(flawed_logic):
    prompt = build_prompt(flawed_logic)
    response_text = ""
    with requests.post(
        "http://localhost:11434/api/generate",
        json={"model": "magistral", "prompt": prompt, "stream": True},
        stream=True,
    ) as r:
        for line in r.iter_lines():
            if line:
                content = json.loads(line).get("response", "")
                response_text += content
    return response_text
with gr.Blocks(theme=gr.themes.Base()) as demo:
    gr.Markdown("## Chain-of-Logic Debugger (Magistral + Ollama)")
    gr.Markdown("Paste a flawed logical argument or math proof, and Magistral will debug it with step-by-step reasoning.")
    with gr.Row():
        input_box = gr.Textbox(lines=8, label="Flawed Logic / Proof")
        output_box = gr.Textbox(lines=15, label="Debugged Explanation")
    debug_button = gr.Button("Run Debugger")
    debug_button.click(fn=call_ollama_stream, inputs=input_box, outputs=output_box)
demo.launch(debug = True, share=True)
यहाँ संक्षेप में क्या हो रहा है:
build_prompt() फ़ंक्शन से शुरू करते हैं, जो यूज़र इनपुट को एक स्ट्रक्चर्ड प्रॉम्प्ट में लपेटता है और मॉडल को <think> रीजनिंग टैग्स के साथ निर्देशित करता है।call_ollama_stream() फ़ंक्शन स्ट्रीमिंग POST रिक्वेस्ट के माध्यम से localhost:11434 पर Ollama के HTTP API को प्रॉम्प्ट भेजता है।requests.iter_lines() का उपयोग करके पंक्ति-दर-पंक्ति स्ट्रीम प्रतिक्रियाएँ सुनता है। हर लाइन के लिए, यह JSON पेलोड से response फ़ील्ड निकालता है और उसे रनिंग टेक्स्ट बफ़र में जोड़ता है।मैंने यह इनपुट आज़माया:
Assume x = y. Then, x² = xy. Subtracting both sides gives x² - y² = xy - y². So, (x+y)(x−y) = y(x−y). Cancelling x−y gives x+y = y. But since x = y, this means 2y = y → 2 = 1.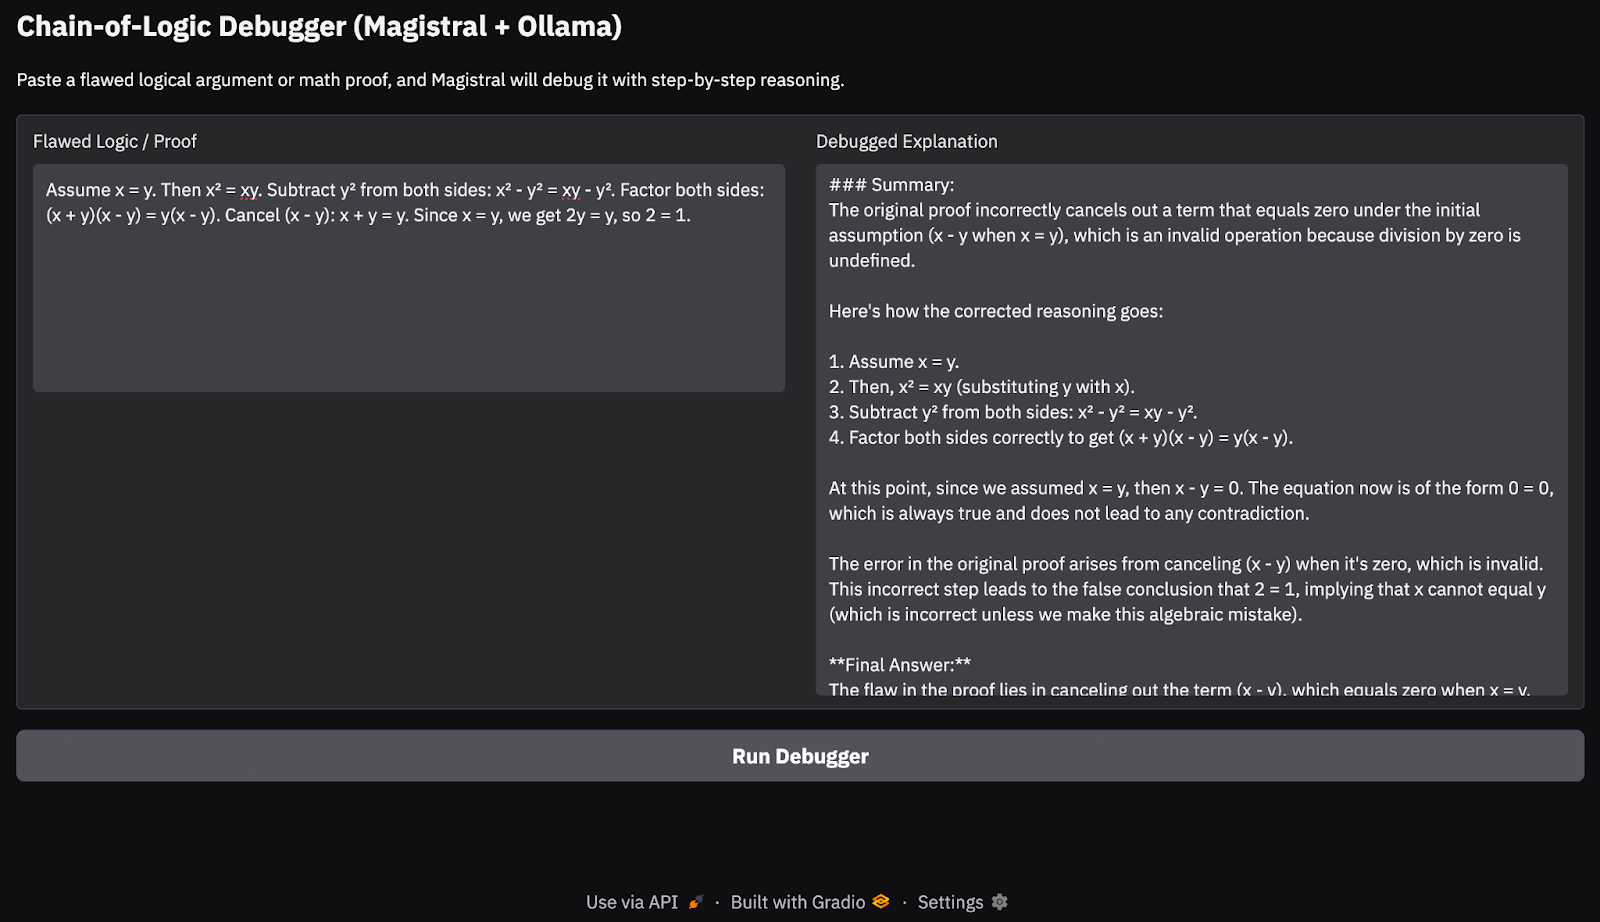
M3 MacBook Pro पर मेरे परीक्षण में, मॉडल ने सरल तार्किक श्रंखलाओं और गणितीय प्रूफ को काफ़ी अच्छी तरह संभाला। हालाँकि, गहरी रीजनिंग टास्क या लंबी थॉट-चेन के लिए, यह कभी-कभी एज केस मिस कर देता था—जो कि 24B ओपन मॉडल से अपेक्षित है। यह तरीका हल्के-फुल्के रीजनिंग डेमो या ऑन-डिवाइस चेन-ऑफ-थॉट एप्लिकेशन के लिए आदर्श है, वह भी क्लाउड APIs पर निर्भर हुए बिना।
इस सेक्शन में, मैं बताऊँगा कि RunPod पर एक शक्तिशाली GPU इंस्टेंस कैसे प्रोविज़न करें, vLLM के माध्यम से Mistral का Magistral मॉडल डिप्लॉय करें, और लोकल व रिमोट इंफरेंस के लिए OpenAI-कम्पैटिबल API को एक्सपोज़ करें।
मॉडल लॉन्च करने से पहले, सुनिश्चित करें कि आपका RunPod अकाउंट सेट है:
अब, ऐसा पॉड प्रोविज़न करें जो मॉडल को होस्ट कर सके। पॉड सेट करने के लिए ये कदम अपनाएँ:
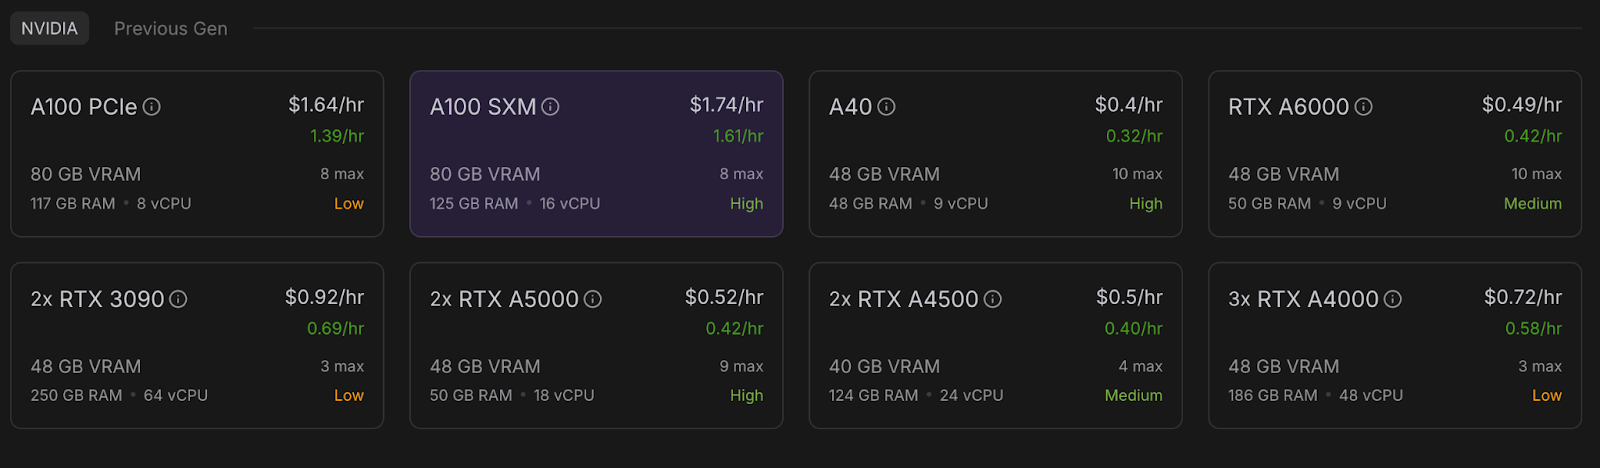
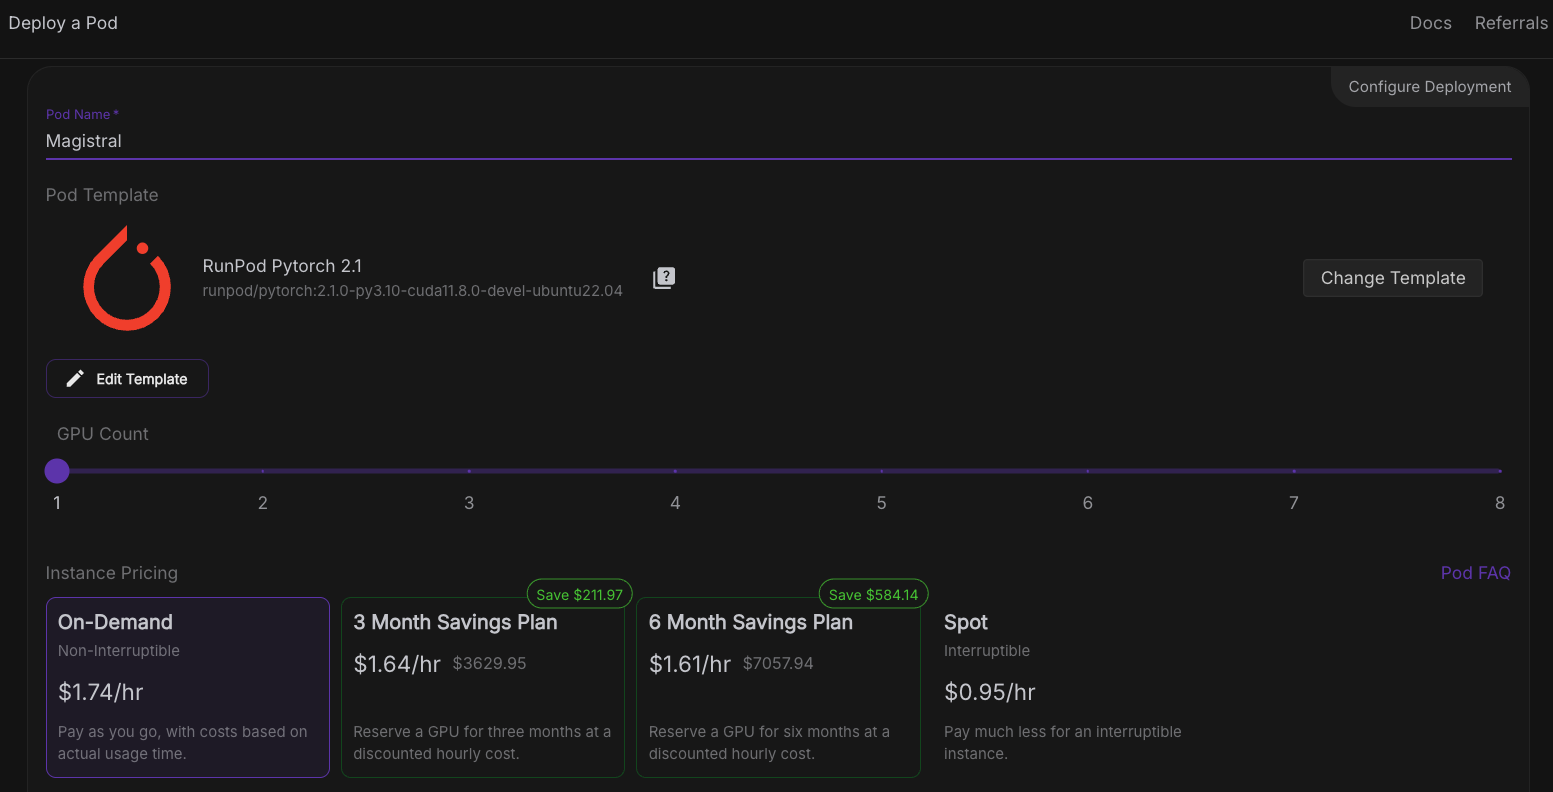
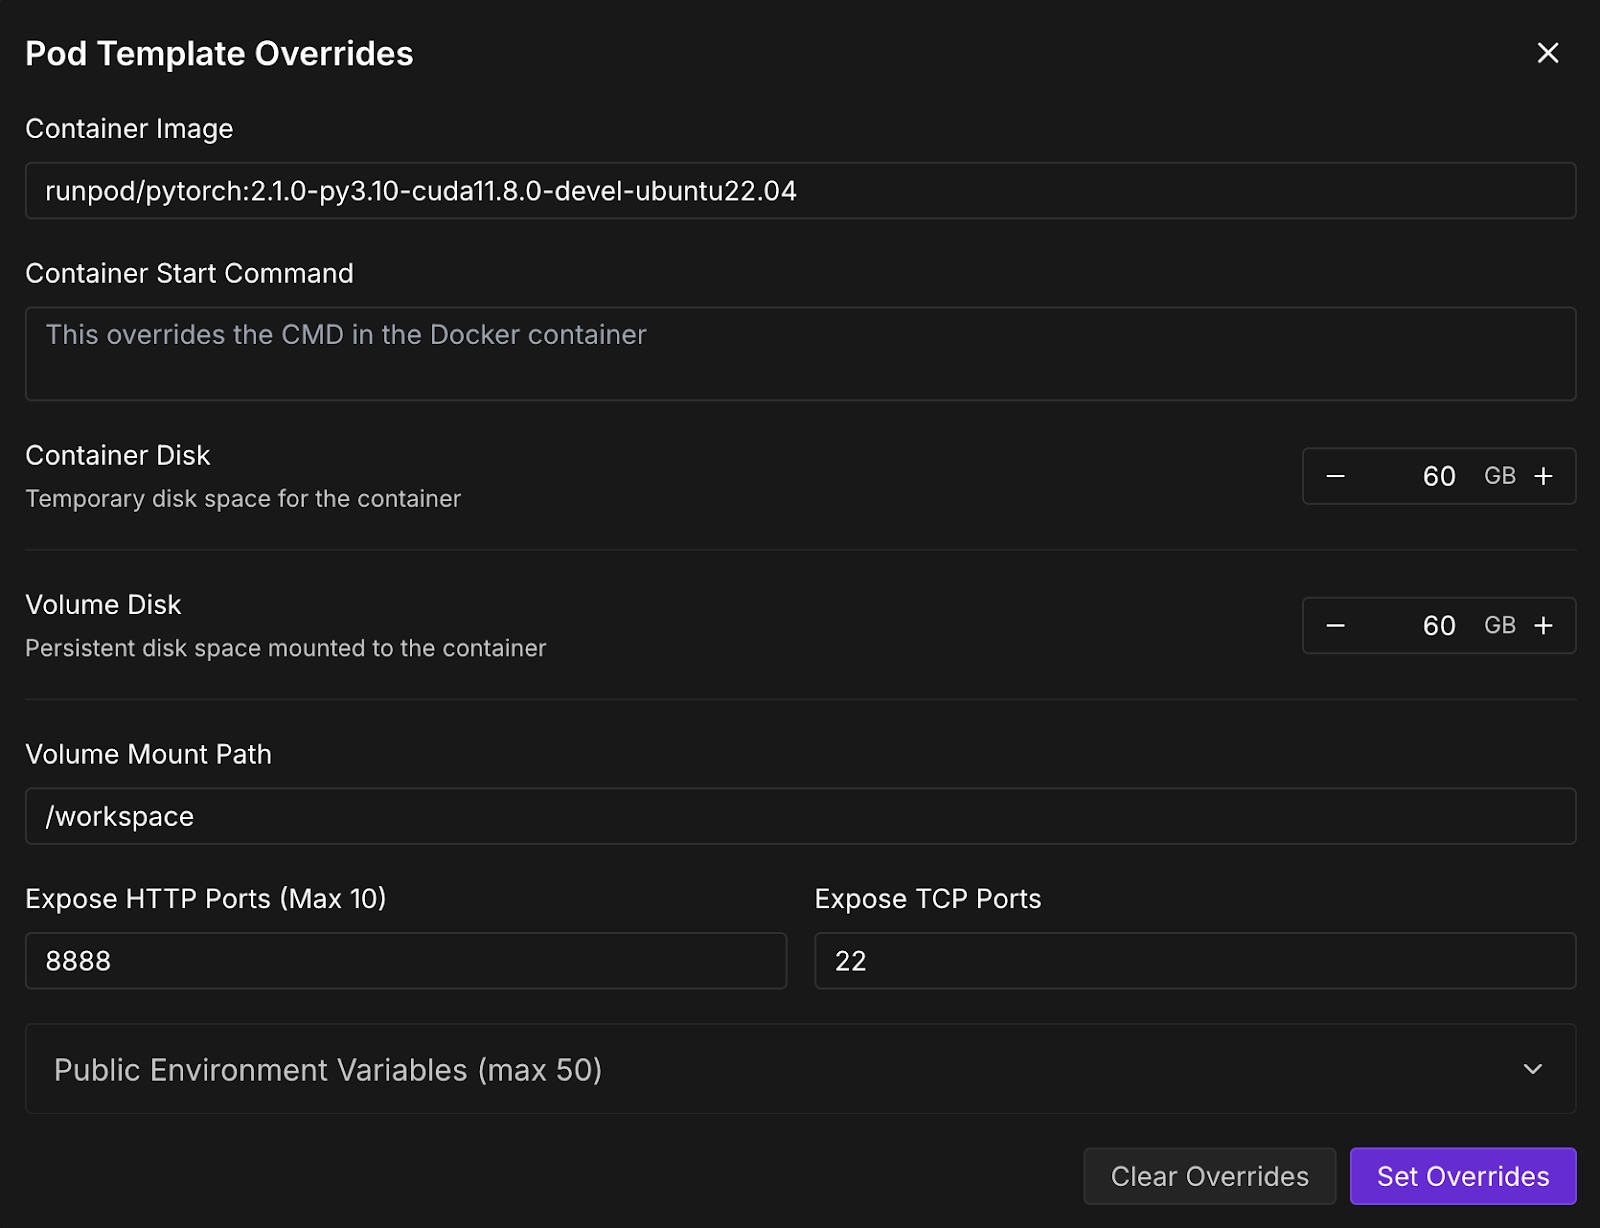
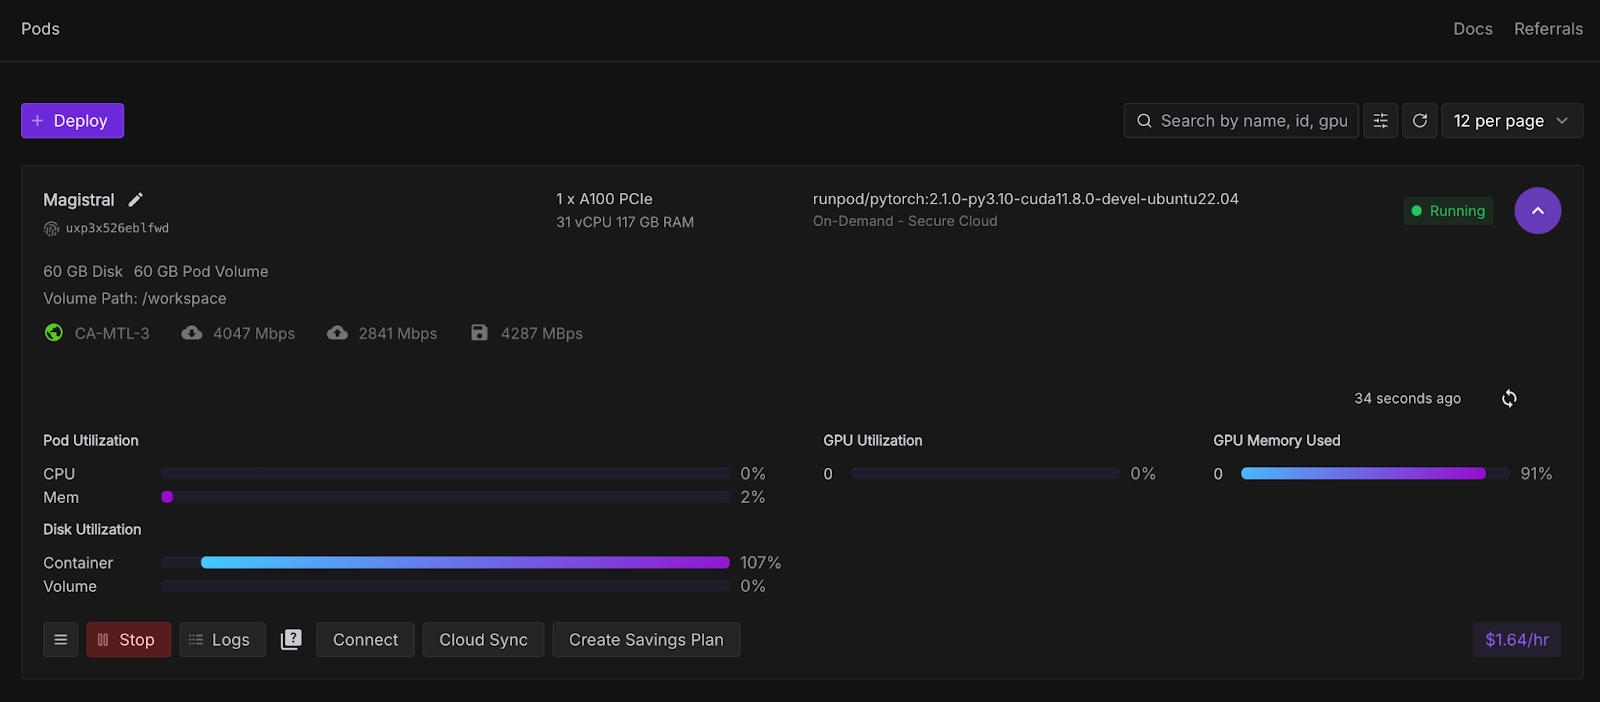
जैसे ही Connect बटन क्लिक करने योग्य हो जाए, उस पर क्लिक करें। आपको कई कनेक्शन विकल्प दिखाई देंगे—आप या तो:
नोट: Jupyter Lab के नीचे हरे रंग का डॉट 🟢 और Ready संकेत दिखाई देने तक प्रतीक्षा करें।
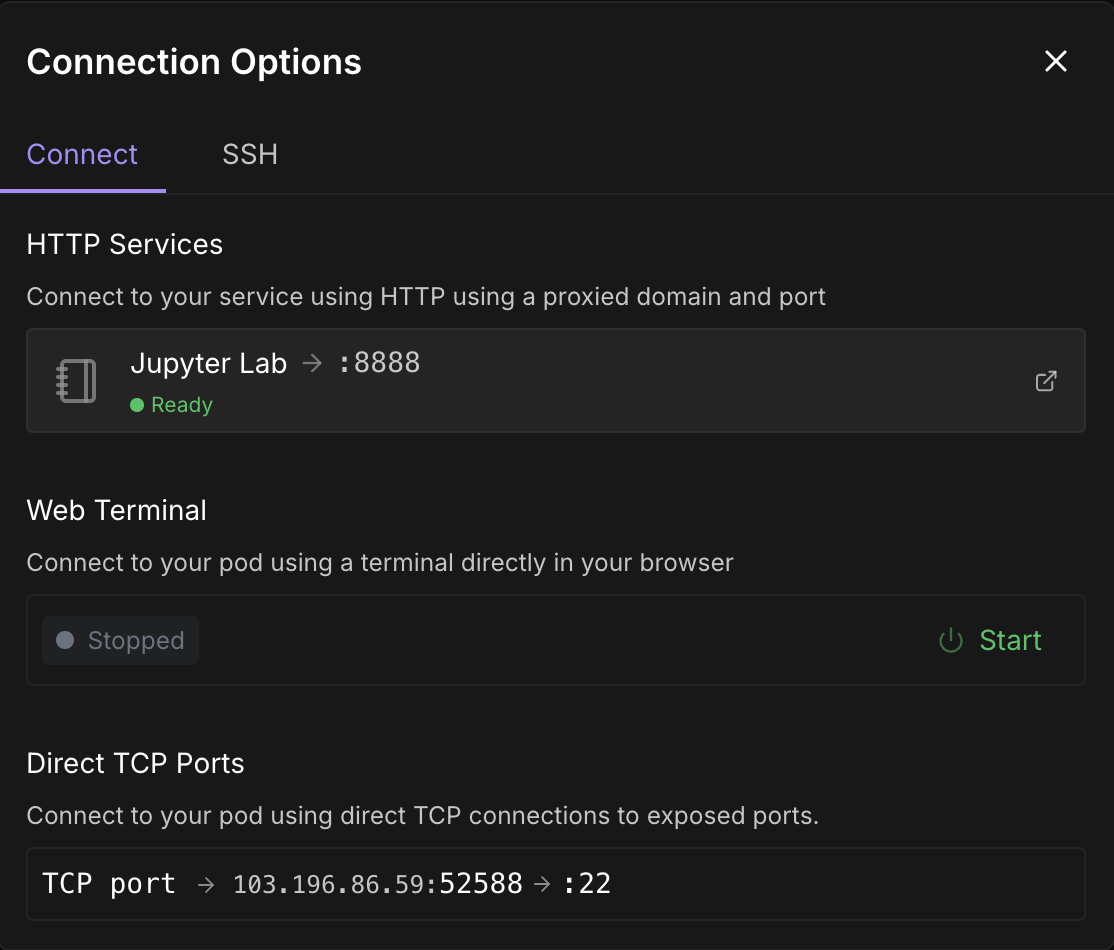
Jupyter Lab पर क्लिक करें—यह आपको एक अन्य विंडो में ले जाएगा जहाँ नया Jupyter नोटबुक बनाने के विकल्प होंगे। एक नया टर्मिनल खोलें या नई Python फ़ाइल सेट करें।
अपने पॉड के अंदर, टर्मिनल या Jupyter Notebook में, vLLM और इसकी निर्भरताएँ इंस्टॉल करें।
pip install -U vllm --pre --extra-index-url https://wheels.vllm.ai/nightly
pip install gradio
साथ ही, यह सुनिश्चित करें कि आप mistral_common >= 1.6.0 चला रहे हैं, इसके लिए यह कमांड चलाएँ:
python -c "import mistral_common; print(mistral_common.__version__)"अब, मॉडल को सर्व करते हैं। बाएँ ऊपर कोने में “+” चिन्ह पर क्लिक करें और विकल्पों में से Terminal चुनें, फिर निम्न कमांड चलाएँ:
vllm serve mistralai/Magistral-Small-2506 \
  --tokenizer_mode mistral \
  --config_format mistral \
  --load_format mistral \
  --tool-call-parser mistral \
  --enable-auto-tool-choice
इस टर्मिनल को चलता रहने दें क्योंकि यह कमांड vLLM का उपयोग करके Magistral Small मॉडल लॉन्च करती है और इसे तेज, OpenAI-संगत API एन्डपॉइंट (http://localhost:8000/v1) पर उपलब्ध कराती है। यहाँ प्रत्येक फ्लैग का विवरण है:
|
फ्लैग |
विवरण |
|
|
यह एक Hugging Face मॉडल पहचानकर्ता है। यदि यह मॉडल पहले से मौजूद नहीं है, तो vLLM इसे स्वतः डाउनलोड कर लेता है। |
|
|
यह सुनिश्चित करता है कि टोकनाइज़र को Mistral-विशिष्ट लॉजिक के अनुसार इंटरप्रेट किया जाए। |
|
|
यह संकेत देता है कि मॉडल कॉन्फ़िग Mistral के कस्टम फ़ॉर्मेट में है, न कि Hugging Face के डिफ़ॉल्ट में। |
|
|
यह Mistral द्वारा अपेक्षित लेआउट में मॉडल वेट्स लोड करता है (संगतता के लिए महत्वपूर्ण)। |
|
|
यह Mistral की संरचना के अनुसार टूल-कॉलिंग सिंटैक्स को पार्स करने में सक्षम बनाता है। |
|
|
यदि टूल कॉलिंग का उपयोग होता है, तो इनपुट के आधार पर स्वतः सर्वश्रेष्ठ टूल चुनता है। यह वैकल्पिक है, लेकिन टूल रीजनिंग पर प्रशिक्षित मॉडलों के लिए उपयोगी है। |
अब हम एक डेमो बनाएँगे जहाँ Magistral से त्रुटिपूर्ण तर्क या गणितीय प्रूफ को डीबग करने के लिए कहा जाएगा। मॉडल <think> टैग्स में एक विस्तृत आंतरिक मोनोलॉग और अंत में एक सारांश आउटपुट करेगा।
हम Jupyter Notebook में इम्पोर्ट्स सेटअप करने और OpenAI क्लाइंट को इनिशियलाइज़ करने से शुरू करते हैं। फिर, मूल Magistral पेपर में सुझाए अनुसार Magistral का सिस्टम प्रॉम्प्ट सेट करते हैं।
import gradio as gr
from openai import OpenAI
import re
import time
client = OpenAI(api_key="EMPTY", base_url="http://localhost:8000/v1")
SYSTEM_PROMPT = """<s>[SYSTEM_PROMPT]system_prompt
A user will ask you to solve a task. You should first draft your thinking process (inner monologue) until you have derived the final answer. Afterwards, write a self-contained summary of your thoughts.
<think>
Your thoughts or draft, like working through an exercise on scratch paper.
</think>
Here, provide a concise summary that reflects your reasoning and presents a clear final answer to the user.
Problem:
[/SYSTEM_PROMPT]"""
SYSTEM_PROMPT यह परिभाषित करता है कि मॉडल को किस संरचित फ़ॉर्मेट में प्रतिक्रिया देनी चाहिए:
इसके बाद, हम Magistral के मूल ब्लॉग में सुझाए अनुसार आवश्यक temperature, top_p, और max_tokens सेट करके मॉडल आउटपुट स्ट्रीमिंग को हैंडल करते हैं।
# Streaming logic with stop control
def debug_faulty_logic_stream(faulty_proof, stop_signal):
    stop_signal["stop"] = False
    messages = [
        {"role": "system", "content": SYSTEM_PROMPT},
        {"role": "user", "content": f"Here is a flawed logic or math proof. Can you debug it step-by-step?\n\n{faulty_proof}"}
    ]
    try:
        response = client.chat.completions.create(
            model="mistralai/Magistral-Small-2506",
            messages=messages,
            stream=True,
            temperature=0.7,
            top_p=0.95,
            max_tokens=2048
        )
        buffer = ""
        for chunk in response:
            if stop_signal.get("stop"):
                break
            delta = chunk.choices[0].delta
            if hasattr(delta, "content") and delta.content:
                buffer += delta.content
                filtered = re.sub(r"<think>.*?</think>", "", buffer, flags=re.DOTALL).strip()
                yield filtered
            time.sleep(0.02)
    except Exception as e:
        yield f"Error: {str(e)}"
# Set stop flag when stop button is clicked
def stop_streaming(stop_signal):
    stop_signal["stop"] = True
    return gr.Textbox.update(value="Stopped.")
उपरोक्त कोड स्निपेट मॉडल से टोकन-दर-टोकन लाइव आउटपुट स्ट्रीमिंग को संभालता है। stop_signal उपयोगकर्ताओं को "Stop" बटन पर क्लिक करके स्ट्रीमिंग रोकने देता है।
बफ़र सारे कंटेंट को इकट्ठा करता है, लेकिन रेगुलर एक्सप्रेशन का उपयोग करते हुए केवल सारांश (<think> टैग को हटाकर) ही यील्ड किया जाता है। यदि कोई त्रुटि होती है (जैसे, नेटवर्क समस्या), तो यह त्रुटि संदेश लौटाता है।
आइए इसे एक साधारण Gradio ऐप के साथ जोड़ते हैं जो उपयोगकर्ताओं को उनका त्रुटिपूर्ण तर्क या प्रूफ जोड़ने और उसे मॉडल को रीजनिंग के लिए सबमिट करने की सुविधा देता है।
with gr.Blocks() as demo:
    gr.Markdown("## Chain-of-Logic Debugger (Streaming via Magistral + vLLM)")

    input_box = gr.Textbox(
        label="Paste Your Faulty Logic or Proof",
        lines=8,
        placeholder="e.g., Assume x = y, then x² = xy..."
    )
    output_box = gr.Textbox(label="Corrected Reasoning (Streaming Output)")

    submit_btn = gr.Button("Submit")
    stop_btn = gr.Button("Stop")

    stop_flag = gr.State({"stop": False})

    submit_btn.click(
        fn=debug_faulty_logic_stream,
        inputs=[input_box, stop_flag],
        outputs=output_box
    )

    stop_btn.click(
        fn=stop_streaming,
        inputs=stop_flag,
        outputs=output_box
    )

if __name__ == "__main__":
    demo.launch(share=True, inbrowser=True, debug=True)
ऊपर दिया गया कोड एक सरल Gradio इंटरफ़ेस बनाता है, जिसमें:
यह gr.State का उपयोग करता है ताकि पता रखा जा सके कि उपयोगकर्ता स्ट्रीमिंग प्रक्रिया को रोकना चाहता है या नहीं। फिर launch() मेथड ऐप को लोकली चलाता है और आपके ब्राउज़र में खोलता है। यहाँ वह इनपुट है जो मैंने आज़माया:
Assume x = y. Then, x² = xy. Subtracting both sides gives x² - y² = xy - y². So, (x+y)(x−y) = y(x−y). Cancelling x−y gives x+y = y. But since x = y, this means 2y = y → 2 = 1.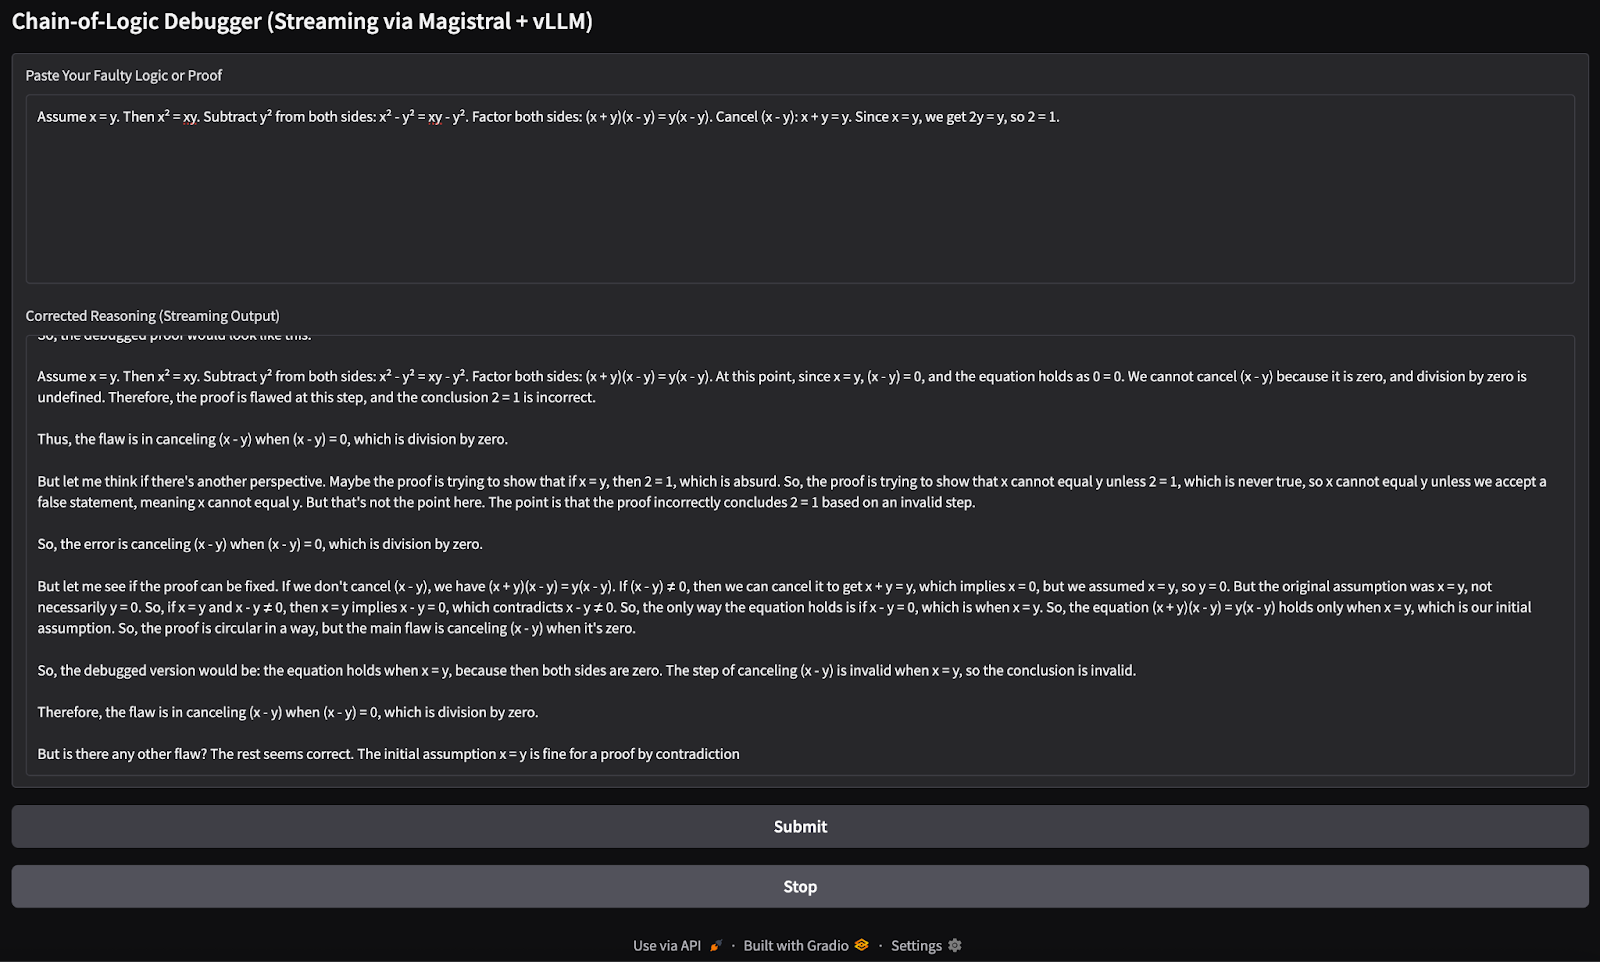
आप उस पहले से चल रहे टर्मिनल पर स्विच कर सकते हैं जहाँ vLLM सर्व कर रहा है, ताकि KV कैश उपयोग के लॉग्स देखें, साथ ही जब मॉडल आउटपुट देता है तो हिट रेट कैसे बढ़ती है यह भी देख सकें।
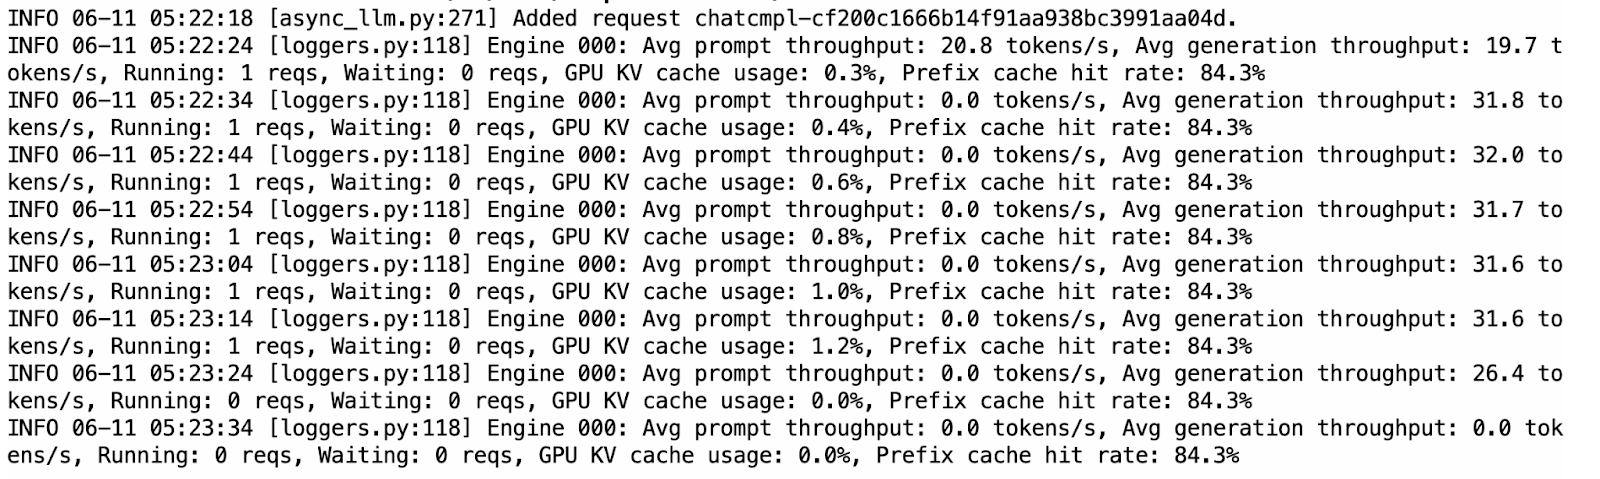
Ollama की तुलना में, vLLM अनुमान के दौरान स्पष्ट रूप से तेज़ और अधिक स्थिर रहा। स्ट्रीमिंग स्मूथ लगी, और आउटपुट अधिकतर अच्छी तरह संरचित थे। यह कहा जा सकता है कि कभी-कभी मॉडल ने <think> सेक्शंस में विचारों को दोहराया, जो संभवतः सैंपलिंग पेनल्टी के बिना ऑटोरिग्रेसिव डिकोडिंग की प्रकृति के कारण है।
जहाँ Ollama डिवाइस पर कुशल अनुमान के लिए मॉडल का क्वांटाइज़्ड 4-बिट संस्करण सपोर्ट करता है, वहीं vLLM को GPU एक्सेलेरेशन की ज़रूरत होती है, जिससे इसे चलाना थोड़ा महँगा पड़ता है (इस प्रोजेक्ट के लिए लगभग $5)। 4-बिट क्वांटाइज़्ड Magistral मॉडल को लगभग 14GB मेमोरी चाहिए, जिसे एक RTX 4090 GPU या यहाँ तक कि 32GB RAM वाले MacBook पर भी होस्ट किया जा सकता है। हालाँकि, सीमित कंप्यूट के कारण अनुमान धीमा हो सकता है—प्रति प्रतिक्रिया 4 मिनट तक।
इसके विपरीत, vLLM उच्च-प्रदर्शन GPUs जैसे A100 SXM पर डिप्लॉय होने पर काफी तेज़ अनुमान देता है (लगभग एक मिनट से कम प्रति प्रतिक्रिया), जिससे यह प्रतिक्रियाशील ऐप्स या स्केल्ड डिप्लॉयमेंट्स के लिए बेहतर विकल्प बनता है।
यदि आप सिर्फ प्रयोग कर रहे हैं और आपके पास लोकल संसाधन हैं, तो कम सेटअप लागत के कारण Ollama उपयुक्त है। लेकिन प्रोडक्शन-ग्रेड प्रदर्शन या बड़े वर्कलोड्स के लिए, vLLM अनुशंसित विकल्प है। ध्यान रखें कि vLLM लोकली चल सकता है, फिर भी इसे सक्षम GPU की आवश्यकता होती है।
इस ट्यूटोरियल में, हमने Magistral Small—Mistral का एक reasoning-first LLM—का उपयोग करके चरण-दर-चरण लॉजिक डीबगर बनाया। हमने मॉडल को लोकली डिप्लॉय किया: त्वरित ऑन-डिवाइस टेस्टिंग के लिए Ollama के माध्यम से और OpenAI-संगत APIs के साथ उच्च-थ्रूपुट GPU अनुमान के लिए vLLM के माध्यम से। हमने Gradio एप्लिकेशन के साथ मॉडल की रीजनिंग क्षमताओं का भी परीक्षण किया। चाहे आप त्रुटिपूर्ण तर्क को डीबग कर रहे हों या रीजनिंग AI टूल्स बना रहे हों, Magistral Small एक अच्छा समाधान हो सकता है।
इन कोर्सों के साथ AI सीखें!
कोर्स
कोर्स
कोर्स