
कोर्स
R में Bioconductor के साथ RNA-Seq
4 घंटा
21.6K
परिमाणात्मक वित्त में एक दशक लंबी यात्रा के दौरान, मैंने कई सांख्यिकीय वितरण देखे हैं, लेकिन बहुत कम ऐसे रहे हैं जिनका नाम आकर्षक होने के साथ-साथ व्यावहारिक मूल्य भी उतना ही हो — जैसे नेगेटिव बाइनोमियल डिस्ट्रीब्यूशन। ट्रेडिंग पैटर्न और जोखिम मॉडलों का विश्लेषण करते समय, मैंने पाया कि अपने कुछ हद तक निराशावादी नाम के बावजूद यह वितरण काउंटिंग प्रक्रियाओं पर ऐसी अंतर्दृष्टि देता है, जिन्हें कई सरल मॉडल समझ ही नहीं पाते।
नेगेटिव बाइनोमियल डिस्ट्रीब्यूशन ऐसे परिदृश्यों के लिए एक परिष्कृत ढांचा प्रदान करता है, जो पोइसों डिस्ट्रीब्यूशन जैसे सरल समकक्षों की तुलना में अधिक लचीला है। यह बाइनोमियल डिस्ट्रीब्यूशन का एक स्वाभाविक विस्तार है, जो उन स्थितियों में ढलता है जहाँ हमें एक निश्चित संख्या में सफलताएँ प्राप्त होने तक किए गए प्रयासों की संख्या को मॉडल करना होता है — न कि तय प्रयासों की संख्या में मिली सफलताओं की संख्या को।
इस व्यापक मार्गदर्शिका में, हम नेगेटिव बाइनोमियल डिस्ट्रीब्यूशन की गणितीय नींव, व्यावहारिक उपयोग और Python व R में उसके इम्प्लीमेंटेशन का अन्वेषण करेंगे। आधारभूत गुणों से शुरू कर उन्नत अनुप्रयोगों तक, हम इस शक्तिशाली सांख्यिकीय औज़ार की ठोस समझ विकसित करेंगे।
नेगेटिव बाइनोमियल डिस्ट्रीब्यूशन का उद्गम 18वीं शताब्दी में सट्टा खेलों में प्रायिकता के अध्ययन से हुआ। यह एक विविक्त प्रायिकता वितरण है जो स्वतंत्र बर्नौली ट्रायल्स की श्रृंखला में पूर्व-निर्धारित सफलताओं की संख्या प्राप्त करने से पहले होने वाली असफलताओं की संख्या को मॉडल करता है। प्रत्येक ट्रायल स्वतंत्र होना चाहिए और सफलता की प्रायिकता समान होनी चाहिए।
इसे सहज रूप से समझने के लिए एक सरल प्रयोग पर विचार करें: किसी पद के लिए तब तक उम्मीदवारों का इंटरव्यू लेना जब तक तीन योग्य उम्मीदवार न मिल जाएँ। यह वितरण उन असफल इंटरव्यू की संख्या को मॉडल करेगा जो इन तीन योग्य उम्मीदवारों (सफलताओं) को पाने से पहले लगेंगे। यह बाइनोमियल डिस्ट्रीब्यूशन से मूल रूप से भिन्न है, जो तय प्रयासों की संख्या में सफलताओं की संख्या को मॉडल करता है — जैसे ठीक 20 इंटरव्यू में मिले योग्य उम्मीदवारों की संख्या।
तो आप देख सकते हैं, हालांकि "नेगेटिव बाइनोमियल" नाम सुनकर भौंहें तन सकती हैं, इसका पारंपरिक अर्थों में किसी नकारात्मक बात से संबंध नहीं है। "नेगेटिव" पहलू इसका ऐतिहासिक व्युत्पत्ति से आता है, जिसमें निगेटिव घातों का समावेश है।
नेगेटिव बाइनोमियल डिस्ट्रीब्यूशन का उपयोग कई तरीकों से होता है। वित्त में — जहाँ मैंने इसका सबसे अधिक उपयोग किया — यह ऐसे परिदृश्यों को मॉडल करता है, जैसे लक्ष्य लाभ स्तर हासिल करने तक लगने वाले ट्रेडिंग दिनों की संख्या, या एक निश्चित संख्या में योग्य उधारकर्ताओं को पाने से पहले जाँची गई क्रेडिट आवेदनों की संख्या।
सामान्यतः, काउंट डेटा को मॉडल करते समय, जब वैरिएंस औसत से अधिक होता है — जिसे ओवरडिस्पर्शन कहते हैं — तब यह वितरण अत्यंत उपयोगी साबित होता है। जहाँ पोइसों डिस्ट्रीब्यूशन औसत और वैरिएंस को बराबर मानता है, वास्तविक दुनिया के काउंट डेटा में प्रायः अधिक परिवर्तनशीलता दिखती है। उदाहरण के लिए, महामारी विज्ञान में बीमारी के मामलों की संख्या अक्सर पोइसों मॉडल की भविष्यवाणी से अधिक भिन्नता दिखाती है, जिससे रोग प्रसार के मॉडलिंग के लिए नेगेटिव बाइनोमियल अधिक उपयुक्त हो जाता है।
जेनेटिसिस्ट इस वितरण पर सीक्वेंसिंग डेटा का विश्लेषण करते समय भरोसा करते हैं। RNA सीक्वेंसिंग प्रयोगों में जीन अभिव्यक्ति स्तरों में उच्च परिवर्तनशीलता होती है। नेगेटिव बाइनोमियल प्रत्येक जीन से मैप किए गए सीक्वेंस रीड्स की संख्या को मॉडल करता है, तकनीकी और जैविक दोनों तरह की विविधता का हिसाब रखते हुए। इससे स्थिर वैरिएंस मान लेने वाली विधियों की तुलना में भिन्न रूप से अभिव्यक्त जीनों की पहचान अधिक सटीक होती है।
पारिस्थितिकी अध्ययन में, शोधकर्ता इसे प्रजातियों की प्रचुरता को मॉडल करने के लिए उपयोग करते हैं। मान लें पक्षी आबादी का अध्ययन करना है: कुछ क्षेत्रों में बहुत कम पक्षी होंगे जबकि अन्य में बड़े समूह, जिससे अपेक्षा से अधिक वैरिएंस बनता है। नेगेटिव बाइनोमियल ऐसे क्लस्टर्ड वितरणों को प्रभावी ढंग से मॉडल करता है, जिससे पारिस्थितिकीविद जनसंख्या गतिकी समझते हैं और संरक्षण प्रयासों की योजना बनाते हैं।
नेगेटिव बाइनोमियल डिस्ट्रीब्यूशन की आकृति और व्यवहार दो प्रमुख पैरामीटरों से निर्धारित होते हैं। इन पैरामीटरों और गणितीय अभिव्यक्ति को समझने से हमें पता चलता है कि यह वितरण वास्तविक दुनिया की घटनाओं को कैसे मॉडल करता है। आइए इन विशेषताओं को क्रमबद्ध तरीके से जानें।
नेगेटिव बाइनोमियल डिस्ट्रीब्यूशन के दो बुनियादी पैरामीटर होते हैं:
ये पैरामीटर वितरण के व्यवहार को आकार देते हैं। मान लें पाँच नए क्लाइंट (r = 5) पाने के लिए आवश्यक सेल्स कॉल्स की संख्या ट्रैक कर रहे हैं, जब प्रत्येक कॉल में सफलता की संभावना 20% (p = 0.2) है। r हमारा स्टॉपिंग पॉइंट तय करता है, जबकि p यह प्रभावित करता है कि हमें औसतन कितनी देर तक कॉल करते रहना पड़ सकता है।
जब हम p को स्थिर रखते हुए r बढ़ाते हैं, तो वितरण दाएँ खिसकता है और अधिक फैला हुआ हो जाता है, जो दर्शाता है कि अधिक सफलताएँ पाने के लिए अधिक ट्रायल्स चाहिए। इसके विपरीत, r को स्थिर रखते हुए p बढ़ाने पर, वितरण बाएँ खिसकता है और अधिक सघन हो जाता है, यानी सफलता अधिक संभावित होने पर सामान्यतः कम ट्रायल्स लगते हैं।
प्रायिकता द्रव्यमान फलन हमें यह प्रायिकता देता है कि r सफलताओं को पाने से पहले ठीक k असफलताएँ आवश्यक हों। नेगेटिव बाइनोमियल डिस्ट्रीब्यूशन के लिए PMF है:
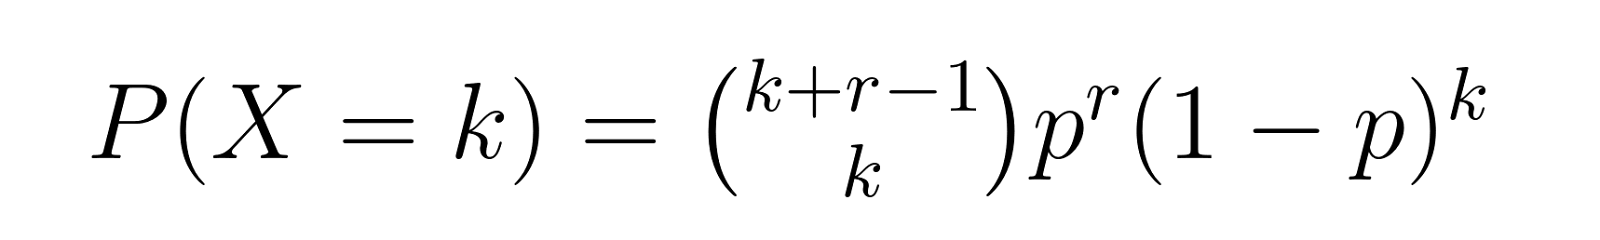
जहाँ:
उदाहरण: क्वालिटी कंट्रोल में, यदि हमें 3 डिफेक्टिव यूनिट्स चाहिए (r = 3) और प्रत्येक यूनिट के डिफेक्टिव होने की संभावना 10% है (p = 0.1), तो हम विशिष्ट प्रायिकताएँ निकाल सकते हैं। जैसे, तीसरा डिफेक्टिव मिलने से पहले ठीक 5 नॉन-डिफेक्टिव यूनिट्स (k = 5) मिलने की प्रायिकता:
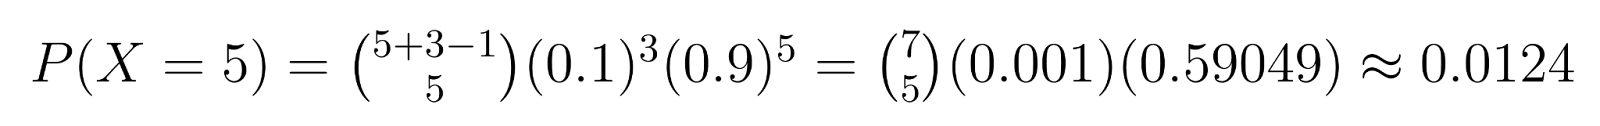
यह गणना दर्शाती है कि तीसरा डिफेक्टिव मिलने से पहले ठीक 5 नॉन-डिफेक्टिव यूनिट्स की आवश्यकता होने की संभावना लगभग 1.24% है।
संचयी वितरण फलन (CDF) PMF पर आधारित है, जो यह प्रायिकता देता है कि लक्ष्य सफलताओं की संख्या पाने से पहले k या उससे कम असफलताएँ आवश्यक हों:
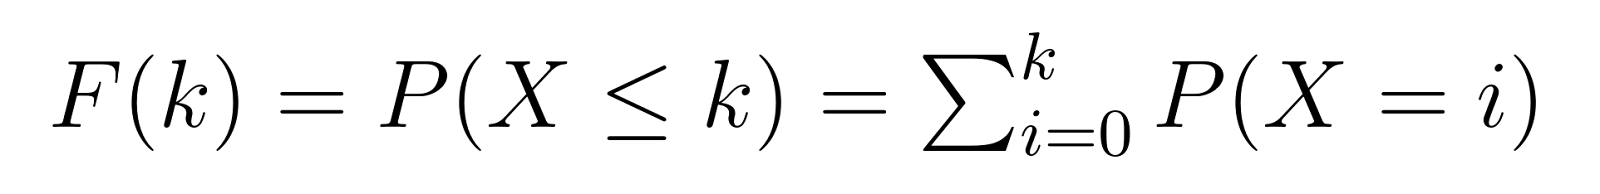
अर्थात F(k) हमें यह प्रायिकता देता है कि तीसरा डिफेक्टिव मिलने से पहले अधिकतम k नॉन-डिफेक्टिव यूनिट्स ही लगें। उदाहरण के लिए, F(5) 5 या उससे कम नॉन-डिफेक्टिव यूनिट्स की आवश्यकता होने की प्रायिकता देगा।
नेगेटिव बाइनोमियल डिस्ट्रीब्यूशन का मीन (अपेक्षित मान) और वैरिएंस ऐसी सुंदर समीकरणों से व्यक्त होता है जो मीन (μ) और वैरिएंस (σ²) के बारे में महत्वपूर्ण गुणों को उजागर करते हैं।
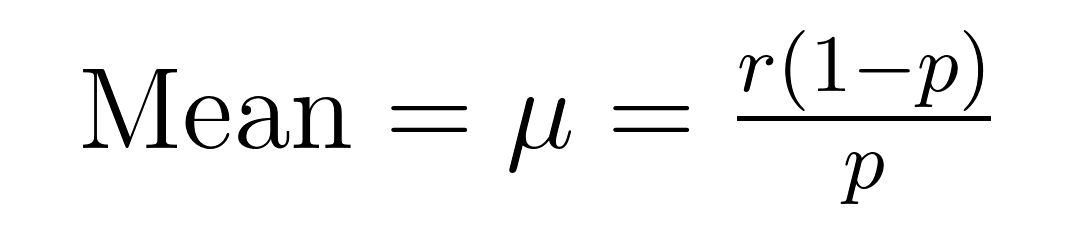
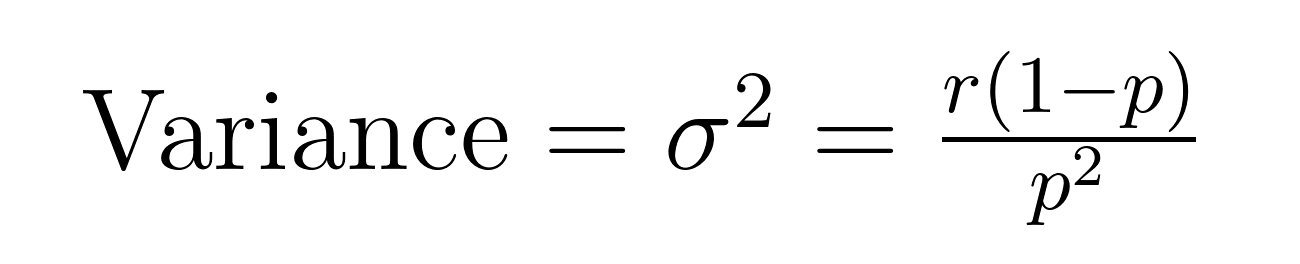
ये सूत्र बताते हैं कि यह वितरण ओवरडिस्पर्स्ड डेटा के मॉडलिंग में क्यों उत्कृष्ट है। ध्यान दें कि वैरिएंस हमेशा मीन से 1/p के गुणक से बड़ा होता है। यह अंतर्निहित गुण इसे स्वाभाविक रूप से उन डेटासेट्स के लिए उपयुक्त बनाता है जहाँ परिवर्तनशीलता औसत से अधिक होती है।
उदाहरण के लिए, यदि हम कस्टमर सर्विस कॉल्स को मॉडल कर रहे हैं जहाँ हम 5 केस (r = 5) सुलझाने की उम्मीद करते हैं और प्रत्येक प्रयास में सफलता की दर 20% है (p = 0.2), तो विफल प्रयासों की अपेक्षित संख्या होगी:
यह अधिक वैरिएंस उस वास्तविकता का हिसाब रखता है कि कुछ केस जल्दी सुलझ जाते हैं जबकि अन्य में कहीं अधिक प्रयास लग सकते हैं — जो वास्तविक दुनिया में अक्सर देखा जाता है।
इन विशेषताओं को समझना हमें यह पहचानने में मदद करता है कि नेगेटिव बाइनोमियल डिस्ट्रीब्यूशन कब लागू करना है और उसके परिणामों की प्रभावी व्याख्या कैसे करनी है। ये गणितीय नींव हमें व्यावहारिक अनुप्रयोगों और इम्प्लीमेंटेशन की ओर ले जाती हैं, जिन्हें हम आगामी अनुभागों में देखेंगे।
आइए अपने पहले के उदाहरण का सत्यापन करें: तीसरा डिफेक्टिव मिलने से पहले ठीक 5 नॉन-डिफेक्टिव यूनिट्स मिलने की प्रायिकता निकालना (r=3, p=0.1)।
import scipy.stats as stats
import math

def calculate_nb_pmf(k, r, p):
    # Calculate binomial coefficient (k+r-1 choose k)
    binom_coef = math.comb(k + r - 1, k)
    # Calculate p^r * (1-p)^k
    prob = (p ** r) * ((1 - p) ** k)
    return binom_coef * prob

# Our example parameters
k = 5  # failures (non-defective units)
r = 3  # successes (defective units)
p = 0.1  # probability of success (defective)

# Calculate using our function
prob_manual = calculate_nb_pmf(k, r, p)
print(f"Manual calculation: {prob_manual:.4f}")

# Verify using scipy
prob_scipy = stats.nbinom.pmf(k, r, p)
print(f"SciPy calculation: {prob_scipy:.4f}")
उपरोक्त कोड स्निपेट का आउटपुट नीचे जैसा होना चाहिए:
Manual calculation: 0.0124
SciPy calculation: 0.0124# Calculate probability mass function
k <- 5 # failures (non-defective units)
r <- 3 # successes (defective units)
p <- 0.1 # probability of success (defective)
# Using dnbinom
prob_r <- dnbinom(k, size = r, prob = p)
print(sprintf("R calculation: %.4f", prob_r))
# Manual calculation for verification
manual_calc <- choose(k + r - 1, k) * p^r * (1-p)^k
print(sprintf("Manual calculation: %.4f", manual_calc))उपरोक्त कोड स्निपेट का आउटपुट हमारे Python उदाहरण जैसा ही होना चाहिए:
R calculation: 0.0124
Manual Calculation: 0.0124
दोनों इम्प्लीमेंटेशन हमारी पहले निकाली गई लगभग 0.0124 या 1.24% प्रायिकता की पुष्टि करते हैं।
यह समझना कि नेगेटिव बाइनोमियल डिस्ट्रीब्यूशन का अन्य प्रायिकता वितरणों से क्या संबंध है, प्रत्येक के उपयोग का समय स्पष्ट करता है। इसका सांख्यिकी के कई महत्वपूर्ण वितरणों से विशेष संबंध है।
बाइनोमियल डिस्ट्रीब्यूशन एक बुनियादी प्रारंभिक बिंदु है। जहाँ बाइनोमियल तय ट्रायल्स की संख्या में सफलताओं की गिनती करता है, वहीं नेगेटिव बाइनोमियल इस विचार को उलटकर तय सफलताओं की संख्या पाने तक आवश्यक ट्रायल्स की गिनती करता है। ये परस्पर पूरक हैं — यदि आपको ठीक 3 सफलताएँ चाहिएँ और यह जानना है कि ठीक 8 ट्रायल्स में इसकी प्रायिकता क्या है, तो बाइनोमियल डिस्ट्रीब्यूशन का उपयोग करें। यदि आप जानना चाहते हैं कि 3 सफलताएँ पाने के लिए ठीक 8 ट्रायल्स लगने की प्रायिकता क्या है, तो नेगेटिव बाइनोमियल का उपयोग करें।
काउंट डेटा को मॉडल करते समय पोइसों डिस्ट्रीब्यूशन की अक्सर नेगेटिव बाइनोमियल से तुलना होती है। दोनों विविक्त घटनाओं को संभालते हैं, लेकिन इनके वैरिएंस संबंधी मान्यताएँ अलग हैं। पोइसों डिस्ट्रीब्यूशन की परिभाषित विशेषता है कि उसका मीन उसके वैरिएंस के बराबर होता है। जबकि वास्तविक काउंट डेटा में अक्सर ओवरडिस्पर्शन दिखता है, जहाँ वैरिएंस मीन से अधिक होता है। नेगेटिव बाइनोमियल यह अतिरिक्त परिवर्तनशीलता स्वाभाविक रूप से समाहित करता है, जिससे यह निम्न जैसी घटनाओं के लिए अधिक उपयुक्त हो जाता है:
जब हम r=1 रखते हैं, तो ज्योमेट्रिक डिस्ट्रीब्यूशन नेगेटिव बाइनोमियल का एक विशेष मामला बनकर उभरता है — यानी हम सिर्फ पहली सफलता की प्रतीक्षा कर रहे हैं। यह निम्न जैसे परिदृश्यों के लिए उपयुक्त है:
अंततः, नेगेटिव बाइनोमियल को गामा-पोइसों मिश्रण के रूप में व्युत्पन्न किया जा सकता है, जो ओवरडिस्पर्शन संभालने की इसकी क्षमता के लिए सैद्धांतिक आधार प्रदान करता है। यह संबंध बताता है कि हायरार्किकल मॉडलों में, जहाँ घटनाओं की दरें गामा डिस्ट्रीब्यूशन के अनुसार भिन्न होती हैं, नेगेटिव बाइनोमियल क्यों अच्छी तरह काम करता है।
नेगेटिव बाइनोमियल डिस्ट्रीब्यूशन ऐसे विशिष्ट लाभ प्रदान करता है जो इसे वास्तविक दुनिया की घटनाओं के मॉडलिंग के लिए मूल्यवान बनाते हैं, साथ ही ऐसी सीमाएँ भी हैं जिन पर डेटा वैज्ञानिकों को ध्यान देना चाहिए।
नेगेटिव बाइनोमियल रिग्रेशन काउंट डेटा के लिए पारंपरिक रिग्रेशन का विस्तार है, विशेषकर तब जब डेटा ओवरडिस्पर्शन दर्शाता है। जहाँ पोइसों रिग्रेशन मीन और वैरिएंस को समान मानता है, नेगेटिव बाइनोमियल रिग्रेशन इस बाधा को ढीला करता है, जिससे यह वास्तविक दुनिया के उपयोग के लिए अधिक उपयुक्त बनता है।
एक कॉल सेंटर परिदृश्य पर विचार करें: हम प्रति घंटे कस्टमर सर्विस कॉल्स की संख्या का पूर्वानुमान लगाना चाहते हैं। हमारे प्रेडिक्टर्स में शामिल हो सकते हैं:
मानक पोइसों रिग्रेशन कॉल वॉल्यूम में परिवर्तनशीलता को, खासकर पीक घंटे या विशेष आयोजनों के दौरान, कम करके आँक सकता है। नेगेटिव बाइनोमियल रिग्रेशन इस अतिरिक्त परिवर्तनशीलता को समाहित करता है, और अधिक यथार्थपरक पूर्वानुमान और कॉन्फिडेंस इंटरवल प्रदान करता है।
जटिल काउंट डेटा को मॉडल करने और ओवरडिस्पर्शन को संभालने की क्षमता के कारण, नेगेटिव बाइनोमियल डिस्ट्रीब्यूशन वास्तविक दुनिया की घटनाओं को समझने और भविष्यवाणी करने के लिए एक आवश्यक औज़ार बना रहता है। जैसा कि आपने देखा, यह ओवरडिस्पर्स्ड डेटा के मॉडलिंग में उत्कृष्ट है, यह विभिन्न परिदृश्यों को मॉडल करने में लचीलापन देता है, और स्वाभाविक रूप से रिग्रेशन विश्लेषण तक विस्तृत होता है।
यदि आप प्रायिकता वितरणों और उनके अनुप्रयोगों की अपनी समझ को गहरा करना चाहते हैं, तो हमारे Probability and Statistics पाठ्यक्रम इन विषयों का व्यापक कवरेज प्रदान करते हैं। हमारे पाठ्यक्रमों में वास्तविक दुनिया के डेटासेट्स के साथ हाथों-हाथ अभ्यास शामिल हैं, जो आपको सैद्धांतिक अवधारणाओं और Python व R में व्यावहारिक इम्प्लीमेंटेशन — दोनों में दक्ष बनाते हैं। साथ ही, हमारे Machine Learning Scientist in Python कैरियर ट्रैक पर भी विचार करें। यकीन मानिए, आप बहुत कुछ सीखेंगे।
DataCamp के साथ सीखें
कोर्स
कोर्स
कोर्स