
कोर्स
OpenAI API के साथ मल्टी-मॉडल सिस्टम
2 घंटा
3.5K
Qwen-Image-2512 एक शक्तिशाली ओपन-सोर्स टेक्स्ट-टू-इमेज मॉडल है, जो विशेष रूप से यथार्थपरक दृश्य और टेक्स्ट-प्रधान कंपोज़िशन में अच्छा है। इस ट्यूटोरियल में, हम इससे एक पोस्टर स्टूडियो बनाएंगे—एक Gradio ऐप—जहां आप प्रोडक्ट का नाम, ऑफर, कीमत, CTA और लाभ जैसे विवरण दर्ज करें, प्लेटफ़ॉर्म का एस्पेक्ट रेशियो चुनें, और एक क्लिक में प्रोमो इमेज जनरेट करें।
क्योंकि Qwen-Image-2512 एक बड़ा मॉडल है, हम इसे सुचारु रूप से चलाने के व्यावहारिक पक्ष पर भी ध्यान देंगे। आप सीखेंगे कि A100 पर सही प्रिसिशन सेटिंग्स के साथ इसे स्थिरता से कैसे लोड करें, सामान्य फेल्योर मोड्स से बचें, और किसी भी वर्कफ़्लो के अनुसार छोटे रेज़ोल्यूशन पर इटरेट करके, स्टेप्स घटाकर, या सख्त हार्डवेयर के लिए क्वांटाइज़्ड मॉडल आज़माकर कैसे ढालें।
Qwen-Image-2512, Qwen टेक्स्ट-टू-इमेज फाउंडेशन मॉडल का एक अपडेट है, जो पहले के Qwen-Image रिलीज़ पर गुणवत्ता में छलांग लाता है। अंदरूनी तौर पर, Qwen-Image एक 20B MMDiT डिफ्यूज़न मॉडल है, जिसे सशक्त प्रॉम्प्ट अनुपालन और इमेज-में-टेक्स्ट रेंडरिंग के लिए डिज़ाइन किया गया है।
इसे AI Arena पर 10,000+ ब्लाइंड राउंड्स वाली बड़े पैमाने की प्रेफरेंस-स्टाइल इवैल्यूएशन का समर्थन भी है, जहां मॉडल खुले स्रोत में सबसे मजबूत के रूप में उभरा, जबकि क्लोज़्ड सिस्टम्स के मुकाबले प्रतिस्पर्धी बना रहा।
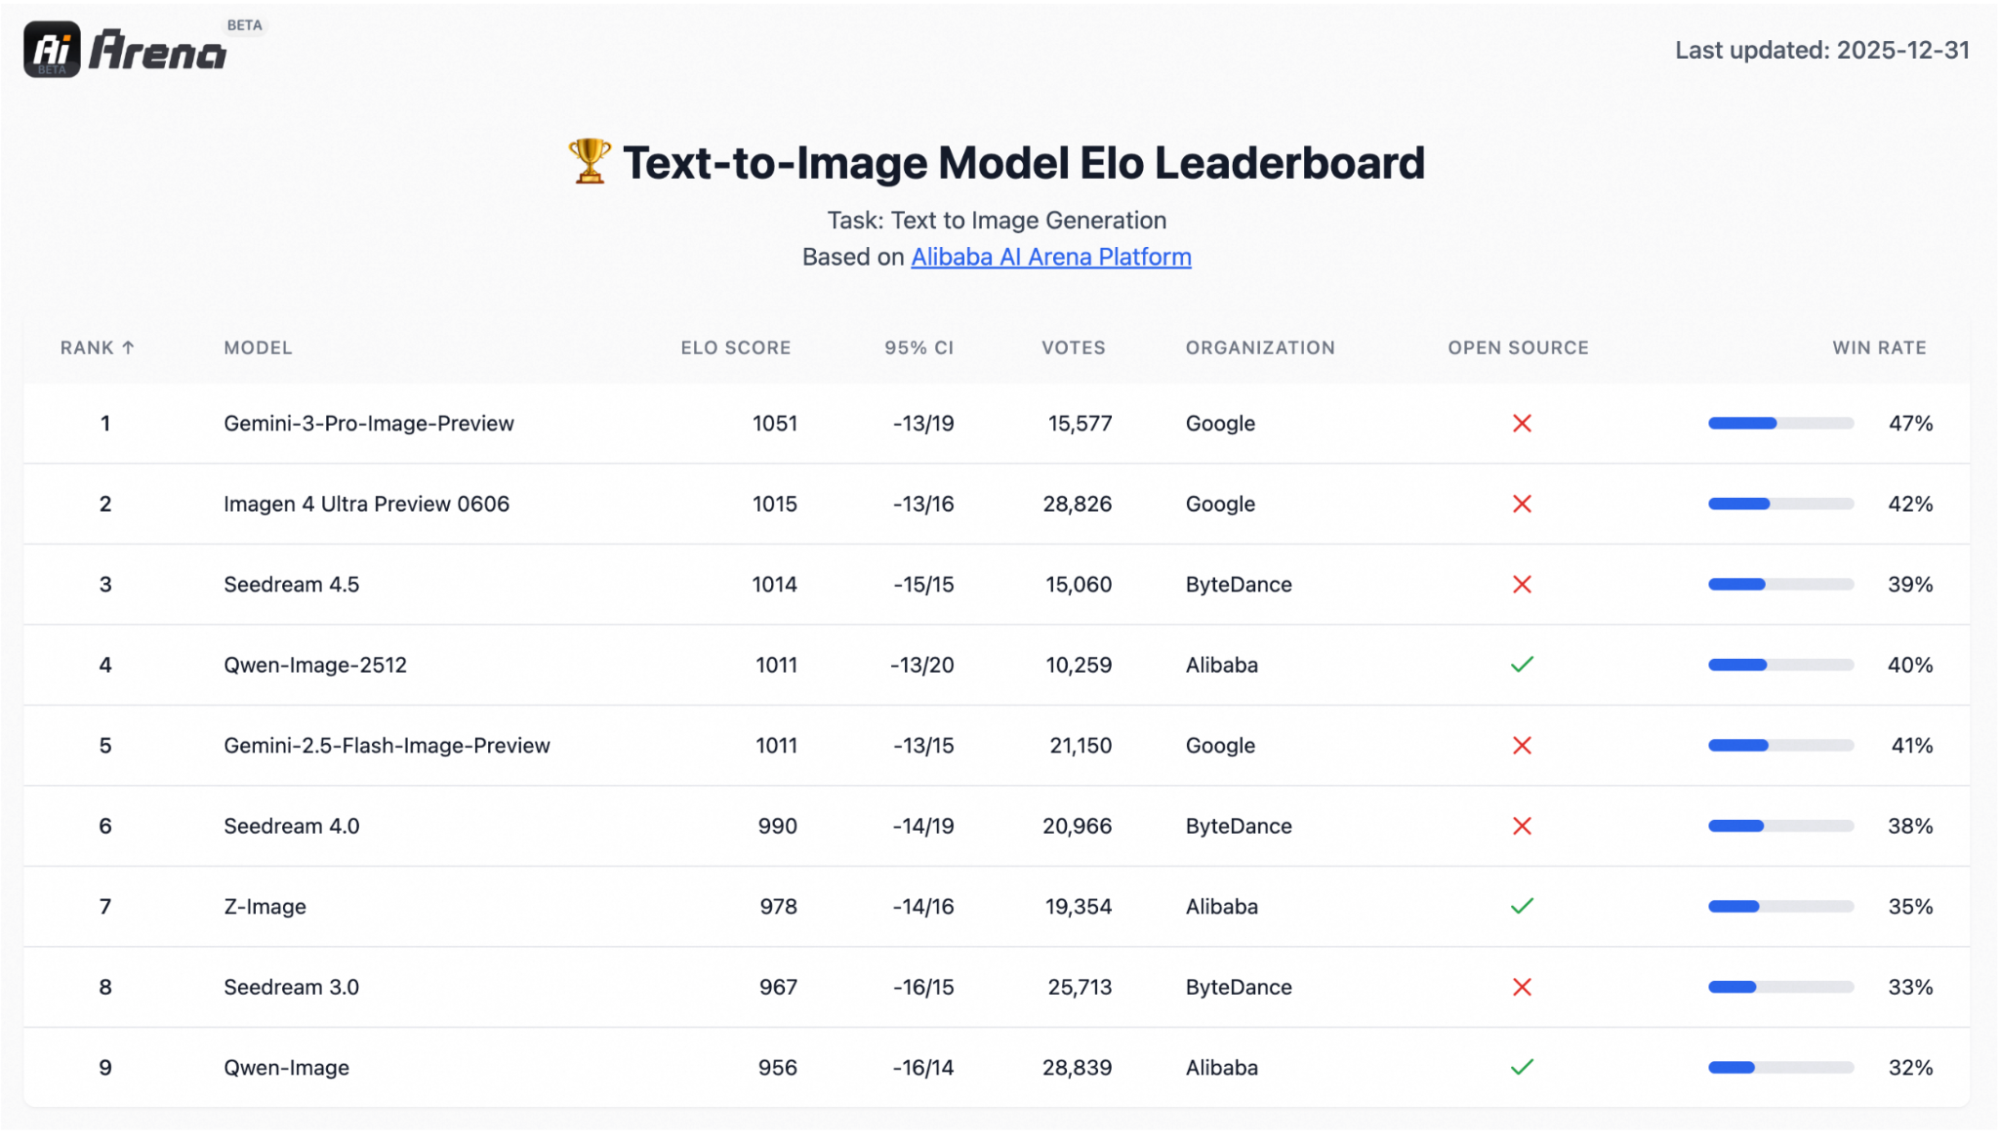
वास्तविक वर्कफ़्लोज़ में सबसे ज्यादा मायने रखने वाले तीन अपग्रेड ये हैं:
इस सेक्शन में, हम एक साधारण Gradio ऐप बनाएंगे जो:
steps, true_cfg_scale, seed, और वैकल्पिक negative prompt के लिए एक पैनल प्रदान करता हैQwenImagePipeline का उपयोग करके एक पोस्टर इमेज जनरेट करता है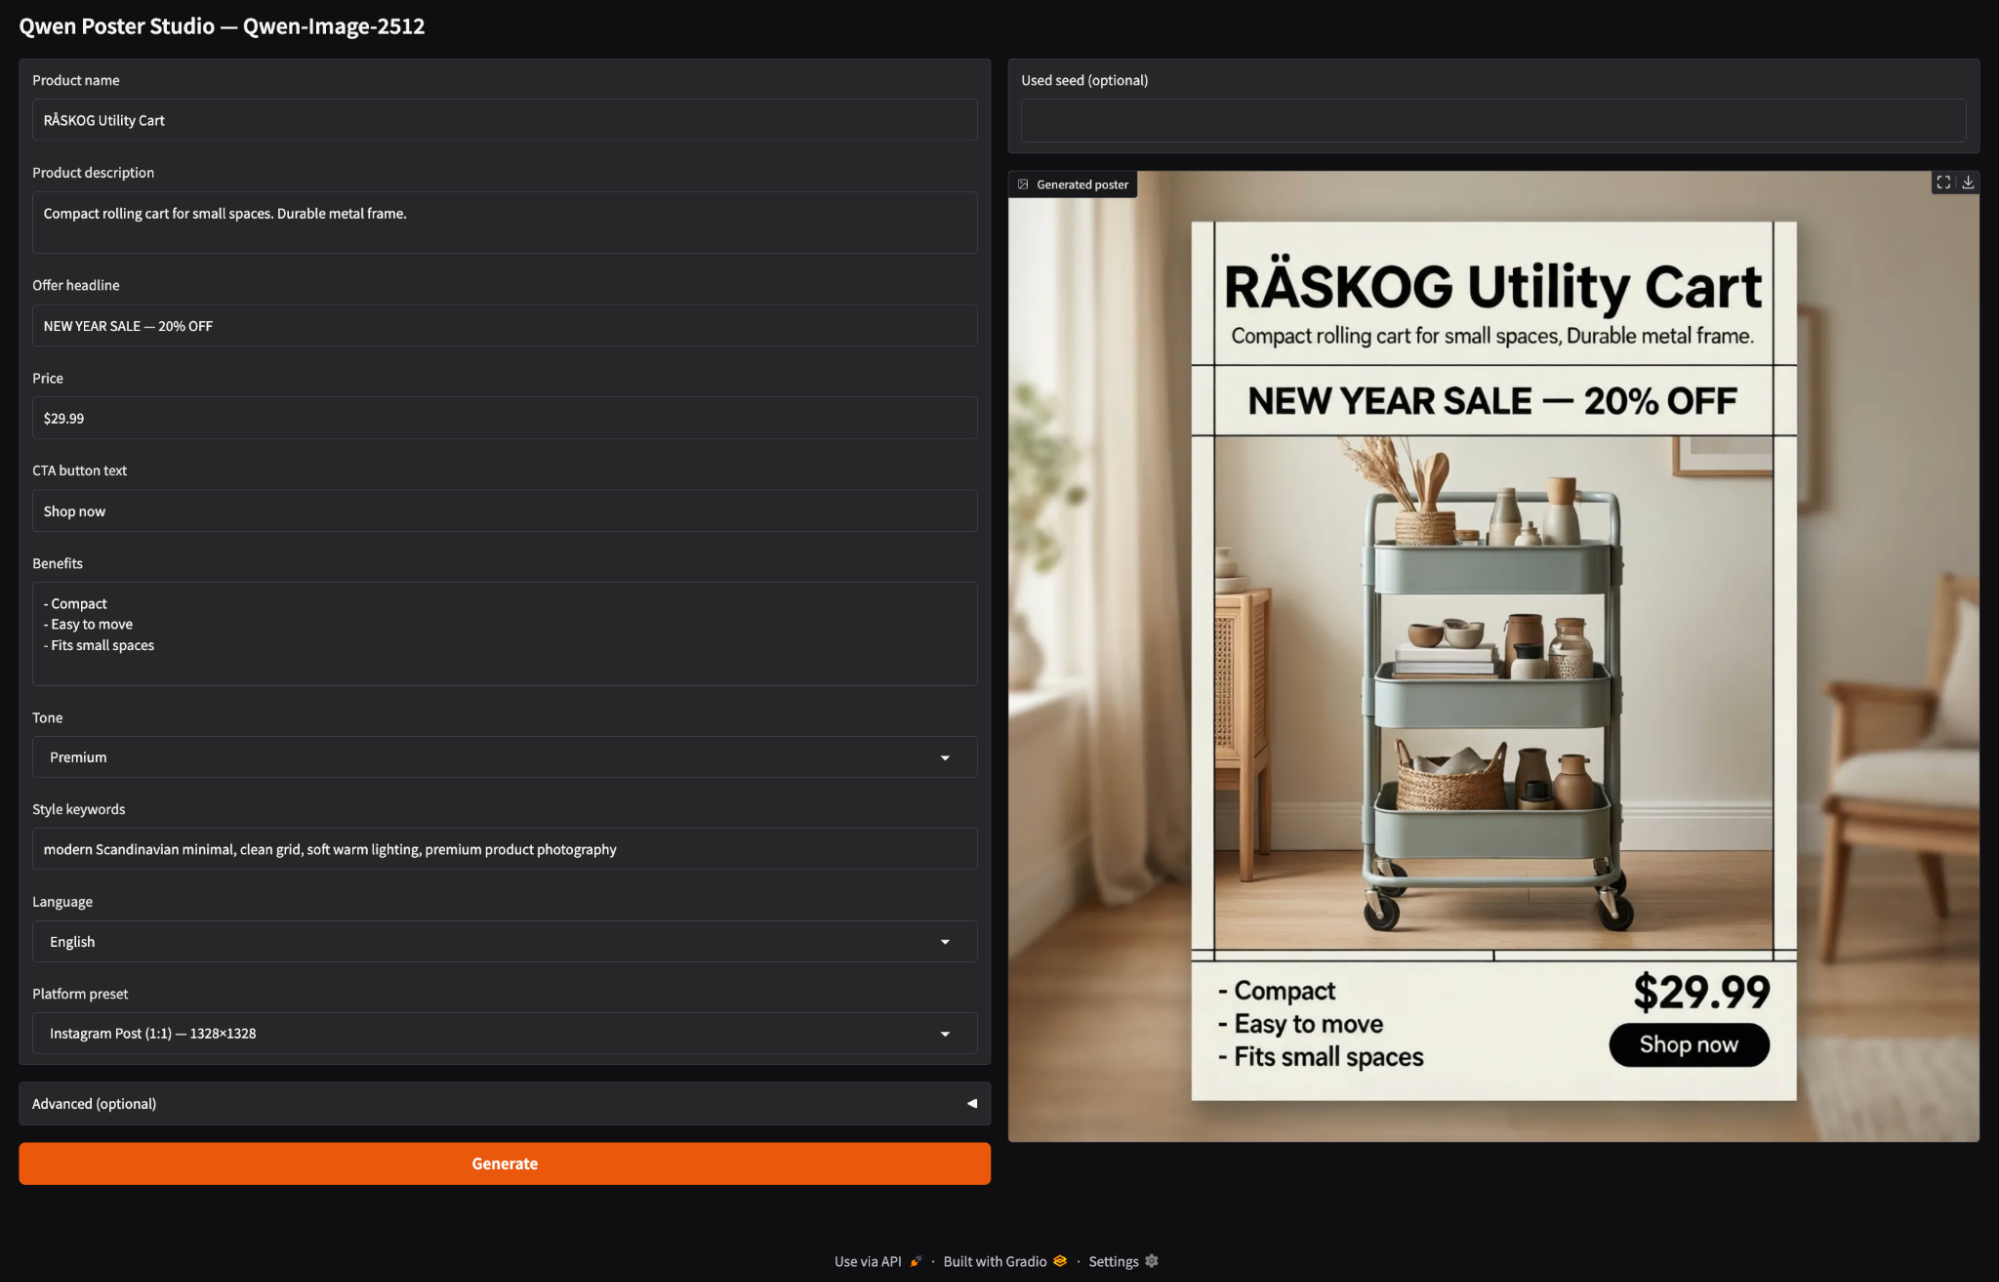
इसे चरण-दर-चरण बनाते हैं।
सबसे पहले, GitHub से नवीनतम Diffusers इंस्टॉल करें (Qwen का मॉडल कार्ड पाइपलाइन सपोर्ट के लिए यही सुझाता है) और कोर डिपेंडेंसियाँ भी:
!pip -q install --upgrade pip
!pip -q install git+https://github.com/huggingface/diffusers
!pip -q install transformers accelerate safetensors gradio pillow psutil
अगला, एक त्वरित sanity चेक करें कि CUDA उपलब्ध है और GPU की पहचान करें:
import torch, diffusers
print("diffusers:", diffusers.__version__)
print("CUDA available:", torch.cuda.is_available())
!nvidia-smi
यदि CUDA available: True आता है और आप nvidia-smi में अपना GPU देखते हैं, तो आप मॉडल लोड करने के लिए तैयार हैं।
नोट: QwenImagePipeline एक एकल UNet-स्टाइल ब्लॉक नहीं है। Diffusers में, यह एक पूरा स्टैक है जिसमें Qwen2.5-VL-7B-Instruct टेक्स्ट एन्कोडर, MMDiT डिफ्यूज़न ट्रांसफॉर्मर, और डिकोडिंग के लिए एक Variational Auto-Encoder (VAE) शामिल है। 7B टेक्स्ट एन्कोडर एक बड़ा कारण है कि मॉडल लोड और जनरेशन के दौरान RAM/VRAM बढ़ सकता है, खासकर छोटे GPUs पर।
मैंने यह ट्यूटोरियल Google Colab पर A100 के साथ चलाया, जो ~50 स्टेप्स पर 1328×1328 इमेज रेज़ोल्यूशन को आराम से संभालता है। T4/16GB-क्लास GPUs पर, आपको आमतौर पर स्केल डाउन करना होगा (लगभग 768×768 रेज़ोल्यूशन और कम स्टेप्स) या वैकल्पिक रनटाइम्स (जैसे GGUF/ComfyUI) के माध्यम से क्वांटाइज़्ड वेरिएंट्स का उपयोग करना होगा।
मॉडल लोड करने से पहले, एक छोटा रनटाइम हार्नेस सेट करना उपयोगी है जो Colab को अनुमानित रखता है। Qwen-Image-2512 भारी है, और इमेज जनरेशन वर्कलोड चुपचाप सिस्टम RAM और GPU मेमोरी दोनों खा सकता है।
import os, gc, random, psutil, torch
from diffusers import QwenImagePipeline
import gradio as gr
os.environ["HF_HOME"] = "/content/hf"
os.makedirs("/content/hf", exist_ok=True)
def mem(tag=""):
    ram = psutil.virtual_memory().used / 1e9
    v_alloc = torch.cuda.memory_allocated()/1e9 if torch.cuda.is_available() else 0
    v_res   = torch.cuda.memory_reserved()/1e9 if torch.cuda.is_available() else 0
    print(f"[{tag}] RAM={ram:.1f}GB | VRAM alloc={v_alloc:.1f}GB reserved={v_res:.1f}GB")
def cleanup(tag="cleanup"):
    gc.collect()
    if torch.cuda.is_available():
        torch.cuda.empty_cache()
    mem(tag)
assert torch.cuda.is_available(), "GPU runtime required"
print("GPU:", torch.cuda.get_device_name(0))
torch.backends.cuda.matmul.allow_tf32 = True
torch.set_float32_matmul_precision("high")
cleanup("startup")
एक बार डिपेंडेंसियाँ इंस्टॉल होने के बाद, हम इम्पोर्ट्स, कैशिंग, मेमोरी मॉनिटरिंग, और कुछ GPU परफॉर्मेंस फ्लैग्स सेट करते हैं। कोड में यह इस तरह दिखता है:
QwenImagePipeline: यह मुख्य पाइपलाइन क्लास है जिसका उपयोग हम बाद में Qwen-Image-2512 को लोड और रन करने के लिए करेंगे।gradio: यह लाइब्रेरी साधारण वेब UI को पावर देती है ताकि हम Colab के अंदर पोस्टर जनरेट कर सकें।HF_HOME=/content/hf: इसका उपयोग हम Hugging Face कैश को एक ज्ञात फ़ोल्डर पर पिन करने के लिए करते हैं, ताकि मॉडल डाउनलोड और वेट्स रन के बीच लगातार स्टोर हों।mem() फ़ंक्शन: mem() फ़ंक्शन सिस्टम RAM और GPU VRAM (allocated बनाम reserved) पर नज़र रखता है। cleanup() फ़ंक्शन: यह एक छोटा रीसेट यूटिलिटी है जो Python रेफ़रेंसेज़ साफ करता है और कैश्ड GPU मेमोरी रिलीज़ करता है, जो रेज़ोल्यूशन/स्टेप्स पर इटरेट करते समय काम आता है।यह सेटअप अभी इमेजेज़ जनरेट नहीं करता, लेकिन अगले चरण (लोडिंग और इन्फेरेंस) को अधिक स्थिर और डीबग्गेबल बना देता है।
अब जब रनटाइम सेट हो गया है, तो मॉडल को Diffusers पाइपलाइन में लोड करने का समय है। A100 पर, मीठा स्थान यह है कि ज़्यादातर वेट्स को परफॉर्मेंस के लिए BF16 में चलाएं, लेकिन VAE डिकोडिंग को FP32 में रखें ताकि वे NaNs से बचें जो पूरी तरह काली इमेज के रूप में दिख सकते हैं।
DTYPE = torch.bfloat16
pipe = QwenImagePipeline.from_pretrained(
    "Qwen/Qwen-Image-2512",
    torch_dtype=DTYPE,
    low_cpu_mem_usage=True,
    use_safetensors=True,
).to("cuda")
if hasattr(pipe, "vae") and pipe.vae is not None:
    pipe.vae.to(dtype=torch.float32)
cleanup("after pipe load")
ऊपर दिए गए कोड में हम ये हासिल करना चाहते हैं:
torch_dtype=DTYPE: ज़्यादातर वेट्स को BF16 में लोड करता है ताकि VRAM कम हो और इन्फेरेंस तेज़ हो।low_cpu_mem_usage=True: लोड के दौरान CPU-साइड डुप्लीकेशन घटाता है (बड़े चेकपॉइंट्स के लिए महत्वपूर्ण)।use_safetensors=True: उपलब्ध होने पर सुरक्षित/तेज़ safetensors फॉर्मेट का उपयोग सुनिश्चित करता है।pipe.vae.to(torch.float32) लेटेंट स्पेस आउटपुट को पिक्सल्स में बदलता है। यदि वह डिकोड स्टेप लोअर प्रिसिशन में NaNs/Infs से टकराता है, तो फाइनल इमेज पूरी काली हो सकती है। इसलिए, हम VAE को FP32 पर फोर्स करते हैं और उसके बाद cleanup() कॉल से पोस्ट-लोड RAM/VRAM फुटप्रिंट की पुष्टि करते हैं।अब हम प्लेटफ़ॉर्म एस्पेक्ट रेशियो प्रीसेट्स परिभाषित करेंगे और पाइपलाइन को एक मिनिमल Gradio UI में वायर करेंगे ताकि इंटरैक्टिव पोस्टर जनरेशन हो सके।
अब हम डेमो का इंजन बनाते हैं, यानी एक छोटी लेयर जो UI इनपुट्स को एक सुव्यवस्थित प्रॉम्प्ट में बदलती है, प्लेटफ़ॉर्म प्रीसेट्स के आधार पर आउटपुट रेज़ोल्यूशन चुनती है, और इमेज जनरेट करने के लिए Qwen Image पाइपलाइन को कॉल करती है।
ASPECT_PRESETS = {
    "Instagram Post (1:1) — 1328×1328": (1328, 1328),
    "Instagram Story (9:16) — 928×1664": (928, 1664),
    "YouTube / Banner (16:9) — 1664×928": (1664, 928),
    "Poster (3:4) — 1104×1472": (1104, 1472),
    "Slides (4:3) — 1472×1104": (1472, 1104),
    "Fast Draft (1:1) — 768×768": (768, 768),
}
DEFAULT_NEG = " "
def build_prompt(product_name, product_desc, offer, price, cta, benefits, tone, style_keywords, language):
    return f"""
Create a high-converting e-commerce promotional poster in {language}. Clean grid layout, strong hierarchy.
- Product name: "{product_name}"
- Product description: "{product_desc}"
- Offer headline (exact): "{offer}"
- Price (exact): "{price}"
- CTA button text (exact): "{cta}"
- Benefits (use these exact phrases, no typos):
{benefits}
- Tone: {tone}
- Style keywords: {style_keywords}
- Text must be legible and correctly spelled.
- Do not add extra words, fake prices, or random letters.
- Align typography to a neat grid with consistent margins.
""".strip()
@torch.inference_mode()
def generate_image(product_name, product_desc, offer, price, cta, benefits, tone, style_keywords,
                   language, preset, negative_prompt, steps, true_cfg_scale, seed, show_seed):
    w, h = ASPECT_PRESETS[preset]
    prompt = build_prompt(product_name, product_desc, offer, price, cta, benefits, tone, style_keywords, language)
    if seed is None or int(seed) < 0:
        seed = random.randint(0, 2**31 - 1)
    seed = int(seed)
    gen = torch.Generator(device="cuda").manual_seed(seed)
    img = pipe(
        prompt=prompt,
        negative_prompt=negative_prompt,
        width=int(w),
        height=int(h),
        num_inference_steps=int(steps),
        true_cfg_scale=float(true_cfg_scale),
        generator=gen,
    ).images[0].convert("RGB")
    return (seed if show_seed else None), img
ऊपर दिया गया प्रीसेट मैप और दोनों फ़ंक्शन हमारे पोस्टर स्टूडियो का कोर इंजन बनाते हैं।
ASPECT_PRESETS डिक्शनरी अलग-अलग प्लेटफ़ॉर्म कैनवास साइज परिभाषित करती है (जैसे Instagram पोस्ट के लिए 1:1, स्टोरीज़ के लिए 9:16, बैनर्स के लिए 16:9)। यूज़र केवल प्रीसेट चुनता है, और हम उसे जनरेशन के लिए सही width × height में अनुवाद कर देते हैं।build_prompt() फ़ंक्शन नाम, ऑफर, कीमत, CTA और लाभ जैसे साधारण प्रोडक्ट इनपुट्स को एक इमेज ब्रीफ़ में बदल देता है। यह लेआउट और टेक्स्ट नियमों का ध्यान रखता है, ताकि मॉडल को हर बार सुसंगत constraints मिलें और वह रैंडम कॉपी में न भटके।generate_image() फ़ंक्शन एक्सिक्यूशन लेयर है। यह चुने गए प्रीसेट से width/height पढ़ता है, और चुने हुए steps, true_cfg_scale, और negative_prompt के साथ Qwen-Image पाइपलाइन को कॉल करता है। अंत में, यह जनरेटेड पोस्टर (और वैकल्पिक रूप से seed) लौटाता है। steps नियंत्रित करता है कि डिफ्यूज़न प्रक्रिया कितनी देर चलेगी (ज़्यादा स्टेप्स मतलब धीमा, पर आमतौर पर साफ़ परिणाम), जबकि true_cfg_scale नियंत्रित करता है कि मॉडल प्रॉम्प्ट का कितना कड़ाई से पालन करे (मान बढ़ाने से adherence बेहतर होता है, पर बहुत अधिक होने पर आर्टिफैक्ट्स आ सकते हैं)।अगले चरण में, हम generate_image() फ़ंक्शन को Gradio इंटरफ़ेस में एंबेड करेंगे ताकि यूज़र बिना रॉ प्रॉम्प्ट इंजीनियरिंग के पोस्टर बना सकें।
अंततः, हम पोस्टर-जनरेशन इंजन को Gradio इंटरफ़ेस में रैप करते हैं। ऐप यूज़र को प्रोडक्ट विवरण टाइप करने, प्लेटफ़ॉर्म एस्पेक्ट रेशियो चुनने, और Generate दबाने देता है।
with gr.Blocks(title="Qwen Poster Studio (Simple)") as demo:
    gr.Markdown("## Qwen Poster Studio — Qwen-Image-2512")
    with gr.Row():
        with gr.Column(scale=1):
            product_name = gr.Textbox(value="RÅSKOG Utility Cart", label="Product name")
            product_desc = gr.Textbox(value="Compact rolling cart for small spaces. Durable metal frame.", lines=2, label="Product description")
            offer = gr.Textbox(value="NEW YEAR SALE — 20% OFF", label="Offer headline")
            price = gr.Textbox(value="$29.99", label="Price")
            cta = gr.Textbox(value="Shop now", label="CTA button text")
            benefits = gr.Textbox(value="- Compact\n- Easy to move\n- Fits small spaces", lines=4, label="Benefits")
            tone = gr.Dropdown(["Premium", "Minimal", "Bold", "Playful", "Tech"], value="Premium", label="Tone")
            style_keywords = gr.Textbox(value="modern Scandinavian minimal, clean grid, soft warm lighting, premium product photography", label="Style keywords")
            language = gr.Dropdown(["English", "中文"], value="English", label="Language")
            preset = gr.Dropdown(list(ASPECT_PRESETS.keys()), value="Instagram Post (1:1) — 1328×1328", label="Platform preset")
            with gr.Accordion("Advanced (optional)", open=False):
                negative_prompt = gr.Textbox(value=DEFAULT_NEG, label="Negative prompt", lines=2)
                steps = gr.Slider(10, 80, value=50, step=1, label="Steps")
                true_cfg_scale = gr.Slider(1.0, 10.0, value=4.0, step=0.1, label="true_cfg_scale")
                seed = gr.Number(value=-1, precision=0, label="Seed (-1 = random)")
                show_seed = gr.Checkbox(value=False, label="Show seed in output")
            btn = gr.Button("Generate", variant="primary")
        with gr.Column(scale=1):
            used_seed_out = gr.Number(label="Used seed (optional)", precision=0)
            image_out = gr.Image(label="Generated poster")
    btn.click(
        fn=generate_image,
        inputs=[product_name, product_desc, offer, price, cta, benefits, tone, style_keywords,
                language, preset, negative_prompt, steps, true_cfg_scale, seed, show_seed],
        outputs=[used_seed_out, image_out]
    )
demo.launch(share=True, debug=True)
हम Gradio ऐप इस तरह बनाते हैं:
ASPECT_PRESETS का उपयोग करके अंतिम width × height पर मैप होता है।steps और true_cfg_scale जैसे प्रमुख पैरामीटर्स शामिल हैं, जो क्रमशः यह नियंत्रित करते हैं कि मॉडल कितनी denoising iterations चलाए और मॉडल प्रॉम्प्ट का कितना कड़ाई से पालन करे। Seed पुनरुत्पादनशीलता नियंत्रित करता है, और show_seed वैकल्पिक रूप से अंतिम seed दिखाता है।btn.click() सब कुछ कनेक्ट करता है। Gradio क्रम में सभी इनपुट विजेट्स लेता है, उन्हें generate_image() को पास करता है, और लौटाए गए मानों को आउटपुट विजेट्स में रूट करता है। अंततः, demo.launch(share=True, debug=True) Gradio सर्वर शुरू करता है, डेमो के लिए एक shareable पब्लिक लिंक देता है, और नोटबुक में डीबग लॉग्स प्रिंट करता है ताकि समस्याओं का निदान हो सके।यह रहा एक वीडियो जो हमारे अंतिम Qwen Image 2512 ऐप को एक्शन में दिखाता है:
शीर्ष DataCamp पाठ्यक्रम
कोर्स
कोर्स
कोर्स