

परिचय
मान लीजिए आपके पास बिक्री टीमों के दो समूह हैं और आप जाँचना चाहते हैं कि एक सप्ताह में दोनों टीमों द्वारा बेचे गए मोबाइल फ़ोनों की औसत संख्या समान है या नहीं। आप प्रदर्शन की तुलना कैसे करेंगे?
आप संबंधित टीमों द्वारा 200 यादृच्छिक ग्राहकों को बेचे गए मोबाइल फ़ोनों की औसत संख्या लेंगे और अंतर निर्धारित करेंगे। पहली मार्केटिंग टीम ने औसतन 120 फ़ोन बेचे हैं, जबकि दूसरी टीम ने 80 बेचे हैं।
तो, यह स्पष्ट है कि पहली टीम ने दूसरी टीम की तुलना में बिक्री में बेहतर प्रदर्शन किया। सही? हम पक्के तौर पर नहीं कह सकते; डेटा सेट यादृच्छिक ग्राहकों से एकत्र किया गया है और उस सप्ताह फ़ोन खरीदने वाले सभी लोगों का प्रतिनिधित्व नहीं करता।
तो हम कैसे तय करें कि किस टीम ने बेहतर प्रदर्शन किया? हम एक t-test का उपयोग करेंगे ताकि समझ सकें कि क्या दो औसतों के बीच का अंतर वास्तविक है या सिर्फ़ संयोग।
t-test एक सांख्यिकीय परिकल्पना परीक्षण है जो दोनों समूहों से नमूने लेकर यह निर्धारित करता है कि क्या दोनों समूहों के औसत में सार्थक अंतर है। यह कैसे काम करता है? यह नमूना औसत और मानक विचलन की तुलना करता है, साथ ही नमूना आकार और डेटा की परिवर्तनशीलता की डिग्री को भी ध्यान में रखता है।
इस ट्यूटोरियल में, हम t-tests के वर्गीकरण (वन-सैंपल, टू-सैंपल और पेयर्ड सैंपल t-test) को R कोड उदाहरणों के साथ सीखेंगे और परिणामों की व्याख्या करना समझेंगे।
नोट: यदि आप R में नए हैं, तो बुनियादी बातें समझने के लिए एक मिनी Introduction to R Programming कोर्स करें।
R में t.test() फ़ंक्शन
R भाषा हमें One Sample, Two Samples और Paired t-tests के लिए एक सरल t.test बिल्ट-इन फ़ंक्शन प्रदान करती है।
t.test फ़ंक्शन के दो उपयोग हैं: डिफ़ॉल्ट और फ़ॉर्मूला विधि।
डिफ़ॉल्ट विधि
आप x समूह और y समूह से संख्यात्मक नमूने देते हैं, और alternative परिकल्पना, परिकल्पित औसत mu, और इंटरवल का विश्वसनीयता स्तर निर्दिष्ट करते हैं। साथ ही, आप paired आर्ग्युमेंट टॉगल करके Paired t-test और var.equal आर्ग्युमेंट बदलकर समान विचरण के साथ Two Sample t-test कर सकते हैं।
t.test(x, y,
alternative = c("two.sided", "less", "greater"),
mu = 0, paired = FALSE, var.equal = FALSE,
conf.level = 0.95, ...)फ़ॉर्मूला विधि
इस विधि में, आप फ़ॉर्मूला x~y प्रदान करते हैं, जहाँ x एक संख्यात्मक वेक्टर या data की कोई कॉलम है, और y एक बाइनरी कॉलम है जिसमें समूहों के प्रकार होते हैं।
t.test(formula, data, subset, na.action, ...)R में One Sample t-test कैसे करें
वन-सैंपल t-test एक सांख्यिकीय परिकल्पना परीक्षण है जो यह परखता है कि क्या नमूना औसत और परिकल्पित या मानी हुई जनसंख्या औसत के बीच सार्थक अंतर है। यह परीक्षण डेटा की परिवर्तनशीलता को ध्यान में रखते हुए नमूना औसत की तुलना परिकल्पित औसत से करता है।
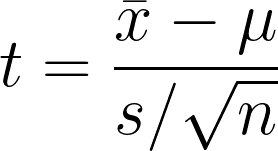
- x̄1 = नमूना औसत
- μ = परिकल्पित जनसंख्या औसत
- s = नमूना मानक विचलन
- n = नमूना आकार
इस ट्यूटोरियल में, हम t-test कोड उदाहरणों के लिए Carbon Dioxide Uptake in Grass Plants R डेटासेट का उपयोग करेंगे। इस डेटासेट में 84 पंक्तियाँ और 5 कॉलम हैं, और इसे घास प्रजाति Echinochloa crus-galli की ठंड सहनशीलता का परीक्षण करने के लिए एक प्रयोग से एकत्र किया गया था। हम मुख्यतः uptake, Treatment, और Type कॉलम पर विचार करेंगे।
head(CO2)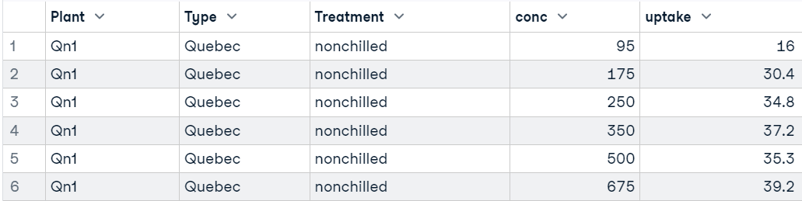
उदाहरण में, हम डेटासेट के conc (कार्बन डाइऑक्साइड सांद्रता) कॉलम का उपयोग करेंगे।
हम बॉक्सप्लॉट का उपयोग करके औसत, वितरण और बाहरी मान देख सकते हैं।
boxplot(CO2$conc)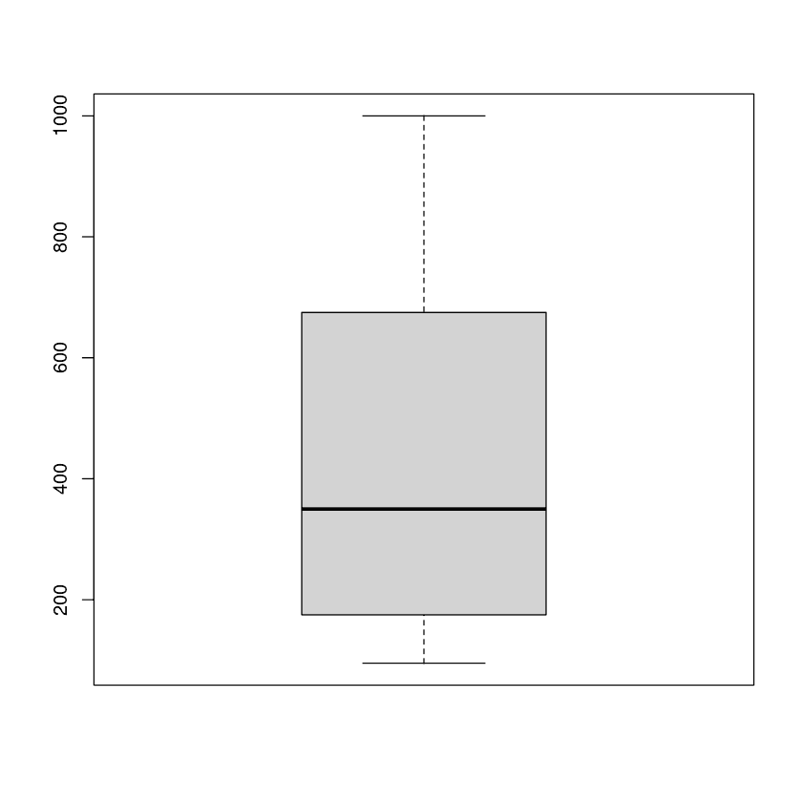
वन-सैंपल t-test के लिए, हम `t.test(x,mu=0)` का उपयोग करेंगे। जहाँ x चर है, mu शून्य परिकल्पना द्वारा सेट किया जाता है। हमारे मामले में यह 550 है।
t.test(CO2$conc, mu = 550)परिणाम:
कार्बन डाइऑक्साइड की सांद्रता 550 के बराबर नहीं है और परिकल्पित जनसंख्या औसत से सार्थक रूप से कम है।
One Sample t-test
data: CO2$conc
t = -3.5617, df = 83, p-value = 0.0006134
alternative hypothesis: true mean is not equal to 550
95 percent confidence interval:
370.7805 499.2195
sample estimates:
mean of x
435 R में Two Sample t-test कैसे करें
Two Sample t-tests में, हम दो उपचार प्रकारों: non-chilled और chilled के कार्बन डाइऑक्साइड uptake दरों की तुलना करेंगे।
हम बॉक्सप्लॉट का उपयोग करके दोनों समूहों के वितरण को विज़ुअलाइज़ कर सकते हैं।
plot(uptake ~ Treatment, data=CO2)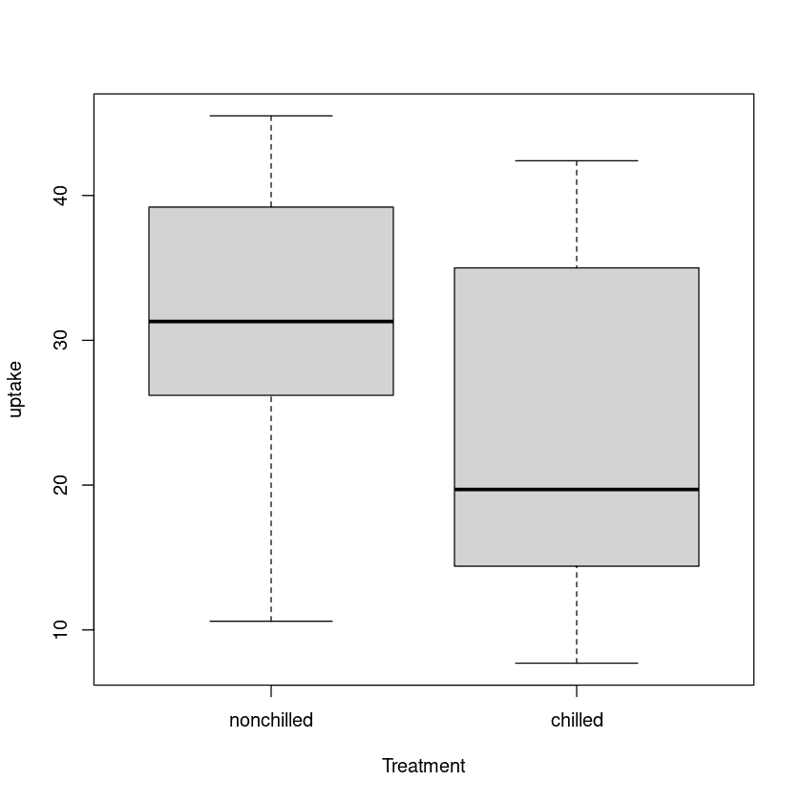
Welch Two Sample t-test
यह एक सांख्यिकीय परिकल्पना परीक्षण है जो जाँचता है कि दो स्वतंत्र समूहों के औसत में, जिनके विचरण असमान हो सकते हैं, कोई सार्थक अंतर है या नहीं। यह परीक्षण प्रत्येक समूह के भीतर की परिवर्तनशीलता को ध्यान में रखते हुए दोनों समूहों के औसतों की तुलना करता है।
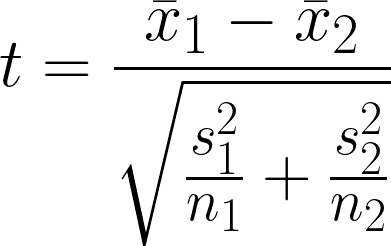
- x̄1 = पहले समूह का नमूना औसत
- x̄2 = दूसरे समूह का नमूना औसत
- n1 = पहले समूह का नमूना आकार
- n2 = दूसरे समूह का नमूना आकार
- s12 = पहले समूह का नमूना विचरण
- s22 = दूसरे समूह का नमूना विचरण
डिफ़ॉल्ट रूप से, t.test() फ़ंक्शन मानता है कि दोनों समूहों का विचरण असमान है (var.equal=FALSE)। इसलिए, हमें कोई बदलाव करने की आवश्यकता नहीं है।
हम फ़ॉर्मूला विधि का उपयोग करके t-test के परिणाम प्राप्त कर रहे हैं, जहाँ uptake एक संख्यात्मक वेक्टर है और Treatment CO2 डेटासेट का एक बाइनरी श्रेणी कॉलम है।
t.test(uptake ~ Treatment, data = CO2)परिणाम:
दोनों समूहों के औसत में सार्थक अंतर है, और nonchilled समूह का uptake chilled समूह से अधिक है।
Welch Two Sample t-test
data: uptake by Treatment
t = 3.0485, df = 80.945, p-value = 0.003107
alternative hypothesis: true difference in means between group nonchilled and group chilled is not equal to 0
95 percent confidence interval:
2.382366 11.336682
sample estimates:
mean in group nonchilled mean in group chilled
30.64286 23.78333 Equal Variance के साथ Two Sample t-test
Two Sample t-test एक सांख्यिकीय परिकल्पना परीक्षण है जो यह निर्धारित करता है कि दो स्वतंत्र समूहों के औसत में, यह मानते हुए कि दोनों समूहों का विचरण समान है, कोई सार्थक अंतर है या नहीं। यह परीक्षण प्रत्येक समूह के भीतर की परिवर्तनशीलता को ध्यान में रखते हुए दोनों समूहों के औसतों की तुलना करता है।
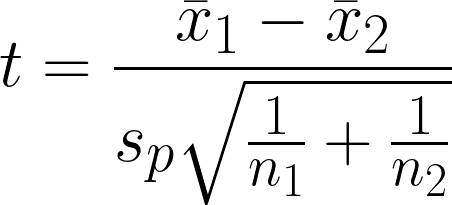
- x̄1 = पहले समूह का नमूना औसत
- x̄2 = दूसरे समूह का नमूना औसत
- n1 = पहले समूह का नमूना आकार
- n2 = दूसरे समूह का नमूना आकार
- sp = pooled मानक विचलन
Equal variance के साथ Two Sample t-test करने के लिए, हमें var.equal को TRUE सेट करना होगा और उसी फ़ॉर्मूला और डेटासेट के साथ परीक्षण फिर चलाना होगा।
t.test(uptake ~ Treatment, data = CO2, var.equal = TRUE)परिणाम:
जैसा कि हम देख सकते हैं, हमें लगभग समान परिणाम मिले हैं कि दोनों समूहों के औसत में सार्थक अंतर है।
Two Sample t-test
data: uptake by Treatment
t = 3.0485, df = 82, p-value = 0.003096
alternative hypothesis: true difference in means between group nonchilled and group chilled is not equal to 0
95 percent confidence interval:
2.38324 11.33581
sample estimates:
mean in group nonchilled mean in group chilled
30.64286 23.78333R में Paired t-test कैसे करें
Paired t-test एक सांख्यिकीय परिकल्पना परीक्षण है जिसका उपयोग यह निर्धारित करने के लिए किया जाता है कि क्या दो संबंधित या युग्मित नमूनों के औसत में सार्थक अंतर है। यह युग्मित प्रेक्षणों के बीच के अंतरों की तुलना करते हुए, अंतरों के भीतर की परिवर्तनशीलता को ध्यान में रखकर t-test मान की गणना करता है।
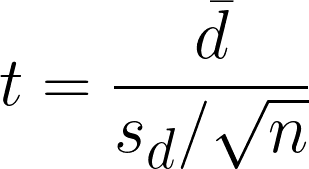
- dࠡ = युग्मित प्रेक्षणों में औसत के अंतर
- sd = अंतरों का नमूना मानक विचलन
- n = युग्मों की संख्या
R में Paired t-test करने के लिए, हमें paired आर्ग्युमेंट को TRUE सेट करना होगा और उसी फ़ॉर्मूला और डेटासेट के साथ परीक्षण फिर चलाना होगा।
t.test(uptake ~ Treatment, paired = TRUE, data = CO2)परिणाम:
t और p-मूल्य को ध्यान में रखते हुए दोनों समूहों के औसत के बीच सांख्यिकीय रूप से सार्थक अंतर है।
Paired t-test
data: uptake by Treatment
t = 7.939, df = 41, p-value = 8.051e-10
alternative hypothesis: true mean difference is not equal to 0
95 percent confidence interval:
5.114589 8.604458
sample estimates:
mean difference
6.859524 दूसरे उदाहरण में, हम एक ही पौधे की दो किस्मों के लिए uptake दर को फैक्टर करेंगे। एक Quebec से है, और दूसरा Mississippi से।
plot(uptake ~ Type, data=CO2)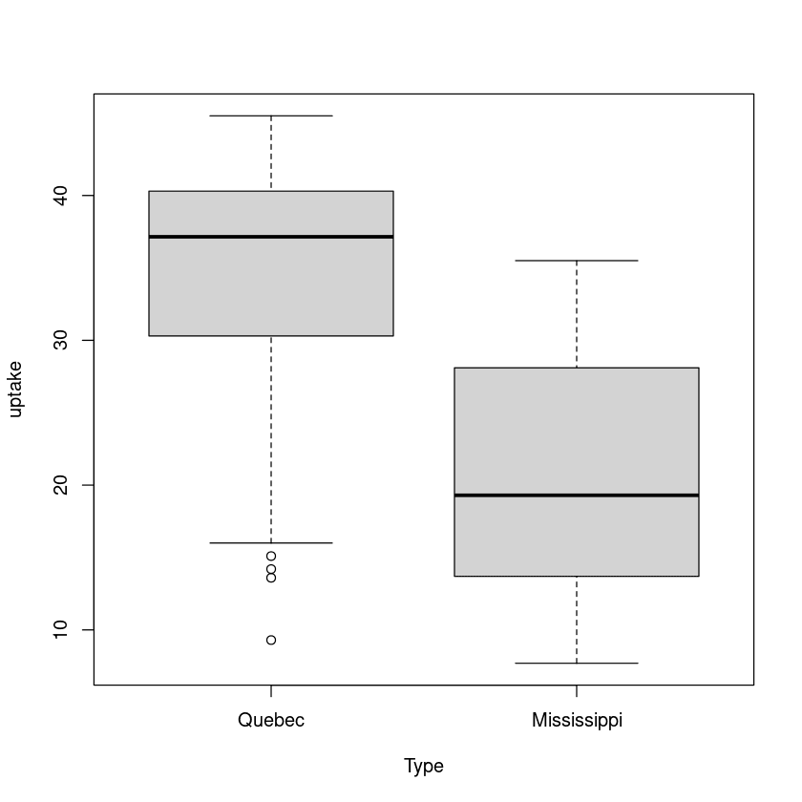
आइए फ़ॉर्मूला में Treatment को Type से बदलकर paired t-test के परिणाम जाँचें।
t.test(uptake ~ Type, paired = TRUE, data = CO2)परिणाम:
फिर से, Quebec और Mississippi समूहों के औसत में सार्थक अंतर है।
Paired t-test
data: uptake by Type
t = 11.374, df = 41, p-value = 2.937e-14
alternative hypothesis: true mean difference is not equal to 0
95 percent confidence interval:
10.41177 14.90727
sample estimates:
mean difference
12.65952 R में t-test DataLab Workbook आज़माएँ। इसमें कोड स्रोत और परिणाम आते हैं। आप वर्कबुक को डुप्लिकेट करके अलग-अलग उदाहरणों पर अभ्यास भी शुरू कर सकते हैं।
नोट: सांख्यिकी की मजबूत नींव आपको किसी भी उद्योग में लाभ देगी। सांख्यिकी आधुनिक AI की रीढ़ है, और आपको अपनी यात्रा Statistics Fundamentals with R स्किल ट्रैक से शुरू करनी चाहिए।
R में t-test के परिणामों की व्याख्या कैसे करें
हम परिणाम बना रहे हैं, लेकिन df, p-value, वैकल्पिक परिकल्पना, या sample estimates का क्या अर्थ है? इस खंड में, हम सीखेंगे कि R में t-test के परिणामों की व्याख्या कैसे करें।
आइए rnorm फ़ंक्शन का उपयोग करके दो समूह बनाएँ और Two Sample t-tests चलाएँ।
set.seed(125)
group1 <- c(rnorm(100, mean = 24, sd = 3))
group2 <- c(rnorm(100, mean = 43, sd = 2.4))
t.test(group1, group2)आउटपुट:
Welch Two Sample t-test
data: group1 and group2
t = -47.765, df = 179.99, p-value < 2.2e-16
alternative hypothesis: true difference in means is not equal to 0
95 percent confidence interval:
-19.51569 -17.96722
sample estimates:
mean of x mean of y
24.30063 43.04208 - data: Two Sample t-test में प्रयुक्त डेटा (group1 और group2)
- t: t परीक्षण-सांख्यिक। -47.765 का नकारात्मक t-मूल्य संकेत करता है कि group1 का नमूना औसत group2 से काफ़ी छोटा है।
- df: t-test मान के साथ संबद्ध स्वतंत्रता की डिग्री।
- p-value: परिणाम की सांख्यिकीय महत्वपूर्णता दर्शाता है। p-value 2.2e-16 है जो अल्फ़ा (0.005) से कम है, यह दर्शाता है कि दो समूहों के बीच इतना बड़ा अंतर संयोग से मिलने की संभावना बहुत कम है।
- alternative hypothesis: हम वैकल्पिक परिकल्पना सेट कर सकते हैं। हमारे मामले में, यह जाँचना था कि वास्तविक औसतों का अंतर शून्य के बराबर नहीं है।
- 95 percent confidence interval: 95% विश्वास है कि दोनों समूहों के बीच वास्तविक जनसंख्या औसत का अंतर -19.51569 और -17.96722 के दायरे में है।
- sample estimates: यह प्रत्येक समूह के नमूना औसत बताता है, जहाँ group1 और group2 क्रमशः 24.30063 और 43.04208 हैं। यानी औसतन, group2 का मान group1 से अधिक है।
t-test के लिए दो परिकल्पनाएँ होती हैं:
- H0: µ1 = µ2: दोनों जनसंख्या औसत समान हैं।
- HA: µ1 ≠ µ2: दोनों जनसंख्या औसत समान नहीं हैं।
निष्कर्षतः, Welch Two Sample t-test के परिणाम संकेत करते हैं कि group1 और group2 के बीच सांख्यिकीय रूप से सार्थक अंतर के प्रबल प्रमाण हैं।
निष्कर्ष
इस ट्यूटोरियल में, हमने R प्रोग्रामिंग उदाहरणों के साथ One Sample, Two Samples, और Paired t-tests के बारे में सीखा और परिणामों की व्याख्या करना जाना।
t-test परिकल्पना परीक्षण में प्रयुक्त अनेक सांख्यिकीय औज़ारों में से एक है, और यदि आप परिकल्पना परीक्षण के बारे में सब कुछ सीखना चाहते हैं, तो इंटरैक्टिव Hypothesis Testing in R कोर्स करें। यह कोर्स t-tests, ANOVA, proportion tests, और chi-square tests को कवर करता है।
आप इससे आगे बढ़कर हमारे Statistician with R करियर ट्रैक में भी नामांकन कर सकते हैं ताकि आवश्यक कौशल में महारत हासिल कर सकें और सांख्यिकीविद् के रूप में नौकरी पा सकें।