
Curso
Modelos Transformer con PyTorch
2 h
9K
Sabemos que los Transformers se han vuelto fundamentales en el procesamiento del lenguaje natural y ahora ganan terreno en visión por computador. Los Vision Transformers (ViT) proponen una forma novedosa de entender imágenes aplicando los mismos principios de los modelos basados en texto; Large Language Models.
Los ViT se presentaron por primera vez en 2020 por Google Research en el artículo «An Image is Worth 16×16 Words», mostrando que los transformers entrenados con grandes conjuntos de imágenes pueden igualar o superar a las CNN. Desde entonces, variantes prácticas como DeiT y Swin han ampliado su uso a muchas tareas de visión.
En este tutorial te guiaré por los conceptos clave, los componentes de la arquitectura y las aplicaciones prácticas de los vision transformers (la variante original o "vanilla"). Al final, no solo entenderemos cómo funcionan los ViT, sino también cómo implementarlos en nuestros propios proyectos de visión por computador. Te recomiendo además mi guía sobre atención multi-cabeza.
Empecemos con una introducción suave a los vision transformers.
Estos modelos tratan una imagen como una secuencia de datos, de forma similar a cómo un modelo de lenguaje procesa las palabras en una frase. Primero, la imagen se divide en parches de tamaño fijo; cada parche se aplana y se incrusta en un vector.
Después, estos vectores pasan por un codificador transformer estándar, que modela las relaciones entre parches a nivel global usando el mecanismo de atención.
Esto es fundamentalmente distinto de las redes neuronales convolucionales (CNN), que se centran en rasgos locales y dependen de la extracción jerárquica de características.
Ya que hablamos de CNN, veamos en qué se diferencian de los ViT:
|
Característica |
Redes neuronales convolucionales (CNN) |
Vision Transformers (ViT) |
|
Arquitectura |
Usan capas de convolución + pooling |
Usan codificador transformer con autoatención |
|
Campo receptivo |
Local, pero se amplía con la profundidad |
Global desde el principio |
|
Conciencia posicional |
Implícita por la estructura |
Explícita mediante codificaciones posicionales |
|
Requisitos de datos |
Bastante eficaces con conjuntos pequeños |
Requieren conjuntos de gran escala |
|
Sesgo inductivo |
Fuerte |
Mínimo, pero más flexible |
|
Potencial de paralelismo |
Moderado |
Muy alto |
|
Escalado del modelo |
Menos escalables a modelos grandes |
Altamente escalables |
|
Interpretabilidad |
Vía capas de pooling, aunque sigue siendo difícil |
Mejorable con visualización de atención, pero también compleja |
Aún no hemos cubierto los vision transformers a fondo, pero conviene repasar algunos puntos que quizá no se entiendan a la primera.
Por ejemplo, los términos sesgo inductivo y campos receptivos son importantes y puede que no te suenen.
El sesgo inductivo son las suposiciones que hace un modelo para ayudarle a aprender de los datos. Puede sonar confuso, pero verás que encaja con esta analogía.
Imagina que hacemos un puzle juntos. Pensamos que las piezas se conectan por su forma y color. Esa suposición nos ayuda a montarlo más rápido. Así funcionan las CNN.
Hacen conjeturas inteligentes suponiendo que las partes cercanas de una imagen están relacionadas, como piezas próximas del puzle que suelen pertenecer a la misma zona. También asumen que, si movemos una forma, sigue siendo la misma forma. Estas conjeturas útiles se llaman sesgos inductivos fuertes.
Ahora imagina que nos dan un montón de piezas, pero no sabemos cómo es la imagen final. Ni siquiera si debemos fijarnos en la forma, el color o en otra cosa. Probamos de todo y, poco a poco, vamos viendo qué funciona.
Eso es lo que hace un modelo Transformer. No hace suposiciones fuertes. Aprende patrones viendo muchos datos. A esto se le llama sesgo inductivo mínimo. Da más libertad al modelo, pero necesita más datos y tiempo para aprender.
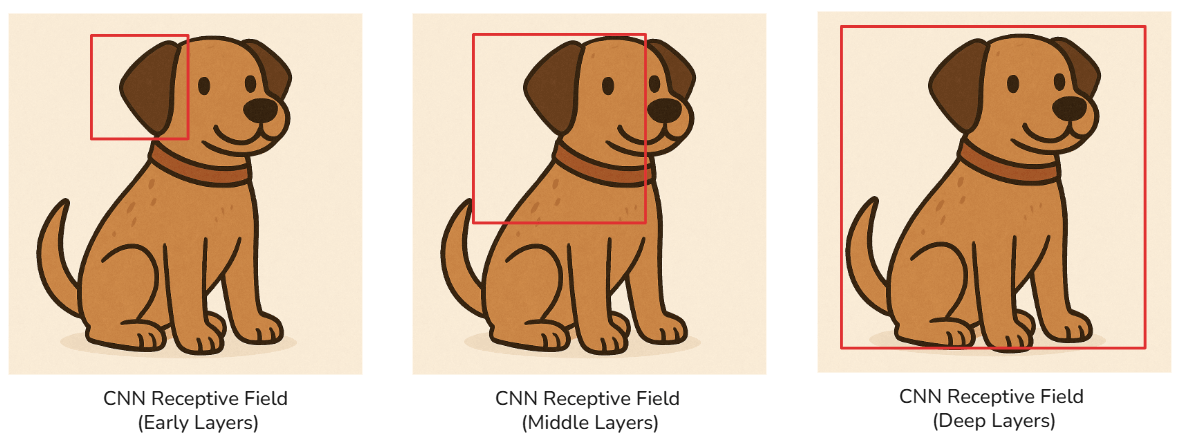
La imagen anterior muestra cómo cambia el campo receptivo de un modelo CNN. Recuerda que hay múltiples capas de convolución en una CNN y, a medida que profundizamos en la red, cada neurona de la capa queda influida por una región cada vez mayor de la entrada.
Este campo receptivo en expansión permite que las capas profundas detecten rasgos más complejos y globales, como se ve en la figura (de oreja a cara y al perro completo).
Esto es muy distinto del campo receptivo de un Vision Transformer:
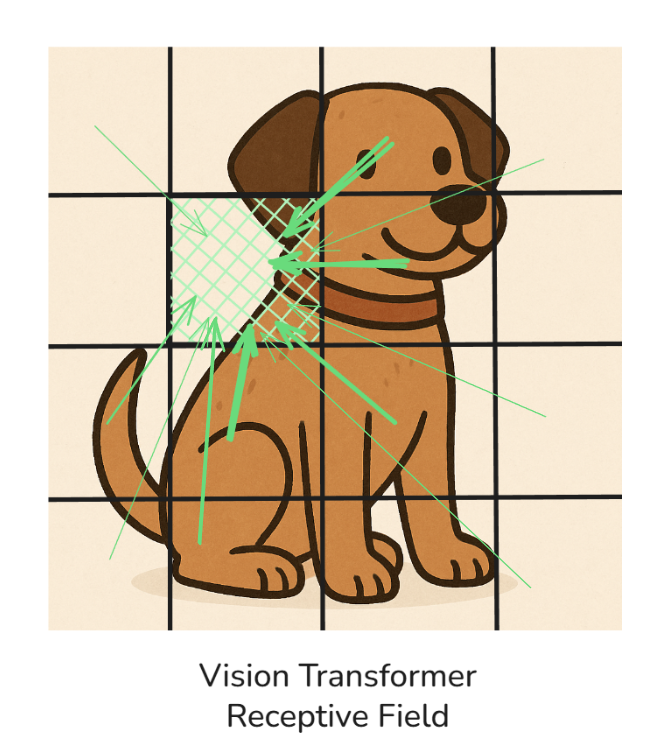
En la ilustración superior vemos que el campo receptivo en un ViT (vanilla) es global: todos los parches se atienden entre sí con diferentes magnitudes (indicadas por el grosor de las flechas).
Para simplificar, he mostrado que el parche (en verde) es atendido por los demás, pero en realidad todos se atienden entre sí (¡dibujarlo quedaba demasiado enmarañado!).
Elegir entre una CNN y un vision transformer es clave para tomar decisiones de arquitectura eficaces en nuestros flujos de visión por computador.
Ambos modelos tienen puntos fuertes (¡y débiles!), pero rinden mejor en condiciones distintas según el tamaño de los datos, los recursos computacionales y la complejidad de los patrones visuales que queremos modelar.
Yo suelo tener presentes estos puntos al decidir:
Usa CNN cuando:
Usa Vision Transformers cuando:
En resumen, si te mueves en un entorno con pocos recursos o necesitas resultados rápidos y fiables con pocos datos, las CNN son la opción más segura y eficiente.
En cambio, si tu proyecto exige razonamiento global profundo sobre el espacio visual y cuentas con potencia de cómputo, los vision transformers son la mejor opción.
Ahora sí, entremos en la arquitectura del Vision Transformer. Como hay varias etapas (cinco, para ser exactos), vamos a verlas una a una.
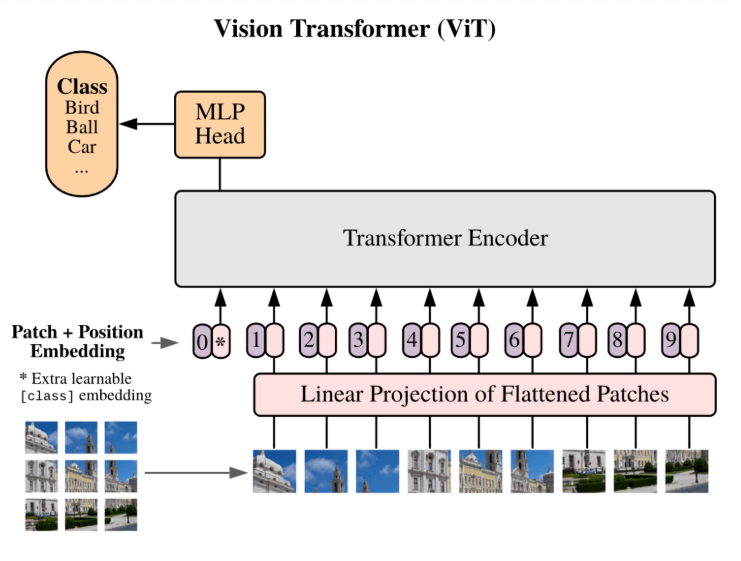
Este es el primer paso de transformación: convertir una imagen a un formato que el transformer pueda entender.
Supongamos que tenemos una imagen de 224×224. En lugar de pasarla entera, la dividimos en parches cuadrados de tamaño fijo. Si cada parche es de 16×16 (como propone el paper original), la imagen se divide en 14×14 = 196 parches, ya que (224/16 = 14).
Una forma sencilla de entenderlo es pensar en recortar una fotografía en baldosas cuadradas idénticas. Cada parche contiene información local y actuará como una "palabra" en una frase.
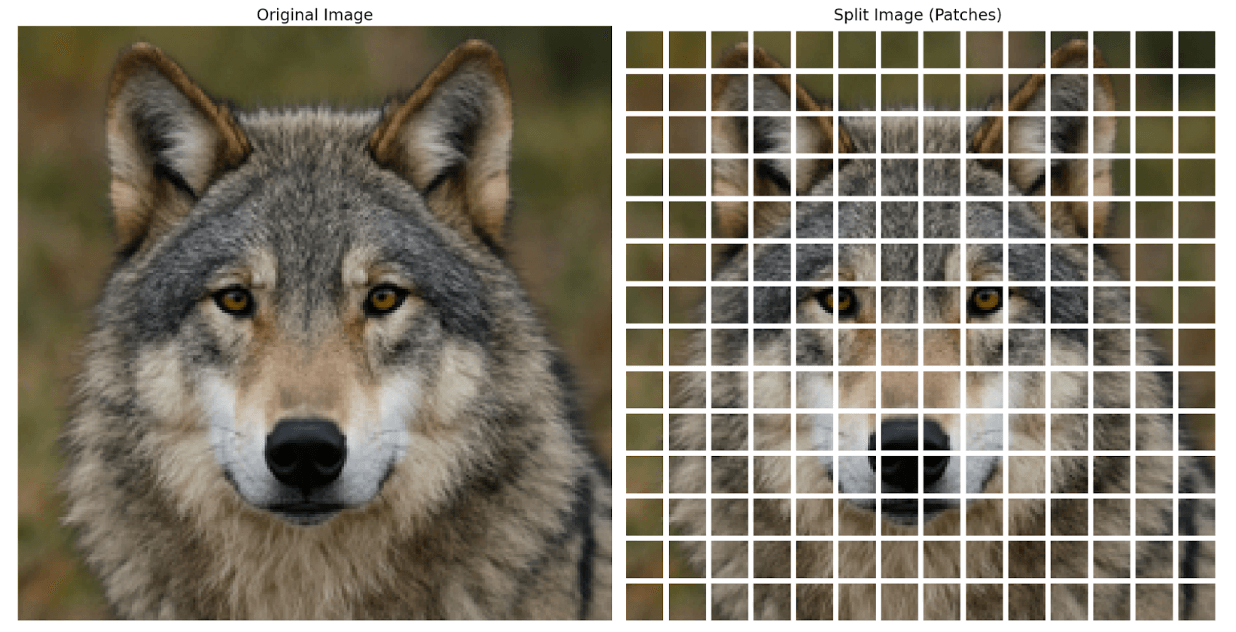
En la ilustración anterior, ves cómo la imagen de un lobo se divide en parches cuadrados e iguales: 196 en total.
Puede que te surja una pregunta:
«La imagen es RGB, ¿qué pasa con los 3 canales de color?»
Es un punto importante: cada parche es en realidad un bloque de datos que, en nuestro caso, tiene forma 16×16×3. 16×16 es alto y ancho, y 3 son los canales de color, convirtiendo cada parche en un tensor tridimensional.
Así, cada parche es una representación compacta de la información espacial y de color de una región local de la imagen.
Dividir en parches transforma la estructura espacial 2D de la imagen en una secuencia 1D de datos multidimensionales, apta para un transformer.
Después, debemos transformar cada parche en una representación numérica que el transformer pueda usar.
Cada parche RGB 16×16 se aplana en un único vector. En nuestro ejemplo, 16×16×3 = 768 valores. Básicamente, desenrollamos todos los píxeles y colores en una sola línea de números.
Estos vectores en bruto, aunque informativos, aún no están en un espacio adecuado para aprender. Por eso, pasamos cada uno por una capa de proyección lineal entrenable. Piensa en ella como una capa densa que mapea cada entrada de 768 dimensiones a un nuevo espacio de incrustación de tamaño D (a menudo también 768, pero no siempre).
¿Por qué?
Porque así alineamos todos los tokens de parches en un formato consistente y aprendible que espera el codificador transformer. Hasta aquí, tenemos una secuencia de vectores de longitud fija, donde cada vector representa un parche de la imagen.
Todo este proceso convierte parches ricos en información espacial y de color en una secuencia unificada de «tokens» (análogos a las incrustaciones de palabras en PLN), lo que permite al transformer tratar la imagen como una serie estructurada de entidades aprendibles.
Queda una cosa antes de enviar estos tokens al codificador. ¡Seguro que la intuyes si ya has visto LLMs!
Los transformers son intrínsecamente agnósticos a la posición.
Es decir, tratan la secuencia de entradas como una colección desordenada: no tienen un mecanismo interno para entender el orden o la posición de los tokens. Y esto es un problema en análisis de imágenes, donde la estructura espacial y el diseño son críticos.
Veámoslo en detalle.
En imágenes, cada parche representa una región concreta de la imagen original. Si pasamos al modelo una secuencia de incrustaciones de parches sin indicar de dónde viene cada uno, no sabrá si procede de la esquina superior izquierda o de la inferior derecha.
Esta falta de conocimiento espacial limitaría la capacidad del modelo para entender patrones, formas, estructuras, etc.
Para solucionarlo, añadimos lo que llamamos codificación posicional a cada incrustación de parche. Es un vector que actúa como etiqueta espacial; codifica la posición original del parche en la imagen. Estos vectores posicionales se suman directamente a las incrustaciones antes de entrar en el transformer.
Hay dos tipos comunes de codificaciones posicionales:
Si aquí te pierdes, piensa en las codificaciones posicionales como las coordenadas GPS de los parches.
Le dicen al transformer la posición original del token. Al incluir esta información, permitimos que la autoatención modele tanto el contenido de cada parche como su posición relativa o absoluta en la imagen.
Este paso es crucial: sin él, el Vision Transformer no podría reconstruir la estructura de una imagen, por muy potente que sea la atención.
Aquí es donde ocurre el deep learning de verdad: descubrimiento de patrones, modelado de contexto y fusión de características.
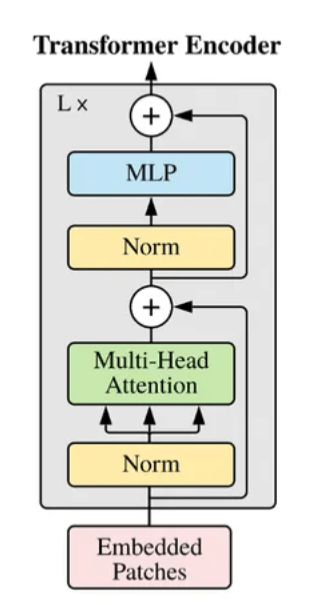
Se apilan varios de estos bloques de codificador para formar el codificador completo del Vision Transformer. Veamos qué contiene cada bloque:
Estos bloques se apilan en capas (p. ej., 12 en ViT-Base) y, con cada una, se aprenden representaciones más profundas de la imagen.
¡Ya casi estamos! Pasemos a la última etapa del ViT (vanilla).
Tras todas las capas del codificador, necesitamos resumirlo todo y hacer una predicción.
Para ello, introducimos un token [CLS] especial al principio de la secuencia de parches. Es una incrustación aprendible que interactúa con el resto de tokens durante el codificado.
A medida que atraviesa las capas del transformer, va recogiendo información global. Al final, extraemos este token y lo pasamos por otra cabecera de perceptrón multicapa (MLP) (normalmente un par de capas densas seguidas de una softmax para clasificación).
Este último paso nos da la etiqueta predicha, como decir «esta imagen es un perro», basándose en la información que recopiló el token [CLS]. Es importante: solo el [CLS] se envía a esta MLP final y, por tanto, se usa para clasificar; ¡no el resto de tokens!
Veamos algunas arquitecturas revolucionarias de Vision Transformer.
Muchas veces no entrenaremos un ViT desde cero. Veamos cómo usar modelos ViT preentrenados de bibliotecas populares de deep learning.
Una de las maneras más sencillas y fiables de usar vision transformers es con la biblioteca Transformers de Hugging Face. Proporciona modelos ViT preentrenados listos para usar con pocas líneas de código.
He escrito un poco de código para descargar y usar el modelo ViT Base original:
# Imports neededfrom transformers import ViTImageProcessor, ViTForImageClassificationfrom PIL import Imageimport torchimport requests# Here I am loading and preprocessing an image - but you can use any image of your choiceimage = Image.open(requests.get(https://huggingface.co/datasets/huggingface/cats-image?image-viewer=ED6CB286C90CF5F1FAF278077DF091477DF05416', stream=True).raw)# Here, we load and process the ViT modelprocessor = ViTImageProcessor.from_pretrained('google/vit-base-patch16-224')model = ViTForImageClassification.from_pretrained('google/vit-base-patch16-224')# Preprocessing the image so it gets it into the necessary formatinputs = processor(images=image, return_tensors='pt')# Forward pass - with no backpropagationwith torch.no_grad(): outputs = model(**inputs)# Here we get the predicted labels (since we are performing classification)logits = outputs.logits predicted_class = logits.argmax(-1) # Selects the index of the class with the highest logit score (highest predicted probability)print(f"Predicted class index: {predicted_class.item()}")Comentemos el código con más detalle. Puede que te preguntes por qué hay que descargar dos componentes. Son distintos, pero se complementan:
ViTImageProcessor – se encarga del preprocesamiento de la imagen antes de pasarla al modelo: redimensiona, normaliza y convierte la imagen al formato que espera el ViT. Piénsalo como el equivalente visual del tokenizer en PLN.ViTForImageClassification – es el modelo que hace la inferencia. Espera entradas en un formato tensorial específico y produce predicciones (p. ej., logits o probabilidades por clase).Otra duda puede ser sobre output.logits y, en concreto, qué son los logits.
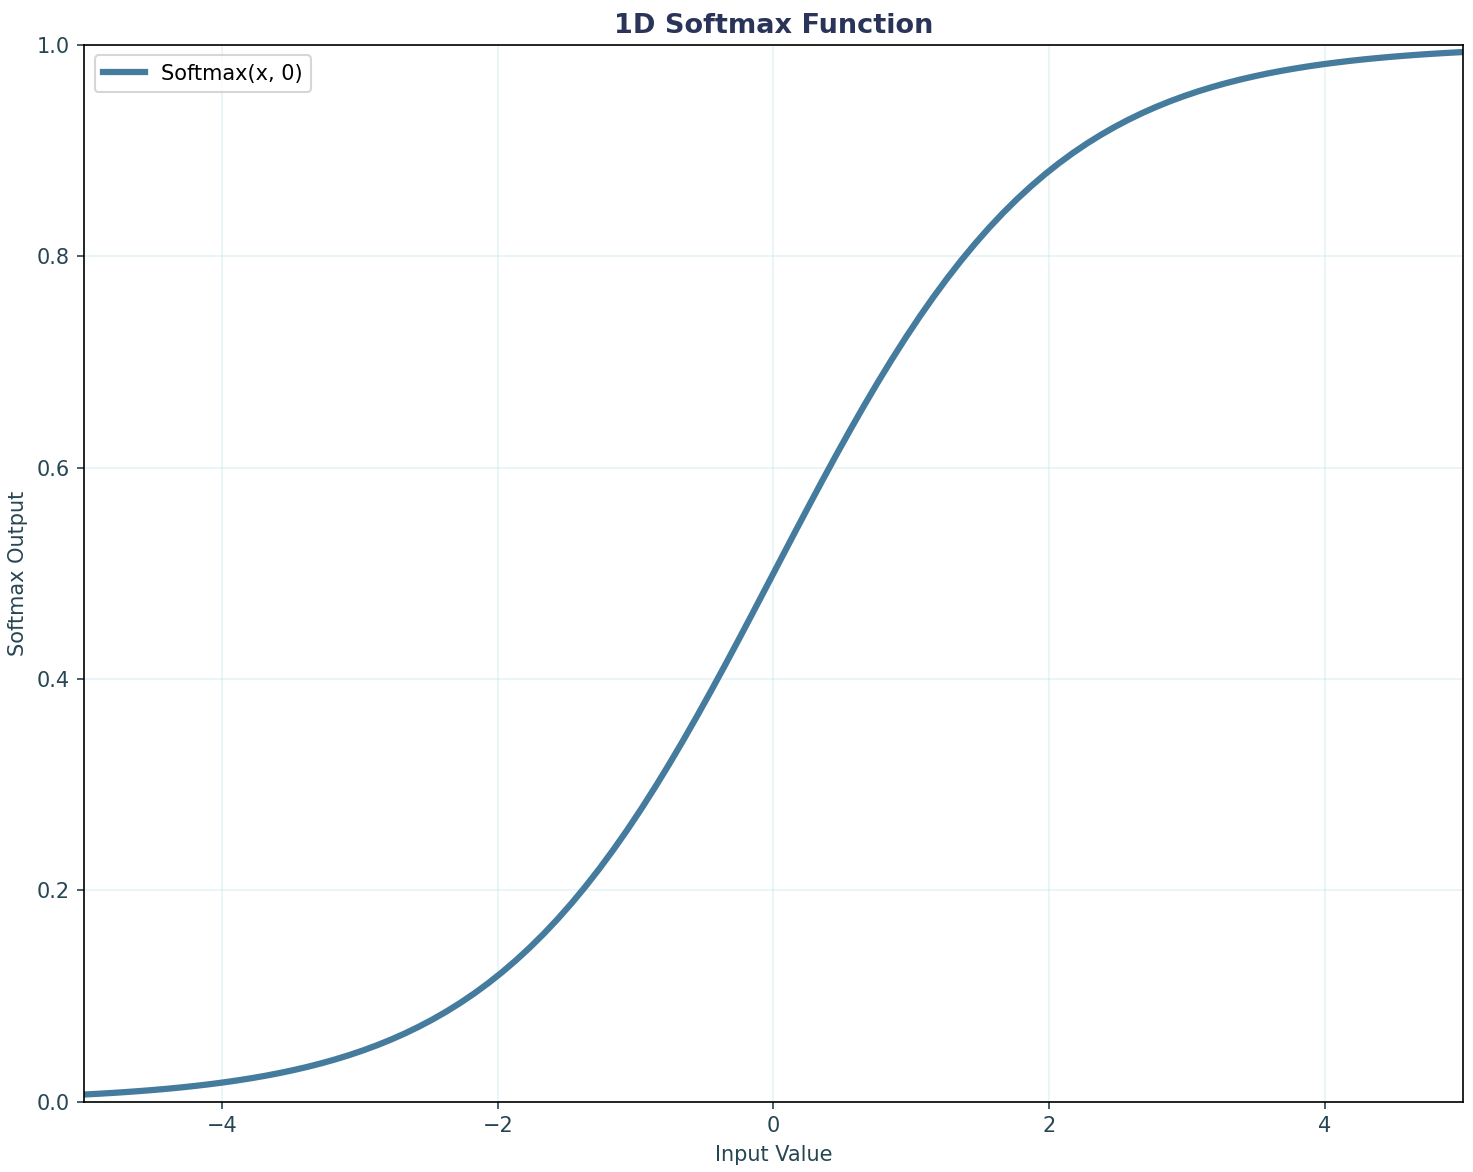
En modelos de aprendizaje automático —especialmente de clasificación— los logits son los valores brutos que produce la última capa antes de aplicar una activación como softmax. Representan puntuaciones no normalizadas para cada clase.
Puedes verlos como los niveles de confianza internos del modelo para cada clase. Pueden ser positivos o negativos y no están obligados a sumar uno.
Para convertir logits en probabilidades, aplicamos la función softmax, que los escala a una distribución de probabilidad.
Así que, cuando usamos argmax(logits, -1), seleccionamos el índice (clase) con la puntuación bruta más alta, que suele coincidir con la de mayor probabilidad tras la softmax.
Otra biblioteca estupenda y muy conocida para usar vision transformers es timm (de Ross Wightman). También ofrece una gran variedad de variantes ViT preentrenadas y es ideal para experimentar o hacer fine-tuning. Así cargamos y usamos un ViT para inferencia:
# Relevant importsimport timmimport torchfrom torchvision import transformsfrom PIL import Imageimport requests# Loading an imageurl = 'https://huggingface.co/datasets/huggingface/cats-image?image-viewer=ED6CB286C90CF5F1FAF278077DF091477DF05416'image = Image.open(requests.get(url, stream=True).raw)# Here we have defined the transformation we are going to do on the imagetransform = transforms.Compose([ transforms.Resize((224, 224)), transforms.ToTensor(), transforms.Normalize(mean=[0.5, 0.5, 0.5], std=[0.5, 0.5, 0.5])])image_tensor = transform(image).unsqueeze(0) # Adding batch dimension# Loading the ViT modelmodel = timm.create_model('vit_base_patch16_224', pretrained=True)model.eval() # Setting it to evaluation mode# Inference componentwith torch.no_grad(): outputs = model(image_tensor) predicted_class = outputs.argmax(dim=1) # Obtaining the class with the highest probabilityprint(f"Predicted class index: {predicted_class.item()}")Ahora verás la similitud entre timm y la biblioteca transformers. Ambas proporcionan modelos ViT preentrenados, permiten procesar imágenes (aunque en timm usamos código estándar de PyTorch) y, al final, obtenemos la clase con el logit más alto.
En conjunto, los vision transformers han cambiado la visión por computador al convertir imágenes en «frases» de parches y usar autoatención para capturar el contexto global desde la primera capa. En este tutorial hemos visto:
Para seguir aprendiendo, te recomiendo este artículo sobre cómo funcionan los Transformers, para entender la teoría. Para consolidarlo, explora cómo construir un transformer desde cero.
Si quieres aprender ambas cosas a la vez y con práctica, nuestro curso Transformer Models with PyTorch es el lugar ideal.
Cursos destacados de DataCamp
Curso
programa
programa
blog
Abid Ali Awan
10 min
Tutorial
Arjun Sarkar
15 min
Tutorial
Arunn Thevapalan
12 min
Tutorial
Kurtis Pykes
14 min
Tutorial
Natassha Selvaraj
8 min
Tutorial







