
Last chance! 50% off DataCamp Premium
Sale ends in
भले ही ज़्यादातर लोग Amazon को प्राइम डिलीवरी और कंटेंट से जोड़ते हैं, यह कंपनी डेवलपर्स के बीच भी बेहद लोकप्रिय है। विशेष रूप से, Amazon Web Services (AWS) 10 लाख से अधिक सक्रिय उपयोगकर्ताओं को क्लाउड तकनीकें प्रदान करता है, जिनमें एंटरप्राइज़ कॉरपोरेशंस और छोटे-से-मध्यम आकार के व्यवसाय शामिल हैं।
इस लेख में, हम AWS इकोसिस्टम का हिस्सा AWS SageMaker पर ध्यान देंगे — एक समर्पित प्लेटफ़ॉर्म जो बड़े पैमाने पर एंड-टू-एंड मशीन लर्निंग (ML) वर्कफ़्लो चलाने के लिए बनाया गया है। लेख के अंत तक, हमारे पास एक डिप्लॉय किया हुआ मॉडल होगा जिसे हम क्लासिफिकेशन टास्क के लिए प्रेडिक्शन जनरेट करने हेतु रिक्वेस्ट भेजने में उपयोग कर सकेंगे।
Amazon SageMaker एक पूर्ण प्रबंधित सेवा है जो मशीन लर्निंग मॉडल बनाने, ट्रेन करने, और परिनियोजित करने के लिए टूल्स और इन्फ्रास्ट्रक्चर उपलब्ध कराती है। यह मशीन लर्निंग वर्कफ़्लो को सरल बनाती है, जिससे डेटा वैज्ञानिक और डेवलपर्स तेज़ी और कुशलता से मॉडल बना, ट्रेन और डिप्लॉय कर सकें।
एक सामान्य मशीन लर्निंग प्रोजेक्ट में, आप कई चरणों से गुजरते हैं:
हर चरण के लिए अलग टूल्स और कुशल विशेषज्ञों की टीम चाहिए जो इन्हें बिना रुकावट समन्वित करे। Amazon SageMaker इस पूरी प्रक्रिया को एक ही प्लेटफ़ॉर्म में ले आता है। इसके कुछ लाभ निम्नलिखित हैं:
ये लाभ Amazon SageMaker को बड़े पैमाने पर मशीन लर्निंग मॉडल बनाने, ट्रेन करने और डिप्लॉय करने के लिए एक शक्तिशाली और लचीला प्लेटफ़ॉर्म बनाते हैं।
जैसा कि बताया गया, SageMaker AWS इकोसिस्टम का हिस्सा है, जिसमें कई क्लाउड कंप्यूटिंग सॉल्यूशंस शामिल हैं जो स्टोरेज, नेटवर्किंग, डेटाबेस, एनालिटिक्स और मशीन लर्निंग क्षमताएँ प्रदान करते हैं। ये सभी सॉल्यूशंस SageMaker के साथ सिंक में मिलकर आपके मशीन लर्निंग वर्कफ़्लो को एकजुट करते हैं।
इसी कारण, यदि आपका पहले से AWS खाता नहीं है तो SageMaker के लिए आपको एक AWS खाता बनाना होगा।
अपना खाता बनाने के लिए https://aws.amazon.com/ पर जाएँ और नया खाता बनाने की प्रक्रिया का पालन करें।
साइन-अप प्रक्रिया में बिलिंग जानकारी जोड़ना और आपका फ़ोन नंबर सत्यापित करना शामिल है। चिंता न करें — जब तक आप वास्तव में SageMaker की किसी सुविधा का उपयोग शुरू नहीं करते (जो आम तौर पर किफ़ायती होती है), तब तक आपसे शुल्क नहीं लिया जाएगा।
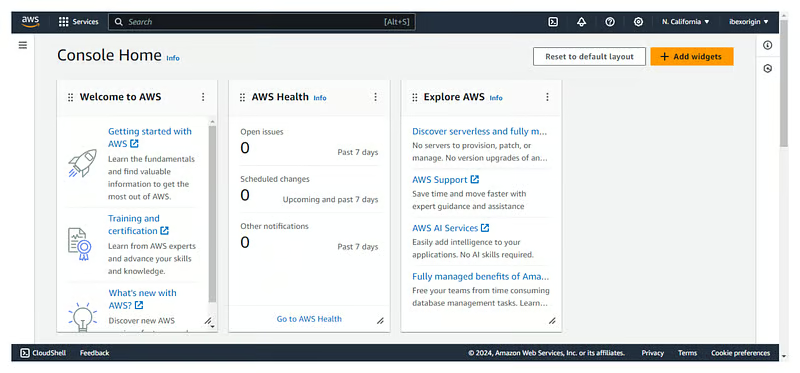
पूरा होने पर, आपको आपके AWS कंसोल पर भेज दिया जाएगा, जो आमतौर पर निम्न छवि जैसा दिखता है। ध्यान दें कि आपके कंसोल में कुछ विजेट अलग हो सकते हैं।
अब हम Amazon के क्लाउड मशीनों पर कोड चलाने के लिए एक JupyterLab सत्र बनाएँगे।
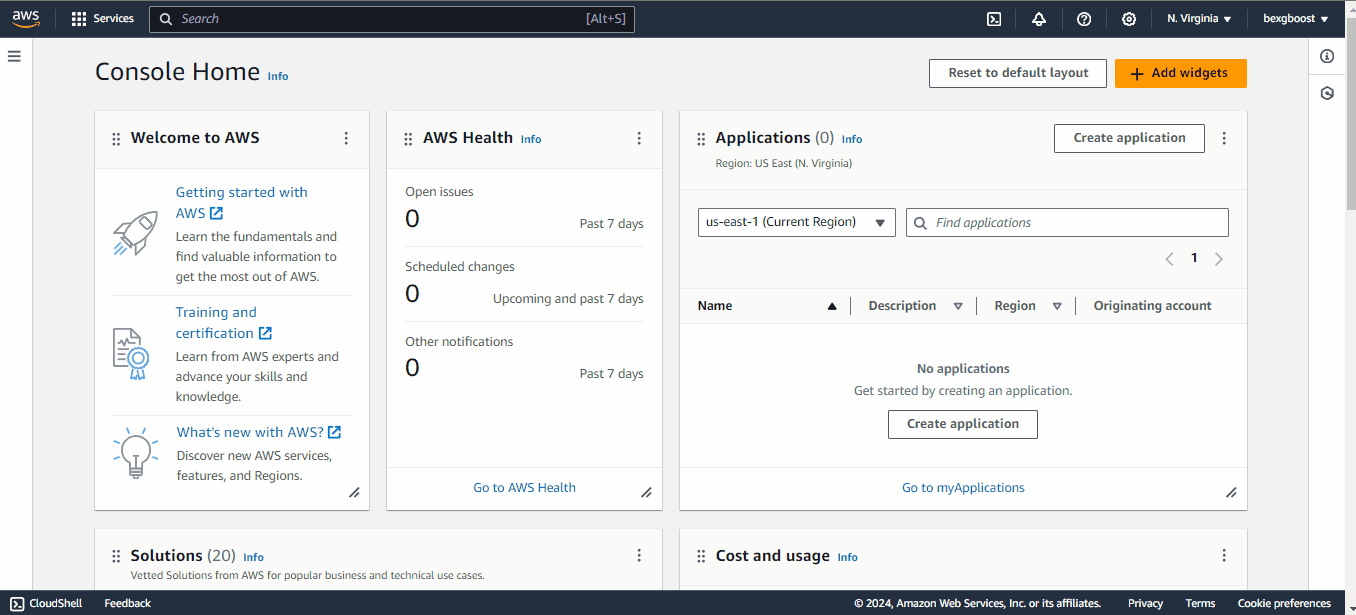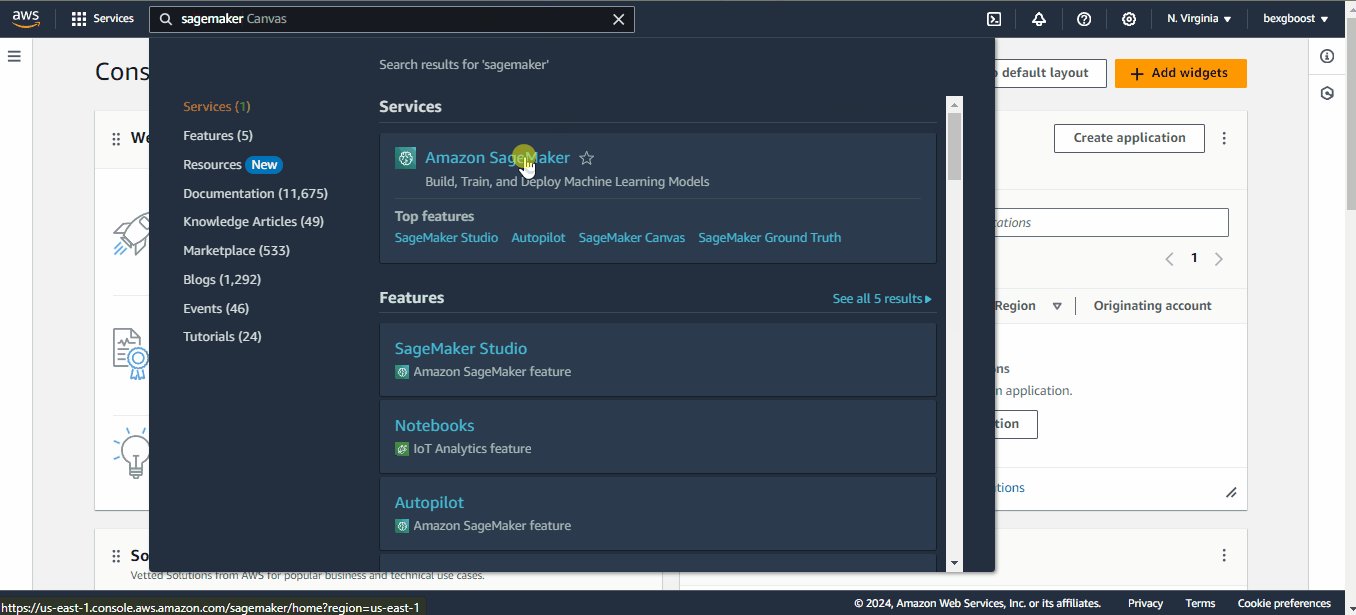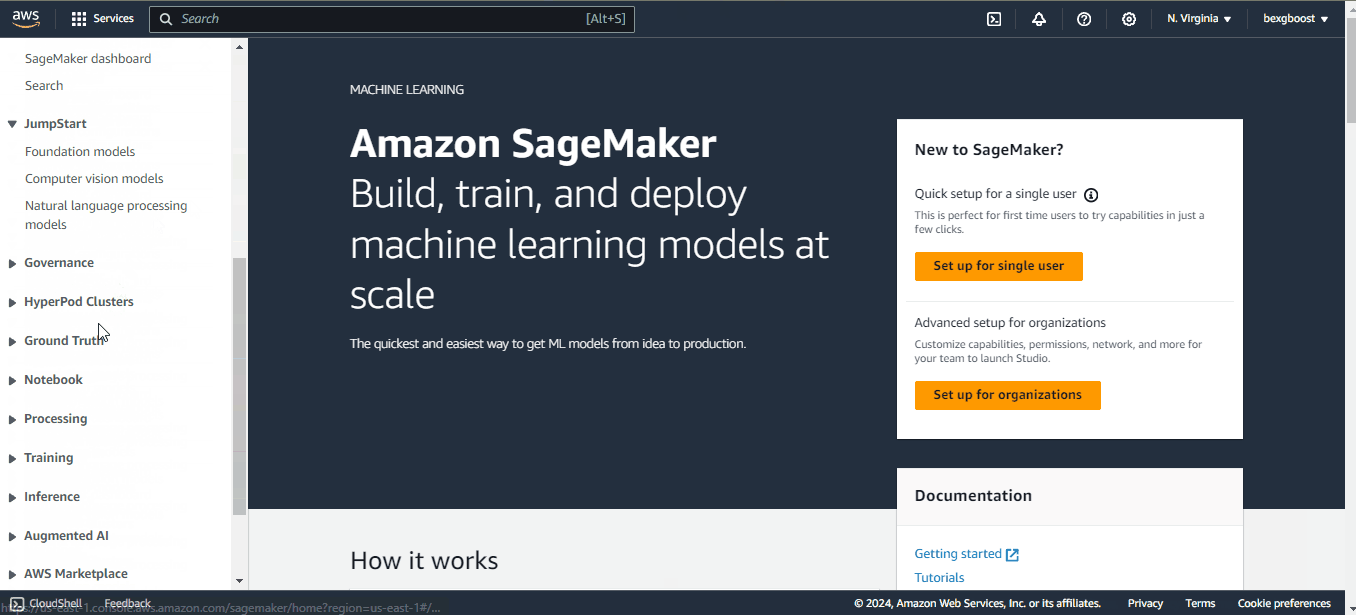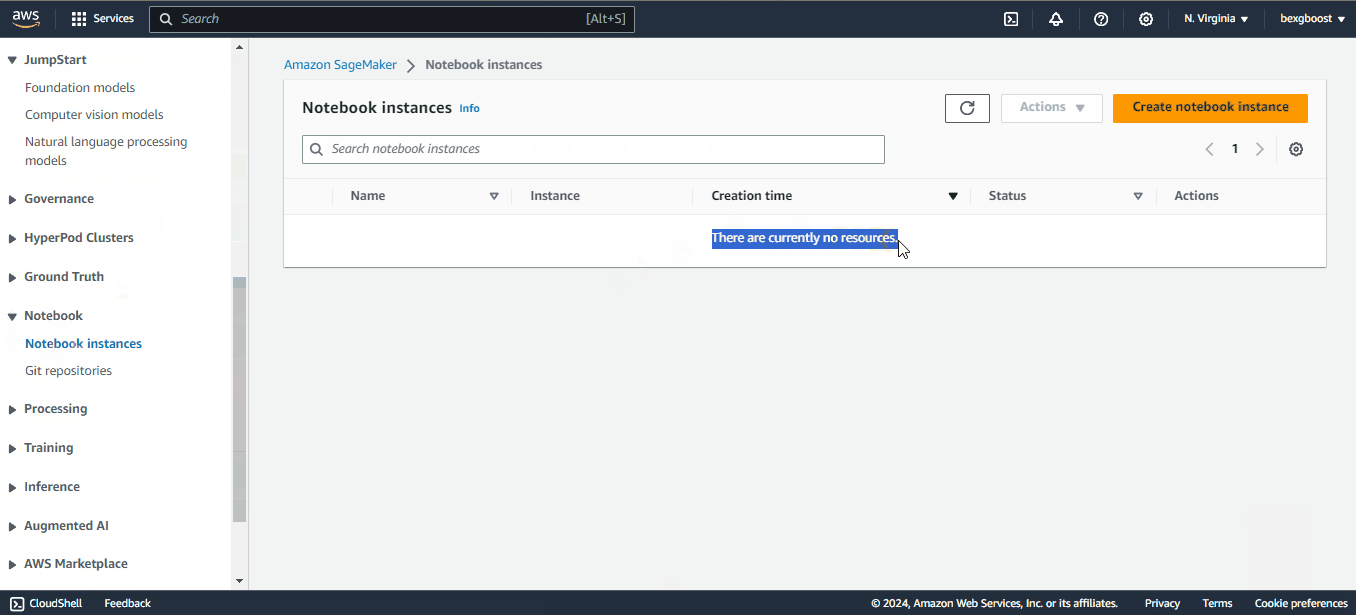
अपने AWS कंसोल से, स्क्रीन के शीर्ष पर स्थित सर्च बार का उपयोग करके SageMaker डैशबोर्ड खोजें:
फिर नीचे स्क्रॉल करके “Notebooks” टैब और उसके अंदर “Notebooks instances” विकल्प खोजें। आपको कोई इंस्टेंस नहीं दिखेगा, इसलिए हमें एक बनाना होगा:
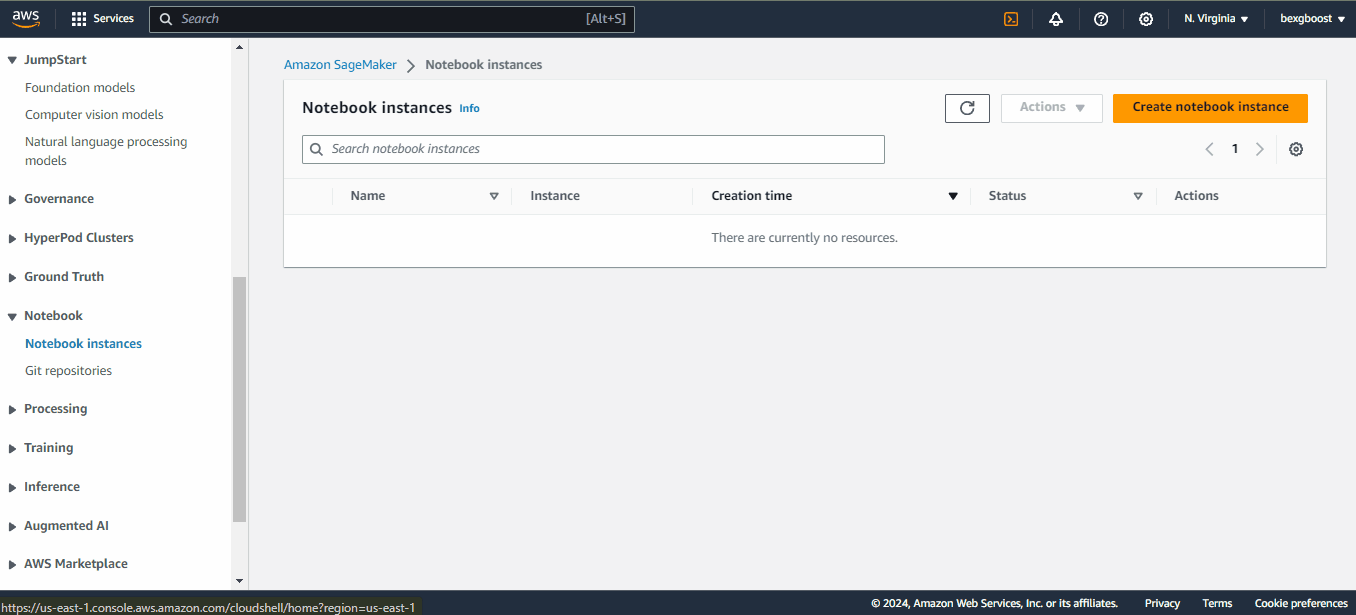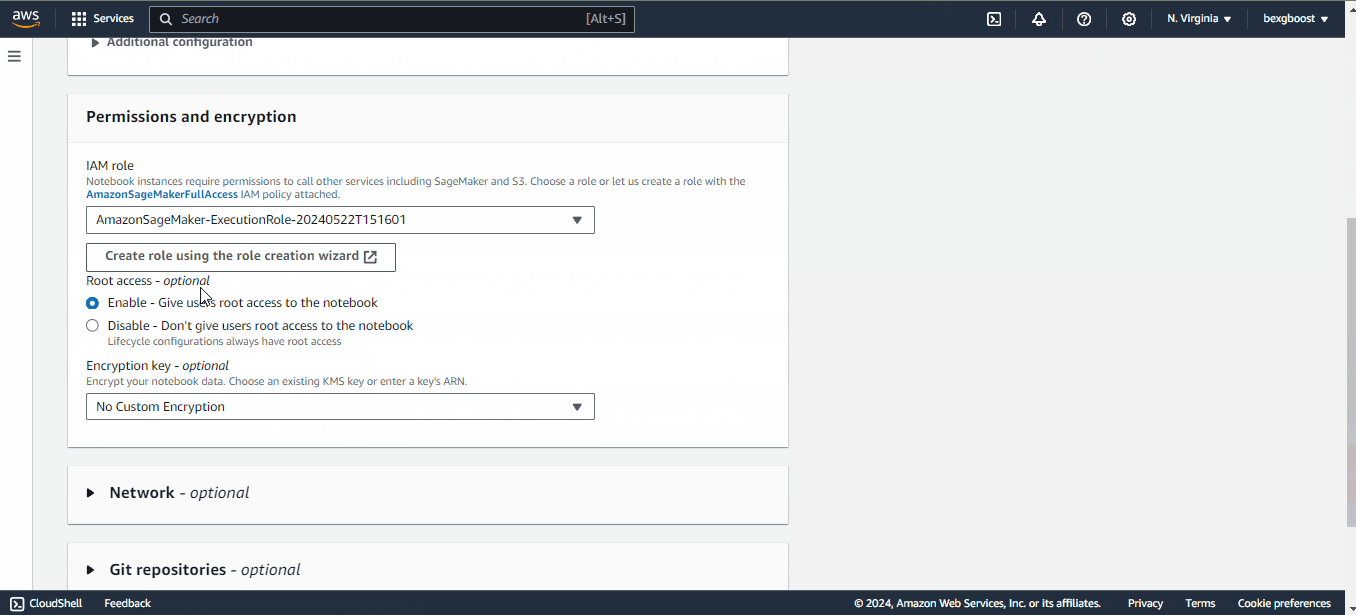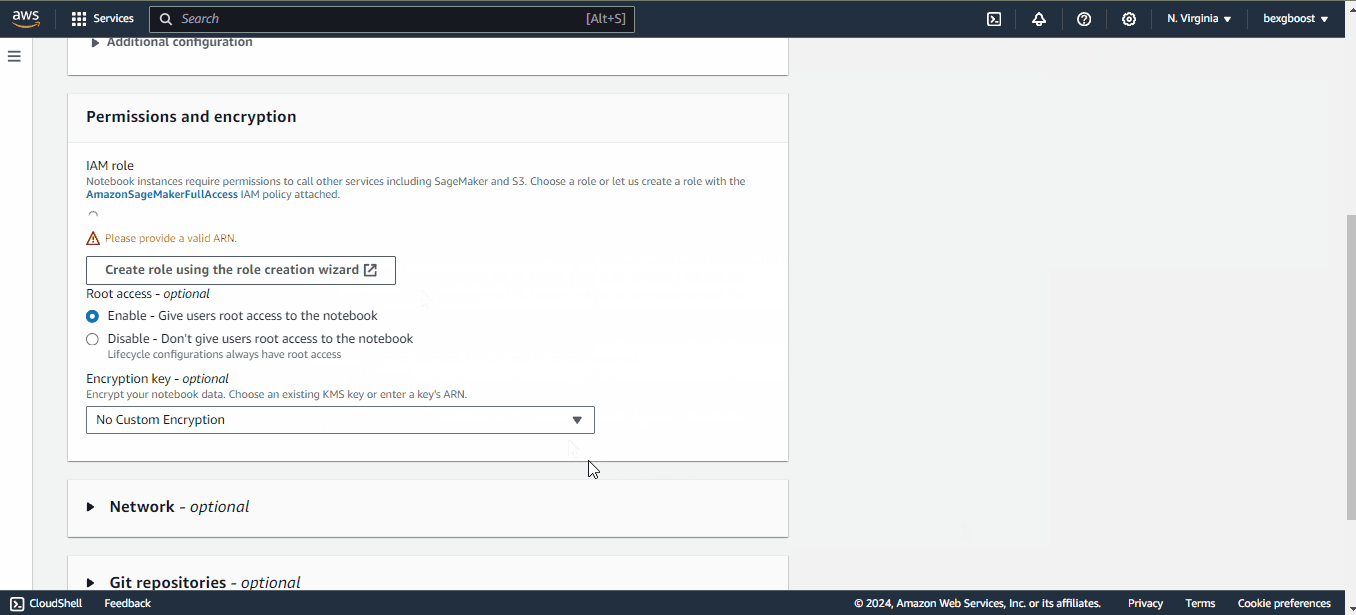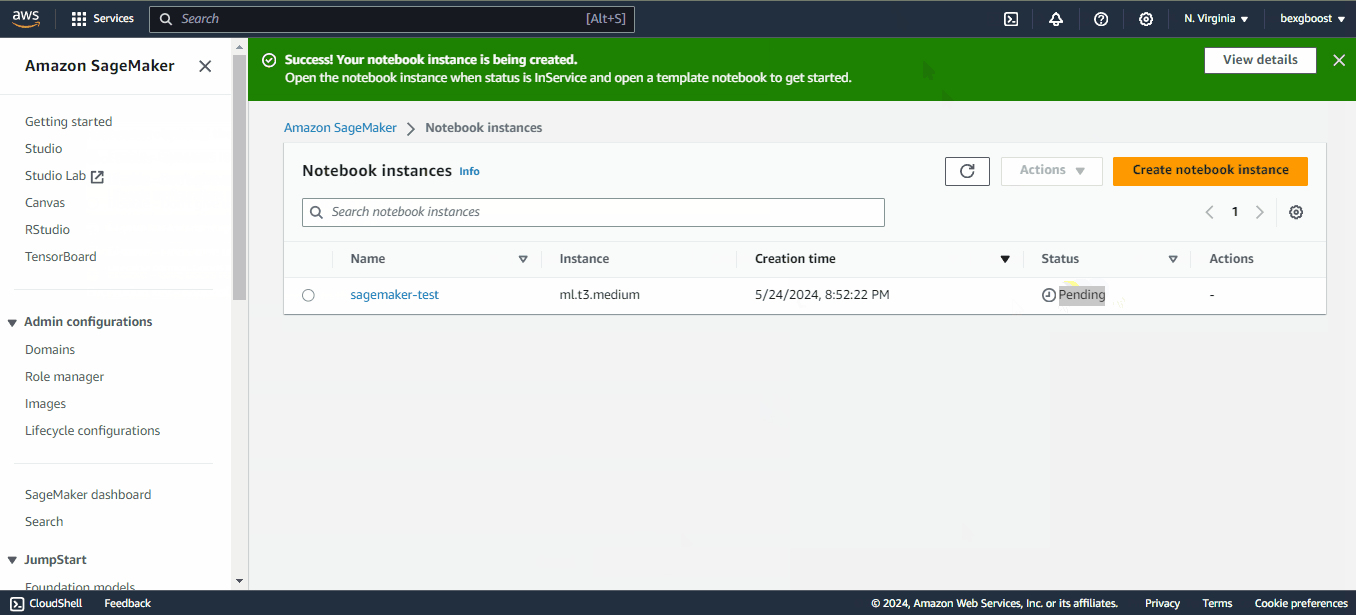
नया नोटबुक बनाने के लिए, स्क्रीन के दाएँ ऊपर “Create notebook instance” पर क्लिक करें। फिर निम्न फ़ील्ड भरें:
sagemaker-test रखा है।सभी आवश्यक जानकारी भरने के बाद, “Create notebook instance” पर क्लिक करें।
जब “Pending” स्टेटस “inService” में बदल जाए, तो नोटबुक के बगल में “Open in JupyterLab” लिंक पर क्लिक करके JupyterLab लॉन्च कर सकते हैं:
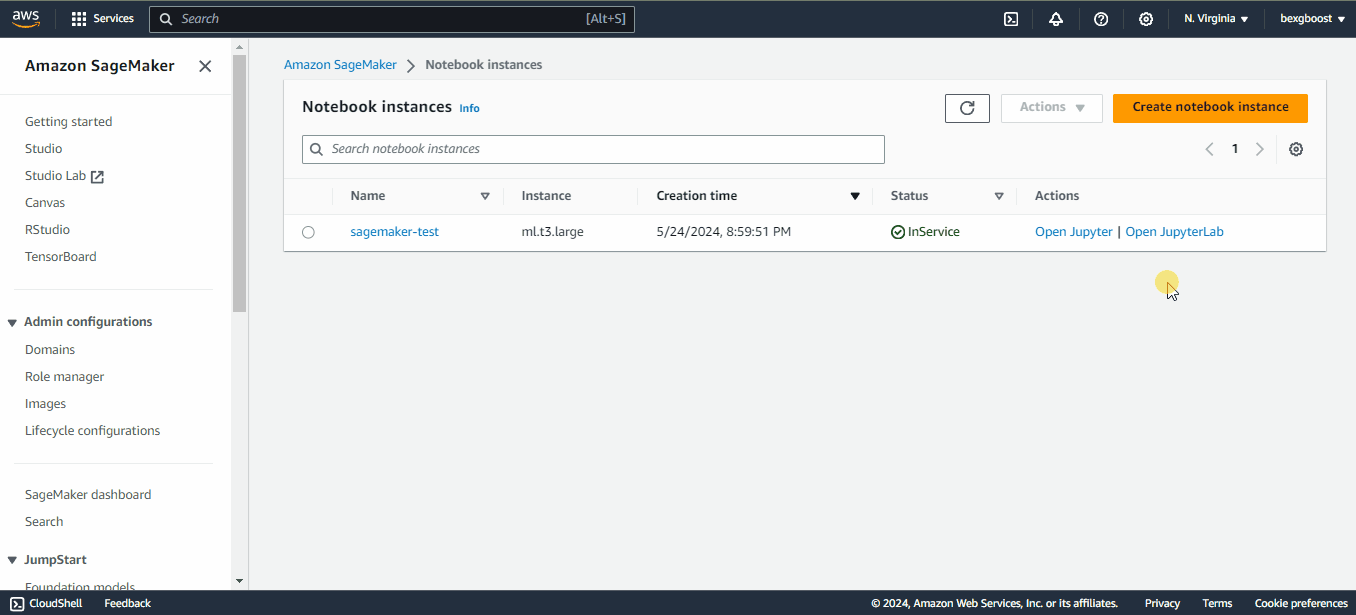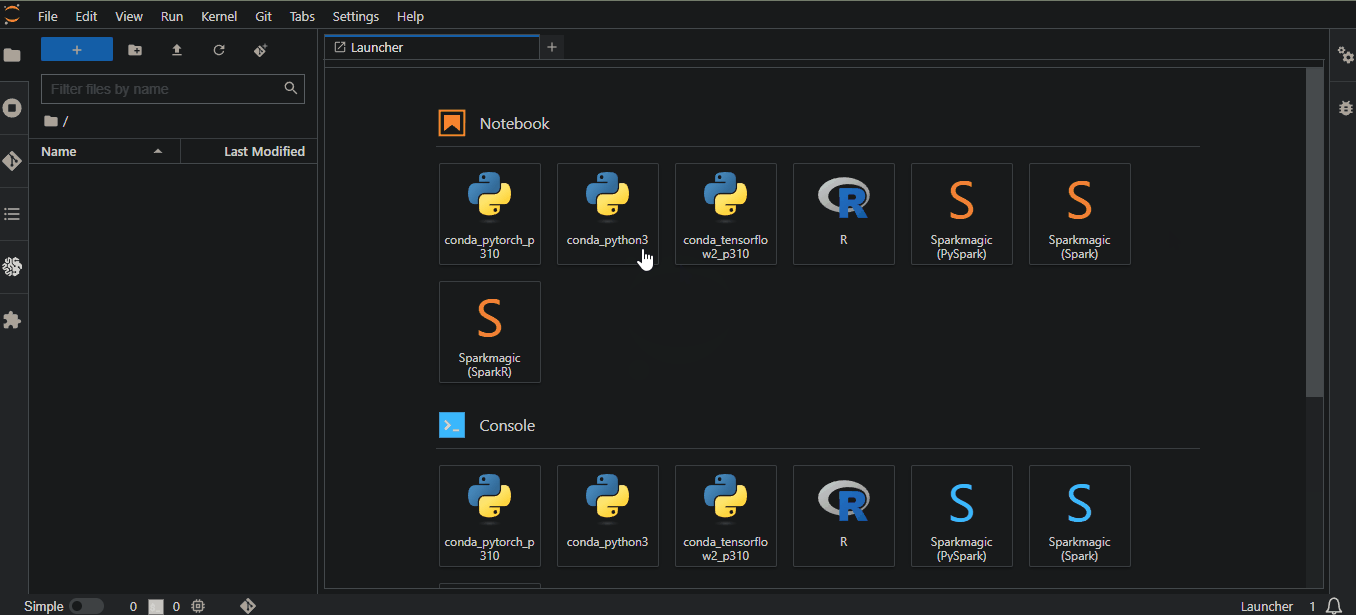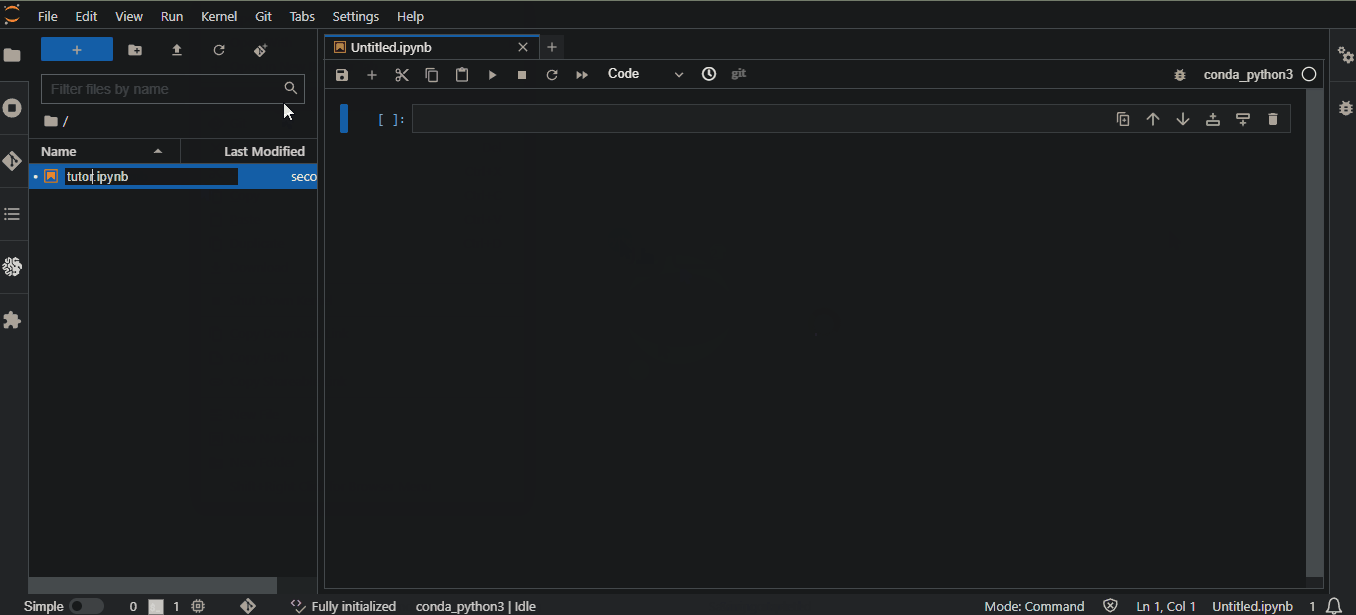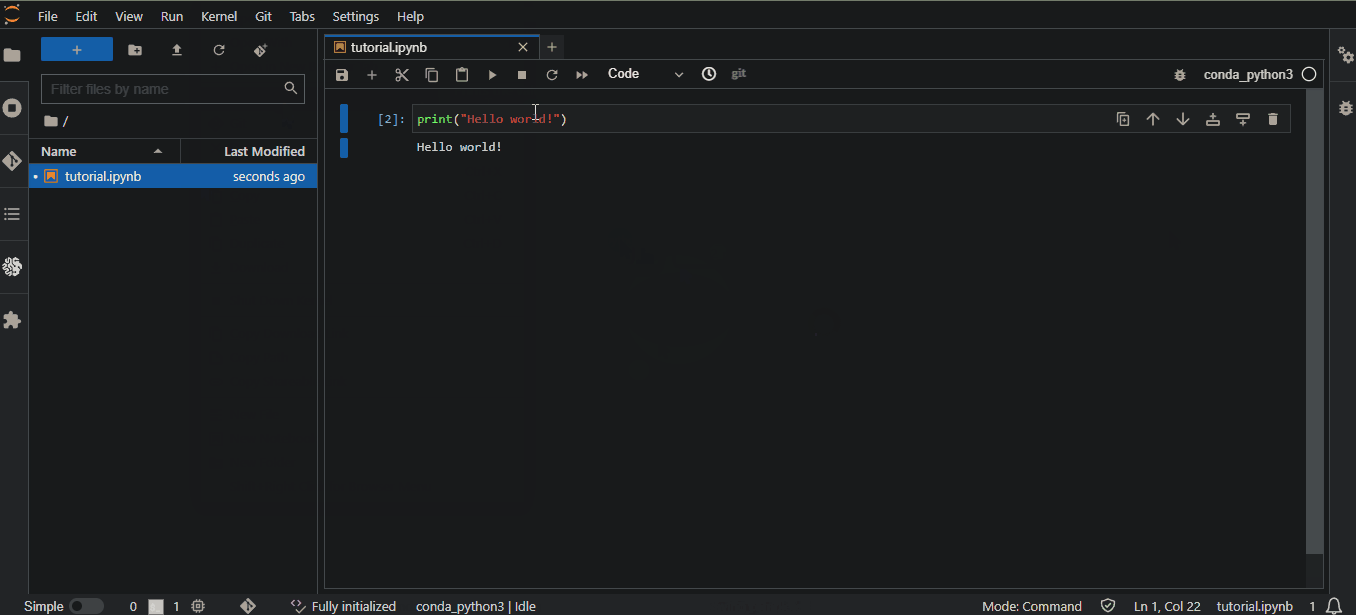
जैसे ही इंस्टेंस सेवा में आता है, समय गणना शुरू हो जाती है और बिलिंग भी। यदि आप ब्रेक लेना चाहते हैं, तो गैर-ज़रूरी लागतों से बचने के लिए “Actions” पर क्लिक करके “Stop” चुनना न भूलें। डिफ़ॉल्ट रूप से आइडल शटडाउन दो घंटे का होता है:
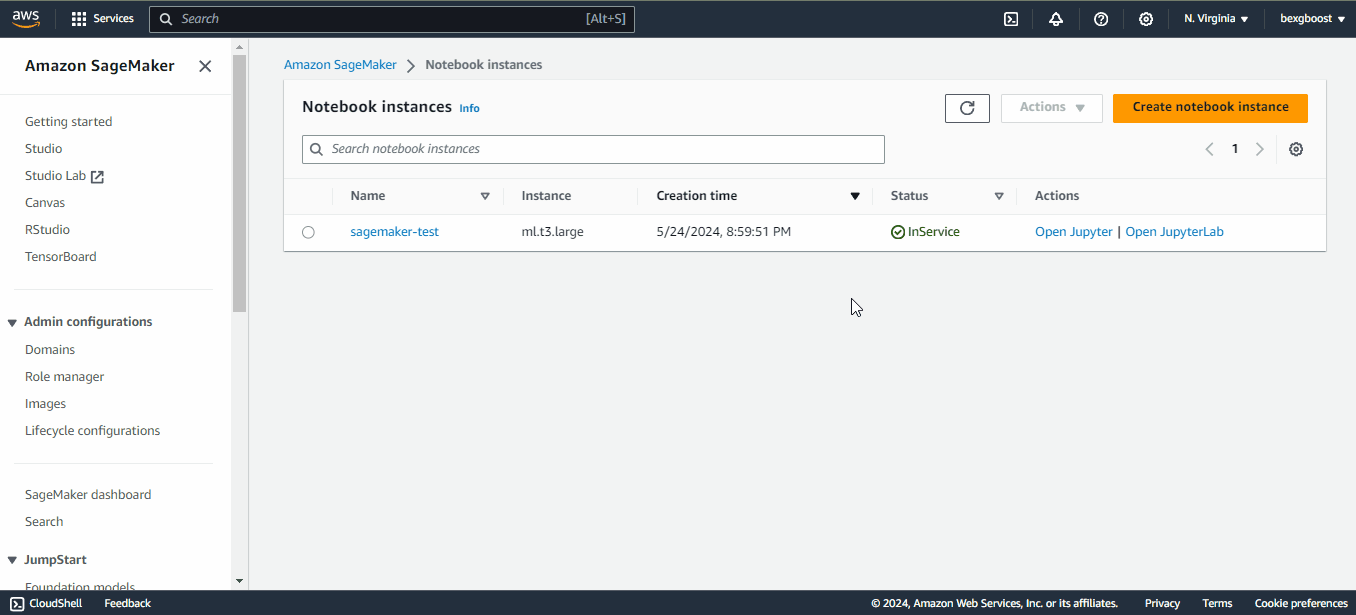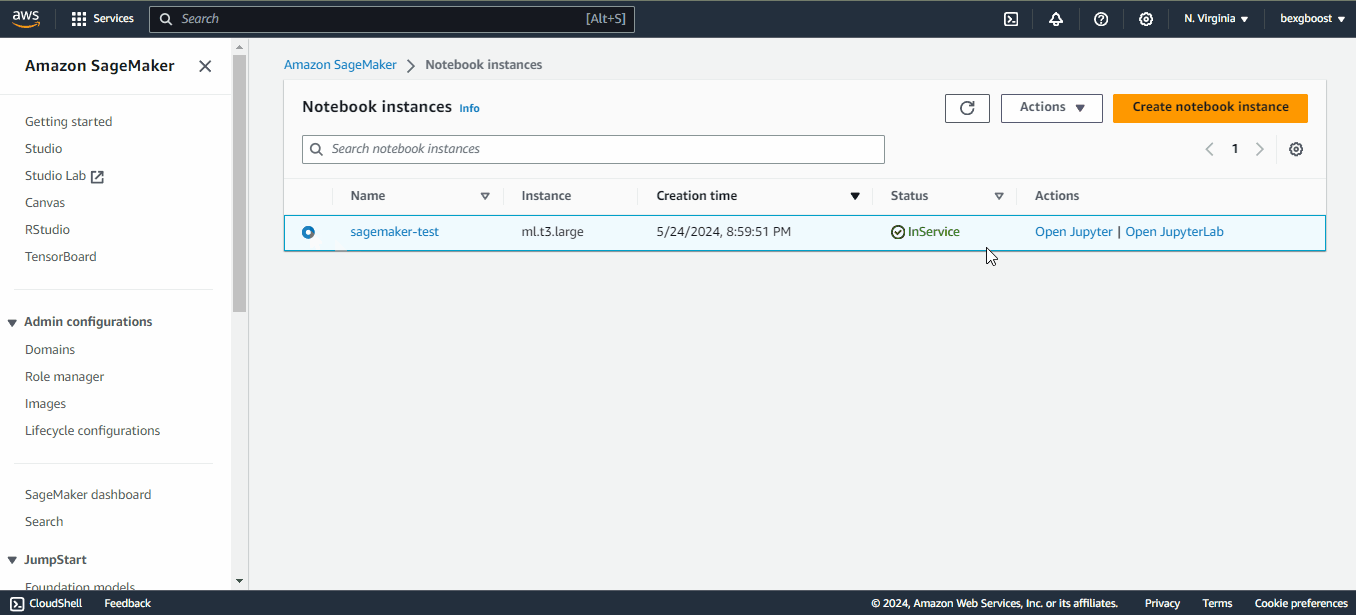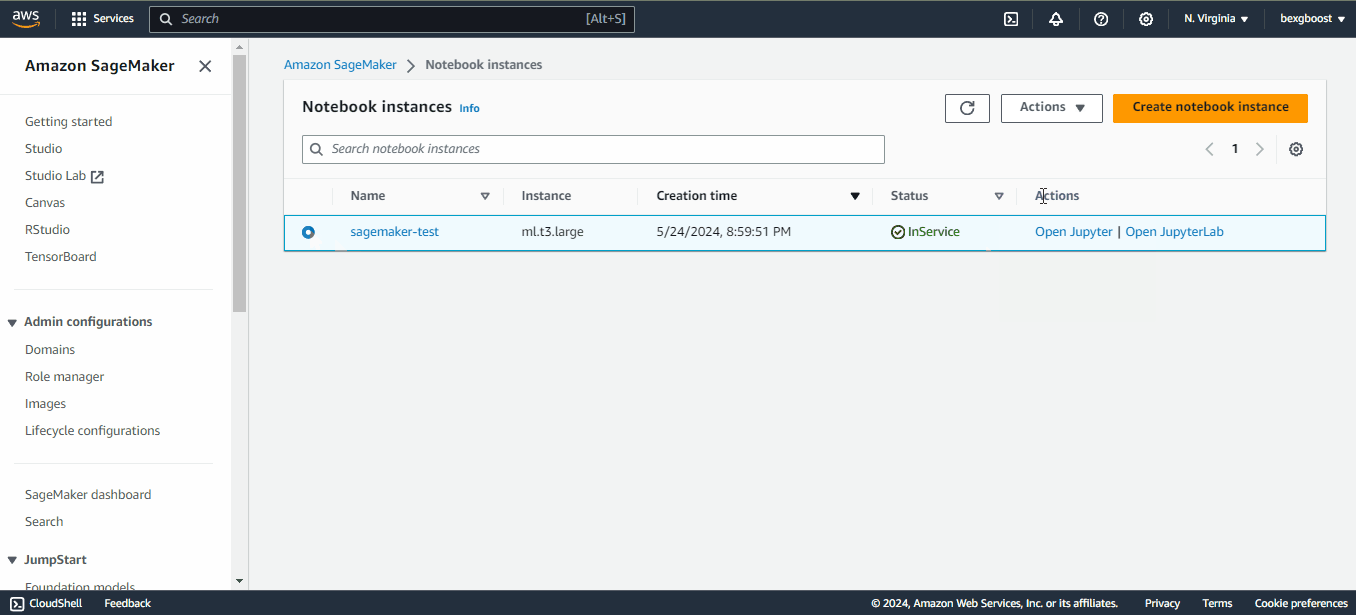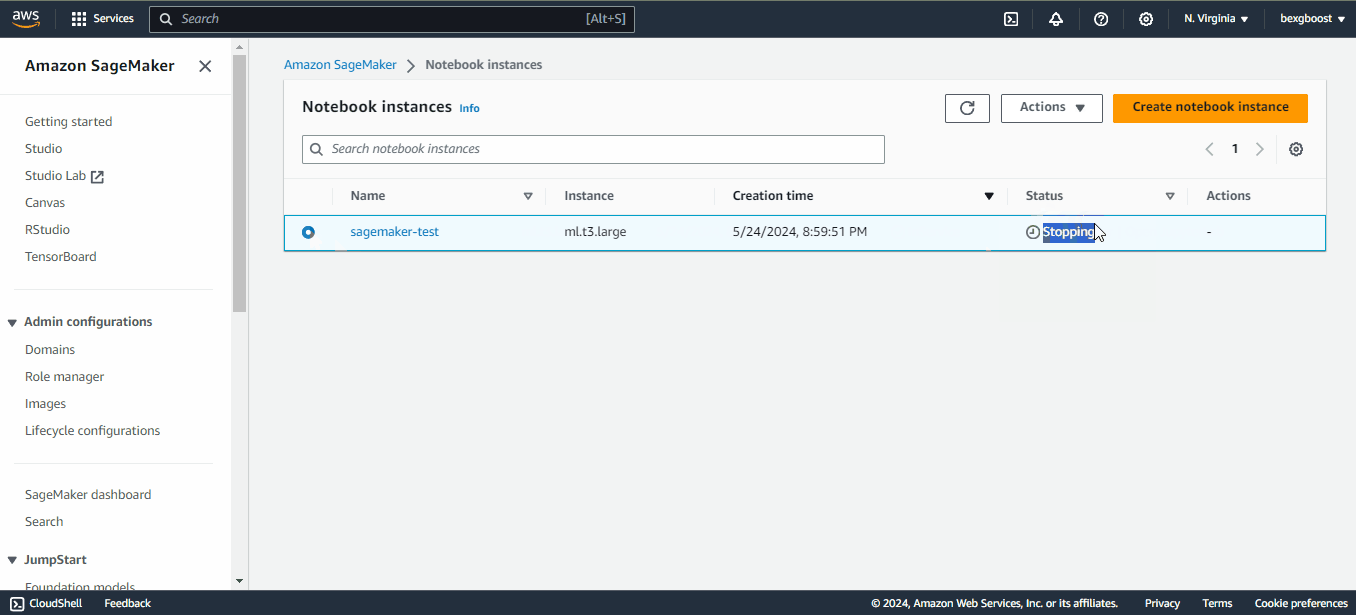
यदि आप कोई नोटबुक इंस्टेंस रोकते हैं, तो बाद में उसे दोबारा शुरू कर सकते हैं। आपका वातावरण सुरक्षित रहेगा।
इस भाग में, हम सीखेंगे कि लोकल फ़ाइल को Amazon के सर्वर पर कैसे अपलोड करें, जो SageMaker के लिए आवश्यक है।
हम UCI ML रिपॉज़िटरी के Dry Bean डेटासेट का उपयोग करके एक मल्टी-क्लास क्लासिफ़ायर बनाएँगे। इसमें बीन्स की 13 हज़ार प्रविष्टियाँ और उनकी 15 संख्यात्मक मापें हैं।
कार्य यह है कि उन्हें सात प्रकार की बीन्स में वर्गीकृत किया जाए: Seker, Barbunya, Bombay, Cali, Dermosan, Horoz और Sira।
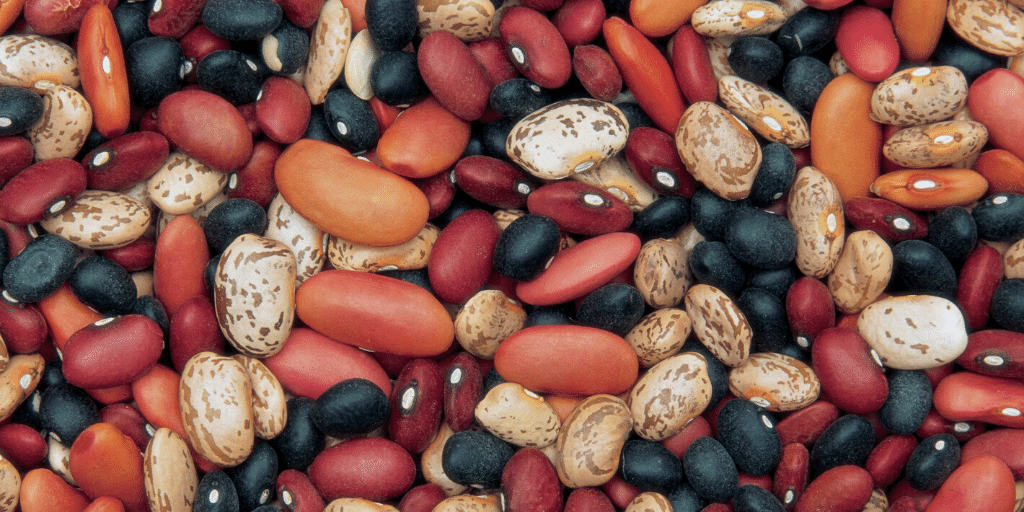
बीन्स के सात प्रकार: Seker, Barbunya, Bombay, Cali, Dermosan, Horoz और Sira।
डाउनलोड करने के बाद, ZIP के अंदर मौजूद Excel फ़ाइल को JupyterLab में अपनी लोकल data डायरेक्टरी के अंदर सेव करें, और फिर अपने नोटबुक में नीचे दिया गया कोड जोड़ें:
from pathlib import Path

cwd = Path.cwd()
data_path = cwd / "data" / "Dry_Bean_Dataset.xlsx"
इसके बाद, निम्न कोड जोड़कर हम pandas से Excel फ़ाइल पढ़ सकते हैं और उसे CSV के रूप में सेव कर सकते हैं:
import pandas as pd

beans = pd.read_excel(data_path)
beans.to_csv(cwd / "data" / "dry_bean.csv", index=False)हमारे डेटासेट को SageMaker द्वारा एक्सेस करने के लिए S3 बकेट में होना चाहिए। AWS S3 एक क्लाउड स्टोरेज समाधान है, जो आपको Amazon सर्वरों पर होस्ट किए गए बकेट्स में प्रोजेक्ट-संबंधित ऑब्जेक्ट्स रखने देता है।
बकेट बनाने के लिए, ये चरण अपनाएँ:
dry-bean-bucket नहीं ले पाएँगे।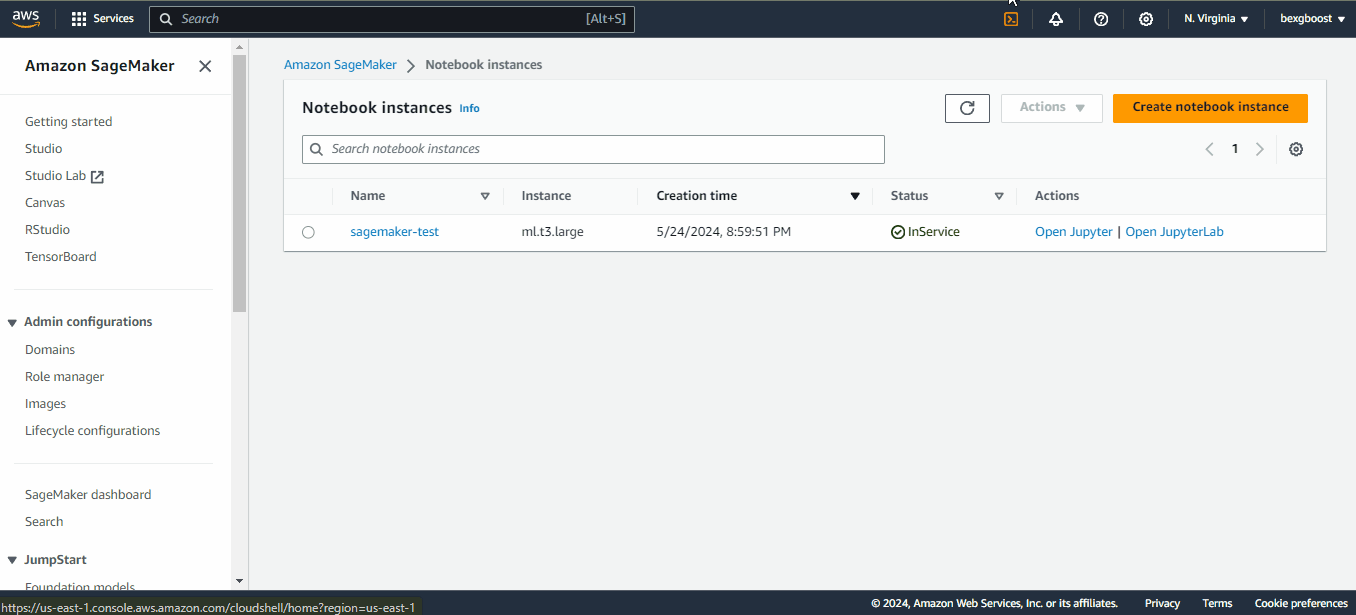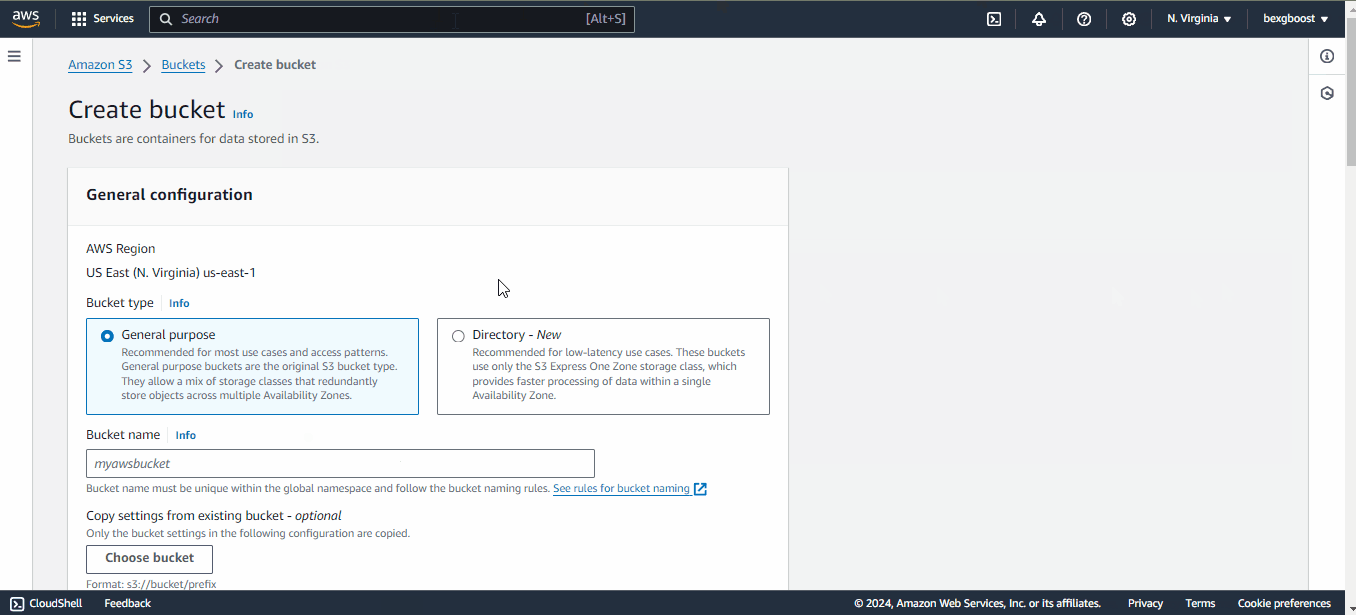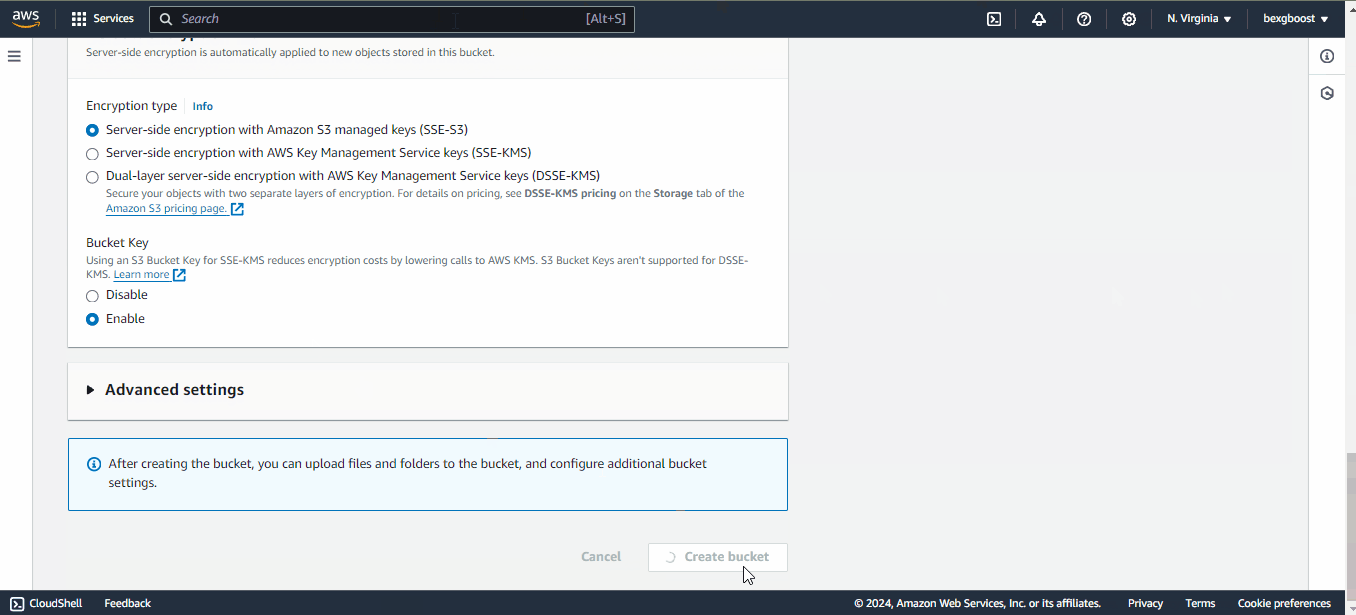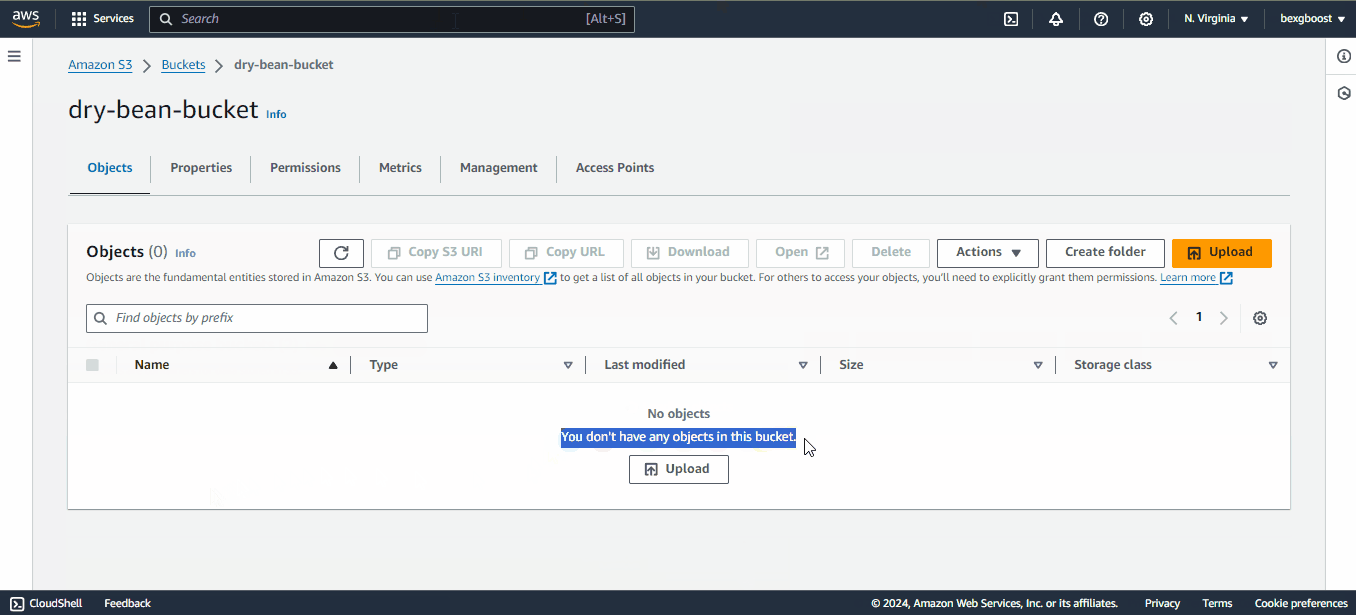
बकेट बन जाने के बाद, पहले सेव की गई CSV फ़ाइल अपलोड करने के लिए उस पर क्लिक करें:
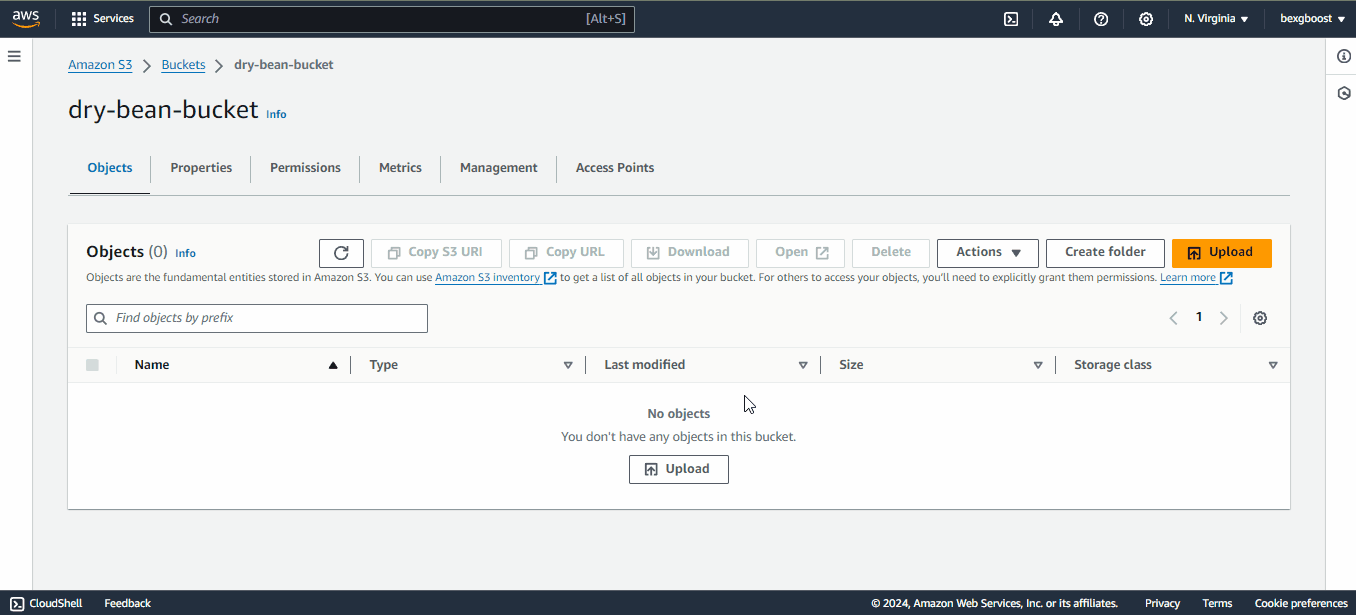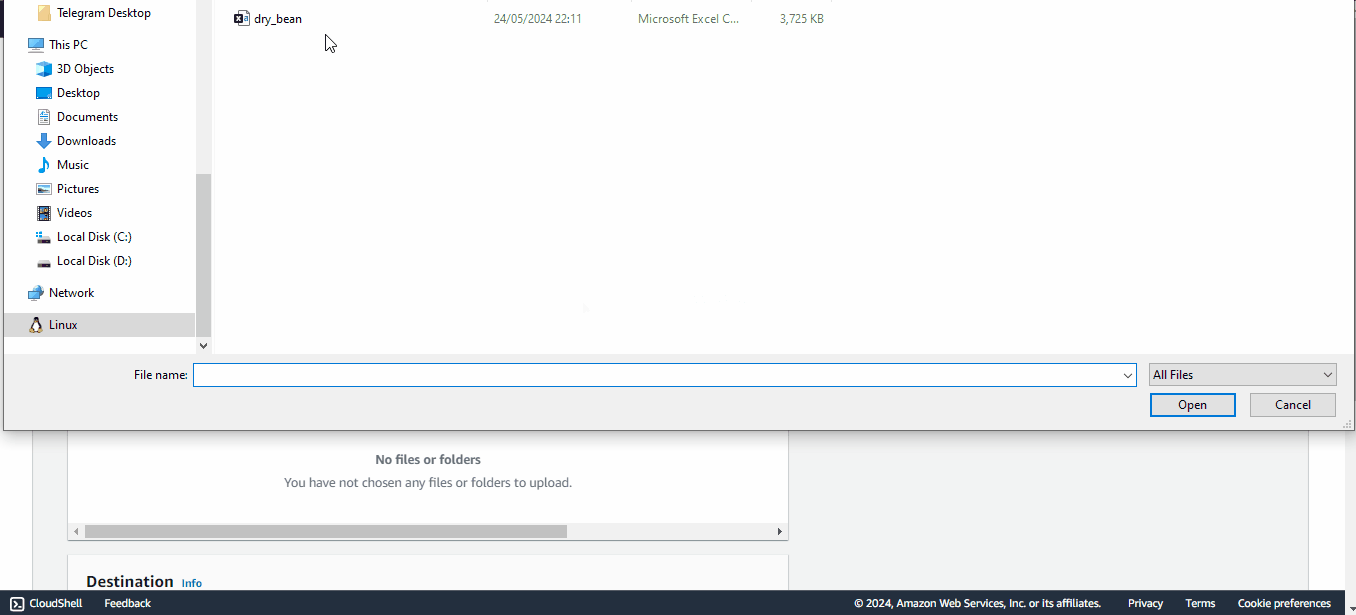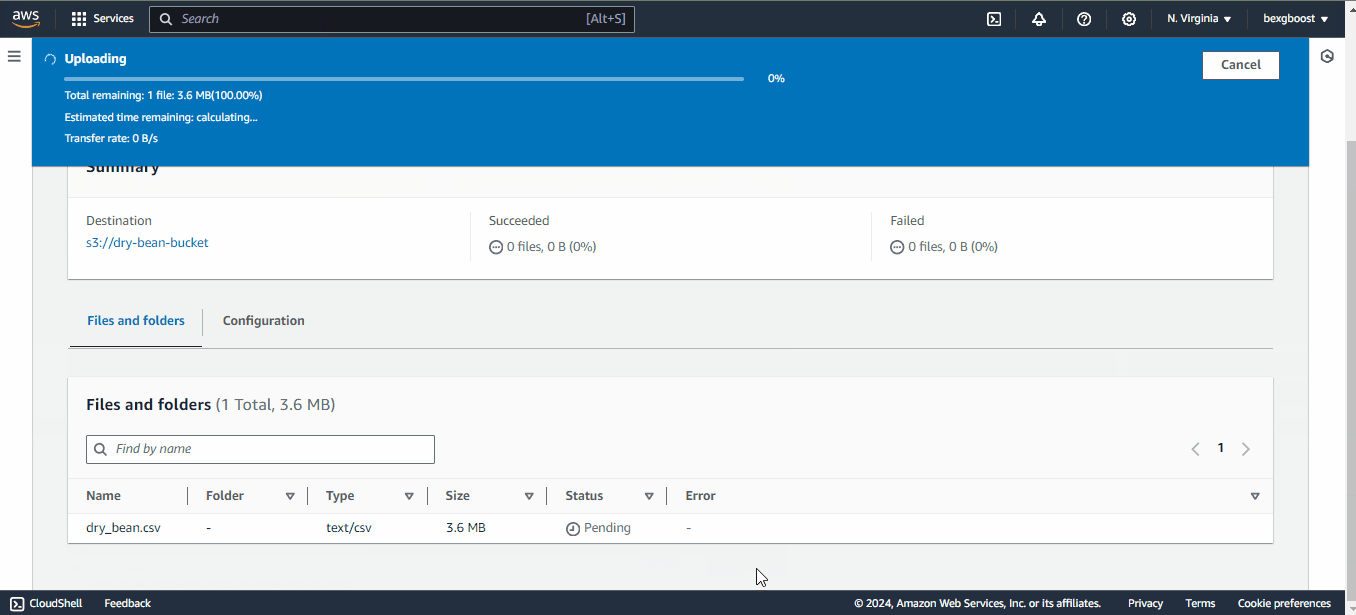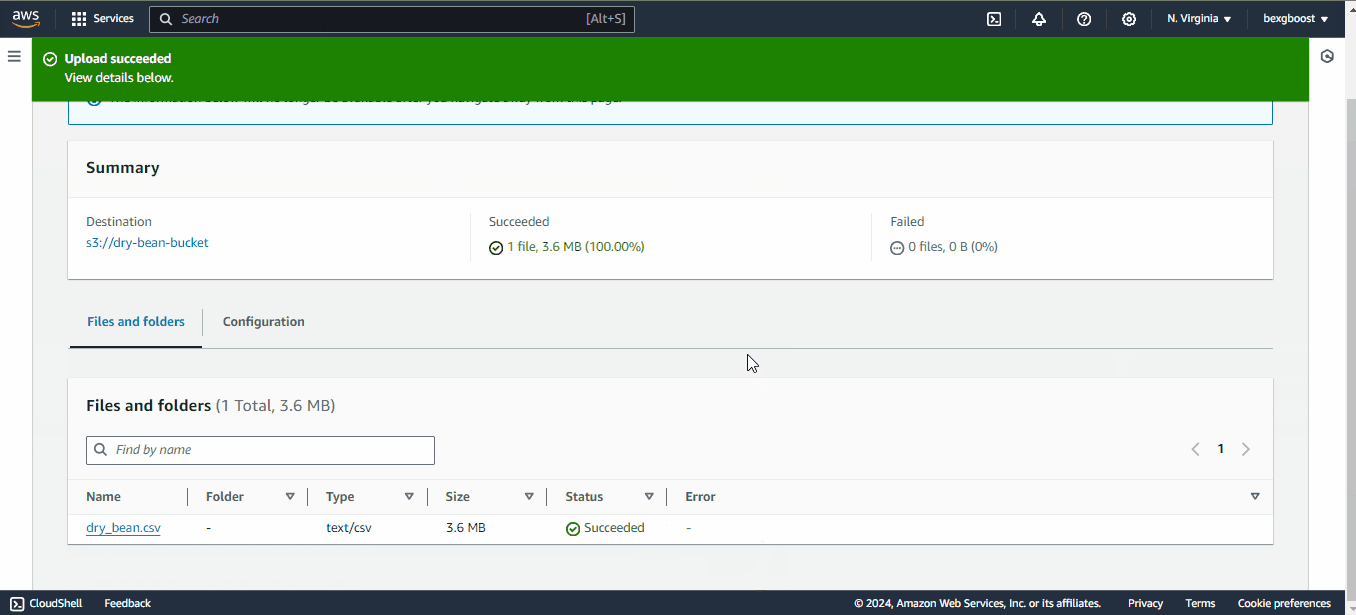
इसके बाद, आप JupyterLab इंटरफ़ेस पर लौट सकते हैं क्योंकि अब हम कुछ कोड चलाएँगे!
इस भाग में, हम एक एंड-टू-एंड वर्कफ़्लो से गुजरेंगे जो हमें CSV डेटासेट से एक ऐसे मॉडल तक ले जाएगा जो किसी एंडपॉइंट पर डिप्लॉय होगा। लेकिन तकनीकी विवरणों में खोने से पहले, एक बार ऊँचे स्तर पर समझ लें कि हम क्या करेंगे।
SageMaker में मशीन लर्निंग करना, लोकल मशीन पर करने से थोड़ा अलग है। शुरुआती चरण हम कवर कर चुके हैं:
आपके लोकल नोटबुक्स की तरह, SageMaker नोटबुक इंस्टेंस एक्सप्लोरेटरी विश्लेषण—डेटा क्लीनिंग, एक्सप्लोरेशन, इन्गेशन और बेसिक एक्सपेरिमेंटेशन—के लिए होते हैं।
जब आप मॉडल ट्रेनिंग चरण पर पहुँचते हैं, तो SageMaker कुछ नियमों के साथ काम करने की अपेक्षा करता है। विशेष रूप से, आपके कस्टम मॉडलों को एंडपॉइंट्स के रूप में डिप्लॉय करने के लिए SageMaker को एक ट्रेनिंग स्क्रिप्ट चाहिए जो निम्नलिखित करे:
स्क्रिप्ट को कमांड-लाइन आर्ग्युमेंट्स के रूप में किसी भी वैरिएबल को डायनेमिक रूप से स्वीकार करना चाहिए। इसलिए, स्क्रिप्ट के अंदर भविष्य में आप जिसे भी बदलना चाहें (मॉडल हाइपरपैरामीटर्स, फ़ाइल पाथ, इत्यादि) उसे कमांड-लाइन आर्ग्युमेंट्स के रूप में सेट करना होगा।
जब यह स्क्रिप्ट तैयार हो जाती है, तो इसे SageMaker द्वारा प्रदान किए गए विशेष एस्टिमेटर्स को दिया जाता है। ये scikit-learn, XGBoost, TensorFlow, PyTorch जैसी लोकप्रिय एमएल लाइब्रेरीज़ के साथी होते हैं। इन एस्टिमेटर्स का उपयोग करके SageMaker आपकी स्क्रिप्ट के चारों ओर Docker कंटेनर बनाता है और उसे बड़े पैमाने पर सर्व करने के लिए एंडपॉइंट के रूप में डिप्लॉय करता है।
जैसे-जैसे हम चरण-दर-चरण आगे बढ़ेंगे, ये सभी बिंदु और अधिक स्पष्ट होते जाएँगे।
आइए आपके द्वारा पहले बनाए गए sagemaker-test नोटबुक के अंदर आवश्यक लाइब्रेरीज़ इम्पोर्ट करने से शुरू करें:
import boto3
import numpy as np
import pandas as pd
import sagemaker
from sagemaker import get_execution_role
from sklearn.model_selection import train_test_split
इन इम्पोर्ट्स में से कुछ का कार्य यह है:
sagemaker आधिकारिक Python SDK है जो Amazon SageMaker पर मशीन लर्निंग मॉडल ट्रेन और डिप्लॉय करता है। इस SDK के साथ, आप लोकप्रिय डीप लर्निंग फ़्रेमवर्क, Amazon द्वारा प्रदान किए गए एल्गोरिद्म, या SageMaker-कम्पैटिबल Docker इमेजेज़ में बनाए गए अपने एल्गोरिद्म का उपयोग कर सकते हैं।boto3 एक और आधिकारिक Python SDK है, लेकिन यह केवल SageMaker ही नहीं, बल्कि सभी AWS सेवाओं के बीच आपके कोड और सेवाओं के बीच पुल का काम करता है। आप इस कोर्स में boto3 के बारे में और जान सकते हैं। इम्पोर्ट्स के बाद, वे संसाधन बनाते हैं जिनकी ज़रूरत पूरे ट्यूटोरियल में पड़ेगी:
sm_boto3 = boto3.client("sagemaker")
sess = sagemaker.Session()boto3 का उपयोग करके SageMaker क्लाइंट ऑब्जेक्ट बनाते हैं। ये दोनों ऑब्जेक्ट्स हमें अलग-अलग तरीकों से SageMaker प्लेटफ़ॉर्म के साथ इंटरैक्ट करने देते हैं।
अब, कुछ ग्लोबल वैरिएबल्स परिभाषित करते हैं जिनकी ज़रूरत पड़ेगी:
region = sess.boto_session.region_name
BUCKET_URI = "s3://dry-bean-bucket"
BUCKET_NAME = "dry-bean-bucket"
DATASET_PATH = f"{BUCKET_URI}/dry_bean.csv"
TARGET_NAME = "Class"
ये वैरिएबल्स स्व-स्पष्टीकरणात्मक हैं और हम इन्हें पूरे ट्यूटोरियल में इस्तेमाल करेंगे।
आपके ज़्यादातर डेटा प्रोजेक्ट्स में, ट्रेनिंग डेटासेट BigQuery, GCS, या AWS S3 बकेट जैसे क्लाउड स्टोरेज में होगा। हमने अपना आख़िरी वाले में सेव किया है, तो pandas का उपयोग करके उसे लोड करते हैं। ऐसा करने के लिए अपने नोटबुक में नीचे दिया गया कोड जोड़ें और चलाएँ:
dry_bean = pd.read_csv(DATASET_PATH)
dry_bean.head()
SageMaker नोटबुक पर काम करने का एक फ़ायदा यह है कि हम pandas के ज़रिए सीधे S3 से फ़ाइलें पढ़ सकते हैं। सभी SageMaker वातावरण आपके क्रेडेंशियल्स के साथ कॉन्फ़िगर होते हैं ताकि pandas बकेट से CSV डाउनलोड कर सके। अगर आप इसे लोकल पर चलाते, तो यह कोड काम नहीं करता।
EDA (Exploratory Data Analysis) करना हर प्रोजेक्ट का हिस्सा होना चाहिए, और यह अपवाद नहीं है। हालाँकि, यहाँ हम गहराई में नहीं जाएँगे क्योंकि यह हमें लेख के मुख्य विषय से भटका देगा।
हम कुछ सारांश सांख्यिकी और चार्ट्स प्रिंट करने पर संतुष्ट रहेंगे:
dry_bean.info()<class 'pandas.core.frame.DataFrame'>
RangeIndex: 13611 entries, 0 to 13610
Data columns (total 17 columns):
# Column Non-Null Count Dtype
--- ------ -------------- -----
0 Area 13611 non-null int64
1 Perimeter 13611 non-null float64
2 MajorAxisLength 13611 non-null float64
3 MinorAxisLength 13611 non-null float64
4 AspectRation 13611 non-null float64
5 Eccentricity 13611 non-null float64
6 ConvexArea 13611 non-null int64
7 EquivDiameter 13611 non-null float64
8 Extent 13611 non-null float64
9 Solidity 13611 non-null float64
10 roundness 13611 non-null float64
11 Compactness 13611 non-null float64
12 ShapeFactor1 13611 non-null float64
13 ShapeFactor2 13611 non-null float64
14 ShapeFactor3 13611 non-null float64
15 ShapeFactor4 13611 non-null float64
16 Class 13611 non-null object
dtypes: float64(14), int64(2), object(1)
memory usage: 1.8+ MBऊपर दी गई जानकारी बताती है कि 16 संख्यात्मक फ़ीचर्स हैं और एक टारगेट Class नाम का है। डेटासेट छोटा है—सिर्फ़ 13 हज़ार प्रविष्टियाँ—इसलिए हमें शक्तिशाली मशीनों की ज़रूरत नहीं पड़ेगी और न ही मॉडल ट्रेन करने में ज़्यादा लागत आएगी।
अब seaborn का उपयोग करके कुछ महत्वपूर्ण फ़ीचर्स का पेयर प्लॉट बनाते हैं:
import seaborn as sns

sns.pairplot(
   dry_bean,
   vars=["Area", "MajorAxisLength", "MinorAxisLength", "Eccentricity", "roundness"],
   hue="Class",
);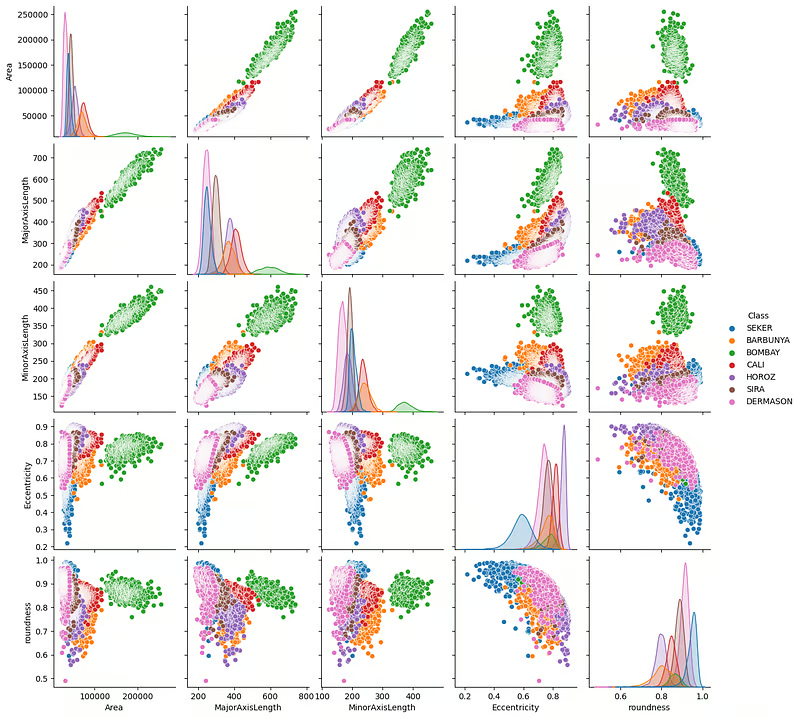
ऊपर दिए प्लॉट दिखाते हैं कि बीन्स उनकी भौतिक मापों के आधार पर स्पष्ट रूप से अलग-अलग हैं। हरे रंग वाले बीन्स (Bombay) विशेष रूप से अच्छी तरह परिभाषित हैं।
हम फ़ीचर्स के बीच संबंध देखने के लिए एक कोरिलेशन मैट्रिक्स भी प्लॉट कर सकते हैं:
import matplotlib.pyplot as plt

correlation = dry_bean.corr(numeric_only=True)

# Create a square heatmap with center at 0
sns.heatmap(correlation, center=0, square=True, cmap="coolwarm", vmin=-1, vmax=1)
plt.show()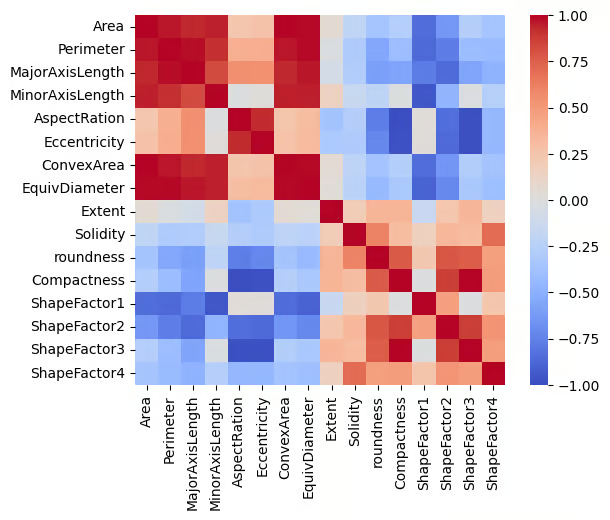
प्लॉट कई पूर्णतः सहसंबद्ध (पॉज़िटिव और नेगेटिव) फ़ीचर्स दिखाता है, जो तर्कसंगत है क्योंकि सभी फ़ीचर्स भौतिक मापों से संबंधित हैं।
इस बिंदु पर, आगे की एक्सप्लोरेशन आप पर छोड़ता हूँ।
एक्सप्लोरेशन के बाद, ट्रेनिंग से पहले आपको अपने डेटासेट में किसी भी क्वालिटी या तार्किक समस्याओं को सुलझाना चाहिए और आवश्यक हो तो नए फ़ीचर्स इंजीनियर करने चाहिए।
Dry Bean डेटासेट काफ़ी क्लीन है, इसलिए हमारा काम आसान है। हमें सिर्फ़ टारगेट को एन्कोड करना है क्योंकि इसमें टेक्स्ट है। हम यह scikit-learn से करेंगे:
from sklearn.preprocessing import LabelEncoder

# For preprocessing
df = dry_bean.copy(deep=True)

# Encode the target
le = LabelEncoder()
df[TARGET_NAME] = le.fit_transform(df[TARGET_NAME])
प्रोसेसिंग के बाद, हमें डेटासेट को स्प्लिट करना होगा:
from sklearn.model_selection import train_test_split

# Split the data into two sets
train, test = train_test_split(df, random_state=1, test_size=0.2)
आप चाहें तो डेटा को तीसरे वैलिडेशन सेट में भी बाँट सकते हैं, लेकिन हम अभी इसे सरल ही रखेंगे।
अब डेटासेट्स को CSV के रूप में सेव करते हैं:
train.to_csv("dry-bean-train.csv")
test.to_csv("dry-bean-test.csv")
और उन्हें अपने S3 बकेट में अपलोड करते हैं:
# Send data to S3. SageMaker will take training data from s3
trainpath = sess.upload_data(
   path="dry-bean-train.csv",
   bucket=BUCKET_NAME,
   key_prefix="sagemaker/sklearncontainer",
)

testpath = sess.upload_data(
   path="dry-bean-test.csv",
   bucket=BUCKET_NAME,
   key_prefix="sagemaker/sklearncontainer",
)
सेशन ऑब्जेक्ट का .upload_data() फ़ंक्शन अपलोड की गई फ़ाइल का पूरा पाथ लौटाता है, जो क्रमशः trainpath और testpath वैरिएबल्स में स्टोर होता है। हम बाद में इन पाथ्स का उपयोग करेंगे।
एक नए नोटबुक सेल में, निम्न कोड पेस्ट करें:
%%writefile script.py

import argparse
import os
import joblib
import numpy as np
import pandas as pd
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import balanced_accuracy_score

if __name__ == "__main__":
   print("extracting arguments")
   parser = argparse.ArgumentParser()

   # Hyperparameters sent by the client are passed as command-line arguments to the script.
   parser.add_argument("--n-estimators", type=int, default=10)
   parser.add_argument("--min-samples-leaf", type=int, default=3)

   # Data, model, and output directories
   parser.add_argument("--model-dir", type=str, default=os.environ.get("SM_MODEL_DIR"))
   parser.add_argument("--train", type=str, default=os.environ.get("SM_CHANNEL_TRAIN"))
   parser.add_argument("--test", type=str, default=os.environ.get("SM_CHANNEL_TEST"))
   parser.add_argument("--train-file", type=str, default="dry-bean-train.csv")
   parser.add_argument("--test-file", type=str, default="dry-bean-test.csv")
   args, _ = parser.parse_known_args()

   print("reading data")

   train_df = pd.read_csv(os.path.join(args.train, args.train_file))
   test_df = pd.read_csv(os.path.join(args.test, args.test_file))

   print("building training and testing datasets")

   X_train = train_df.drop("Class", axis=1)
   X_test = test_df.drop("Class", axis=1)
   y_train = train_df[["Class"]]
   y_test = test_df[["Class"]]

   # Train model
   print("training model")

   model = RandomForestClassifier(
       n_estimators=args.n_estimators,
       min_samples_leaf=args.min_samples_leaf,
       n_jobs=-1,
   )

   model.fit(X_train, y_train)

   # Print abs error
   print("validating model")

   bal_acc_train = balanced_accuracy_score(y_train, model.predict(X_train))
   bal_acc_test = balanced_accuracy_score(y_test, model.predict(X_test))

   print(f"Train balanced accuracy: {bal_acc_train:.3f}")
   print(f"Test balanced accuracy: {bal_acc_test:.3f}")

   # Persist model
   path = os.path.join(args.model_dir, "model.joblib")
   joblib.dump(model, path)
   print("model persisted at " + path)
ऊपर दी गई स्क्रिप्ट में %%writefile script.py मैजिक कमांड सेल की सामग्री को रन करने के बजाय एक Python स्क्रिप्ट में बदल देती है।
अब, स्क्रिप्ट में स्टेप-बाय-स्टेप क्या हो रहा है, देखते हैं:
import argparse
import os
import joblib
import numpy as np
import pandas as pd
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import balanced_accuracy_score
सबसे पहले, कुछ आवश्यक लाइब्रेरीज़ इम्पोर्ट करते हैं।
if __name__ == "__main__":
   print("extracting arguments")
   parser = argparse.ArgumentParser()

   # Hyperparameters sent by the client are passed as command-line arguments to the script.
   parser.add_argument("--n-estimators", type=int, default=10)
   parser.add_argument("--min-samples-leaf", type=int, default=3)

   # Data, model, and output directories
   parser.add_argument("--model-dir", type=str, default=os.environ.get("SM_MODEL_DIR"))
   parser.add_argument("--train", type=str, default=os.environ.get("SM_CHANNEL_TRAIN"))
   parser.add_argument("--test", type=str, default=os.environ.get("SM_CHANNEL_TEST"))
   parser.add_argument("--train-file", type=str, default="dry-bean-train.csv")
   parser.add_argument("--test-file", type=str, default="dry-bean-test.csv")
   args, _ = parser.parse_known_args()
इसके बाद, हम एक आर्ग्युमेंट पार्सर ऑब्जेक्ट बनाते हैं ताकि कमांड-लाइन आर्ग्युमेंट्स पढ़ सकें। जैसा कि मैंने बताया, भविष्य में अपडेट होने वाली कोई भी वैल्यू CLI आर्ग्युमेंट्स के रूप में पास की जानी चाहिए। यह सेक्शन उन्हीं आर्ग्युमेंट्स को परिभाषित करता है:
यदि आप model-dir, train और test डायरेक्टरीज़ के डिफ़ॉल्ट वैल्यूज़ पर ध्यान दें, तो आपको कुछ एनवायरनमेंट वैरिएबल्स दिखेंगे। ये SageMaker SDK डॉक्स से लिए गए हैं, जो ऐसी स्क्रिप्ट फ़ाइलें लिखने के निर्देश भी देती हैं।
print("reading data")
train_df = pd.read_csv(os.path.join(args.train, args.train_file))
test_df = pd.read_csv(os.path.join(args.test, args.test_file))
print("building training and testing datasets")
X_train = train_df.drop("Class", axis=1)
X_test = test_df.drop("Class", axis=1)
y_train = train_df[["Class"]]
y_test = test_df[["Class"]]
डायनेमिक वैल्यूज़ परिभाषित करने के बाद, हम ट्रेनिंग और टेस्टिंग डेटासेट्स को पढ़ते और बनाते हैं। जैसा कि आप देख सकते हैं, हार्ड-कोडेड पाथ पास करने की बजाय, हम args.argument वैल्यूज़ का उपयोग कर रहे हैं।
# Train model
print("training model")

model = RandomForestClassifier(
    n_estimators=args.n_estimators,
    min_samples_leaf=args.min_samples_leaf,
    n_jobs=-1,
)

model.fit(X_train, y_train)

# Print abs error
print("validating model")

bal_acc_train = balanced_accuracy_score(y_train, model.predict(X_train))
bal_acc_test = balanced_accuracy_score(y_test, model.predict(X_test))

print(f"Train balanced accuracy: {bal_acc_train:.3f}")
print(f"Test balanced accuracy: {bal_acc_test:.3f}")
हम मॉडल को ट्रेन करते हैं, फिर उसे ट्रेनिंग और टेस्ट दोनों डेटासेट्स पर इवैल्युएट करते हैं और प्रदर्शन प्रिंट करते हैं।
# Persist model
path = os.path.join(args.model_dir, "model.joblib")
joblib.dump(model, path)
print("model persisted at " + path)
अंत में, हम joblib का उपयोग करके मॉडल को मॉडल डायरेक्टरी में सेव करते हैं।
जब आप अपने नोटबुक में यह सेल चलाएँगे, तो script.py फ़ाइल आपके JupyterLab वातावरण में दिखाई देगी। आप नीचे दिए अनुसार इसे चलाकर जाँच सकते हैं कि यह सही काम कर रही है या नहीं:
! python script.py --n-estimators 100 \

                  --min-samples-leaf 2 \

                  --model-dir ./ \

                  --train ./ \

                  --test ./ \
extracting arguments
reading data
building training and testing datasets
validating model
Train balanced accuracy: 1.000
Test balanced accuracy: 0.998
model persisted at ./modejoblibबहुत बढ़िया, हमें 99% balanced accuracy स्कोर मिला—इससे बेहतर क्या! इसका मतलब है कि अब हम ट्रेनिंग जॉब शुरू कर सकते हैं।
अब, हम स्क्रिप्ट को SageMaker एस्टिमेटर ऑब्जेक्ट में पास करेंगे। AWS के संदर्भ में, एक ट्रेनिंग जॉब वह प्रक्रिया है जहाँ किसी निर्दिष्ट एल्गोरिद्म, डेटासेट और AWS SageMaker द्वारा प्रदान किए कंप्यूटिंग संसाधनों का उपयोग करके एक मॉडल ट्रेन किया जाता है। लोकल मशीन या नोटबुक पर ट्रेनिंग के विपरीत, यह जॉब क्लाउड में स्केलेबल इन्फ्रास्ट्रक्चर पर चलता है, जो अधिक कंप्यूटेशनल पावर, तेज़ प्रोसेसिंग और बड़े डेटासेट संभालने की क्षमता देता है।
अपने नोटबुक में एक नए सेल में निम्न कोड जोड़ें:
# We use the Estimator from the SageMaker Python SDK
from sagemaker.sklearn.estimator import SKLearn
FRAMEWORK_VERSION = "0.23-1"

sklearn_estimator = SKLearn(
   entry_point="script.py",
   role=get_execution_role(),
   instance_count=1,
   instance_type="ml.c5.xlarge",
   framework_version=FRAMEWORK_VERSION,
   base_job_name="rf-scikit",
   hyperparameters={
       "n-estimators": 100,
       "min-samples-leaf": 3,
   },
)
ऊपर दिए कोड में, SKLearn क्लास scikit-learn स्क्रिप्ट्स के साथ काम करती है। इसके कुछ आवश्यक पैरामीटर्स का विवरण:
entry_point: स्क्रिप्ट का पाथ।role: वह यूज़र/रोल जिसके पास SageMaker तक पहुँच है।instance_count: कितनी मशीनें चालू की जाएँ।instance_type: मशीन का प्रकार।हाइपरपैरामीटर्स के लिए, केवल वही पास करें जिन्हें आपने ट्रेनिंग स्क्रिप्ट में परिभाषित किया है। अन्यथा एरर आएगा।
अब, हम इस एस्टिमेटर को अपने डेटा पर फिट कर सकते हैं:
# Launch training job, with asynchronous call
sklearn_estimator.fit({"train": trainpath, "test": testpath}, wait=True)
यदि आपको इस ट्यूटोरियल के पहले के भाग याद हों, तो trainpath और testpath हमारे CSV फ़ाइलों की ओर इशारा करते S3 बकेट पाथ हैं।
जब आप ऊपर दिए कोड के साथ सेल चलाते हैं, तो ट्रेनिंग शुरू हो जाती है:
INFO:sagemaker:Creating training-job with name: rf-scikit-2024-06-04-10-36-31-142

2024-06-04 10:36:31 Starting - Starting the training job...

2024-06-04 10:36:46 Starting - Preparing the instances for training...

2024-06-04 10:37:13 Downloading - Downloading input data...

2024-06-04 10:37:53 Training - Training image download completed. Training in progress...
SageMaker आवश्यक Docker इमेज डाउनलोड करता है जो आपको scikit-learn कोड चलाने देता है और आपकी स्क्रिप्ट को निष्पादित करता है। पूरा होने पर, आपको निम्न संदेश मिलेगा:
2024-06-04 10:38:17 Uploading - Uploading generated training model

2024-06-04 10:38:17 Completed - Training job completed

Training seconds: 65

Billable seconds: 65
यदि आप अपने SageMaker डैशबोर्ड के “SageMaker” > “Traning” > “Training Jobs” सेक्शन में जाएँगे, तो आपको वहाँ यह ट्रेनिंग जॉब भी सूचीबद्ध दिखाई देगा।
क्योंकि हमारा डेटासेट छोटा है, हम कम-लागत, कम-कॉन्फ़िगरेशन वाली मशीन—ml.c5.xlarge—से काम चला पाए। लेकिन अपने प्रोजेक्ट्स में आपको लाखों रिकॉर्ड वाले या विशाल इमेज डेटासेट्स से जूझना पड़ सकता है। ऐसे मामलों में, आपको अधिक शक्ति और GPUs वाली मशीनें चुननी होंगी।
इन मशीनों का ऑन-डिमांड उपयोग काफ़ी महँगा हो सकता है। लागत घटाने के लिए, Amazon Spot Training इंस्टेंस प्रदान करता है। इन इंस्टेंस के साथ, आप कम कीमत पर हाई-पावर्ड कंप्यूटिंग संसाधन चुन सकते हैं, एक शर्त के साथ—ट्रेनिंग तुरंत शुरू नहीं होगी। इसके बजाय, SageMaker तब तक इंतज़ार करेगा जब तक डिमांड कम न हो जाए और आपके द्वारा अनुरोध की गई मशीन उपलब्ध न हो जाए।
Spot Training सक्षम करने के लिए, आपको पिछले कोड ब्लॉक में सिर्फ़ कुछ पंक्तियाँ जोड़नी हैं:
spot_sklearn_estimator = SKLearn(
   entry_point="script.py",
   role=get_execution_role(),
   instance_count=1,
   instance_type="ml.c5.xlarge",
   framework_version=FRAMEWORK_VERSION,
   base_job_name="rf-scikit",
   hyperparameters={
       "n-estimators": 100,
       "min-samples-leaf": 3,
   },
   use_spot_instances=True,
   max_wait=7200,
   max_run=3600,
)
use_spot_instances को True सेट करके, आप spot_sklearn_estimator को स्पॉट ट्रेनिंग उपयोग करने के लिए कहते हैं। आप स्पॉट इंस्टेंस के उपलब्ध होने के लिए अधिकतम प्रतीक्षा समय और ट्रेनिंग के अधिकतम रन समय को भी सेट कर सकते हैं।
ट्रेनिंग वास्तव में तब शुरू होती है जब आप दोबारा .fit() कॉल करते हैं:
# Launch training job, with asynchronous call
spot_sklearn_estimator.fit({"train": trainpath, "test": testpath}, wait=True)उसी ट्रेनिंग स्क्रिप्ट का उपयोग करके, हम मिलते-जुलते वर्कफ़्लो के साथ एक हाइपरपैरामीटर-ट्यून किया हुआ मॉडल तैयार कर सकते हैं।
पहले, हम sagemaker.tuner से IntegerParameter क्लास इम्पोर्ट करते हैं:
from sagemaker.tuner import IntegerParameterIntegerParameter क्लास SageMaker को ऐसे पैरामीटर्स के लिए ट्यूनिंग रेंज परिभाषित करने देता है जिनकी मान पूर्णांक होते हैं। tuner मॉड्यूल में अन्य प्रकार के पैरामीटर्स के लिए क्लासेज़ भी हैं:
CategoricalParameter: ऐसे हाइपरपैरामीटर्स परिभाषित करता है जो सीमित डिस्क्रीट श्रेणी मान लेते हैं।ContinuousParameter: ऐसे हाइपरपैरामीटर्स की रेंज परिभाषित करता है जिनकी मान सतत (कॉन्टिन्युअस) होती है।लेकिन इस ट्यूटोरियल में हम IntegerParameter तक ही सीमित रहेंगे क्योंकि हम Random Forest के दो पैरामीटर्स ही ट्यून कर रहे हैं:
# We use the Hyperparameter Tuner
from sagemaker.tuner import IntegerParameter

# Define exploration boundaries
hyperparameter_ranges = {
   "n-estimators": IntegerParameter(20, 100),
   "min-samples-leaf": IntegerParameter(2, 6),
}
फिर, हम एक ट्यूनर ऑब्जेक्ट बनाते हैं:
# Create Optimizer
Optimizer = sagemaker.tuner.HyperparameterTuner(
   estimator=sklearn_estimator,
   hyperparameter_ranges=hyperparameter_ranges,
   base_tuning_job_name="RF-tuner",
   objective_type="Maximize",
   objective_metric_name="balanced-accuracy",
   metric_definitions=[
       {"Name": "balanced-accuracy", "Regex": "Test balanced accuracy: ([0-9.]+).*$"}
   ],  # Extract tracked metric from logs with regexp
   max_jobs=10,
   max_parallel_jobs=2,
)
Optimizer के आवश्यक पैरामीटर्स हैं:
estimator: एस्टिमेटर ऑब्जेक्ट, जो आपकी ट्रेनिंग स्क्रिप्ट के साथ कम्पैटिबल हो।hyperparameter_ranges: ट्यूनर मॉड्यूल की क्लासेज़ से परिभाषित पैरामीटर्स की रेंज।objective_type: दिए गए मेट्रिक को मैक्सिमाइज़ करना है या मिनिमाइज़। Balanced accuracy को मैक्सिमाइज़ करना चाहिए।metric_definitions: ऑप्टिमाइज़ किए जाने वाले मेट्रिक्स के नाम और उन्हें ट्रेनिंग लॉग्स से कैसे निकाला जाए।metric_definitions पैरामीटर थोड़ा मुश्किल है क्योंकि यह मेट्रिक्स को परिभाषित करने में काफ़ी लचीलापन देता है।
ट्रेनिंग स्क्रिप्ट में, हम निम्न लॉग संदेशों से balanced accuracy रिपोर्ट कर रहे हैं:
print(f"Train balanced accuracy: {bal_acc_train:.3f}")
print(f"Test balanced accuracy: {bal_acc_test:.3f}")
metric_definitions हमसे अपेक्षा करता है कि हम रेगुलर एक्सप्रेशंस का उपयोग करके उस संदेश को कैप्चर करें। इसलिए, हमारे पास निम्न डिक्शनरी है, जो “Test balanced accuracy” से शुरू होने वाले मैट्रिक को एक कस्टम नाम देती है।
{
   "Name": "balanced-accuracy",
   "Regex": "Test balanced accuracy: ([0-9.]+).*$",
}
बाकी कोड परिचित है:
Optimizer.fit({"train": trainpath, "test": testpath})INFO:sagemaker:Creating hyperparameter tuning job with name: RF-tuner-240604-1049एक बार ऑप्टिमाइज़र ट्यूनिंग पूरी कर ले, तो आप उसके परिणामों को DataFrame के रूप में दिखा सकते हैं:
# Get tuner results in a df
results = Optimizer.analytics().dataframe()

while results.empty:
   time.sleep(1)
   results = Optimizer.analytics().dataframe()

results.head()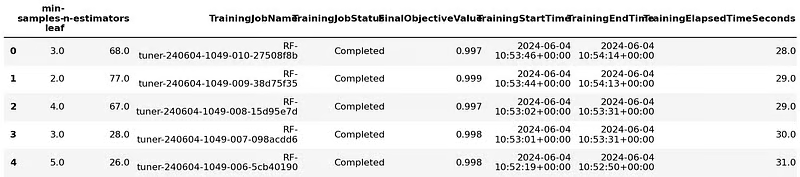
इसके बाद, आप सर्वश्रेष्ठ एस्टिमेटर प्राप्त कर सकते हैं:
best_estimator = Optimizer.best_estimator()एक बार जब आप तय कर लेते हैं कि अपने प्रयोगों के लिए किस मॉडल का उपयोग करेंगे, तो आप उसे उसके सभी आर्टिफ़ैक्ट्स सहित SageMaker पर अपलोड कर सकते हैं। यह कार्य boto3 का उपयोग करके किया जा सकता है:
artifact_path = sm_boto3.describe_training_job(
   TrainingJobName=best_estimator.latest_training_job.name
)["ModelArtifacts"]["S3ModelArtifacts"]

print("Model artifact persisted at " + artifact)
Model artifact persisted at s3://sagemaker-us-east-1-496320894061/RF-tuner-240604-1049-009-38d75f35/output/model.tar.gzdescribe_training_job() फ़ंक्शन एक एस्टिमेटर ऑब्जेक्ट लेता है और उसे SageMaker द्वारा प्रदान किए गए डिफ़ॉल्ट S3 लोकेशन पर पुश कर देता है। ऊपर, आप देख सकते हैं कि फ़ंक्शन ने अपलोड करने से पहले मॉडल को एक टारबॉल में कन्वर्ट किया।
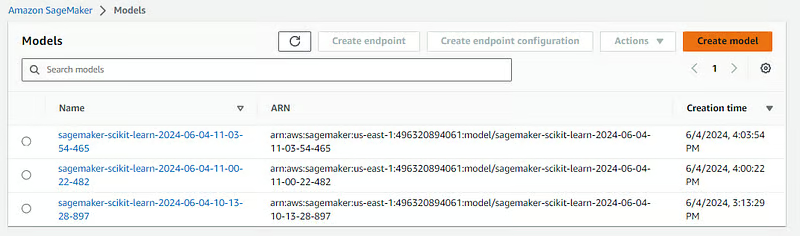
अपलोड किए गए मॉडल्स आपको अपने SageMaker डैशबोर्ड के “Inference” > “Models” सेक्शन में दिखाई देंगे:
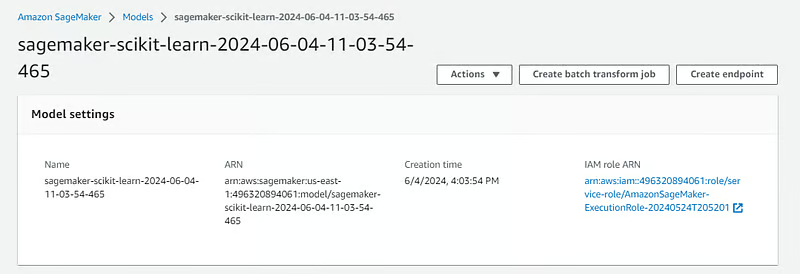
यदि आप इनमें से किसी पर क्लिक करते हैं, तो आपको स्क्रीन के दाएँ ऊपर “Create endpoint” बटन दिखाई देगा:
आप उस बटन का उपयोग करके मॉडल डिप्लॉय कर सकते हैं, या फिर कोड से, नोटबुक इंस्टेंस पर लौटकर .deploy() मेथड का उपयोग कर सकते हैं:
from sagemaker.sklearn.model import SKLearnModel

model = SKLearnModel(
   model_data=artifact_path,
   role=get_execution_role(),
   entry_point="script.py",
   framework_version=FRAMEWORK_VERSION,
)
इस बार, हम SKLearnModel क्लास का उपयोग कर रहे हैं, जो पहले से ट्रेन किए गए मॉडलों के लिए होती है। इसे आर्टिफ़ैक्ट्स जहाँ स्टोर हैं उस S3 लोकेशन और ट्रेनिंग में उपयोग हुई स्क्रिप्ट चाहिए। एक बार यह जानकारी देने के बाद, आप नीचे दिया कोड चलाकर इसे डिप्लॉय कर सकते हैं:
predictor = model.deploy(instance_type="ml.c5.large", initial_instance_count=1)
INFO:sagemaker:Creating model with name: sagemaker-scikit-learn-2024-06-04-11-03-54-465
INFO:sagemaker:Creating endpoint-config with name sagemaker-scikit-learn-2024-06-04-11-03-54-960
INFO:sagemaker:Creating endpoint with name sagemaker-scikit-learn-2024-06-04-11-03-54-960
इसके बाद, आपको अपने SageMaker डैशबोर्ड के “Inference” > “Endpoints” सेक्शन में एंडपॉइंट सूचीबद्ध दिखाई देना चाहिए:
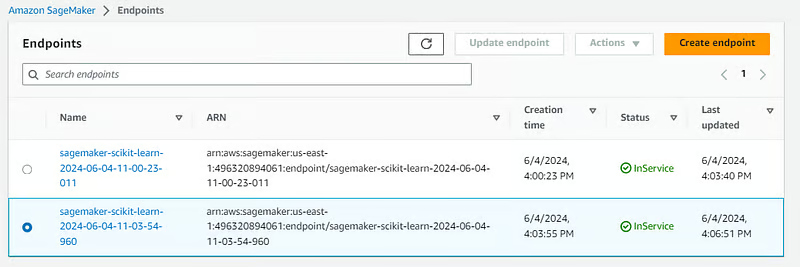
प्रेडिक्शन के लिए इसे उपयोग करने हेतु, आप अपने नोटबुक से एंडपॉइंट ऑब्जेक्ट के .predict() मेथड का उपयोग कर सकते हैं:
preds = predictor.predict(test.sample(4).drop("Class", axis=1))
preds
array([3, 0, 1, 2])बधाई हो, आपने SageMaker के साथ अपना पहला मॉडल डिप्लॉय कर लिया!
काम पूरा होने पर एंडपॉइंट को डिलीट करना न भूलें, क्योंकि यह लगातार नई लागतें पैदा करता रहता है:
sm_boto3.delete_endpoint(EndpointName=predictor.endpoint)ध्यान रखें, SageMaker में आप जो भी नोटबुक इंस्टेंस बनाते हैं, वे एक अलग टैब के साथ आते हैं जिसमें उदाहरण नोटबुक्स होते हैं जो SageMaker की अलग-अलग सुविधाएँ दिखाते हैं:
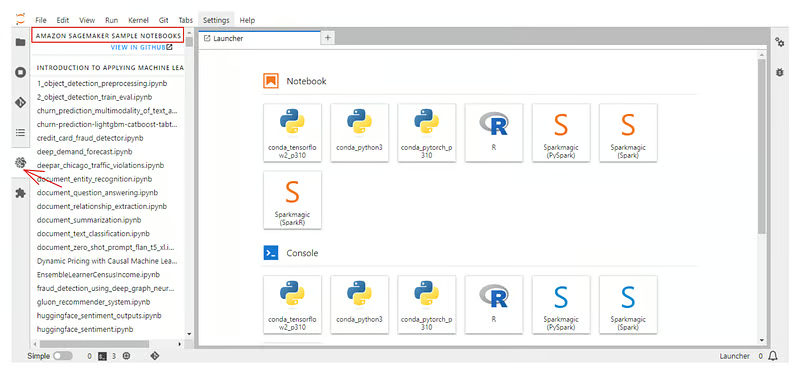
साथ ही, SageMaker Python SDK के आधिकारिक दस्तावेज़ भी ज़रूर देखें।
आज हमने सबसे लोकप्रिय एंटरप्राइज़ मशीन लर्निंग प्लेटफ़ॉर्म्स में से एक—AWS SageMaker—का उपयोग करना सीखा। हमने AWS खाता बनाने से लेकर SageMaker का उपयोग करके ML मॉडलों को एंडपॉइंट्स के रूप में डिप्लॉय करने तक सब कुछ कवर किया।
हर प्लेटफ़ॉर्म की तरह, यहाँ भी हमने केवल सतह को छुआ है। अपने प्रोजेक्ट्स में इसे अन्य AWS तकनीकों के साथ मिलाकर आप और भी बहुत कुछ कर सकते हैं। देखने के लिए कुछ संबंधित संसाधन यहाँ हैं:
इन कोर्सेज़ के साथ मशीन लर्निंग और AWS के बारे में और जानें!
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}
