डेटा और मशीन लर्निंग तकनीकों की उपलब्धता में विस्फोटक वृद्धि के साथ, रैखिक बीजगणित ने मशीन लर्निंग और डेटा साइंस के गणित में एक बुनियादी स्थान बना लिया है। ऐसे में, आकांक्षी मशीन लर्निंग और डेटा वैज्ञानिकों को रैखिक बीजगणित की बुनियादी अवधारणाएँ—जैसे वेक्टर और मैट्रिक्स, उनकी विशेषताएँ, और उन पर लागू होने वाले सामान्य क्रियाकलाप—सीखने से बहुत लाभ होगा।
हमारे Linear Algebra for Data Science in R कोर्स को लेने के लिए मैं आपको प्रोत्साहित करता/करती हूँ, ताकि डेटा साइंस और मशीन लर्निंग के लिए आपकी गणितीय नींव मजबूत हो। इस कोर्स के माध्यम से, आप रैखिक बीजगणित को एक सुंदर और रोचक विषय के रूप में सराहेंगे, जो रेखाओं, समतलों और आयतनों के माध्यम से बीजगणित और ज्यामिति का समन्वय करता है। खासकर, आप देखेंगे कि उच्च-आयामी डेटा को वेक्टर ऑब्जेक्ट्स (जैसे पाठ, चित्र, ऑडियो और फीचर्स) के रूप में प्रस्तुत करना कितना उपयुक्त है, और ये गणितीय ऑब्जेक्ट्स विज्ञान और अभियांत्रिकी—जैसे भौतिकी, सांख्यिकी, और कंप्यूटर विज्ञान—में किस तरह व्यापक रूप से प्रयुक्त होते हैं।
इस लेख में, हम रैखिक बीजगणित के एक बुनियादी ऑब्जेक्ट—मैट्रिक्स—पर निकटता से नजर डालेंगे। अन्य गणितीय ऑब्जेक्ट्स की तरह, मैट्रिक्स की भी कुछ विशेषताएँ होती हैं जो उन्हें निरूपित करती हैं। विशेष रूप से, मैं एक वर्ग मैट्रिक्स की एक निरूपक विशेषता की समीक्षा और प्रस्तुति करूँगा/करूँगी: कैरेक्टरिस्टिक बहुपद या कैरेक्टरिस्टिक समीकरण। आइए देखते हैं।
प्रत्याशी (Characteristic) समीकरण की परिभाषा
बहुपद वह फलन है जिसमें अज्ञात का घात n होता है। अज्ञात को सामान्यतः x अक्षर से दर्शाया जाता है, पर विशेष संदर्भों में एक अलग संकेतन—जैसे यूनानी अक्षर 𝝀 (लैम्ब्डा)—का उपयोग किया जाता है, जिसका हम यहाँ उपयोग करेंगे। वास्तविक संख्याओं पर परिभाषित वर्ग मैट्रिक्स A ∈Rn×n और अज्ञात 𝝀 का कैरेक्टरिस्टिक बहुपद इस प्रकार परिभाषित है:
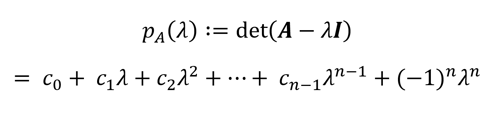
जहाँ det(.) किसी वर्ग मैट्रिक्स का डिटरमिनेंट है और I पहचान मैट्रिक्स (आइडेंटिटी मैट्रिक्स) है।
जब हम इस कैरेक्टरिस्टिक बहुपद को शून्य के बराबर रखते हैं (ताकि 𝝀 के लिए हल निकाला जा सके), तब इसे कैरेक्टरिस्टिक समीकरण कहते हैं। इस बहुपदीय समीकरण की जड़ें स्व्यात्त मान (eigenvalues) कहलाती हैं, जो मैट्रिक्स ट्रांसफॉर्मेशन और मशीन लर्निंग (जैसे आयाम-घटाव) में महत्वपूर्ण हैं। यदि आप स्व्यात्त सदिश (eigenvectors) और स्व्यात्त मानों के बारे में आश्वस्त नहीं हैं, तो हमारे पास इस विषय पर एक ट्यूटोरियल है: Eigenvectors and Eigenvalues: Key Insights for Data Science।
प्रत्याशी समीकरण का व्युत्पादन और गणना
हम दिखाते हैं कि 2x2 के वर्ग मैट्रिक्स A के लिए कैरेक्टरिस्टिक बहुपद कैसे बनाया जाता है, जहाँ:
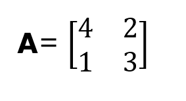
कैरेक्टरिस्टिक बहुपद की परिभाषा से, हमारे पास है:
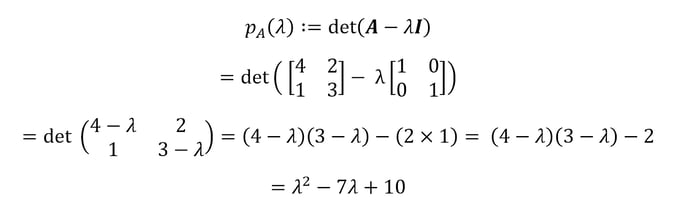
अतः, ऊपर दिए गए मैट्रिक्स A का कैरेक्टरिस्टिक बहुपद pA(𝝀)=𝝀2-7𝝀+10। हम इसे शून्य के बराबर रखकर इसकी जड़ों का पता लगा सकते हैं।
कैरेक्टरिस्टिक समीकरण का उपयोग कर स्व्यात्त मान और स्व्यात्त सदिश निकालना
किसी वर्ग मैट्रिक्स का कैरेक्टरिस्टिक बहुपद उसके संबद्ध मैट्रिक्स के महत्वपूर्ण लक्षण—जैसे स्व्यात्त मान और डिटरमिनेंट—को समाहित करता है। अतः, अज्ञात के लिए हल निकालकर कैरेक्टरिस्टिक बहुपद से स्व्यात्त मान प्राप्त करना संभव है। हम ऊपर दिए 2x2 वर्ग मैट्रिक्स A के लिए इस प्रक्रिया को दर्शाते हैं। जैसा कि हमने दिखाया, इस मैट्रिक्स का कैरेक्टरिस्टिक बहुपद है:
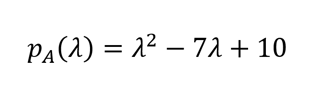
अब, स्व्यात्त मान पाने के लिए, हम इस बहुपद को शून्य के बराबर रखते हैं और बीजीय (या संगणनात्मक) विधियों से जड़ें निकालते हैं:
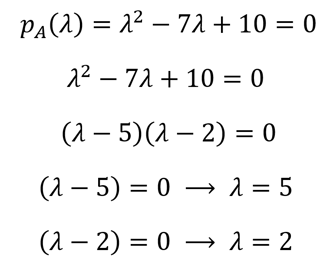
तो, स्व्यात्त मान हैं 𝝀1=5 और 𝝀2=2 (स्व्यात्त मान परंपरागत रूप से अवरोही क्रम में सूचीबद्ध किए जाते हैं, क्योंकि वे कुछ डेटा मैट्रिक्स में सूचना की मात्रा का संकेत देते हैं)। किसी मैट्रिक्स के सभी स्व्यात्त मानों के समूह को उसका eigenspectrum या spectrum कहते हैं। स्व्यात्त मानों से हम शून्य स्थान (null space) में (A-𝝀I)x=0 का उपयोग कर प्रत्येक स्व्यात्त मान के लिए स्व्यात्त सदिश निकाल सकते हैं:
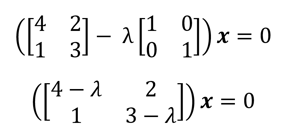
जहाँ 𝝀1=5 के लिए, हम 5 रखकर समजात रैखिक समीकरणों की प्रणाली हल करते हैं:
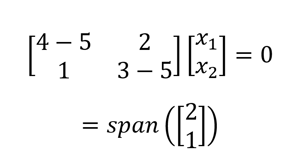
जिससे एक-आयामी (अर्थात् एक आधार सदिश) eigenspace मिलता है। हम यही प्रक्रिया 𝝀2=2 के लिए करते हैं और प्राप्त करते हैं:
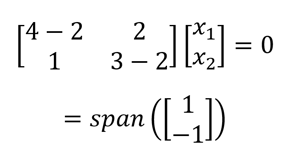
इस उदाहरण में हमारे पास दो पृथक स्व्यात्त मान हैं। किसी मैट्रिक्स में कई आवृत्त समान स्व्यात्त मान भी हो सकते हैं, जिससे बहु-आयामी (अर्थात् कई आधार सदिशों वाला) eigenspace प्राप्त होता है। इस स्थिति में, विशिष्ट स्व्यात्त सदिशों द्वारा व्याप्त eigenspace का आयाम उस स्व्यात्त मान की ज्यामितीय घाति (geometric multiplicity) कहलाता है i।
दूसरी ओर, किसी मैट्रिक्स का कोई स्व्यात्त मान जितनी बार दोहराया जाता है, उसे बीजीय घाति (algebraic multiplicity) कहते हैं। संभवतः स्व्यात्त मानों और स्व्यात्त सदिशों का सबसे रोचक अनुप्रयोग Google का PageRank एल्गोरिद्म है, जो खोज परिणामों के महत्व का रैंक निर्धारण करता है। यदि आप रुचि रखते हैं, तो हमारे Predictive Analytics using Networked Data in R कोर्स में PageRank एल्गोरिद्म पर एक रोचक अध्याय है।
संगणनात्मक तकनीकें
कैरेक्टरिस्टिक बहुपद वस्तुतः एक बहुपद ही है, जिसके कुछ विशेष गुण होते हैं (जैसे, इसमें किसी वर्ग मैट्रिक्स का ट्रेस, डिटरमिनेंट और स्व्यात्त मान शामिल होते हैं)। इसलिए, n की उच्च घातों पर कैरेक्टरिस्टिक समीकरण की जड़ें निकालना कठिन हो जाता है।
इसके अलावा, कैरेक्टरिस्टिक बहुपद निकालने के लिए आपको वर्ग मैट्रिक्स का डिटरमिनेंट निकालना पड़ता है। यद्यपि शैक्षणिक कारणों से हमने कागज-कलम से कैरेक्टरिस्टिक बहुपद के व्युत्पादन और समाधान का उदाहरण और विधि दी है, वास्तविक डेटा साइंस अनुप्रयोगों में कैरेक्टरिस्टिक बहुपद की जड़ों की गणना या सन्निकटन के लिए संख्यात्मक (संगणनात्मक) विधियों का उपयोग किया जाता है। Laplace विस्तार, Gaussian elimination, और QR decompositions कुछ ऐसी विधियाँ हैं जो संख्यात्मक तौर पर डिटरमिनेंट निकाल सकती हैं।
कैरेक्टरिस्टिक बहुपद की जड़ें निकालने के लिए प्रचलित एल्गोरिद्म में Newton-Raphson विधि, द्विभाजन (bisection), सेकैंट विधि, और Muller विधि शामिल हैं।
कैरेक्टरिस्टिक समीकरण के अनुप्रयोग
स्व्यात्त मान और स्व्यात्त सदिश, वर्ग मैट्रिक्स के बुनियादी गणितीय लक्षण हैं जिन्हें उसके कैरेक्टरिस्टिक समीकरण से निकाला जा सकता है। सांख्यिकी और मशीन लर्निंग में, कैरेक्टरिस्टिक समीकरणों का उपयोग उन विभिन्न एल्गोरिद्म में होता है जो स्व्यात्त मानों पर आधारित होते हैं और डेटा संकुचन तथा सूचना निष्कर्षण के लिए प्रयुक्त होते हैं, जैसे:
- Principal Component Analysis (PCA) और आयाम-घटाव, जहाँ निकाले गए स्व्यात्त मानों के मूल्यों के आधार पर किसी डेटा सेट को कम संख्या के वेक्टरों तक घटा दिया जाता है।
- स्पेक्ट्रल क्लस्टरिंग, जो किसी डेटा सेट की समानता मैट्रिक्स के eigenspectrum पर आधारित तकनीक है, और क्लस्टरिंग एल्गोरिद्म (जैसे k-means क्लस्टरिंग) चलाने से पहले एक चरण के रूप में डेटा का आयाम घटाने के लिए प्रयोग होती है।
- ग्राफ सिद्धांत और नेटवर्क विश्लेषण, जहाँ स्व्यात्त मानों और स्व्यात्त सदिशों का उपयोग ग्राफ को समुदायों (मुख्य अवयवों) में विभाजित करने, दृश्यांकन हेतु ग्राफ को निम्न-आयामी स्थान में एम्बेड करने, और समान eigenspectrum के साथ ग्राफ का सन्निकटन करने के लिए स्पेक्ट्रल स्पार्सिफिकेशन में किया जाता है।
- समय श्रेणी, जहाँ सिंगुलर स्पेक्ट्रम विश्लेषण का उपयोग श्रेणी में अंतर्निहित पैटर्न—जैसे प्रवृत्तियाँ, चक्र, और विसंगतियाँ—खोजने के लिए किया जाता है।
कैरेक्टरिस्टिक बहुपद के गुण
एक गणितीय ऑब्जेक्ट के रूप में, कैरेक्टरिस्टिक बहुपद के कुछ रोचक गुण होते हैं, जिनमें शामिल हैं:
- Monic: कैरेक्टरिस्टिक बहुपद का अग्रणी गुणांक सदैव एक होता है (मोनिक)।
- घात: किसी कैरेक्टरिस्टिक बहुपद की घात n सदैव संबद्ध n xn मैट्रिक्स के आकार के बराबर होती है।
- मैट्रिक्स समानता के प्रति अपरिवर्तनीयता: यदि हम किसी मैट्रिक्स को इस प्रकार रूपांतरित करें कि परिणाम एक समान (similar) मैट्रिक्स हो, तो दोनों का कैरेक्टरिस्टिक बहुपद समान होता है (अर्थात् रूपांतरित समान मैट्रिक्स मूल कैरेक्टरिस्टिक बहुपद को बनाए रखता है)।
- गुणांक: कैरेक्टरिस्टिक बहुपद का प्रथम अग्रणी पद संबद्ध मैट्रिक्स का डिटरमिनेंट होता है, और अंतिम से दूसरा गुणांक संबद्ध मैट्रिक्स का चिह्न-रहित ट्रेस होता है, c0=det(A) और cn-1=-1n-1tr(A)
- कैरेक्टरिस्टिक बहुपद में, यदि हम प्रत्येक अज्ञात के स्थान पर मूल वर्ग मैट्रिक्स रख दें, तो परिणाम शून्य मैट्रिक्स होता है (Cayley-Hamilton प्रमेय)। दूसरे शब्दों में, कैरेक्टरिस्टिक बहुपद उस वर्ग मैट्रिक्स के लिए एक विनाशी (annihilating) बहुपद है। इस रूप में, स्व्यात्त मान सीधे वर्ग मैट्रिक्स से निकाले जा सकते हैं। तदनुसार, यह कहा जा सकता है कि प्रत्येक वर्ग मैट्रिक्स अपने स्वयं के कैरेक्टरिस्टिक समीकरण को संतुष्ट करता है।
उन्नत विषय
अंत में, मैं कैरेक्टरिस्टिक बहुपदों और मैट्रिक्स गुणों से संबंधित कुछ और उन्नत विवरण प्रस्तुत करना चाहता/चाहती हूँ—गणित पर आगे की दृष्टि के रूप में—परंतु विस्तृत विवेचन के बिना।
- न्यूनतम बहुपद (Minimal Polynomial): कैरेक्टरिस्टिक बहुपद से निकटता से संबंधित एक मोनिक बहुपद न्यूनतम बहुपद होता है, जो सबसे कम धनात्मक घात का ऐसा बहुपद है जो वर्ग मैट्रिक्स A को विनष्ट करता है। क्योंकि कैरेक्टरिस्टिक बहुपद भी अपने वर्ग मैट्रिक्स को विनष्ट कर सकता है, अतः न्यूनतम बहुपद उस कैरेक्टरिस्टिक बहुपद से व्युत्पन्न किया जा सकता है।
- समानता और विकर्णीकरण (Similarity and Diagonalization): दो मैट्रिक्स समान कहलाते हैं यदि वे एक समान रैखिक रूपांतरण के माध्यम से परस्पर संबंधित हों। यदि दो मैट्रिक्स समान हैं, तो उनका रैंक, ट्रेस, डिटरमिनेंट, स्व्यात्त मान, कैरेक्टरिस्टिक बहुपद, और न्यूनतम बहुपद समान होते हैं।
- मैट्रिक्स की घातों और फलनों के कैरेक्टरिस्टिक समीकरण: किसी मैट्रिक्स की घात में, स्व्यात्त मान मैट्रिक्स Ak की k-वीं घात तक उठाए जाते हैं और संबद्ध कैरेक्टरिस्टिक बहुपद det(Ak-λI) के रूप में निकाला जाता है। किसी मैट्रिक्स फलन f(x) के लिए, कैरेक्टरिस्टिक बहुपद A के स्व्यात्त मानों पर f() का मानांकन करके निकाला जा सकता है।
निष्कर्ष
इस लेख में, हमने कैरेक्टरिस्टिक बहुपद के बारे में सीखा और यह देखा कि इसमें किसी वर्ग मैट्रिक्स की महत्वपूर्ण विशेषताएँ—जैसे स्व्यात्त मान, ट्रेस और डिटरमिनेंट—कैसे समाहित रहती हैं। डेटा साइंस और मशीन लर्निंग में स्व्यात्त मानों की महत्वपूर्ण भूमिका को देखते हुए, कैरेक्टरिस्टिक समीकरण की समझ हमें यह समझने में बहुत मदद करती है कि मशीन लर्निंग और सांख्यिकीय एल्गोरिद्म डेटा मैट्रिक्स से मुख्य अवयव कैसे निकालते हैं, पैटर्न कैसे खोजते हैं और संगणन कुशलता कैसे बढ़ाते हैं।
यदि आप डेटा साइंस और मशीन लर्निंग की अन्य महत्वपूर्ण और प्रसिद्ध समीकरणों के बारे में पढ़ने में रुचि रखते हैं, तो हमारा Normal Equation for Linear Regression Tutorial देखें। DataCamp में व्यापक और संरचित लर्निंग पाथ के लिए उत्कृष्ट कोर्स भी हैं, जैसे कि हमारा Linear Algebra for Data Science in R कोर्स, जिसका मैंने पहले उल्लेख किया था और जिसकी मैं निश्चित रूप से अनुशंसा करता/करती हूँ।


डेटा और मशीन लर्निंग तकनीकों की उपलब्धता में विस्फोटक वृद्धि के साथ, रैखिक बीजगणित ने मशीन लर्निंग और डेटा साइंस के गणित में एक बुनियादी स्थान बना लिया है। ऐसे में, आकांक्षी मशीन लर्निंग और डेटा वैज्ञानिकों को रैखिक बीजगणित की बुनियादी अवधारणाएँ—जैसे वेक्टर और मैट्रिक्स, उनकी विशेषताएँ, और उन पर लागू होने वाले सामान्य क्रियाकलाप—सीखने से बहुत लाभ होगा।
हमारे Linear Algebra for Data Science in R कोर्स को लेने के लिए मैं आपको प्रोत्साहित करता/करती हूँ, ताकि डेटा साइंस और मशीन लर्निंग के लिए आपकी गणितीय नींव मजबूत हो। इस कोर्स के माध्यम से, आप रैखिक बीजगणित को एक सुंदर और रोचक विषय के रूप में सराहेंगे, जो रेखाओं, समतलों और आयतनों के माध्यम से बीजगणित और ज्यामिति का समन्वय करता है। खासकर, आप देखेंगे कि उच्च-आयामी डेटा को वेक्टर ऑब्जेक्ट्स (जैसे पाठ, चित्र, ऑडियो और फीचर्स) के रूप में प्रस्तुत करना कितना उपयुक्त है, और ये गणितीय ऑब्जेक्ट्स विज्ञान और अभियांत्रिकी—जैसे भौतिकी, सांख्यिकी, और कंप्यूटर विज्ञान—में किस तरह व्यापक रूप से प्रयुक्त होते हैं।
इस लेख में, हम रैखिक बीजगणित के एक बुनियादी ऑब्जेक्ट—मैट्रिक्स—पर निकटता से नजर डालेंगे। अन्य गणितीय ऑब्जेक्ट्स की तरह, मैट्रिक्स की भी कुछ विशेषताएँ होती हैं जो उन्हें निरूपित करती हैं। विशेष रूप से, मैं एक वर्ग मैट्रिक्स की एक निरूपक विशेषता की समीक्षा और प्रस्तुति करूँगा/करूँगी: कैरेक्टरिस्टिक बहुपद या कैरेक्टरिस्टिक समीकरण। आइए देखते हैं।
प्रत्याशी (Characteristic) समीकरण की परिभाषा
बहुपद वह फलन है जिसमें अज्ञात का घात n होता है। अज्ञात को सामान्यतः x अक्षर से दर्शाया जाता है, पर विशेष संदर्भों में एक अलग संकेतन—जैसे यूनानी अक्षर 𝝀 (लैम्ब्डा)—का उपयोग किया जाता है, जिसका हम यहाँ उपयोग करेंगे। वास्तविक संख्याओं पर परिभाषित वर्ग मैट्रिक्स A ∈Rn×n और अज्ञात 𝝀 का कैरेक्टरिस्टिक बहुपद इस प्रकार परिभाषित है:
जहाँ det(.) किसी वर्ग मैट्रिक्स का डिटरमिनेंट है और I पहचान मैट्रिक्स (आइडेंटिटी मैट्रिक्स) है।
जब हम इस कैरेक्टरिस्टिक बहुपद को शून्य के बराबर रखते हैं (ताकि 𝝀 के लिए हल निकाला जा सके), तब इसे कैरेक्टरिस्टिक समीकरण कहते हैं। इस बहुपदीय समीकरण की जड़ें स्व्यात्त मान (eigenvalues) कहलाती हैं, जो मैट्रिक्स ट्रांसफॉर्मेशन और मशीन लर्निंग (जैसे आयाम-घटाव) में महत्वपूर्ण हैं। यदि आप स्व्यात्त सदिश (eigenvectors) और स्व्यात्त मानों के बारे में आश्वस्त नहीं हैं, तो हमारे पास इस विषय पर एक ट्यूटोरियल है: Eigenvectors and Eigenvalues: Key Insights for Data Science।
प्रत्याशी समीकरण का व्युत्पादन और गणना
हम दिखाते हैं कि 2x2 के वर्ग मैट्रिक्स A के लिए कैरेक्टरिस्टिक बहुपद कैसे बनाया जाता है, जहाँ:
कैरेक्टरिस्टिक बहुपद की परिभाषा से, हमारे पास है:
अतः, ऊपर दिए गए मैट्रिक्स A का कैरेक्टरिस्टिक बहुपद pA(𝝀)=𝝀2-7𝝀+10। हम इसे शून्य के बराबर रखकर इसकी जड़ों का पता लगा सकते हैं।
कैरेक्टरिस्टिक समीकरण का उपयोग कर स्व्यात्त मान और स्व्यात्त सदिश निकालना
किसी वर्ग मैट्रिक्स का कैरेक्टरिस्टिक बहुपद उसके संबद्ध मैट्रिक्स के महत्वपूर्ण लक्षण—जैसे स्व्यात्त मान और डिटरमिनेंट—को समाहित करता है। अतः, अज्ञात के लिए हल निकालकर कैरेक्टरिस्टिक बहुपद से स्व्यात्त मान प्राप्त करना संभव है। हम ऊपर दिए 2x2 वर्ग मैट्रिक्स A के लिए इस प्रक्रिया को दर्शाते हैं। जैसा कि हमने दिखाया, इस मैट्रिक्स का कैरेक्टरिस्टिक बहुपद है:
अब, स्व्यात्त मान पाने के लिए, हम इस बहुपद को शून्य के बराबर रखते हैं और बीजीय (या संगणनात्मक) विधियों से जड़ें निकालते हैं:
तो, स्व्यात्त मान हैं 𝝀1=5 और 𝝀2=2 (स्व्यात्त मान परंपरागत रूप से अवरोही क्रम में सूचीबद्ध किए जाते हैं, क्योंकि वे कुछ डेटा मैट्रिक्स में सूचना की मात्रा का संकेत देते हैं)। किसी मैट्रिक्स के सभी स्व्यात्त मानों के समूह को उसका eigenspectrum या spectrum कहते हैं। स्व्यात्त मानों से हम शून्य स्थान (null space) में (A-𝝀I)x=0 का उपयोग कर प्रत्येक स्व्यात्त मान के लिए स्व्यात्त सदिश निकाल सकते हैं:
जहाँ 𝝀1=5 के लिए, हम 5 रखकर समजात रैखिक समीकरणों की प्रणाली हल करते हैं:
जिससे एक-आयामी (अर्थात् एक आधार सदिश) eigenspace मिलता है। हम यही प्रक्रिया 𝝀2=2 के लिए करते हैं और प्राप्त करते हैं:
इस उदाहरण में हमारे पास दो पृथक स्व्यात्त मान हैं। किसी मैट्रिक्स में कई आवृत्त समान स्व्यात्त मान भी हो सकते हैं, जिससे बहु-आयामी (अर्थात् कई आधार सदिशों वाला) eigenspace प्राप्त होता है। इस स्थिति में, विशिष्ट स्व्यात्त सदिशों द्वारा व्याप्त eigenspace का आयाम उस स्व्यात्त मान की ज्यामितीय घाति (geometric multiplicity) कहलाता है i।
दूसरी ओर, किसी मैट्रिक्स का कोई स्व्यात्त मान जितनी बार दोहराया जाता है, उसे बीजीय घाति (algebraic multiplicity) कहते हैं। संभवतः स्व्यात्त मानों और स्व्यात्त सदिशों का सबसे रोचक अनुप्रयोग Google का PageRank एल्गोरिद्म है, जो खोज परिणामों के महत्व का रैंक निर्धारण करता है। यदि आप रुचि रखते हैं, तो हमारे Predictive Analytics using Networked Data in R कोर्स में PageRank एल्गोरिद्म पर एक रोचक अध्याय है।
संगणनात्मक तकनीकें
कैरेक्टरिस्टिक बहुपद वस्तुतः एक बहुपद ही है, जिसके कुछ विशेष गुण होते हैं (जैसे, इसमें किसी वर्ग मैट्रिक्स का ट्रेस, डिटरमिनेंट और स्व्यात्त मान शामिल होते हैं)। इसलिए, n की उच्च घातों पर कैरेक्टरिस्टिक समीकरण की जड़ें निकालना कठिन हो जाता है।
इसके अलावा, कैरेक्टरिस्टिक बहुपद निकालने के लिए आपको वर्ग मैट्रिक्स का डिटरमिनेंट निकालना पड़ता है। यद्यपि शैक्षणिक कारणों से हमने कागज-कलम से कैरेक्टरिस्टिक बहुपद के व्युत्पादन और समाधान का उदाहरण और विधि दी है, वास्तविक डेटा साइंस अनुप्रयोगों में कैरेक्टरिस्टिक बहुपद की जड़ों की गणना या सन्निकटन के लिए संख्यात्मक (संगणनात्मक) विधियों का उपयोग किया जाता है। Laplace विस्तार, Gaussian elimination, और QR decompositions कुछ ऐसी विधियाँ हैं जो संख्यात्मक तौर पर डिटरमिनेंट निकाल सकती हैं।
कैरेक्टरिस्टिक बहुपद की जड़ें निकालने के लिए प्रचलित एल्गोरिद्म में Newton-Raphson विधि, द्विभाजन (bisection), सेकैंट विधि, और Muller विधि शामिल हैं।
कैरेक्टरिस्टिक समीकरण के अनुप्रयोग
स्व्यात्त मान और स्व्यात्त सदिश, वर्ग मैट्रिक्स के बुनियादी गणितीय लक्षण हैं जिन्हें उसके कैरेक्टरिस्टिक समीकरण से निकाला जा सकता है। सांख्यिकी और मशीन लर्निंग में, कैरेक्टरिस्टिक समीकरणों का उपयोग उन विभिन्न एल्गोरिद्म में होता है जो स्व्यात्त मानों पर आधारित होते हैं और डेटा संकुचन तथा सूचना निष्कर्षण के लिए प्रयुक्त होते हैं, जैसे:
कैरेक्टरिस्टिक बहुपद के गुण
एक गणितीय ऑब्जेक्ट के रूप में, कैरेक्टरिस्टिक बहुपद के कुछ रोचक गुण होते हैं, जिनमें शामिल हैं:
उन्नत विषय
अंत में, मैं कैरेक्टरिस्टिक बहुपदों और मैट्रिक्स गुणों से संबंधित कुछ और उन्नत विवरण प्रस्तुत करना चाहता/चाहती हूँ—गणित पर आगे की दृष्टि के रूप में—परंतु विस्तृत विवेचन के बिना।
निष्कर्ष
इस लेख में, हमने कैरेक्टरिस्टिक बहुपद के बारे में सीखा और यह देखा कि इसमें किसी वर्ग मैट्रिक्स की महत्वपूर्ण विशेषताएँ—जैसे स्व्यात्त मान, ट्रेस और डिटरमिनेंट—कैसे समाहित रहती हैं। डेटा साइंस और मशीन लर्निंग में स्व्यात्त मानों की महत्वपूर्ण भूमिका को देखते हुए, कैरेक्टरिस्टिक समीकरण की समझ हमें यह समझने में बहुत मदद करती है कि मशीन लर्निंग और सांख्यिकीय एल्गोरिद्म डेटा मैट्रिक्स से मुख्य अवयव कैसे निकालते हैं, पैटर्न कैसे खोजते हैं और संगणन कुशलता कैसे बढ़ाते हैं।
यदि आप डेटा साइंस और मशीन लर्निंग की अन्य महत्वपूर्ण और प्रसिद्ध समीकरणों के बारे में पढ़ने में रुचि रखते हैं, तो हमारा Normal Equation for Linear Regression Tutorial देखें। DataCamp में व्यापक और संरचित लर्निंग पाथ के लिए उत्कृष्ट कोर्स भी हैं, जैसे कि हमारा Linear Algebra for Data Science in R कोर्स, जिसका मैंने पहले उल्लेख किया था और जिसकी मैं निश्चित रूप से अनुशंसा करता/करती हूँ।