
कोर्स
Llama 3 के साथ फाइन-ट्यूनिंग
2 घंटा
4.1K
इस ट्यूटोरियल में, हम FunctionGemma—Google DeepMind का एक हल्का फंक्शन-कॉलिंग भाषा मॉडल—का अन्वेषण करेंगे, और मैं समझाऊंगा कि विश्वसनीय और स्कीमा-अनुरूप टूल उपयोग प्राप्त करने के लिए फाइन-ट्यूनिंग क्यों आवश्यक है।
हम GPU-सक्षम Kaggle वातावरण सेटअप करने से शुरू करेंगे, फिर डाटा सेट और बेस FunctionGemma मॉडल दोनों को लोड और तैयार करेंगे।
इसके बाद, हम प्री-फाइन-ट्यूनिंग मूल्यांकन करेंगे ताकि टूल चयन और फंक्शन-कॉल की सटीकता के लिए एक बेसलाइन स्थापित हो सके। फिर हम सुपरवाइज्ड ट्रेनिंग से FunctionGemma को फाइन-ट्यून करेंगे और प्रशिक्षण के बाद उसके प्रदर्शन का मूल्यांकन करेंगे ताकि यह सत्यापित हो सके कि फाइन-ट्यूनिंग सही ढंग से लागू हुई है।
यदि आप फाइन-ट्यूनिंग सीखने के लिए कुछ हैंड्स-ऑन अभ्यास ढूंढ रहे हैं, तो मैं Fine-Tuning with Llama 3 कोर्स देखने की सलाह देता/देती हूँ।
FunctionGemma, Google का Gemma 3 270M ओपन मॉडल का एक विशेष संस्करण है, जिसे सामान्य बातचीत की बजाय विशेष रूप से फंक्शन कॉलिंग और टूल उपयोग के लिए बनाया गया है।
यह Gemma 3 के समान आर्किटेक्चर का उपयोग करता है, लेकिन इसमें समर्पित फ़ॉर्मेट और प्रशिक्षण फोकस शामिल है जो इसे फंक्शन कॉल का प्रतिनिधित्व करने वाले स्ट्रक्चर्ड आउटपुट जनरेट करने में सक्षम बनाता है।
FunctionGemma एक बेस मॉडल के रूप में जारी किया गया है, जिसे डेवलपर विशिष्ट उपयोग मामलों के लिए फाइन-ट्यून कर सकते हैं। इसका आकार और डिजाइन इसे हल्का, कुशल, और सीमित संसाधनों वाले उपकरणों—जैसे लैपटॉप और एज हार्डवेयर—पर भी डिप्लॉय करने योग्य बनाते हैं।
हालाँकि FunctionGemma को फंक्शन कॉलिंग के लिए प्रशिक्षित किया गया है, इस आकार के मॉडल तब सर्वश्रेष्ठ प्रदर्शन करते हैं जब उन्हें टास्क-विशिष्ट डाटा पर फाइन-ट्यूनिंग के जरिए विशेषज्ञ बनाया जाता है।
फाइन-ट्यूनिंग मॉडल को कई टूल्स में से सही फंक्शन चुनने और वास्तविक उपयोग मामलों के लिए संबंधित आर्ग्युमेंट्स को सही ढंग से फॉर्मैट करने के स्थिर पैटर्न सीखने में मदद करती है।
यह प्रक्रिया अधिक सुसंगत और अनुमानित स्ट्रक्चर्ड आउटपुट तक ले जाती है, जो व्यावहारिक वर्कफ़्लो में विश्वसनीयता बढ़ाती है।
आइए FunctionGemma को फाइन-ट्यून करने के लिए आवश्यक चरणों से गुजरते हैं।
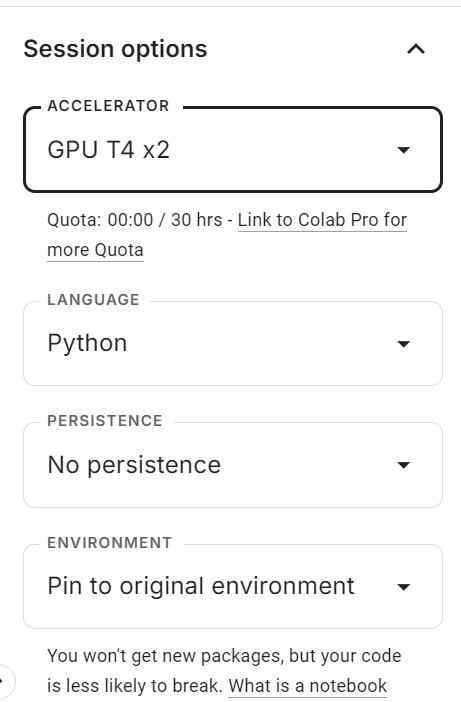
शुरू करने के लिए Kaggle पर जाएँ और नया नोटबुक बनाएँ। नोटबुक खुलने के बाद, दाएँ ओर Session options पैनल ढूँढें और Accelerator को GPU (T4 ×2) पर सेट करें।
यह सत्र के लिए GPU त्वरण सक्षम करता है और आपको Kaggle के मुफ्त कंप्यूट संसाधनों का उपयोग करके मॉडल को फाइन-ट्यून करने देता है।
GPU सक्षम करने के बाद, एक नया कोड सेल बनाएँ और सभी आवश्यक Python डिपेंडेंसी स्थापित करने के लिए निम्न कमांड चलाएँ। कर्नेल शुरू होने में थोड़ा समय लग सकता है, जिसके बाद पैकेज अपने-आप इंस्टॉल हो जाएँगे।
%pip -q install -U datasets accelerate trl kagglehub sentencepiece huggingface_hub tqdm evaluate jiwerइसके बाद, अपना Hugging Face एक्सेस टोकन सुरक्षित रूप से जोड़ें।
ऊपर के मेनू से Add-ons → Secrets खोलें, फिर Add Secret पर क्लिक करें। सीक्रेट का नाम HUGGINGFACE_TOKEN रखें और अपनी Hugging Face API कुंजी को वैल्यू के रूप में पेस्ट करें।
Kaggle Secrets का उपयोग करना नोटबुक में सीधे एंवायरनमेंट वैरिएबल या टोकन हार्ड-कोड करने की तुलना में अधिक सुरक्षित है।
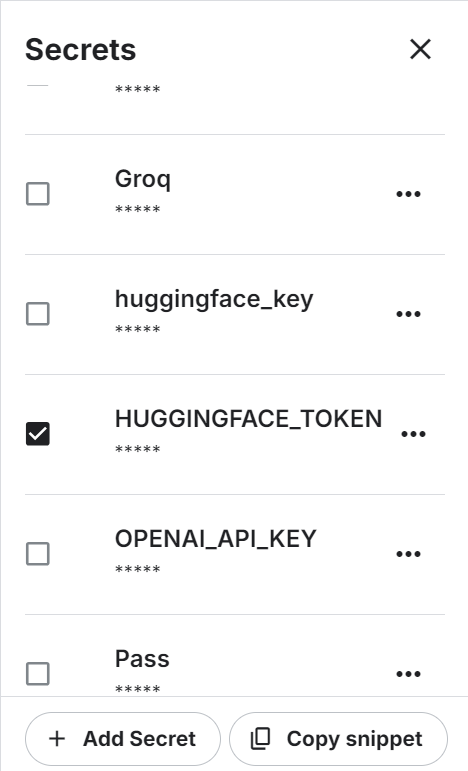
सीक्रेट सेव होने के बाद, Kaggle इसे प्रोग्रामेटिक रूप से एक्सेस करने के लिए एक स्निपेट प्रदान करेगा।
Hugging Face Hub के साथ प्रमाणीकृत होने के लिए निम्न कोड का उपयोग करें:
from kaggle_secrets import UserSecretsClient
from huggingface_hub import login

hf_token = UserSecretsClient().get_secret("HUGGINGFACE_TOKEN")
if not hf_token:
    raise ValueError("HUGGINGFACE_TOKEN not found in Kaggle Secrets.")
login(token=hf_token)
सफल प्रमाणन के बाद, आप गेटेड मॉडल और डाटा सेट एक्सेस कर सकेंगे, साथ ही अपने फाइन-ट्यून किए गए FunctionGemma मॉडल को साझा करने और पुन: उपयोग के लिए Hugging Face Hub पर पुश कर सकेंगे।
Hermes Reasoning Tool-Use डाटा सेट एक ओपन इंग्लिश डाटा सेट है जो टूल-यूज़ रीज़निंग फ़ॉर्मेट में संरचित उदाहरणों के साथ आता है, जिन्हें टूल चयन और JSON-स्टाइल फंक्शन कॉलिंग कार्यों पर मॉडलों को प्रशिक्षित और मूल्यांकन करने के लिए डिज़ाइन किया गया है।
इसमें प्राकृतिक भाषा प्रॉम्प्ट और टूल स्कीमा के साथ टूल-यूज़ रीज़निंग के हज़ारों नमूने शामिल हैं, जो सुपरवाइज्ड फाइन-ट्यूनिंग के लिए उपयुक्त फ़ॉर्मेट में हैं।
इस ट्यूटोरियल में, हम तेज़ प्रयोग के लिए डाटा सेट के एक सबसेट का उपयोग करेंगे।
सबसे पहले, एक रैंडम सीड और उपयोग करने के लिए कुल उदाहरणों की संख्या परिभाषित करें। फिर डाटा को प्रशिक्षण और मूल्यांकन स्प्लिट में बाँटें:
from datasets import load_dataset

SEED = 40
N_TOTAL = 3000
N_EVAL  = 300
N_TRAIN = N_TOTAL - N_EVAL
इसके बाद, डाटा सेट लोड करें, उसे शफ़ल करें, और ट्रेन तथा इवैल सबसेट बनाएँ:
raw = load_dataset("interstellarninja/hermes_reasoning_tool_use", split="train")
raw = raw.shuffle(seed=SEED).select(range(N_TOTAL))
train_ds = raw.select(range(N_TRAIN))
eval_ds  = raw.select(range(N_TRAIN, N_TOTAL))

print("train:", len(train_ds), "eval:", len(eval_ds))
इससे आपको 2,700 प्रशिक्षण नमूने और 300 मूल्यांकन नमूने मिलते हैं, जो कंप्यूट आवश्यकताओं को प्रबंधनीय रखते हुए फाइन-ट्यूनिंग का प्रदर्शन करने के लिए पर्याप्त हैं।
train: 2700 eval: 300इस ट्यूटोरियल में, हम KaggleHub का उपयोग करके FunctionGemma मॉडल को सीधे Kaggle नोटबुक में लोड करते हैं।
KaggleHub स्वचालित रूप से मॉडल लोकेशन को रिज़ॉल्व करता है और उसे नोटबुक वातावरण में उपलब्ध कराता है, जिससे Hugging Face से मैन्युअल डाउनलोड की आवश्यकता समाप्त हो जाती है।
import kagglehub
from transformers import AutoProcessor, AutoModelForCausalLM

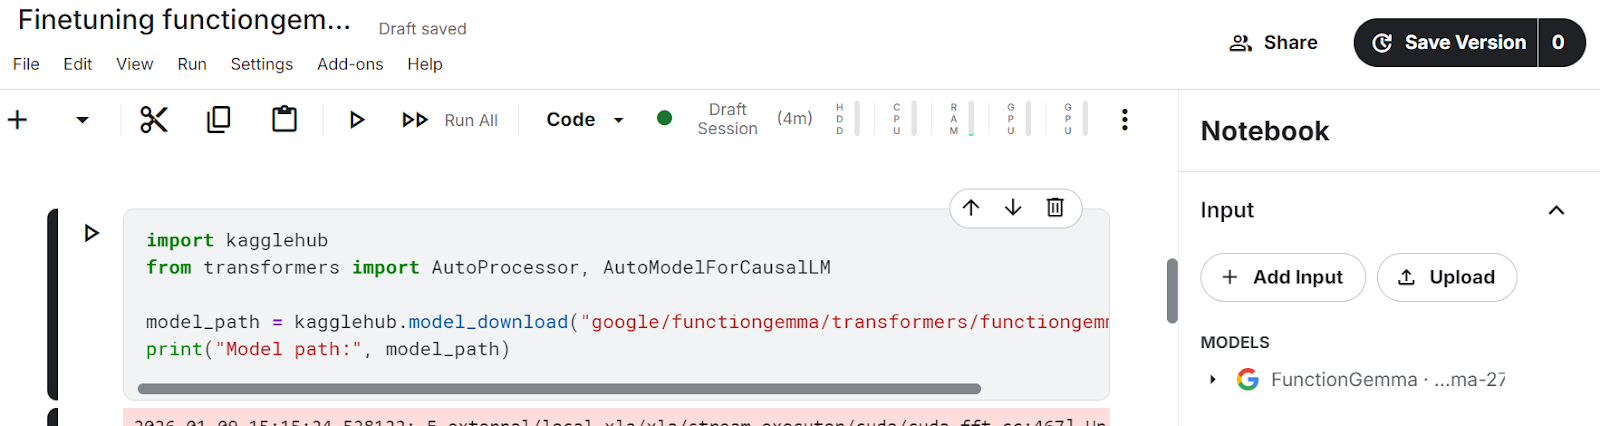
model_path = kagglehub.model_download("google/functiongemma/transformers/functiongemma-270m-it")
ऊपर वाला सेल चलाने के बाद, मॉडल फाइलें Kaggle नोटबुक के Input सेक्शन में दिखाई देंगी, जो पुष्टि करता है कि मॉडल सफलतापूर्वक लोड हो गया है और लोकली उपलब्ध है।
मॉडल उपलब्ध होने पर, हम प्रोसेसर और मॉडल दोनों को GPU मेमोरी में लोड करते हैं।
प्रोसेसर चैट टेम्पलेट और टूल स्कीमा फॉर्मैटिंग संभालता है, जबकि मॉडल स्ट्रक्चर्ड फंक्शन कॉल जनरेट करने के लिए जिम्मेदार है।
device_map="auto" सेट करने से मॉडल उपलब्ध GPU पर प्लेस होता है, और dtype="auto" हार्डवेयर द्वारा समर्थित कुशल प्रिसिशन चुनता है।
processor = AutoProcessor.from_pretrained(model_path, device_map="auto")
model = AutoModelForCausalLM.from_pretrained(model_path, dtype="auto", device_map="auto")
tokenizer = processor.tokenizer if hasattr(processor, "tokenizer") else processor

print("dtype:", model.dtype, "| device:", model.device)
यह पुष्टि करता है कि FunctionGemma सही तरीके से लोड हुआ है, GPU पर प्लेस हुआ है, और मूल्यांकन तथा फाइन-ट्यूनिंग के लिए तैयार है।
dtype: torch.bfloat16 | device: cuda:1FunctionGemma को फाइन-ट्यून करने से पहले, हमें टूल्स के रिप्रेज़ेंटेशन को मानकीकृत करना और डाटा सेट से सही (गोल्ड) फंक्शन कॉल्स को विश्वसनीय रूप से निकालना होगा।
Hermes Reasoning Tool-Use डाटा सेट कई फॉर्मैट में टूल परिभाषाएँ स्टोर कर सकता है, इसलिए यह चरण सब कुछ एक सुसंगत संरचना में बदलता है जिसे हम सुपरवाइज्ड फाइन-ट्यूनिंग के लिए उपयोग कर सकें।
हम tools फ़ील्ड को नॉर्मलाइज़ करने से शुरू करते हैं। डाटा सेट में, tools पायथन लिस्ट, JSON स्ट्रिंग के रूप में दिखाई दे सकता है, या पूरी तरह गायब भी हो सकता है।
नीचे दिया गया हेल्पर फ़ंक्शन सभी वैध रिप्रेज़ेंटेशन को एक साफ पायथन लिस्ट में बदल देता है और ख़राब या खाली एंट्रीज़ को सुरक्षित रूप से नज़रअंदाज़ कर देता है।
import re, json

def normalize_tools_field(tools):
    if tools is None:
        return []
    if isinstance(tools, list):
        return tools
    if isinstance(tools, str):
        s = tools.strip()
        if not s:
            return []
        try:
            parsed = json.loads(s)
            return parsed if isinstance(parsed, list) else []
        except Exception:
            return []
return []अब हम पैरामीटर प्रकारों को नॉर्मलाइज़ करते हैं। Hermes टूल परिभाषाएँ अक्सर अनौपचारिक टाइप एनोटेशन—जैसे str,int—या List[str] जैसे कंटेनर टाइप का उपयोग करती हैं। नीचे दिया गया फ़ंक्शन इन्हें वैध JSON Schema प्रकारों में बदल देता है जो Hugging Face फंक्शन कॉलिंग के साथ संगत हैं।
def _parse_hermes_type(t) -> dict:
    if t is None:
        return {"type": "string"}
    if isinstance(t, dict):
        return t if "type" in t else {"type": "object"}
    if isinstance(t, list):
        return {"type": "array"}
    if not isinstance(t, str):
        return {"type": "string"}

    t = t.strip()
    prim = {
        "str": "string", "string": "string",
        "int": "integer", "integer": "integer",
        "float": "number", "number": "number",
        "bool": "boolean", "boolean": "boolean",
        "dict": "object", "object": "object",
        "list": "array", "array": "array",
    }
    if t.lower() in prim:
        return {"type": prim[t.lower()]}

    m = re.match(r"List\[(.+)\]$", t)
    if m:
        return {"type": "array", "items": _parse_hermes_type(m.group(1).strip())}

    m = re.match(r"Dict\[(.+),\s*(.+)\]$", t)
    if m:
        return {"type": "object", "additionalProperties": _parse_hermes_type(m.group(2).strip())}

return {"type": "string"}इन यूटिलिटीज़ का उपयोग करके, हम Hermes-स्टाइल टूल परिभाषाओं को Hugging Face के {"type": "function", "function": {...}} स्कीमा में बदलते हैं। यह फ़ंक्शन दो फ़ॉर्मैट सपोर्ट करता है:
प्रति-आर्ग्युमेंट फ़ॉर्मैट के लिए, यह इम्प्लीमेंटेशन सूचीबद्ध पैरामीटर्स को आवश्यक मानता है यदि आवश्यक सूची स्पष्ट रूप से प्रदान नहीं की गई है।
def hermes_tools_to_hf_schema(tools_field):
    """
    Handles both:
    - Hermes per-arg style: {"parameters": {"x":{"type":"str"}, ...}}
    - Already-JSON-schema style: {"parameters":{"type":"object","properties":...,"required":[...]}}
    """
    hermes_tools = normalize_tools_field(tools_field)
    out = []

    for tool in hermes_tools:
        if not isinstance(tool, dict):
            continue

        name = tool.get("name")
        desc = tool.get("description", "")
        params = tool.get("parameters", {}) or {}

        # If params already look like JSON schema (best case)
        if isinstance(params, dict) and "type" in params and "properties" in params:
            json_schema_params = params
            if "required" not in json_schema_params:
                json_schema_params["required"] = []
        else:
            props, req = {}, []
            if isinstance(params, dict):
                for p_name, p_spec in params.items():
                    p_spec = p_spec or {}
                    if isinstance(p_spec, dict):
                        p_desc = p_spec.get("description", "")
                        p_type = p_spec.get("type", "str")
                    else:
                        p_desc, p_type = "", "str"

                    frag = dict(_parse_hermes_type(p_type))
                    if p_desc:
                        frag["description"] = p_desc
                    props[p_name] = frag
                    req.append(p_name)

            json_schema_params = {"type": "object", "properties": props, "required": req}

        out.append({
            "type": "function",
            "function": {
                "name": name,
                "description": desc,
                "parameters": json_schema_params,
            }
        })

return outहम प्रत्येक डाटा सेट उदाहरण के लिए बदले हुए टूल स्कीमा प्राप्त करने हेतु एक छोटा हेल्पर परिभाषित करते हैं:
def get_tools_hf(ex):
return hermes_tools_to_hf_schema(ex.get("tools"))इसके बाद, हम बातचीत से गोल्ड टूल कॉल निकालते हैं। Hermes बातचीतों में कई टर्न हो सकते हैं, इसलिए हम <tool_call>{...}</tool_call> ब्लॉक्स पार्स करते हैं और पहला वैध टूल कॉल ऑब्जेक्ट (नाम + आर्ग्युमेंट्स) निकालते हैं। इससे सुपरविजन सरल और सुसंगत रहता है।
TOOL_CALL_RE = re.compile(r"<tool_call>\s*(\{.*?\})\s*</tool_call>", re.DOTALL)

def extract_first_tool_call_obj(text: str):
    if not text:
        return None
    m = TOOL_CALL_RE.search(text)
    if not m:
        return None
    try:
        obj = json.loads(m.group(1))
        if isinstance(obj, dict) and "name" in obj and "arguments" in obj:
            return obj
    except Exception:
        return None
    return None
टूल कॉल को सही यूज़र टास्क से संरेखित करने के लिए, हम बातचीत इतिहास स्कैन करते हैं, उस यूज़र संदेश को ढूँढते हैं जो डाटा सेट के task से मेल खाता है, और फिर उसके तुरंत बाद आने वाला असिस्टेंट रिस्पॉन्स लेते हैं। यदि असिस्टेंट रिस्पॉन्स में टूल कॉल है, तो हम उसे गोल्ड लेबल के रूप में लौटाते हैं।
def _role(turn):
    return (turn.get("from") or "").lower().strip()

def get_gold_tool_call_task_aligned(ex):
    task = (ex.get("task") or "").strip()
    conv = ex.get("conversations") or []
    if not conv:
        return None

    idx = None
    if task:
        for i, t in enumerate(conv):
            if _role(t) in ["human", "user"]:
                val = (t.get("value") or "").strip()
                if val == task or task in val or val in task:
                    idx = i
                    break
    if idx is None:
        for i in range(len(conv)-1, -1, -1):
            if _role(conv[i]) in ["human", "user"]:
                idx = i
                break
    if idx is None:
        return None

    for j in range(idx+1, len(conv)):
        if _role(conv[j]) in ["gpt", "assistant", "model"]:
            gold = extract_first_tool_call_obj(conv[j].get("value", ""))
            if gold:
                return gold
        if _role(conv[j]) in ["human", "user"]:
            break
    return None
इस चरण के अंत में, प्रत्येक उपयोगी डाटा सेट उदाहरण में होता है:
अब हमें इन्हें ठीक उसी फ़ॉर्मेट में सुपरवाइज्ड फाइन-ट्यूनिंग (SFT) प्रशिक्षण सैंपल में बदलना है, जिसकी FunctionGemma अपेक्षा करता है, ऊपर दिए गए हेल्पर फ़ंक्शन्स का उपयोग करते हुए।
लक्ष्य ऐसे उदाहरण बनाना है जहाँ इनपुट में शामिल हो:
और टारगेट एकल, स्ट्रक्चर्ड FunctionGemma कॉल इस फ़ॉर्मेट में हो:
<start_function_call>call:TOOL_NAME{args:<escape>{...}<escape>}<end_function_call>हम डाटा सेट के माध्यम से इटरेट करके ऐसी एंट्रीज़ को फ़िल्टर करने से शुरू करते हैं जिन्हें प्रशिक्षण के लिए उपयोग नहीं किया जा सकता।
यह फ़ंक्शन केवल उन्हीं उदाहरणों को रखता है जहाँ:
from datasets import Dataset

def build_simple_rows(ds, max_rows=None):
    rows = []
    for ex in ds:
        # 1) task-aligned gold tool call
        gold = get_gold_tool_call_task_aligned(ex)
        if not gold:
            continue

        # 2) tools -> HF schema
        hf_tools = get_tools_hf(ex)
        if not hf_tools:
            continue

        # 3) build required_map: tool_name -> required fields
        required_map = {}
        for t in hf_tools:
            if t.get("type") == "function":
                fn = t.get("function", {})
                name = fn.get("name")
                req = (fn.get("parameters", {}) or {}).get("required", []) or []
                if name:
                    required_map[name] = req

        # 4) guard: gold tool must be in tool list
        tool_names = set(required_map.keys())
        if gold["name"] not in tool_names:
            continue

        # 5) force {} when no required params
        gold_args = gold.get("arguments", {})
        if not isinstance(gold_args, dict):
            gold_args = {}

        req = required_map.get(gold["name"], [])
        if len(req) == 0:
            gold_args = {}  # key fix

        rows.append({
            "user_content": ex.get("task", ""),
            "tool_name": gold["name"],
            "tool_arguments": json.dumps(gold_args, ensure_ascii=False),
            "hf_tools": hf_tools,
        })

        if max_rows and len(rows) >= max_rows:
            break

    return rows
अब हम प्रशिक्षण और मूल्यांकन पंक्तियाँ जनरेट करते हैं:
simple_train = build_simple_rows(train_ds, max_rows=N_TRAIN)
simple_eval  = build_simple_rows(eval_ds,  max_rows=N_EVAL)
print("usable train:", len(simple_train), "usable eval:", len(simple_eval))
हमारे मामले में, मूल 3,000 में से 961 प्रशिक्षण नमूने और 109 मूल्यांकन नमूने मिलते हैं। यह गिरावट अपेक्षित है क्योंकि फ़िल्टरिंग कड़ी है। यह मिसिंग टूल कॉल्स, अमान्य टूल परिभाषाओं, मिसमैच्ड टूल नामों या ख़राब आर्ग्युमेंट्स वाले उदाहरणों को हटा देती है।
usable train: 961 usable eval: 109यह क्लीनिंग चरण बहुत मायने रखता है। इसे लागू करने से पहले, डाटा सेट में शोर और मिसएलाइन सैंपल्स थे, जिनके कारण फंक्शन-कॉलिंग व्यवहार अस्थिर रहा और फाइन-ट्यूनिंग के बाद भी परिणाम खराब थे। केवल उच्च-गुणवत्ता, टास्क-संरेखित उदाहरणों तक फ़िल्टर करने के बाद, FunctionGemma कहीं अधिक सुसंगत हो जाता है और फाइन-ट्यूनिंग के परिणाम उल्लेखनीय रूप से बेहतर होते हैं।
इसके बाद, हम प्रत्येक पंक्ति को ठीक उसी प्रॉम्प्ट-प्लस-टारगेट संरचना में फॉर्मैट करते हैं जिसकी FunctionGemma को आवश्यकता है। हम प्रोसेसर के apply_chat_template का उपयोग करके टूल घोषणाओं को सही ढंग से इंजेक्ट करते हैं, फिर टारगेट के रूप में गोल्ड फंक्शन कॉल जोड़ते हैं।
def format_row_as_text(row):
    messages = [
        {"role": "developer", "content": "You are a model that can do function calling with the following functions"},
        {"role": "user", "content": row["user_content"]},
    ]
    prompt = processor.apply_chat_template(
        messages,
        tools=row["hf_tools"],
        add_generation_prompt=True,
        tokenize=False,
    )
    target = (
        f"<start_function_call>call:{row['tool_name']}"
        f"{{args:<escape>{row['tool_arguments']}<escape>}}"
        f"<end_function_call>"
    )
    return prompt + target
अब हम पंक्तियों को Hugging Face डाटा सेट ऑब्जेक्ट्स में बदलते हैं:
train_text_ds = Dataset.from_list([{"text": format_row_as_text(r)} for r in simple_train])
eval_text_ds = Dataset.from_list([{"text": format_row_as_text(r)} for r in simple_eval])कुछ TRL संस्करणों में formatting_func का स्ट्रिंग लौटाना आवश्यक है, और यदि कोई सैंपल सूची या नॉन-स्ट्रिंग बन जाता है तो ट्रेनिंग टूट सकती है। यह हेल्पर text को हमेशा एक साफ स्ट्रिंग होने के लिए फोर्स करता है।
# ensure text is always a string
def force_text_string(ds):
    def fix(ex):
        t = ex.get("text", "")
        if isinstance(t, list):
            t = "\n".join(map(str, t))
        return {"text": str(t)}
    return ds.map(fix)

train_text_ds = force_text_string(train_text_ds)
eval_text_ds  = force_text_string(eval_text_ds)
अंत में, एक सैंपल प्रिंट करें ताकि फॉर्मैटिंग की पुष्टि हो सके:
print(train_text_ds[0]["text"])आपको टूल घोषणाओं सहित एक पूर्ण रूप से रेंडर किया हुआ प्रॉम्प्ट दिखाई देना चाहिए, जिसके बाद एक गोल्ड फंक्शन कॉल इस तरह होगा:
<bos><start_of_turn>developer
You are a model that can do function calling with the following functions<start_function_declaration>declaration:get_pollution_levels{description:<escape>Retrieve pollution levels information<escape>,parameters:{properties:{location:{description:<escape>The location for which you want to get the pollution levels (e.g., Beijing, London, New York)<escape>,type:<escape>STRING<escape>},pollutant:{description:<escape>Specify a pollutant for pollution levels (e.g., PM2.5, PM10, ozone)<escape>,type:<escape>STRING<escape>}},required:[<escape>location<escape>],type:<escape>DICT<escape>}}<end_function_declaration><start_function_declaration>declaration:get_water_quality{description:<escape>Retrieve water quality information<escape>,parameters:{properties:{location:{description:<escape>The location for which you want to get the water quality (e.g., river, lake, beach)<escape>,type:<escape>STRING<escape>}},required:[<escape>location<escape>],type:<escape>DICT<escape>}}<end_function_declaration><end_of_turn>
<start_of_turn>user
I'm planning a beach cleanup at Zuma Beach this weekend and need to ensure safety. Can you provide the current water quality and if it's poor, check the pollution level of PM2.5 there?<end_of_turn>
<start_of_turn>model
<start_function_call>call:get_water_quality{args:<escape>{"location": "Zuma Beach"}<escape>}<end_function_call>प्रशिक्षण से पहले, आपको यह मापना चाहिए कि बेस FunctionGemma मॉडल फंक्शन कॉलिंग पर कितना अच्छा प्रदर्शन करता है। यह बेसलाइन आपको यह पुष्टि करने में मदद करती है कि फाइन-ट्यूनिंग वास्तव में टूल चयन और फंक्शन-कॉल फॉर्मैटिंग में सुधार करती है।
इस सेक्शन में, हम दो चीज़ों का मूल्यांकन करते हैं:
हम दो रेगुलर एक्सप्रेशन का उपयोग करते हैं ताकि मॉडल आउटपुट से भविष्यवाणी किए गए टूल नाम और पूरे फंक्शन-कॉल ब्लॉक को निकाला जा सके, फिर उन्हें गोल्ड लेबल्स से तुलना करते हैं।
import re
import evaluate
import torch
from tqdm.auto import tqdm

cer_metric = evaluate.load("cer")

# Gemma / FunctionGemma-style only
FG_BLOCK_RE = re.compile(r"<start_function_call>.*?<end_function_call>", re.DOTALL)
FG_NAME_RE  = re.compile(r"call:([a-zA-Z0-9_]+)\{", re.DOTALL)

def extract_tool_name(gen: str):
    gen = gen or ""
    m = FG_NAME_RE.search(gen)
    return m.group(1) if m else None

def extract_call_block(gen: str):
    gen = gen or ""
    m = FG_BLOCK_RE.search(gen)
    return m.group(0) if m else ""

def gold_call_block(r):
    return (
        f"<start_function_call>call:{r['tool_name']}"
        f"{{args:<escape>{r['tool_arguments']}<escape>}}"
        f"<end_function_call>"
)नीचे दिया गया फ़ंक्शन मूल्यांकन उदाहरणों के एक सबसेट पर इन्फरेंस चलाता है और दोनों मेट्रिक्स की गणना करता है। हम सैंपलिंग को (do_sample=False) अक्षम रखते हैं ताकि परिणाम नियतात्मक हों और फाइन-ट्यूनिंग से पहले और बाद में तुलना करना आसान हो।
@torch.inference_mode()
def eval_tool_and_cer(proc, mdl, rows, n=50, max_new_tokens=128):
    mdl.eval()
    n = min(n, len(rows))
    tool_ok = 0
    preds, refs = [], []

    for i in tqdm(range(n)):
        r = rows[i]
        messages = [
            {"role": "developer", "content": "You are a model that can do function calling with the following functions"},
            {"role": "user", "content": r["user_content"]},
        ]

        inputs = proc.apply_chat_template(
            messages,
            tools=r["hf_tools"],
            add_generation_prompt=True,
            return_dict=True,
            return_tensors="pt",
        )
        inputs = {k: v.to(mdl.device) for k, v in inputs.items()}

        out = mdl.generate(
            **inputs,
            do_sample=False,
            max_new_tokens=max_new_tokens,
            pad_token_id=proc.eos_token_id,
        )

        gen = proc.decode(out[0][inputs["input_ids"].shape[-1]:], skip_special_tokens=True).strip()

        if extract_tool_name(gen) == r["tool_name"]:
            tool_ok += 1

        preds.append(extract_call_block(gen))
        refs.append(gold_call_block(r))

    return {
        "n_eval": n,
        "tool_accuracy": tool_ok / n,
        "TC-CER (lower is better)": cer_metric.compute(predictions=preds, references=refs),
    }
बेसलाइन मूल्यांकन चलाएँ:
pre_metrics = eval_tool_and_cer(processor, model, simple_eval, n=50, max_new_tokens=128)
print("PRE metrics:", pre_metrics)
फाइन-ट्यूनिंग से पहले भी, FunctionGemma इस कार्य पर मजबूत बेसलाइन प्रदर्शन दिखाता है।
50 मूल्यांकन उदाहरणों के सबसेट पर, मॉडल 88% टूल-नाम सटीकता प्राप्त करता है, यानी अधिकांश मामलों में यह सही फंक्शन का चयन करता है।
इसके अलावा, पूरे फंक्शन-कॉल ब्लॉक के लिए टूल-कॉल कैरेक्टर एरर रेट (TC-CER) लगभग 33% है, जो इंगित करता है कि जबकि अक्सर सही टूल चुना जाता है, जनरेट किए गए आर्ग्युमेंट्स और फॉर्मैटिंग अभी भी गोल्ड टारगेट से भिन्न होते हैं।
PRE metrics: {'n_eval': 50, 'tool_accuracy': 0.88, 'TC-CER (lower is better)': 0.33399307273626916}ये परिणाम पुष्टि करते हैं कि बेस FunctionGemma मॉडल पहले से ही फंक्शन कॉलिंग की बुनियादी यांत्रिकी समझता है।
हालाँकि, अपेक्षाकृत उच्च कैरेक्टर एरर रेट यह उजागर करता है कि जनरेट किए गए फंक्शन कॉल्स के आर्ग्युमेंट्स की पूर्णता, फॉर्मैटिंग की सुसंगतता और समग्र स्ट्रक्चरल शुद्धता को सुधारने के लिए फाइन-ट्यूनिंग की आवश्यकता है।
मेट्रिक्स उपयोगी हैं, लेकिन गुणवत्तापूर्ण आउटपुट देखना भी महत्वपूर्ण है। नीचे दिया गया हेल्पर एक उदाहरण के लिए इन्फरेंस चलाता है और भविष्यवाणी किए गए फंक्शन कॉल को गोल्ड रेफरेंस के साथ प्रिंट करता है।
import torch

@torch.inference_mode()
def infer_one(proc, mdl, rows, idx=0, max_new_tokens=128):
    r = rows[idx]

    messages = [
        {"role": "developer", "content": "You are a model that can do function calling with the following functions"},
        {"role": "user", "content": r["user_content"]},
    ]

    inputs = proc.apply_chat_template(
        messages,
        tools=r["hf_tools"],
        add_generation_prompt=True,
        return_dict=True,
        return_tensors="pt",
    )
    inputs = {k: v.to(mdl.device) for k, v in inputs.items()}

    out = mdl.generate(
        **inputs,
        do_sample=False,
        max_new_tokens=max_new_tokens,
        pad_token_id=proc.eos_token_id,
    )

    gen = proc.decode(
        out[0][inputs["input_ids"].shape[-1]:],
        skip_special_tokens=True
    ).strip()

    pred_tool = extract_tool_name(gen)

    return {
        "task": r["user_content"],
        "tool_match": (pred_tool == r["tool_name"]),
        "predicted": extract_call_block(gen),
        "gold": gold_call_block(r),
    }
इसे एक उदाहरण पर चलाएँ:
pre = infer_one(processor, model, simple_eval, idx=15)


print(f"""
TASK:
{pre['task']}

TOOL MATCH: {pre['tool_match']}

--- PREDICTED ---
{pre['predicted']}

--- GOLD ---
{pre['gold']}
""")
आउटपुट:
TASK:
I'm reviewing the schedule in the surgical unit. Can you fetch the surgical nursing details for patient ID 12345 undergoing a 'Cardiac Bypass' today? If the procedure is handled by Nurse Ratched, let's record a post-operative care task for this evening.

TOOL MATCH: True

--- PREDICTED ---
<start_function_call>call:get_surgical_nursing_information{nurse_id:<escape>Ratched<escape>,patient_id:<escape>12345<escape>,procedure_type:<escape>Cardiac Bypass<escape>}<end_function_call>

--- GOLD ---
<start_function_call>call:get_surgical_nursing_information{args:<escape>{"patient_id": "12345", "procedure_type": "Cardiac Bypass"}<escape>}<end_function_call>
इस उदाहरण में, मॉडल सही फंक्शन चुनता है, इसलिए टूल मैच True है।
हालाँकि, जनरेट किया गया कॉल अतिरिक्त आर्ग्युमेंट्स शामिल करता है और प्रशिक्षण में उपयोग किए गए सटीक टारगेट स्ट्रक्चर का पालन नहीं करता।
यद्यपि ये आर्ग्युमेंट्स अर्थपूर्ण हैं, वे गोल्ड फंक्शन कॉल फ़ॉर्मेट से मेल नहीं खाते, जो उच्च कैरेक्टर एरर रेट में योगदान देता है। यह दर्शाता है कि केवल टूल चयन ही नहीं, बल्कि स्ट्रक्चरल सुसंगतता और स्कीमा अनुपालन सुधारने के लिए भी फाइन-ट्यूनिंग आवश्यक है।
अब जबकि हमारे पास साफ SFT डाटा सेट हैं, अगला कदम उस ट्रेनर को कॉन्फ़िगर करना है जो FunctionGemma को फाइन-ट्यून करेगा। हम TRL के SFTTrainer का उपयोग करते हैं, जो टेक्स्ट उदाहरणों पर चैट-स्टाइल मॉडलों को फाइन-ट्यून करने का हल्का और विश्वसनीय तरीका है।
हम एक आउटपुट डायरेक्टरी भी सेट करते हैं ताकि Kaggle फाइन-ट्यून किया हुआ चेकपॉइंट एक पर्सिस्टेंट लोकेशन पर सेव कर दे।
from trl import SFTConfig, SFTTrainer

OUT_DIR = "/kaggle/working/functiongemma-hermes-ft"
प्रशिक्षण के दौरान VRAM उपयोग कम करने के लिए, हम ग्रेडिएंट चेकपॉइंटिंग सक्षम करते हैं और KV कैश को अक्षम करते हैं।
# VRAM savings
model.gradient_checkpointing_enable()
model.config.use_cache = Falseहम SFTConfig का उपयोग करके प्रशिक्षण कॉन्फ़िगरेशन परिभाषित करते हैं। ये सेटिंग्स Kaggle GPUs पर स्थिरता और दक्षता के संतुलन के लिए चुनी गई हैं, साथ ही प्रशिक्षण समय को छोटा रखने के लिए।
cfg = SFTConfig(
    output_dir=OUT_DIR,
    max_length=512,
    packing=False,
    num_train_epochs=1,
    per_device_train_batch_size=2,
    gradient_accumulation_steps=8,
    learning_rate=5e-5,
    lr_scheduler_type="cosine",
    warmup_ratio=0.03,
    logging_steps=10,
    eval_strategy="steps",
    eval_steps=10,
    report_to="none",
    fp16=(model.dtype == torch.float16),
    bf16=(model.dtype == torch.bfloat16),
    optim="adamw_torch_fused",
)
फॉर्मैटिंग फ़ंक्शन सुनिश्चित करता है कि प्रत्येक प्रशिक्षण उदाहरण एकल स्ट्रिंग के रूप में वापस आए, जो मौजूदा TRL संस्करण के लिए आवश्यक है।
def formatting_func(example):
    # MUST return a STRING (not list) for your TRL version
    t = example.get("text", "")
    if isinstance(t, list):
        t = "\n".join(map(str, t))
return str(t)अंत में, हम मॉडल, कॉन्फ़िगरेशन, डाटा सेट और टोकनाइज़र के साथ SFTTrainer को इनिशियलाइज़ करते हैं।
trainer = SFTTrainer(
    model=model,
    args=cfg,
    train_dataset=train_text_ds,
    eval_dataset=eval_text_ds,
    processing_class=tokenizer,
    formatting_func=formatting_func,
)ट्रेनर कॉन्फ़िगर होने के साथ, अब हम मॉडल को फाइन-ट्यून करना शुरू कर सकते हैं। यह चरण तैयार डाटा सेट पर सुपरवाइज्ड ट्रेनिंग चलाता है और प्रशिक्षण के दौरान समय-समय पर मॉडल का मूल्यांकन करता है।
trainer.train()
trainer.save_model(OUT_DIR)
processor.save_pretrained(OUT_DIR)
print("Saved to:", OUT_DIR)
प्रशिक्षण पूरा होने के बाद, हम फाइन-ट्यून किए गए मॉडल और प्रोसेसर दोनों को आउटपुट डायरेक्टरी में सेव करते हैं ताकि उन्हें इन्फरेंस के लिए पुन: उपयोग किया जा सके या Hugging Face Hub पर अपलोड किया जा सके।
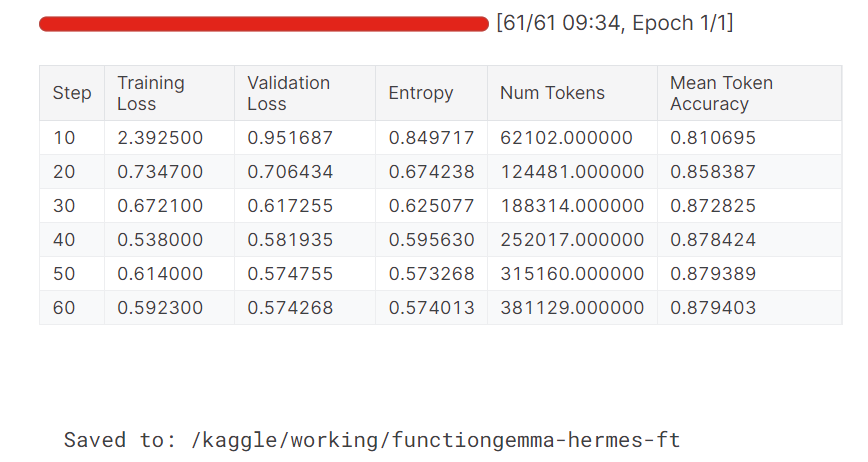
प्रशिक्षण के दौरान, प्रशिक्षण और मान्यकरण लॉस दोनों स्थिर रूप से घटते हैं। औसत टोकन सटीकता भी समय के साथ बेहतर होती है, जो दर्शाता है कि मॉडल ने अधिक सटीक और सुसंगत फंक्शन-कॉल आउटपुट उत्पन्न करना सफलतापूर्वक सीख लिया है।
फाइन-ट्यूनिंग पूरा होने के बाद, हम मॉडल को प्रकाशित कर सकते हैं ताकि उसे आसानी से पुन: उपयोग, साझा या डिप्लॉय किया जा सके। मॉडल को Hugging Face Hub पर पुश करने से अन्य लोग इसे मानक Transformers API के माध्यम से सीधे लोड कर सकते हैं।
HF_REPO_ID = "kingabzpro/functiongemma-hermes-3k-ft"
model.push_to_hub(HF_REPO_ID)
processor.push_to_hub(HF_REPO_ID)
print("Pushed to:", HF_REPO_ID)
अपलोड पूरा होने के बाद, फाइन-ट्यून किया गया मॉडल Hugging Face पर सार्वजनिक रूप से उपलब्ध होता है:
Pushed to: kingabzpro/functiongemma-hermes-3k-ft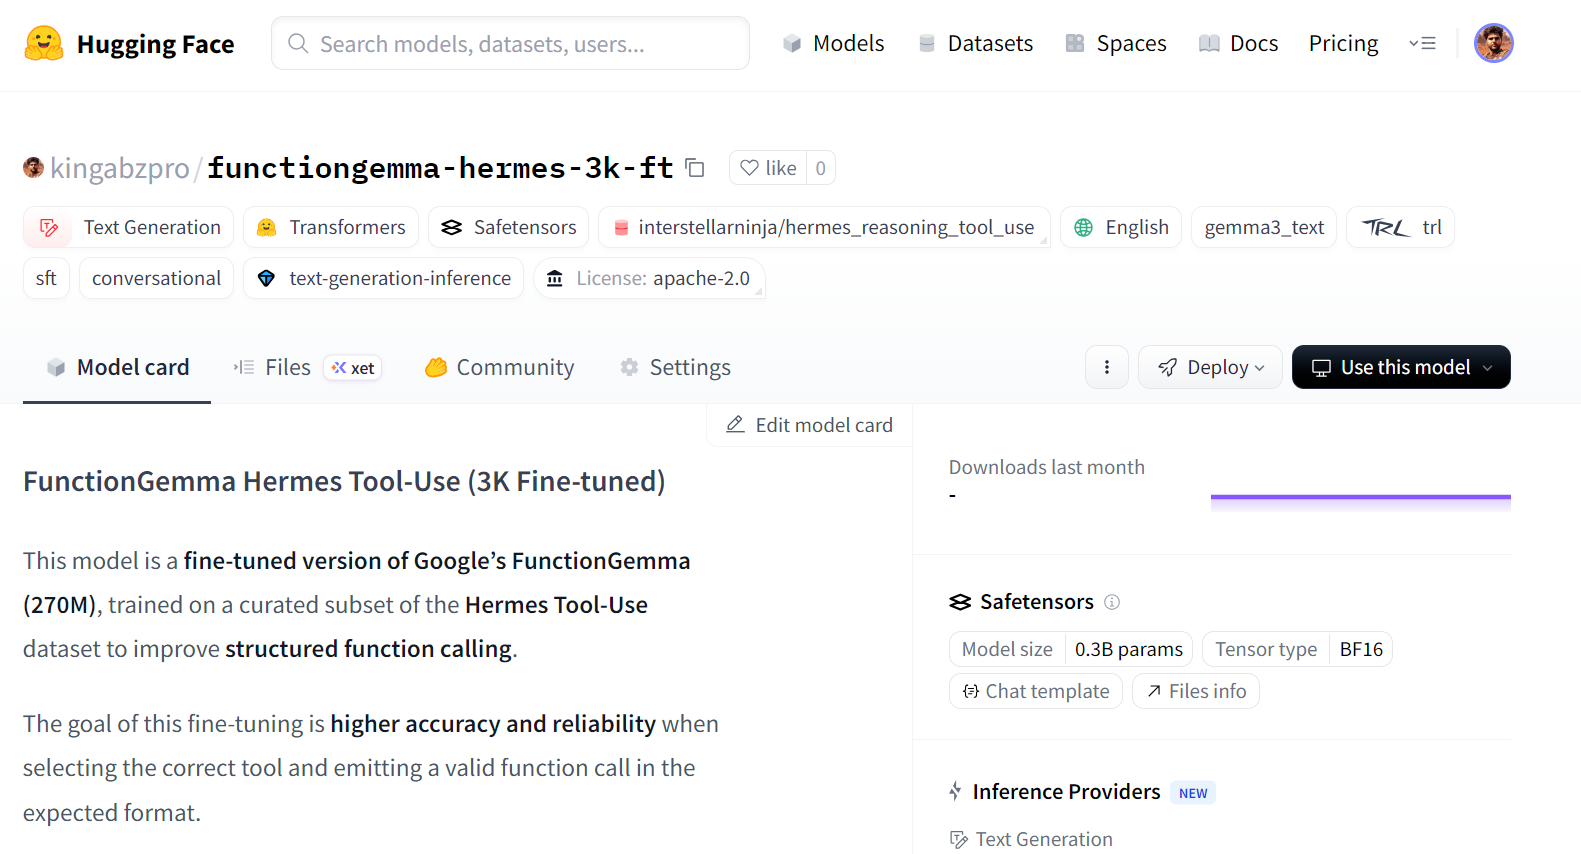
स्रोत: kingabzpro/functiongemma-hermes-3k-ft · Hugging Face
फाइन-ट्यूनिंग पूरा होने के बाद, हम डिस्क से सेव किए गए मॉडल और प्रोसेसर को फिर से लोड करते हैं और वही मूल्यांकन पाइपलाइन चलाते हैं जो प्रशिक्षण से पहले उपयोग की गई थी। इससे प्री- और पोस्ट-फाइन-ट्यूनिंग प्रदर्शन के बीच तुलना निष्पक्ष और सुसंगत रहती है।
from transformers import AutoProcessor, AutoModelForCausalLM

ft_processor = AutoProcessor.from_pretrained(OUT_DIR, device_map="auto")
ft_model = AutoModelForCausalLM.from_pretrained(OUT_DIR, dtype="auto", device_map="auto")
इसके बाद, हम मूल्यांकन सेट पर फाइन-ट्यून मॉडल का टूल-नाम सटीकता और TC-CER के साथ मूल्यांकन करते हैं।
post_metrics = eval_tool_and_cer(ft_processor, ft_model, simple_eval, n=50, max_new_tokens=64)
print("POST metrics:", post_metrics)
परिणाम बेसलाइन पर स्पष्ट सुधार दिखाते हैं:
POST metrics: {'n_eval': 50, 'tool_accuracy': 0.98, 'TC-CER (lower is better)': 0.1454725383473528}टूल-नाम सटीकता 88 प्रतिशत से बढ़कर 98 प्रतिशत हो जाती है, और पूरे फंक्शन-कॉल ब्लॉक के लिए कैरेक्टर एरर रेट आधे से अधिक कम हो जाता है। यह इंगित करता है कि अब मॉडल न केवल सही टूल अधिक विश्वसनीय रूप से चुनता है, बल्कि ऐसे आउटपुट भी उत्पन्न करता है जो टारगेट स्कीमा से अधिक मेल खाते हैं।
सुधार को बेहतर समझने के लिए, हम व्यक्तिगत भविष्यवाणियों का निरीक्षण करते हैं। नीचे दिए गए उदाहरण में, मॉडल सही फंक्शन चुनता है और अधिक पूर्ण आर्ग्युमेंट्स के साथ एक अच्छा-संरचित कॉल उत्पन्न करता है।
post = infer_one(ft_processor, ft_model, simple_eval, idx=15)

print(f"""
TASK:
{post['task']}

TOOL MATCH: {pre['tool_match']}

--- PREDICTED ---
{post['predicted']}

--- GOLD ---
{post['gold']}
""")
यद्यपि भविष्यवाणी किया गया कॉल गोल्ड टारगेट से आगे कुछ अतिरिक्त आर्ग्युमेंट्स शामिल कर सकता है, समग्र संरचना और आर्ग्युमेंट फॉर्मैटिंग फाइन-ट्यूनिंग से पहले की तुलना में काफी अधिक सुसंगत है। यह बेहतर स्कीमा जागरूकता और यूज़र इरादे तथा जनरेट किए गए फंक्शन कॉल्स के बीच मजबूत एलाइनमेंट को दर्शाता है।
TASK:
I'm reviewing the schedule in the surgical unit. Can you fetch the surgical nursing details for patient ID 12345 undergoing a 'Cardiac Bypass' today? If the procedure is handled by Nurse Ratched, let's record a post-operative care task for this evening.

TOOL MATCH: True

--- PREDICTED ---
<start_function_call>call:get_surgical_nursing_information{args:<escape>{"patient_id": "12345", "procedure_type": "Cardiac Bypass", "nurse_id": "Ratched", "task": "Post-operative care"}<escape>}<end_function_call>

--- GOLD ---
<start_function_call>call:get_surgical_nursing_information{args:<escape>{"patient_id": "12345", "procedure_type": "Cardiac Bypass"}<escape>}<end_function_call>
आइए एक और सैंपल देखें।
post = infer_one(ft_processor, ft_model, simple_eval, idx=25)

print(f"""
TASK:
{post['task']}

TOOL MATCH: {pre['tool_match']}

--- PREDICTED ---
{post['predicted']}

--- GOLD ---
{post['gold']}
""")
दूसरा उदाहरण URL एक्सट्रैक्शन टास्क के लिए एक साफ और सही फंक्शन कॉल दिखाता है, जो दर्शाता है कि फाइन-ट्यून किया गया मॉडल विभिन्न टूल्स में अच्छी तरह जनरलाइज़ करता है।
TASK:
I would like to extract details from a LinkedIn company page. Could you assist me in fetching the information from this URL: https://www.linkedin.com/company/abc-corporation?

TOOL MATCH: True

--- PREDICTED ---
<start_function_call>call:extract{args:<escape>{"url": "https://www.linkedin.com/company/abc-corporation"}<escape>}<end_function_call>

--- GOLD ---
<start_function_call>call:extract{args:<escape>{"url": "https://www.linkedin.com/company/abc-corporation", "html": true}<escape>}<end_function_call>
कुल मिलाकर, ये परिणाम पुष्टि करते हैं कि फाइन-ट्यूनिंग फंक्शन-कॉलिंग कार्यों के लिए सटीकता और स्ट्रक्चरल शुद्धता दोनों में सफलतापूर्वक सुधार लाती है।
इस ट्यूटोरियल का पूरा Kaggle नोटबुक यहाँ उपलब्ध है:https://www.kaggle.com/code/kingabzpro/finetuning-functiongemma
यदि आपको कोई समस्या आती है, तो आप नोटबुक को क्लोन कर सकते हैं, अपना Hugging Face सीक्रेट जोड़ सकते हैं, और इसे एंड-टू-एंड चला सकते हैं।
यदि आप FunctionGemma को जनरल टेक्स्ट-जेनेरेशन डाटा सेट्स पर प्रशिक्षित करने की कोशिश कर रहे हैं, तो बेहतर होगा कि आप जल्दी रुक जाएँ। FunctionGemma सामान्य-उद्देश्य भाषा मॉडल की तरह व्यवहार करने के लिए डिज़ाइन नहीं किया गया है।
ओपन-एंडेड टेक्स्ट जनरेशन के लिए, Gemma 3 मॉडल परिवार बेहतर विकल्प है।
FunctionGemma फंक्शन कॉलिंग के लिए उद्देश्य-निर्मित है, जहाँ लक्ष्य सही टूल चुनना, स्कीमा-अनुरूप आर्ग्युमेंट्स तैयार करना, और APIs, डेटाबेस, व सेवाओं जैसे बाहरी सिस्टम्स के साथ विश्वसनीय रूप से इंटरैक्ट करना है।
FunctionGemma का छोटा आकार एक सोचा-समझा डिज़ाइन विकल्प है। 270 मिलियन पैरामीटर्स पर, यह लो-लेटेंसी, संसाधन-कुशल डिप्लॉयमेंट्स—जिनमें लोकल मशीनें, एज डिवाइसेस, और प्राइवेट इन्फ्रास्ट्रक्चर शामिल हैं—के लिए अनुकूलित है। यह उसे रियल-टाइम फंक्शन कॉलिंग और एजेंटिक वर्कफ़्लोज़ के लिए उपयुक्त बनाता है, जहाँ शुद्धता और संरचना, प्रवाहपूर्ण गद्य से अधिक मायने रखते हैं।
इस ट्यूटोरियल में, हमने Hermes Reasoning Tool-Use डाटा सेट पर FunctionGemma को फाइन-ट्यून करना सीखा। एक प्रमुख निष्कर्ष यह है कि डाटा तैयारी और मूल्यांकन, कच्चे प्रशिक्षण समय से अधिक मायने रखते हैं।
डाटा सेट को सावधानी से साफ करके, टास्क को गोल्ड टूल कॉल्स के साथ संरेखित करके, और कड़े स्कीमा अनुशासन को लागू करके, हम अपेक्षाकृत कम संख्या के उच्च-गुणवत्ता वाले सैंपल्स के साथ मॉडल व्यवहार में नाटकीय सुधार करने में सक्षम रहे।
परिणाम स्पष्ट रूप से फाइन-ट्यूनिंग के प्रभाव को दिखाते हैं। टूल-नाम सटीकता 88 प्रतिशत से 98 प्रतिशत पर पहुँची, और पूरे फंक्शन-कॉल ब्लॉक्स के लिए कैरेक्टर एरर रेट आधे से अधिक घट गया। इससे भी महत्वपूर्ण बात यह है कि मॉडल वास्तविक-विश्व उपयोग के अनुरूप, अच्छी तरह-संरचित और पूर्वानुमेय फंक्शन कॉल्स उत्पन्न करने में कहीं अधिक सुसंगत हो गया।
शीर्ष DataCamp कोर्स
कोर्स
कोर्स
कोर्स